مثال على استكشاف VOC#
اعتبارًا من ultralytics>=8.3.12، تمت إزالة Ultralytics Explorer. لاستخدام Explorer، ثبّت pip install ultralytics==8.3.11. تتوفر ميزات مماثلة (وموسّعة) لاستكشاف مجموعات البيانات في Ultralytics Platform.
يستعرض هذا المثال استخدام Explorer API على مجموعة بيانات VOC: إنشاء جدول تضمينات، وإجراء عمليات بحث دلالية وSQL، وطرح أسئلة باللغة الطبيعية. تشغل الخطوات نفسها GUI الخاصة بـ yolo explorer.
الإعداد#
قم بتثبيت إصدار ultralytics المثبت مع ملحقات Explorer، ثم تحقق من البرمجيات والأجهزة.
pip install "ultralytics[explorer]==8.3.11" openai
yolo checks
البحث عن التشابه#
استفد من قوة البحث عن التشابه المتجهي للعثور على نقاط البيانات المشابهة في مجموعة بياناتك، إلى جانب مسافاتها في فضاء التضمين. ما عليك سوى إنشاء جدول تضمينات لزوج مجموعة البيانات والنموذج المحدد. يلزم تنفيذ ذلك مرة واحدة فقط، ويُعاد استخدامه تلقائيًا.
from ultralytics import Explorer

exp = Explorer("VOC.yaml", model="yolo11n.pt")
exp.create_embeddings_table()
بعد إنشاء جدول التضمينات، يمكنك إجراء بحث دلالي بإحدى الطرق التالية:
- في فهرس/قائمة فهارس محددة في مجموعة البيانات، مثل
exp.get_similar(idx=[1, 10], limit=10) - على أي صورة أو قائمة صور غير موجودة في مجموعة البيانات، مثل
exp.get_similar(img=["path/to/img1", "path/to/img2"], limit=10)حال وجود مدخلات متعددة، يتم استخدام إجمالي تضميناتها.
تحصل على DataFrame من pandas يضم عددًا من نقاط البيانات الأكثر تشابهًا مع المدخل، وفقًا للحد المحدد، إلى جانب مسافاتها في فضاء التضمين. يمكنك استخدام مجموعة البيانات هذه لإجراء مزيد من التصفية.
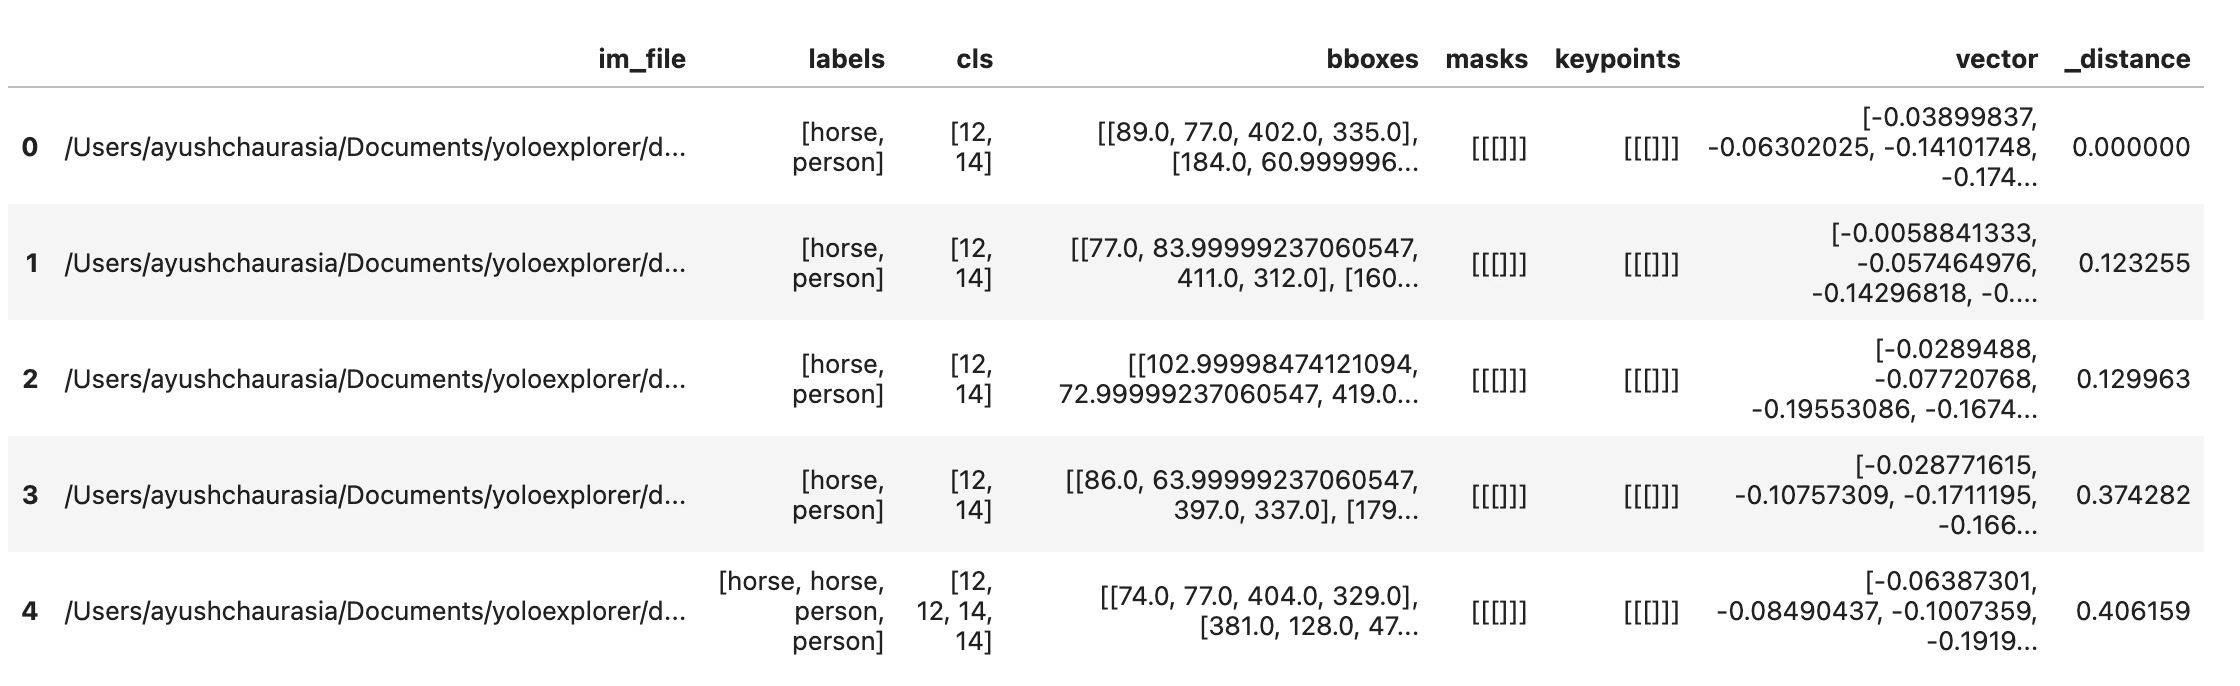
# Search dataset by index
similar = exp.get_similar(idx=1, limit=10)
similar.head()
يمكنك أيضًا رسم العينات المتشابهة مباشرةً باستخدام الأداة plot_similar
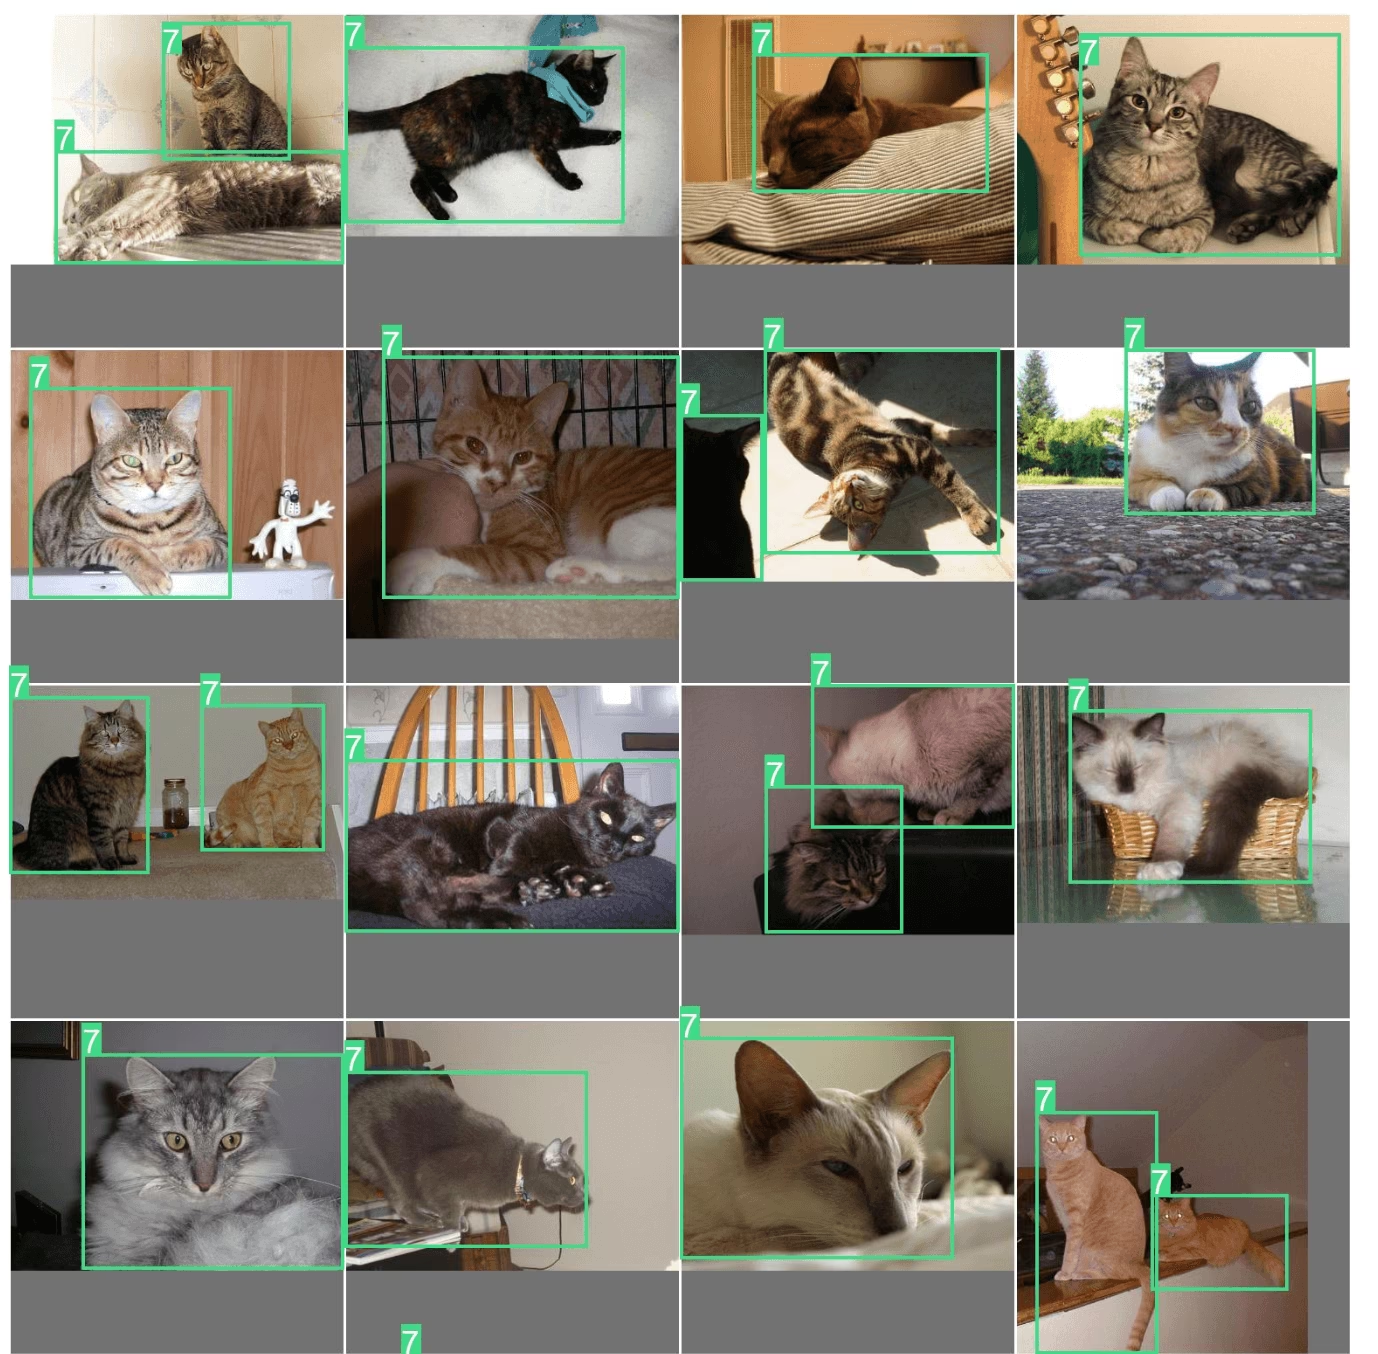
exp.plot_similar(idx=6500, limit=20)
exp.plot_similar(idx=[100, 101], limit=10)  # Can also pass list of idxs or imgs

exp.plot_similar(img="https://ultralytics.com/images/bus.jpg", limit=10, labels=False)  # Can also pass external images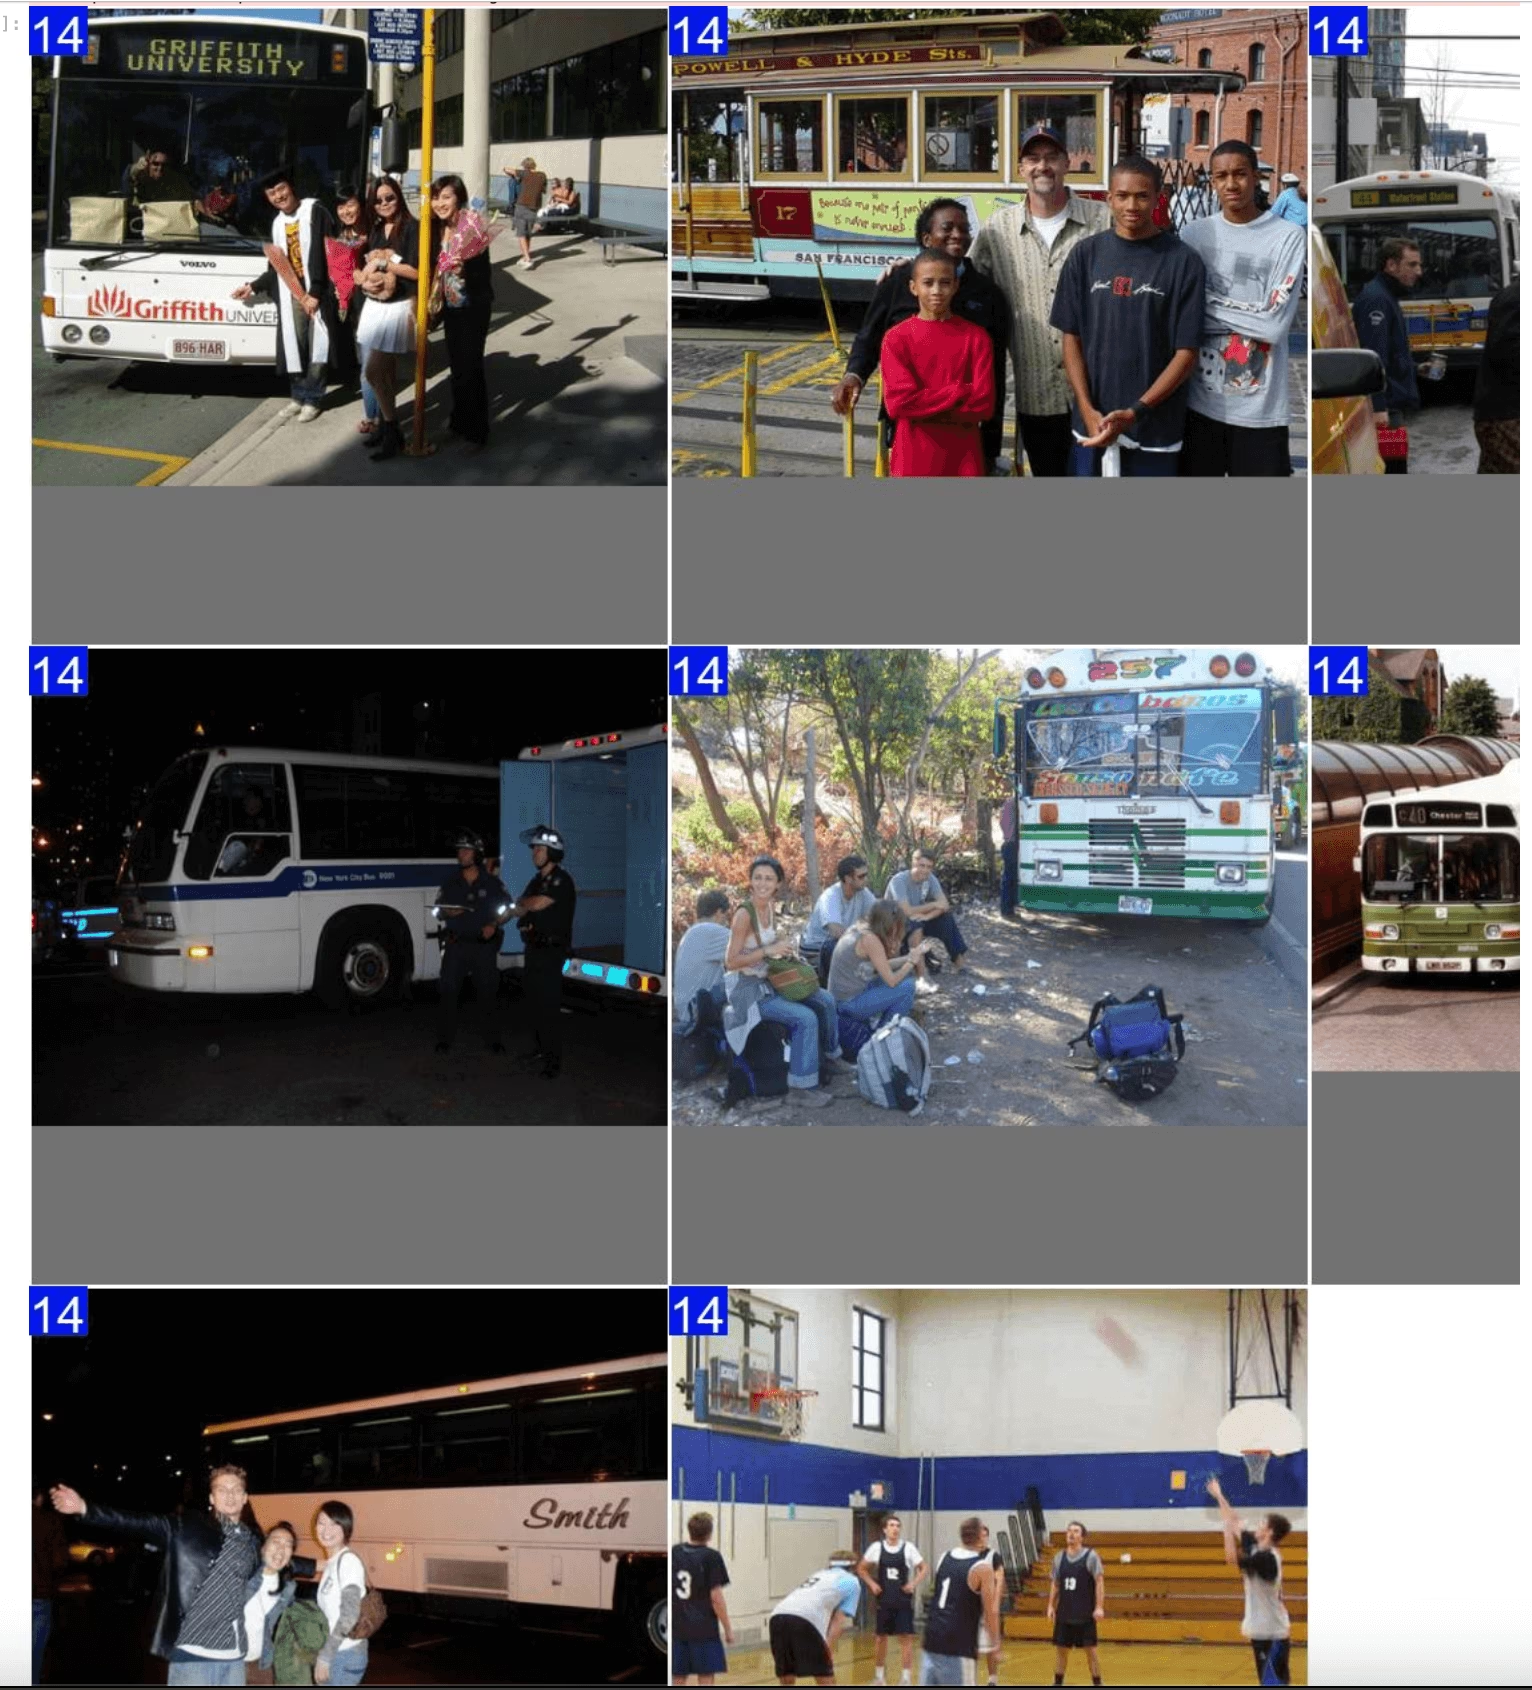
اسأل الذكاء الاصطناعي: البحث أو التصفية باستخدام اللغة الطبيعية#
يمكنك توجيه كائن Explorer بنوع نقاط البيانات التي تريد رؤيتها، وسيحاول إرجاع DataFrame بهذه النتائج. وبما أنه مدعوم بنماذج اللغة الكبيرة، فقد لا يصيب دائمًا. وفي هذه الحالة، سيُرجع None.
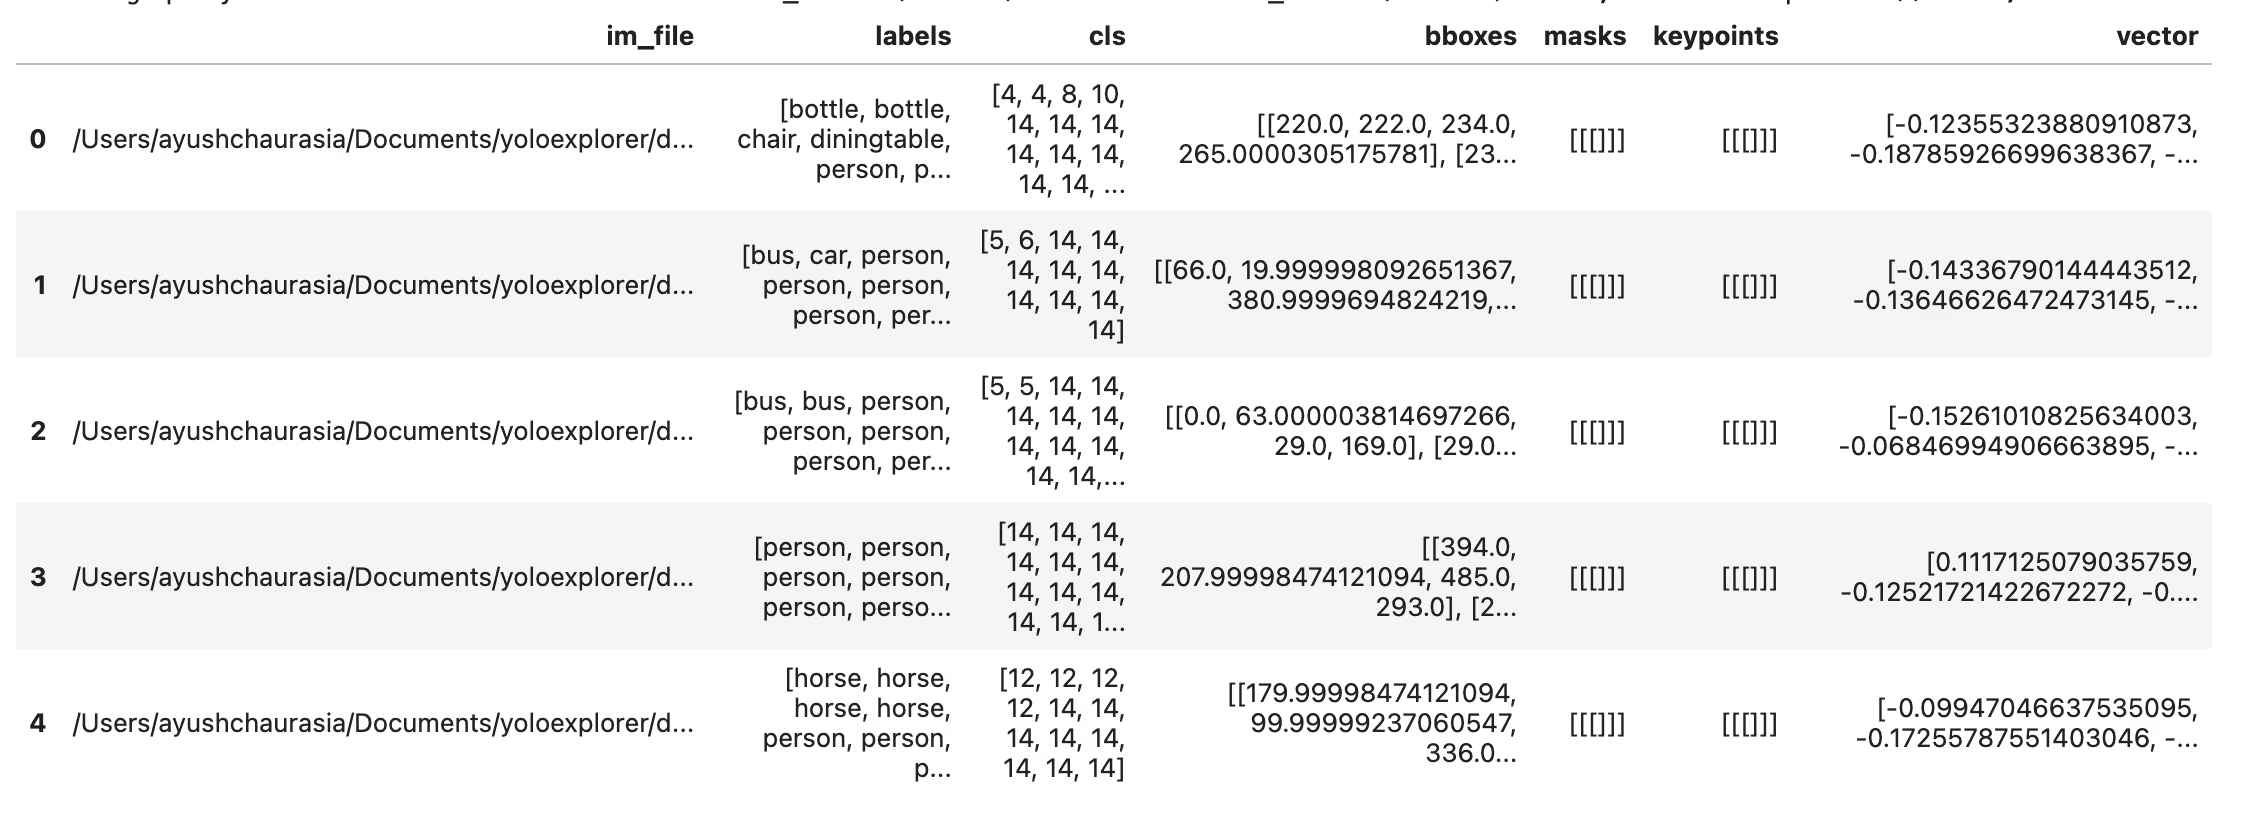
df = exp.ask_ai("show me images containing more than 10 objects with at least 2 persons")
df.head(5)
لرسم هذه النتائج، يمكنك استخدام الأداة plot_query_result. مثال:
plt = plot_query_result(exp.ask_ai("show me 10 images containing exactly 2 persons"))
Image.fromarray(plt)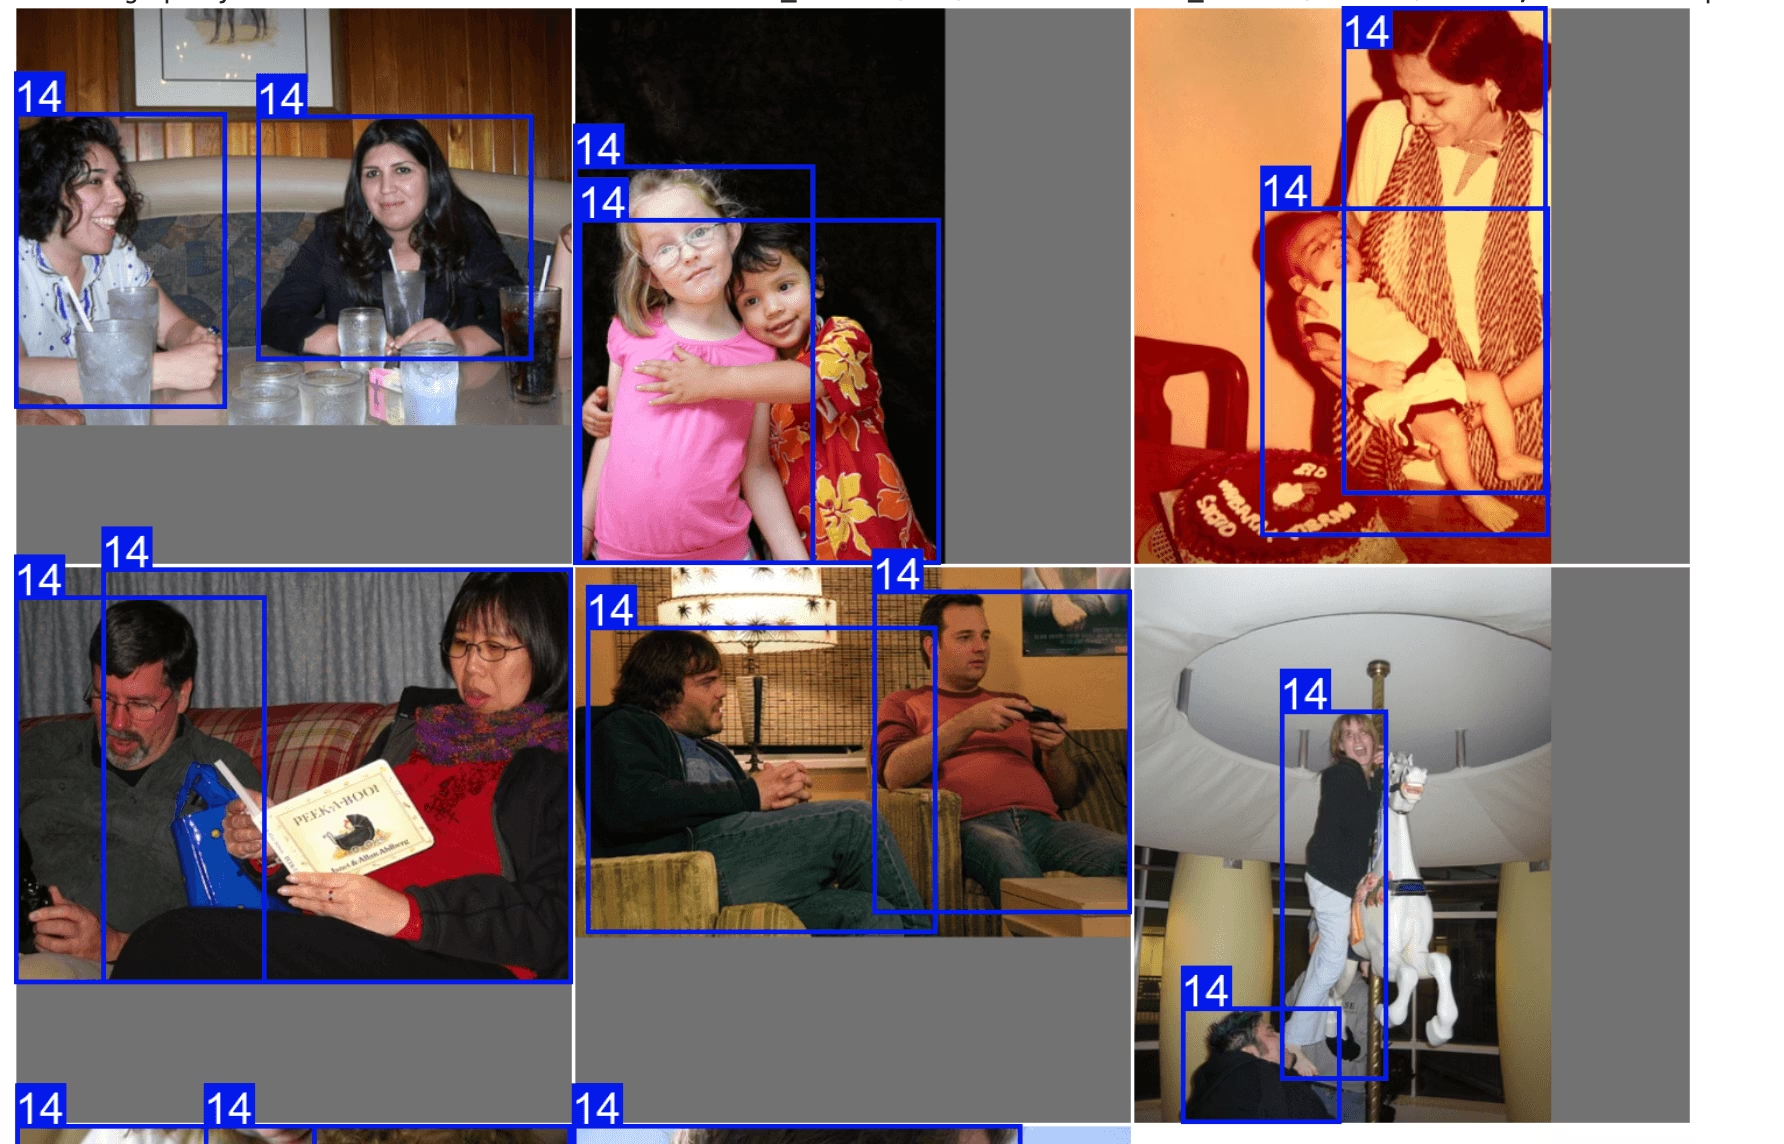
# plot
from PIL import Image
from ultralytics.data.explorer import plot_query_result

plt = plot_query_result(exp.ask_ai("show me 10 images containing exactly 2 persons"))
Image.fromarray(plt)
تشغيل استعلامات SQL على مجموعة بياناتك#
قد ترغب أحيانًا في فحص إدخالات معينة في مجموعة بياناتك. يتيح لك Explorer تنفيذ استعلامات SQL لهذا الغرض. وهو يقبل أيًا من التنسيقين التاليين:
- ستحدد الاستعلامات التي تبدأ بـ "WHERE" جميع الأعمدة تلقائيًا. ويمكن اعتبار ذلك اختصارًا للاستعلام.
- يمكنك أيضًا كتابة استعلامات كاملة تحدد فيها الأعمدة المطلوب تحديدها.
يمكن استخدام ذلك لفحص أداء النموذج ونقاط بيانات محددة. على سبيل المثال:
- لنفترض أن نموذجك يواجه صعوبة في الصور التي تحتوي على أشخاص وكلاب. يمكنك كتابة استعلام كهذا لتحديد النقاط التي تحتوي على شخصين على الأقل AND كلب واحد على الأقل.
يمكنك دمج استعلام SQL والبحث الدلالي لتصفية النتائج والوصول إلى أنواع محددة منها
table = exp.sql_query("WHERE labels LIKE '%person, person%' AND labels LIKE '%dog%' LIMIT 10")
exp.plot_sql_query("WHERE labels LIKE '%person, person%' AND labels LIKE '%dog%' LIMIT 10", labels=True)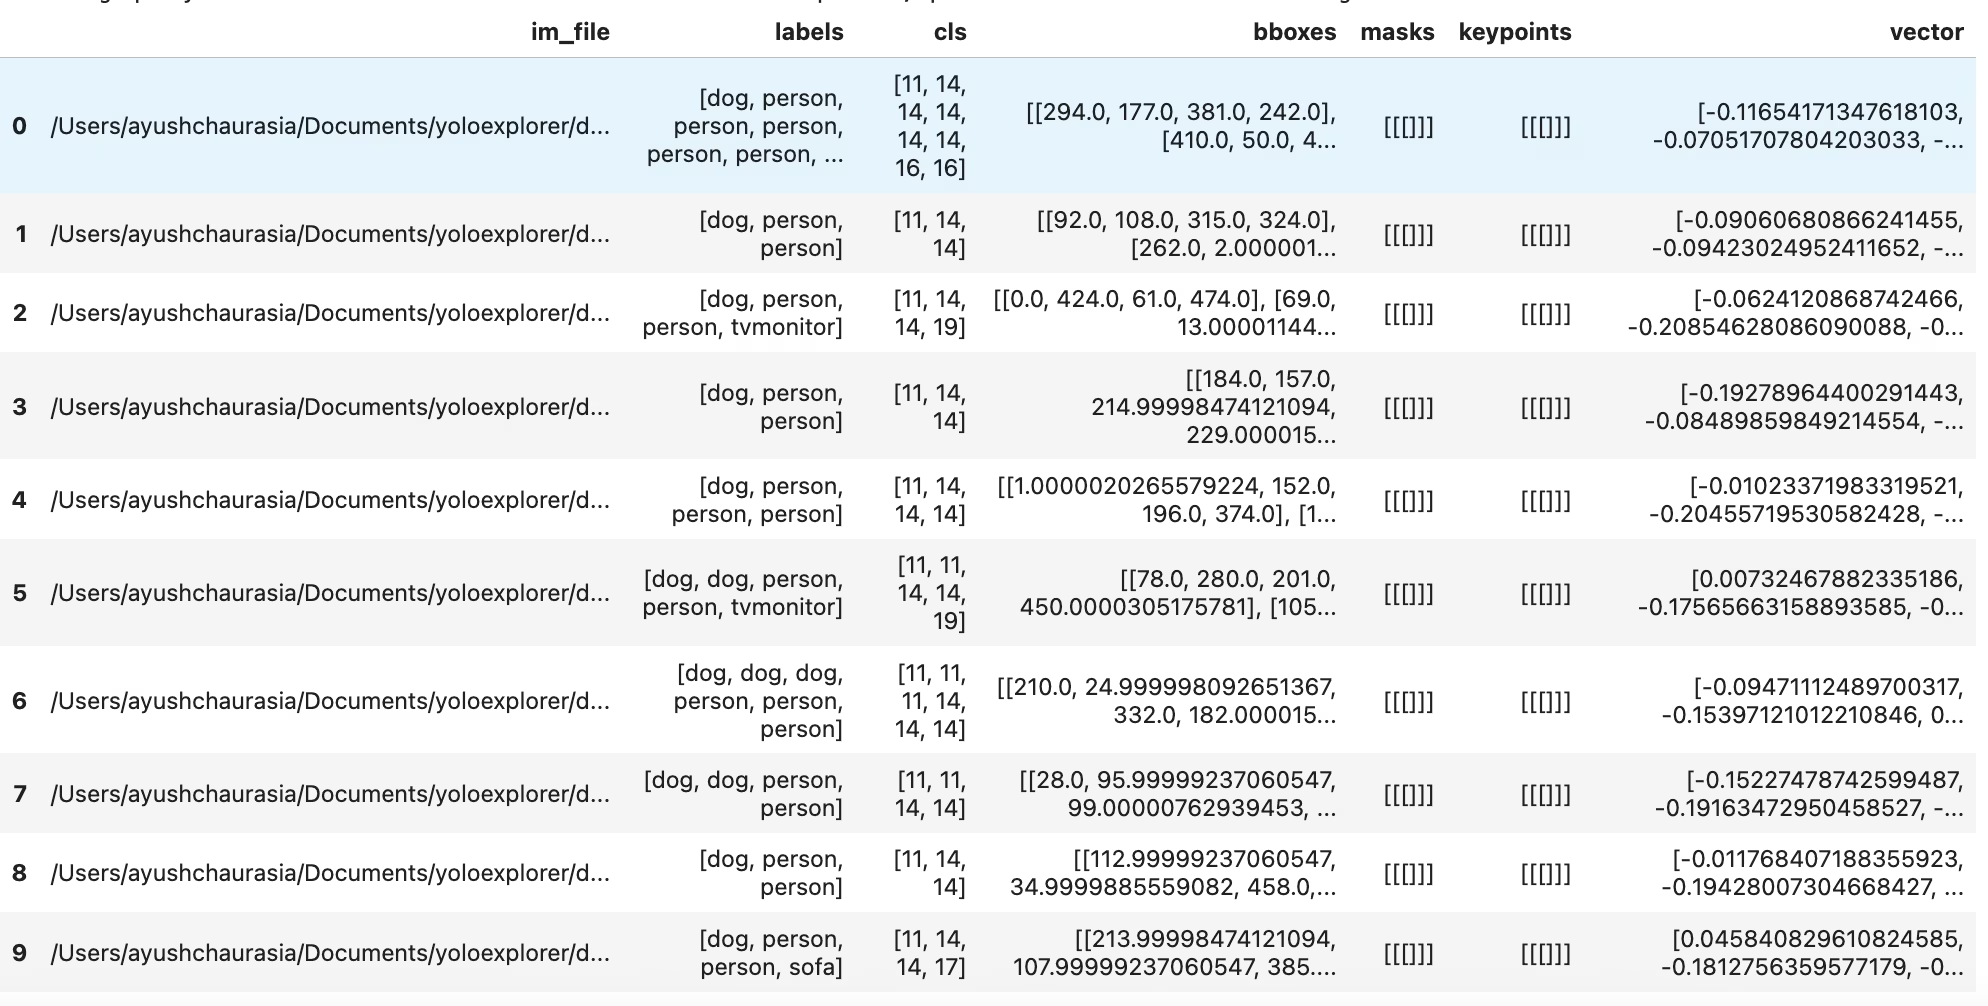
table = exp.sql_query("WHERE labels LIKE '%person, person%' AND labels LIKE '%dog%' LIMIT 10")
print(table)
وكما هو الحال في البحث عن التشابه، تحصل أيضًا على أداة لرسم استعلامات SQL مباشرةً باستخدام exp.plot_sql_query
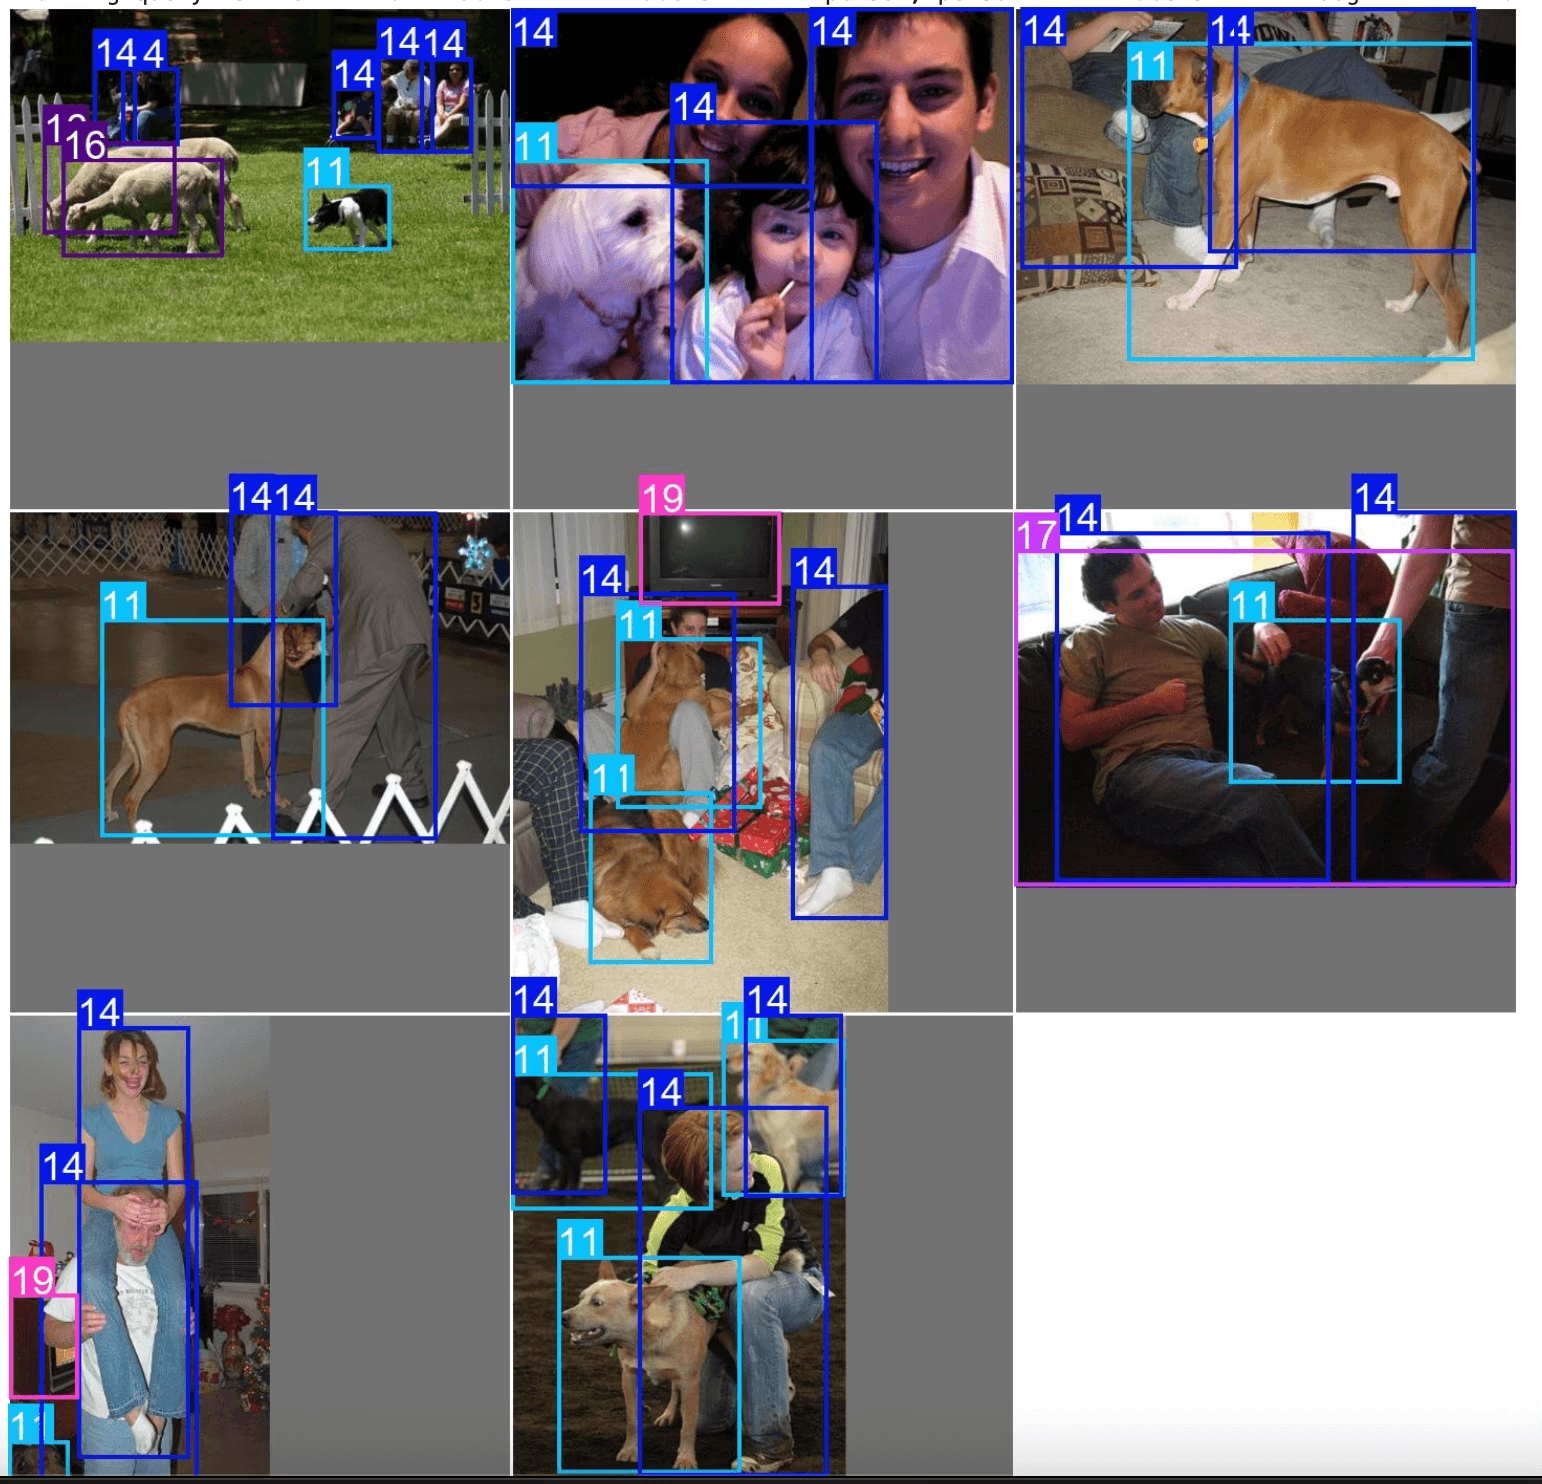
exp.plot_sql_query("WHERE labels LIKE '%person, person%' AND labels LIKE '%dog%' LIMIT 10", labels=True)العمل مع جدول التضمينات (متقدم)#
يعمل Explorer داخليًا على جداول LanceDB. يمكنك الوصول إلى هذا الجدول مباشرةً باستخدام كائن Explorer.table وتشغيل استعلامات أولية، ودفع عوامل التصفية السابقة واللاحقة إلى مصدر البيانات، وغير ذلك.
table = exp.table
print(table.schema)
تشغيل استعلامات خام#
يعثر البحث المتجهي على أقرب المتجهات من قاعدة البيانات. في نظام توصية أو محرك بحث، يمكنك العثور على منتجات مشابهة للمنتج الذي بحثت عنه. في نماذج اللغة الكبيرة وتطبيقات الذكاء الاصطناعي الأخرى، يمكن تمثيل كل نقطة بيانات بالتضمينات التي تنشئها بعض النماذج، وتُرجع الميزات الأكثر صلة.
يتمثل البحث في فضاء متجهي عالي الأبعاد في العثور على الجيران الأقرب K للمتجه المستعلم عنه (KNN).
المقياس في LanceDB، المقياس هو الطريقة المستخدمة لوصف المسافة بين زوج من المتجهات. يدعم حاليًا المقاييس التالية:
- L2
- جيب التمام
- النقطة
يستخدم بحث التشابه في Explorer مقياس L2 افتراضياً. يمكنك تشغيل الاستعلامات على الجداول مباشرةً، أو استخدام تنسيق lance بناء أدوات مخصصة لإدارة مجموعات البيانات. المزيد من التفاصيل حول عمليات جداول LanceDB المتاحة موجودة في LanceDB docs.
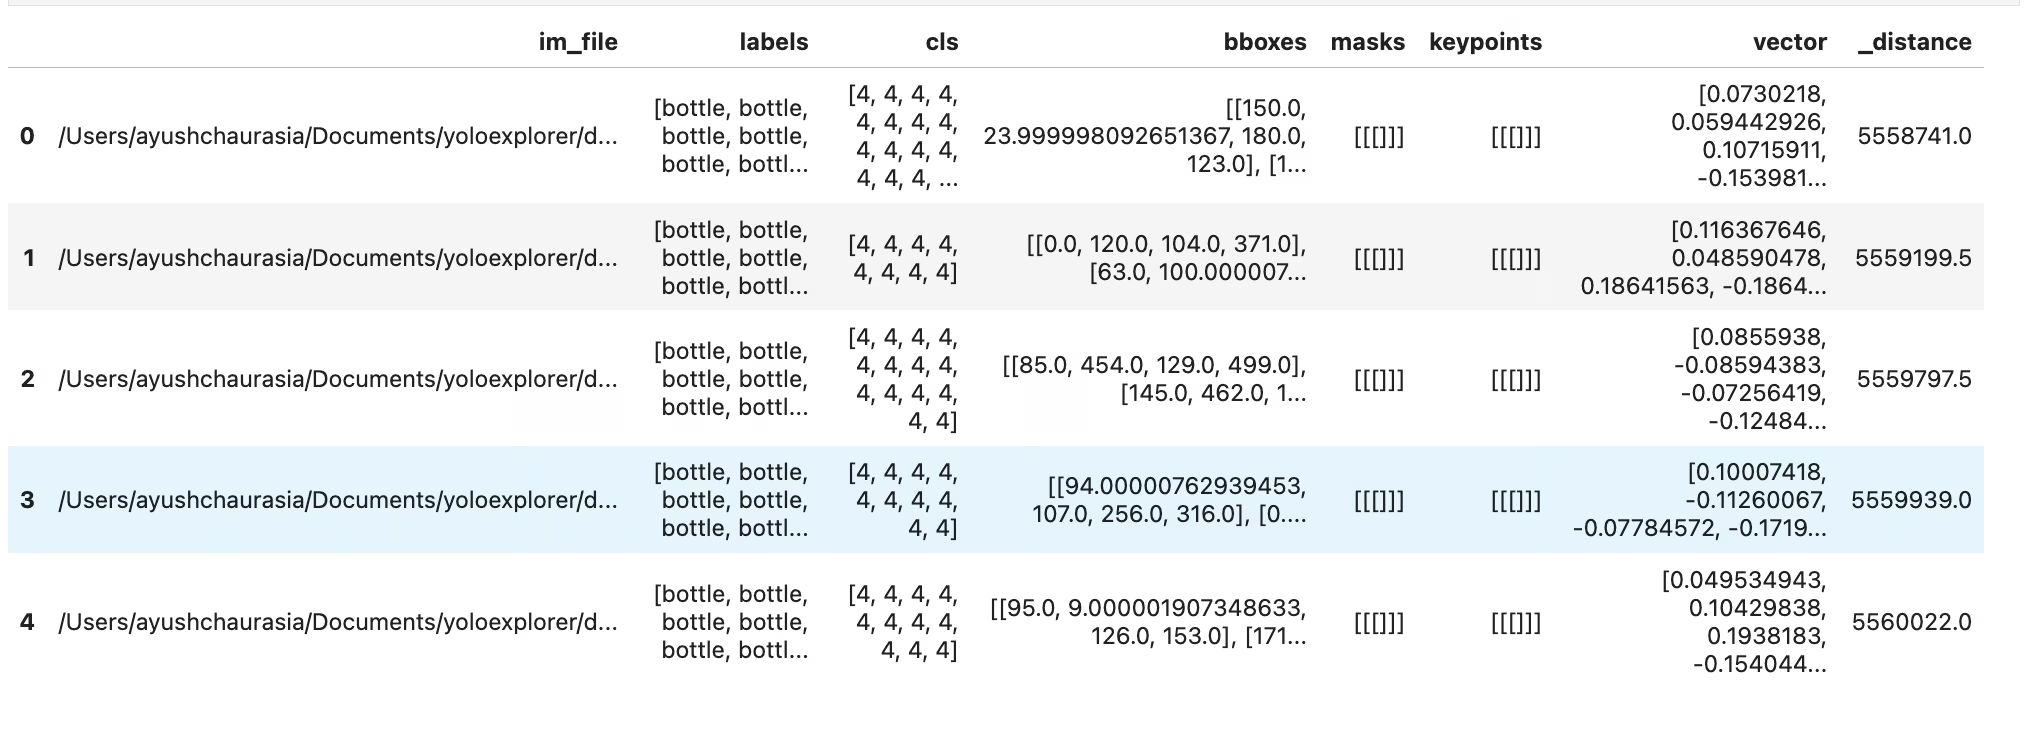
dummy_img_embedding = [i for i in range(256)]
table.search(dummy_img_embedding).limit(5).to_pandas()
التحويل المتبادل إلى تنسيقات البيانات الشائعة#
df = table.to_pandas()
pa_table = table.to_arrow()
العمل مع التضمينات#
يمكنك الوصول إلى التضمين الأولي من جدول lancedb وتحليله. تُخزَّن تضمينات الصور في العمود vector
import numpy as np

embeddings = table.to_pandas()["vector"].tolist()
embeddings = np.array(embeddings)
المخطط المبعثر#
تتمثل إحدى الخطوات الأولية في تحليل التضمينات في رسمها في فضاء ثنائي الأبعاد باستخدام تقليل الأبعاد. لنجرب مثالًا
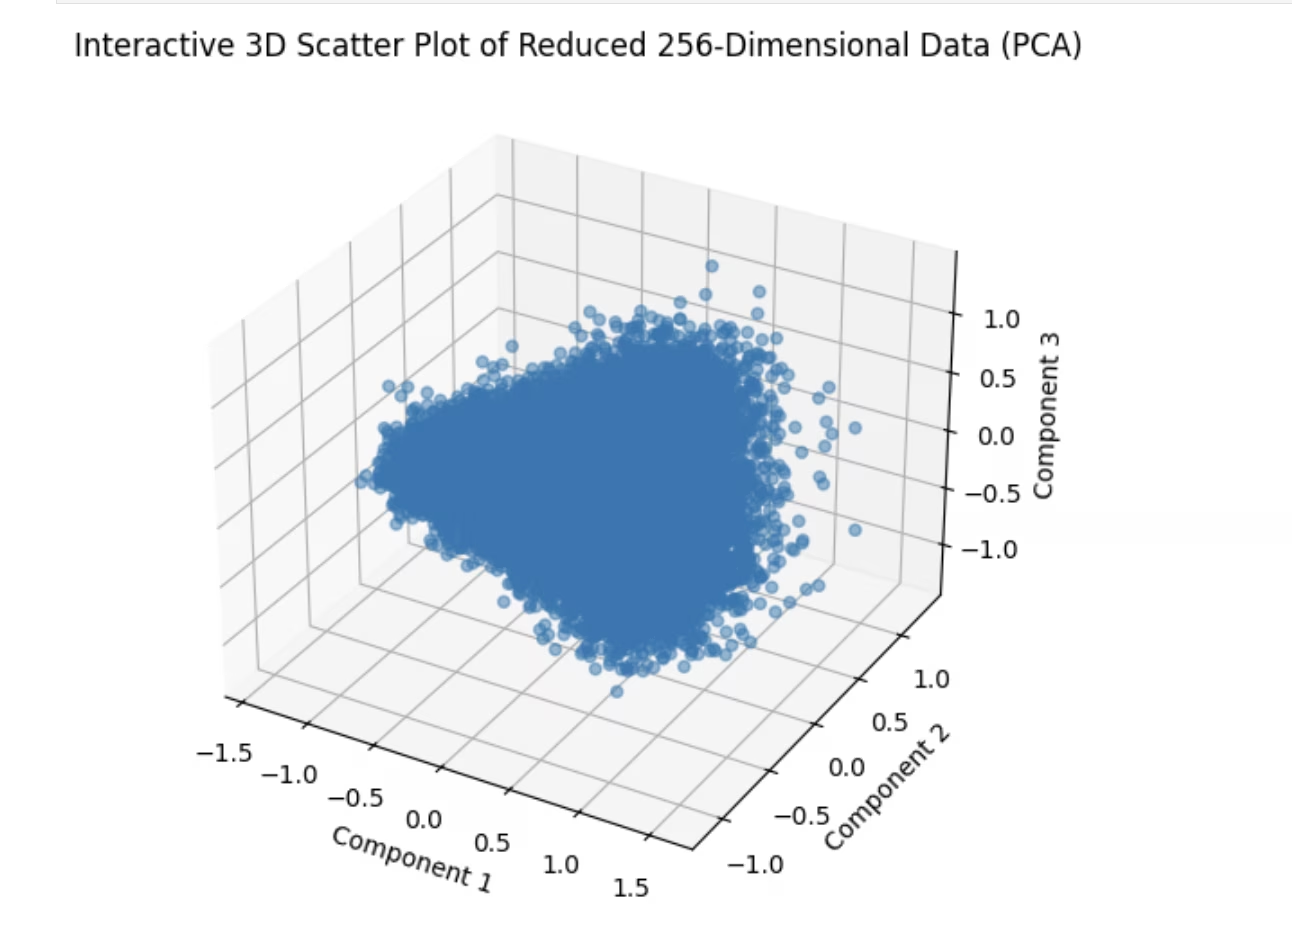
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA  # pip install scikit-learn

# Reduce dimensions using PCA to 3 components for visualization in 3D
pca = PCA(n_components=3)
reduced_data = pca.fit_transform(embeddings)

# Create a 3D scatter plot using Matplotlib's Axes3D
fig = plt.figure(figsize=(8, 6))
ax = fig.add_subplot(111, projection="3d")

# Scatter plot
ax.scatter(reduced_data[:, 0], reduced_data[:, 1], reduced_data[:, 2], alpha=0.5)
ax.set_title("3D Scatter Plot of Reduced 256-Dimensional Data (PCA)")
ax.set_xlabel("Component 1")
ax.set_ylabel("Component 2")
ax.set_zlabel("Component 3")

plt.show()
فهرس التشابه#
إليك مثالًا بسيطًا على عملية مدعومة بجدول التضمينات. يأتي Explorer مزودًا بعملية similarity_index-
- تحاول تقدير مدى تشابه كل نقطة بيانات مع بقية مجموعة البيانات.
- تقوم بذلك عبر عدّ عدد تضمينات الصور الأقرب من الصورة الحالية من max_dist في فضاء التضمين المُنشأ، مع مراعاة top_k من الصور المتشابهة في كل مرة.
بالنسبة إلى مجموعة بيانات ونموذج وmax_dist وtop_k محددة، سيُعاد استخدام فهرس التشابه بعد إنشائه. إذا تغيّرت مجموعة بياناتك، أو كنت تحتاج ببساطة إلى إعادة إنشاء فهرس التشابه، فيمكنك تمرير force=True. وكما هو الحال في البحث المتجهي وبحث SQL، تأتي هذه العملية أيضًا مع أداة لرسمها مباشرةً.
sim_idx = exp.similarity_index(max_dist=0.2, top_k=0.01)
exp.plot_similarity_index(max_dist=0.2, top_k=0.01)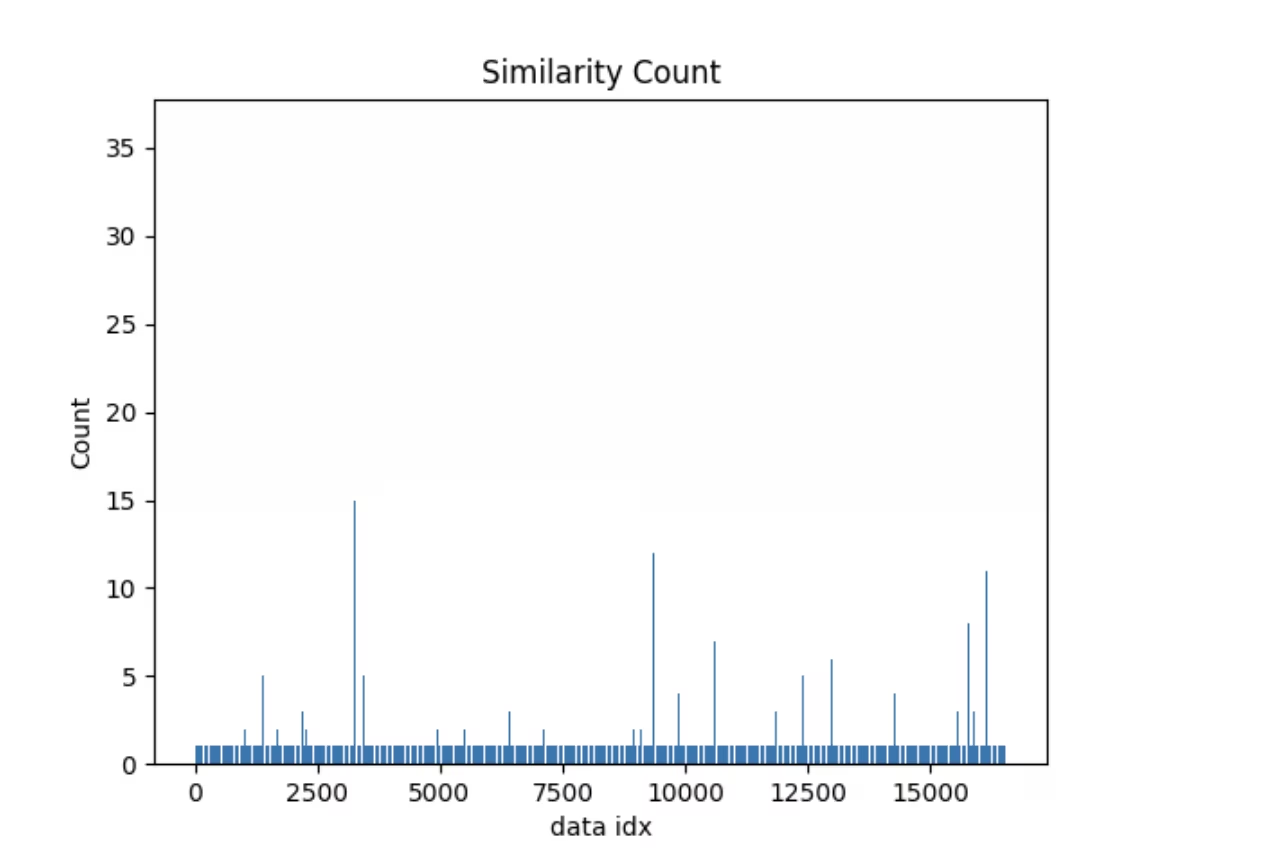
لنلقِ نظرة أولًا على المخطط
exp.plot_similarity_index(max_dist=0.2, top_k=0.01)لنلقِ الآن نظرة على ناتج العملية
sim_idx = exp.similarity_index(max_dist=0.2, top_k=0.01, force=False)

sim_idx
لننشئ استعلامًا لمعرفة نقاط البيانات التي يزيد عدد تشابهها على 30، ولرسم الصور المشابهة لها.
import numpy as np

sim_count = np.array(sim_idx["count"])
sim_idx["im_file"][sim_count > 30]
من المفترض أن ترى شيئًا شبيهًا بهذا
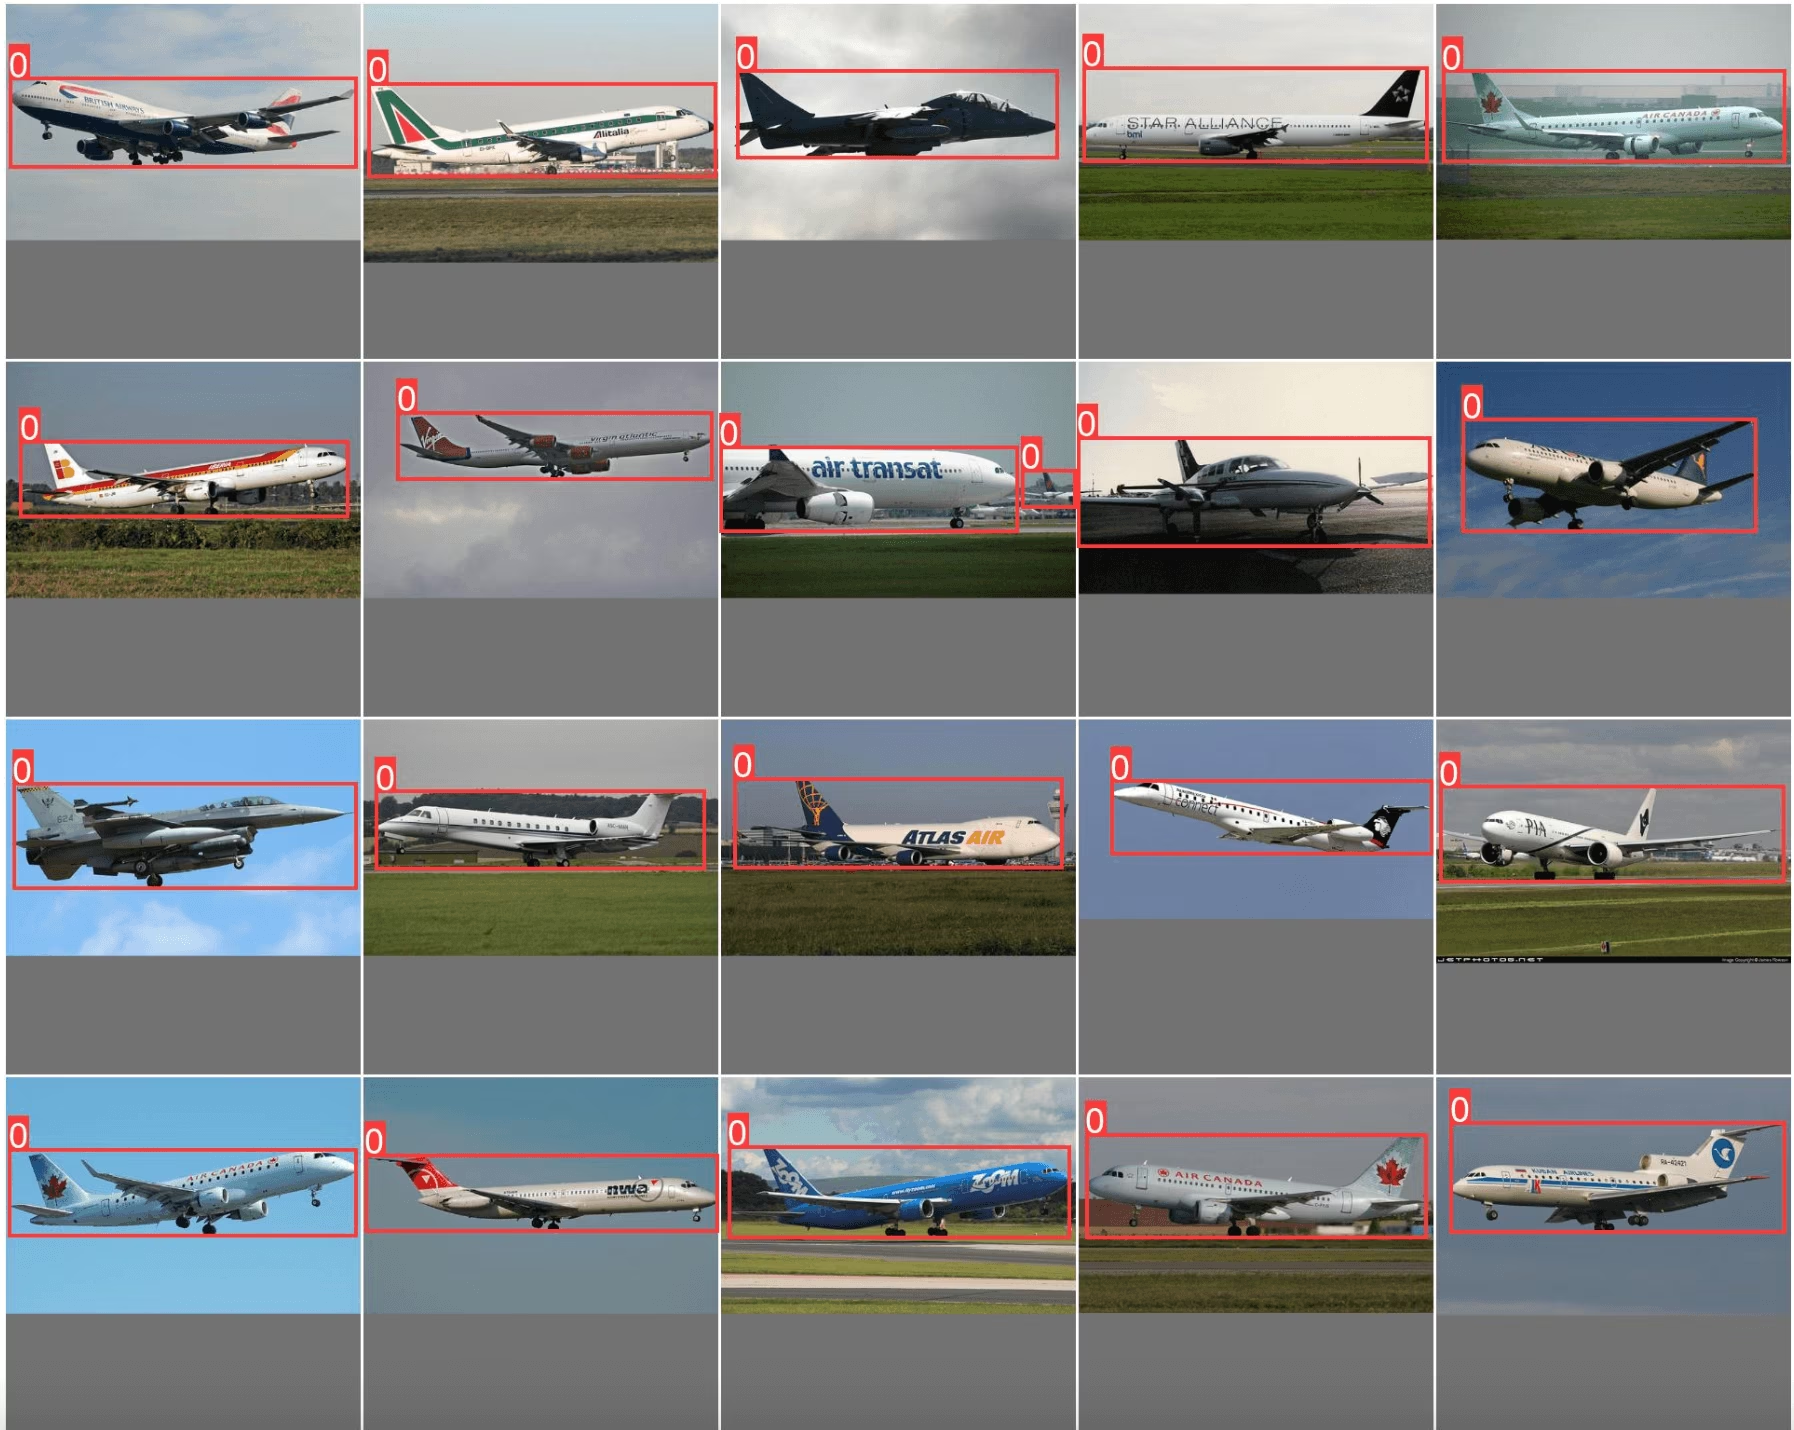
exp.plot_similar(idx=[7146, 14035]) # Using avg embeddings of 2 imagesالأسئلة الشائعة#
تمت إزالة Explorer من حزمة
ultralyticsفي الإصدار 8.3.12. لتشغيل الأمثلة في هذه الصفحة، قم بتثبيت الإصدار الأخير الذي يتضمنه باستخدامpip install "ultralytics[explorer]==8.3.11". يتم تضمين استكشاف مجموعات البيانات المكافئ والموسع داخل Ultralytics Platform.بعد إنشاء جدول تضمينات مرة واحدة باستخدام
create_embeddings_table()، يمكنك العثور على صور متشابهة بصرياً حسب الفهرس أو حسب صورة خارجية، وتصفية مجموعة البيانات باستخدام جمل SQLWHERE، وطرح أسئلة بلغة طبيعية باستخدامask_ai()، وحساب similarity index لاكتشاف الصور المتطابقة تقريباً.يحفظ Explorer التضمينات في جدول LanceDB على القرص، لذلك يتم إنشاؤه مرة واحدة لكل زوج من مجموعة البيانات والنموذج وإعادة استخدامه عبر الجلسات. يمكنك الوصول إليه مباشرة من خلال
exp.tableلاستعلامات المتجهات الخام، والمرشحات القبلية والبعدية، والتصدير إلى pandas أو Arrow.