Esempio di esplorazione VOC
A partire da ultralytics>=8.3.12, Ultralytics Explorer è stato rimosso. Per usare Explorer, installa pip install ultralytics==8.3.11. Funzionalità simili (e ampliate) per esplorare i dataset sono disponibili su Ultralytics Platform.
Questo esempio illustra l'Explorer API sul dataset VOC: creazione di una tabella di embedding, esecuzione di ricerche semantiche e SQL e invio di domande in linguaggio naturale. Gli stessi passaggi alimentano l'interfaccia grafica yolo explorer.
Configurazione#
Installa la versione bloccata ultralytics con gli extra di Explorer, quindi verifica software e hardware.
pip install "ultralytics[explorer]==8.3.11" openai
yolo checks
Ricerca di similarità#
Usa la ricerca per similarità vettoriale per trovare punti dati simili nel dataset e la relativa distanza nello spazio degli embedding. Per prima cosa crea una tabella degli embedding per la coppia dataset-modello; viene creata una sola volta e riutilizzata automaticamente.
from ultralytics import Explorer

exp = Explorer("VOC.yaml", model="yolo11n.pt")
exp.create_embeddings_table()
Una volta creata la tabella di embedding, puoi eseguire la ricerca semantica in uno dei seguenti modi:
- Su un indice o un elenco di indici specifici del dataset, ad esempio
exp.get_similar(idx=[1, 10], limit=10) - Su qualsiasi immagine o elenco di immagini non presente nel dataset, ad esempio
exp.get_similar(img=["path/to/img1", "path/to/img2"], limit=10). Se sono presenti più input, viene usato l'insieme dei relativi embedding.
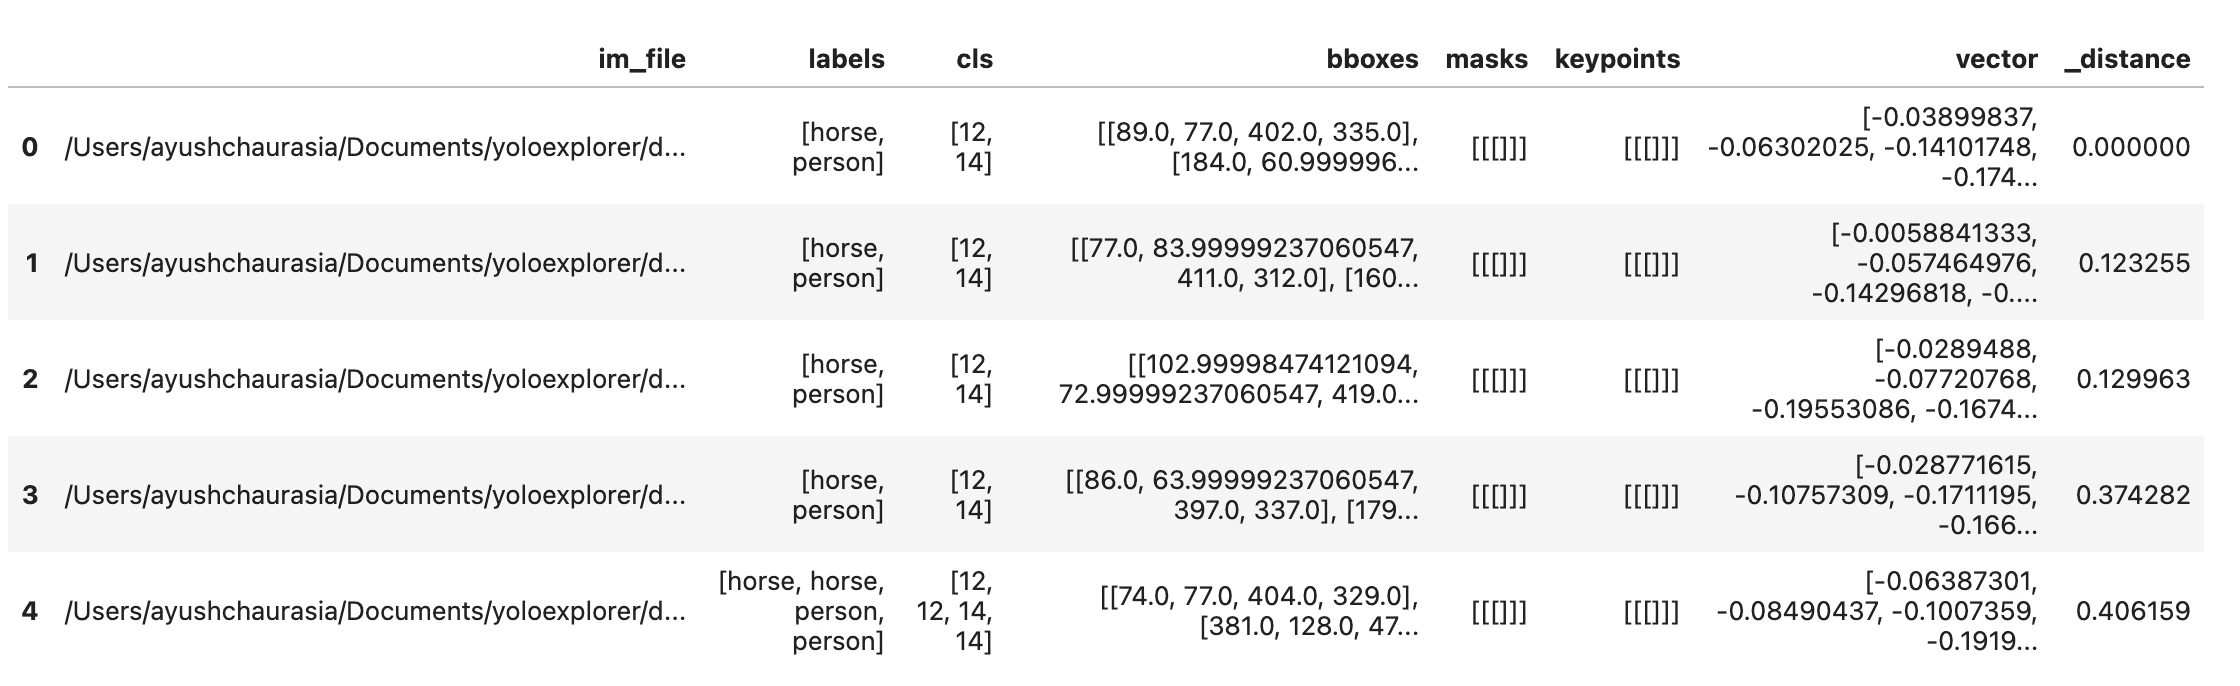
Otterrai un DataFrame pandas con i limit punti dati più simili all'input e la relativa distanza nello spazio degli embedding. Puoi usare questo dataset per applicare altri filtri.
# Cerca nel dataset per indice
similar = exp.get_similar(idx=1, limit=10)
similar.head()
Puoi anche tracciare direttamente i campioni simili usando l'utilità plot_similar:
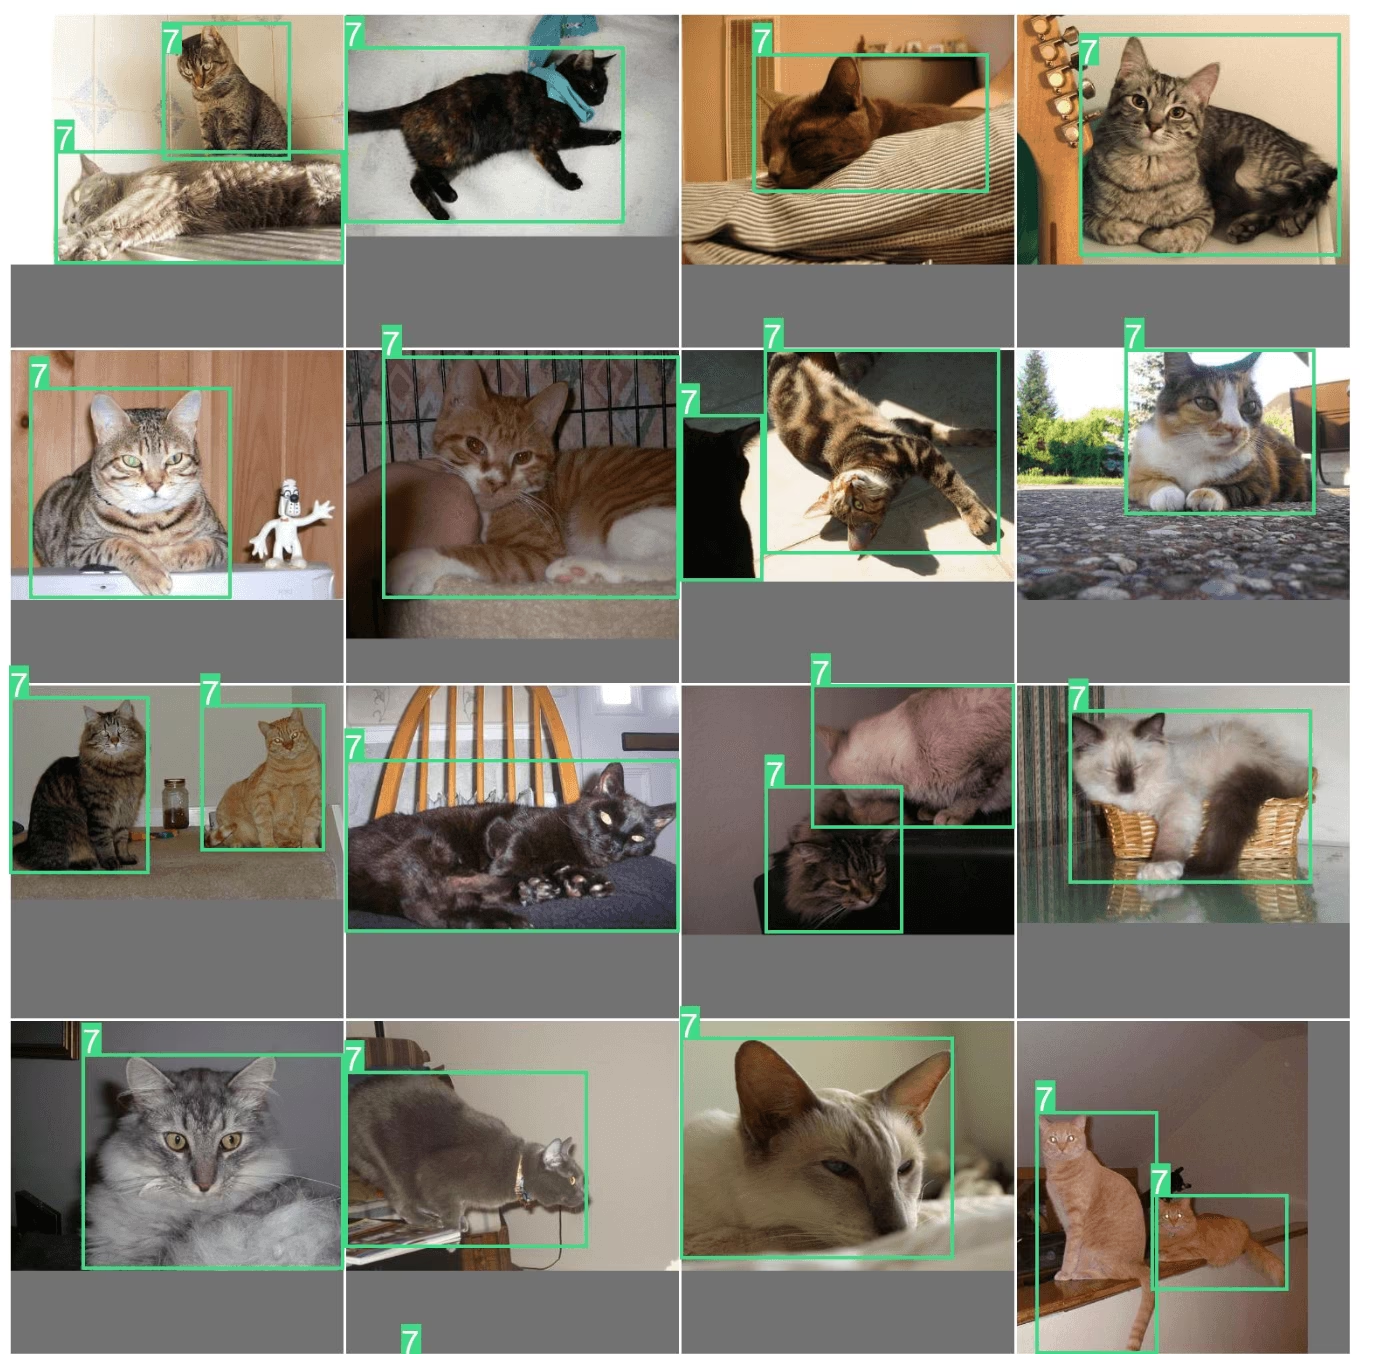
exp.plot_similar(idx=6500, limit=20)
exp.plot_similar(idx=[100, 101], limit=10)  # Puoi anche passare un elenco di indici o immagini

exp.plot_similar(img="https://ultralytics.com/images/bus.jpg", limit=10, labels=False)  # Puoi anche passare immagini esterne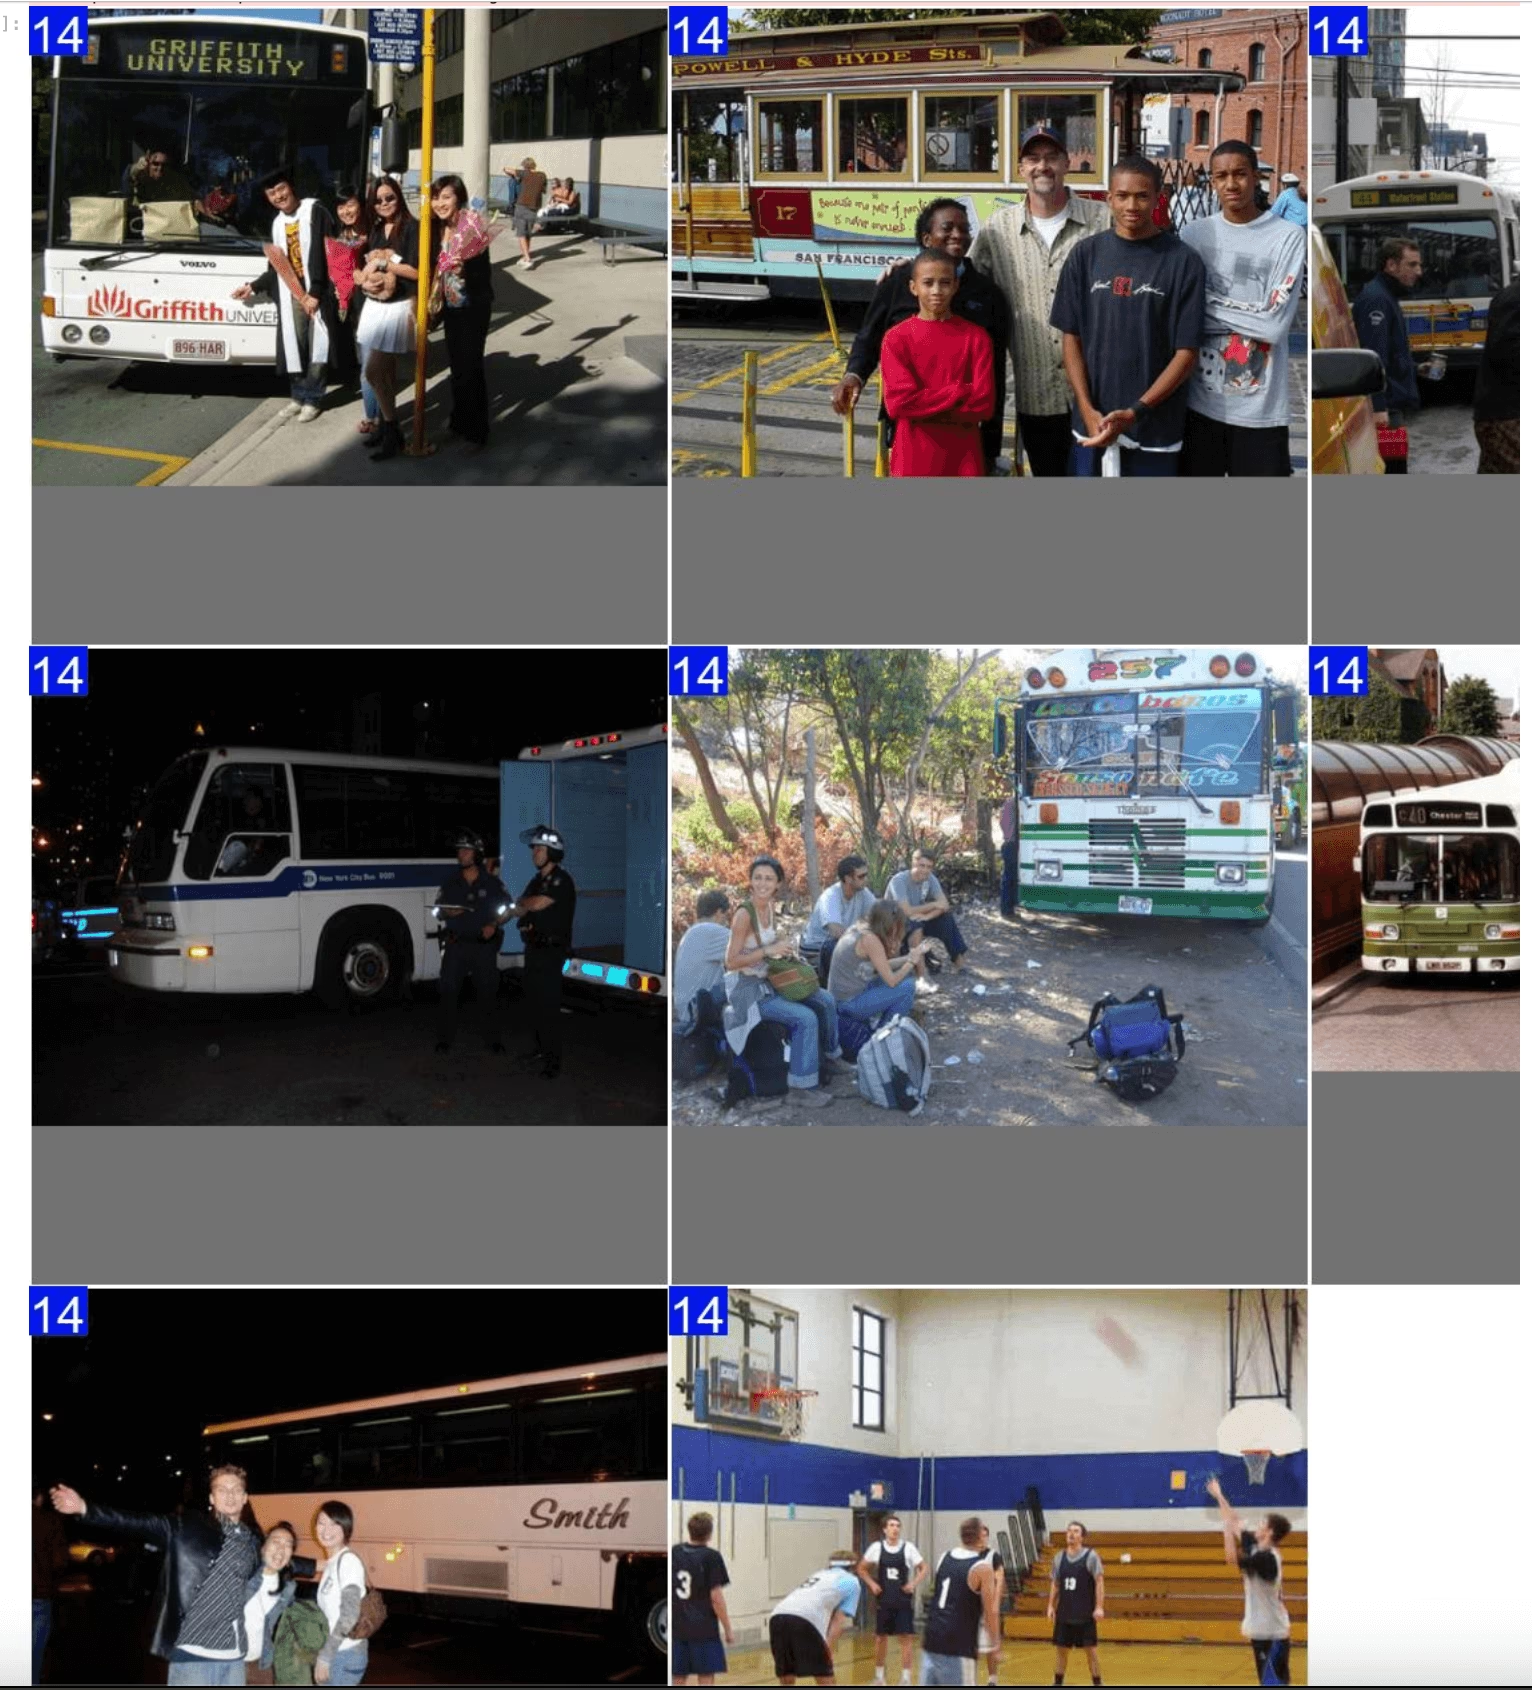
Ask AI: cerca o filtra usando il linguaggio naturale#
Puoi indicare all'oggetto Explorer il tipo di punti dati che vuoi visualizzare e questo proverà a restituire un DataFrame con i risultati. Poiché si basa su LLM, non sempre fornisce risultati corretti. In tal caso, restituirà None.
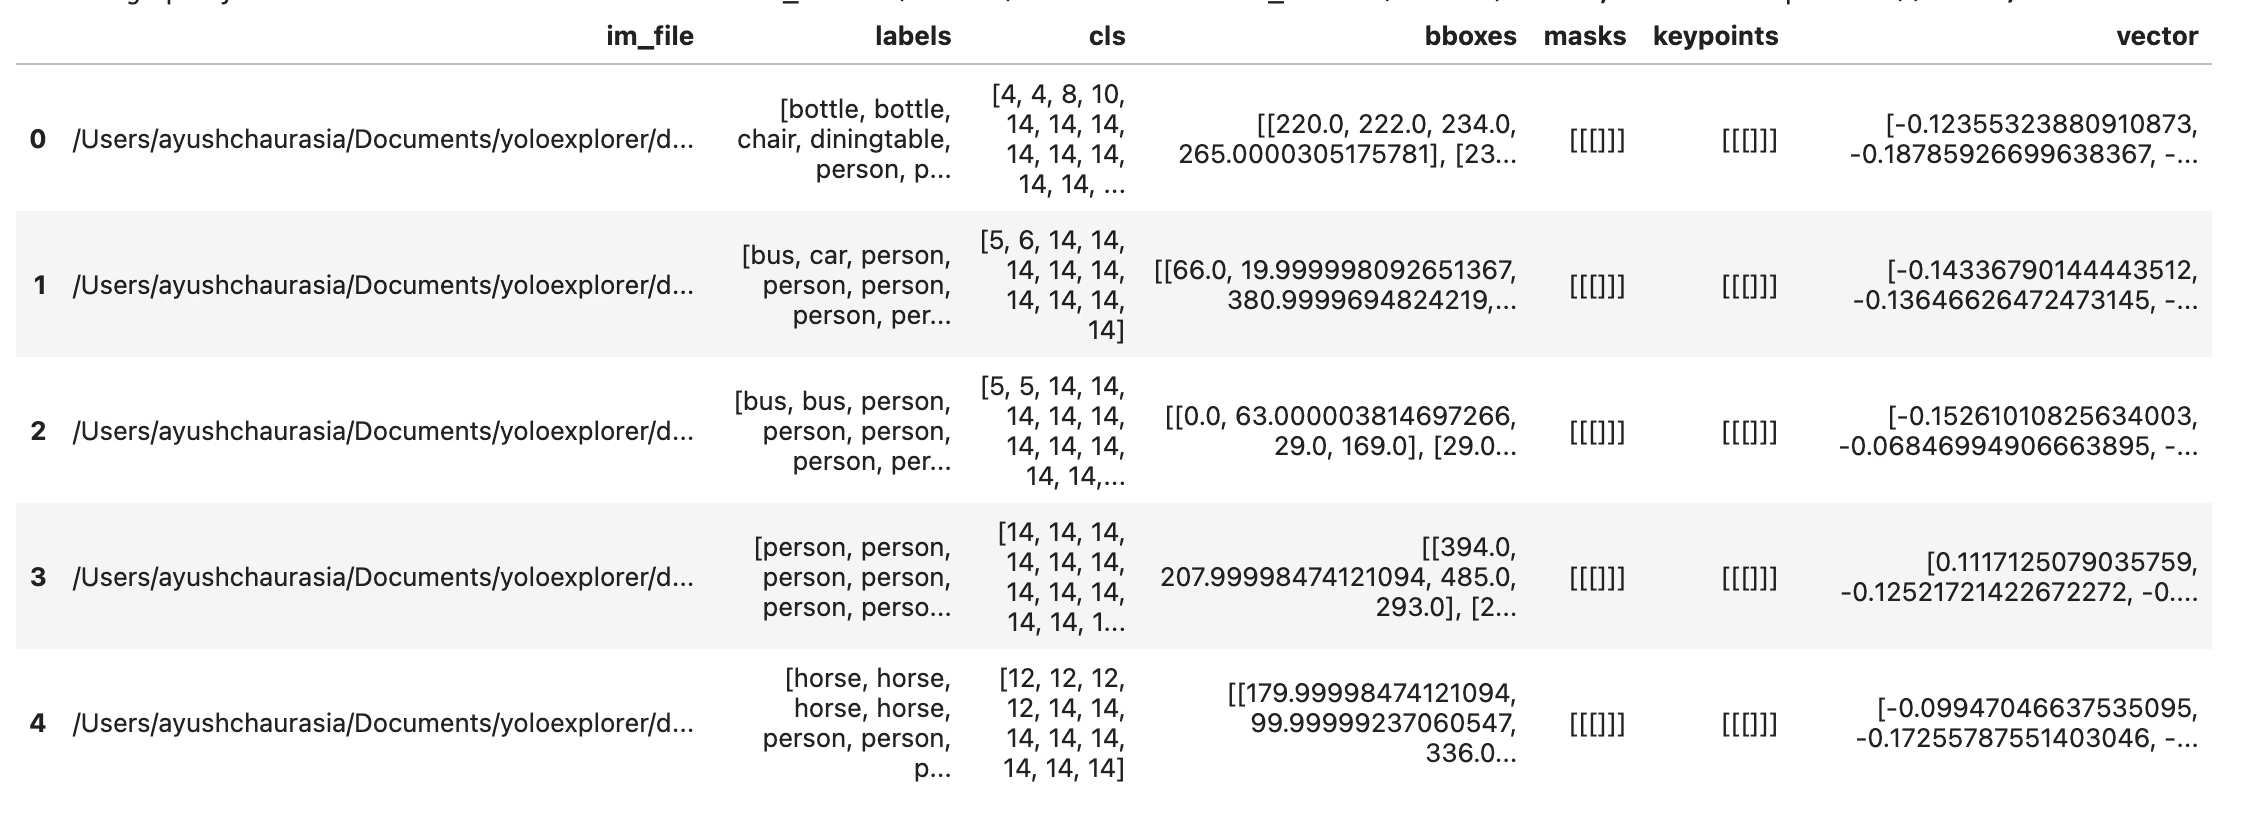
df = exp.ask_ai("show me images containing more than 10 objects with at least 2 persons")
df.head(5)
Per tracciare questi risultati, puoi usare l'utilità plot_query_result:
# plot
from PIL import Image
from ultralytics.data.explorer import plot_query_result

plt = plot_query_result(exp.ask_ai("show me 10 images containing exactly 2 persons"))
Image.fromarray(plt)
Esegui query SQL sul tuo dataset#
A volte potresti voler esaminare determinate voci del dataset. A questo scopo, Explorer ti consente di eseguire query SQL. Accetta i seguenti formati:
- Le query che iniziano con "WHERE" selezionano automaticamente tutte le colonne. Puoi considerarle query abbreviate.
- Puoi anche scrivere query complete specificando le colonne da selezionare.
Puoi usare questa funzionalità per esaminare le prestazioni del modello e punti dati specifici. Ad esempio:
- Se il tuo modello ha difficoltà con le immagini che contengono persone e cani, puoi scrivere una query come quella seguente per selezionare i punti che contengono almeno 2 persone E almeno un cane.
Puoi combinare query SQL e ricerca semantica per filtrare i risultati e individuare tipi specifici.
table = exp.sql_query("WHERE labels LIKE '%person, person%' AND labels LIKE '%dog%' LIMIT 10")
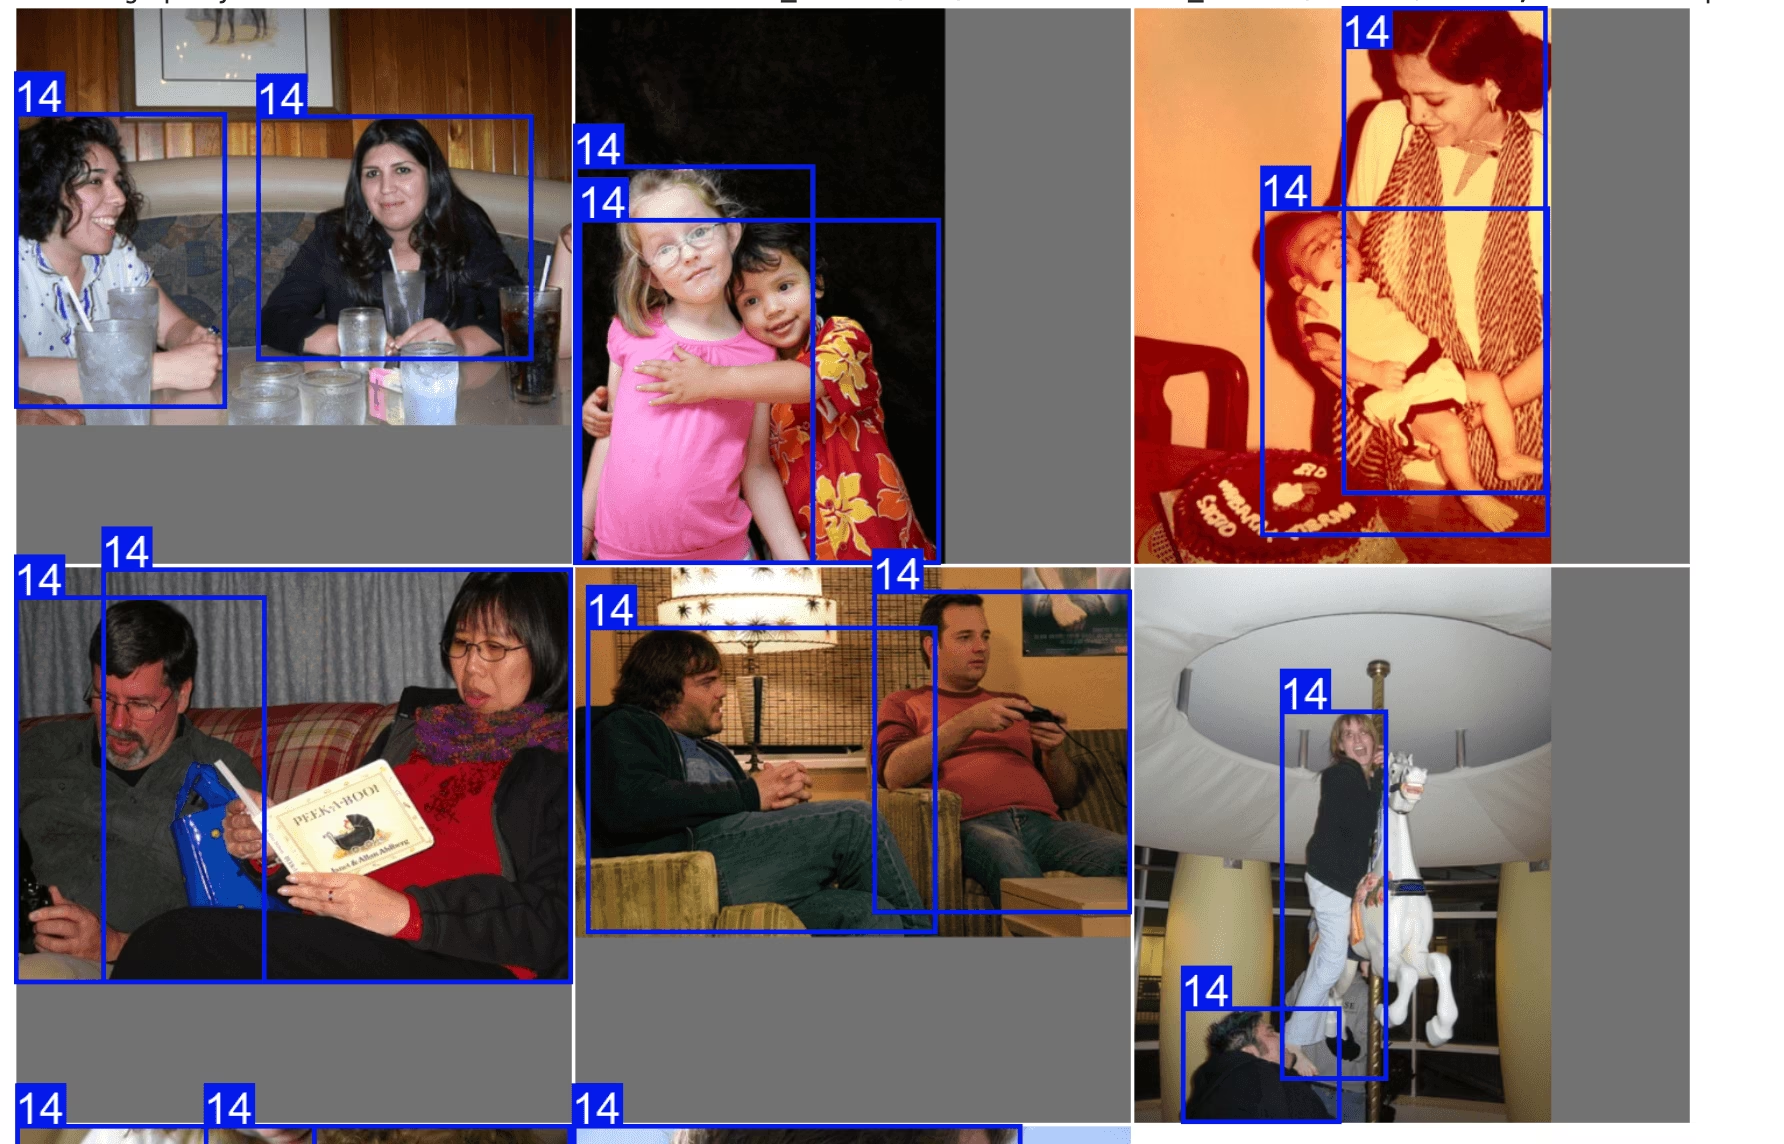
exp.plot_sql_query("WHERE labels LIKE '%person, person%' AND labels LIKE '%dog%' LIMIT 10", labels=True)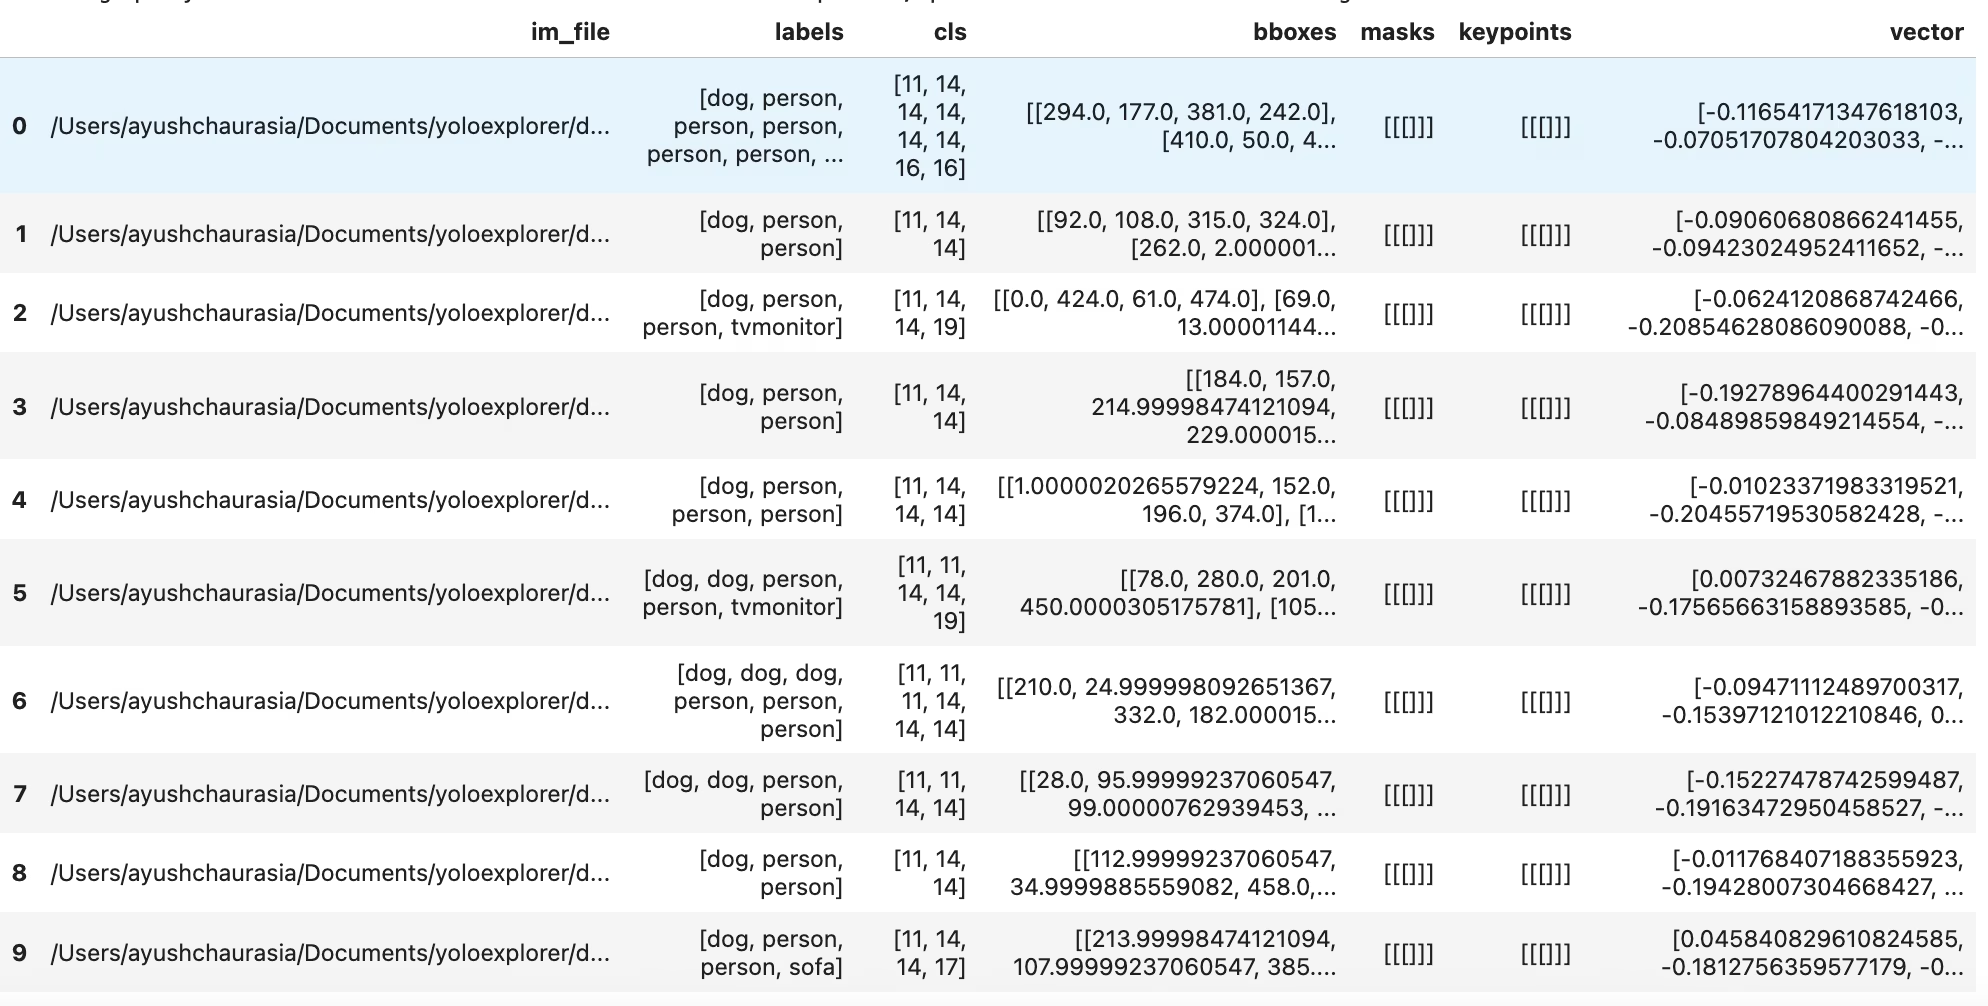
table = exp.sql_query("WHERE labels LIKE '%person, person%' AND labels LIKE '%dog%' LIMIT 10")
print(table)
Come per la ricerca per similarità, puoi rappresentare direttamente i risultati delle query SQL con exp.plot_sql_query:
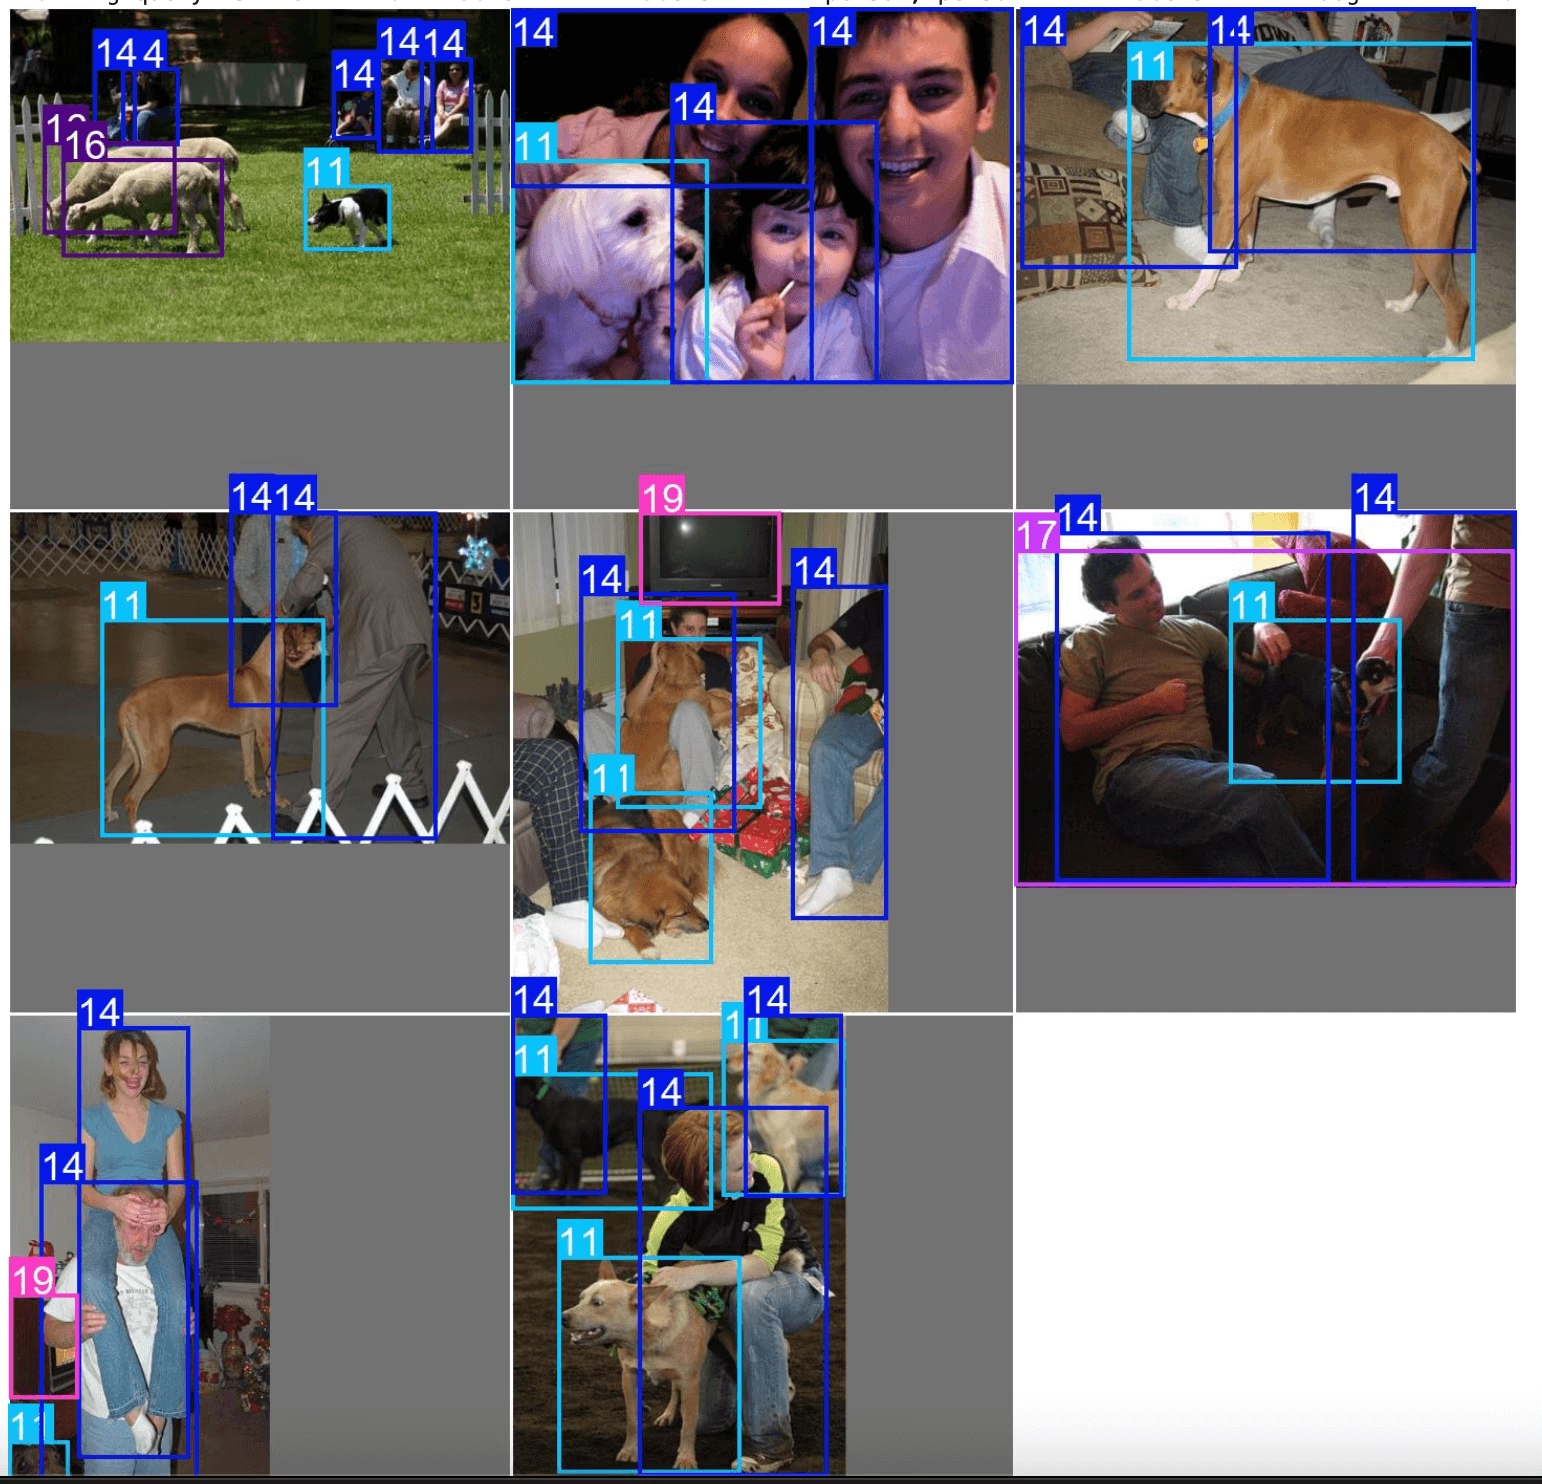
exp.plot_sql_query("WHERE labels LIKE '%person, person%' AND labels LIKE '%dog%' LIMIT 10", labels=True)Uso della tabella degli embedding (avanzato)#
Explorer usa internamente le tabelle LanceDB. Puoi accedere direttamente a questa tabella usando l'oggetto Explorer.table ed eseguire query dirette, applicare filtri preliminari e successivi e altro ancora.
table = exp.table
print(table.schema)
Esegui query grezze#
La ricerca vettoriale trova i vettori più vicini nel database. In un sistema di raccomandazione o in un motore di ricerca, individua prodotti simili a quello cercato. Nelle applicazioni LLM e in altre applicazioni di IA, ogni punto dati può essere rappresentato da embedding generati da un modello e la ricerca vettoriale restituisce quelli più pertinenti.
Una ricerca in uno spazio vettoriale ad alta dimensionalità trova i k vicini più prossimi (KNN) del vettore di query.
In LanceDB, una metrica descrive la distanza tra una coppia di vettori. Attualmente sono supportate le seguenti metriche:
- L2
- Coseno
- Prodotto scalare
La ricerca per similarità di Explorer usa L2 per impostazione predefinita. Puoi eseguire query direttamente sulle tabelle oppure usare il formato lance per creare utility personalizzate per gestire i dataset. Per maggiori dettagli sulle operazioni disponibili sulle tabelle LanceDB, consulta la documentazione di LanceDB.
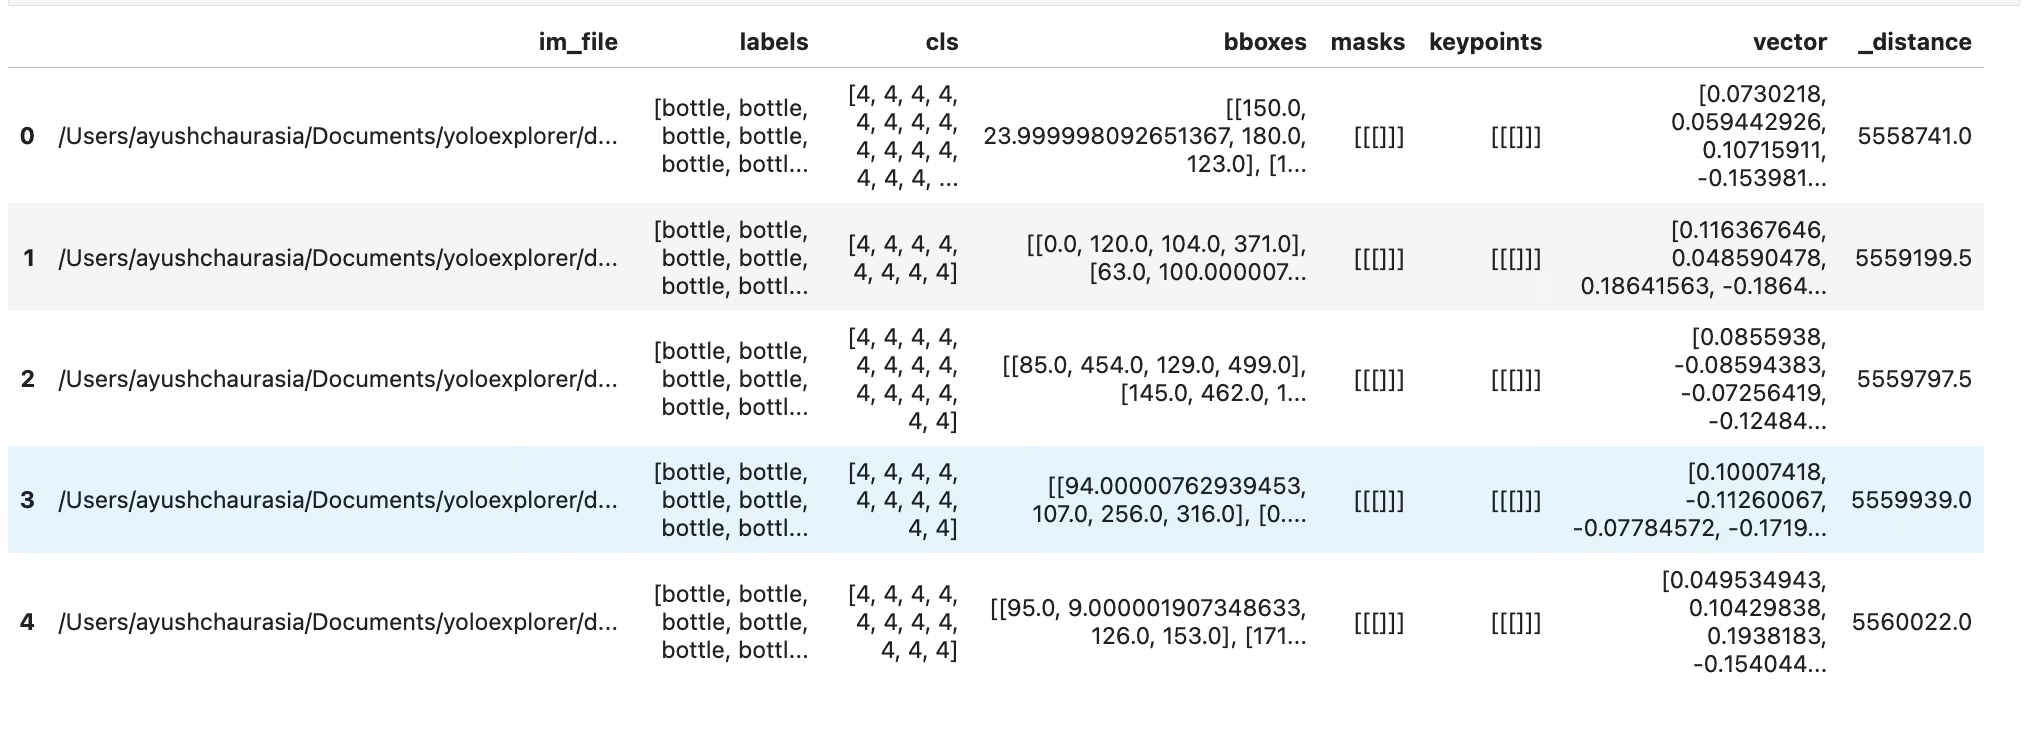
dummy_img_embedding = [i for i in range(256)]
table.search(dummy_img_embedding).limit(5).to_pandas()
Conversione tra i formati di dati più diffusi#
df = table.to_pandas()
pa_table = table.to_arrow()
Lavorare con gli embedding#
Puoi accedere agli embedding grezzi dalla tabella LanceDB e analizzarli. Gli embedding delle immagini sono memorizzati nella colonna vector:
import numpy as np

embeddings = table.to_pandas()["vector"].tolist()
embeddings = np.array(embeddings)
Grafico a dispersione#
Un primo passaggio comune nell'analisi degli embedding consiste nel rappresentarli in uno spazio 2D o 3D tramite la riduzione della dimensionalità. L'esempio seguente usa PCA per proiettarli in 3D:
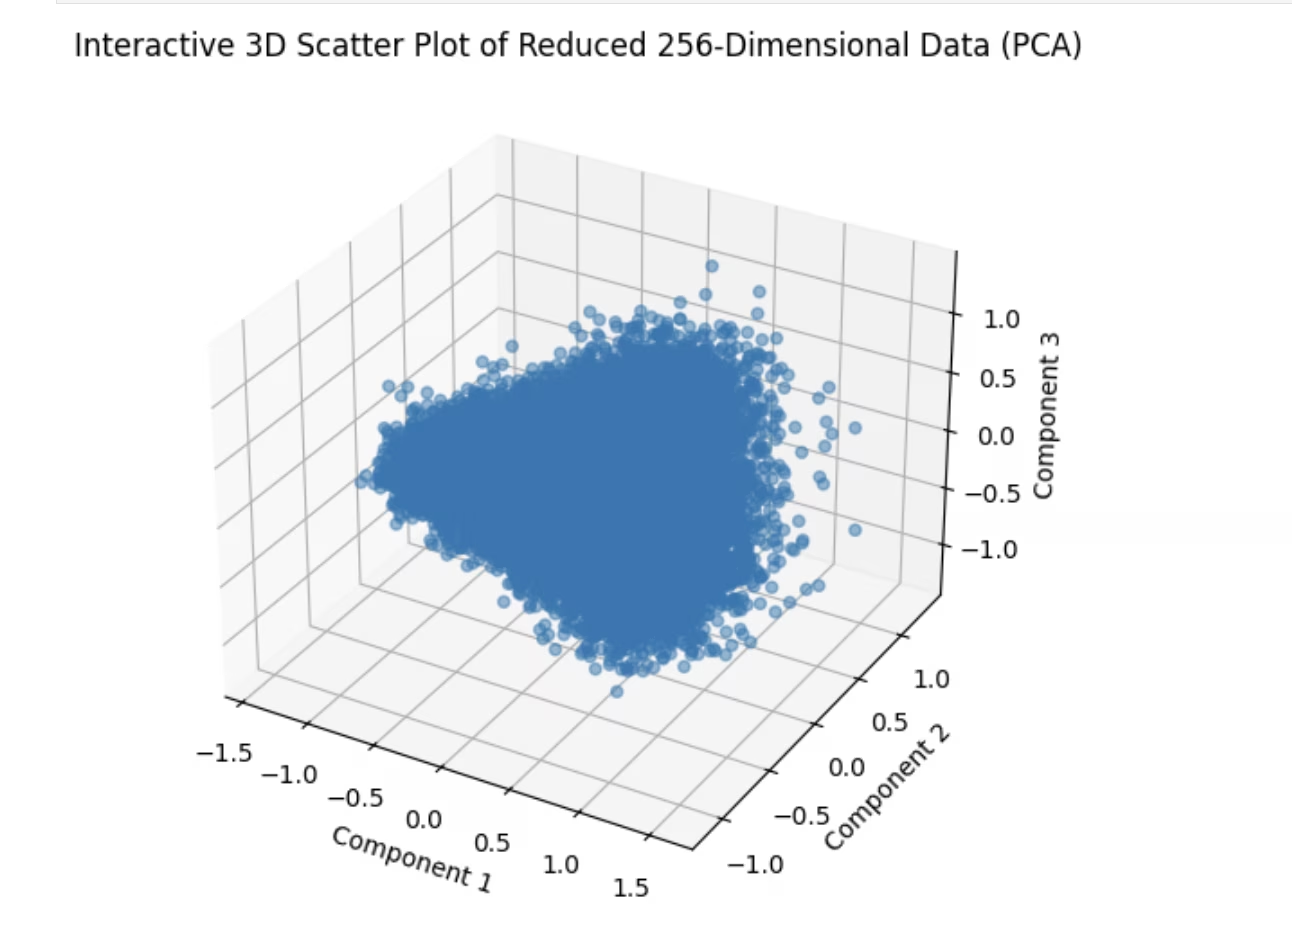
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA  # pip install scikit-learn

# Riduci le dimensioni a 3 componenti usando PCA per la visualizzazione in 3D
pca = PCA(n_components=3)
reduced_data = pca.fit_transform(embeddings)

# Crea un grafico a dispersione 3D usando Axes3D di Matplotlib
fig = plt.figure(figsize=(8, 6))
ax = fig.add_subplot(111, projection="3d")

# Grafico a dispersione
ax.scatter(reduced_data[:, 0], reduced_data[:, 1], reduced_data[:, 2], alpha=0.5)
ax.set_title("3D Scatter Plot of Reduced 256-Dimensional Data (PCA)")
ax.set_xlabel("Component 1")
ax.set_ylabel("Component 2")
ax.set_zlabel("Component 3")

plt.show()
Indice di similarità#
Ecco un semplice esempio di un'operazione basata sulla tabella degli embedding. Explorer include un'operazione similarity_index:
- Prova a stimare quanto ciascun punto dati sia simile al resto del dataset.
- Lo fa contando quanti embedding di immagini si trovano a una distanza inferiore a
max_distdall'immagine corrente nello spazio degli embedding generato, considerandotop_kimmagini simili alla volta.
Per un determinato dataset, modello, max_dist e top_k, l'indice di similarità, una volta generato, verrà riutilizzato. Se il dataset è cambiato o devi rigenerare l'indice di similarità, passa force=True. Come la ricerca vettoriale e SQL, anche questa include un'utilità per rappresentare direttamente il risultato.
sim_idx = exp.similarity_index(max_dist=0.2, top_k=0.01)
exp.plot_similarity_index(max_dist=0.2, top_k=0.01)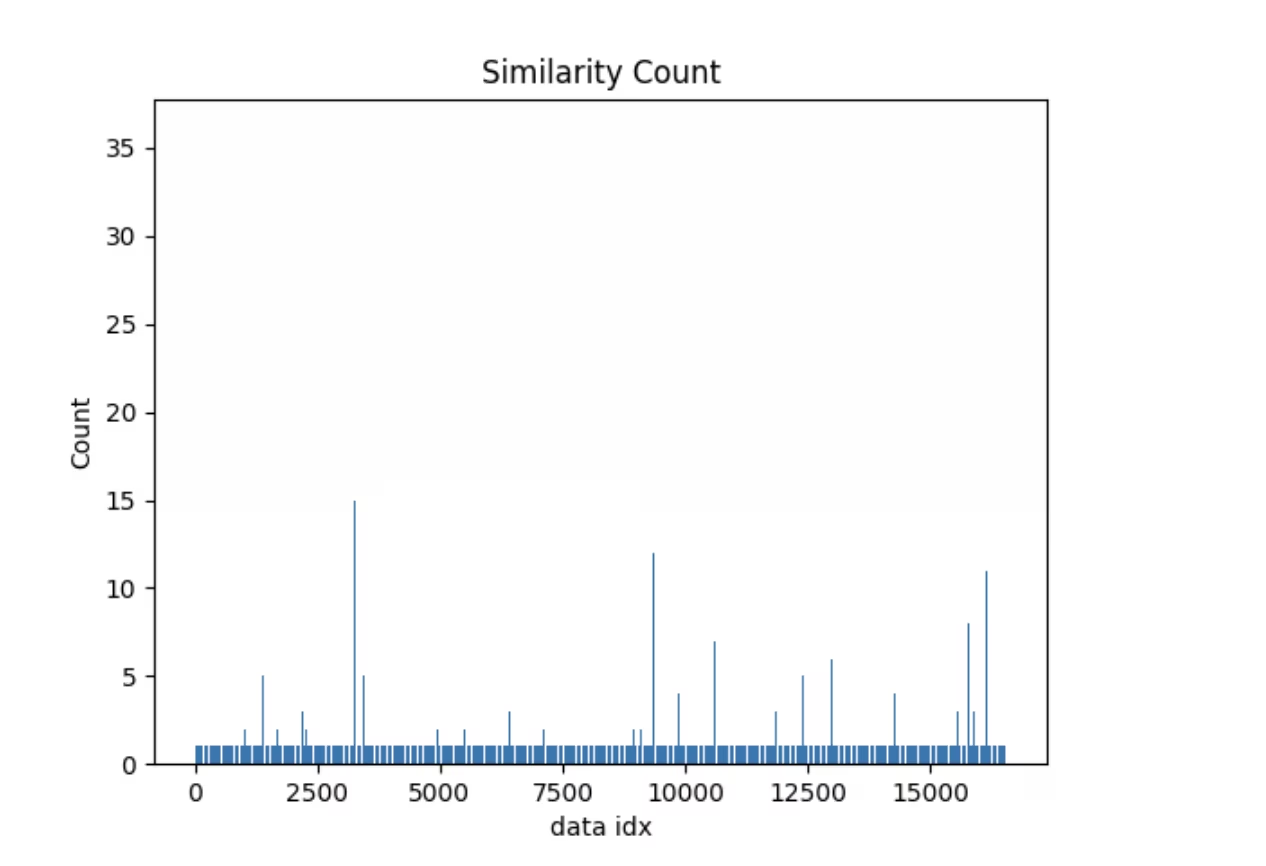
Per prima cosa, osserva il grafico:
exp.plot_similarity_index(max_dist=0.2, top_k=0.01)Poi esamina il risultato dell'operazione:
sim_idx = exp.similarity_index(max_dist=0.2, top_k=0.01, force=False)

sim_idx
Quindi, interroga i punti dati con un conteggio di similarità superiore a 30 e rappresenta le immagini simili:
import numpy as np

sim_count = np.array(sim_idx["count"])
sim_idx["im_file"][sim_count > 30]
Dovresti vedere qualcosa di simile:
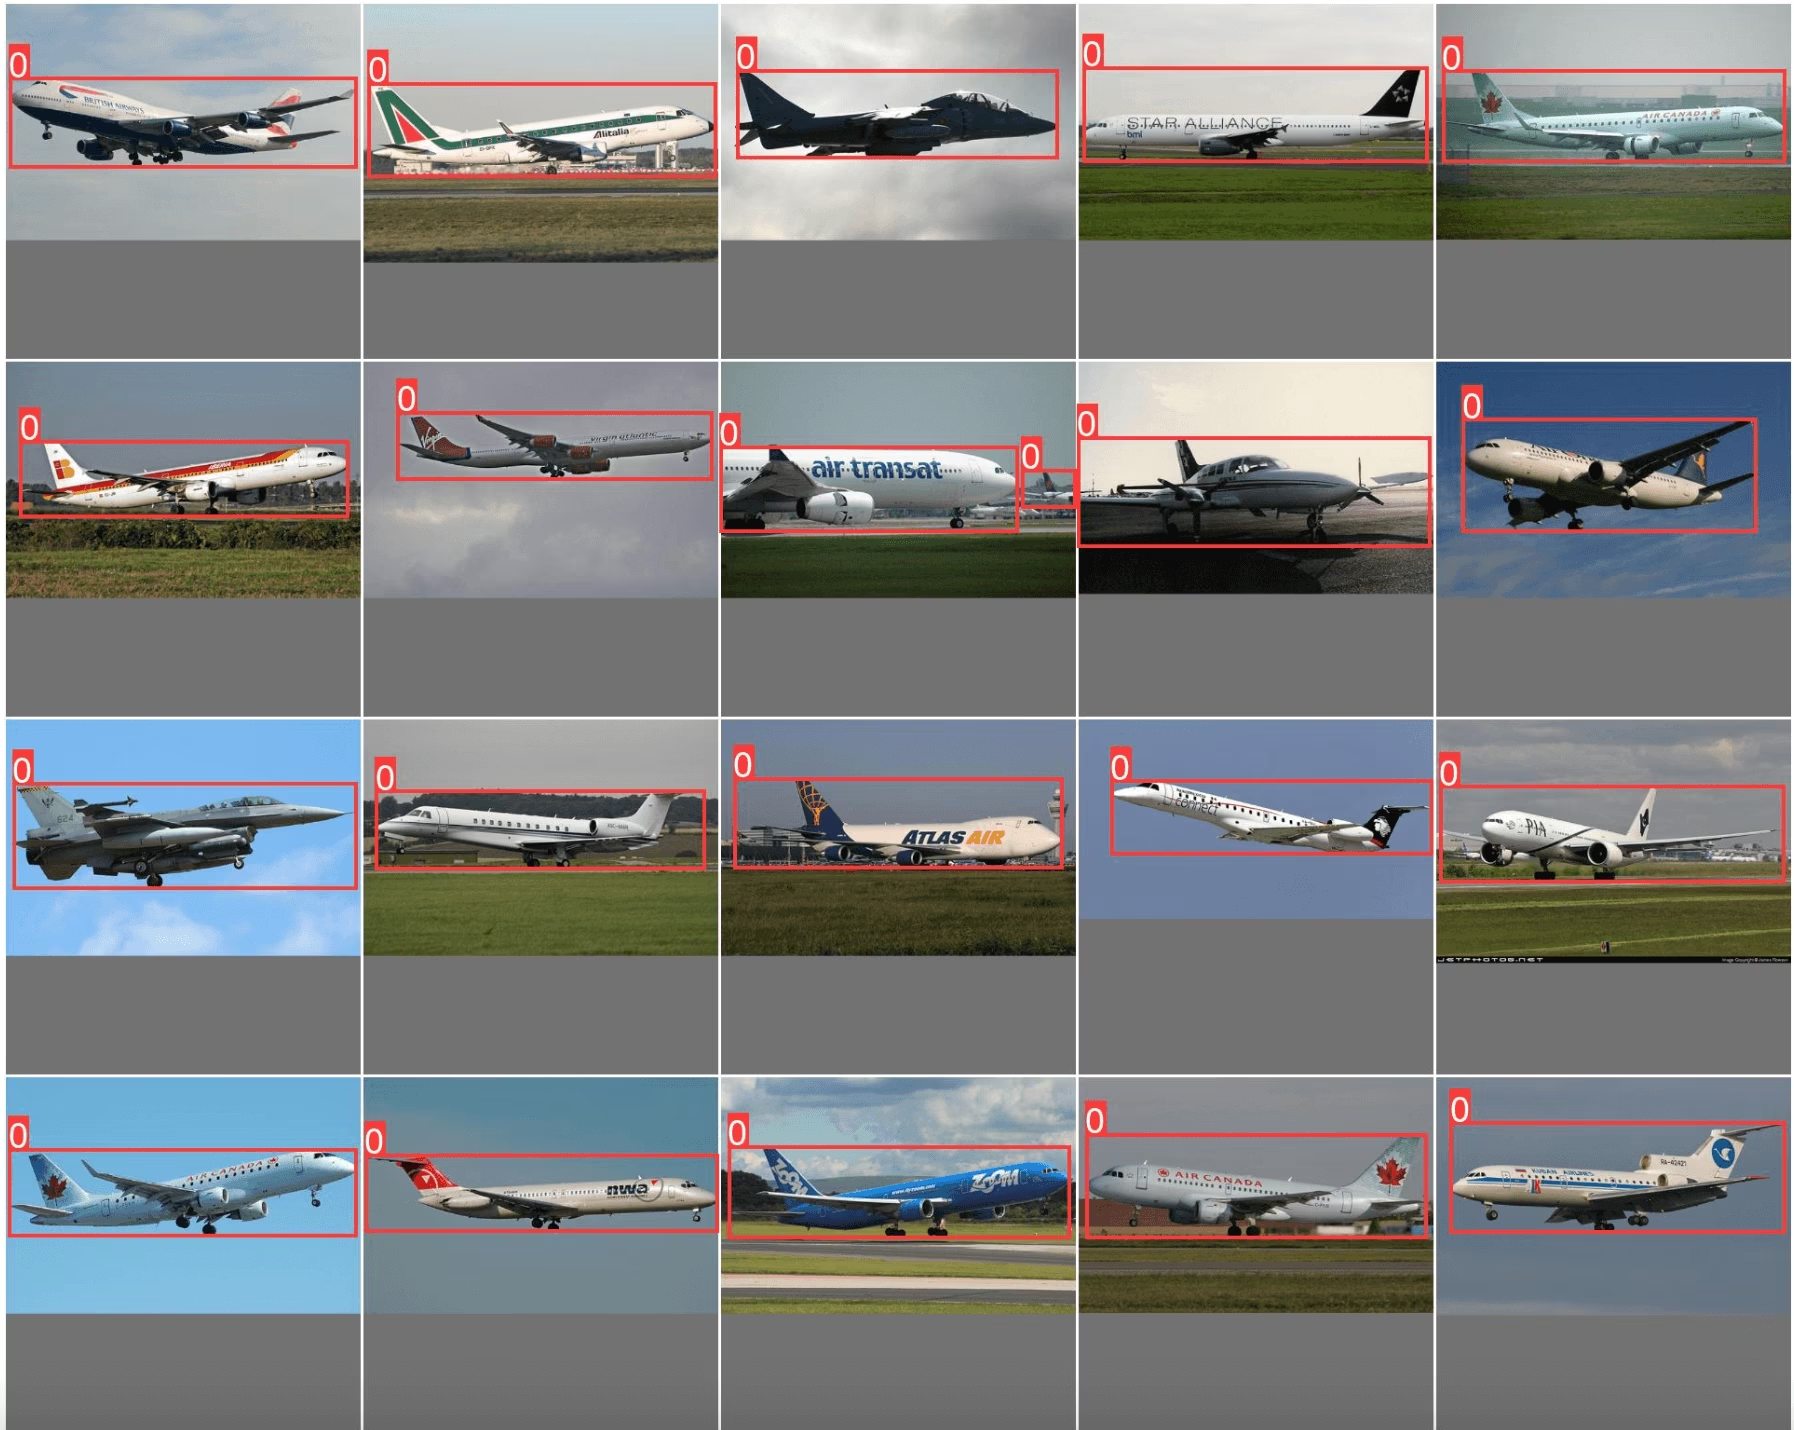
exp.plot_similar(idx=[7146, 14035]) # Uso degli embedding medi di 2 immaginiDomande frequenti#
Explorer è stato rimosso dal pacchetto
ultralyticsnella versione 8.3.12. Per eseguire gli esempi in questa pagina, installa l'ultima versione che lo include conpip install "ultralytics[explorer]==8.3.11". Funzionalità equivalenti e più ampie per l'esplorazione dei dataset sono integrate in Ultralytics Platform.Dopo aver creato una tabella degli embedding con
create_embeddings_table(), puoi trovare immagini visivamente simili tramite indice o immagine esterna, filtrare il dataset con clausole SQLWHERE, porre domande in linguaggio naturale conask_ai()e calcolare un indice di similarità per individuare immagini quasi duplicate.Explorer mantiene gli embedding in una tabella LanceDB su disco, che viene quindi creata una sola volta per ogni coppia dataset-modello e riutilizzata tra le sessioni. Accedervi direttamente tramite
exp.tableper eseguire query sui vettori raw, applicare pre-filtri e post-filtri ed esportare i dati in pandas o Arrow.


Commenti2
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
Lovelesh1412
Hi This dataset is of different sectors from United Kingdom and can be useful in finding insolvencies Uploading 1737780247JM 71 dataa 24th January revised.xlsx.xlsx…
 Glenn JocherUltralytics(modificato)
@Lovelesh1412 thanks for sharing your dataset! For analyzing tabular data like Excel files with Ultralytics tools, you'll need to first convert it into a supported vision dataset format (like YOLO TXT or COCO JSON) for object detection/classification tasks. Our tools are optimized for image/video analysis rather than raw tabular data processing. For spreadsheet analysis, you might want to consider dedicated data science tools like Pandas or Tableau.
While Ultralytics Explorer has been removed (
ultralytics>=8.3.12), you can explore similar capabilities in Ultralytics Platform for vision datasets: https://platform.ultralytics.com