YOLOv7: مجموعة مزايا قابلة للتدريب
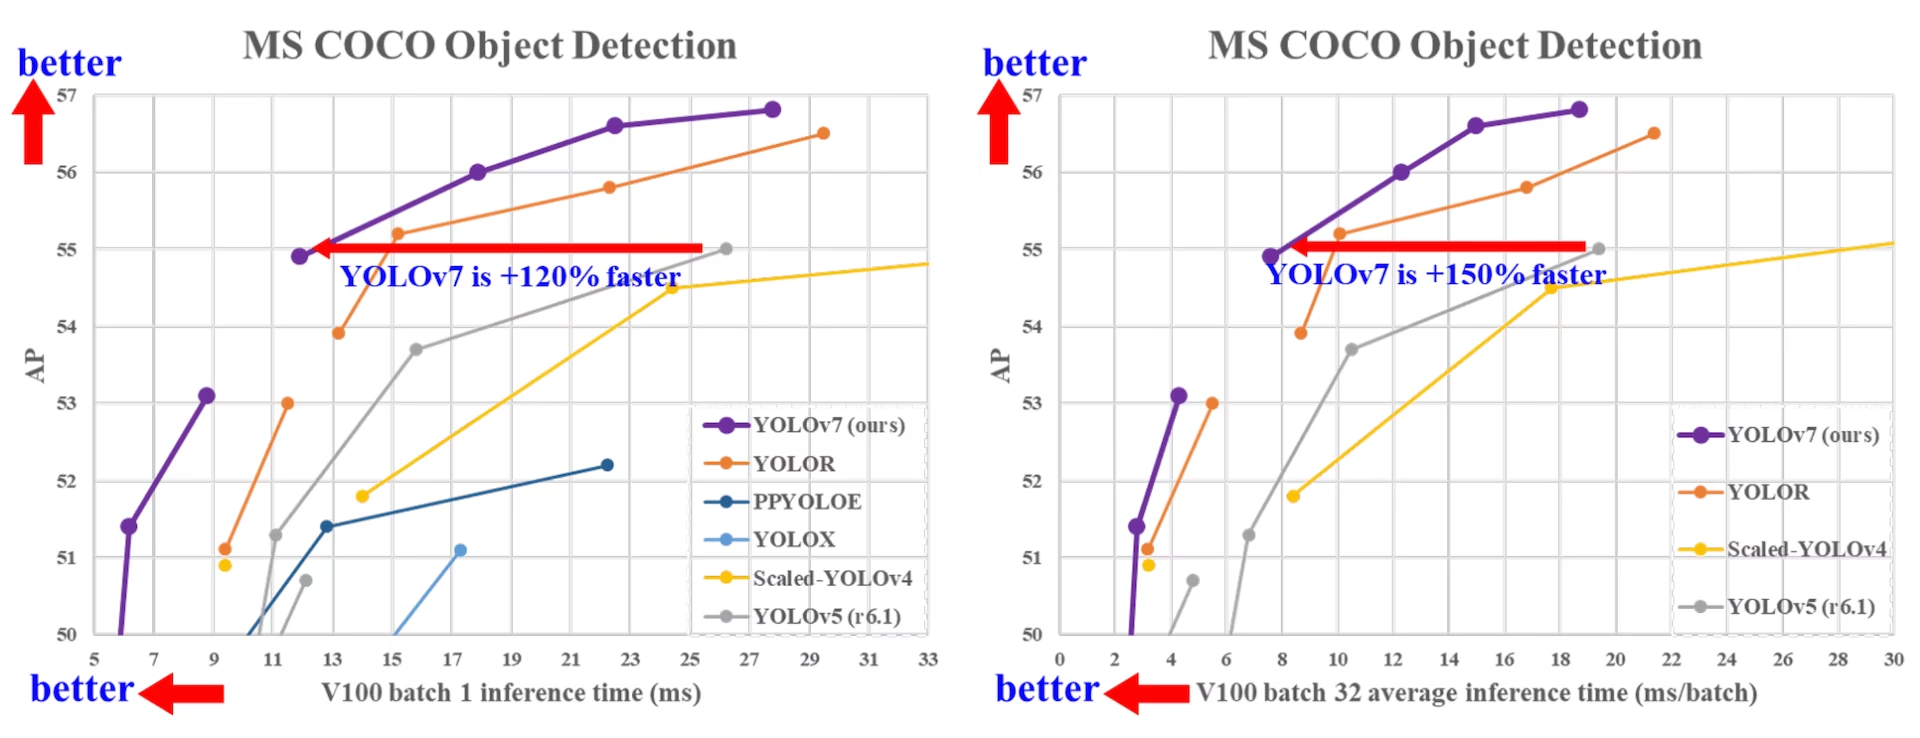
كان YOLOv7، الذي أُصدر في يوليو 2022، تقدمًا كبيرًا في اكتشاف الكائنات الآني وقت إصداره. وحقق دقة AP بلغت 56.8%، وهي الأعلى بين كواشف الكائنات الآنية التي تعمل بمعدل 30 إطارًا في الثانية أو أكثر على وحدة GPU من طراز V100 عند طرحه. وتفوق YOLOv7 على كواشف الكائنات المعاصرة مثل YOLOR وYOLOX وScaled-YOLOv4 وYOLOv5 من حيث السرعة والدقة. ودُرّب النموذج من البداية على مجموعة بيانات MS COCO دون استخدام أي مجموعات بيانات أخرى أو أوزان مدرّبة مسبقًا. تتوفر الشيفرة المصدرية لـYOLOv7 على GitHub. تجدر الإشارة إلى أن نماذج أحدث مثل YOLO26 وYOLO11 حققت منذ ذلك الحين دقة أعلى وكفاءة محسّنة.
مقارنة كاشفات الكائنات المتطورة#
وفقًا لجدول المقارنة في ورقة YOLOv7 البحثية، يحقق YOLOv7 أفضل مفاضلة إجمالية بين السرعة والدقة. وبالمقارنة مع YOLOv5-N (r6.1)، فإن YOLOv7-tiny-SiLU أسرع بمقدار 127 إطارًا في الثانية وأكثر دقة بنسبة 10.7% وفق مقياس AP. إضافة إلى ذلك، يحقق YOLOv7 نسبة AP تبلغ 51.4% عند 161 إطارًا في الثانية، بينما يحقق PPYOLOE-L نسبة AP نفسها عند 78 إطارًا في الثانية فقط، ويستخدم YOLOv7 معلمات أقل بنسبة 41% من PPYOLOE-L.
مقارنةً بـYOLOv5-L (r6.1) الذي يعمل بسرعة 99 إطارًا في الثانية، يعمل YOLOv7-X بسرعة 114 إطارًا في الثانية ويحسّن AP بنسبة 3.9%. وبالمقارنة مع YOLOv5-X (r6.1) ذي الحجم المماثل، فإن YOLOv7-X أسرع بمقدار 31 إطارًا في الثانية، ويستخدم معلمات أقل بنسبة 22% وحسابات أقل بنسبة 8%، ويحسّن AP بنسبة 2.2% (المصدر).
| النموذج | المعلمات (M) | FLOPs (G) | الحجم (بكسل) | إطارًا في الثانية (FPS) | APالاختبار / التحقق50-95 | APالاختبار50 | APالاختبار75 | APالاختبارS | APالاختبارM | APالاختبارL |
|---|---|---|---|---|---|---|---|---|---|---|
| YOLOX-S | 9.0 | 26.8 | 640 | 102 | 40.5% / 40.5% | - | - | - | - | - |
| YOLOX-M | 25.3 | 73.8 | 640 | 81 | 47.2% / 46.9% | - | - | - | - | - |
| YOLOX-L | 54.2 | 155.6 | 640 | 69 | 50.1% / 49.7% | - | - | - | - | - |
| YOLOX-X | 99.1 | 281.9 | 640 | 58 | 51.5% / 51.1% | - | - | - | - | - |
| PPYOLOE-S | 7.9 | 17.4 | 640 | 208 | 43.1% / 42.7% | 60.5% | 46.6% | 23.2% | 46.4% | 56.9% |
| PPYOLOE-M | 23.4 | 49.9 | 640 | 123 | 48.9% / 48.6% | 66.5% | 53.0% | 28.6% | 52.9% | 63.8% |
| PPYOLOE-L | 52.2 | 110.1 | 640 | 78 | 51.4% / 50.9% | 68.9% | 55.6% | 31.4% | 55.3% | 66.1% |
| PPYOLOE-X | 98.4 | 206.6 | 640 | 45 | 52.2% / 51.9% | 69.9% | 56.5% | 33.3% | 56.3% | 66.4% |
| YOLOv5-N (r6.1) | 1.9 | 4.5 | 640 | 159 | - / 28.0% | - | - | - | - | - |
| YOLOv5-S (r6.1) | 7.2 | 16.5 | 640 | 156 | - / 37.4% | - | - | - | - | - |
| YOLOv5-M (r6.1) | 21.2 | 49.0 | 640 | 122 | - / 45.4% | - | - | - | - | - |
| YOLOv5-L (r6.1) | 46.5 | 109.1 | 640 | 99 | - / 49.0% | - | - | - | - | - |
| YOLOv5-X (r6.1) | 86.7 | 205.7 | 640 | 83 | - / 50.7% | - | - | - | - | - |
| YOLOR-CSP | 52.9 | 120.4 | 640 | 106 | 51.1% / 50.8% | 69.6% | 55.7% | 31.7% | 55.3% | 64.7% |
| YOLOR-CSP-X | 96.9 | 226.8 | 640 | 87 | 53.0% / 52.7% | 71.4% | 57.9% | 33.7% | 57.1% | 66.8% |
| YOLOv7-tiny-SiLU | 6.2 | 13.8 | 640 | 286 | 38.7% / 38.7% | 56.7% | 41.7% | 18.8% | 42.4% | 51.9% |
| YOLOv7 | 36.9 | 104.7 | 640 | 161 | 51.4% / 51.2% | 69.7% | 55.9% | 31.8% | 55.5% | 65.0% |
| YOLOv7-X | 71.3 | 189.9 | 640 | 114 | 53.1% / 52.9% | 71.2% | 57.8% | 33.8% | 57.1% | 67.4% |
| YOLOv5-N6 (r6.1) | 3.2 | 18.4 | 1280 | 123 | - / 36.0% | - | - | - | - | - |
| YOLOv5-S6 (r6.1) | 12.6 | 67.2 | 1280 | 122 | - / 44.8% | - | - | - | - | - |
| YOLOv5-M6 (r6.1) | 35.7 | 200.0 | 1280 | 90 | - / 51.3% | - | - | - | - | - |
| YOLOv5-L6 (r6.1) | 76.8 | 445.6 | 1280 | 63 | - / 53.7% | - | - | - | - | - |
| YOLOv5-X6 (r6.1) | 140.7 | 839.2 | 1280 | 38 | - / 55.0% | - | - | - | - | - |
| YOLOR-P6 | 37.2 | 325.6 | 1280 | 76 | 53.9% / 53.5% | 71.4% | 58.9% | 36.1% | 57.7% | 65.6% |
| YOLOR-W6 | 79.8 | 453.2 | 1280 | 66 | 55.2% / 54.8% | 72.7% | 60.5% | 37.7% | 59.1% | 67.1% |
| YOLOR-E6 | 115.8 | 683.2 | 1280 | 45 | 55.8% / 55.7% | 73.4% | 61.1% | 38.4% | 59.7% | 67.7% |
| YOLOR-D6 | 151.7 | 935.6 | 1280 | 34 | 56.5% / 56.1% | 74.1% | 61.9% | 38.9% | 60.4% | 68.7% |
| YOLOv7-W6 | 70.4 | 360.0 | 1280 | 84 | 54.9% / 54.6% | 72.6% | 60.1% | 37.3% | 58.7% | 67.1% |
| YOLOv7-E6 | 97.2 | 515.2 | 1280 | 56 | 56.0% / 55.9% | 73.5% | 61.2% | 38.0% | 59.9% | 68.4% |
| YOLOv7-D6 | 154.7 | 806.8 | 1280 | 44 | 56.6% / 56.3% | 74.0% | 61.8% | 38.8% | 60.1% | 69.5% |
| YOLOv7-E6E | 151.7 | 843.2 | 1280 | 36 | 56.8% / 56.8% | 74.4% | 62.1% | 39.3% | 60.5% | 69.0% |
نظرة عامة#
يُعد اكتشاف الكائنات الآني مكونًا مهمًا في كثير من أنظمة الرؤية الحاسوبية، بما فيها تتبع الكائنات المتعددة والقيادة الذاتية والروبوتات وتحليل الصور الطبية. وفي السنوات الأخيرة، ركز تطوير اكتشاف الكائنات الآني على تصميم بنيات فعالة وتحسين سرعة الاستدلال لمختلف وحدات CPU وGPU ووحدات المعالجة العصبية (NPUs). ويدعم YOLOv7 وحدات GPU المحمولة ووحدات GPU الأخرى، من الأجهزة الطرفية إلى السحابة.
على خلاف كاشفات الأجسام التقليدية في الزمن الفعلي التي تركز على تحسين البنية، يركّز YOLOv7 على تحسين عملية التدريب. ويشمل ذلك وحدات وأساليب تحسين مصممة لرفع دقة اكتشاف الأجسام من دون زيادة كلفة الاستدلال، وهو مفهوم يُعرف باسم «حزمة المزايا المجانية القابلة للتدريب».
الميزات الرئيسية#
يقدّم YOLOv7 عدة ميزات أساسية:
-
إعادة ضبط معلمات النموذج: يقترح YOLOv7 نموذجاً مخططاً له ومعاد ضبط معلماته، وهي استراتيجية يمكن تطبيقها على الطبقات في شبكات مختلفة وفق مفهوم مسار انتشار التدرّج.
-
التعيين الديناميكي للتسميات: يطرح تدريب النموذج ذي طبقات الإخراج المتعددة مسألة جديدة: «كيف نعيّن أهدافاً ديناميكية لمخرجات الفروع المختلفة؟» لحل هذه المشكلة، يقدّم YOLOv7 طريقة جديدة لتعيين التسميات تُسمّى التعيين الموجّه للتسميات من الخشن إلى الدقيق.
-
التوسيع والقياس المركّب: يقترح YOLOv7 طريقتَي «التوسيع» و«القياس المركّب» لكاشف الأجسام في الزمن الفعلي، بما يتيح استخدام المعلمات والعمليات الحسابية بفعالية.
-
الكفاءة: تقلل الطريقة التي يقترحها YOLOv7 عدد المعلمات بنحو 40% والحسابات بنحو 50% مقارنةً بكواشف الكائنات الآنية المتطورة، مع تحقيق استدلال أسرع ودقة أعلى في الاكتشاف.
أمثلة الاستخدام#
لا تنشر Ultralytics أوزاناً مدرّبة مسبقاً yolov7.pt أو ملفات YAML ultralytics/cfg/models/v7/، ولا تدعم حزمة Ultralytics Python تدريب YOLOv7 واستدلاله الأصليين باستخدام PyTorch. لكن يمكنك استخدام نقطة تحقق YOLOv7 المدرّبة في مستودع YOLOv7 المنبع ضمن Ultralytics، وذلك بتصديرها إلى ONNX أو TensorRT، كما هو موضح أدناه.
التصدير إلى ONNX#
لاستخدام نموذج YOLOv7 بصيغة ONNX مع Ultralytics:
-
(اختياري) ثبّت Ultralytics وصدّر نموذجاً بصيغة ONNX لتثبيت التبعيات المطلوبة تلقائياً:
pip install ultralytics yolo export model=yolo26n.pt format=onnx -
صدّر نموذج YOLOv7 المطلوب باستخدام أداة التصدير في مستودع YOLOv7:
git clone https://github.com/WongKinYiu/yolov7 cd yolov7 python export.py --weights yolov7-tiny.pt --grid --end2end --simplify --topk-all 100 --iou-thres 0.65 --conf-thres 0.35 --img-size 640 640 --max-wh 640 -
عدّل مخطط نموذج ONNX ليكون متوافقاً مع Ultralytics باستخدام النص البرمجي التالي:
import numpy as np import onnx from onnx import helper, numpy_helper # Load the ONNX model model_path = "yolov7/yolov7-tiny.onnx" # Replace with your model path model = onnx.load(model_path) graph = model.graph # Fix input shape to batch size 1 input_shape = graph.input[0].type.tensor_type.shape input_shape.dim[0].dim_value = 1 # Define the output of the original model original_output_name = graph.output[0].name # Create slicing nodes sliced_output_name = f"{original_output_name}_sliced" # Define initializers for slicing (remove the first value) start = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_start") end = numpy_helper.from_array(np.array([7], dtype=np.int64), name="slice_end") axes = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_axes") steps = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_steps") graph.initializer.extend([start, end, axes, steps]) slice_node = helper.make_node( "Slice", inputs=[original_output_name, "slice_start", "slice_end", "slice_axes", "slice_steps"], outputs=[sliced_output_name], name="SliceNode", ) graph.node.append(slice_node) # Define segment slicing seg1_start = numpy_helper.from_array(np.array([0], dtype=np.int64), name="seg1_start") seg1_end = numpy_helper.from_array(np.array([4], dtype=np.int64), name="seg1_end") seg2_start = numpy_helper.from_array(np.array([4], dtype=np.int64), name="seg2_start") seg2_end = numpy_helper.from_array(np.array([5], dtype=np.int64), name="seg2_end") seg3_start = numpy_helper.from_array(np.array([5], dtype=np.int64), name="seg3_start") seg3_end = numpy_helper.from_array(np.array([6], dtype=np.int64), name="seg3_end") graph.initializer.extend([seg1_start, seg1_end, seg2_start, seg2_end, seg3_start, seg3_end]) # Create intermediate tensors for segments segment_1_name = f"{sliced_output_name}_segment1" segment_2_name = f"{sliced_output_name}_segment2" segment_3_name = f"{sliced_output_name}_segment3" # Add segment slicing nodes graph.node.extend( [ helper.make_node( "Slice", inputs=[sliced_output_name, "seg1_start", "seg1_end", "slice_axes", "slice_steps"], outputs=[segment_1_name], name="SliceSegment1", ), helper.make_node( "Slice", inputs=[sliced_output_name, "seg2_start", "seg2_end", "slice_axes", "slice_steps"], outputs=[segment_2_name], name="SliceSegment2", ), helper.make_node( "Slice", inputs=[sliced_output_name, "seg3_start", "seg3_end", "slice_axes", "slice_steps"], outputs=[segment_3_name], name="SliceSegment3", ), ] ) # Concatenate the segments concat_output_name = f"{sliced_output_name}_concat" concat_node = helper.make_node( "Concat", inputs=[segment_1_name, segment_3_name, segment_2_name], outputs=[concat_output_name], axis=1, name="ConcatSwapped", ) graph.node.append(concat_node) # Reshape to [1, -1, 6] reshape_shape = numpy_helper.from_array(np.array([1, -1, 6], dtype=np.int64), name="reshape_shape") graph.initializer.append(reshape_shape) final_output_name = f"{concat_output_name}_batched" reshape_node = helper.make_node( "Reshape", inputs=[concat_output_name, "reshape_shape"], outputs=[final_output_name], name="AddBatchDimension", ) graph.node.append(reshape_node) # Get the shape of the reshaped tensor shape_node_name = f"{final_output_name}_shape" shape_node = helper.make_node( "Shape", inputs=[final_output_name], outputs=[shape_node_name], name="GetShapeDim", ) graph.node.append(shape_node) # Extract the second dimension dim_1_index = numpy_helper.from_array(np.array([1], dtype=np.int64), name="dim_1_index") graph.initializer.append(dim_1_index) second_dim_name = f"{final_output_name}_dim1" gather_node = helper.make_node( "Gather", inputs=[shape_node_name, "dim_1_index"], outputs=[second_dim_name], name="GatherSecondDim", ) graph.node.append(gather_node) # Subtract from 100 to determine how many values to pad target_size = numpy_helper.from_array(np.array([100], dtype=np.int64), name="target_size") graph.initializer.append(target_size) pad_size_name = f"{second_dim_name}_padsize" sub_node = helper.make_node( "Sub", inputs=["target_size", second_dim_name], outputs=[pad_size_name], name="CalculatePadSize", ) graph.node.append(sub_node) # Build the [2, 3] pad array: # 1st row -> [0, 0, 0] (no padding at the start of any dim) # 2nd row -> [0, pad_size, 0] (pad only at the end of the second dim) pad_starts = numpy_helper.from_array(np.array([0, 0, 0], dtype=np.int64), name="pad_starts") graph.initializer.append(pad_starts) zero_scalar = numpy_helper.from_array(np.array([0], dtype=np.int64), name="zero_scalar") graph.initializer.append(zero_scalar) pad_ends_name = "pad_ends" concat_pad_ends_node = helper.make_node( "Concat", inputs=["zero_scalar", pad_size_name, "zero_scalar"], outputs=[pad_ends_name], axis=0, name="ConcatPadEnds", ) graph.node.append(concat_pad_ends_node) pad_values_name = "pad_values" concat_pad_node = helper.make_node( "Concat", inputs=["pad_starts", pad_ends_name], outputs=[pad_values_name], axis=0, name="ConcatPadStartsEnds", ) graph.node.append(concat_pad_node) # Create Pad operator to pad with zeros pad_output_name = f"{final_output_name}_padded" pad_constant_value = numpy_helper.from_array( np.array([0.0], dtype=np.float32), name="pad_constant_value", ) graph.initializer.append(pad_constant_value) pad_node = helper.make_node( "Pad", inputs=[final_output_name, pad_values_name, "pad_constant_value"], outputs=[pad_output_name], mode="constant", name="PadToFixedSize", ) graph.node.append(pad_node) # Update the graph's final output to [1, 100, 6] new_output_type = onnx.helper.make_tensor_type_proto( elem_type=graph.output[0].type.tensor_type.elem_type, shape=[1, 100, 6] ) new_output = onnx.helper.make_value_info(name=pad_output_name, type_proto=new_output_type) # Replace the old output with the new one graph.output.pop() graph.output.extend([new_output]) # Save the modified model onnx.save(model, "yolov7-ultralytics.onnx") -
يمكنك بعد ذلك تحميل نموذج ONNX المعدّل وإجراء الاستدلال به في Ultralytics كالمعتاد:
from ultralytics import ASSETS, YOLO

model = YOLO("yolov7-ultralytics.onnx", task="detect")

results = model(ASSETS / "bus.jpg")
التصدير إلى TensorRT#
-
اتبع الخطوتين 1 و2 في قسم التصدير إلى ONNX.
-
ثبّت حزمة Python
TensorRT:pip install tensorrt -
شغّل البرنامج النصي التالي لتحويل نموذج ONNX المعدّل إلى محرك TensorRT:
from ultralytics.utils.export import onnx2engine onnx2engine("yolov7-ultralytics.onnx", quantize=16) -
حمّل النموذج وشغّله في Ultralytics:
from ultralytics import ASSETS, YOLO

model = YOLO("yolov7-ultralytics.engine", task="detect")

results = model(ASSETS / "bus.jpg")
الاستشهادات والشكر والتقدير#
نودّ الإشادة بمؤلفي YOLOv7 لإسهاماتهم المهمة في مجال اكتشاف الأجسام في الزمن الفعلي:
@inproceedings{wang2023yolov7,
  title={YOLOv7: Trainable Bag-of-Freebies Sets New State-of-the-Art for Real-Time Object Detectors},
  author={Wang, Chien-Yao and Bochkovskiy, Alexey and Liao, Hong-Yuan Mark},
  booktitle={Proceedings of the IEEE/CVF conference on Computer Vision and Pattern Recognition (CVPR)},
  pages={7464--7475},
  year={2023}
}
نُشرت الورقة البحثية الرسمية لـYOLOv7 في مؤتمر CVPR 2023، وهي متاحة عبر CVF Open Access، كما تتوفر نسخة تمهيدية منها على arXiv. أتاح المؤلفون عملهم للجمهور، ويمكن الوصول إلى قاعدة الشيفرة على GitHub. ونقدّر جهودهم في تطوير المجال وإتاحة عملهم للمجتمع الأوسع.
الأسئلة الشائعة#
كان YOLOv7، الذي صدر في يوليو 2022، نموذجًا لاكتشاف الكائنات في الزمن الفعلي حقق سرعة ودقة متقدمتين وقت إصداره. وتفوق على نماذج معاصرة مثل YOLOX وYOLOv5 وPPYOLOE من حيث استخدام المعلمات وسرعة الاستدلال. وتشمل السمات المميزة لـ YOLOv7 إعادة معلمة النموذج والإسناد الديناميكي للتسميات، اللذين يحسّنان أداءه دون زيادة تكاليف الاستدلال.
يقدّم YOLOv7 عدة ابتكارات، منها إعادة ضبط معلمات النموذج والتعيين الديناميكي للتسميات، ما يعزّز عملية التدريب ويحسّن دقة الاستدلال. وبالمقارنة مع YOLOv5، يرفع YOLOv7 السرعة والدقة بدرجة كبيرة. فعلى سبيل المثال، يحسّن YOLOv7-X الدقة بنسبة 2.2% ويقلّل عدد المعلمات بنسبة 22% مقارنةً بـ YOLOv5-X. يمكن الاطلاع على مقارنات مفصلة في جدول الأداء مقارنة YOLOv7 بأحدث كاشفات الأجسام.
حتى الآن، لا تدعم Ultralytics سوى استدلال YOLOv7 بصيغتَي ONNX وTensorRT. لتشغيل إصدار YOLOv7 المُصدّر إلى ONNX أو TensorRT باستخدام Ultralytics، راجع قسم أمثلة الاستخدام.
لتثبيت نموذج YOLOv7 مخصص وتدريبه، اتبع الخطوات التالية:
-
استنسخ مستودع YOLOv7:
git clone https://github.com/WongKinYiu/yolov7 -
انتقل إلى الدليل المستنسخ وثبّت التبعيات:
cd yolov7 pip install -r requirements.txt -
أعِدّ مجموعة البيانات واضبط معلمات النموذج وفقًا لـتعليمات الاستخدام المقدمة في المستودع.
-
بعد التدريب، يمكنك تصدير النموذج إلى ONNX أو TensorRT لاستخدامه في Ultralytics، كما هو موضح في أمثلة الاستخدام.
-
يقدّم YOLOv7 عدة ميزات أساسية للكشف عن الأجسام في الوقت الفعلي:
- إعادة ضبط معلمات النموذج: تحسّن أداء النموذج من خلال تحسين مسارات انتشار التدرّج.
- التعيين الديناميكي للتسميات: يستخدم طريقة موجّهة من الخشن إلى الدقيق لتعيين أهداف ديناميكية لمخرجات الفروع المختلفة، ما يحسّن الدقة.
- التوسيع والقياس المركّب: يستخدم المعلمات والعمليات الحسابية بكفاءة لتوسيع النموذج بما يلائم تطبيقات متنوعة في الزمن الفعلي.
- الكفاءة: يقلّل عدد المعلمات بنسبة 40% والعمليات الحسابية بنسبة 50% مقارنةً بالنماذج الأخرى المتطورة، مع تحقيق سرعات استدلال أعلى.


التعليقات2
اطرح سؤالًا، وشارك نتائجك، أو ساعد شخصًا آخر.
naps22
YOLOv7's approach as a trainable bag-of-freebies really stands out, especially in how it optimizes performance without additional inference cost. It's impressive how techniques like re-parameterization and dynamic label assignment enhance accuracy. However, after doing a YOLOv8 comparison, it’s clear that while YOLOv8 brings some architectural improvements and streamlined workflows, YOLOv7 still holds strong in many real-time detection scenarios due to its training-time flexibility.
 Glenn JocherUltralytics(تم التعديل)
You're absolutely right about YOLOv7's innovative "trainable bag-of-freebies" approach - it was a game-changing concept that improved accuracy purely through training optimizations rather than architectural changes. The re-parameterization and dynamic label assignment techniques were particularly clever solutions that set new standards for efficiency.
While YOLOv7 remains excellent for real-time detection scenarios, you might want to explore YOLO26 as well - it's our latest model that builds upon these innovations with even better performance across detection, segmentation, and other tasks, all within the streamlined Ultralytics framework.