YOLO26 mit ExecuTorch auf Mobilgeräten und Edge-Geräten bereitstellen#
Die Bereitstellung von Computer-Vision-Modellen auf Edge-Geräten wie Smartphones, Tablets und eingebetteten Systemen erfordert eine optimierte Laufzeitumgebung, die Leistung und Ressourcenbeschränkungen in Einklang bringt. ExecuTorch, PyTorchs Lösung für Edge Computing, ermöglicht eine effiziente Inferenz direkt auf dem Gerät für Ultralytics-YOLO-Modelle.
Dieser Leitfaden erklärt, wie du Ultralytics-YOLO-Modelle in das ExecuTorch-Format exportierst, damit du sie mit optimierter Leistung auf Mobilgeräten und Edge-Geräten bereitstellen kannst.
Warum nach ExecuTorch exportieren?#
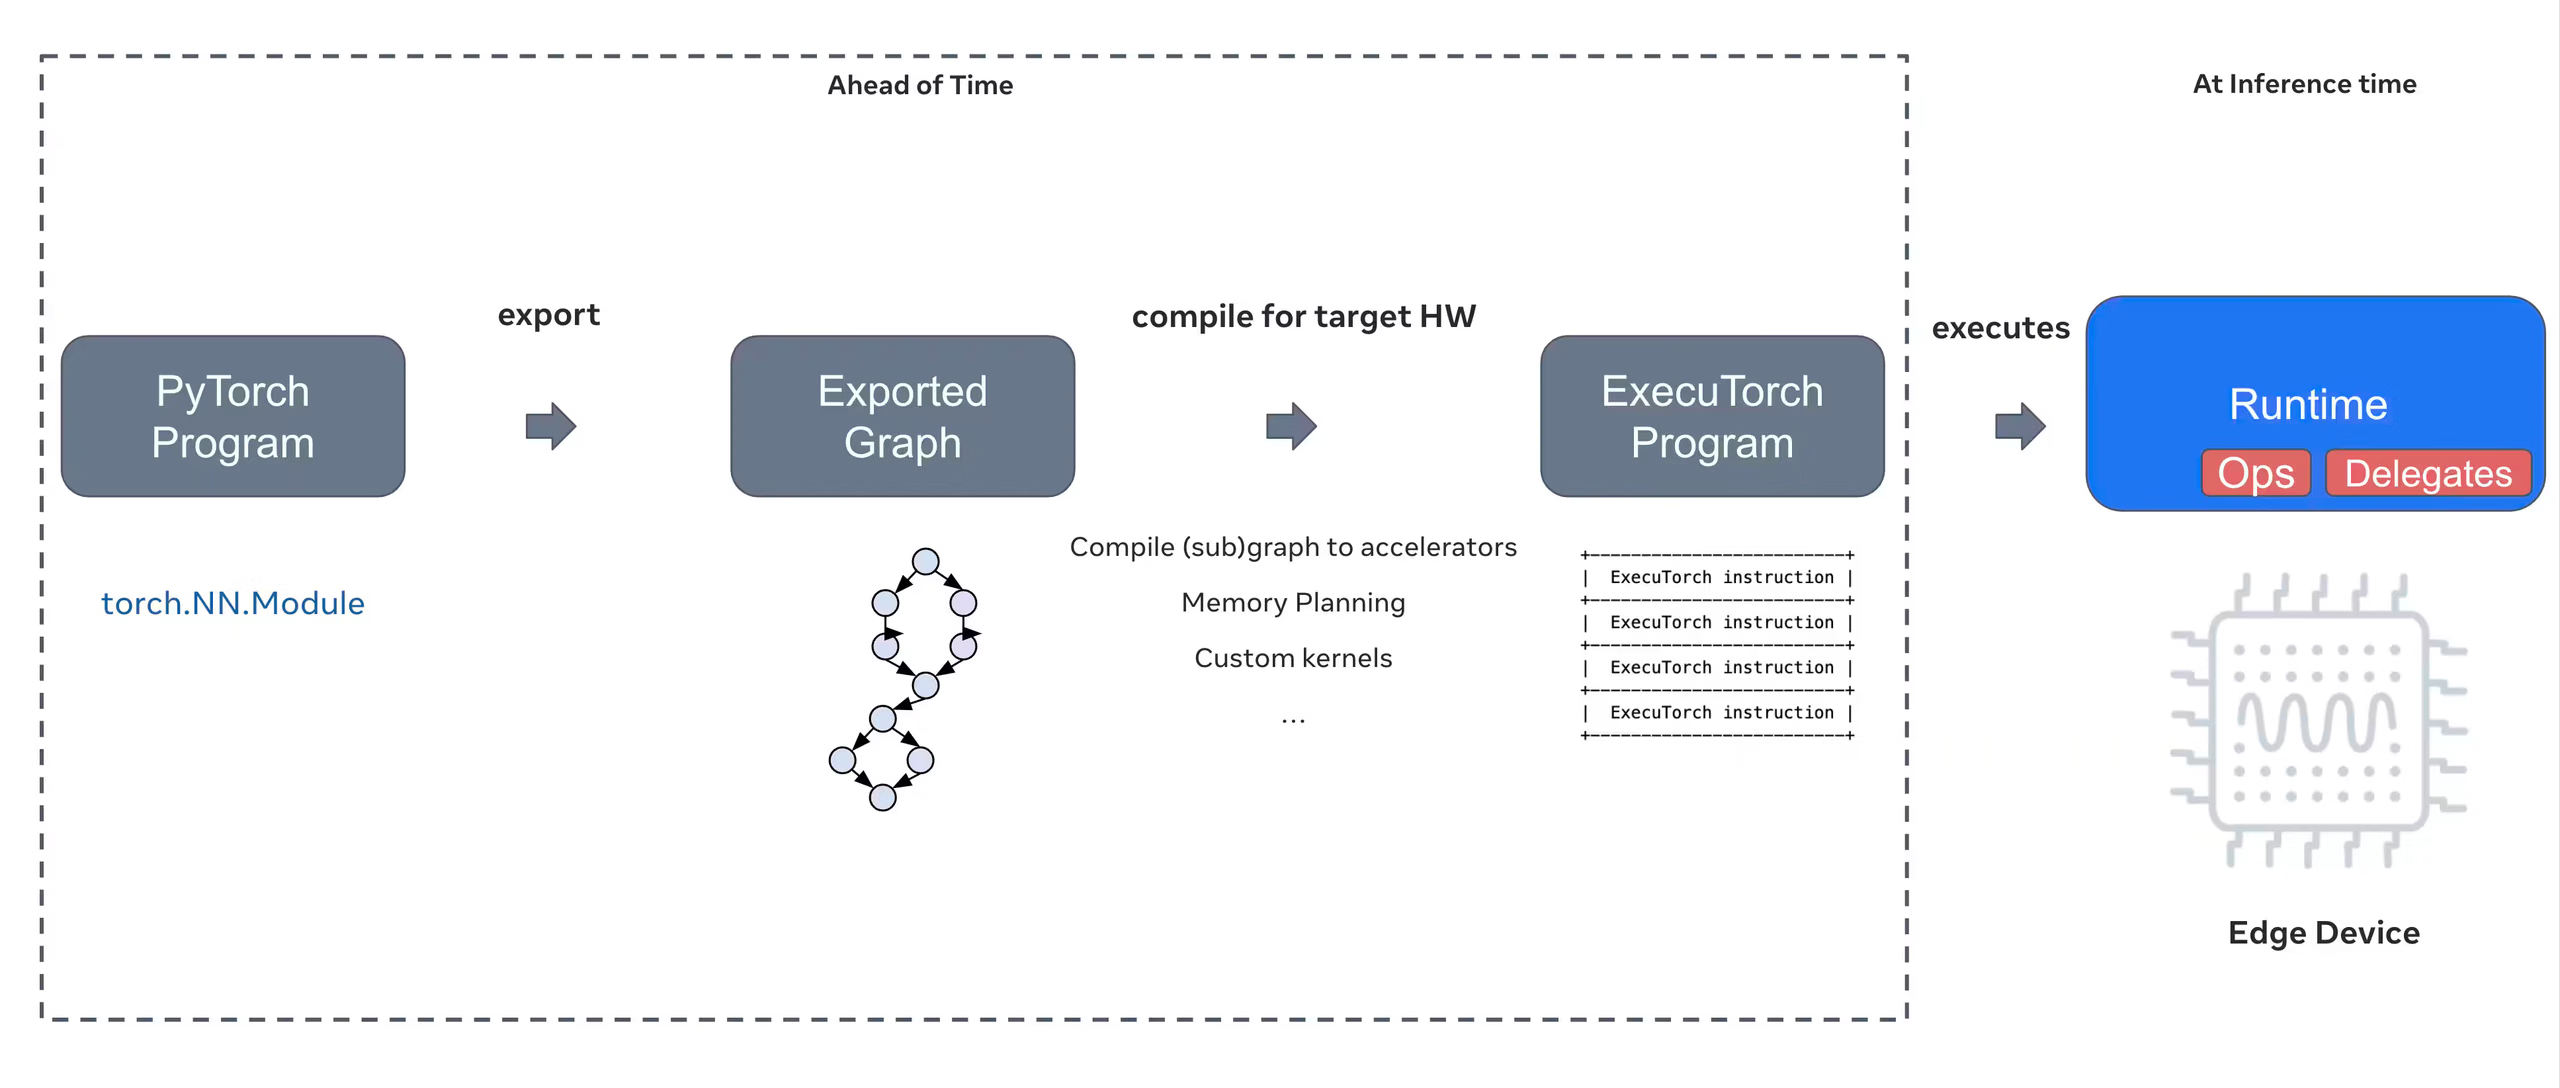
ExecuTorch ist PyTorchs umfassende Lösung für Inferenz direkt auf dem Gerät – auf Mobilgeräten und Edge-Geräten. ExecuTorch wurde für Portabilität und Effizienz entwickelt und kann PyTorch-Programme auf einer Vielzahl von Computerplattformen ausführen.
Wichtige Funktionen von ExecuTorch#
ExecuTorch bietet mehrere leistungsstarke Funktionen zur Bereitstellung von Ultralytics-YOLO-Modellen auf Edge-Geräten:
-
Portables Modellformat: ExecuTorch verwendet das Format
.pte(PyTorch ExecuTorch), das für geringe Größe und schnelles Laden auf Geräten mit begrenzten Ressourcen optimiert ist. -
XNNPACK-Backend: Die standardmäßige Integration von XNNPACK ermöglicht eine stark optimierte Inferenz auf mobilen CPUs und bietet hervorragende Leistung, ohne spezielle Hardware zu erfordern.
-
Für Quantisierung geeignet: Das ExecuTorch-Ökosystem unterstützt Quantisierungstechniken, mit denen sich die Modellgröße verringern und die Inferenz beschleunigen lässt. Ultralytics exportiert derzeit FP32-Modelle über das XNNPACK-Backend.
-
Speichereffizienz: Eine optimierte Speicherverwaltung verringert den Speicherbedarf zur Laufzeit und eignet sich damit für Geräte mit begrenztem RAM.
-
Modellmetadaten: Exportierte Modelle enthalten Metadaten (Bildgröße, Klassennamen usw.) in einer separaten YAML-Datei, um die Integration zu erleichtern.
Bereitstellungsoptionen mit ExecuTorch#
ExecuTorch-Modelle lassen sich auf verschiedenen Edge- und Mobilplattformen bereitstellen:
-
Mobile Anwendungen: Stelle Modelle mit nativer Leistung in iOS- und Android-Anwendungen bereit und ermögliche so die Objekterkennung in Echtzeit in mobilen Apps.
-
Eingebettete Systeme: Führe Modelle mit optimierter Leistung auf eingebetteten Linux-Geräten wie Raspberry Pi, NVIDIA Jetson und anderen ARM-basierten Systemen aus.
-
Edge-AI-Geräte: Stelle Modelle auf spezialisierter Edge-AI-Hardware bereit und nutze benutzerdefinierte Delegates zur Beschleunigung der Inferenz.
-
IoT-Geräte: Integriere Modelle in IoT-Geräte, um Inferenz direkt auf dem Gerät ohne Cloud-Verbindung auszuführen.
Unterstützte Aufgaben#
Der ExecuTorch-Export unterstützt alle sieben Ultralytics-Aufgaben. Semantische Segmentierung und Tiefenschätzung sind nur mit YOLO26 verfügbar, der einzigen Modellfamilie, die diese Modellköpfe enthält.
| Aufgabe | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Erkennung | ✅ | ✅ | ✅ |
| Segmentierung | ✅ | ✅ | ✅ |
| Semantik | ❌ | ❌ | ✅ |
| Tiefe | ❌ | ❌ | ✅ |
| Klassifizierung | ✅ | ✅ | ✅ |
| Pose | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Ultralytics-YOLO26-Modelle nach ExecuTorch exportieren#
Durch die Konvertierung von Ultralytics-YOLO26-Modellen in das ExecuTorch-Format lassen sie sich effizient auf Mobilgeräten und Edge-Geräten bereitstellen.
Installation#
Für den ExecuTorch-Export sind Python 3.10–3.14 und PyTorch >= 2.9.0 erforderlich. Ultralytics installiert ein kompatibles Paket executorch, wenn du ein ExecuTorch-Modell exportierst oder lädst. Bei PyTorch-Versionen älter als 2.13 wird das Paket auf executorch<1.5 festgelegt. Aktualisiere es daher nicht manuell.
# Install Ultralytics package
pip install ultralytics
Ausführliche Anweisungen und bewährte Vorgehensweisen zur Installation findest du in unserem Installationsleitfaden für YOLO26. Wenn bei der Installation der erforderlichen Pakete für YOLO26 Probleme auftreten, findest du Lösungen und Tipps in unserem Leitfaden zu häufigen Problemen.
Verwendung#
Der Export von YOLO26-Modellen nach ExecuTorch ist unkompliziert:
Das ExecuTorch-Format unterstützt die Modi Exportieren, Vorhersagen und Validieren. Exportiere dein Modell und lade es anschließend, um Inferenz auszuführen oder seine Genauigkeit zu validieren.
from ultralytics import YOLO

# Ein YOLO26-Modell laden
model = YOLO("yolo26n.pt")

# Das Modell in das ExecuTorch-Format exportieren
model.export(format="executorch") # creates 'yolo26n_executorch_model'from ultralytics import YOLO
# Das exportierte ExecuTorch-Modell laden
model = YOLO("yolo26n_executorch_model")
# Inferenz ausführen
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Das exportierte ExecuTorch-Modell laden
model = YOLO("yolo26n_executorch_model")
# Die Genauigkeit anhand des COCO8-Datensatzes validieren
metrics = model.val(data="coco8.yaml")Beim ExecuTorch-Export wird ein Verzeichnis mit einer Datei .pte und den Metadaten erstellt. Lade das Modell .pte mit der ExecuTorch-Laufzeitumgebung in deiner mobilen oder eingebetteten Anwendung und führe die Inferenz aus.
Exportargumente#
Beim Export in das ExecuTorch-Format kannst du die folgenden Argumente angeben:
| Argument | Typ | Standard | Beschreibung |
|---|---|---|---|
format | str | 'executorch' | Zielformat des exportierten Modells, das die Kompatibilität mit verschiedenen Bereitstellungsumgebungen festlegt. |
imgsz | int oder tuple | 640 | Gewünschte Bildgröße für die Modelleingabe. Kann eine Ganzzahl für quadratische Bilder oder ein Tupel (height, width) für bestimmte Abmessungen sein. |
quantize | int oder str | None | Export ausschließlich mit FP32. Der ExecuTorch-Export unterstützt keine Konvertierung der Präzision in FP16, INT8 oder W8A16 während des Exports. |
batch | int | 1 | Gibt die Batchgröße für die Inferenz des Exportmodells oder die Höchstzahl der Bilder an, die das exportierte Modell gleichzeitig im predict-Modus verarbeiten kann. |
device | str | None | Legt das Exportgerät fest: GPU (device=0), CPU (device=cpu), MPS für Apple Silicon (device=mps). |
Ausgabestruktur#
Beim ExecuTorch-Export wird ein Verzeichnis mit dem Modell und den Metadaten erstellt:
yolo26n_executorch_model/
├── model.pte               # ExecuTorch model file
└── metadata.yaml           # Model metadata (classes, image size, etc.)
Exportierte ExecuTorch-Modelle verwenden#
Nach dem Export musst du dein Modell mithilfe der ExecuTorch-Laufzeitumgebung in deine Zielanwendung integrieren.
Integration in mobile Anwendungen#
Für mobile Anwendungen (iOS/Android) musst du:
- ExecuTorch-Laufzeitumgebung hinzufügen: Binde die ExecuTorch-Laufzeitbibliothek in dein mobiles Projekt ein.
- Modell laden: Lade die Datei
.ptein deiner Anwendung. - Inferenz ausführen: Verarbeite Bilder und rufe Vorhersagen ab.
iOS#
Beispiel für eine iOS-Integration (Objective-C/C++):
// iOS uses C++ APIs for model loading and inference
// See https://pytorch.org/executorch/stable/using-executorch-ios.html for complete examples

#include <executorch/extension/module/module.h>

using namespace ::executorch::extension;

// Load the model
Module module("/path/to/model.pte");

// Create input tensor
float input[1 * 3 * 640 * 640];
auto tensor = from_blob(input, {1, 3, 640, 640});

// Run inference
const auto result = module.forward(tensor);Android#
Füge das ExecuTorch Android AAR aus Maven Central hinzu:
dependencies {
    implementation("org.pytorch:executorch-android:<version>")
}
Beispiel für eine Android-Integration (Kotlin):
import org.pytorch.executorch.EValue
import org.pytorch.executorch.Module
import org.pytorch.executorch.Tensor

// Load the model
val module = Module.load("/path/to/model.pte")

// Prepare input tensor
val inputTensor = Tensor.fromBlob(floatData, longArrayOf(1, 3, 640, 640))
val inputEValue = EValue.from(inputTensor)

// Run inference
val outputs = module.forward(inputEValue)
val scores = outputs[0].toTensor().dataAsFloatArray
Eingebettetes Linux#
Verwende für eingebettete Linux-Systeme die ExecuTorch-C++-API:
#include <executorch/extension/module/module.h>
#include <executorch/extension/tensor/tensor.h>

using namespace ::executorch::extension;

// Load model
Module module("model.pte");

// Prepare input
std::vector<float> input_data = preprocessImage(image);
auto input_tensor = from_blob(input_data.data(), {1, 3, 640, 640});

// Run inference
const auto outputs = module.forward(input_tensor);
Weitere Informationen zur Integration von ExecuTorch in deine Anwendungen findest du in der ExecuTorch-Dokumentation.
Leistungsoptimierung#
Optimierung der Modellgröße#
So reduzierst du die Modellgröße für den Einsatz:
- Kleinere Modelle verwenden: Beginne mit YOLO26n (nano), um den Speicherbedarf möglichst gering zu halten
- Eingabeauflösung verringern: Verwende kleinere Bildgrößen (z. B.
imgsz=320oderimgsz=416) - Quantisierung: Wende Quantisierungstechniken von ExecuTorch außerhalb von Ultralytics an (der ExecuTorch-Export von Ultralytics unterstützt nur FP32)
Optimierung der Inferenzgeschwindigkeit#
So beschleunigst du die Inferenz:
- XNNPACK-Backend: Das standardmäßige XNNPACK-Backend ermöglicht eine optimierte CPU-Inferenz
- Hardwarebeschleunigung: Verwende plattformspezifische Delegates (z. B. CoreML für iOS)
- Stapelverarbeitung: Verarbeite nach Möglichkeit mehrere Bilder gleichzeitig
Benchmarks#
Das Ultralytics-Team hat YOLO26-Modelle einem Benchmark unterzogen und dabei Geschwindigkeit und Genauigkeit von PyTorch und ExecuTorch verglichen.
| Modell | Format | Status | Größe (MB) | metrics/mAP50-95(B) | Inferenzzeit (ms/Bild) |
|---|---|---|---|---|---|
| YOLO26n | PyTorch | ✅ | 5.3 | 0.4790 | 314.80 |
| YOLO26n | ExecuTorch | ✅ | 9.4 | 0.4800 | 142 |
| YOLO26s | PyTorch | ✅ | 19.5 | 0.5730 | 930.90 |
| YOLO26s | ExecuTorch | ✅ | 36.5 | 0.5780 | 376.1 |
Die Inferenzzeit umfasst keine Vor- und Nachverarbeitung.
Fehlerbehebung#
Häufige Probleme#
Problem: Python version error
Lösung: ExecuTorch erfordert Python 3.10 bis 3.14. Erstelle eine Umgebung mit einer unterstützten Version:
# Using conda
conda create -n executorch python=3.14
conda activate executorch
Weitere Hilfe bei der Fehlerbehebung findest du unter Ultralytics GitHub Issues oder in der ExecuTorch-Dokumentation.
Zusammenfassung#
Durch den Export von YOLO26-Modellen ins ExecuTorch-Format lassen sie sich effizient auf Mobilgeräten und Edge-Geräten einsetzen. Dank der nativen PyTorch-Integration, der plattformübergreifenden Unterstützung und der optimierten Leistung eignet sich ExecuTorch hervorragend für Edge-AI-Anwendungen.
Die wichtigsten Punkte:
- ExecuTorch ermöglicht die native Bereitstellung von PyTorch-Modellen auf Edge-Geräten und bietet hervorragende Leistung
- Der Export erfolgt ganz einfach mit dem Parameter
format='executorch' - Modelle werden mit dem XNNPACK-Backend für mobile CPUs optimiert
- Unterstützt iOS, Android und eingebettete Linux-Plattformen
- Erfordert Python 3.10–3.14 und PyTorch >= 2.9.0
Häufig gestellte Fragen#
Exportiere ein YOLO26-Modell mit Python oder CLI nach ExecuTorch:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(format="executorch")
oder
yolo export model=yolo26n.pt format=executorchFür den ExecuTorch-Export benötigst du:
- Python 3.10 bis 3.14
- Das Paket
executorch, das automatisch installiert wird (executorch<1.5bei PyTorch-Versionen vor 2.13, die von neueren ExecuTorch-Laufzeitumgebungen nicht unterstützt werden) - PyTorch (wird automatisch mit ultralytics installiert)
Hinweis: Das Paket
executorchenthält vorgefertigte Wheels (mit dem XNNPACK-Backend), sodass beim Export kein zusätzlicher Kompilierungsschritt erforderlich ist.ExecuTorch-Modelle lassen sich für Inferenz und Validierung direkt mit
YOLO()in Python laden (siehe die Beispiele für Predict/Validate oben). Außerdem können sie mithilfe der ExecuTorch-Laufzeitbibliotheken auf Mobilgeräten und Edge-Geräten eingesetzt werden.ExecuTorch unterstützt:
- Mobilgeräte: iOS und Android
- Eingebettetes Linux: Raspberry Pi, NVIDIA Jetson und andere ARM-Geräte
- Desktop: Linux, macOS und Windows (für die Entwicklung)
Sowohl ExecuTorch als auch LiteRT eignen sich hervorragend für den Einsatz auf Mobilgeräten:
- ExecuTorch: Bessere PyTorch-Integration, nativer PyTorch-Workflow, wachsendes Ökosystem
- LiteRT: Ausgereifter, breitere Hardwareunterstützung, mehr Beispiele für die Bereitstellung; außerdem wird dasselbe Modell auf Android, iOS und im Browser ausgeführt
Wähle ExecuTorch, wenn du bereits PyTorch verwendest und einen nativen Weg für die Bereitstellung suchst. Wähle LiteRT für maximale Kompatibilität und ausgereifte Werkzeuge.
Ja! ExecuTorch unterstützt Hardwarebeschleunigung über verschiedene Backends:
- Mobile GPU: Über Vulkan-, Metal- oder OpenCL-Delegates
- NPU/DSP: Über plattformspezifische Delegates
- Standard: XNNPACK für optimierte CPU-Inferenz
Eine Anleitung zur Einrichtung der einzelnen Backends findest du in der ExecuTorch-Dokumentation.