ONNX-Export für YOLO26-Modelle
ONNX (Austausch offener neuronaler Netze) ist ein offenes Modellformat, das von den meisten Inferenz-Laufzeitumgebungen geladen werden kann. Beim Export eines Ultralytics YOLO26-Modells mit format="onnx" wird eine einzelne .onnx-Datei erstellt, die mit ONNX Runtime auf CPUs, NVIDIA- und AMD-GPUs, Apple Silicon und Windows-Geräten ausgeführt werden kann.
Auf einen Blick#
| Eigenschaft | Details |
|---|---|
Argument format | onnx |
| Ausgabe | yolo26n.onnx, eine Datei mit Klassennamen, Aufgabe und Bildgröße als Metadaten; yolo26n_int8.onnx für einen kalibrierten quantize=8-Export |
| Ausführbar auf | CPUs, NVIDIA-GPUs (CUDA), AMD-GPUs (MIGraphX), Apple Silicon (Core ML-Ausführungsanbieter) und Windows ML-Geräten |
| Laufzeitumgebung | ONNX Runtime oder OpenCV DNN mit dnn=True |
| Precision | FP32, FP16, INT8. YOLO26n ist 9,9 MB groß in FP32, 5,0 MB in FP16 und 3,1 MB in INT8 |
| Exportrechner | Linux, macOS oder Windows, mit oder ohne GPU |
Die Ultralytics Platform kann ein trainiertes Modell für dich nach ONNX exportieren, sodass du keine lokale Exportumgebung benötigst.
Schnellstart#
Installiere das Ultralytics-Paket. Beim ersten Export werden onnx, onnxslim und onnxruntime installiert, falls sie fehlen (onnxruntime-gpu, wenn du mit device=0 auf einer NVIDIA-GPU exportierst).
pip install ultralyticsWeitere Installationsmethoden findest du in der Installationsanleitung. Anschließend exportierst du dein Modell und lädst die exportierte Datei, um Inferenz auszuführen oder die Genauigkeit zu validieren.
from ultralytics import YOLO

# Ein YOLO26-Modell laden
model = YOLO("yolo26n.pt")

# Exportiere das Modell in das ONNX-Format
model.export(format="onnx")  # erstellt 'yolo26n.onnx'

# Ein INT8-quantisiertes ONNX-Modell mit Kalibrierungsdaten exportieren
model.export(format="onnx", quantize=8, data="coco8.yaml") # Erstellt „yolo26n_int8.onnx“from ultralytics import YOLO
# Das exportierte ONNX-Modell laden
model = YOLO("yolo26n.onnx")
# Inferenz ausführen
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Das exportierte ONNX-Modell laden
model = YOLO("yolo26n.onnx")
# Die Genauigkeit anhand des COCO8-Datensatzes validieren
metrics = model.val(data="coco8.yaml")Unterstützte Aufgaben#
Der ONNX-Export unterstützt alle sieben Ultralytics-Aufgaben mit YOLOv8-, YOLO11- und YOLO26-Modellen: Objekterkennung, Segmentierung, semantische Segmentierung, Tiefenschätzung, Klassifizierung, Posenschätzung und OBB. Semantische Segmentierung und Tiefenschätzung sind nur mit YOLO26 verfügbar, der einzigen Modellfamilie, die diese Köpfe enthält.
Exportargumente#
| Argument | Typ | Standard | Beschreibung |
|---|---|---|---|
format | str | 'onnx' | Zielformat des exportierten Modells, das die Kompatibilität mit verschiedenen Bereitstellungsumgebungen festlegt. |
imgsz | int oder tuple | 640 | Bildgröße der Modelleingabe: eine Ganzzahl für quadratische Bilder oder ein Tupel (height, width). Wenn nicht angegeben, verwendet der Export die Größe, mit der der Checkpoint trainiert wurde. Die offiziellen YOLO26-Checkpoints verwenden 640 für Erkennung, Segmentierung, Posenschätzung und auf ADE20K vortrainierte semantische Modelle, 1024 für OBB und auf Cityscapes vortrainierte semantische Modelle, 768 für Tiefenschätzung und 224 für Klassifizierung. |
quantize | int oder str | None | Quantisierungsgenauigkeit: 16 (FP16; bei einem CPU-Export bleiben Eingaben und Ausgaben in FP32, bei einem GPU-Export werden auch sie in FP16 umgewandelt) oder 8 (statische INT8-Quantisierung mit ONNX Runtime unter Verwendung von Kalibrierungsbildern aus data; dabei entsteht ein _int8.onnx-Modell); 32/nicht festgelegt bedeutet FP32. Ein mit quantize=8 trainierter Checkpoint wird mit nicht festgelegtem quantize oder mit 8 als INT8 exportiert (andere Werte führen zu einem Fehler), und zwar als Q/DQ-Knoten anhand der enthaltenen Wertebereiche, ohne Kalibrierung und unter dem einfachen Namen .onnx. Ersetzt die veralteten Optionen half/int8. |
data | str | None | Für die INT8-Kalibrierung verwendete Dataset-YAML-Datei; bei der Klassifizierung wird stattdessen ein Dataset-Verzeichnis oder ein integrierter Dataset-Name angegeben. Wird die Option zusammen mit quantize=8 weggelassen, wählt Ultralytics den standardmäßigen Kalibrierungsdatensatz für die Modellaufgabe aus; bei einem mit quantize=8 trainierten Checkpoint ist keine Kalibrierung erforderlich. |
fraction | float, int oder list | 1.0 | Kalibrierungsteilstichprobe als Verhältnis, Bildanzahl oder [train, val, test]-Verhältnisse/-Anzahlen. Bei Listen mit zwei Elementen bleibt test vollständig erhalten, während 0 es überspringt. |
dynamic | bool | False | Macht Batch, Höhe und Breite der Eingabe zu dynamischen Achsen, sodass eine Datei verschiedene Batchgrößen (bis zum Exportwert batch mit nms=True) und Bildgrößen akzeptiert. Siehe dynamischer Export. |
simplify | bool | True | Vereinfacht den Modellgraphen mit onnxslim. |
opset | int | None | Legt die ONNX-Operatorsatzversion fest, um die Kompatibilität mit verschiedenen ONNX-Parsern und Laufzeitumgebungen sicherzustellen. Wenn nicht angegeben, wird Operatorsatz 18 verwendet (niedriger bei PyTorch < 2.4), begrenzt auf die installierte Version onnx. Siehe Mindest-Operatorsatz. |
nms | bool, optional | None | Wählt die Rohausgabe (None, Standard), eingebettetes NMS (True) oder den NMS-freien Kopf (False) aus. Siehe Ausgabeformat. |
batch | int | 1 | Batchgröße des exportierten Modells. Bei einem statischen Export ist diese Batchgröße in der Eingabeform festgelegt. Verwende mit dynamic=True und nms=True die größte Batchgröße, die du ausführen möchtest. |
device | str | None | Gerät für den Export: cpu (Standard, auch auf einem Rechner mit GPU), 0 für eine CUDA-GPU oder mps für Apple Silicon. Dies wirkt sich nur auf quantize=16 aus; siehe FP16-Eingaben. |
Die für alle Formate geltenden Argumente findest du in der Dokumentation zum Exportmodus.
INT8-Quantisierung#
Bei Checkpoints, die nicht mit quantisierungsbewusstem Training trainiert wurden, wendet quantize=8 die statische Quantisierung von ONNX Runtime nur auf die Knoten Conv, Gemm und MatMul an. Alle anderen Knoten bleiben im Gleitkommaformat, darunter auch die Operationen, die output0 zusammensetzen: Box-Koordinaten (Pixel) und Klassenbewertungen (0 bis 1) teilen sich diesen Tensor, sodass eine einzige INT8-Skalierung dafür jede Klassenbewertung auf null runden würde. Ab Opset 13 werden Gewichte pro Kanal quantisiert. Schließe dieselben Knoten aus und setze per_channel=True, wenn du quantize_static selbst auf ein exportiertes FP32-Modell anwendest:
import onnx
from onnxruntime.quantization import quantize_static

model = "yolo26n.onnx"
exclude = [n.name for n in onnx.load(model).graph.node if n.op_type not in {"Conv", "Gemm", "MatMul"}]
quantize_static(model, "yolo26n_int8.onnx", calibration_reader, nodes_to_exclude=exclude, per_channel=True)
Hier ist calibration_reader ein onnxruntime.quantization.CalibrationDataReader, das {"images": array} mit der Batchgröße des Modells liefert und wie für die Inferenz vorverarbeitet wurde: Letterboxing auf die Exportgröße (für die Klassifizierung skaliert und mittig zugeschnitten), RGB, NCHW, float32 im Bereich von 0 bis 1.
Ein INT8-Modell behält die Eingabe- und Ausgabetypen des FP32-Modells bei, sodass für das FP32-Modell geschriebener Inferenzcode unverändert funktioniert. INT8 verkleinert die Datei im Vergleich zu FP32 um das Drei- bis Vierfache, lief in den Benchmarks mit ONNX Runtime auf GPU und CPU jedoch langsamer als FP32. Miss die Latenz auf deiner Zielhardware, bevor du dich für eine Genauigkeit entscheidest.
Ausgabeformat#
Das exportierte Modell erwartet eine Eingabe namens images mit der Form (batch, 3, height, width), in RGB und auf den Bereich 0 bis 1 skaliert. Der Eingabetyp ist float32, außer bei GPU-Exporten mit quantize=16; diese erwarten float16. Das Argument nms legt das Layout von output0 fest. Die folgenden Formen gelten für ein YOLO26n-Erkennungsmodell mit 80 Klassen, exportiert mit imgsz=640:
nms | Form von output0 | Inhalt |
|---|---|---|
None (Standard) | (1, 84, 8400) | Für jeden der 8400 Anker: Boxmittelpunkt x, Mittelpunkt y, Breite und Höhe in Eingabepixeln, gefolgt von 80 Klassenwerten. Wende NMS selbst an. |
True | (1, 300, 6) | NMS wird innerhalb des Modells ausgeführt. Jede Zeile hat die Form x1, y1, x2, y2, score, class; Zeilen nach der letzten Erkennung enthalten Nullen. |
False | (1, 300, 6) | NMS-freier Kopf. Jede Zeile hat die Form x1, y1, x2, y2, score, class, ohne NMS-Schritt. Filtere die Zeilen selbst anhand des Konfidenzwerts. |
Die übrigen Aufgaben verwenden dieselbe Eingabe und folgende Ausgaben. Die Formen gelten für die offiziellen YOLO26n-Checkpoints mit ihrer standardmäßigen Exportgröße; für die semantische Segmentierung ist der Cityscapes-Checkpoint yolo26n-sem.pt angegeben:
| Aufgabe | Standardmäßiges imgsz | Ausgabe mit nms=None | Ausgabe mit nms=False oder nms=True |
|---|---|---|---|
| Detect | 640 | output0 (1, 84, 8400) | output0 (1, 300, 6) |
| Segment | 640 | output0 (1, 116, 8400), output1 (1, 32, 160, 160) | output0 (1, 300, 38), output1 (1, 32, 160, 160) |
| Semantisch | 1024 | output0 (1, 1024, 1024), uint8 Klassenindex für jedes Pixel | Wie nms=None |
| Tiefe | 768 | output0 (1, 1, 768, 768), Tiefenkarte | Wie nms=None |
| Klassifizieren | 224 | output0 (1, 1000), Klassenwahrscheinlichkeiten nach Softmax | Wie nms=None für nms=False; nms=True führt zu einem Fehler |
| Pose | 640 | output0 (1, 56, 8400) | output0 (1, 300, 57): 6 Boxwerte, gefolgt von 17 Keypoints × 3 |
| OBB | 1024 | output0 (1, 20, 21504) | output0 (1, 300, 7): center x, center y, width, height, score, class, angle (Radiant) |
Segmentierungszeilen enthalten nach den Boxwerten 32 Maskenkoeffizienten, und output1 enthält die Maskenprototypen. Bei FP32- und INT8-Modellen haben alle Ausgaben den Typ float32, mit Ausnahme der semantischen Klassenkarte.
Mit nms=True werden der Konfidenzschwellenwert conf (Standard: 0.25), der IoU-Schwellenwert iou (Standard: 0.5), agnostic_nms und max_det (Standard: 300) beim Export fest in den Graphen übernommen. Ein niedrigerer Wert für conf zur Vorhersagezeit kann Erkennungen, die der Graph bereits entfernt hat, nicht wiederherstellen. Exportiere das Modell daher erneut, um diese Werte zu ändern. max_det und agnostic_nms gelten auch für nms=False: max_det=100 ergibt die Form (1, 100, 6) für output0.
YOLO("yolo26n.onnx") liest das Layout aus den Dateimetadaten. Daher benötigst du diese Formen nur, wenn du das Modell in eigenem Code ausführst. Die Metadaten stehen deinem Code auch als Zeichenfolgen zur Verfügung: names, task, imgsz, stride, batch, end2end und args.
import ast

import onnxruntime as ort

meta = ort.InferenceSession("yolo26n.onnx").get_modelmeta().custom_metadata_map
names = ast.literal_eval(meta["names"])  # {0: 'person', 1: 'bicycle', ...}
imgsz = ast.literal_eval(meta["imgsz"]) # [640, 640]Bereitstellen#
YOLO("yolo26n.onnx") führt das Modell mit ONNX Runtime aus und wählt den Ausführungsanbieter anhand des Arguments device aus. Auf einem Rechner mit CUDA-GPU wird die GPU verwendet, wenn device nicht festgelegt ist.
device | Ausführungsanbieter |
|---|---|
cpu | CPUExecutionProvider |
0 auf einer NVIDIA-GPU | CUDAExecutionProvider, aus dem Paket onnxruntime-gpu, das bei der ersten Verwendung installiert wird |
0 auf einer AMD-ROCm-GPU | MIGraphXExecutionProvider, siehe AMD-GPU-Inferenz mit MIGraphX |
mps auf Apple Silicon | CoreMLExecutionProvider für Knoten mit statischen Formen; Knoten mit dynamischen Formen werden auf CPUExecutionProvider ausgeführt |
Die Protokollzeile Using ONNX Runtime 1.31.1 with CUDAExecutionProvider zeigt, welcher Anbieter aktiv ist. Das Verhalten zur Inferenzzeit hängt davon ab, wie das Modell exportiert wurde:
- Statischer Export (Standard): Das Modell wird immer mit den Exportwerten
imgszundbatchausgeführt, die Ultralytics aus den Dateimetadaten ausliest. Ein anpredictübergebenesimgszwird ignoriert. Größere Batches werden in Abschnitte mit der Export-Batchgröße aufgeteilt, kleinere werden aufgefüllt, sodass beliebig viele Bilder verarbeitet werden können. - Dynamischer Export (
dynamic=True):predictakzeptiert jedesimgsz, das ein Vielfaches des Modell-Strides ist. Die Batchgröße kann variieren, ist mitnms=Truejedoch auf den beim Export verwendeten Wertbatchbegrenzt. Lege diesen daher auf die größte Batchgröße fest, die du ausführen möchtest. - GPU-Speicher: Bei
CUDAExecutionProviderverwendet ein statisches Modell das IO-Binding von ONNX Runtime, wodurch Eingabe- und Ausgabetensoren auf der GPU bleiben. Bei einem dynamischen Modell werden sie bei jedem Aufruf über den CPU-Speicher kopiert. - CPU-Threads: Ultralytics begrenzt ONNX Runtime auf 8 Intra-op-Threads oder auf die Anzahl der physischen CPU-Kerne, die dem Prozess zur Verfügung stehen, falls diese niedriger ist. Lege die Umgebungsvariable
ORT_INTRA_OP_NUM_THREADSfest, um eine andere Anzahl zu verwenden.
Übergib dnn=True an predict oder val, um das Modell mit OpenCV DNN statt ONNX Runtime auf der CPU auszuführen. OpenCV DNN unterstützt weniger Exportoptionen; siehe Einschränkungen und Fehlerbehebung.
Informationen zur Ausführung des Modells außerhalb des Ultralytics-Pakets findest du in diesen Ressourcen:
- ONNX Runtime Python API: Lade ein ONNX-Modell in Python und führe es aus.
- ONNX Runtime-Ausführungsanbieter: Hardware-Backends wie CUDA, TensorRT, OpenVINO, Core ML und DirectML.
- Ultralytics-Beispiele: ONNX-Runtime-Inferenz in Python, C++ und Rust sowie OpenCV-DNN-Inferenz in Python.
- Triton Inference Server: Stelle das ONNX-Modell über HTTP oder gRPC mit NVIDIA Triton bereit.
- Bereitstellung auf Edge-Geräten: ONNX-Runtime-Anleitungen für IoT- und Edge-Hardware.
Windows-ML-Inferenz#
Unter Windows 11 24H2 (Build 26100) oder neuer mit Python 3.10+ kannst du onnxruntime-windowsml in einer separaten Umgebung installieren, damit Windows ML Ausführungsanbieter auswählen kann, die für deine Hardware geeignet sind. Installiere es anstelle anderer ONNX Runtime-Builds und verwende dann dasselbe exportierte .onnx-Modell mit YOLO("model.onnx"). Das Backend übernimmt die Anzahl der PyTorch-Threads und die übergebenen Sitzungsoptionen, einschließlich einer expliziten Richtlinie für Anbieter. Wenn keine Richtlinie übergeben wird, wählt Windows ML die Hardware für maximale Leistung aus, auch wenn das PyTorch-Gerät cpu ist. Miss die Vorhersagelatenz auf deinem Gerät, bevor du diese Laufzeitumgebung auswählst; sie ist optional und wird nicht standardmäßig installiert.
Auf integrierten GPUs, die sich die Stromversorgung mit der CPU teilen, können untätige PyTorch-Threads bei der Vor- und Nachverarbeitung die Windows-ML-Inferenz verlangsamen. Rufe torch.set_num_threads(1) vor der Vorhersage auf, um das zu verringern. Die Änderung gilt für den gesamten Prozess, sodass auch andere PyTorch-Modelle in diesem Prozess mit nur einem Thread ausgeführt werden.
import torch

from ultralytics import YOLO

torch.set_num_threads(1)  # Optional, auf deinem Gerät messen
results = YOLO("yolo26n.onnx")("https://ultralytics.com/images/bus.jpg")
AMD-GPU-Inferenz mit MIGraphX#
Ultralytics führt exportierte ONNX-Modelle auf AMD-GPUs über den ONNX-Runtime-MIGraphX-Ausführungsanbieter aus. Auf einem ROCm-(HIP-)System mit Python 3.11 oder neuer auf x86-64 installiert das ONNX-Backend beim ersten Verwenden das Plugin onnxruntime-ep-migraphx und wählt MIGraphXExecutionProvider automatisch aus, ohne dass Codeänderungen nötig sind. Alle YOLO26-Aufgaben werden unterstützt. Voraussetzungen, Installation, Verwendung, Benchmarks und den Cache für kompilierte Programme findest du in der Anleitung zur AMD-GPU-Inferenz.
Einschränkungen und Fehlerbehebung#
- Mindest-Operatorsatz: Der Export schlägt mit
ONNX export requires opset>=Nfehl, wennopsetfür das Modell zu niedrig ist. Der Mindestwert ist7für Klassifizierung,9für Erkennung, Segmentierung, semantische Segmentierung, Posenschätzung und OBB,11für Tiefenschätzung sowie für Erkennungs-, Segmentierungs-, Posenschätzungs- und OBB-Modelle, die mitnms=Trueexportiert wurden, und16für RT-DETR. - FP16-Eingaben: Ein auf einer GPU exportiertes FP16-Modell (
quantize=16 device=0) erwartet in deinem eigenen Code FP16-Eingabetensoren. Bei einem auf einer CPU exportierten FP16-Modell bleiben Eingaben und Ausgaben in FP32 und werden innerhalb des Graphen konvertiert.YOLO()liefert beiden Modellen auf GPU und CPU den passenden Eingabetyp. - INT8-Dateiname:
quantize=8schreibtyolo26n_int8.onnxund entfernt die FP32-Zwischendatei. Lade daher für die Inferenz die Datei_int8. Eine Ausnahme ist ein mitquantize=8trainierter Checkpoint: Sein Export schreibt Q/DQ-Knoten inyolo26n.onnxund überspringt die Kalibrierung. - INT8-Kalibrierungsgröße: Bei einem nicht mit
quantize=8trainierten Checkpoint wird beim Export eine Warnung ausgegeben, wenn der Kalibrierungssplit weniger als 300 Bilder enthält. Standardmäßig wird der Splitvalzur Kalibrierung verwendet.coco8.yamlenthält nur 4 Validierungsbilder; verwende daher für ein Modell, das du bereitstellen möchtest, deinen eigenen Datensatz. - Eingebettetes NMS:
nms=Trueerfordert PyTorch 1.13 oder neuer. Bei Klassifizierung wird'nms=True' is not valid for classification modelsausgelöst; bei Modellen für semantische Segmentierung, Tiefenschätzung und RT-DETR wird die Option mit einer Warnung ignoriert. - NMS-freier Kopf:
nms=Falseerfordert ein Modell mit NMS-freiem Kopf, etwa YOLO26 oder YOLOv10. Bei anderen Modellen, zum Beispiel YOLO11, gibt der Export die WarnungThis model has no one-to-one head; using one-to-many outputsaus und schreibt die Rohausgabe(1, 84, 8400). - GPU wird nicht verwendet: Wenn das Protokoll
CUDA requested but CUDAExecutionProvider not available. Using CPU...anzeigt, verfügt der installierte ONNX-Runtime-Build über keinen funktionierenden CUDA-Anbieter. Installiereonnxruntime-gpustattonnxruntimeund prüfe, ob die CUDA- und cuDNN-Versionen dazu mit deinem System übereinstimmen. - OpenCV DNN: Mit OpenCV 4.14.0 kann
dnn=TrueStandard-,nms=False-, INT8- und GPU-exportierte FP16-Modelle ausführen. Das Laden von Modellen, die mitnms=True, mitdynamic=Trueoder mitquantize=16auf der CPU exportiert wurden, schlägt fehl. - Dynamische Formen mit NMS: Wenn du
dynamic=Truemitnms=Truekombinierst, legebatchebenfalls auf die größte Batchgröße fest, die du ausführen möchtest. Der Export gibt eine Warnung aus, wennbatchauf1gesetzt bleibt. - Graphvereinfachung: Wenn
onnxslimfehlschlägt, protokolliert der Export eine Warnung und speichert das Modell ohne Vereinfachung. - IR-Version: Der Exporter begrenzt die ONNX-IR-Version auf 10, damit ältere ONNX-Runtime-Versionen die Datei laden können. Ein Standardexport mit Operatorsatz 18 hat die IR-Version 8.
Weitere Fehler findest du im Leitfaden zu häufigen Problemen.
Benchmarks#
YOLO26n läuft mit ONNX Runtime auf einer CPU (Intel Xeon CPU @ 2.00 GHz) bis zu 43 % schneller als YOLO11n. Auf der YOLO26-Modellseite ist die CPU-ONNX-Geschwindigkeit jedes Modells für alle Aufgaben außer semantischer Segmentierung aufgeführt.
Ansehen: Inferenztest: Ultralytics YOLO26 vs. Ultralytics YOLO11 mit ONNX | YOLO26 ermöglicht rund 43 % schnellere Inferenz 🚀
FP32, FP16 und INT8 mit ONNX Runtime#
Die folgenden Tabellen vergleichen PyTorch mit FP32-, FP16- und INT8-ONNX-Modellen für alle YOLO26-Erkennungsmodelle, ausgeführt mit CUDAExecutionProvider für ONNX Runtime. Alle GPU-Werte wurden auf einer NVIDIA RTX PRO 6000 Blackwell Server Edition-GPU gemessen.
Millisekunden pro Bild; niedrigere Werte sind besser. Das schnellste Format für jedes Modell ist fett hervorgehoben.
| Modell | imgsz | PyTorch | ONNX FP32 | ONNX FP16 | ONNX INT8 |
|---|---|---|---|---|---|
| YOLO26n | 640 | 2.85 | 1.96 | 1.88 | 3.73 |
| YOLO26s | 640 | 2.98 | 2.14 | 1.73 | 4.31 |
| YOLO26m | 640 | 3.29 | 3.01 | 2.14 | 5.37 |
| YOLO26l | 640 | 4.70 | 4.09 | 3.08 | 7.51 |
| YOLO26x | 640 | 5.93 | 5.56 | 3.90 | 9.38 |
YOLO26n auf der CPU (AMD EPYC 9655, PyTorch und ONNX Runtime mit jeweils 8 Threads; eine andere CPU als die für die YOLO26-Modelltabellen verwendete):
| Kennzahl | PyTorch | ONNX FP32 | ONNX FP16 | ONNX INT8 |
|---|---|---|---|---|
| Latenz (ms/Bild) | 13.2 | 13.4 | 13.2 | 56.5 |
| mAPval 50-95 | 40.8 | 40.9 | 40.9 | 38.7 |
- FP16 halbierte die Dateigröße bei einem Verlust von nur 0,1 mAP gegenüber FP32 und lief auf der GPU bis zu 1,4-mal schneller als FP32, jedoch ohne Geschwindigkeitssteigerung auf der CPU.
- INT8 ergab die kleinste Datei, büßte jedoch 2,2 bis 3,0 mAP ein und lief sowohl auf der GPU als auch auf der CPU langsamer als FP32.
Gemessen mit ultralytics 8.4.211, ONNX Runtime 1.30.0, PyTorch 2.15.0 und CUDA 13.2 auf batch=1 am 13. November 2026. Die Latenz bezieht sich auf die von val gemeldete Inferenzphase und umfasst weder Vorverarbeitung noch Nachverarbeitung.
Über ONNX#
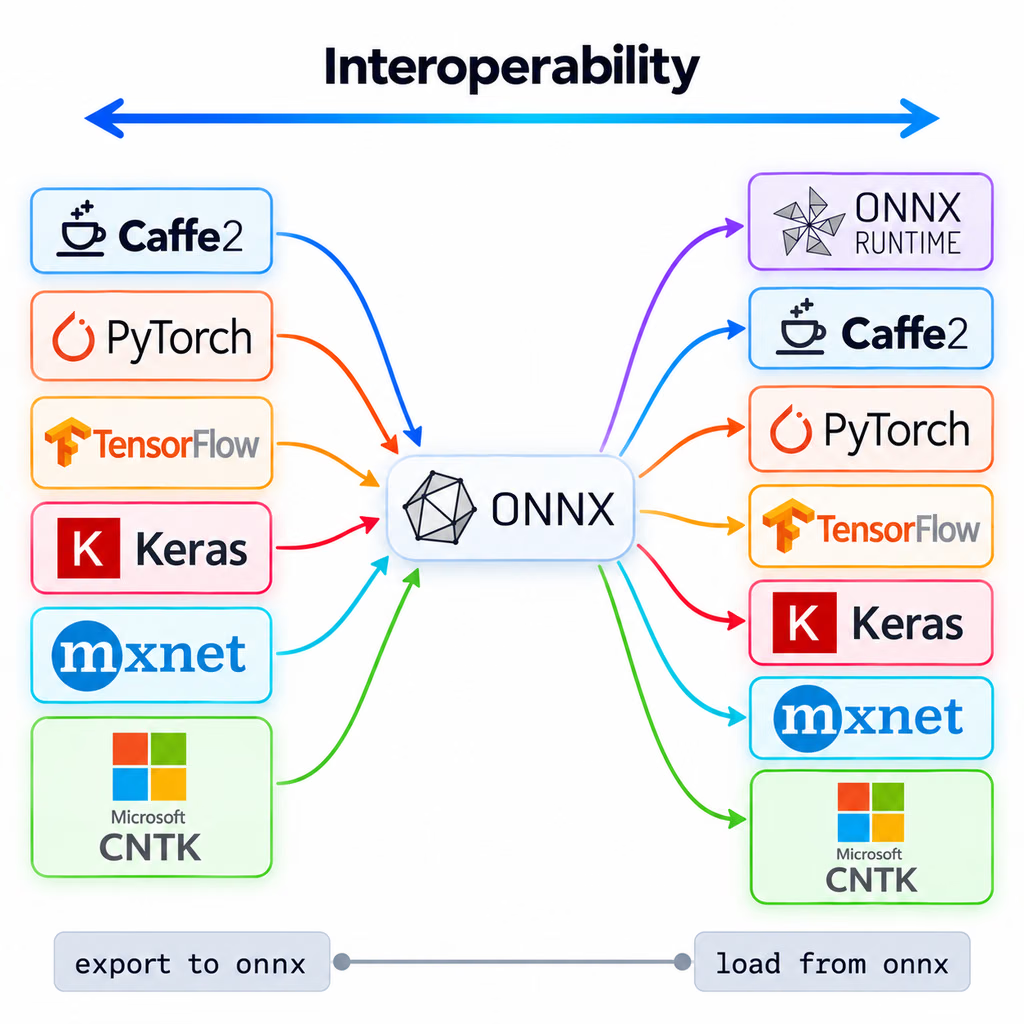
ONNX ist ein Community-Projekt, das Facebook und Microsoft gestartet haben und das inzwischen gemeinsam mit Organisationen wie IBM, Amazon und Google weiterentwickelt wird. Es definiert einen gemeinsamen Satz von Operatoren und ein Dateiformat für maschinelle Lernmodelle, sodass ein in einem Framework wie PyTorch trainiertes Modell in vielen Laufzeitumgebungen und auf zahlreichen Hardwareplattformen ausgeführt werden kann.
ONNX Runtime ist eine plattformübergreifende Inferenz-Engine für ONNX-Modelle. Die Ausführungsanbieter verwenden hardwarespezifische Bibliotheken, um ein Modell auf CPUs, GPUs und spezialisierten Beschleunigern auszuführen.
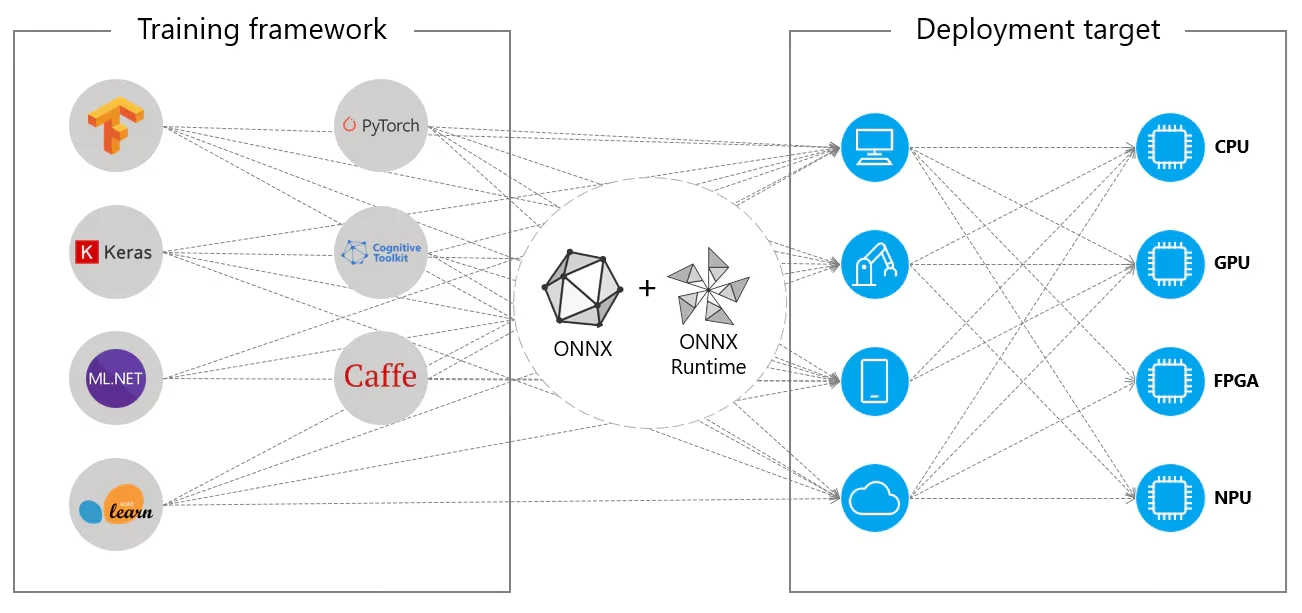
ONNX dient auch als Zwischenschritt für andere Ultralytics-Exportformate, darunter TensorRT, und als Eingabe für NPU-Werkzeugketten von Anbietern wie Huawei Ascend, Qualcomm QNN und Rockchip RKNN. Die Spezifikation findest du in der ONNX-Dokumentation.
Häufig gestellte Fragen#
Lass
opsetungesetzt, sofern deine Laufzeitumgebung keine bestimmte Version benötigt. Der Exporter verwendet dann opset18mit PyTorch 2.4 und neuer, opset17mit PyTorch 1.13 bis 2.3, ein niedrigeres opset mit älteren PyTorch-Versionen und nie ein höheres opset, als das installierte Paketonnxunterstützt. Der Standardwert ist auf 18 begrenzt, da der CUDA-Anbieter von ONNX Runtime einige Operatoren ab opset 19, etwaResize, auf der CPU ausführt. Lege einen niedrigeren Wert fest, zum Beispielopset=12, wenn eine ältere Laufzeitumgebung oder ein älterer Konverter den Standardwert ablehnt. Der Wert darf nicht unter dem Mindest-opset des Modells liegen.Das hängt vom Argument
nmsab, mit dem du das Modell exportiert hast. Ein Export mit den Standardeinstellungen gibt Rohvorhersagen zurück, die eine Konfidenzfilterung und NMS erfordern. Ein Export mitnms=Falseodernms=Truegibt pro Bild bis zumax_det(Standardwert 300) endgültige Erkennungen alsx1, y1, x2, y2, score, classin Pixeln des Eingabebilds zurück. Daher musst du nur nach dem Score filtern und die Boxen auf die Größe des Originalbilds zurückskalieren. OBB-Zeilen enthalten anstelle der Eckpunktecenter x, center y, width, heightsowie den Winkel. Die Formen findest du unter Ausgabeformat.NMS-freie Ausgabe mit ONNX Runtime auslesen# Zuerst exportieren: yolo export model=yolo26n.pt format=onnx nms=False import numpy as np import onnxruntime as ort session = ort.InferenceSession("yolo26n.onnx") # mit nms=False exportiert image = np.zeros((1, 3, 640, 640), dtype=np.float32) # dein vorverarbeitetes Bild detections = session.run(None, {"images": image})[0][0] # shape (300, 6) detections = detections[detections[:, 4] > 0.25] # Zeilen oberhalb des Konfidenzschwellenwerts beibehaltenSetze
dynamic=True. Die Eingabeimageshat dann mit dynamischer Batchgröße, Höhe und Breite die Form(batch, 3, height, width), und eine standardmäßige Erkennungsausgabe (nms=None)output0hat die Form(batch, 84, anchors), sodass dieselbe Datei zur Inferenz unterschiedliche Batchgrößen und Bildgrößen akzeptiert. Mitnms=Trueist die Batchgröße auf den beim Export verwendeten Wertbatchbeschränkt. Höhe und Breite müssen Vielfache der Schrittweite des Modells sein; bei den offiziellen YOLO26-Checkpoints außer denen für die Klassifizierung beträgt sie 32. Ein dynamisches Modell nutzt mit CUDA keine IO-Bindung und lässt sich nicht mit OpenCV DNN laden. Verwende daher den standardmäßigen statischen Export, wenn die Eingabegröße feststeht.Dynamischer Exportfrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="onnx", dynamic=True)Verwende ONNX, wenn eine Datei auf unterschiedlicher Hardware laufen muss oder wenn du nicht auf dem Rechner exportierst, auf dem das Modell eingesetzt wird. Verwende TensorRT für die geringste Latenz auf einer bestimmten NVIDIA-GPU: Eine TensorRT-Engine wird für eine GPU-Architektur und eine TensorRT-Version erstellt und ist nicht portabel. Weitere Optionen findest du im Leitfaden zu Modellbereitstellungen.


Kommentare77
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
dopeggguy
The parameter "half" bost apperence in train and export, what’s difference. when we using this parameter what should we need attention.
 Glenn JocherUltralytics(bearbeitet)
@dopeggguy Good question—summary: training uses mixed precision via
amp=True(weights stay FP32; compute is FP16 where safe), while export usesquantize=16(the formerhalf=True, now deprecated) to write an FP16 model for runtimes that support FP16. During training preferamp; use FP16 only at export/inference, and don't combine it with INT8 (quantize=8). See the train overview and AMP notes in the Train mode docs and thequantizeoption details in Model Export – Arguments and Configuration – Export Settings.from ultralytics import YOLO # Mixed-precision training (recommended) YOLO("yolo26n.yaml").train(data="data.yaml", amp=True) # FP16 export for FP16-capable runtimes (e.g., CUDA/TensorRT/OpenVINO FP16) YOLO("best.pt").export(format="onnx", quantize=16)yoloModel = YOLO(path_dir) yoloModel.export(format='onnx', dynamic=False, half=True, imgsz=(640, 640))
I'm not sure why. I enabled half=True, but the actual size of the exported model doesn't seem to change at all.
- Glenn JocherUltralytics(bearbeitet)
@dopeggguy
half=Trueis deprecated in favor ofquantize=16. On older releases a CPU-only ONNX export ignored the flag and stayed FP32, so the file size was almost identical. Current releases convert CPU ONNX exports to FP16 too (keeping float32 inputs/outputs), and GPU exports are FP16 natively. If you have a GPU, you can force export on it and re-check:from ultralytics import YOLO YOLO(path_dir).export(format="onnx", imgsz=(640, 640), dynamic=False, quantize=16, device=0)You can then open the ONNX in Netron or inspect it with the
onnxPython API to confirm the weights arefloat16; for pure CPU deployments it is often better to keep ONNX as FP32 or use a CPU‑oriented backend (e.g. OpenVINO) for FP16/INT8 optimization instead, with some general ONNX background outlined in the ONNX: Open Neural Network Exchange overview.
bastinj98
Hi, I trained d a YOLOV8-segn model to detect and segment a single class (nc=1) and then exported in to onnx (simplify, nms, half are all False) with opset = 17. The output shape is 1x37x8400.
I am building a C++ pipeline to use this model to run inference. How can I process this output to get the final segmentation mask ?
NgZiming
I exported a yolo 11 segment model to onnx format, and used onnx-runtime to infer. It responded two ndarrays of shapes (1, 37, 21504) and (1, 32, 256, 256). (imgsz=1024) So, how can i extract masks from these two arrays?
- Glenn JocherUltralytics
@NgZiming 这两个输出正是分割模型的“检测头 + 原型掩码”:
(1, 37, 21504)=4(xywh) + nc + 32(mask系数),(1, 32, 256, 256)为32个原型;掩码可由原型与对应检测的32维系数线性组合并裁剪到框内,最小示例(Python/NumPy)如下:import numpy as np import cv2 def sigmoid(x): return 1 / (1 + np.exp(-x)) def mask_from_outputs(det, proto, img_h, img_w, det_idx): # det: (1, C, N) -> (C, N), proto: (1, 32, 256, 256) -> (32, 256, 256) det = det[0]; proto = proto[0] nm, ph, pw = proto.shape # 32, 256, 256 nc = det.shape[0] - 4 - nm # 1) 取该检测的框、类别分数与32维掩码系数 cx, cy, w, h = det[0, det_idx], det[1, det_idx], det[2, det_idx], det[3, det_idx] coeff = det[4+nc:4+nc+nm, det_idx] # (32,) # 2) 原型 × 系数 -> 原始掩码 (ph, pw) m = sigmoid((proto.reshape(nm, -1).T @ coeff).reshape(ph, pw)) # 3) 可选:按框在原型分辨率下裁剪(坐标为[0,1]比例) x0 = int(max(0, (cx - w/2) * pw)); x1 = int(min(pw, (cx + w/2) * pw)) y0 = int(max(0, (cy - h/2) * ph)); y1 = int(min(ph, (cy + h/2) * ph)) crop = np.zeros_like(m); crop[y0:y1, x0:x1] = m[y0:y1, x0:x1] # 4) 上采样到原图尺寸并二值化 mask = cv2.resize(crop, (img_w, img_h), interpolation=cv2.INTER_LINEAR) return (mask > 0.5).astype(np.uint8)要点:确保与推理时的预处理一致(letterbox 缩放与填充、RGB/归一化等),否则框与掩码会错位。关于分割导出产生两个输出(
output0检测+系数,output1原型)的由来,可见导出实现参考的export_onnx说明:export_onnx 函数参考.1 thanks
- Glenn JocherUltralytics
Glad it helped—if you later need a C++ reference for segmentation mask decoding and preprocessing alignment, the step-by-step overview is in the Segmentation task docs.
 User
I have a question. If it's convenient, please answer it. Thank you! I'm working with cell images, and the image size is 3072*2048. I trained with imagesize=3072, but if I use imagesize=640, I can't detect objects. I can predict with a 3072 imagesize using a pt file, but now I'm trying to switch to C++ and call onnx, and the 3072 inference is very slow. Is this normal?
denni281
You should keep the same preprocess way between python-inference and cpp-inference.
- Glenn JocherUltralytics
@giter915 Yes—running 3072×2048 through ONNX/C++ will be much slower; inference time grows quickly with input area. Two practical options: use a faster backend or reduce effective input while keeping accuracy. For GPU, prefer TensorRT; for CPU, OpenVINO FP16/INT8 gives the largest gains. Examples:
from ultralytics import YOLO

# GPU-optimized
YOLO("best.pt").export(format="engine", imgsz=1536, half=True, dynamic=True)

# CPU-optimized
YOLO("best.pt").export(format="openvino", imgsz=1536, half=True)  # add int8=True with calibration if desired
If you must keep 3072, tile the image (e.g., 1024×1024 patches), run ONNX per tile, then merge detections with NMS in C++; this is a common approach for microscopy. Also ensure preprocessing in C++ exactly matches Python (letterbox padding, RGB order, 1/255 scaling)—agree with @DennisJcy here. For backend choices and supported export targets, see the export formats table in Object Detection – Ultralytics YOLO Docs, and for high‑throughput GPU serving consider Triton Inference Server with YOLO11.
- User
Thank you very much!
- Glenn JocherUltralytics
Glad it helped—one extra tip for ONNX Runtime C++: enable full graph optimizations and tune threads to squeeze more speed from large inputs like 3072×2048.
#include <onnxruntime_cxx_api.h>
#include <thread>

Ort::Env env(ORT_LOGGING_LEVEL_WARNING, "yolo");
Ort::SessionOptions so;
so.SetGraphOptimizationLevel(GraphOptimizationLevel::ORT_ENABLE_ALL);
so.SetIntraOpNumThreads(std::thread::hardware_concurrency());
so.SetInterOpNumThreads(1);  // often fine to leave at 1

Ort::Session session(env, "best.onnx", so);
Hello, I use ultratics to export YOLO11 half-Precision onnx model, but when I load the .onnx model to eval by onnxruntime, exception shows :Unexpected input data type. Actual: (tensor(float16)) , expected: (tensor(float)). And I compare the Float32 and Float16(half) .onnx model,These two files are exactly the same in size and input type.So the "half" keyword doesn't take effect when exporting ONNX, right? I remember Ultralytics didn't have this issue last year.
Here is my python script to export half-precision onnx model:
def main(opt): model = YOLO(opt.model) model.export( format="onnx", # opset=12, simplify=True, dynamic=False, imgsz=opt.imgsz, half=opt.half, batch=opt.batch, ) if __name__ == "__main__": multiprocessing.freeze_support() parser = argparse.ArgumentParser() parser.add_argument( "--model", type=str, default="/home/ultralytics/runs/detect/SHFY/weights/best.pt", ) parser.add_argument("--imgsz", type=int, default=640) parser.add_argument("--half", type=bool, default=True) parser.add_argument("--batch", type=int, default=1) opt, unparsed = parser.parse_known_args() print(opt) main(opt)Fine... It's my fault. My docker environment is Python-3.11.9 torch-2.4.1+cu118 CPU (unknown). The error is made by my cpu environment
- Glenn JocherUltralytics(bearbeitet)
@DennisJcy thanks for the update. On older releases
half=Truehad no effect on CPU ONNX exports, so the file stayed FP32. Current Ultralytics usesquantize=16(replacing the deprecatedhalf) and also converts CPU ONNX exports to FP16 while keeping float32 inputs/outputs, whereas GPU exports (device=0) are FP16 natively and need an FP16-capable ONNX Runtime provider. For CPU-optimized FP16 you can also export OpenVINO. For example:from ultralytics import YOLO # FP16 ONNX YOLO("best.pt").export(format="onnx", quantize=16) # CPU-optimized FP16 (OpenVINO) YOLO("best.pt").export(format="openvino", quantize=16)Details on OpenVINO export are in the export_openvino reference.
ShuaibZyx
def yolo_to_onnx(model_path, input_shape=(600, 600)): # Load the YOLOv8 model model = YOLO(model_path)
# Export the model to ONNX format
model.export(format='onnx',
             imgsz=input_shape,
             dynamic=True,
             batch=1,
             device="0")
Ultralytics YOLOv8.0.220 🚀 Python-3.9.18 torch-2.1.1+cu121 CUDA:0 (Tesla T4, 14931MiB) Model summary (fused): 268 layers, 43610463 parameters, 0 gradients, 164.8 GFLOPs
PyTorch: starting from 'best.pt' with input shape (1, 3, 640, 640) BCHW and output shape(s) (1, 9, 8400) (83.6 MB)
ONNX: starting export with onnx 1.18.0 opset 17... ONNX: export success ✅ 3.3s, saved as 'best.onnx' (166.5 MB) 我的模型在训练时是5个类别的目标检测,导出的模型的输出格式是(1, 9, 8400)。 我想请问您其中9具体代表的是什么呢? 如果是为了预测5个类别(1, 9, 8400)的输出格式是正确的嘛? 期待您的帮助!感谢!
xiaoqiang-l
9指的是:[x,y,w,h,class1_scores,class2_scores,class3_scores,class4_scores,class5_scores],即四个坐标及N个类别分数。 8400指的是:640下采样8倍、16倍、32倍特征图的anchor总数,(640/8)(640/8)+(640/16)(640/16)+(640/32)(640/32)=8080+4040+2020=8400
感谢您的指导!
- Glenn JocherUltralytics
@ShuaibZyx you're welcome! @xiaoqiang-l provided an excellent explanation. Just to confirm, the output shape (1, 9, 8400) is indeed correct for your 5-class detection model - the 9 channels represent the 4 bounding box coordinates (x, y, w, h) plus 5 class confidence scores. The 8400 represents all detection anchors across the three feature map scales (80×80 + 40×40 + 20×20 = 8400 total anchors).
UltralyticsAssistantUltralytics
👋 Hello, thank you for your interest in Ultralytics 🚀! We recommend a visit to the Docs for new users where you can find many Python and CLI usage examples, as well as detailed guides about exporting YOLO models to ONNX and other formats.
If this is a 🐛 Bug Report, please provide a minimum reproducible example to help us debug it.
If you have a custom training ❓ Question or require help with ONNX export, please include as much detail as possible—such as your command, model version, logs, and environment details. Also, check out our Tips for Best Training Results for optimal performance.
Join the Ultralytics community where it suits you best! For real-time chat, head to Discord 🎧. For in-depth discussions, try Discourse, or join the conversation on our Subreddit.
Upgrade
Upgrade to the latest
ultralyticspackage including all requirements in a Python>=3.8 environment with PyTorch>=1.8 to ensure you’re using the most up-to-date features and bug fixes:pip install -U ultralyticsEnvironments
YOLO can be run in these up-to-date verified environments, with all dependencies including CUDA/CUDNN, Python, and PyTorch preinstalled:
- Notebooks with free GPU:


- Google Cloud Deep Learning VM. See GCP Quickstart Guide
- Amazon Deep Learning AMI. See AWS Quickstart Guide
- Docker Image. See Docker Quickstart Guide
Status

If this badge is green, all Ultralytics CI tests are currently passing. CI tests verify correct operation of all YOLO Modes and Tasks on macOS, Windows, and Ubuntu every 24 hours and on every commit.
This is an automated response 🤖. An Ultralytics engineer will review your discussion and assist you soon!
- Glenn JocherUltralytics
Hello! Thanks for your interest in exporting YOLO11 models to ONNX format. This is a great option for deployment across different platforms with performance benefits.
Exporting to ONNX is straightforward with Ultralytics:
from ultralytics import YOLO

# Load model
model = YOLO("yolo11n.pt")  # or your custom trained model

# Export to ONNX with optional parameters
model.export(format="onnx", dynamic=True, simplify=True)  # creates 'yolo11n.onnx'

# Use the exported model
onnx_model = YOLO("yolo11n.onnx")
results = onnx_model("https://ultralytics.com/images/bus.jpg")
ONNX export can provide up to 3x CPU speedup compared to PyTorch models. You can customize the export with several parameters like
half=Truefor FP16 precision,dynamic=Truefor variable input sizes, oropsetto specify the ONNX version.For deployment, you can use ONNX Runtime or integrate with platforms like NVIDIA Triton Inference Server for production-scale serving.
If you have specific questions about exporting your models or encounter any issues during the process, please let us know!
- Notebooks with free GPU:
👋 Hello, thank you for your interest in Ultralytics 🚀! For users exploring ONNX integration and YOLO11, we recommend checking out the Docs where you’ll find dedicated Python and CLI tutorials, as well as specific ONNX integration guidance.
If this is a 🐛 Bug Report, please provide a minimum reproducible example to help us investigate further.
For custom deployment or export ❓ questions, please include as many details as possible, such as your export commands, model versions, and error logs. Make sure you review our Tips for Best Training Results for optimal performance.
Join the Ultralytics community where it suits you best: jump into real-time conversations on Discord 🎧, post or search on Discourse, or connect on our Subreddit.
Upgrade
Upgrade to the latest
ultralyticspackage, including all requirements, in a Python>=3.8 environment with PyTorch>=1.8 to ensure you have the latest features and fixes:pip install -U ultralyticsEnvironments
YOLO can be run in any of the following up-to-date verified environments (with all dependencies including CUDA/CUDNN, Python and PyTorch preinstalled):
- Notebooks with free GPU:
- Google Cloud Deep Learning VM. See GCP Quickstart Guide
- Amazon Deep Learning AMI. See AWS Quickstart Guide
- Docker Image. See Docker Quickstart Guide
Status
If this badge is green, all Ultralytics CI tests are currently passing. CI tests verify correct operation of all YOLO Modes and Tasks on macOS, Windows, and Ubuntu every 24 hours and on every commit.
This is an automated response. An Ultralytics engineer will assist you here soon!
- Glenn JocherUltralytics
Yes, you can adjust the batch size dynamically when exporting to ONNX format by using the
dynamic=Trueparameter in your export call. When this is enabled, the batch dimension becomes dynamic, allowing you to use various batch sizes during inference without reexporting the model.Here's a simple example:
from ultralytics import YOLO

# Load your model
model = YOLO("yolo11n.pt")

# Export with dynamic input size
model.export(format="onnx", dynamic=True)
This creates dynamic dimensions in the exported ONNX model, where the batch dimension (as well as height and width) can vary during inference. The resulting model will be more flexible for production deployments where batch size requirements might change.
- Notebooks with free GPU:
skyceeee
First of all, thank you for everything. Can we adjust the batch size dynamically when exporting the model as onnx?
When I export the YOLOV11 onnx model, I use: model.export(format='onnx', imgsz=640, device='cpu'). Then I use onnxruntime (1.14.0) to deploy it on the C++ side, but an error is reported during runtime: onnxruntime::Model::Model Unsupported model IR version: 9, max supported IR version: 8. Is there any parameter or method to set the exported model to support IR version: 8? Because I cannot upgrade onnxruntime to other higher versions locally, I look forward to your help
- Glenn JocherUltralytics
@xiaoqiang-l to resolve the ONNX IR version compatibility issue, you can specify an older
opsetversion during export. Try addingopset=13to your export command:model.export(format='onnx', imgsz=640, device='cpu', opset=13)This will generate an ONNX model compatible with IR version 8. For detailed version mapping, see the ONNX operator version matrix in the ONNX documentation.
