YOLO26-Modelle für eine schnelle Bereitstellung nach TorchScript exportieren#
PyTorch hat TorchScript als veraltet eingestuft und entfernt dessen Funktionen schrittweise. Verwende für neue Bereitstellungen auf Mobilgeräten und Edge-Geräten die unterstützte ExecuTorch-Integration. Ultralytics unterstützt weiterhin den regulären TorchScript-Export für die Kompatibilität mit älteren C++-Anwendungen.
Für die Bereitstellung von Computer-Vision-Modellen in C++-Umgebungen ohne Python ist eine portable serialisierte Darstellung erforderlich. TorchScript bietet diese Kompatibilität für ältere LibTorch-Anwendungen.
Exportiere deine Ultralytics-YOLO26-Modelle nach TorchScript, um sie plattformübergreifend kompatibel zu machen und einfacher bereitzustellen. In dieser Anleitung zeigen wir dir, wie du deine YOLO26-Modelle in das TorchScript-Format exportierst, damit du sie in einem breiteren Spektrum von Anwendungen nutzen kannst.
Warum solltest du nach TorchScript exportieren?#
TorchScript wurde von den Entwicklern von PyTorch entwickelt und ist ein leistungsstarkes Werkzeug zur Optimierung und Bereitstellung von PyTorch-Modellen auf verschiedenen Plattformen. Der Export von YOLO26-Modellen nach TorchScript ist entscheidend, um von der Forschung zu praktischen Anwendungen überzugehen. Als Teil des PyTorch-Frameworks erleichtert TorchScript diesen Übergang, indem PyTorch-Modelle auch in Umgebungen ohne Python-Unterstützung verwendet werden können.
Der Prozess umfasst zwei Verfahren: Tracing und Scripting. Beim Tracing werden Operationen während der Modellausführung aufgezeichnet, während sich beim Scripting Modelle mit einer Teilmenge von Python definieren lassen. So können Modelle wie YOLO26 auch außerhalb ihrer üblichen Python-Umgebung weiterhin ihre Aufgaben erfüllen.
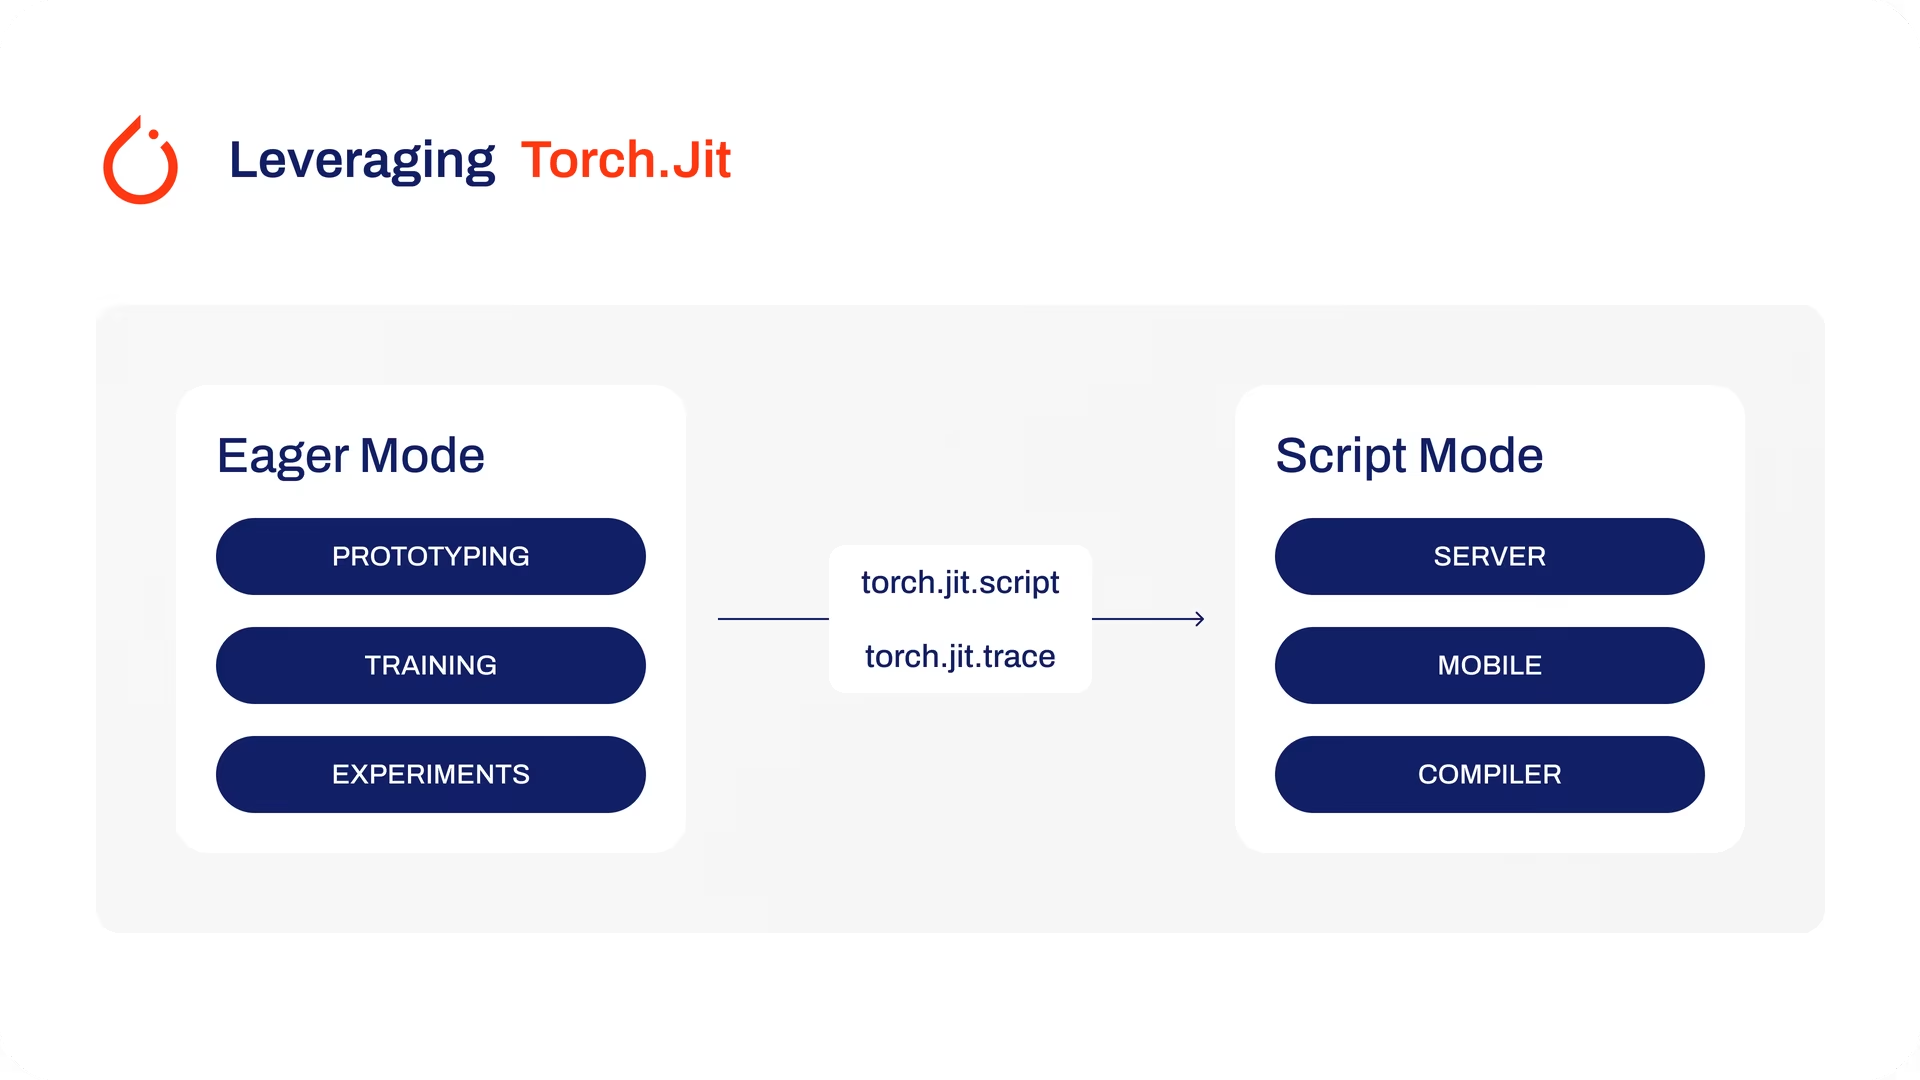
TorchScript-Modelle lassen sich außerdem mit Verfahren wie der Zusammenführung von Operatoren und einer optimierten Speichernutzung verbessern, um eine effiziente Ausführung sicherzustellen. Ein weiterer Vorteil des Exports nach TorchScript ist die Möglichkeit, die Modellausführung auf verschiedenen Hardwareplattformen zu beschleunigen. Dabei entsteht eine eigenständige, produktionsreife Darstellung deines PyTorch-Modells, die sich in C++-Umgebungen integrieren lässt.
Wichtige Merkmale von TorchScript-Modellen#
TorchScript ist ein zentraler Bestandteil des PyTorch-Ökosystems und bietet leistungsstarke Funktionen zur Optimierung und Bereitstellung von Deep-Learning-Modellen.
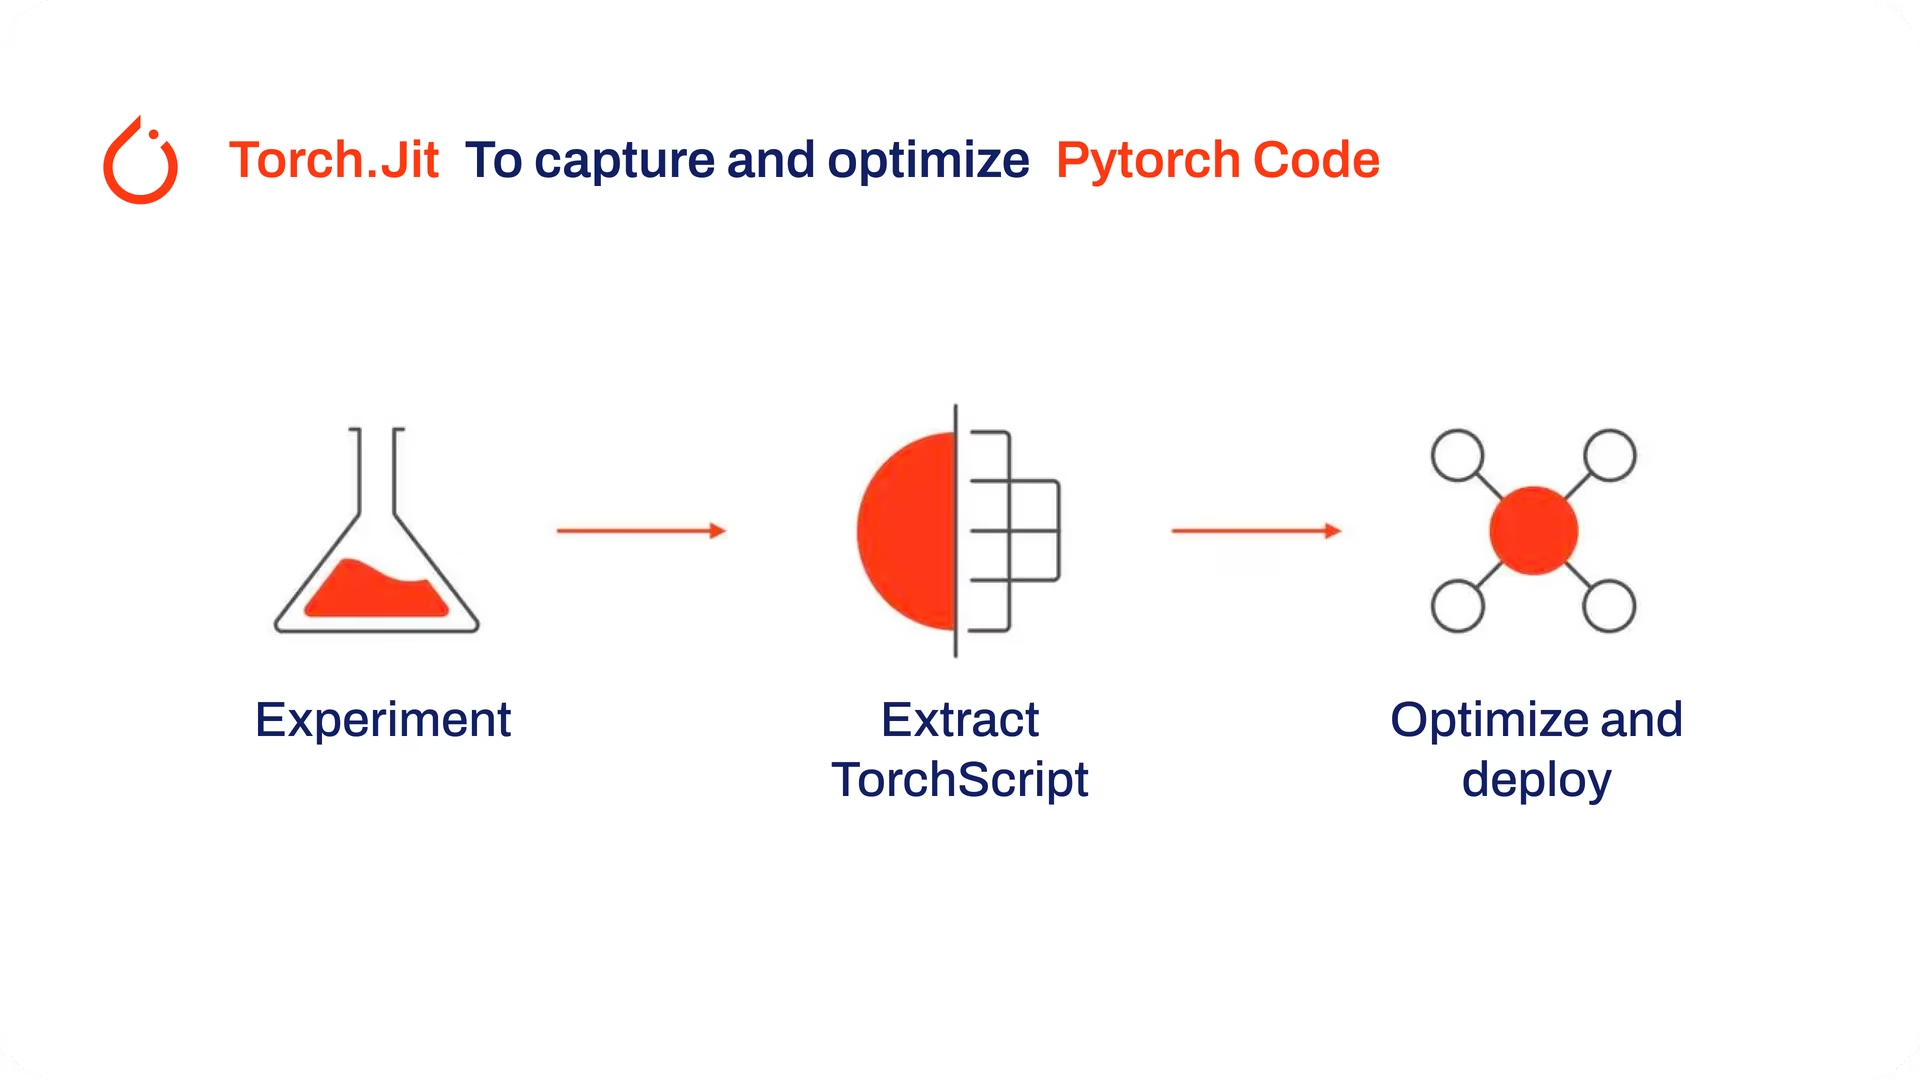
Hier sind die wichtigsten Funktionen, die TorchScript zu einem wertvollen Werkzeug für Entwickler machen:
-
Ausführung mit statischem Graphen: TorchScript verwendet eine statische Graphdarstellung der Modellberechnungen, anders als die dynamische Graphausführung von PyTorch. Bei der Ausführung mit statischem Graphen wird der Berechnungsgraph vor der eigentlichen Ausführung einmal definiert und kompiliert. Das verbessert die Leistung während der Inferenz.
-
Modellserialisierung: Mit TorchScript kannst du PyTorch-Modelle in ein plattformunabhängiges Format serialisieren. Serialisierte Modelle lassen sich ohne den ursprünglichen Python-Code laden und so in unterschiedlichen Laufzeitumgebungen bereitstellen.
-
JIT-Kompilierung: TorchScript verwendet die Just-in-Time-Kompilierung (JIT), um PyTorch-Modelle in eine optimierte Zwischendarstellung umzuwandeln. JIT kompiliert den Berechnungsgraphen des Modells und ermöglicht so eine effiziente Ausführung auf Zielgeräten.
-
Schrittweise Umwandlung: TorchScript ermöglicht eine schrittweise Umwandlung, sodass du Teile deines PyTorch-Modells nach und nach in TorchScript umwandeln kannst. Diese Flexibilität ist besonders nützlich bei komplexen Modellen oder wenn du bestimmte Teile des Codes optimieren möchtest.
Bereitstellungsoptionen für TorchScript#
Bevor wir uns den Code zum Export von YOLO26-Modellen in das TorchScript-Format ansehen, schauen wir uns an, wo TorchScript-Modelle üblicherweise eingesetzt werden.
TorchScript bietet verschiedene Bereitstellungsoptionen für Machine-Learning-Modelle, zum Beispiel:
-
C++-API: TorchScript wird am häufigsten über die LibTorch-C++-API verwendet. Damit kannst du optimierte TorchScript-Modelle direkt in C++-Anwendungen laden und ausführen. Das eignet sich ideal für Produktionsumgebungen, in denen Python ungeeignet oder nicht verfügbar ist. Die C++-API führt TorchScript-Modelle mit geringem Mehraufwand und effizient aus und schöpft so ihr Leistungspotenzial aus.
-
Bereitstellung auf Mobilgeräten: Für Inferenz mit geringer Latenz und ohne Netzwerkverbindung sowie für Datenschutz auf Mobilgeräten solltest du ExecuTorch verwenden, den Ersatz von PyTorch für TorchScript Mobile.
-
Cloud-Bereitstellung: TorchScript-Modelle lassen sich mit Lösungen wie TorchServe auf cloudbasierten Servern bereitstellen. TorchServe bietet Funktionen wie Modellversionierung, Stapelverarbeitung und Metriküberwachung für eine skalierbare Bereitstellung in Produktionsumgebungen. Mit der Cloud-Bereitstellung über TorchScript kannst du deine Modelle über APIs oder andere Webdienste zugänglich machen.
Unterstützte Aufgaben#
Der TorchScript-Export unterstützt alle sieben Ultralytics-Aufgaben. Semantische Segmentierung und Tiefenschätzung sind nur mit YOLO26 verfügbar, der einzigen Modellfamilie mit diesen Köpfen.
| Aufgabe | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Erkennung | ✅ | ✅ | ✅ |
| Segmentierung | ✅ | ✅ | ✅ |
| Semantik | ❌ | ❌ | ✅ |
| Tiefe | ❌ | ❌ | ✅ |
| Klassifizierung | ✅ | ✅ | ✅ |
| Pose | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Nach TorchScript exportieren: Dein YOLO26-Modell umwandeln#
Der Export von YOLO26-Modellen nach TorchScript erleichtert ihre Verwendung in verschiedenen Umgebungen und sorgt für eine schnellere und effizientere Ausführung. Das ist besonders hilfreich, wenn du Deep-Learning-Modelle in praktischen Anwendungen effektiver einsetzen möchtest.
Installation#
Führe zum Installieren des erforderlichen Pakets Folgendes aus:
# Install the required package for YOLO26
pip install ultralytics
Ausführliche Anweisungen und bewährte Vorgehensweisen zur Installation findest du in unserer Installationsanleitung von Ultralytics. Falls bei der Installation der für YOLO26 erforderlichen Pakete Probleme auftreten, findest du Lösungen und Tipps in unserer Anleitung zu häufigen Problemen.
Verwendung#
Alle Ultralytics YOLO26-Modelle sind so ausgelegt, dass sie sofort exportiert werden können. Dadurch lassen sie sich problemlos in deinen bevorzugten Bereitstellungsablauf integrieren. In der vollständigen Liste der unterstützten Exportformate und Konfigurationsoptionen findest du die passende Konfiguration für deine Anwendung.
Das TorchScript-Format unterstützt die Modi Export, Predict und Validate. Exportiere dein Modell und lade anschließend das exportierte Modell, um Inferenz auszuführen oder seine Genauigkeit zu validieren.
from ultralytics import YOLO

# Ein YOLO26-Modell laden
model = YOLO("yolo26n.pt")

# Modell in das TorchScript-Format exportieren
model.export(format="torchscript") # creates 'yolo26n.torchscript'from ultralytics import YOLO
# Exportiertes TorchScript-Modell laden
model = YOLO("yolo26n.torchscript")
# Inferenz ausführen
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Exportiertes TorchScript-Modell laden
model = YOLO("yolo26n.torchscript")
# Die Genauigkeit anhand des COCO8-Datensatzes validieren
metrics = model.val(data="coco8.yaml")Exportargumente#
| Argument | Typ | Standard | Beschreibung |
|---|---|---|---|
format | str | 'torchscript' | Zielformat des exportierten Modells, das die Kompatibilität mit verschiedenen Bereitstellungsumgebungen festlegt. |
imgsz | int oder tuple | 640 | Gewünschte Bildgröße für die Modelleingabe. Kann eine Ganzzahl für quadratische Bilder oder ein Tupel (height, width) für bestimmte Abmessungen sein. |
dynamic | bool | False | Ermöglicht dynamische Eingabegrößen und sorgt so für mehr Flexibilität beim Umgang mit unterschiedlichen Bildabmessungen. |
quantize | int oder str | None | Quantisierungsgenauigkeit: 16 (FP16) erfordert einen GPU-Export mit device=0; 32/nicht festgelegt entspricht FP32. Ersetzt das veraltete Flag half. |
nms | bool, optional | None | Wähle die Rohausgabe (None, Standard), eingebettetes NMS (True) oder den NMS-freien Kopf (False). |
batch | int | 1 | Gibt die Batchgröße für die Inferenz des Exportmodells oder die Höchstzahl der Bilder an, die das exportierte Modell gleichzeitig im predict-Modus verarbeiten kann. |
device | str | None | Legt das Exportgerät fest: GPU (device=0), CPU (device=cpu), MPS für Apple Silicon (device=mps). |
Weitere Informationen zum Exportvorgang findest du auf der Ultralytics-Dokumentationsseite zum Export.
Exportierte YOLO26-TorchScript-Modelle bereitstellen#
Nachdem du deine Ultralytics-YOLO26-Modelle erfolgreich in das TorchScript-Format exportiert hast, kannst du sie nun bereitstellen. Als ersten und empfohlenen Schritt zum Ausführen eines TorchScript-Modells verwendest du die Methode YOLO("model.torchscript"), wie im vorherigen Codebeispiel zur Verwendung gezeigt. Ausführliche Anleitungen zur Bereitstellung deiner TorchScript-Modelle in anderen Umgebungen findest du in den folgenden Ressourcen:
-
Bereitstellung auf Mobilgeräten entdecken: Verwende für die aktuelle PyTorch-Bereitstellung auf Mobilgeräten die separate
torch.export()→.pte-Pipeline von ExecuTorch. -
Serverseitige Bereitstellung meistern: Erfahre in einer Schritt-für-Schritt-Anleitung, wie du Modelle mit TorchServe serverseitig bereitstellst und skalierbare, effiziente Modelldienste einrichtest.
-
C++-Bereitstellung umsetzen: Wirf einen Blick auf die Anleitung zum Laden eines TorchScript-Modells in C++ und erfahre, wie du deine TorchScript-Modelle in C++-Anwendungen integrierst, um Leistung und Vielseitigkeit zu steigern.
Zusammenfassung#
In dieser Anleitung haben wir den Export von Ultralytics-YOLO26-Modellen in das TorchScript-Format behandelt. Mit den beschriebenen Anweisungen kannst du YOLO26-Modelle für eine höhere Leistung optimieren und sie flexibel auf verschiedenen Plattformen und in unterschiedlichen Umgebungen bereitstellen.
Weitere Informationen zur Verwendung findest du in der offiziellen TorchScript-Dokumentation.
Wenn du mehr über weitere Integrationen von Ultralytics YOLO26 erfahren möchtest, besuche auch unsere Seite mit Integrationsanleitungen. Dort findest du zahlreiche nützliche Ressourcen und Einblicke.
Häufig gestellte Fragen#
Wenn du ein Ultralytics-YOLO26-Modell nach TorchScript exportierst, kannst du es flexibel und plattformübergreifend bereitstellen. TorchScript ist Teil des PyTorch-Ökosystems und ermöglicht die Serialisierung von Modellen, die sich anschließend in Umgebungen ohne Python-Unterstützung ausführen lassen. Dadurch eignet es sich für die Bereitstellung von Modellen in C++-Umgebungen.
Zum Export eines YOLO26-Modells nach TorchScript kannst du den folgenden Beispielcode verwenden:
Verwendungfrom ultralytics import YOLO # Ein YOLO26-Modell laden model = YOLO("yolo26n.pt") # Modell in das TorchScript-Format exportieren model.export(format="torchscript") # creates 'yolo26n.torchscript' # Exportiertes TorchScript-Modell laden torchscript_model = YOLO("yolo26n.torchscript") # Inferenz ausführen results = torchscript_model("https://ultralytics.com/images/bus.jpg")Weitere Informationen zum Exportvorgang findest du in der Ultralytics-Dokumentation zum Export.
Die Bereitstellung von YOLO26-Modellen mit TorchScript bietet mehrere Vorteile:
- Portabilität: Exportierte Modelle lassen sich ohne Python in C++-Anwendungen ausführen.
- Optimierung: TorchScript unterstützt die Ausführung mit statischem Graphen und die Just-in-Time-Kompilierung (JIT), wodurch sich die Modellleistung optimieren lässt.
- Sprachübergreifende Integration: TorchScript-Modelle lassen sich in andere Programmiersprachen integrieren, was Flexibilität und Erweiterbarkeit verbessert.
- Serialisierung: Modelle lassen sich serialisieren und dadurch plattformunabhängig laden und für Inferenz verwenden.
Weitere Informationen zur Bereitstellung findest du in der TorchServe-Dokumentation und im Leitfaden zur C++-Bereitstellung. Für die mobile Bereitstellung auf dem Gerät empfiehlt PyTorch inzwischen ExecuTorch. Dabei kommt eine separate Pipeline
torch.export()→.ptezum Einsatz und nicht TorchScript.Installiere das erforderliche Paket für den Export von YOLO26-Modellen mit folgendem Befehl:
Installation# Install the required package for YOLO26 pip install ultralyticsEine detaillierte Anleitung findest du im Ultralytics-Installationsleitfaden. Falls bei der Installation Probleme auftreten, lies den Leitfaden zu häufigen Problemen.
Nachdem du YOLO26-Modelle in das TorchScript-Format exportiert hast, kannst du sie auf verschiedenen Plattformen bereitstellen:
- C++-API: Verwende LibTorch für Produktionsumgebungen mit geringem Overhead und hoher Effizienz.
- Bereitstellung auf Mobilgeräten: Verwende ExecuTorch, den von PyTorch unterstützten Ersatz mit einer separaten Exportpipeline
.pte. - Cloud-Bereitstellung: Nutze Dienste wie TorchServe für eine skalierbare serverseitige Bereitstellung.
Informiere dich ausführlich über die Bereitstellung von Modellen in diesen Umgebungen, um die Möglichkeiten von TorchScript voll auszuschöpfen.