YOLOv4: schnelle und präzise Objekterkennung
YOLOv4 ist ein Echtzeitobjektdetektor, der 2020 von Alexey Bochkovskiy, Chien-Yao Wang und Hong-Yuan Mark Liao im AlexeyAB/darknet-Repository veröffentlicht wurde. Das Modell wurde auf ein optimales Verhältnis zwischen Geschwindigkeit und Genauigkeit ausgelegt.
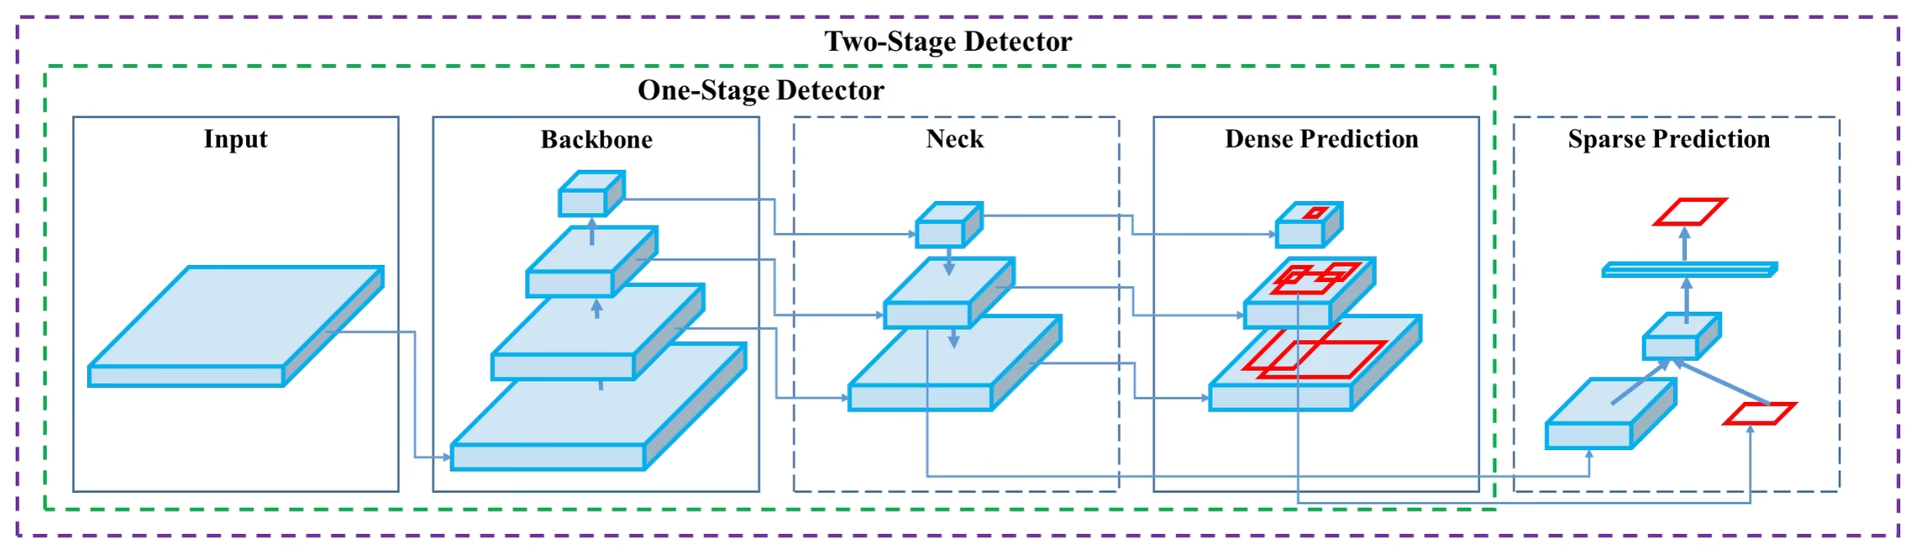 YOLOv4-Architekturdiagramm. Das Diagramm zeigt die Backbone-, Neck- und Kopfkomponenten von YOLOv4 und die Verbindungen zwischen ihren Schichten.
Einführung#
YOLOv4 steht für You Only Look Once, Version 4. Es ist ein Echtzeitmodell zur Objekterkennung, das entwickelt wurde, um die Einschränkungen früherer YOLO-Versionen wie YOLOv3 und anderer Objekterkennungsmodelle zu beheben. Die meisten früheren Detektoren auf Basis faltender neuronaler Netze (CNN) waren nur für Empfehlungssysteme praktikabel; die Echtzeitgenauigkeit von YOLOv4 eignet sich auch für die eigenständige Prozesssteuerung und die Verringerung menschlicher Eingriffe. Das Modell läuft in Echtzeit auf einer herkömmlichen Grafikprozessoreinheit (GPU) und benötigt zum Training nur eine GPU dieser Art. Dadurch bleibt der Einsatz im großen Maßstab erschwinglich.
Architektur#
YOLOv4 kombiniert mehrere Techniken zur Leistungssteigerung. Dazu zählen Weighted-Residual-Connections (WRC), Cross-Stage-Partial-Connections (CSP), Cross-Mini-Batch-Normalisierung (CmBN), Self-Adversarial-Training (SAT), Mish-Aktivierung, Mosaic-Datenerweiterung, DropBlock-Regularisierung und CIoU-Verlust. Zusammen verbessern diese Techniken die Genauigkeit und halten zugleich die Inferenz schnell.
Ein typischer Objektdetektor besteht aus mehreren Teilen: Eingabe, Backbone, Neck und Kopf. Das Backbone wird auf ImageNet vortrainiert und extrahiert Merkmale aus dem Eingabebild. Zu den gängigen Detektor-Backbones zählen VGG, ResNet, ResNeXt und DenseNet; YOLOv4 verwendet CSPDarknet53. Der Neck des Detektors sammelt Merkmalskarten aus verschiedenen Stufen und umfasst üblicherweise mehrere Pfade von unten nach oben sowie mehrere Pfade von oben nach unten. Der Kopf nutzt diese Merkmale, um Klassen und Begrenzungsrahmen von Objekten vorherzusagen.
Kostenlose Zusatzverfahren#
YOLOv4 verwendet außerdem sogenannte „Bag of Freebies“ – Techniken, die die Genauigkeit des Modells während des Trainings verbessern, ohne die Inferenzkosten zu erhöhen. Die Datenerweiterung ist eine gängige Bag-of-Freebies-Technik für die Objekterkennung. Sie erhöht die Vielfalt der Eingabebilder und verbessert so die Robustheit des Modells. Beispiele für Datenerweiterung sind photometrische Verzerrungen (Anpassung von Helligkeit, Kontrast, Farbton, Sättigung und Bildrauschen) und geometrische Verzerrungen (zufällige Skalierung, Zuschneiden, Spiegeln und Drehen). Diese Techniken helfen dem Modell, auf verschiedene Bildtypen besser zu generalisieren.
Funktionen und Leistung#
YOLOv4 ist auf optimale Geschwindigkeit und Genauigkeit bei der Objekterkennung ausgelegt. Die Architektur umfasst CSPDarknet53 als Backbone, PANet als Neck und YOLOv3 als Erkennungskopf. Durch dieses Design ist YOLOv4 schnell genug für Echtzeitanwendungen. Bei der Veröffentlichung erzielte das Modell eine Genauigkeit auf dem neuesten Stand der Technik bei Benchmarks zur Objekterkennung wie COCO.
Im Vergleich zu anderen Modellen der YOLO-Familie wie YOLOv5 und YOLOv7 bleibt YOLOv4 ein wichtiger Referenzpunkt für das Verhältnis zwischen Geschwindigkeit und Genauigkeit. Neuere Modelle bieten höhere Genauigkeit und eine einfachere Bereitstellung, doch die architektonischen Neuerungen von YOLOv4 sind für Anwendungen mit Echtzeitanforderungen weiterhin relevant.
Anwendungsbeispiele#
YOLOv4 ist ein Darknet-basiertes Modell und wird vom Ultralytics-Python-Paket nicht nativ unterstützt: Auf ultralytics/assets sind keine vortrainierten Gewichte yolov4.pt veröffentlicht, und es gibt keine YAML-Dateien ultralytics/cfg/models/v4/. Diese Seite bleibt als Architekturübersicht erhalten. Wenn du YOLOv4 ausführen möchtest, findest du Installations- und Anwendungshinweise direkt im YOLOv4-GitHub-Repository.
Hier findest du eine kurze Übersicht der typischen Schritte zur Verwendung von YOLOv4:
-
Besuche das YOLOv4-GitHub-Repository: https://github.com/AlexeyAB/darknet.
-
Befolge die Installationsanweisungen in der README-Datei. Dazu gehört in der Regel, das Repository zu klonen, die erforderlichen Abhängigkeiten zu installieren und alle erforderlichen Umgebungsvariablen einzurichten.
-
Nach abgeschlossener Installation kannst du das Modell gemäß den Anwendungshinweisen im Repository trainieren und verwenden. Dazu bereitest du üblicherweise deinen Datensatz vor, konfigurierst die Modellparameter, trainierst das Modell und verwendest es anschließend zur Objekterkennung.
Die genauen Schritte hängen von deinem Anwendungsfall und dem aktuellen Stand des YOLOv4-Repositorys ab. Folge daher den Anweisungen im YOLOv4-GitHub-Repository.
Verwende für Training und Inferenz innerhalb des Ultralytics-Frameworks YOLO26 oder YOLO11.
Fazit#
YOLOv4 ist ein effizientes Objekterkennungsmodell, das Geschwindigkeit und Genauigkeit miteinander vereint. Dank seiner Architektur und der Bag-of-Freebies-Trainingstechniken eignet es sich gut für Echtzeitaufgaben zur Objekterkennung. Jede Person kann YOLOv4 mit einer herkömmlichen GPU trainieren und einsetzen. Dadurch ist das Modell für viele Anwendungen zugänglich und praktisch, darunter Überwachungssysteme, autonome Fahrzeuge und industrielle Automatisierung.
Wenn du Objekterkennung in deinen Projekten einsetzen möchtest, ist YOLOv4 weiterhin eine überzeugende Option – besonders, wenn Echtzeitleistung wichtig ist. Ultralytics konzentriert sich zwar derzeit auf die Unterstützung neuerer YOLO-Versionen wie YOLO26 und YOLO11, doch die mit YOLOv4 eingeführten architektonischen Neuerungen haben die Entwicklung dieser späteren Modelle beeinflusst.
Zitate und Danksagungen#
Wir möchten den Autoren von YOLOv4 für ihre bedeutenden Beiträge zur Echtzeit-Objekterkennung danken:
@misc{bochkovskiy2020yolov4,
      title={YOLOv4: Optimal Speed and Accuracy of Object Detection},
      author={Alexey Bochkovskiy and Chien-Yao Wang and Hong-Yuan Mark Liao},
      year={2020},
      eprint={2004.10934},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Die ursprüngliche YOLOv4-Arbeit ist auf arXiv verfügbar. Die Autoren haben ihre Arbeit öffentlich zugänglich gemacht; der Quellcode ist auf GitHub verfügbar. Wir schätzen ihre Bemühungen, das Fachgebiet voranzubringen und ihre Arbeit einer breiteren Gemeinschaft zugänglich zu machen.
Häufig gestellte Fragen#
YOLOv4, kurz für „You Only Look Once, Version 4“, ist ein 2020 von Alexey Bochkovskiy und Kollegen entwickeltes Echtzeitmodell zur Objekterkennung. Es vereint Geschwindigkeit und Genauigkeit und eignet sich daher für Echtzeitanwendungen. Die YOLOv4-Architektur integriert Techniken wie Weighted-Residual-Connections (WRC), Cross-Stage-Partial-Connections (CSP) und Self-Adversarial-Training (SAT), mit denen das Modell bei seiner Veröffentlichung Ergebnisse auf dem neuesten Stand der Technik erzielte. YOLOv4 läuft effizient auf einer einzelnen herkömmlichen GPU. Verwende YOLO26 für natives Training und die Bereitstellung mit dem Ultralytics-Paket.
Die YOLOv4-Architektur umfasst mehrere wichtige Komponenten: Backbone, Neck und Kopf. Das Backbone CSPDarknet53 wird auf ImageNet vortrainiert und extrahiert Merkmale. Der Neck aggregiert mithilfe von PANet Merkmalskarten aus verschiedenen Stufen. Der Kopf folgt schließlich YOLOv3 und sagt Klassen sowie Begrenzungsrahmen von Objekten vorher. YOLOv4 nutzt außerdem Bag-of-Freebies-Techniken wie Mosaic-Datenerweiterung und DropBlock-Regularisierung, um Geschwindigkeit und Genauigkeit weiter zu optimieren.
„Kostenlose Zusatzverfahren“ bezeichnet Methoden, die die Trainingsgenauigkeit von YOLOv4 verbessern, ohne die Inferenzkosten zu erhöhen. Zu diesen Techniken zählen verschiedene Formen der Datenerweiterung, etwa photometrische Verzerrungen (Anpassen von Helligkeit, Kontrast usw.) und geometrische Verzerrungen (Skalieren, Zuschneiden, Spiegeln und Drehen). Durch die größere Variabilität der Eingabebilder können diese Erweiterungen YOLOv4 helfen, besser auf verschiedene Bildtypen zu verallgemeinern. Dadurch verbessern sie die Robustheit und Genauigkeit, ohne die Echtzeitleistung zu beeinträchtigen.
YOLOv4 ist darauf ausgelegt, Geschwindigkeit und Genauigkeit bei der Objekterkennung in Echtzeit zu optimieren. Das Modell läuft sowohl beim Training als auch bei der Inferenz auf einer einzelnen herkömmlichen GPU. Dadurch sinken die Hardwarekosten und das Modell eignet sich für Anwendungen von Empfehlungssystemen bis hin zur eigenständigen Prozesssteuerung.
Um mit YOLOv4 anzufangen, besuche das offizielle YOLOv4-GitHub-Repository. Befolge die Installationsanweisungen in der README-Datei. Dazu gehören üblicherweise das Klonen des Repositorys, die Installation der Abhängigkeiten und das Einrichten der Umgebungsvariablen. Nach der Installation kannst du das Modell trainieren, indem du deinen Datensatz vorbereitest, die Modellparameter konfigurierst und den bereitgestellten Anwendungshinweisen folgst. Da Ultralytics YOLOv4 derzeit nicht unterstützt, empfiehlt es sich, die aktuellsten und ausführlichsten Anweisungen direkt im YOLOv4-GitHub-Repository nachzulesen.


Kommentare
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.