Guía para implementar YOLO26 en los endpoints de Amazon SageMaker
Los endpoints de Amazon SageMaker ofrecen alojamiento gestionado y escalable para modelos de visión artificial, como Ultralytics YOLO26, en aplicaciones de aprendizaje automático en producción. Para desplegar correctamente un modelo, es necesario entender la configuración y los pasos de despliegue tanto del modelo como de AWS.
Esta guía te explicará paso a paso cómo implementar modelos YOLO26 de PyTorch en los endpoints de Amazon SageMaker. Aprenderás los aspectos esenciales para preparar tu entorno de AWS, configurar el modelo correctamente y utilizar herramientas como AWS CloudFormation y el kit de desarrollo de AWS (CDK) para la implementación.
Amazon SageMaker#
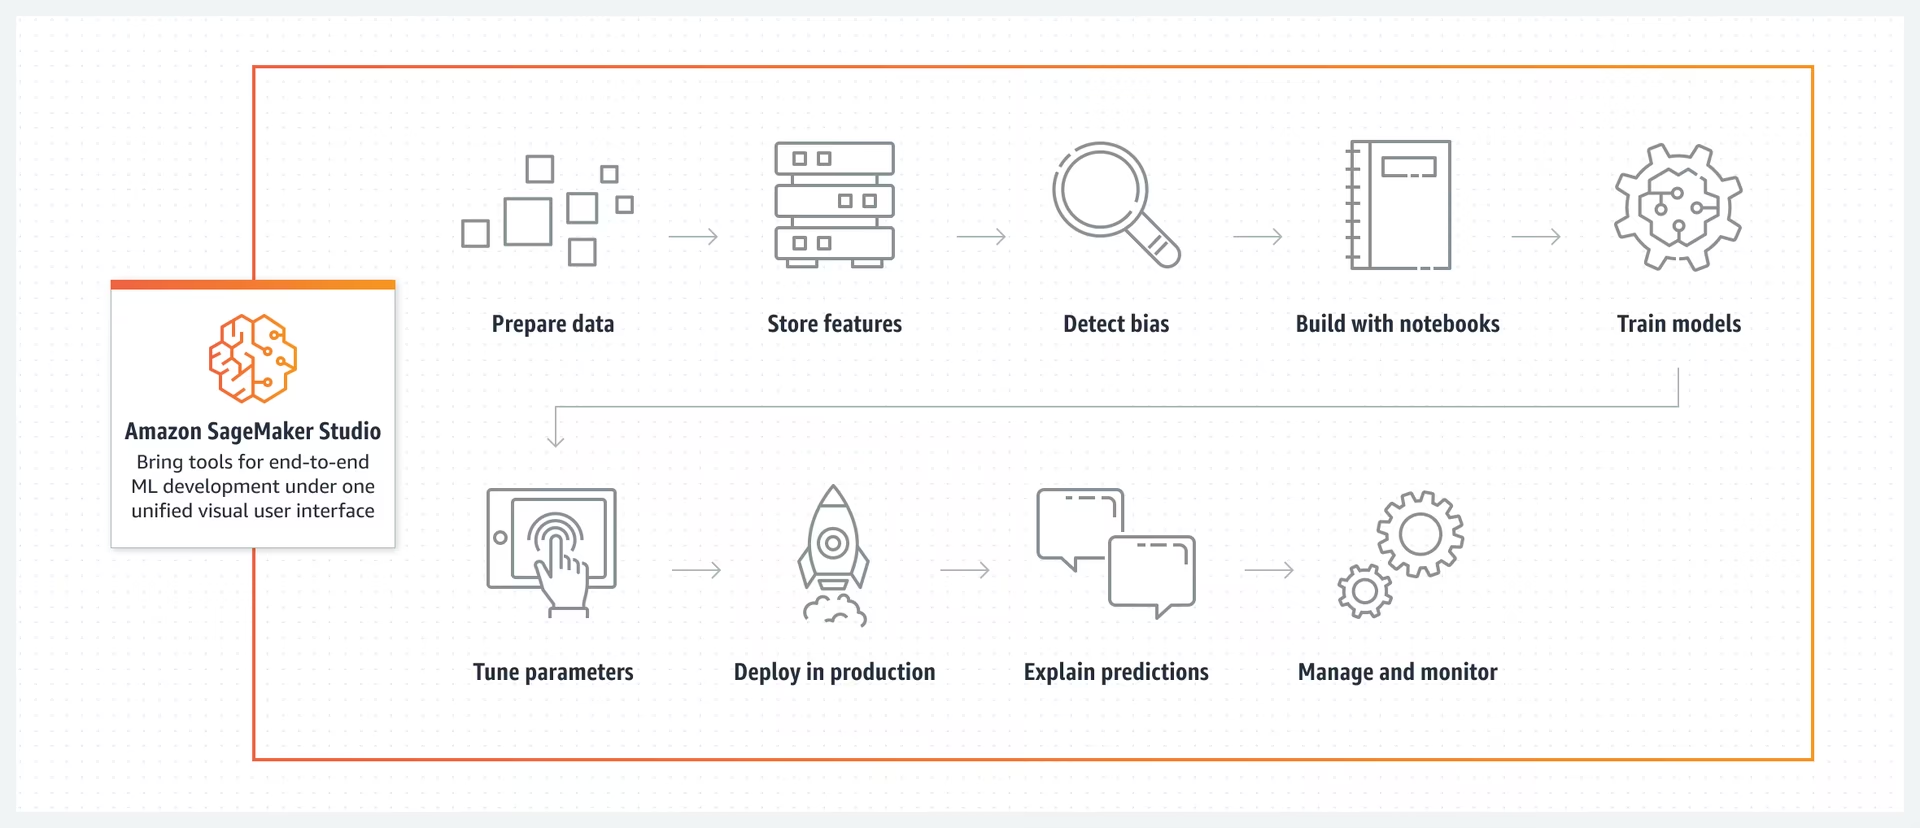
Amazon SageMaker es un servicio de aprendizaje automático de Amazon Web Services (AWS) que simplifica el proceso de creación, entrenamiento e implementación de modelos de aprendizaje automático. Ofrece una amplia variedad de herramientas para gestionar distintos aspectos de los flujos de trabajo de aprendizaje automático. Entre ellas se incluyen funciones automatizadas para ajustar modelos, opciones para entrenarlos a gran escala y métodos sencillos para implementarlos en producción. SageMaker es compatible con marcos de trabajo populares de aprendizaje automático y ofrece la flexibilidad necesaria para proyectos diversos. Sus funciones también abarcan el etiquetado de datos, la gestión de flujos de trabajo y el análisis del rendimiento.
Implementación de YOLO26 en los endpoints de Amazon SageMaker#
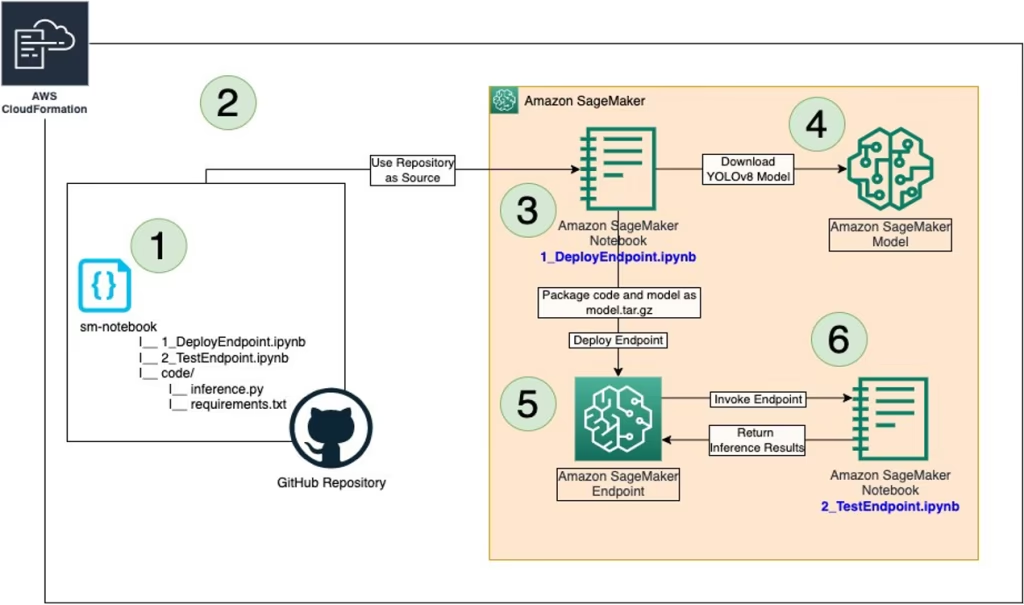
Desplegar YOLO26 en Amazon SageMaker te permite usar su entorno gestionado para la inferencia en tiempo real y aprovechar funciones como el escalado automático. Echa un vistazo a la arquitectura de AWS que aparece a continuación.
Paso 1: Configura tu entorno de AWS#
En primer lugar, asegúrate de tener preparados los siguientes requisitos previos:
-
Una cuenta de AWS: Si aún no tienes una, regístrate para obtener una cuenta de AWS.
-
Roles de IAM configurados: Necesitarás un rol de IAM con los permisos necesarios para Amazon SageMaker, AWS CloudFormation y Amazon S3. Este rol debe tener políticas que le permitan acceder a estos servicios.
-
AWS CLI: Si aún no está instalada, descarga e instala la interfaz de línea de comandos de AWS (CLI) y configúrala con los datos de tu cuenta. Sigue las instrucciones de AWS CLI para instalarla.
-
AWS CDK: Si aún no está instalado, instala el kit de desarrollo de la nube de AWS (CDK), que se utilizará para crear los scripts de implementación. Sigue las instrucciones de AWS CDK para instalarlo.
-
Cuota de servicio suficiente: Confirma que tienes cuotas suficientes para dos recursos distintos de Amazon SageMaker: una para
ml.m5.4xlarge, destinada al uso de endpoints, y otra paraml.m5.4xlarge, destinada al uso de instancias de cuaderno. Cada una requiere un valor de cuota mínimo de uno. Si tus cuotas actuales no alcanzan este requisito, es importante que solicites un aumento para cada una. Puedes solicitar un aumento de cuota siguiendo las instrucciones detalladas de la documentación de cuotas de servicio de AWS.
Paso 2: Clona el repositorio de YOLO26 para SageMaker#
El siguiente paso es clonar el repositorio específico de AWS que contiene los recursos para implementar YOLO26 en SageMaker. Este repositorio, alojado en GitHub, incluye los scripts de CDK y los archivos de configuración necesarios.
-
Clona el repositorio de GitHub: Ejecuta el siguiente comando en el terminal para clonar el repositorio host-yolov8-on-sagemaker-endpoint:
git clone https://github.com/aws-samples/host-yolov8-on-sagemaker-endpoint.git -
Ve al directorio clonado: Cambia al directorio del repositorio clonado:
cd host-yolov8-on-sagemaker-endpoint/yolov8-pytorch-cdk
Paso 3: Configura el entorno de CDK#
Ahora que tienes el código necesario, configura tu entorno para implementar con AWS CDK.
-
Crea un entorno virtual de Python: Así aislarás el entorno de Python y sus dependencias. Ejecuta:
python3 -m venv .venv -
Activa el entorno virtual:
source .venv/bin/activate -
Instala las dependencias: Instala las dependencias de Python necesarias para el proyecto:
pip3 install -r requirements.txt -
Actualiza la biblioteca de AWS CDK: Asegúrate de tener la versión más reciente de la biblioteca de AWS CDK:
pip install --upgrade aws-cdk-lib
Paso 4: Crea la pila de AWS CloudFormation#
-
Sintetiza la aplicación de CDK: Genera la plantilla de AWS CloudFormation a partir del código de CDK:
cdk synth -
Prepara la aplicación de CDK: Prepara tu entorno de AWS para la implementación con CDK:
cdk bootstrap -
Implementa la pila: Esto creará los recursos de AWS necesarios e implementará tu modelo:
cdk deploy
Paso 5: Implementa el modelo YOLO#
Una vez creada la pila de AWS CloudFormation, el siguiente paso es implementar YOLO26.
-
Abre la instancia de cuaderno: Ve a la consola de AWS y accede al servicio Amazon SageMaker. Selecciona «Notebook Instances» en el panel y, a continuación, busca la instancia de cuaderno que creó el script de implementación de CDK. Abre la instancia de cuaderno para acceder al entorno de Jupyter.
-
Accede a inference.py y modifícalo: Después de abrir la instancia de cuaderno de SageMaker en Jupyter, busca el archivo inference.py. Edita la función output_fn de inference.py como se muestra a continuación y guarda los cambios en el script, asegurándote de que no haya errores de sintaxis.
import json def output_fn(prediction_output, content_type): """Formats model outputs as JSON string, extracting attributes like boxes, masks, keypoints.""" print("Executing output_fn from inference.py ...") infer = {} for result in prediction_output: if result.boxes is not None: infer["boxes"] = result.boxes.numpy().data.tolist() if result.masks is not None: infer["masks"] = result.masks.numpy().data.tolist() if result.keypoints is not None: infer["keypoints"] = result.keypoints.numpy().data.tolist() if result.obb is not None: infer["obb"] = result.obb.numpy().data.tolist() if result.probs is not None: infer["probs"] = result.probs.numpy().data.tolist() return json.dumps(infer) -
Implementa el endpoint con 1_DeployEndpoint.ipynb: en el entorno Jupyter, abre el cuaderno 1_DeployEndpoint.ipynb situado en el directorio sm-notebook. Establece
model_nameen el cuaderno en un checkpoint de YOLO26, comoyolo26n.pt(de forma predeterminada, se usa un modelo YOLOv8), y ejecuta las celdas para descargar el modelo, empaquetarlo con el código de inferencia actualizado y subirlo a un bucket de Amazon S3. El cuaderno te guiará en la creación y la implementación de un endpoint de SageMaker para el modelo YOLO26.
Paso 6: Prueba la implementación#
Ahora que has implementado el modelo YOLO26, es importante probar su rendimiento y funcionalidad.
-
Abre el cuaderno de pruebas: En el mismo entorno de Jupyter, busca y abre el cuaderno 2_TestEndpoint.ipynb, también ubicado en el directorio sm-notebook.
-
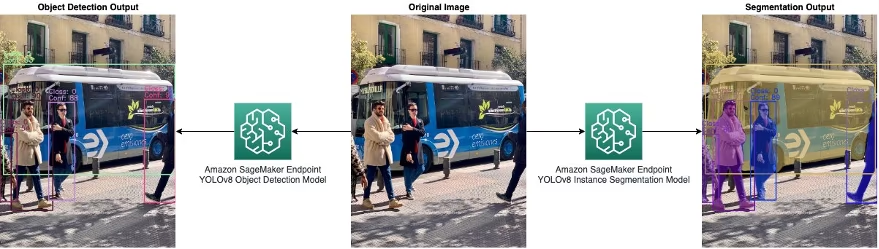
Ejecuta el cuaderno de pruebas: Sigue las instrucciones del cuaderno para probar el endpoint de SageMaker implementado. Esto incluye enviar una imagen al endpoint y ejecutar inferencias. Después, representarás la salida gráficamente para visualizar el rendimiento y la precisión del modelo, como se muestra a continuación.
- Limpia los recursos: El cuaderno de pruebas también te guiará por el proceso de eliminar el endpoint y el modelo alojado. Este paso es importante para gestionar eficazmente los costes y los recursos, sobre todo si no tienes previsto utilizar el modelo implementado de inmediato.
Paso 7: Supervisión y gestión#
Después de las pruebas, es fundamental supervisar y gestionar continuamente el modelo implementado.
-
Supervisa con Amazon CloudWatch: Comprueba periódicamente el rendimiento y el estado del endpoint de SageMaker mediante Amazon CloudWatch.
-
Gestiona el endpoint: Utiliza la consola de SageMaker para gestionar el endpoint de forma continua. Esto incluye escalar, actualizar o volver a implementar el modelo según sea necesario.
Al completar estos pasos, habrás desplegado y probado un modelo YOLO26 en los endpoints de Amazon SageMaker. El mismo flujo de trabajo se aplica al despliegue de otros modelos en AWS.
Resumen#
Esta guía te ha explicado paso a paso cómo desplegar YOLO26 en los endpoints de Amazon SageMaker mediante AWS CloudFormation y el kit de desarrollo en la nube de AWS (CDK). El proceso incluye clonar el repositorio de ejemplo de AWS de la publicación del blog de aprendizaje automático de AWS sobre el alojamiento de modelos YOLOv8 de PyTorch en endpoints de Amazon SageMaker, configurar el entorno de CDK, desplegar el modelo con los servicios de AWS y probar su rendimiento en SageMaker.
Preguntas frecuentes#
Para desplegar el modelo Ultralytics YOLO26 en Amazon SageMaker Endpoints, sigue estos pasos:
- Configura tu entorno de AWS: Asegúrate de tener una cuenta de AWS, roles de IAM con los permisos necesarios y AWS CLI configurado. Instala AWS CDK si aún no lo has hecho (consulta las instrucciones de AWS CDK).
- Clona el repositorio de YOLO26 para SageMaker:
git clone https://github.com/aws-samples/host-yolov8-on-sagemaker-endpoint.git cd host-yolov8-on-sagemaker-endpoint/yolov8-pytorch-cdk - Configura el entorno de CDK: Crea un entorno virtual de Python, actívalo, instala las dependencias y actualiza la biblioteca de AWS CDK.
python3 -m venv .venv source .venv/bin/activate pip3 install -r requirements.txt pip install --upgrade aws-cdk-lib - Despliega mediante AWS CDK: Sintetiza y despliega la pila de CloudFormation, e inicializa el entorno.
cdk synth
cdk bootstrap
cdk deploy
Para desplegar YOLO26 en Amazon SageMaker, asegúrate de cumplir los siguientes requisitos previos:
- Cuenta de AWS: Cuenta de AWS activa (regístrate en AWS.
- Roles de IAM: Roles de IAM configurados con permisos para SageMaker, CloudFormation y Amazon S3.
- AWS CLI: Interfaz de línea de comandos de AWS instalada y configurada (guía de instalación de AWS CLI).
- AWS CDK: Kit de desarrollo en la nube de AWS instalado (guía de configuración de CDK).
- Cuotas de servicio: Cuotas suficientes para las instancias
ml.m5.4xlargetanto para los endpoints como para los notebooks (solicita un aumento de cuota).
Usar Ultralytics YOLO26 en Amazon SageMaker ofrece varias ventajas:
- Escalabilidad y gestión: SageMaker proporciona un entorno gestionado con funciones como el escalado automático, que ayuda a satisfacer las necesidades de inferencia en tiempo real.
- Integración con servicios de AWS: Intégralo con otros servicios de AWS, como S3 para el almacenamiento de datos, CloudFormation para la infraestructura como código y CloudWatch para la supervisión.
- Facilidad de despliegue: Configuración simplificada mediante scripts de AWS CDK y procesos de despliegue optimizados.
- Rendimiento: Usa la infraestructura gestionada de Amazon SageMaker para ejecutar cargas de trabajo de inferencia a gran escala.
Sí, puedes personalizar la lógica de inferencia de YOLO26 en Amazon SageMaker:
-
Modifica
inference.py: Busca y personaliza la funciónoutput_fnen el archivoinference.pypara adaptar los formatos de salida.import json def output_fn(prediction_output, content_type): """Formats model outputs as JSON string, extracting attributes like boxes, masks, keypoints.""" infer = {} for result in prediction_output: if result.boxes is not None: infer["boxes"] = result.boxes.numpy().data.tolist() # Añade más lógica de procesamiento si es necesario return json.dumps(infer) -
Despliega el modelo actualizado: Asegúrate de volver a desplegar el modelo usando los notebooks de Jupyter proporcionados (
1_DeployEndpoint.ipynb) para incluir estos cambios.
Consulta los pasos detallados para desplegar el modelo modificado.
-
Para probar el modelo YOLO26 desplegado en Amazon SageMaker:
- Abre el notebook de prueba: Busca el notebook
2_TestEndpoint.ipynben el entorno Jupyter de SageMaker. - Ejecuta el notebook: Sigue sus instrucciones para enviar una imagen al endpoint, realizar la inferencia y mostrar los resultados.
- Visualización de resultados: Usa el código de trazado del notebook para dibujar los cuadros delimitadores predichos en la imagen de prueba.
Para obtener instrucciones de prueba completas, visita la sección de pruebas.
- Abre el notebook de prueba: Busca el notebook


Comentarios10
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
 User
I want to upload the YOLOv8 model I trained on my own dataset to Jupyter, and then compress it into a
model.tar.gzfile following the officialdeployendpointsteps. However, when I usetestendpoint, I encounter an error. If I rename my trained model toyolov8, the test succeeds, but it uses the original model from the official website instead of my custom one. How should I modifyinference.pyto ensure it loads my trained model?1 Glenn JocherUltralytics
@lijoe123 to ensure your custom YOLOv8 model is used, modify the
inference.pyto load your model by specifying its path directly. Ensure the model name in your deployment matches your custom model's name. For detailed steps, refer to the Ultralytics documentation on Amazon SageMaker.- User
Thank you for your answer. I had followed the
1_DeployEndpoint.ipynbto delpoy my own model. In the 1.4 Create the SageMaker PyTorchModel, I had set theenv={'TS_MAX_RESPONSE_SIZE':'20000000', 'MY_MODEL': 'my_own_model'}. And in theinference.py:def model_fn(model_dir): print("Executing model_fn from inference.py ...") env = os.environ model = YOLO(os.path.join(model_dir, env['MY_MODEL'])) return modelI think it will be use my own model directly. But it failed, and it occur this problem:
ModelError: An error occurred (ModelError) when calling the InvokeEndpoint operation: Received server error (0)from primary with message "Your invocation timed out while waiting for a response from container primary. Reviewthe latency metrics for each container in Amazon Cloudatch, resolve the issue, and try again.". See https://useast-1. console. aws. aazon. com/cloudwatch/home?region=us-east-1#logEventViewer: group=/aws/sagemaker Endpoints/yolov8-pytorch-2024-09-06-11-33-49-418696 in account 211125332801 for more information.Could you tell me how to modify the
inference.pyto load my own model. Thank you so much. - Glenn JocherUltralytics
To ensure your custom YOLOv8 model is used, verify that the
model_fnininference.pycorrectly points to your model's path. Ensure theMY_MODELenvironment variable matches your model's filename. If issues persist, check CloudWatch logs for detailed error messages. For further guidance, refer to the Ultralytics documentation on Amazon SageMaker.
SJTUPanda
Thanks for your sharing, it's very clear and useful. My own deployment workflow on AWS has already built but the test result is not so satisfying. The performance of detection result of yolo11-xl on AWS is worse than on my own laptop. I not sure if there is some default quantization when it's deployed to the AWS(I did not modified much to host-yolov8-on-sagemaker-endpoint), or do you have some other ideas about which would bring this significant performance differences?
- Glenn JocherUltralytics
@SJTUPanda thank you for your feedback! The performance difference could stem from several factors like hardware disparities (AWS instance vs laptop GPU), inference settings, or environment configurations. First, verify that your SageMaker instance type matches your local hardware capabilities, and ensure identical inference parameters (e.g.,
imgsz,batch). Check our Amazon SageMaker deployment guide for optimization tips and consider profiling both environments withyolo valto isolate bottlenecks. Let us know if specific metrics differ! 🚀 Thanks for your quick reply. The issue is fixed after I comment out resize related code. Although the model is trained with (640,640) and the input image size is (720,440), using the raw images directly as input is better than resized it. I am curious the input images would be auto-resized by the model just as in the training/testing part? And why resized by myself has so much impact on the results? If these part code should be update because yolo version updating?
image_height, image_width, _ = orig_image.shape model_height, model_width = 640, 640 x_ratio = image_width/model_width y_ratio = image_height/model_height # Resize the image as numpy array resized_image = cv2.resize(orig_image, (model_height, model_width)) # Conver the array into jpeg resized_jpeg = cv2.imencode('.jpg', resized_image)[1] # Serialize the jpg using base 64 payload = base64.b64encode(resized_jpeg).decode('utf-8')- Glenn JocherUltralytics
Thank you for sharing your findings! YOLO models do automatically resize inputs to match their training dimensions while preserving aspect ratio with letterboxing. Manual resizing can distort aspect ratios or introduce artifacts, potentially degrading performance. We recommend using the model's native preprocessing by feeding full-size images directly, as this maintains proper scaling and aspect ratio handling. For implementation details, refer to our model deployment best practices regarding input consistency.
NikoXanthidis
Gostaria de saber se esses recursos são pagos.
- Glenn JocherUltralytics
Olá! 👋 Os recursos mencionados para implementar o YOLOv8 no Amazon SageMaker não são pagos por si só. No entanto, o uso do Amazon SageMaker e outros serviços da AWS associados à implementação e execução do modelo podem incorrer em custos conforme o uso. A AWS oferece uma camada gratuita que você pode aproveitar para experimentar alguns serviços sem custo, mas é sempre bom verificar a página de preços do SageMaker para detalhes específicos. Se precisar de ajuda para estimar os custos ou tiver outras dúvidas, estou aqui para ajudar! 🚀