Exportación ONNX para modelos YOLO26
ONNX (Intercambio Abierto de Redes Neuronales) es un formato de modelo abierto que la mayoría de los entornos de ejecución de inferencia pueden cargar. Al exportar un modelo Ultralytics YOLO26 con format="onnx", se crea un único archivo .onnx que se ejecuta con ONNX Runtime en CPU, GPU de NVIDIA y AMD, Apple silicon y dispositivos Windows.
Resumen#
| Propiedad | Detalles |
|---|---|
Argumento format | onnx |
| Salida | yolo26n.onnx, un archivo con los nombres de las clases, la tarea y el tamaño de imagen guardados como metadatos; yolo26n_int8.onnx para una exportación quantize=8 calibrada |
| Se ejecuta en | CPU, GPU de NVIDIA (CUDA), GPU de AMD (MIGraphX), Apple silicon (proveedor de ejecución de Core ML) y dispositivos Windows ML |
| Entorno de ejecución | ONNX Runtime o OpenCV DNN con dnn=True |
| Precisión | FP32, FP16, INT8. YOLO26n ocupa 9,9 MB en FP32, 5,0 MB en FP16 y 3,1 MB en INT8 |
| Equipo de exportación | Linux, macOS o Windows, con o sin GPU |
Ultralytics Platform puede exportar por ti un modelo entrenado a ONNX, así que no necesitas un entorno de exportación local.
Inicio rápido#
Instala el paquete Ultralytics. La primera exportación instala onnx, onnxslim y onnxruntime si no están instalados (onnxruntime-gpu cuando exportas con device=0 en una GPU de NVIDIA).
pip install ultralyticsPara ver otros métodos de instalación, consulta la guía de instalación. Después, exporta tu modelo y carga el archivo exportado para ejecutar inferencias o validar su precisión.
from ultralytics import YOLO

# Carga un modelo YOLO26
model = YOLO("yolo26n.pt")

# Exporta el modelo al formato ONNX
model.export(format="onnx")  # crea 'yolo26n.onnx'

# Exporta un modelo ONNX cuantizado a INT8 con datos de calibración
model.export(format="onnx", quantize=8, data="coco8.yaml") # crea 'yolo26n_int8.onnx'from ultralytics import YOLO
# Carga el modelo ONNX exportado
model = YOLO("yolo26n.onnx")
# Ejecutar inferencia
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Carga el modelo ONNX exportado
model = YOLO("yolo26n.onnx")
# Valida la precisión con el conjunto de datos COCO8
metrics = model.val(data="coco8.yaml")Tareas compatibles#
La exportación a ONNX admite las siete tareas de Ultralytics con modelos YOLOv8, YOLO11 y YOLO26: detección, segmentación, segmentación semántica, estimación de profundidad, clasificación, estimación de pose y OBB. La segmentación semántica y la estimación de profundidad solo están disponibles con YOLO26, la única familia que incluye esos cabezales.
Argumentos de exportación#
| Argumento | Tipo | Predeterminado | Descripción |
|---|---|---|---|
format | str | 'onnx' | Formato de destino del modelo exportado, que define su compatibilidad con distintos entornos de implementación. |
imgsz | int o tuple | 640 | Tamaño de imagen de la entrada del modelo: un entero para imágenes cuadradas o una tupla (height, width). Si no se especifica, la exportación utiliza el tamaño con el que se entrenó el punto de control. Los puntos de control oficiales de YOLO26 utilizan 640 para detección, segmentación, pose y modelos semánticos preentrenados con ADE20K, 1024 para OBB y modelos semánticos preentrenados con Cityscapes, 768 para profundidad y 224 para clasificación. |
quantize | int o str | None | Precisión de cuantización: 16 (FP16; una exportación para CPU conserva entradas y salidas FP32, mientras que una exportación para GPU también las convierte a FP16) o 8 (cuantización estática INT8 con ONNX Runtime mediante imágenes de calibración de data, que genera un modelo _int8.onnx); 32 o sin especificar equivale a FP32. Un punto de control entrenado con quantize=8 se exporta a INT8 si quantize no se especifica o vale 8 (otros valores generan un error), mediante nodos Q/DQ basados en los rangos que contiene, sin calibración y con el nombre simple .onnx. Sustituye las opciones obsoletas half/int8. |
data | str | None | Archivo YAML del conjunto de datos utilizado para la calibración INT8; en clasificación, en su lugar se acepta un directorio de conjunto de datos o el nombre de un conjunto de datos integrado. Si se omite con quantize=8, Ultralytics selecciona el conjunto de datos de calibración predeterminado para la tarea del modelo; si el punto de control se ha entrenado con quantize=8, no hace falta. |
fraction | float, int o list | 1.0 | Subconjunto de calibración expresado como proporción, número de imágenes o proporciones/recuentos [train, val, test]. Las listas de dos elementos dejan completo test, mientras que 0 lo omite. |
dynamic | bool | False | Hace que los ejes de lote, alto y ancho de la entrada sean dinámicos, de modo que un solo archivo admita distintos tamaños de lote (hasta el valor de exportación batch con nms=True) y tamaños de imagen. Consulta la exportación dinámica. |
simplify | bool | True | Simplifica el grafo del modelo con onnxslim. |
opset | int | None | Especifica la versión de opset de ONNX para garantizar la compatibilidad con distintos analizadores y entornos de ejecución de ONNX. Si no se establece, se utiliza el opset 18 (inferior con PyTorch < 2.4), limitado a la versión onnx instalada. Consulta el opset mínimo. |
nms | bool, opcional | None | Selecciona la salida sin procesar (None, valor predeterminado), NMS integrado (True) o el cabezal sin NMS (False). Consulta el formato de salida. |
batch | int | 1 | Tamaño del lote del modelo exportado. En una exportación estática, este tamaño de lote queda fijado en la forma de entrada. Con dynamic=True y nms=True, establece el tamaño de lote máximo que tengas previsto utilizar. |
device | str | None | Dispositivo en el que se exporta: cpu (valor predeterminado, también en equipos con GPU), 0 para una GPU CUDA o mps para Apple silicon. Solo afecta al resultado de quantize=16; consulta Entradas FP16. |
Para consultar los argumentos comunes a todos los formatos, visita la documentación del modo de exportación.
Cuantización INT8#
Para los puntos de control que no se hayan entrenado con entrenamiento con conciencia de cuantización, quantize=8 aplica cuantización estática de ONNX Runtime solo a los nodos Conv, Gemm y MatMul. Todos los demás nodos se mantienen en coma flotante, incluidas las operaciones que ensamblan output0: las coordenadas de los cuadros (en píxeles) y las puntuaciones de clase (de 0 a 1) comparten ese tensor, por lo que una única escala INT8 para ese tensor redondearía todas las puntuaciones de clase a cero. Los pesos se cuantizan por canal a partir de opset 13. Excluye los mismos nodos y configura per_channel=True si ejecutas quantize_static por tu cuenta en un modelo FP32 exportado:
import onnx
from onnxruntime.quantization import quantize_static

model = "yolo26n.onnx"
exclude = [n.name for n in onnx.load(model).graph.node if n.op_type not in {"Conv", "Gemm", "MatMul"}]
quantize_static(model, "yolo26n_int8.onnx", calibration_reader, nodes_to_exclude=exclude, per_channel=True)
Aquí, calibration_reader es un onnxruntime.quantization.CalibrationDataReader que genera {"images": array} con el tamaño de lote del modelo y se preprocesa como para la inferencia: con letterbox hasta el tamaño de exportación (se cambia el tamaño y se recorta por el centro para la clasificación), en RGB, NCHW y float32 en el intervalo 0-1.
Un modelo INT8 conserva los tipos de entrada y salida del modelo FP32, por lo que el código de inferencia escrito para el modelo FP32 se ejecuta sin cambios. INT8 reduce el tamaño del archivo entre tres y cuatro veces, pero en las pruebas de rendimiento funcionó más despacio que FP32 con ONNX Runtime tanto en GPU como en CPU. Mide la latencia en el hardware de destino antes de elegir una precisión.
Formato de salida#
El modelo exportado recibe una entrada llamada images con forma (batch, 3, height, width), en RGB y escalada al intervalo 0-1. La entrada es float32, excepto en las exportaciones para GPU realizadas con quantize=16, que reciben float16. El argumento nms establece la disposición de output0. Las formas siguientes corresponden a un modelo de detección YOLO26n con 80 clases, exportado en imgsz=640:
nms | Forma de output0 | Contenido |
|---|---|---|
None (predeterminado) | (1, 84, 8400) | Para cada uno de los 8400 puntos de anclaje: centro x de la caja, centro y, ancho y alto en píxeles de entrada, seguidos de 80 puntuaciones de clase. Aplica NMS por tu cuenta. |
True | (1, 300, 6) | NMS se ejecuta dentro del modelo. Cada fila es x1, y1, x2, y2, score, class; las filas posteriores a la última detección contienen ceros. |
False | (1, 300, 6) | Cabezal sin NMS. Cada fila es x1, y1, x2, y2, score, class, sin paso de NMS. Filtra las filas por puntuación por tu cuenta. |
Las demás tareas utilizan la misma entrada y estas salidas. Las formas corresponden a los puntos de control oficiales YOLO26n en sus tamaños de exportación predeterminados, con el punto de control de Cityscapes yolo26n-sem.pt para la segmentación semántica:
| Tarea | Valor predeterminado imgsz | Salida con nms=None | Salida con nms=False o nms=True |
|---|---|---|---|
| Detección | 640 | output0 (1, 84, 8400) | output0 (1, 300, 6) |
| Segmentación | 640 | output0 (1, 116, 8400), output1 (1, 32, 160, 160) | output0 (1, 300, 38), output1 (1, 32, 160, 160) |
| Semántica | 1024 | output0 (1, 1024, 1024), uint8 índice de clase de cada píxel | Igual que nms=None |
| Profundidad | 768 | output0 (1, 1, 768, 768), mapa de profundidad | Igual que nms=None |
| Clasificar | 224 | output0 (1, 1000), probabilidades de clase tras softmax | Igual que nms=None para nms=False; nms=True genera un error |
| Pose | 640 | output0 (1, 56, 8400) | output0 (1, 300, 57): 6 valores de caja y, a continuación, 17 puntos clave x 3 |
| OBB | 1024 | output0 (1, 20, 21504) | output0 (1, 300, 7): center x, center y, width, height, score, class, angle (radianes) |
Las filas de segmentación incluyen 32 coeficientes de máscara después de los valores de la caja, y output1 contiene los prototipos de máscara. En los modelos FP32 e INT8, todas las salidas son float32, excepto el mapa de clases semánticas.
Con nms=True, el umbral de confianza conf (valor predeterminado 0.25), el umbral IoU iou (valor predeterminado 0.5), agnostic_nms y max_det (valor predeterminado 300) quedan fijados en el grafo durante la exportación. Un valor menor de conf durante la predicción no puede recuperar las detecciones que el grafo ya ha eliminado, así que vuelve a exportar para cambiar estos valores. max_det y agnostic_nms también se aplican a nms=False: max_det=100 genera output0 con forma (1, 100, 6).
YOLO("yolo26n.onnx") obtiene la disposición de los metadatos del archivo, así que solo necesitas estas formas si ejecutas el modelo con tu propio código. Tu código también puede acceder a los metadatos como cadenas: names, task, imgsz, stride, batch, end2end y args.
import ast

import onnxruntime as ort

meta = ort.InferenceSession("yolo26n.onnx").get_modelmeta().custom_metadata_map
names = ast.literal_eval(meta["names"])  # {0: 'person', 1: 'bicycle', ...}
imgsz = ast.literal_eval(meta["imgsz"]) # [640, 640]Despliega#
YOLO("yolo26n.onnx") ejecuta el modelo con ONNX Runtime y selecciona el proveedor de ejecución según el argumento device. En un equipo con una GPU CUDA, se utiliza la GPU si no se especifica device.
device | Proveedor de ejecución |
|---|---|
cpu | CPUExecutionProvider |
0 en una GPU de NVIDIA | CUDAExecutionProvider, del paquete onnxruntime-gpu, que se instala la primera vez que se utiliza |
0 en una GPU AMD ROCm | MIGraphXExecutionProvider; consulta Inferencia en GPU de AMD con MIGraphX |
mps en Apple silicon | CoreMLExecutionProvider para nodos con formas estáticas; los nodos con formas dinámicas se ejecutan en CPUExecutionProvider |
La línea de registro Using ONNX Runtime 1.31.1 with CUDAExecutionProvider indica qué proveedor está activo. El comportamiento durante la inferencia depende de cómo se haya exportado el modelo:
- Exportación estática (predeterminada): el modelo siempre se ejecuta con los valores de exportación
imgszybatch, que Ultralytics lee de los metadatos del archivo. Se ignora cualquier valorimgszque se pase apredict. Los lotes más grandes se dividen en fragmentos del tamaño de lote de exportación y los más pequeños se rellenan, así que se admite cualquier número de imágenes. - Exportación dinámica (
dynamic=True):predictadmite cualquierimgszque sea múltiplo del stride del modelo. El tamaño del lote puede variar, pero connms=Truese limita al valorbatchutilizado durante la exportación, así que establécelo en el tamaño de lote máximo que tengas previsto utilizar. - Memoria de GPU: con
CUDAExecutionProvider, un modelo estático utiliza el enlace de E/S de ONNX Runtime, que mantiene los tensores de entrada y salida en la GPU. Un modelo dinámico los copia a través de la memoria de la CPU en cada llamada. - Hilos de CPU: Ultralytics limita ONNX Runtime a 8 hilos intraoperación o al número de núcleos físicos de CPU disponibles para el proceso, si es menor. Establece la variable de entorno
ORT_INTRA_OP_NUM_THREADSpara utilizar otro número.
Pasa dnn=True a predict o val para ejecutar el modelo en la CPU con OpenCV DNN en lugar de ONNX Runtime. OpenCV DNN admite menos opciones de exportación; consulta Limitaciones y solución de problemas.
Para ejecutar el modelo fuera del paquete Ultralytics, consulta estos recursos:
- API de ONNX Runtime para Python: carga y ejecuta un modelo ONNX en Python.
- Proveedores de ejecución de ONNX Runtime: backends de hardware como CUDA, TensorRT, OpenVINO, Core ML y DirectML.
- Ejemplos de Ultralytics: inferencia con ONNX Runtime en Python, C++ y Rust, e inferencia con OpenCV DNN en Python.
- Triton Inference Server: ofrece el modelo ONNX mediante HTTP o gRPC con NVIDIA Triton.
- Implementación en dispositivos periféricos: tutoriales de ONNX Runtime para IoT y hardware periférico.
Inferencia con Windows ML#
En Windows 11 24H2 (compilación 26100) o posterior, con Python 3.10 o superior, puedes instalar onnxruntime-windowsml en un entorno independiente para que Windows ML seleccione proveedores de ejecución para tu hardware. Instálalo en lugar de otras compilaciones de ONNX Runtime y, después, usa el mismo modelo exportado .onnx con YOLO("model.onnx"). El backend conserva el número de subprocesos de PyTorch y las opciones de sesión proporcionadas, incluida una política explícita de proveedores. Si no proporcionas ninguna política, Windows ML selecciona el hardware para obtener el máximo rendimiento, incluso cuando el dispositivo de PyTorch es cpu. Mide la latencia de predicción en tu dispositivo antes de elegir este entorno de ejecución; es opcional y no se instala de forma predeterminada.
En las GPU integradas que comparten la alimentación con la CPU, los subprocesos inactivos de PyTorch durante el preprocesamiento y el posprocesamiento pueden ralentizar la inferencia de Windows ML. Llama a torch.set_num_threads(1) antes de predecir para reducir este efecto. Se aplica a todo el proceso, por lo que los demás modelos de PyTorch de ese proceso también se ejecutan en un único subproceso.
import torch

from ultralytics import YOLO

torch.set_num_threads(1)  # opcional, mídelo en tu dispositivo
results = YOLO("yolo26n.onnx")("https://ultralytics.com/images/bus.jpg")
Inferencia en GPU AMD con MIGraphX#
Ultralytics ejecuta modelos ONNX exportados en GPU de AMD mediante el proveedor de ejecución MIGraphX de ONNX Runtime. En un sistema ROCm (HIP) con Python 3.11 o posterior en x86-64, el backend ONNX instala el complemento onnxruntime-ep-migraphx la primera vez que se utiliza y selecciona MIGraphXExecutionProvider automáticamente, sin cambios en el código; se admiten todas las tareas de YOLO26. Consulta la guía de inferencia en GPU de AMD para conocer los requisitos previos, la instalación, el uso, las pruebas de rendimiento y la caché de programas compilados.
Limitaciones y solución de problemas#
- Opset mínimo: la exportación falla con
ONNX export requires opset>=Ncuandoopsetes demasiado bajo para el modelo. El mínimo es7para clasificación,9para detección, segmentación, segmentación semántica, pose y OBB,11para estimación de profundidad y para modelos de detección, segmentación, pose y OBB exportados connms=True, y16para RT-DETR. - Entradas FP16: un modelo FP16 exportado en una GPU (
quantize=16 device=0) espera tensores de entrada FP16 en tu propio código. Un modelo FP16 exportado en una CPU conserva las entradas y salidas FP32 y las convierte dentro del grafo.YOLO()proporciona el tipo de entrada adecuado en ambos casos, tanto en GPU como en CPU. - Nombre del archivo INT8:
quantize=8escribeyolo26n_int8.onnxy elimina el archivo FP32 intermedio, así que carga el archivo_int8para la inferencia. La excepción es un punto de control entrenado conquantize=8: su exportación escribe nodos Q/DQ enyolo26n.onnxy omite la calibración. - Tamaño del conjunto de calibración INT8: para un punto de control que no se haya entrenado con
quantize=8, la exportación muestra una advertencia si la partición de calibración contiene menos de 300 imágenes. La calibración utiliza la particiónvalde forma predeterminada, ycoco8.yamlsolo tiene 4 imágenes de validación, así que utiliza tu propio conjunto de datos para un modelo que tengas previsto desplegar. - NMS integrado:
nms=Truerequiere PyTorch 1.13 o posterior. Genera'nms=True' is not valid for classification modelspara la clasificación y se ignora con una advertencia en los modelos de segmentación semántica, estimación de profundidad y RT-DETR. - Cabezal sin NMS:
nms=Falserequiere un modelo con un cabezal sin NMS, como YOLO26 o YOLOv10. Para otros modelos, por ejemplo YOLO11, la exportación muestra la advertenciaThis model has no one-to-one head; using one-to-many outputsy escribe la salida sin procesar(1, 84, 8400). - No se utiliza la GPU: si el registro muestra
CUDA requested but CUDAExecutionProvider not available. Using CPU..., la compilación instalada de ONNX Runtime no tiene ningún proveedor CUDA funcional. Instalaonnxruntime-gpuen lugar deonnxruntimey comprueba que las versiones de CUDA y cuDNN coincidan con las de tu sistema. - OpenCV DNN: con OpenCV 4.14.0,
dnn=Trueejecuta los modelos predeterminados,nms=False, INT8 y FP16 exportados para GPU. No puede cargar modelos exportados connms=True, condynamic=Trueni conquantize=16en CPU. - Formas dinámicas con NMS: al combinar
dynamic=Trueconnms=True, establece tambiénbatchen el tamaño de lote máximo que tengas previsto utilizar. La exportación muestra una advertencia sibatchse deja en1. - Simplificación del grafo: si
onnxslimfalla, la exportación registra una advertencia y guarda el modelo sin simplificarlo. - Versión de IR: el exportador limita la versión de IR de ONNX a 10 para que las versiones anteriores de ONNX Runtime puedan cargar el archivo. Una exportación predeterminada con opset 18 tiene la versión de IR 8.
Para otros errores, consulta la guía de problemas habituales.
Pruebas de rendimiento#
YOLO26n funciona hasta un 43 % más rápido que YOLO11n con ONNX Runtime en CPU (Intel Xeon CPU @ 2.00 GHz). La página de modelos YOLO26 muestra la velocidad de ONNX en CPU de cada modelo para todas las tareas excepto la segmentación semántica.
Ver: Prueba de inferencia ONNX: Ultralytics YOLO26 frente a Ultralytics YOLO11 | YOLO26 ofrece una inferencia ~43 % más rápida 🚀
FP32, FP16 e INT8 con ONNX Runtime#
Las tablas siguientes comparan PyTorch con modelos ONNX FP32, FP16 e INT8 de todos los modelos de detección YOLO26, ejecutados con CUDAExecutionProvider de ONNX Runtime. Todos los valores de GPU se midieron en una GPU NVIDIA RTX PRO 6000 Blackwell Server Edition.
Milisegundos por imagen; cuanto menos, mejor. El formato más rápido de cada modelo aparece en negrita.
| Modelo | imgsz | PyTorch | ONNX FP32 | ONNX FP16 | ONNX INT8 |
|---|---|---|---|---|---|
| YOLO26n | 640 | 2.85 | 1.96 | 1.88 | 3.73 |
| YOLO26s | 640 | 2.98 | 2.14 | 1.73 | 4.31 |
| YOLO26m | 640 | 3.29 | 3.01 | 2.14 | 5.37 |
| YOLO26l | 640 | 4.70 | 4.09 | 3.08 | 7.51 |
| YOLO26x | 640 | 5.93 | 5.56 | 3.90 | 9.38 |
YOLO26n en CPU (AMD EPYC 9655, PyTorch y ONNX Runtime con 8 hilos cada uno; una CPU distinta de la utilizada para las tablas de modelos YOLO26):
| Métrica | PyTorch | ONNX FP32 | ONNX FP16 | ONNX INT8 |
|---|---|---|---|---|
| Latencia (ms/imagen) | 13.2 | 13.4 | 13.2 | 56.5 |
| mAPval 50-95 | 40.8 | 40.9 | 40.9 | 38.7 |
- FP16 redujo a la mitad el tamaño del archivo, con una diferencia de 0,1 mAP respecto a FP32, y funcionó hasta 1,4 veces más rápido que FP32 en GPU, sin acelerar en CPU.
- INT8 generó el archivo más pequeño, pero perdió entre 2,2 y 3,0 mAP y funcionó más despacio que FP32 tanto en GPU como en CPU.
Mediciones realizadas con ultralytics 8.4.211, ONNX Runtime 1.30.0, PyTorch 2.15.0 y CUDA 13.2 en batch=1, el 13 de noviembre de 2026. La latencia corresponde a la fase de inferencia que informa val y no incluye el preprocesamiento ni el posprocesamiento.
Acerca de ONNX#
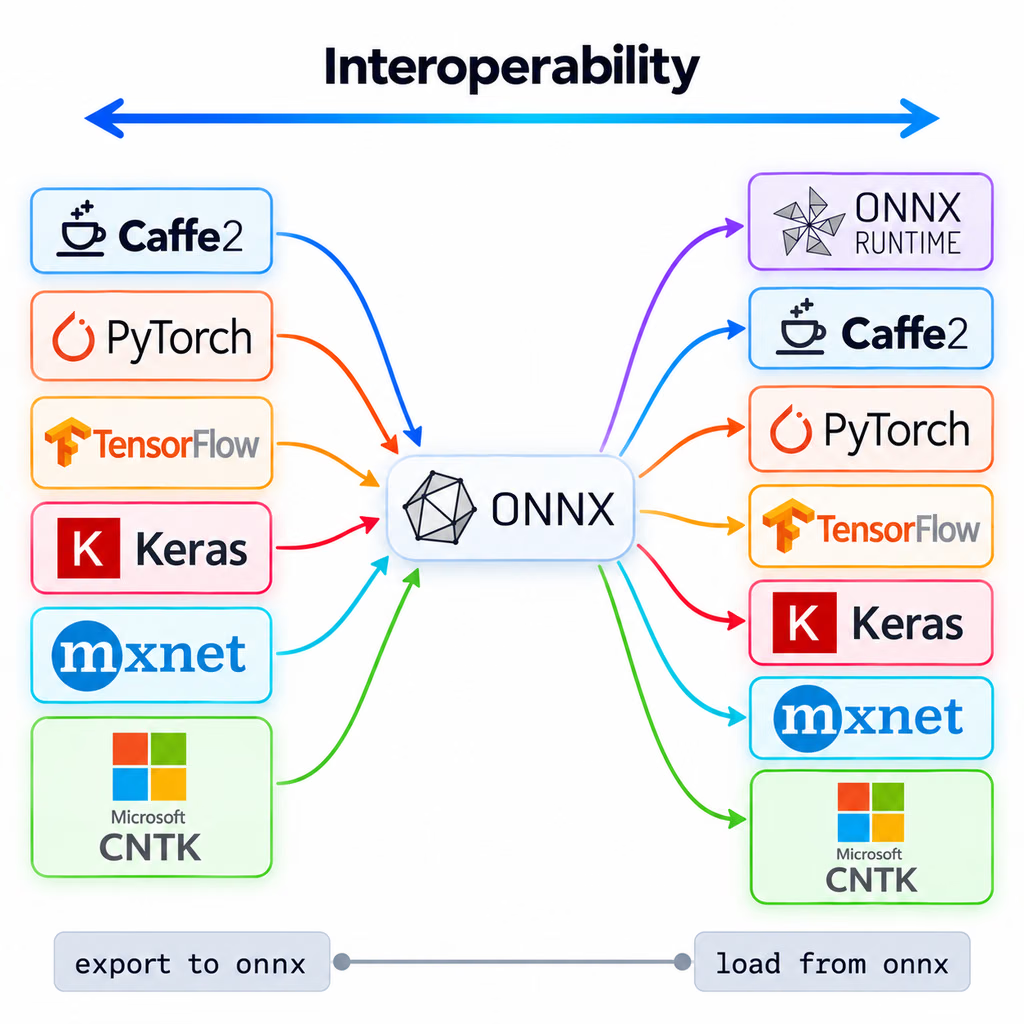
ONNX es un proyecto comunitario que iniciaron Facebook y Microsoft y que ahora desarrollan organizaciones como IBM, Amazon y Google. Define un conjunto común de operadores y un formato de archivo para modelos de aprendizaje automático, de modo que un modelo entrenado en un framework, como PyTorch, pueda ejecutarse en muchos entornos de ejecución y plataformas de hardware.
ONNX Runtime es un motor de inferencia multiplataforma para modelos ONNX. Sus proveedores de ejecución utilizan bibliotecas específicas del hardware para ejecutar un modelo en CPU, GPU y aceleradores dedicados.
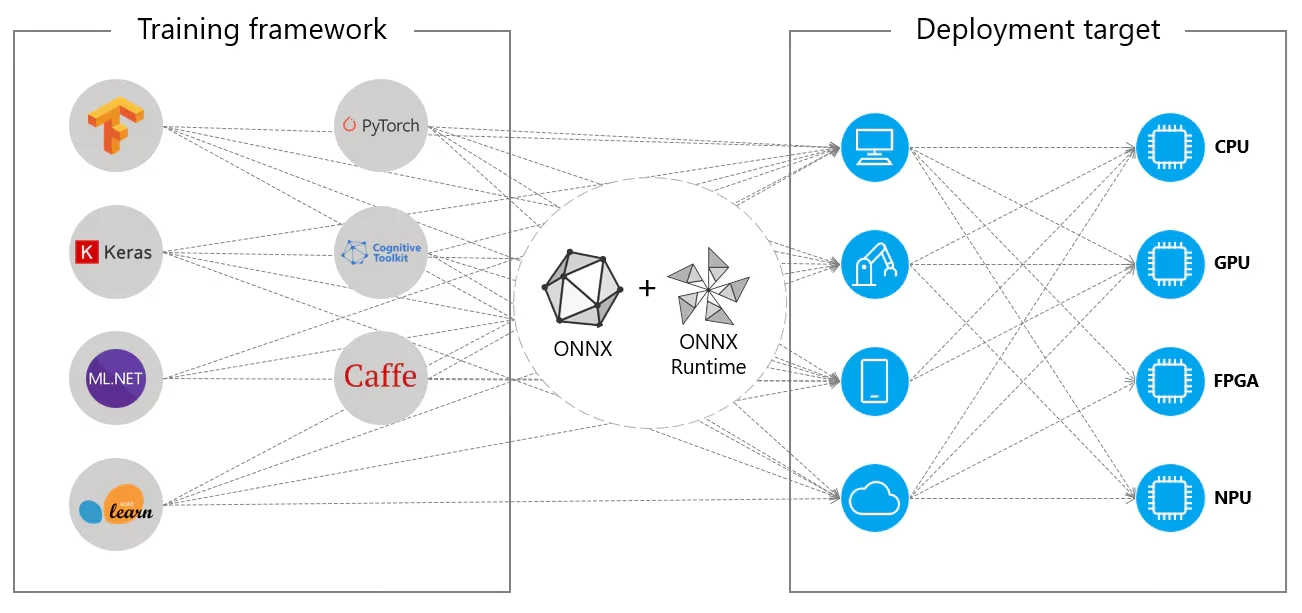
ONNX también es el paso intermedio para otros formatos de exportación de Ultralytics, incluido TensorRT, y sirve como entrada para cadenas de herramientas de NPU de distintos fabricantes, como Huawei Ascend, Qualcomm QNN y Rockchip RKNN. Consulta la documentación de ONNX para ver la especificación.
Preguntas frecuentes#
Deja
opsetsin configurar, salvo que tu entorno de ejecución necesite una versión concreta. En ese caso, el exportador usa el opset18con PyTorch 2.4 y versiones posteriores, el opset17con PyTorch 1.13 a 2.3, un opset inferior con versiones anteriores de PyTorch y nunca uno superior al que admite el paqueteonnxinstalado. El valor predeterminado se limita a 18 porque el proveedor CUDA de ONNX Runtime ejecuta algunos operadores de opset 19 y posteriores, comoResize, en la CPU. Establece un valor inferior, por ejemploopset=12, si un entorno de ejecución o conversor antiguo rechaza el valor predeterminado. El valor no puede ser inferior al opset mínimo del modelo.Depende del argumento
nmscon el que hayas exportado el modelo. Una exportación predeterminada devuelve predicciones sin procesar que requieren filtrado por confianza y NMS. Una exportación connms=Falseonms=Truedevuelve hastamax_det(300 de forma predeterminada) detecciones finales por imagen comox1, y1, x2, y2, score, classen píxeles de la imagen de entrada, por lo que solo tienes que filtrar por puntuación y escalar las cajas a la imagen original. Las filas OBB contienencenter x, center y, width, heighten lugar de las esquinas, además del ángulo. Consulta Formato de salida para ver las formas.Leer la salida sin NMS con ONNX Runtime# Exporta primero: yolo export model=yolo26n.pt format=onnx nms=False import numpy as np import onnxruntime as ort session = ort.InferenceSession("yolo26n.onnx") # exportado con nms=False image = np.zeros((1, 3, 640, 640), dtype=np.float32) # tu imagen preprocesada detections = session.run(None, {"images": image})[0][0] # shape (300, 6) detections = detections[detections[:, 4] > 0.25] # conserva las filas que superen el umbral de confianzaEstablece
dynamic=True. La entradaimagestendrá entonces la forma(batch, 3, height, width), con lote, altura y anchura dinámicos, y una detección predeterminada (nms=None)output0tendrá la forma(batch, 84, anchors), por lo que el mismo archivo admite distintos tamaños de lote e imagen durante la inferencia. Connms=True, el tamaño del lote está limitado al valorbatchusado durante la exportación. La altura y la anchura deben ser múltiplos del stride del modelo: 32 para los checkpoints oficiales YOLO26, salvo los de clasificación. Un modelo dinámico no utiliza enlace de E/S en CUDA y no se carga en OpenCV DNN, así que conserva la exportación estática predeterminada cuando el tamaño de entrada sea fijo.Exportación dinámicafrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="onnx", dynamic=True)Usa ONNX cuando un mismo archivo tenga que ejecutarse en distintos tipos de hardware o cuando la máquina de despliegue no sea la máquina en la que exportas. Usa TensorRT para obtener la latencia más baja en una GPU NVIDIA concreta: un motor TensorRT se crea para una arquitectura de GPU y una versión de TensorRT específicas, y no es portátil. Para otros destinos, consulta la guía de opciones de despliegue de modelos.


Comentarios77
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
dopeggguy
The parameter "half" bost apperence in train and export, what’s difference. when we using this parameter what should we need attention.
 Glenn JocherUltralytics(editado)
@dopeggguy Good question—summary: training uses mixed precision via
amp=True(weights stay FP32; compute is FP16 where safe), while export usesquantize=16(the formerhalf=True, now deprecated) to write an FP16 model for runtimes that support FP16. During training preferamp; use FP16 only at export/inference, and don't combine it with INT8 (quantize=8). See the train overview and AMP notes in the Train mode docs and thequantizeoption details in Model Export – Arguments and Configuration – Export Settings.from ultralytics import YOLO # Mixed-precision training (recommended) YOLO("yolo26n.yaml").train(data="data.yaml", amp=True) # FP16 export for FP16-capable runtimes (e.g., CUDA/TensorRT/OpenVINO FP16) YOLO("best.pt").export(format="onnx", quantize=16)yoloModel = YOLO(path_dir) yoloModel.export(format='onnx', dynamic=False, half=True, imgsz=(640, 640))
I'm not sure why. I enabled half=True, but the actual size of the exported model doesn't seem to change at all.
- Glenn JocherUltralytics(editado)
@dopeggguy
half=Trueis deprecated in favor ofquantize=16. On older releases a CPU-only ONNX export ignored the flag and stayed FP32, so the file size was almost identical. Current releases convert CPU ONNX exports to FP16 too (keeping float32 inputs/outputs), and GPU exports are FP16 natively. If you have a GPU, you can force export on it and re-check:from ultralytics import YOLO YOLO(path_dir).export(format="onnx", imgsz=(640, 640), dynamic=False, quantize=16, device=0)You can then open the ONNX in Netron or inspect it with the
onnxPython API to confirm the weights arefloat16; for pure CPU deployments it is often better to keep ONNX as FP32 or use a CPU‑oriented backend (e.g. OpenVINO) for FP16/INT8 optimization instead, with some general ONNX background outlined in the ONNX: Open Neural Network Exchange overview.
bastinj98
Hi, I trained d a YOLOV8-segn model to detect and segment a single class (nc=1) and then exported in to onnx (simplify, nms, half are all False) with opset = 17. The output shape is 1x37x8400.
I am building a C++ pipeline to use this model to run inference. How can I process this output to get the final segmentation mask ?
NgZiming
I exported a yolo 11 segment model to onnx format, and used onnx-runtime to infer. It responded two ndarrays of shapes (1, 37, 21504) and (1, 32, 256, 256). (imgsz=1024) So, how can i extract masks from these two arrays?
- Glenn JocherUltralytics
@NgZiming 这两个输出正是分割模型的“检测头 + 原型掩码”:
(1, 37, 21504)=4(xywh) + nc + 32(mask系数),(1, 32, 256, 256)为32个原型;掩码可由原型与对应检测的32维系数线性组合并裁剪到框内,最小示例(Python/NumPy)如下:import numpy as np import cv2 def sigmoid(x): return 1 / (1 + np.exp(-x)) def mask_from_outputs(det, proto, img_h, img_w, det_idx): # det: (1, C, N) -> (C, N), proto: (1, 32, 256, 256) -> (32, 256, 256) det = det[0]; proto = proto[0] nm, ph, pw = proto.shape # 32, 256, 256 nc = det.shape[0] - 4 - nm # 1) 取该检测的框、类别分数与32维掩码系数 cx, cy, w, h = det[0, det_idx], det[1, det_idx], det[2, det_idx], det[3, det_idx] coeff = det[4+nc:4+nc+nm, det_idx] # (32,) # 2) 原型 × 系数 -> 原始掩码 (ph, pw) m = sigmoid((proto.reshape(nm, -1).T @ coeff).reshape(ph, pw)) # 3) 可选:按框在原型分辨率下裁剪(坐标为[0,1]比例) x0 = int(max(0, (cx - w/2) * pw)); x1 = int(min(pw, (cx + w/2) * pw)) y0 = int(max(0, (cy - h/2) * ph)); y1 = int(min(ph, (cy + h/2) * ph)) crop = np.zeros_like(m); crop[y0:y1, x0:x1] = m[y0:y1, x0:x1] # 4) 上采样到原图尺寸并二值化 mask = cv2.resize(crop, (img_w, img_h), interpolation=cv2.INTER_LINEAR) return (mask > 0.5).astype(np.uint8)要点:确保与推理时的预处理一致(letterbox 缩放与填充、RGB/归一化等),否则框与掩码会错位。关于分割导出产生两个输出(
output0检测+系数,output1原型)的由来,可见导出实现参考的export_onnx说明:export_onnx 函数参考.1 thanks
- Glenn JocherUltralytics
Glad it helped—if you later need a C++ reference for segmentation mask decoding and preprocessing alignment, the step-by-step overview is in the Segmentation task docs.
 User
I have a question. If it's convenient, please answer it. Thank you! I'm working with cell images, and the image size is 3072*2048. I trained with imagesize=3072, but if I use imagesize=640, I can't detect objects. I can predict with a 3072 imagesize using a pt file, but now I'm trying to switch to C++ and call onnx, and the 3072 inference is very slow. Is this normal?
denni281
You should keep the same preprocess way between python-inference and cpp-inference.
- Glenn JocherUltralytics
@giter915 Yes—running 3072×2048 through ONNX/C++ will be much slower; inference time grows quickly with input area. Two practical options: use a faster backend or reduce effective input while keeping accuracy. For GPU, prefer TensorRT; for CPU, OpenVINO FP16/INT8 gives the largest gains. Examples:
from ultralytics import YOLO

# GPU-optimized
YOLO("best.pt").export(format="engine", imgsz=1536, half=True, dynamic=True)

# CPU-optimized
YOLO("best.pt").export(format="openvino", imgsz=1536, half=True)  # add int8=True with calibration if desired
If you must keep 3072, tile the image (e.g., 1024×1024 patches), run ONNX per tile, then merge detections with NMS in C++; this is a common approach for microscopy. Also ensure preprocessing in C++ exactly matches Python (letterbox padding, RGB order, 1/255 scaling)—agree with @DennisJcy here. For backend choices and supported export targets, see the export formats table in Object Detection – Ultralytics YOLO Docs, and for high‑throughput GPU serving consider Triton Inference Server with YOLO11.
- User
Thank you very much!
- Glenn JocherUltralytics
Glad it helped—one extra tip for ONNX Runtime C++: enable full graph optimizations and tune threads to squeeze more speed from large inputs like 3072×2048.
#include <onnxruntime_cxx_api.h>
#include <thread>

Ort::Env env(ORT_LOGGING_LEVEL_WARNING, "yolo");
Ort::SessionOptions so;
so.SetGraphOptimizationLevel(GraphOptimizationLevel::ORT_ENABLE_ALL);
so.SetIntraOpNumThreads(std::thread::hardware_concurrency());
so.SetInterOpNumThreads(1);  // often fine to leave at 1

Ort::Session session(env, "best.onnx", so);
Hello, I use ultratics to export YOLO11 half-Precision onnx model, but when I load the .onnx model to eval by onnxruntime, exception shows :Unexpected input data type. Actual: (tensor(float16)) , expected: (tensor(float)). And I compare the Float32 and Float16(half) .onnx model,These two files are exactly the same in size and input type.So the "half" keyword doesn't take effect when exporting ONNX, right? I remember Ultralytics didn't have this issue last year.
Here is my python script to export half-precision onnx model:
def main(opt): model = YOLO(opt.model) model.export( format="onnx", # opset=12, simplify=True, dynamic=False, imgsz=opt.imgsz, half=opt.half, batch=opt.batch, ) if __name__ == "__main__": multiprocessing.freeze_support() parser = argparse.ArgumentParser() parser.add_argument( "--model", type=str, default="/home/ultralytics/runs/detect/SHFY/weights/best.pt", ) parser.add_argument("--imgsz", type=int, default=640) parser.add_argument("--half", type=bool, default=True) parser.add_argument("--batch", type=int, default=1) opt, unparsed = parser.parse_known_args() print(opt) main(opt)Fine... It's my fault. My docker environment is Python-3.11.9 torch-2.4.1+cu118 CPU (unknown). The error is made by my cpu environment
- Glenn JocherUltralytics(editado)
@DennisJcy thanks for the update. On older releases
half=Truehad no effect on CPU ONNX exports, so the file stayed FP32. Current Ultralytics usesquantize=16(replacing the deprecatedhalf) and also converts CPU ONNX exports to FP16 while keeping float32 inputs/outputs, whereas GPU exports (device=0) are FP16 natively and need an FP16-capable ONNX Runtime provider. For CPU-optimized FP16 you can also export OpenVINO. For example:from ultralytics import YOLO # FP16 ONNX YOLO("best.pt").export(format="onnx", quantize=16) # CPU-optimized FP16 (OpenVINO) YOLO("best.pt").export(format="openvino", quantize=16)Details on OpenVINO export are in the export_openvino reference.
ShuaibZyx
def yolo_to_onnx(model_path, input_shape=(600, 600)): # Load the YOLOv8 model model = YOLO(model_path)
# Export the model to ONNX format
model.export(format='onnx',
             imgsz=input_shape,
             dynamic=True,
             batch=1,
             device="0")
Ultralytics YOLOv8.0.220 🚀 Python-3.9.18 torch-2.1.1+cu121 CUDA:0 (Tesla T4, 14931MiB) Model summary (fused): 268 layers, 43610463 parameters, 0 gradients, 164.8 GFLOPs
PyTorch: starting from 'best.pt' with input shape (1, 3, 640, 640) BCHW and output shape(s) (1, 9, 8400) (83.6 MB)
ONNX: starting export with onnx 1.18.0 opset 17... ONNX: export success ✅ 3.3s, saved as 'best.onnx' (166.5 MB) 我的模型在训练时是5个类别的目标检测,导出的模型的输出格式是(1, 9, 8400)。 我想请问您其中9具体代表的是什么呢? 如果是为了预测5个类别(1, 9, 8400)的输出格式是正确的嘛? 期待您的帮助!感谢!
xiaoqiang-l
9指的是:[x,y,w,h,class1_scores,class2_scores,class3_scores,class4_scores,class5_scores],即四个坐标及N个类别分数。 8400指的是:640下采样8倍、16倍、32倍特征图的anchor总数,(640/8)(640/8)+(640/16)(640/16)+(640/32)(640/32)=8080+4040+2020=8400
感谢您的指导!
- Glenn JocherUltralytics
@ShuaibZyx you're welcome! @xiaoqiang-l provided an excellent explanation. Just to confirm, the output shape (1, 9, 8400) is indeed correct for your 5-class detection model - the 9 channels represent the 4 bounding box coordinates (x, y, w, h) plus 5 class confidence scores. The 8400 represents all detection anchors across the three feature map scales (80×80 + 40×40 + 20×20 = 8400 total anchors).
UltralyticsAssistantUltralytics
👋 Hello, thank you for your interest in Ultralytics 🚀! We recommend a visit to the Docs for new users where you can find many Python and CLI usage examples, as well as detailed guides about exporting YOLO models to ONNX and other formats.
If this is a 🐛 Bug Report, please provide a minimum reproducible example to help us debug it.
If you have a custom training ❓ Question or require help with ONNX export, please include as much detail as possible—such as your command, model version, logs, and environment details. Also, check out our Tips for Best Training Results for optimal performance.
Join the Ultralytics community where it suits you best! For real-time chat, head to Discord 🎧. For in-depth discussions, try Discourse, or join the conversation on our Subreddit.
Upgrade
Upgrade to the latest
ultralyticspackage including all requirements in a Python>=3.8 environment with PyTorch>=1.8 to ensure you’re using the most up-to-date features and bug fixes:pip install -U ultralyticsEnvironments
YOLO can be run in these up-to-date verified environments, with all dependencies including CUDA/CUDNN, Python, and PyTorch preinstalled:
- Notebooks with free GPU:


- Google Cloud Deep Learning VM. See GCP Quickstart Guide
- Amazon Deep Learning AMI. See AWS Quickstart Guide
- Docker Image. See Docker Quickstart Guide
Status

If this badge is green, all Ultralytics CI tests are currently passing. CI tests verify correct operation of all YOLO Modes and Tasks on macOS, Windows, and Ubuntu every 24 hours and on every commit.
This is an automated response 🤖. An Ultralytics engineer will review your discussion and assist you soon!
- Glenn JocherUltralytics
Hello! Thanks for your interest in exporting YOLO11 models to ONNX format. This is a great option for deployment across different platforms with performance benefits.
Exporting to ONNX is straightforward with Ultralytics:
from ultralytics import YOLO

# Load model
model = YOLO("yolo11n.pt")  # or your custom trained model

# Export to ONNX with optional parameters
model.export(format="onnx", dynamic=True, simplify=True)  # creates 'yolo11n.onnx'

# Use the exported model
onnx_model = YOLO("yolo11n.onnx")
results = onnx_model("https://ultralytics.com/images/bus.jpg")
ONNX export can provide up to 3x CPU speedup compared to PyTorch models. You can customize the export with several parameters like
half=Truefor FP16 precision,dynamic=Truefor variable input sizes, oropsetto specify the ONNX version.For deployment, you can use ONNX Runtime or integrate with platforms like NVIDIA Triton Inference Server for production-scale serving.
If you have specific questions about exporting your models or encounter any issues during the process, please let us know!
- Notebooks with free GPU:
👋 Hello, thank you for your interest in Ultralytics 🚀! For users exploring ONNX integration and YOLO11, we recommend checking out the Docs where you’ll find dedicated Python and CLI tutorials, as well as specific ONNX integration guidance.
If this is a 🐛 Bug Report, please provide a minimum reproducible example to help us investigate further.
For custom deployment or export ❓ questions, please include as many details as possible, such as your export commands, model versions, and error logs. Make sure you review our Tips for Best Training Results for optimal performance.
Join the Ultralytics community where it suits you best: jump into real-time conversations on Discord 🎧, post or search on Discourse, or connect on our Subreddit.
Upgrade
Upgrade to the latest
ultralyticspackage, including all requirements, in a Python>=3.8 environment with PyTorch>=1.8 to ensure you have the latest features and fixes:pip install -U ultralyticsEnvironments
YOLO can be run in any of the following up-to-date verified environments (with all dependencies including CUDA/CUDNN, Python and PyTorch preinstalled):
- Notebooks with free GPU:
- Google Cloud Deep Learning VM. See GCP Quickstart Guide
- Amazon Deep Learning AMI. See AWS Quickstart Guide
- Docker Image. See Docker Quickstart Guide
Status
If this badge is green, all Ultralytics CI tests are currently passing. CI tests verify correct operation of all YOLO Modes and Tasks on macOS, Windows, and Ubuntu every 24 hours and on every commit.
This is an automated response. An Ultralytics engineer will assist you here soon!
- Glenn JocherUltralytics
Yes, you can adjust the batch size dynamically when exporting to ONNX format by using the
dynamic=Trueparameter in your export call. When this is enabled, the batch dimension becomes dynamic, allowing you to use various batch sizes during inference without reexporting the model.Here's a simple example:
from ultralytics import YOLO

# Load your model
model = YOLO("yolo11n.pt")

# Export with dynamic input size
model.export(format="onnx", dynamic=True)
This creates dynamic dimensions in the exported ONNX model, where the batch dimension (as well as height and width) can vary during inference. The resulting model will be more flexible for production deployments where batch size requirements might change.
- Notebooks with free GPU:
skyceeee
First of all, thank you for everything. Can we adjust the batch size dynamically when exporting the model as onnx?
When I export the YOLOV11 onnx model, I use: model.export(format='onnx', imgsz=640, device='cpu'). Then I use onnxruntime (1.14.0) to deploy it on the C++ side, but an error is reported during runtime: onnxruntime::Model::Model Unsupported model IR version: 9, max supported IR version: 8. Is there any parameter or method to set the exported model to support IR version: 8? Because I cannot upgrade onnxruntime to other higher versions locally, I look forward to your help
- Glenn JocherUltralytics
@xiaoqiang-l to resolve the ONNX IR version compatibility issue, you can specify an older
opsetversion during export. Try addingopset=13to your export command:model.export(format='onnx', imgsz=640, device='cpu', opset=13)This will generate an ONNX model compatible with IR version 8. For detailed version mapping, see the ONNX operator version matrix in the ONNX documentation.
