Déployer YOLO26 sur mobile et en périphérie avec ExecuTorch#
Le déploiement de modèles de vision par ordinateur sur des appareils en périphérie, comme les smartphones, les tablettes et les systèmes embarqués, nécessite un moteur d’exécution optimisé qui concilie performances et contraintes de ressources. ExecuTorch, la solution de PyTorch pour l’informatique en périphérie, permet d’exécuter efficacement les modèles Ultralytics YOLO directement sur l’appareil.
Ce guide explique comment exporter des modèles Ultralytics YOLO au format ExecuTorch afin de les déployer sur des appareils mobiles et en périphérie avec des performances optimisées.
Pourquoi exporter au format ExecuTorch ?#
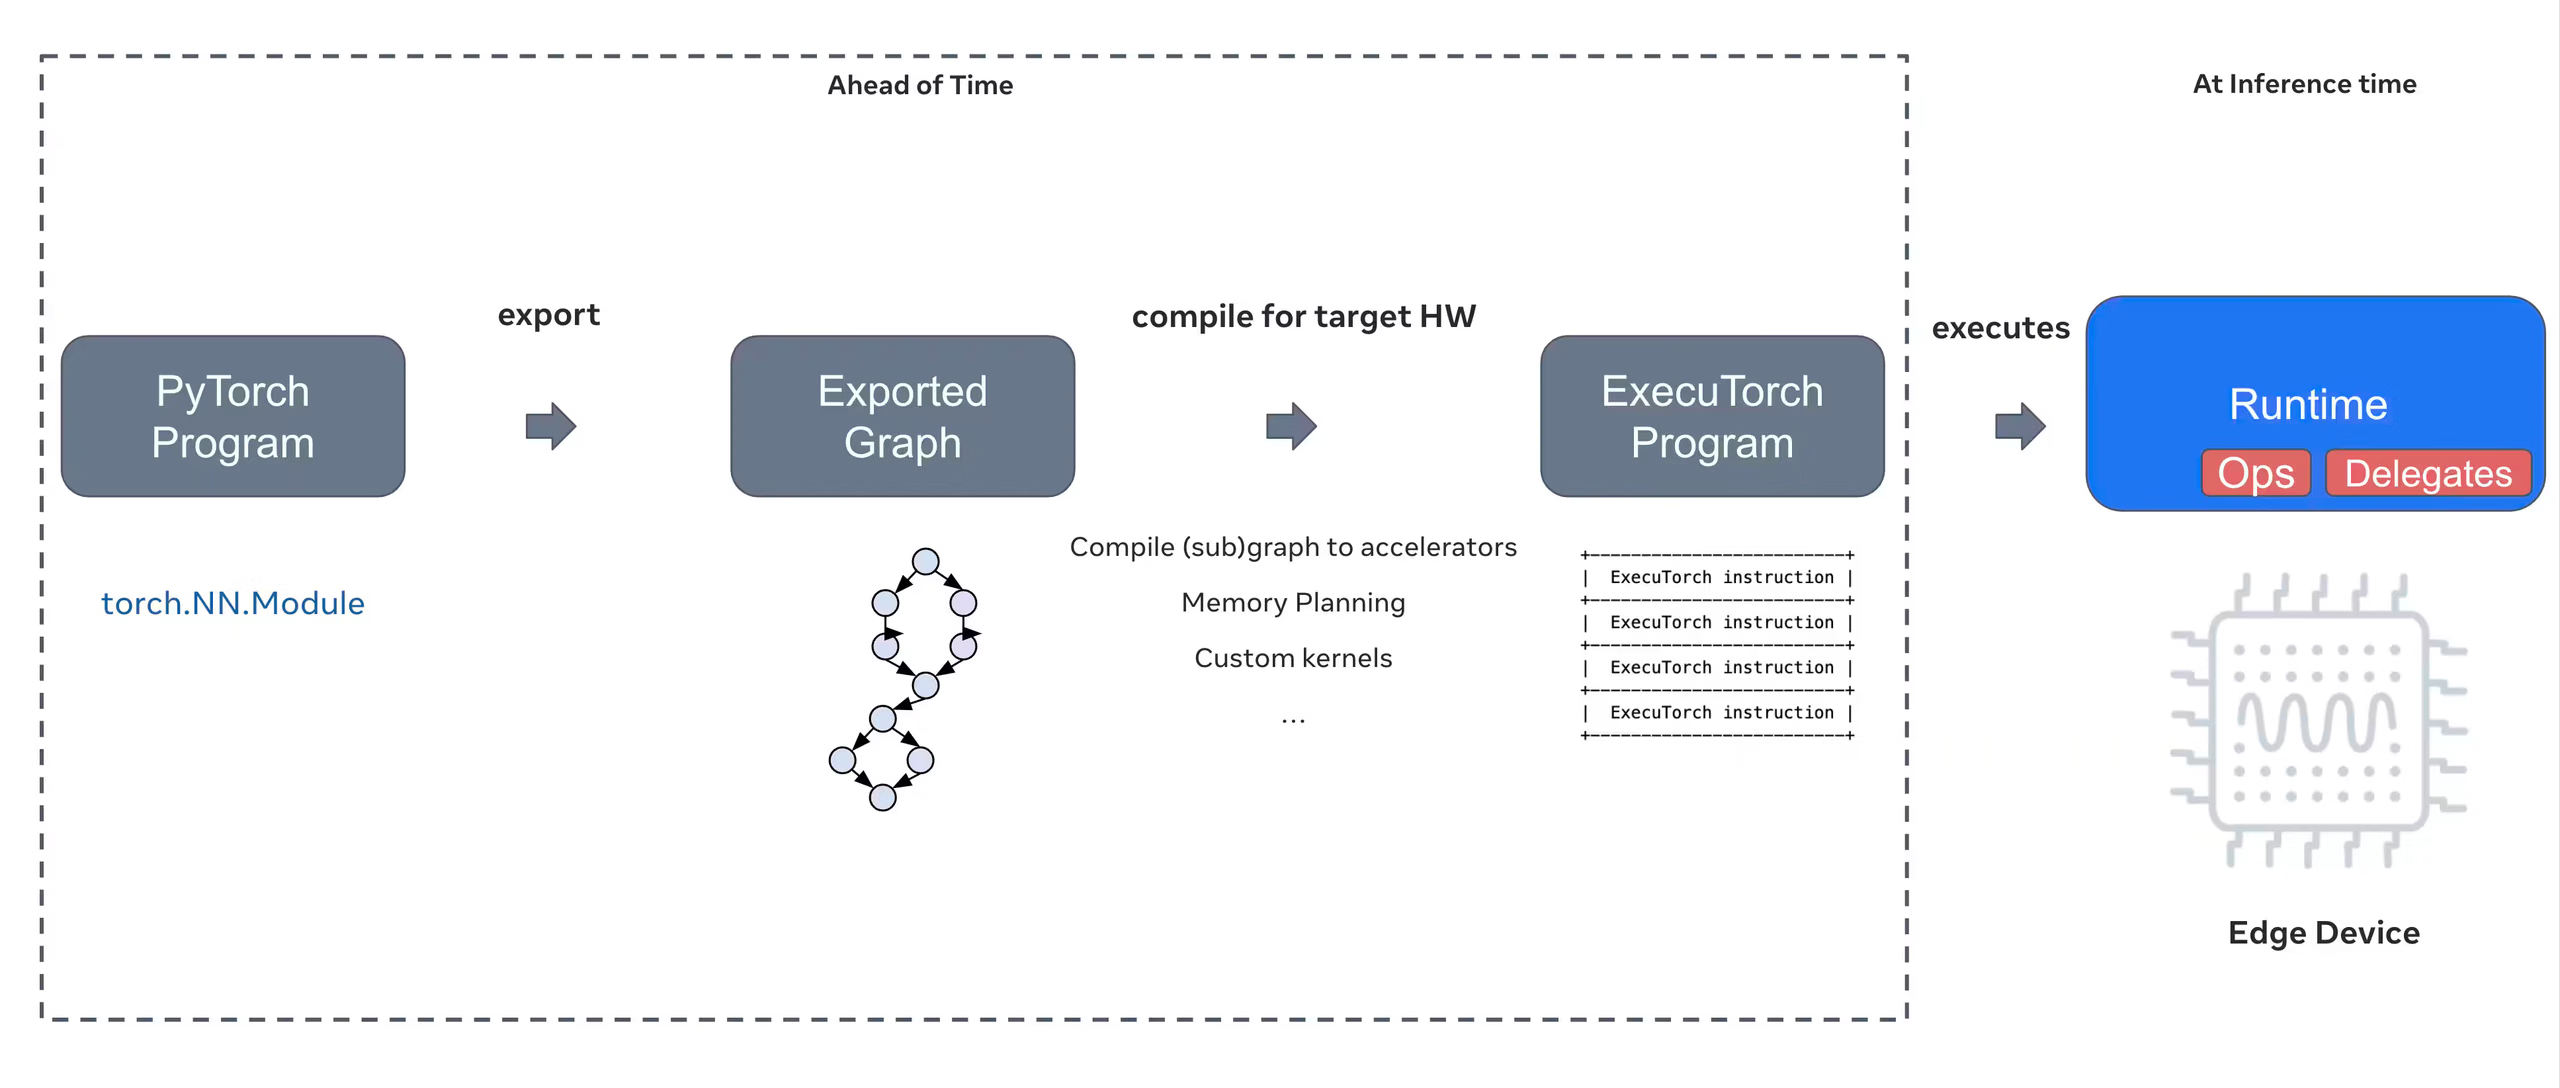
ExecuTorch est la solution de bout en bout de PyTorch qui permet l’inférence sur appareil mobile et en périphérie. Conçu pour être portable et efficace, ExecuTorch permet d’exécuter des programmes PyTorch sur une grande variété de plateformes informatiques.
Principales fonctionnalités d’ExecuTorch#
ExecuTorch propose plusieurs fonctionnalités puissantes pour déployer des modèles Ultralytics YOLO sur des appareils en périphérie :
-
Format de modèle portable : ExecuTorch utilise le format
.pte(PyTorch ExecuTorch), optimisé pour réduire la taille et accélérer le chargement sur les appareils aux ressources limitées. -
Backend XNNPACK : l’intégration par défaut à XNNPACK fournit une inférence hautement optimisée sur les CPU mobiles et offre d’excellentes performances sans matériel spécialisé.
-
Prise en charge de la quantification : l’écosystème ExecuTorch prend en charge les techniques de quantification qui réduisent la taille du modèle et accélèrent l’inférence ; Ultralytics exporte actuellement des modèles FP32 via le backend XNNPACK.
-
Efficacité mémoire : la gestion optimisée de la mémoire réduit l’empreinte mémoire à l’exécution, ce qui rend la solution adaptée aux appareils disposant de peu de RAM.
-
Métadonnées du modèle : les modèles exportés incluent leurs métadonnées (taille des images, noms des classes, etc.) dans un fichier YAML distinct, pour faciliter leur intégration.
Options de déploiement avec ExecuTorch#
Les modèles ExecuTorch peuvent être déployés sur différentes plateformes mobiles et en périphérie :
-
Applications mobiles : déploie les modèles dans des applications iOS et Android avec des performances natives, pour permettre la détection d’objets en temps réel dans les applications mobiles.
-
Systèmes embarqués : exécute les modèles sur des appareils Linux embarqués comme Raspberry Pi, NVIDIA Jetson et d’autres systèmes basés sur ARM, avec des performances optimisées.
-
Appareils d’IA en périphérie : déploie les modèles sur du matériel spécialisé d’IA en périphérie à l’aide de délégués personnalisés pour accélérer l’inférence.
-
Appareils IoT : intègre les modèles à des appareils IoT pour effectuer l’inférence directement sur l’appareil, sans connexion au cloud.
Tâches prises en charge#
L’export ExecuTorch prend en charge les sept tâches d’Ultralytics. La segmentation sémantique et l’estimation de la profondeur sont disponibles uniquement avec YOLO26, la seule famille à inclure ces têtes.
| Tâche | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Détecter | ✅ | ✅ | ✅ |
| Segmenter | ✅ | ✅ | ✅ |
| Sémantique | ❌ | ❌ | ✅ |
| Profondeur | ❌ | ❌ | ✅ |
| Classifier | ✅ | ✅ | ✅ |
| Pose | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Exporter des modèles Ultralytics YOLO26 vers ExecuTorch#
La conversion des modèles Ultralytics YOLO26 au format ExecuTorch permet de les déployer efficacement sur des appareils mobiles et en périphérie.
Installation#
L’export ExecuTorch nécessite Python 3.10-3.14 et PyTorch >= 2.9.0. Ultralytics installe un package executorch compatible lorsque tu exportes ou charges un modèle ExecuTorch ; avec les versions de PyTorch antérieures à 2.13, il est verrouillé sur executorch<1.5. Ne le mets donc pas à niveau manuellement.
# Install Ultralytics package
pip install ultralytics
Pour obtenir des instructions détaillées et des bonnes pratiques sur le processus d’installation, consulte notre guide d’installation de YOLO26. Si tu rencontres des difficultés lors de l’installation des packages requis pour YOLO26, consulte notre guide des problèmes courants pour trouver des solutions et des conseils.
Utilisation#
L’export de modèles YOLO26 vers ExecuTorch est simple :
Le format ExecuTorch prend en charge les modes Export, Predict et Validate. Exporte ton modèle, puis charge le modèle exporté pour exécuter l’inférence ou valider son exactitude.
from ultralytics import YOLO

# Charger un modèle YOLO26
model = YOLO("yolo26n.pt")

# Exporter le modèle au format ExecuTorch
model.export(format="executorch") # creates 'yolo26n_executorch_model'from ultralytics import YOLO
# Charger le modèle ExecuTorch exporté
model = YOLO("yolo26n_executorch_model")
# Exécuter l’inférence
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Charger le modèle ExecuTorch exporté
model = YOLO("yolo26n_executorch_model")
# Valider la précision sur le jeu de données COCO8
metrics = model.val(data="coco8.yaml")Les exports ExecuTorch génèrent un répertoire contenant un fichier .pte et des métadonnées. Utilise le moteur d’exécution ExecuTorch dans ton application mobile ou embarquée pour charger le modèle .pte et effectuer l’inférence.
Arguments d’exportation#
Lors de l’export au format ExecuTorch, tu peux spécifier les arguments suivants :
| Argument | Type | Valeur par défaut | Description |
|---|---|---|---|
format | str | 'executorch' | Format cible du modèle exporté, qui définit sa compatibilité avec différents environnements de déploiement. |
imgsz | int ou tuple | 640 | Taille d’image souhaitée pour l’entrée du modèle. Peut être un entier pour les images carrées ou un tuple (height, width) pour définir des dimensions spécifiques. |
quantize | int ou str | None | Export FP32 fixe. L’export ExecuTorch ne prend pas en charge la conversion de précision FP16, INT8 ou W8A16 au moment de l’export. |
batch | int | 1 | Indique la taille de lot pour l’inférence du modèle exporté ou le nombre maximal d’images que le modèle exporté traitera simultanément en mode predict. |
device | str | None | Définit l’appareil utilisé pour l’export : GPU (device=0), CPU (device=cpu), MPS pour Apple Silicon (device=mps). |
Structure de sortie#
L’export ExecuTorch crée un répertoire qui contient le modèle et ses métadonnées :
yolo26n_executorch_model/
├── model.pte               # ExecuTorch model file
└── metadata.yaml           # Model metadata (classes, image size, etc.)
Utiliser les modèles ExecuTorch exportés#
Après avoir exporté ton modèle, tu dois l’intégrer à l’application cible à l’aide du moteur d’exécution ExecuTorch.
Intégration mobile#
Pour les applications mobiles (iOS/Android), tu dois :
- Ajouter le moteur d’exécution ExecuTorch : inclure la bibliothèque du moteur d’exécution ExecuTorch dans ton projet mobile
- Charger le modèle : charger le fichier
.ptedans ton application - Exécuter l’inférence : traiter les images et obtenir des prédictions
iOS#
Exemple d’intégration iOS (Objective-C/C++) :
// iOS uses C++ APIs for model loading and inference
// See https://pytorch.org/executorch/stable/using-executorch-ios.html for complete examples

#include <executorch/extension/module/module.h>

using namespace ::executorch::extension;

// Load the model
Module module("/path/to/model.pte");

// Create input tensor
float input[1 * 3 * 640 * 640];
auto tensor = from_blob(input, {1, 3, 640, 640});

// Run inference
const auto result = module.forward(tensor);Android#
Ajoute le AAR Android d’ExecuTorch depuis Maven Central :
dependencies {
    implementation("org.pytorch:executorch-android:<version>")
}
Exemple d’intégration Android (Kotlin) :
import org.pytorch.executorch.EValue
import org.pytorch.executorch.Module
import org.pytorch.executorch.Tensor

// Load the model
val module = Module.load("/path/to/model.pte")

// Prepare input tensor
val inputTensor = Tensor.fromBlob(floatData, longArrayOf(1, 3, 640, 640))
val inputEValue = EValue.from(inputTensor)

// Run inference
val outputs = module.forward(inputEValue)
val scores = outputs[0].toTensor().dataAsFloatArray
Linux embarqué#
Pour les systèmes Linux embarqués, utilise l’API C++ d’ExecuTorch :
#include <executorch/extension/module/module.h>
#include <executorch/extension/tensor/tensor.h>

using namespace ::executorch::extension;

// Load model
Module module("model.pte");

// Prepare input
std::vector<float> input_data = preprocessImage(image);
auto input_tensor = from_blob(input_data.data(), {1, 3, 640, 640});

// Run inference
const auto outputs = module.forward(input_tensor);
Pour en savoir plus sur l’intégration d’ExecuTorch dans tes applications, consulte la documentation ExecuTorch.
Optimisation des performances#
Optimisation de la taille du modèle#
Pour réduire la taille du modèle en vue de son déploiement :
- Utiliser des modèles plus petits : commence avec YOLO26n (nano) pour obtenir l’empreinte la plus réduite
- Réduire la résolution d’entrée : utilise des images plus petites (par ex.
imgsz=320ouimgsz=416) - Quantification : applique les techniques de quantification d’ExecuTorch en dehors d’Ultralytics (l’export ExecuTorch d’Ultralytics est uniquement en FP32)
Optimisation de la vitesse d’inférence#
Pour accélérer l’inférence :
- Backend XNNPACK : le backend XNNPACK par défaut optimise l’inférence sur CPU
- Accélération matérielle : utilise des délégués spécifiques à la plateforme (par ex. CoreML pour iOS)
- Traitement par lots : traite plusieurs images lorsque c’est possible
Benchmarks#
L’équipe Ultralytics a évalué les modèles YOLO26 en comparant leur vitesse et leur précision avec PyTorch et ExecuTorch.
| Modèle | Format | Statut | Taille (Mo) | metrics/mAP50-95(B) | Temps d’inférence (ms/im) |
|---|---|---|---|---|---|
| YOLO26n | PyTorch | ✅ | 5.3 | 0.4790 | 314.80 |
| YOLO26n | ExecuTorch | ✅ | 9.4 | 0.4800 | 142 |
| YOLO26s | PyTorch | ✅ | 19.5 | 0.5730 | 930.90 |
| YOLO26s | ExecuTorch | ✅ | 36.5 | 0.5780 | 376.1 |
Le temps d’inférence n’inclut pas le prétraitement ni le post-traitement.
Dépannage#
Problèmes courants#
Problème : Python version error
Solution : ExecuTorch nécessite Python 3.10 à 3.14. Crée un environnement avec une version prise en charge :
# Using conda
conda create -n executorch python=3.14
conda activate executorch
Pour obtenir davantage d’aide au dépannage, consulte les problèmes GitHub d’Ultralytics ou la documentation ExecuTorch.
Résumé#
L’export des modèles YOLO26 au format ExecuTorch permet un déploiement efficace sur les appareils mobiles et en périphérie. Grâce à son intégration native avec PyTorch, à sa prise en charge multiplateforme et à ses performances optimisées, ExecuTorch est un excellent choix pour les applications d’IA en périphérie.
Points clés à retenir :
- ExecuTorch offre un déploiement en périphérie natif avec PyTorch et d’excellentes performances
- L’export est simple grâce au paramètre
format='executorch' - Les modèles sont optimisés pour les CPU mobiles via le backend XNNPACK
- Prend en charge iOS, Android et les plateformes Linux embarquées
- Nécessite Python 3.10-3.14 et PyTorch >= 2.9.0
FAQ#
Exporte un modèle YOLO26 vers ExecuTorch avec Python ou la CLI :
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(format="executorch")
ou
yolo export model=yolo26n.pt format=executorchL’export ExecuTorch nécessite :
- Python 3.10 à 3.14
- Le package
executorch, installé automatiquement (executorch<1.5avec les versions de PyTorch antérieures à 2.13, qui ne sont pas prises en charge par les versions plus récentes du runtime ExecuTorch) - PyTorch (installé automatiquement avec ultralytics)
Remarque : le package
executorchfournit des wheels précompilés (avec le backend XNNPACK) ; aucune étape de compilation supplémentaire n’est donc nécessaire lors de l’export.Les modèles ExecuTorch peuvent être chargés directement avec
YOLO()pour l’inférence et la validation dans Python (voir les exemples Predict/Validate ci-dessus). Ils peuvent également être déployés sur des appareils mobiles et en périphérie à l’aide des bibliothèques du runtime ExecuTorch.ExecuTorch prend en charge :
- Mobile : iOS et Android
- Linux embarqué : Raspberry Pi, NVIDIA Jetson et autres appareils ARM
- Ordinateur de bureau : Linux, macOS et Windows (pour le développement)
ExecuTorch et LiteRT sont tous deux d’excellents choix pour le déploiement mobile :
- ExecuTorch : meilleure intégration avec PyTorch, flux de travail PyTorch natif et écosystème en pleine croissance
- LiteRT : solution plus mature, prise en charge matérielle plus étendue, davantage d’exemples de déploiement et exécution du même modèle sur Android, iOS et dans le navigateur
Choisis ExecuTorch si tu utilises déjà PyTorch et que tu souhaites une voie de déploiement native. Choisis LiteRT pour une compatibilité maximale et des outils éprouvés.
Oui ! ExecuTorch prend en charge l’accélération matérielle via différents backends :
- GPU mobile : via des délégués Vulkan, Metal ou OpenCL
- NPU/DSP : via des délégués spécifiques à la plateforme
- Par défaut : XNNPACK pour une inférence optimisée sur CPU
Consulte la documentation ExecuTorch pour la configuration propre à chaque backend.