Exportation ONNX des modèles YOLO26
ONNX (Échange de réseaux neuronaux ouverts) est un format de modèle ouvert que la plupart des environnements d’inférence peuvent charger. L’exportation d’un modèle Ultralytics YOLO26 avec format="onnx" crée un seul fichier .onnx, exécutable avec ONNX Runtime sur les CPU, les GPU NVIDIA et AMD, les puces Apple et les appareils Windows.
En bref#
| Propriété | Détails |
|---|---|
Argument format | onnx |
| Sortie | yolo26n.onnx, un fichier contenant les noms des classes, la tâche et la taille d’image enregistrés sous forme de métadonnées ; yolo26n_int8.onnx pour un export quantize=8 calibré |
| Fonctionne sur | CPU, GPU NVIDIA (CUDA), GPU AMD (MIGraphX), puces Apple (fournisseur d’exécution Core ML) et appareils Windows ML |
| Environnement d’exécution | ONNX Runtime, ou OpenCV DNN avec dnn=True |
| Précision | FP32, FP16, INT8. YOLO26n fait 9,9 Mo en FP32, 5,0 Mo en FP16 et 3,1 Mo en INT8 |
| Machine d’exportation | Linux, macOS ou Windows, avec ou sans GPU |
Ultralytics Platform peut exporter pour toi un modèle entraîné au format ONNX ; tu n’as donc pas besoin d’un environnement d’exportation local.
Démarrage rapide#
Installe le paquet Ultralytics. Lors du premier export, onnx, onnxslim et onnxruntime sont installés s’ils sont absents (onnxruntime-gpu si tu exportes avec device=0 sur un GPU NVIDIA).
pip install ultralyticsPour les autres méthodes d’installation, consulte le guide d’installation. Ensuite, exporte ton modèle et charge le fichier exporté pour effectuer une inférence ou valider sa précision.
from ultralytics import YOLO

# Charger un modèle YOLO26
model = YOLO("yolo26n.pt")

# Exporter le modèle au format ONNX
model.export(format="onnx")  # crée « yolo26n.onnx »

# Exporte un modèle ONNX quantifié en INT8 avec des données d'étalonnage
model.export(format="onnx", quantize=8, data="coco8.yaml") # crée 'yolo26n_int8.onnx'from ultralytics import YOLO
# Charger le modèle ONNX exporté
model = YOLO("yolo26n.onnx")
# Exécuter l’inférence
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Charger le modèle ONNX exporté
model = YOLO("yolo26n.onnx")
# Valider la précision sur le jeu de données COCO8
metrics = model.val(data="coco8.yaml")Tâches prises en charge#
L’exportation ONNX prend en charge les sept tâches Ultralytics avec les modèles YOLOv8, YOLO11 et YOLO26 : détection, segmentation, segmentation sémantique, estimation de profondeur, classification, estimation de pose et OBB. La segmentation sémantique et l’estimation de profondeur sont disponibles uniquement avec YOLO26, la seule famille qui intègre ces têtes.
Arguments d’exportation#
| Argument | Type | Valeur par défaut | Description |
|---|---|---|---|
format | str | 'onnx' | Format cible du modèle exporté, qui définit sa compatibilité avec différents environnements de déploiement. |
imgsz | int ou tuple | 640 | Taille d’image de l’entrée du modèle : un entier pour les images carrées ou un tuple (height, width). Si elle n’est pas fournie, l’export utilise la taille à laquelle le point de contrôle a été entraîné. Les points de contrôle YOLO26 officiels utilisent 640 pour la détection, la segmentation, la pose et les modèles sémantiques préentraînés sur ADE20K, 1024 pour OBB et les modèles sémantiques préentraînés sur Cityscapes, 768 pour la profondeur et 224 pour la classification. |
quantize | int ou str | None | Précision de quantification : 16 (FP16 ; un export CPU conserve les entrées et sorties FP32, tandis qu’un export GPU les convertit aussi en FP16) ou 8 (quantification statique INT8 avec ONNX Runtime à partir d’images de calibration de data, produisant un modèle _int8.onnx) ; 32/non défini correspond à FP32. Un point de contrôle entraîné avec quantize=8 est exporté en INT8 si quantize n’est pas défini ou vaut 8 (les autres valeurs provoquent une erreur), au moyen de nœuds Q/DQ issus des plages qu’il contient, sans calibration et sous le nom simple .onnx. Remplace les options obsolètes half/int8. |
data | str | None | Fichier YAML du jeu de données utilisé pour l'étalonnage INT8 ; pour la classification, un répertoire de jeu de données ou le nom d'un jeu de données intégré est utilisé à la place. Si cette valeur n'est pas indiquée avec quantize=8, Ultralytics sélectionne le jeu de données d'étalonnage par défaut pour la tâche du modèle ; un point de contrôle entraîné avec quantize=8 n'en a pas besoin. |
fraction | float, int ou list | 1.0 | Sous-ensemble de calibration exprimé en ratio, en nombre d’images ou en listes [train, val, test] de ratios/de nombres. Les listes de deux éléments laissent test complet, tandis que 0 l’ignore. |
dynamic | bool | False | Rend dynamiques les axes du lot, de la hauteur et de la largeur de l’entrée, afin qu’un seul fichier accepte différentes tailles de lots (jusqu’à la valeur batch de l’export avec nms=True) et différentes tailles d’image. Consulte l’exportation dynamique. |
simplify | bool | True | Simplifie le graphe du modèle avec onnxslim. |
opset | int | None | Indique la version de l’opset ONNX pour assurer la compatibilité avec différents analyseurs et environnements d’exécution ONNX. Si elle n’est pas définie, utilise l’opset 18 (une version inférieure avec PyTorch < 2.4), dans la limite de la version onnx installée. Consulte la section opset minimal. |
nms | bool, facultatif | None | Sélectionne la sortie brute (None, par défaut), la NMS intégrée (True) ou la tête sans NMS (False). Consulte le format de sortie. |
batch | int | 1 | Taille du lot du modèle exporté. Pour un export statique, cette taille de lot est fixée dans la forme de l’entrée. Avec dynamic=True et nms=True, définis-la sur la taille de lot maximale que tu prévois d’utiliser. |
device | str | None | Appareil utilisé pour l’exportation : cpu (par défaut, y compris sur une machine équipée d’un GPU), 0 pour un GPU CUDA ou mps pour les puces Apple. Cela ne modifie le résultat que pour quantize=16 ; consulte Entrées FP16. |
Pour les arguments communs à tous les formats, consulte la documentation du mode Export.
Quantification INT8#
Pour les points de contrôle qui n’ont pas été entraînés avec l’entraînement tenant compte de la quantification, quantize=8 applique la quantification statique d’ONNX Runtime aux seuls nœuds Conv, Gemm et MatMul. Tous les autres nœuds restent en virgule flottante, y compris les opérateurs qui assemblent output0 : les coordonnées des boîtes (en pixels) et les scores de classe (de 0 à 1) partagent ce tenseur, si bien qu’une échelle INT8 unique pour celui-ci arrondirait tous les scores de classe à zéro. Les poids sont quantifiés par canal à partir de l’opset 13. Exclue les mêmes nœuds et définis per_channel=True si tu exécutes toi-même quantize_static sur un modèle exporté en FP32 :
import onnx
from onnxruntime.quantization import quantize_static

model = "yolo26n.onnx"
exclude = [n.name for n in onnx.load(model).graph.node if n.op_type not in {"Conv", "Gemm", "MatMul"}]
quantize_static(model, "yolo26n_int8.onnx", calibration_reader, nodes_to_exclude=exclude, per_channel=True)
Ici, calibration_reader est un onnxruntime.quantization.CalibrationDataReader qui produit {"images": array} avec la taille de lot du modèle, prétraité comme pour l’inférence : avec letterboxing à la taille d’exportation (redimensionné et recadré au centre pour la classification), en RGB, au format NCHW, float32 entre 0 et 1.
Un modèle INT8 conserve les types d’entrée et de sortie du modèle FP32 ; le code d’inférence écrit pour le modèle FP32 fonctionne donc sans modification. Le format INT8 réduit la taille du fichier d’un facteur trois à quatre par rapport au FP32, mais il était plus lent que le FP32 avec ONNX Runtime sur GPU et sur CPU dans les benchmarks. Mesure la latence sur ton matériel cible avant de choisir une précision.
Format de sortie#
Le modèle exporté reçoit une entrée nommée images, de forme (batch, 3, height, width), en RGB et normalisée entre 0 et 1. L’entrée est de type float32, sauf pour les exports GPU créés avec quantize=16, qui attendent float16. L’argument nms définit la disposition de output0. Les formes ci-dessous correspondent à un modèle de détection YOLO26n avec 80 classes, exporté à imgsz=640 :
nms | Forme output0 | Contenu |
|---|---|---|
None (par défaut) | (1, 84, 8400) | Pour chacune des 8400 ancres : centre x et centre y de la boîte, largeur et hauteur en pixels d’entrée, puis 80 scores de classe. Applique toi-même la NMS. |
True | (1, 300, 6) | La NMS est exécutée dans le modèle. Chaque ligne est x1, y1, x2, y2, score, class ; les lignes situées après la dernière détection contiennent des zéros. |
False | (1, 300, 6) | Tête sans NMS. Chaque ligne est x1, y1, x2, y2, score, class, sans étape NMS. Filtre toi-même les lignes en fonction du score. |
Les autres tâches utilisent la même entrée et les sorties suivantes. Les formes correspondent aux points de contrôle YOLO26n officiels, à leur taille d’exportation par défaut, avec le point de contrôle Cityscapes yolo26n-sem.pt pour la segmentation sémantique :
| Tâche | imgsz par défaut | Sortie avec nms=None | Sortie avec nms=False ou nms=True |
|---|---|---|---|
| Détection | 640 | output0 (1, 84, 8400) | output0 (1, 300, 6) |
| Segmentation | 640 | output0 (1, 116, 8400), output1 (1, 32, 160, 160) | output0 (1, 300, 38), output1 (1, 32, 160, 160) |
| Sémantique | 1024 | output0 (1, 1024, 1024), uint8 indice de classe pour chaque pixel | Identique à nms=None |
| Profondeur | 768 | output0 (1, 1, 768, 768), carte de profondeur | Identique à nms=None |
| Classification | 224 | output0 (1, 1000), probabilités de classe après softmax | Identique à nms=None pour nms=False ; nms=True provoque une erreur |
| Pose | 640 | output0 (1, 56, 8400) | output0 (1, 300, 57) : 6 valeurs de boîte, puis 17 points clés x 3 |
| OBB | 1024 | output0 (1, 20, 21504) | output0 (1, 300, 7) : center x, center y, width, height, score, class, angle (radians) |
Les lignes de segmentation contiennent 32 coefficients de masque après les valeurs de boîte, et output1 contient les prototypes de masque. Dans les modèles FP32 et INT8, toutes les sorties sont de type float32, sauf la carte des classes sémantiques.
Avec nms=True, le seuil de confiance conf (valeur par défaut 0.25), le seuil IoU iou (valeur par défaut 0.5), agnostic_nms et max_det (valeur par défaut 300) sont fixés dans le graphe lors de l’exportation. Une valeur conf inférieure lors de la prédiction ne peut pas rétablir les détections déjà éliminées par le graphe ; il faut donc réexporter pour modifier ces valeurs. max_det et agnostic_nms s’appliquent aussi à nms=False : max_det=100 donne la forme (1, 100, 6) à output0.
YOLO("yolo26n.onnx") lit la disposition dans les métadonnées du fichier ; tu n’as donc besoin de ces formes que si tu exécutes le modèle dans ton propre code. Les métadonnées sont également accessibles à ton code sous forme de chaînes : names, task, imgsz, stride, batch, end2end et args.
import ast

import onnxruntime as ort

meta = ort.InferenceSession("yolo26n.onnx").get_modelmeta().custom_metadata_map
names = ast.literal_eval(meta["names"])  # {0: 'person', 1: 'bicycle', ...}
imgsz = ast.literal_eval(meta["imgsz"]) # [640, 640]Déployer#
YOLO("yolo26n.onnx") exécute le modèle avec ONNX Runtime et sélectionne le fournisseur d’exécution à partir de l’argument device. Sur une machine équipée d’un GPU CUDA, le GPU est utilisé si device n’est pas défini.
device | Fournisseur d’exécution |
|---|---|
cpu | CPUExecutionProvider |
0 sur un GPU NVIDIA | CUDAExecutionProvider, du paquet onnxruntime-gpu installé lors de la première utilisation |
0 sur un GPU AMD ROCm | MIGraphXExecutionProvider, consulte Inférence sur GPU AMD avec MIGraphX |
mps sur les puces Apple | CoreMLExecutionProvider pour les nœuds à formes statiques ; les nœuds à formes dynamiques s’exécutent sur CPUExecutionProvider |
La ligne de journal Using ONNX Runtime 1.31.1 with CUDAExecutionProvider indique le fournisseur actif. Le comportement lors de l’inférence dépend du mode d’exportation du modèle :
- Export statique (par défaut) : le modèle s’exécute toujours avec les valeurs
imgszetbatchde l’exportation, qu’Ultralytics lit dans les métadonnées du fichier. Une valeurimgsztransmise àpredictest ignorée. Les lots plus grands sont divisés en blocs de la taille du lot d’exportation et les lots plus petits sont complétés ; tu peux donc traiter n’importe quel nombre d’images. - Export dynamique (
dynamic=True) :predictaccepte toute valeurimgszmultiple du pas du modèle. La taille de lot peut varier, mais avecnms=True, elle est limitée à la valeurbatchutilisée lors de l’exportation ; définis-la donc sur la taille de lot maximale que tu prévois d’utiliser. - Mémoire GPU : avec
CUDAExecutionProvider, un modèle statique utilise la liaison IO d’ONNX Runtime, qui garde les tenseurs d’entrée et de sortie sur le GPU. Un modèle dynamique les copie dans la mémoire CPU à chaque appel. - Threads CPU : Ultralytics limite ONNX Runtime à 8 threads intra-op, ou au nombre de cœurs physiques du CPU disponibles pour le processus si celui-ci est inférieur. Définis la variable d’environnement
ORT_INTRA_OP_NUM_THREADSpour utiliser un autre nombre.
Transmets dnn=True à predict ou val pour exécuter le modèle sur le CPU avec OpenCV DNN plutôt qu’avec ONNX Runtime. OpenCV DNN prend en charge moins d’options d’exportation ; consulte Limites et dépannage.
Pour exécuter le modèle sans le paquet Ultralytics, consulte ces ressources :
- API Python d’ONNX Runtime : charge et exécute un modèle ONNX en Python.
- Fournisseurs d’exécution d’ONNX Runtime : backends matériels tels que CUDA, TensorRT, OpenVINO, Core ML et DirectML.
- Exemples Ultralytics : inférence ONNX Runtime en Python, C++ et Rust, et inférence OpenCV DNN en Python.
- Triton Inference Server : déploie le modèle ONNX via HTTP ou gRPC avec NVIDIA Triton.
- Déploiement sur des appareils périphériques : tutoriels ONNX Runtime pour l’IoT et le matériel périphérique.
Inférence Windows ML#
Sous Windows 11 24H2 (build 26100) ou version ultérieure avec Python 3.10+, tu peux installer onnxruntime-windowsml dans un environnement séparé pour laisser Windows ML sélectionner les fournisseurs d’exécution adaptés à ton matériel. Installe-le à la place des autres versions d’ONNX Runtime, puis utilise le même modèle .onnx exporté avec YOLO("model.onnx"). Le backend conserve le nombre de threads PyTorch et les options de session fournies, y compris une stratégie explicite de sélection des fournisseurs. En l’absence de stratégie fournie, Windows ML sélectionne le matériel pour obtenir des performances maximales, même lorsque le périphérique PyTorch est cpu. Mesure la latence de prédiction sur ton périphérique avant de choisir ce runtime ; il est facultatif et n’est pas installé par défaut.
Sur les GPU intégrés qui partagent leur alimentation avec le CPU, les threads PyTorch inactifs pendant le prétraitement et le post-traitement peuvent ralentir l’inférence Windows ML. Appelle torch.set_num_threads(1) avant de lancer les prédictions pour réduire ce ralentissement. Ce réglage s’applique à l’ensemble du processus ; les autres modèles PyTorch exécutés dans ce processus fonctionneront donc eux aussi avec un seul thread.
import torch

from ultralytics import YOLO

torch.set_num_threads(1)  # facultatif, mesure les performances sur ton périphérique
results = YOLO("yolo26n.onnx")("https://ultralytics.com/images/bus.jpg")
Inférence sur GPU AMD avec MIGraphX#
Ultralytics exécute les modèles ONNX exportés sur les GPU AMD grâce au fournisseur d’exécution MIGraphX d’ONNX Runtime. Sur un système ROCm (HIP) avec Python 3.11 ou une version ultérieure sur x86-64, le backend ONNX installe le module onnxruntime-ep-migraphx lors de la première utilisation et sélectionne automatiquement MIGraphXExecutionProvider sans modification du code ; toutes les tâches YOLO26 sont prises en charge. Consulte le guide d’inférence sur GPU AMD pour connaître les prérequis, l’installation, l’utilisation, les benchmarks et le cache des programmes compilés.
Limites et dépannage#
- Opset minimal : l’exportation échoue avec
ONNX export requires opset>=Nlorsqueopsetest trop faible pour le modèle. Le minimum est7pour la classification,9pour la détection, la segmentation, la segmentation sémantique, la pose et OBB,11pour l’estimation de profondeur ainsi que pour les modèles de détection, de segmentation, de pose et OBB exportés avecnms=True, et16pour RT-DETR. - Entrées FP16 : un modèle FP16 exporté sur GPU (
quantize=16 device=0) attend des tenseurs d’entrée FP16 dans ton propre code. Un modèle FP16 exporté sur CPU conserve des entrées et sorties FP32 et effectue la conversion dans le graphe.YOLO()fournit le type d’entrée approprié dans les deux cas, sur GPU comme sur CPU. - Nom du fichier INT8 :
quantize=8écrityolo26n_int8.onnxet supprime le fichier FP32 intermédiaire ; charge donc le fichier_int8pour l’inférence. Les points de contrôle entraînés avecquantize=8font exception : leur exportation écrit des nœuds Q/DQ dansyolo26n.onnxet ignore la calibration. - Taille du jeu de calibration INT8 : pour un point de contrôle qui n’a pas été entraîné avec
quantize=8, l’exportation affiche un avertissement si la partition de calibration contient moins de 300 images. La calibration utilise par défaut la partitionval, etcoco8.yamlne contient que 4 images de validation ; utilise donc ton propre jeu de données pour un modèle destiné au déploiement. - NMS intégrée :
nms=Truenécessite PyTorch 1.13 ou une version ultérieure. Cette option déclenche'nms=True' is not valid for classification modelspour la classification et est ignorée avec un avertissement pour les modèles de segmentation sémantique, d’estimation de profondeur et RT-DETR. - Tête sans NMS :
nms=Falsenécessite un modèle doté d’une tête sans NMS, comme YOLO26 ou YOLOv10. Pour les autres modèles, par exemple YOLO11, l’exportation affiche l’avertissementThis model has no one-to-one head; using one-to-many outputset écrit la sortie brute(1, 84, 8400). - GPU non utilisé : si le journal affiche
CUDA requested but CUDAExecutionProvider not available. Using CPU..., la version installée d’ONNX Runtime ne dispose pas d’un fournisseur CUDA fonctionnel. Installeonnxruntime-gpuà la place deonnxruntimeet vérifie que ses versions de CUDA et de cuDNN correspondent à ton système. - OpenCV DNN : avec OpenCV 4.14.0,
dnn=Trueexécute les modèles par défaut,nms=False, INT8 et FP16 exportés sur GPU. Le chargement échoue pour les modèles exportés avecnms=True, avecdynamic=Trueou avecquantize=16sur CPU. - Formes dynamiques avec NMS : si tu combines
dynamic=Trueavecnms=True, définis aussibatchsur la taille de lot maximale que tu prévois d’utiliser. L’exportation affiche un avertissement sibatchconserve la valeur1. - Simplification du graphe : si
onnxsliméchoue, l’exportation affiche un avertissement et enregistre le modèle sans le simplifier. - Version IR : l’exportateur limite la version IR d’ONNX à 10 pour que les anciennes versions d’ONNX Runtime puissent charger le fichier. Un export par défaut avec l’opset 18 utilise la version IR 8.
Pour les autres erreurs, consulte le guide des problèmes courants.
Benchmarks#
YOLO26n s’exécute jusqu’à 43 % plus rapidement que YOLO11n avec ONNX Runtime sur CPU (Intel Xeon CPU @ 2.00 GHz). La page du modèle YOLO26 répertorie la vitesse CPU ONNX de chaque modèle pour toutes les tâches, sauf la segmentation sémantique.
À regarder : Test d’inférence ONNX : Ultralytics YOLO26 face à Ultralytics YOLO11 | Inférence environ 43 % plus rapide avec YOLO26 🚀
FP32, FP16 et INT8 avec ONNX Runtime#
Les tableaux ci-dessous comparent PyTorch aux modèles ONNX FP32, FP16 et INT8 de chaque modèle de détection YOLO26, exécutés avec CUDAExecutionProvider d’ONNX Runtime. Toutes les valeurs GPU ont été mesurées sur un seul GPU NVIDIA RTX PRO 6000 Blackwell Server Edition.
Millisecondes par image, plus bas est préférable. Le format le plus rapide pour chaque modèle est en gras.
| Modèle | imgsz | PyTorch | ONNX FP32 | ONNX FP16 | ONNX INT8 |
|---|---|---|---|---|---|
| YOLO26n | 640 | 2.85 | 1.96 | 1.88 | 3.73 |
| YOLO26s | 640 | 2.98 | 2.14 | 1.73 | 4.31 |
| YOLO26m | 640 | 3.29 | 3.01 | 2.14 | 5.37 |
| YOLO26l | 640 | 4.70 | 4.09 | 3.08 | 7.51 |
| YOLO26x | 640 | 5.93 | 5.56 | 3.90 | 9.38 |
YOLO26n sur CPU (AMD EPYC 9655, PyTorch et ONNX Runtime avec 8 threads chacun ; CPU différent de celui utilisé pour les tableaux des modèles YOLO26) :
| Mesure | PyTorch | ONNX FP32 | ONNX FP16 | ONNX INT8 |
|---|---|---|---|---|
| Latence (ms/image) | 13.2 | 13.4 | 13.2 | 56.5 |
| mAPval 50-95 | 40.8 | 40.9 | 40.9 | 38.7 |
- FP16 a divisé la taille du fichier par deux, avec un écart de moins de 0,1 mAP par rapport à FP32, et s’est exécuté jusqu’à 1,4 fois plus rapidement que FP32 sur GPU, sans accélération sur CPU.
- INT8 a produit le fichier le plus petit, mais a perdu de 2,2 à 3,0 mAP et s’est exécuté plus lentement que FP32 sur GPU comme sur CPU.
Mesures effectuées avec ultralytics 8.4.211, ONNX Runtime 1.30.0, PyTorch 2.15.0 et CUDA 13.2 à batch=1, le 13 novembre 2026. La latence correspond à l’étape d’inférence indiquée par val et n’inclut pas le prétraitement ni le post-traitement.
À propos d’ONNX#
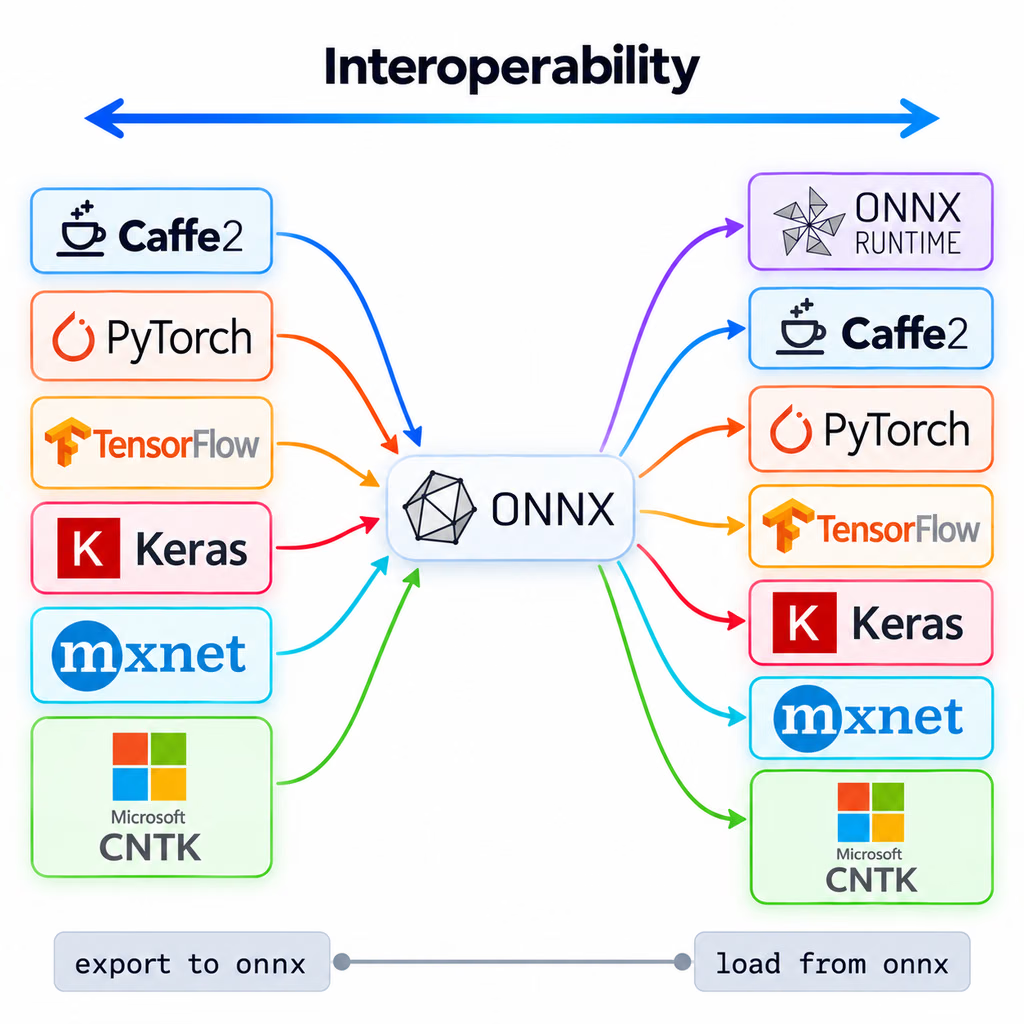
ONNX est un projet communautaire lancé par Facebook et Microsoft, désormais développé avec des organisations comme IBM, Amazon et Google. Il définit un ensemble commun d’opérateurs et un format de fichier pour les modèles de machine learning, afin qu’un modèle entraîné dans un framework, comme PyTorch, puisse s’exécuter dans de nombreux environnements d’exécution et sur de nombreuses plateformes matérielles.
ONNX Runtime est un moteur d’inférence multiplateforme pour les modèles ONNX. Ses fournisseurs d’exécution utilisent des bibliothèques propres au matériel pour exécuter un modèle sur des CPU, des GPU et des accélérateurs dédiés.
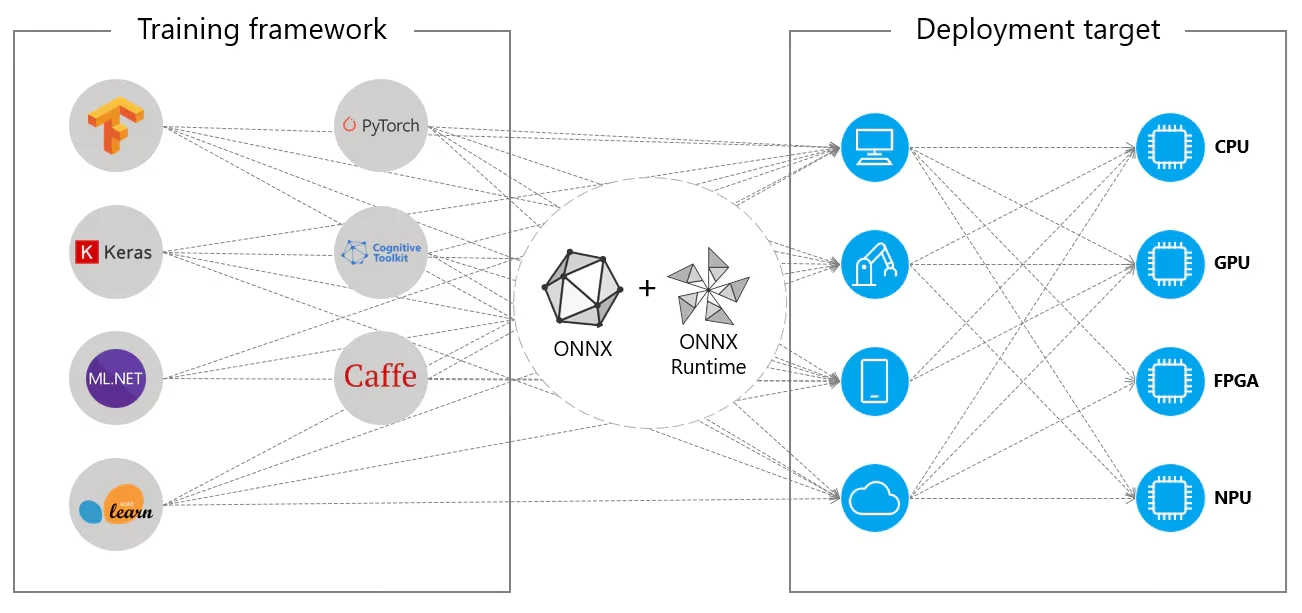
ONNX est également une étape intermédiaire pour d’autres formats d’exportation Ultralytics, notamment TensorRT, et sert d’entrée aux chaînes d’outils NPU des fournisseurs, comme Huawei Ascend, Qualcomm QNN et Rockchip RKNN. Pour consulter la spécification, voir la documentation ONNX.
FAQ#
Laisse
opsetnon défini, sauf si ton environnement d’exécution nécessite une version précise. L’exportateur utilise alors l’opset18avec PyTorch 2.4 et les versions ultérieures, l’opset17avec PyTorch 1.13 à 2.3, un opset inférieur avec les anciennes versions de PyTorch, et jamais une version supérieure à celle prise en charge par le paquetonnxinstallé. La valeur par défaut s’arrête à 18, car le fournisseur CUDA d’ONNX Runtime exécute sur le CPU certains opérateurs des opsets 19 et ultérieurs, commeResize. Choisis une valeur plus basse, par exempleopset=12, si un ancien environnement d’exécution ou convertisseur rejette la valeur par défaut. La valeur ne peut pas être inférieure à l’opset minimal du modèle.Cela dépend de l’argument
nmsutilisé pour l’exportation. Un export par défaut renvoie des prédictions brutes qui nécessitent un filtrage par confiance et une NMS. Un export avecnms=Falseounms=Truerenvoie jusqu’àmax_detdétections finales (300 par défaut) par image, sous forme dex1, y1, x2, y2, score, classdans les pixels de l’image d’entrée. Tu n’as donc qu’à filtrer par score et à remettre les boîtes à l’échelle de l’image d’origine. Les lignes OBB contiennentcenter x, center y, width, heightà la place des coins, ainsi que l’angle. Consulte le format de sortie pour connaître les formes.Lire la sortie sans NMS avec ONNX Runtime# D’abord, exporte : yolo export model=yolo26n.pt format=onnx nms=False import numpy as np import onnxruntime as ort session = ort.InferenceSession("yolo26n.onnx") # exporté avec nms=False image = np.zeros((1, 3, 640, 640), dtype=np.float32) # ton image prétraitée detections = session.run(None, {"images": image})[0][0] # shape (300, 6) detections = detections[detections[:, 4] > 0.25] # conserver les lignes au-dessus du seuil de confianceDéfinis
dynamic=True. L’entréeimagesa alors la forme(batch, 3, height, width), avec un lot, une hauteur et une largeur dynamiques, et une détectionoutput0par défaut (nms=None) a la forme(batch, 84, anchors). Le même fichier accepte donc différentes tailles de lot et d’image au moment de l’inférence. Avecnms=True, la taille du lot est limitée à la valeurbatchutilisée lors de l’exportation. La hauteur et la largeur doivent être des multiples du pas du modèle, soit 32 pour les points de contrôle YOLO26 officiels, à l’exception de ceux de classification. Un modèle dynamique n’utilise pas la liaison IO sur CUDA et ne se charge pas dans OpenCV DNN ; conserve donc l’export statique par défaut lorsque la taille d’entrée est fixe.Exportation dynamiquefrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="onnx", dynamic=True)Utilise ONNX lorsqu’un même fichier doit fonctionner sur différents matériels ou lorsque la machine de déploiement n’est pas celle utilisée pour l’exportation. Utilise TensorRT pour obtenir la latence la plus faible sur un GPU NVIDIA précis : un moteur TensorRT est créé pour une architecture GPU et une version de TensorRT données, et n’est pas portable. Pour les autres cibles, consulte le guide des options de déploiement de modèles.


Commentaires77
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
dopeggguy
The parameter "half" bost apperence in train and export, what’s difference. when we using this parameter what should we need attention.
 Glenn JocherUltralytics(modifié)
@dopeggguy Good question—summary: training uses mixed precision via
amp=True(weights stay FP32; compute is FP16 where safe), while export usesquantize=16(the formerhalf=True, now deprecated) to write an FP16 model for runtimes that support FP16. During training preferamp; use FP16 only at export/inference, and don't combine it with INT8 (quantize=8). See the train overview and AMP notes in the Train mode docs and thequantizeoption details in Model Export – Arguments and Configuration – Export Settings.from ultralytics import YOLO # Mixed-precision training (recommended) YOLO("yolo26n.yaml").train(data="data.yaml", amp=True) # FP16 export for FP16-capable runtimes (e.g., CUDA/TensorRT/OpenVINO FP16) YOLO("best.pt").export(format="onnx", quantize=16)yoloModel = YOLO(path_dir) yoloModel.export(format='onnx', dynamic=False, half=True, imgsz=(640, 640))
I'm not sure why. I enabled half=True, but the actual size of the exported model doesn't seem to change at all.
- Glenn JocherUltralytics(modifié)
@dopeggguy
half=Trueis deprecated in favor ofquantize=16. On older releases a CPU-only ONNX export ignored the flag and stayed FP32, so the file size was almost identical. Current releases convert CPU ONNX exports to FP16 too (keeping float32 inputs/outputs), and GPU exports are FP16 natively. If you have a GPU, you can force export on it and re-check:from ultralytics import YOLO YOLO(path_dir).export(format="onnx", imgsz=(640, 640), dynamic=False, quantize=16, device=0)You can then open the ONNX in Netron or inspect it with the
onnxPython API to confirm the weights arefloat16; for pure CPU deployments it is often better to keep ONNX as FP32 or use a CPU‑oriented backend (e.g. OpenVINO) for FP16/INT8 optimization instead, with some general ONNX background outlined in the ONNX: Open Neural Network Exchange overview.
bastinj98
Hi, I trained d a YOLOV8-segn model to detect and segment a single class (nc=1) and then exported in to onnx (simplify, nms, half are all False) with opset = 17. The output shape is 1x37x8400.
I am building a C++ pipeline to use this model to run inference. How can I process this output to get the final segmentation mask ?
NgZiming
I exported a yolo 11 segment model to onnx format, and used onnx-runtime to infer. It responded two ndarrays of shapes (1, 37, 21504) and (1, 32, 256, 256). (imgsz=1024) So, how can i extract masks from these two arrays?
- Glenn JocherUltralytics
@NgZiming 这两个输出正是分割模型的“检测头 + 原型掩码”:
(1, 37, 21504)=4(xywh) + nc + 32(mask系数),(1, 32, 256, 256)为32个原型;掩码可由原型与对应检测的32维系数线性组合并裁剪到框内,最小示例(Python/NumPy)如下:import numpy as np import cv2 def sigmoid(x): return 1 / (1 + np.exp(-x)) def mask_from_outputs(det, proto, img_h, img_w, det_idx): # det: (1, C, N) -> (C, N), proto: (1, 32, 256, 256) -> (32, 256, 256) det = det[0]; proto = proto[0] nm, ph, pw = proto.shape # 32, 256, 256 nc = det.shape[0] - 4 - nm # 1) 取该检测的框、类别分数与32维掩码系数 cx, cy, w, h = det[0, det_idx], det[1, det_idx], det[2, det_idx], det[3, det_idx] coeff = det[4+nc:4+nc+nm, det_idx] # (32,) # 2) 原型 × 系数 -> 原始掩码 (ph, pw) m = sigmoid((proto.reshape(nm, -1).T @ coeff).reshape(ph, pw)) # 3) 可选:按框在原型分辨率下裁剪(坐标为[0,1]比例) x0 = int(max(0, (cx - w/2) * pw)); x1 = int(min(pw, (cx + w/2) * pw)) y0 = int(max(0, (cy - h/2) * ph)); y1 = int(min(ph, (cy + h/2) * ph)) crop = np.zeros_like(m); crop[y0:y1, x0:x1] = m[y0:y1, x0:x1] # 4) 上采样到原图尺寸并二值化 mask = cv2.resize(crop, (img_w, img_h), interpolation=cv2.INTER_LINEAR) return (mask > 0.5).astype(np.uint8)要点:确保与推理时的预处理一致(letterbox 缩放与填充、RGB/归一化等),否则框与掩码会错位。关于分割导出产生两个输出(
output0检测+系数,output1原型)的由来,可见导出实现参考的export_onnx说明:export_onnx 函数参考.1 thanks
- Glenn JocherUltralytics
Glad it helped—if you later need a C++ reference for segmentation mask decoding and preprocessing alignment, the step-by-step overview is in the Segmentation task docs.
 User
I have a question. If it's convenient, please answer it. Thank you! I'm working with cell images, and the image size is 3072*2048. I trained with imagesize=3072, but if I use imagesize=640, I can't detect objects. I can predict with a 3072 imagesize using a pt file, but now I'm trying to switch to C++ and call onnx, and the 3072 inference is very slow. Is this normal?
denni281
You should keep the same preprocess way between python-inference and cpp-inference.
- Glenn JocherUltralytics
@giter915 Yes—running 3072×2048 through ONNX/C++ will be much slower; inference time grows quickly with input area. Two practical options: use a faster backend or reduce effective input while keeping accuracy. For GPU, prefer TensorRT; for CPU, OpenVINO FP16/INT8 gives the largest gains. Examples:
from ultralytics import YOLO

# GPU-optimized
YOLO("best.pt").export(format="engine", imgsz=1536, half=True, dynamic=True)

# CPU-optimized
YOLO("best.pt").export(format="openvino", imgsz=1536, half=True)  # add int8=True with calibration if desired
If you must keep 3072, tile the image (e.g., 1024×1024 patches), run ONNX per tile, then merge detections with NMS in C++; this is a common approach for microscopy. Also ensure preprocessing in C++ exactly matches Python (letterbox padding, RGB order, 1/255 scaling)—agree with @DennisJcy here. For backend choices and supported export targets, see the export formats table in Object Detection – Ultralytics YOLO Docs, and for high‑throughput GPU serving consider Triton Inference Server with YOLO11.
- User
Thank you very much!
- Glenn JocherUltralytics
Glad it helped—one extra tip for ONNX Runtime C++: enable full graph optimizations and tune threads to squeeze more speed from large inputs like 3072×2048.
#include <onnxruntime_cxx_api.h>
#include <thread>

Ort::Env env(ORT_LOGGING_LEVEL_WARNING, "yolo");
Ort::SessionOptions so;
so.SetGraphOptimizationLevel(GraphOptimizationLevel::ORT_ENABLE_ALL);
so.SetIntraOpNumThreads(std::thread::hardware_concurrency());
so.SetInterOpNumThreads(1);  // often fine to leave at 1

Ort::Session session(env, "best.onnx", so);
Hello, I use ultratics to export YOLO11 half-Precision onnx model, but when I load the .onnx model to eval by onnxruntime, exception shows :Unexpected input data type. Actual: (tensor(float16)) , expected: (tensor(float)). And I compare the Float32 and Float16(half) .onnx model,These two files are exactly the same in size and input type.So the "half" keyword doesn't take effect when exporting ONNX, right? I remember Ultralytics didn't have this issue last year.
Here is my python script to export half-precision onnx model:
def main(opt): model = YOLO(opt.model) model.export( format="onnx", # opset=12, simplify=True, dynamic=False, imgsz=opt.imgsz, half=opt.half, batch=opt.batch, ) if __name__ == "__main__": multiprocessing.freeze_support() parser = argparse.ArgumentParser() parser.add_argument( "--model", type=str, default="/home/ultralytics/runs/detect/SHFY/weights/best.pt", ) parser.add_argument("--imgsz", type=int, default=640) parser.add_argument("--half", type=bool, default=True) parser.add_argument("--batch", type=int, default=1) opt, unparsed = parser.parse_known_args() print(opt) main(opt)Fine... It's my fault. My docker environment is Python-3.11.9 torch-2.4.1+cu118 CPU (unknown). The error is made by my cpu environment
- Glenn JocherUltralytics(modifié)
@DennisJcy thanks for the update. On older releases
half=Truehad no effect on CPU ONNX exports, so the file stayed FP32. Current Ultralytics usesquantize=16(replacing the deprecatedhalf) and also converts CPU ONNX exports to FP16 while keeping float32 inputs/outputs, whereas GPU exports (device=0) are FP16 natively and need an FP16-capable ONNX Runtime provider. For CPU-optimized FP16 you can also export OpenVINO. For example:from ultralytics import YOLO # FP16 ONNX YOLO("best.pt").export(format="onnx", quantize=16) # CPU-optimized FP16 (OpenVINO) YOLO("best.pt").export(format="openvino", quantize=16)Details on OpenVINO export are in the export_openvino reference.
ShuaibZyx
def yolo_to_onnx(model_path, input_shape=(600, 600)): # Load the YOLOv8 model model = YOLO(model_path)
# Export the model to ONNX format
model.export(format='onnx',
             imgsz=input_shape,
             dynamic=True,
             batch=1,
             device="0")
Ultralytics YOLOv8.0.220 🚀 Python-3.9.18 torch-2.1.1+cu121 CUDA:0 (Tesla T4, 14931MiB) Model summary (fused): 268 layers, 43610463 parameters, 0 gradients, 164.8 GFLOPs
PyTorch: starting from 'best.pt' with input shape (1, 3, 640, 640) BCHW and output shape(s) (1, 9, 8400) (83.6 MB)
ONNX: starting export with onnx 1.18.0 opset 17... ONNX: export success ✅ 3.3s, saved as 'best.onnx' (166.5 MB) 我的模型在训练时是5个类别的目标检测,导出的模型的输出格式是(1, 9, 8400)。 我想请问您其中9具体代表的是什么呢? 如果是为了预测5个类别(1, 9, 8400)的输出格式是正确的嘛? 期待您的帮助!感谢!
xiaoqiang-l
9指的是:[x,y,w,h,class1_scores,class2_scores,class3_scores,class4_scores,class5_scores],即四个坐标及N个类别分数。 8400指的是:640下采样8倍、16倍、32倍特征图的anchor总数,(640/8)(640/8)+(640/16)(640/16)+(640/32)(640/32)=8080+4040+2020=8400
感谢您的指导!
- Glenn JocherUltralytics
@ShuaibZyx you're welcome! @xiaoqiang-l provided an excellent explanation. Just to confirm, the output shape (1, 9, 8400) is indeed correct for your 5-class detection model - the 9 channels represent the 4 bounding box coordinates (x, y, w, h) plus 5 class confidence scores. The 8400 represents all detection anchors across the three feature map scales (80×80 + 40×40 + 20×20 = 8400 total anchors).
UltralyticsAssistantUltralytics
👋 Hello, thank you for your interest in Ultralytics 🚀! We recommend a visit to the Docs for new users where you can find many Python and CLI usage examples, as well as detailed guides about exporting YOLO models to ONNX and other formats.
If this is a 🐛 Bug Report, please provide a minimum reproducible example to help us debug it.
If you have a custom training ❓ Question or require help with ONNX export, please include as much detail as possible—such as your command, model version, logs, and environment details. Also, check out our Tips for Best Training Results for optimal performance.
Join the Ultralytics community where it suits you best! For real-time chat, head to Discord 🎧. For in-depth discussions, try Discourse, or join the conversation on our Subreddit.
Upgrade
Upgrade to the latest
ultralyticspackage including all requirements in a Python>=3.8 environment with PyTorch>=1.8 to ensure you’re using the most up-to-date features and bug fixes:pip install -U ultralyticsEnvironments
YOLO can be run in these up-to-date verified environments, with all dependencies including CUDA/CUDNN, Python, and PyTorch preinstalled:
- Notebooks with free GPU:


- Google Cloud Deep Learning VM. See GCP Quickstart Guide
- Amazon Deep Learning AMI. See AWS Quickstart Guide
- Docker Image. See Docker Quickstart Guide
Status

If this badge is green, all Ultralytics CI tests are currently passing. CI tests verify correct operation of all YOLO Modes and Tasks on macOS, Windows, and Ubuntu every 24 hours and on every commit.
This is an automated response 🤖. An Ultralytics engineer will review your discussion and assist you soon!
- Glenn JocherUltralytics
Hello! Thanks for your interest in exporting YOLO11 models to ONNX format. This is a great option for deployment across different platforms with performance benefits.
Exporting to ONNX is straightforward with Ultralytics:
from ultralytics import YOLO

# Load model
model = YOLO("yolo11n.pt")  # or your custom trained model

# Export to ONNX with optional parameters
model.export(format="onnx", dynamic=True, simplify=True)  # creates 'yolo11n.onnx'

# Use the exported model
onnx_model = YOLO("yolo11n.onnx")
results = onnx_model("https://ultralytics.com/images/bus.jpg")
ONNX export can provide up to 3x CPU speedup compared to PyTorch models. You can customize the export with several parameters like
half=Truefor FP16 precision,dynamic=Truefor variable input sizes, oropsetto specify the ONNX version.For deployment, you can use ONNX Runtime or integrate with platforms like NVIDIA Triton Inference Server for production-scale serving.
If you have specific questions about exporting your models or encounter any issues during the process, please let us know!
- Notebooks with free GPU:
👋 Hello, thank you for your interest in Ultralytics 🚀! For users exploring ONNX integration and YOLO11, we recommend checking out the Docs where you’ll find dedicated Python and CLI tutorials, as well as specific ONNX integration guidance.
If this is a 🐛 Bug Report, please provide a minimum reproducible example to help us investigate further.
For custom deployment or export ❓ questions, please include as many details as possible, such as your export commands, model versions, and error logs. Make sure you review our Tips for Best Training Results for optimal performance.
Join the Ultralytics community where it suits you best: jump into real-time conversations on Discord 🎧, post or search on Discourse, or connect on our Subreddit.
Upgrade
Upgrade to the latest
ultralyticspackage, including all requirements, in a Python>=3.8 environment with PyTorch>=1.8 to ensure you have the latest features and fixes:pip install -U ultralyticsEnvironments
YOLO can be run in any of the following up-to-date verified environments (with all dependencies including CUDA/CUDNN, Python and PyTorch preinstalled):
- Notebooks with free GPU:
- Google Cloud Deep Learning VM. See GCP Quickstart Guide
- Amazon Deep Learning AMI. See AWS Quickstart Guide
- Docker Image. See Docker Quickstart Guide
Status
If this badge is green, all Ultralytics CI tests are currently passing. CI tests verify correct operation of all YOLO Modes and Tasks on macOS, Windows, and Ubuntu every 24 hours and on every commit.
This is an automated response. An Ultralytics engineer will assist you here soon!
- Glenn JocherUltralytics
Yes, you can adjust the batch size dynamically when exporting to ONNX format by using the
dynamic=Trueparameter in your export call. When this is enabled, the batch dimension becomes dynamic, allowing you to use various batch sizes during inference without reexporting the model.Here's a simple example:
from ultralytics import YOLO

# Load your model
model = YOLO("yolo11n.pt")

# Export with dynamic input size
model.export(format="onnx", dynamic=True)
This creates dynamic dimensions in the exported ONNX model, where the batch dimension (as well as height and width) can vary during inference. The resulting model will be more flexible for production deployments where batch size requirements might change.
- Notebooks with free GPU:
skyceeee
First of all, thank you for everything. Can we adjust the batch size dynamically when exporting the model as onnx?
When I export the YOLOV11 onnx model, I use: model.export(format='onnx', imgsz=640, device='cpu'). Then I use onnxruntime (1.14.0) to deploy it on the C++ side, but an error is reported during runtime: onnxruntime::Model::Model Unsupported model IR version: 9, max supported IR version: 8. Is there any parameter or method to set the exported model to support IR version: 8? Because I cannot upgrade onnxruntime to other higher versions locally, I look forward to your help
- Glenn JocherUltralytics
@xiaoqiang-l to resolve the ONNX IR version compatibility issue, you can specify an older
opsetversion during export. Try addingopset=13to your export command:model.export(format='onnx', imgsz=640, device='cpu', opset=13)This will generate an ONNX model compatible with IR version 8. For detailed version mapping, see the ONNX operator version matrix in the ONNX documentation.
