Découvre comment exporter YOLO26 au format TF SavedModel#
Le déploiement de modèles de machine learning peut s’avérer complexe. Cependant, un format de modèle efficace et flexible peut te simplifier la tâche. TF SavedModel est le format de sérialisation standard de TensorFlow pour enregistrer et charger des modèles de machine learning de manière cohérente. C’est comme une valise pour les modèles TensorFlow, qui permet de les transporter et de les utiliser facilement sur différents appareils et systèmes.
Apprendre à exporter des modèles Ultralytics YOLO26 au format TF SavedModel peut t’aider à les déployer facilement sur différentes plateformes et dans divers environnements. Dans ce guide, nous allons voir comment convertir tes modèles au format TF SavedModel afin de simplifier l’exécution d’inférences sur différents appareils.
Pourquoi exporter au format TF SavedModel ?#
Le format TensorFlow SavedModel fait partie de l’écosystème TensorFlow développé par Google, comme illustré ci-dessous. Il est conçu pour enregistrer et sérialiser facilement les modèles TensorFlow. Il regroupe tous les éléments des modèles, comme l’architecture, les poids et même les informations de compilation. Cela facilite le partage, le déploiement et la poursuite de l’entraînement dans différents environnements.
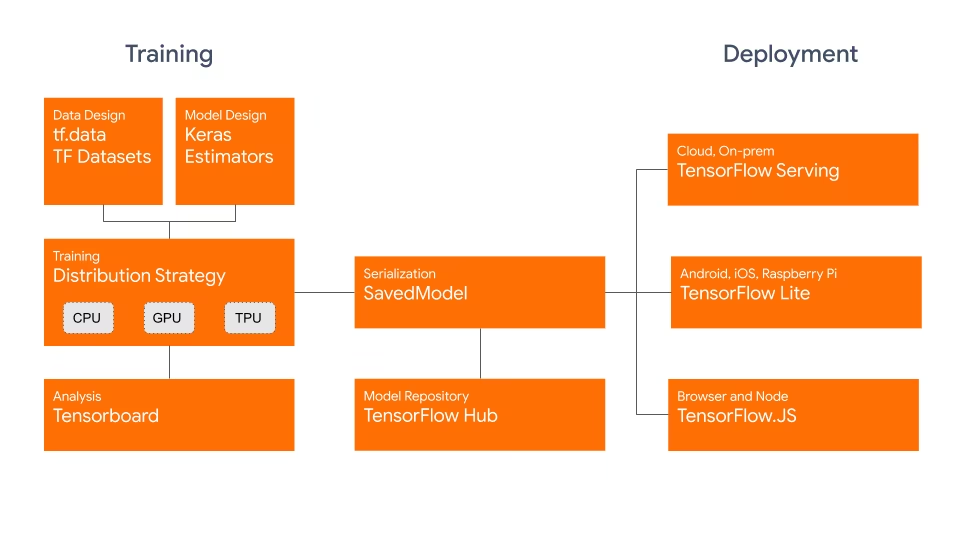
TF SavedModel présente un avantage majeur : sa compatibilité. Il fonctionne bien avec TensorFlow Serving, LiteRT (anciennement TensorFlow Lite) et TensorFlow.js. Cette compatibilité facilite le partage et le déploiement des modèles sur différentes plateformes, notamment dans les applications Web et mobiles. Le format TF SavedModel est utile aussi bien pour la recherche que pour la production. Il offre un moyen unifié de gérer tes modèles et de les préparer à toutes les applications.
Principales caractéristiques de TF SavedModel#
Voici les principales caractéristiques qui font de TF SavedModel une excellente option pour les développeurs en IA :
-
Portabilité : TF SavedModel fournit un format de sérialisation indépendant du langage, récupérable et hermétique. Il permet aux systèmes et aux outils de niveau supérieur de produire, d’utiliser et de transformer des modèles TensorFlow. Les SavedModels peuvent être facilement partagés et déployés sur différentes plateformes et dans divers environnements.
-
Facilité de déploiement : TF SavedModel regroupe le graphe de calcul, les paramètres entraînés et les métadonnées nécessaires dans un seul paquet. Les modèles peuvent être facilement chargés et utilisés pour l’inférence sans le code d’origine qui a servi à les créer. Le déploiement de modèles TensorFlow dans différents environnements de production est ainsi simple et efficace.
-
Gestion des ressources : TF SavedModel permet d’inclure des ressources externes comme des vocabulaires, des plongements ou des tables de correspondance. Ces ressources sont stockées avec la définition du graphe et les variables, ce qui garantit leur disponibilité au chargement du modèle. Cette fonctionnalité simplifie la gestion et la distribution des modèles qui dépendent de ressources externes.
Options de déploiement avec TF SavedModel#
Avant d’aborder l’exportation de modèles YOLO26 au format TF SavedModel, examinons quelques scénarios de déploiement courants dans lesquels ce format est utilisé.
TF SavedModel propose différentes options pour déployer tes modèles de machine learning :
-
TensorFlow Serving : TensorFlow Serving est un système flexible et performant conçu pour les environnements de production. Il prend en charge TF SavedModel de manière native, ce qui facilite le déploiement et la mise à disposition de tes modèles sur des plateformes cloud, des serveurs sur site ou des appareils de périphérie.
-
Plateformes cloud : les principaux fournisseurs de cloud comme Google Cloud (GCP), Amazon Web Services (AWS) et Microsoft Azure proposent des services pour déployer et exécuter des modèles TensorFlow, notamment TF SavedModel. Ces services fournissent une infrastructure évolutive et gérée, qui te permet de déployer et de faire évoluer facilement tes modèles.
-
Appareils mobiles et embarqués : LiteRT (anciennement TensorFlow Lite), une solution légère pour exécuter des modèles de machine learning sur des appareils mobiles, embarqués et IoT, prend en charge la conversion de TF SavedModel au format LiteRT. Tu peux ainsi déployer tes modèles sur un large éventail d’appareils, des smartphones et tablettes aux microcontrôleurs et appareils de périphérie.
-
TensorFlow Runtime : TensorFlow Runtime (
tfrt) est un environnement d’exécution hautes performances pour exécuter des graphes TensorFlow. Il fournit des API de plus bas niveau pour charger et exécuter des TF SavedModels dans des environnements C++. TensorFlow Runtime offre de meilleures performances que l’environnement d’exécution TensorFlow standard. Il convient aux scénarios de déploiement qui nécessitent une inférence à faible latence et une intégration étroite avec des bases de code C++ existantes.
Tâches prises en charge#
L’exportation TF SavedModel prend en charge les sept tâches Ultralytics. La segmentation sémantique et l’estimation de profondeur ne sont disponibles qu’avec YOLO26, la seule famille qui intègre ces têtes.
| Tâche | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Détecter | ✅ | ✅ | ✅ |
| Segmenter | ✅ | ✅ | ✅ |
| Sémantique | ❌ | ❌ | ✅ |
| Profondeur | ❌ | ❌ | ✅ |
| Classifier | ✅ | ✅ | ✅ |
| Pose | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Exporter des modèles YOLO26 vers TF SavedModel#
L’exportation de modèles YOLO26 au format TF SavedModel améliore leur adaptabilité et facilite leur déploiement sur différentes plateformes.
Installation#
Pour installer le package requis, exécute :
# Install the required package for YOLO26
pip install ultralytics
Pour obtenir des instructions détaillées et connaître les bonnes pratiques liées à l’installation, consulte notre guide d’installation Ultralytics. Si tu rencontres des difficultés lors de l’installation des packages requis pour YOLO26, consulte notre guide des problèmes courants, qui propose des solutions et des conseils.
Utilisation#
Tous les modèles Ultralytics YOLO26 sont conçus pour prendre en charge l’exportation dès leur installation, ce qui facilite leur intégration à ton flux de déploiement préféré. Tu peux consulter la liste complète des formats d’exportation pris en charge et des options de configuration pour choisir la configuration la mieux adaptée à ton application.
Le format TF SavedModel prend en charge les modes Export, Predict et Validate. Exporte ton modèle, puis charge le modèle exporté pour effectuer des inférences ou valider sa précision.
from ultralytics import YOLO

# Charger un modèle YOLO26
model = YOLO("yolo26n.pt")

# Exporter le modèle au format TF SavedModel
model.export(format="saved_model") # creates 'yolo26n_saved_model'from ultralytics import YOLO
# Charger le modèle TF SavedModel exporté
model = YOLO("./yolo26n_saved_model")
# Exécuter l’inférence
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Charger le modèle TF SavedModel exporté
model = YOLO("./yolo26n_saved_model")
# Valider la précision sur le jeu de données COCO8
metrics = model.val(data="coco8.yaml")Arguments d’exportation#
| Argument | Type | Valeur par défaut | Description |
|---|---|---|---|
format | str | 'saved_model' | Format cible du modèle exporté, qui définit sa compatibilité avec différents environnements de déploiement. |
imgsz | int ou tuple | 640 | Taille d’image souhaitée pour l’entrée du modèle. Peut être un entier pour les images carrées ou un tuple (height, width) pour définir des dimensions spécifiques. |
quantize | int ou str | None | Précision de quantification : 8 (INT8/PTQ ; nécessite un étalonnage data/fraction) ou 32/non défini (FP32). FP16 n’est pas pris en charge pour l’exportation SavedModel. Remplace l’indicateur obsolète int8. |
opset | int | None | Spécifie la version d’opset ONNX du graphe ONNX intermédiaire. Si elle n’est pas définie, la dernière version prise en charge est utilisée. |
nms | bool, facultatif | None | Sélectionne la sortie brute (None, par défaut), NMS intégrée (True) ou la tête sans NMS (False). |
batch | int | 1 | Indique la taille de lot pour l’inférence du modèle exporté ou le nombre maximal d’images que le modèle exporté traitera simultanément en mode predict. |
data | str | None | Chemin vers le fichier YAML du jeu de données, indispensable à la quantification ; pour la classification, un répertoire de jeu de données ou le nom d’un jeu de données intégré est requis. Si quantize=8 n’est pas indiqué, Ultralytics sélectionne le jeu de données de calibration par défaut correspondant à la tâche du modèle. |
fraction | float, int ou list | 1.0 | Sous-ensemble de calibration exprimé en ratio, en nombre d’images ou en listes [train, val, test] de ratios/de nombres. Les listes de deux éléments laissent test complet, tandis que 0 l’ignore. |
device | str | None | Indique l’appareil utilisé pour l’exportation : CPU (device=cpu), MPS pour les puces Apple (device=mps). |
Pour en savoir plus sur le processus d’export, consulte la page de la documentation Ultralytics consacrée à l’export.
Déployer des modèles YOLO26 TF SavedModel exportés#
Maintenant que tu as exporté ton modèle YOLO26 au format TF SavedModel, l’étape suivante consiste à le déployer. La première étape recommandée pour exécuter un modèle TF SavedModel consiste à utiliser la méthode YOLO("yolo26n_saved_model/"), comme indiqué précédemment dans l’extrait de code d’utilisation.
Pour obtenir des instructions détaillées sur le déploiement de tes modèles TF SavedModel, consulte les ressources suivantes :
-
TensorFlow Serving : consulte la documentation destinée aux développeurs pour savoir comment déployer tes modèles TF SavedModel avec TensorFlow Serving.
-
Exécuter un TensorFlow SavedModel dans Node.js : un article du blog TensorFlow expliquant comment exécuter directement un TensorFlow SavedModel dans Node.js, sans conversion.
-
Déploiement sur le cloud : un billet de blog TensorFlow sur le déploiement d’un modèle TensorFlow SavedModel sur Cloud AI Platform.
Résumé#
Dans ce guide, nous avons vu comment exporter des modèles Ultralytics YOLO26 au format TF SavedModel. En exportant au format TF SavedModel, tu gagnes en flexibilité pour optimiser, déployer et mettre à l’échelle tes modèles YOLO26 sur un large éventail de plateformes.
Pour plus de détails sur l’utilisation, consulte la documentation officielle de TF SavedModel.
Pour en savoir plus sur l’intégration d’Ultralytics YOLO26 à d’autres plateformes et frameworks, n’oublie pas de consulter notre page du guide d’intégration. Elle regorge de ressources utiles pour tirer le meilleur parti de YOLO26 dans tes projets.
FAQ#
L’exportation d’un modèle Ultralytics YOLO au format TensorFlow SavedModel est simple. Tu peux utiliser Python ou la CLI pour y parvenir :
Exporter YOLO26 au format TF SavedModelfrom ultralytics import YOLO # Charger un modèle YOLO26 model = YOLO("yolo26n.pt") # Exporter le modèle au format TF SavedModel model.export(format="saved_model") # creates 'yolo26n_saved_model' # Charger le modèle TF SavedModel exporté pour l’inférence tf_savedmodel_model = YOLO("./yolo26n_saved_model") results = tf_savedmodel_model("https://ultralytics.com/images/bus.jpg")Consulte la documentation sur l’exportation Ultralytics pour en savoir plus.
Le format TensorFlow SavedModel offre plusieurs avantages pour le déploiement de modèles :
- Portabilité : il fournit un format indépendant du langage, ce qui facilite le partage et le déploiement des modèles dans différents environnements.
- Compatibilité : il s’intègre parfaitement à des outils comme TensorFlow Serving, LiteRT et TensorFlow.js, essentiels au déploiement de modèles sur diverses plateformes, y compris les applications web et mobiles.
- Encapsulation complète : il encode l’architecture du modèle, les poids et les informations de compilation, ce qui simplifie le partage et la reprise de l’entraînement.
Pour découvrir d’autres avantages et options de déploiement, consulte les options de déploiement des modèles Ultralytics YOLO.
TF SavedModel peut être déployé dans divers environnements, notamment :
- TensorFlow Serving : idéal pour les environnements de production qui nécessitent un service de modèles évolutif et hautement performant.
- Plateformes cloud : prend en charge les principaux services cloud comme Google Cloud Platform (GCP), Amazon Web Services (AWS) et Microsoft Azure pour le déploiement évolutif de modèles.
- Appareils mobiles et embarqués : l’utilisation de LiteRT (anciennement TensorFlow Lite) pour convertir les modèles TF SavedModel permet leur déploiement sur des appareils mobiles, des appareils IoT et des microcontrôleurs.
- Environnement d’exécution TensorFlow : pour les environnements C++ qui nécessitent une inférence à faible latence et de meilleures performances.
Pour consulter des options de déploiement détaillées, visite les guides officiels sur le déploiement de modèles TensorFlow.
Pour exporter des modèles YOLO26, tu dois installer le package
ultralytics. Exécute la commande suivante dans ton terminal :pip install ultralyticsPour des instructions d’installation et des bonnes pratiques plus détaillées, consulte notre guide d’installation Ultralytics. Si tu rencontres des problèmes, consulte notre guide des problèmes courants.
Le format TF SavedModel est avantageux pour les développeurs en IA grâce aux caractéristiques suivantes :
- Portabilité : permet de partager et de déployer facilement des modèles dans divers environnements.
- Facilité de déploiement : encapsule le graphe de calcul, les paramètres entraînés et les métadonnées dans un seul package, ce qui simplifie le chargement et l’inférence.
- Gestion des ressources : prend en charge les ressources externes comme les vocabulaires, afin qu’elles soient disponibles au chargement du modèle.
Pour plus de détails, consulte la documentation officielle de TensorFlow.