Exporter un modèle YOLO26 vers TorchScript pour un déploiement rapide#
PyTorch a déconseillé TorchScript et supprime progressivement ses fonctionnalités. Pour les nouveaux déploiements mobiles et en périphérie, utilise l’intégration ExecuTorch prise en charge. Ultralytics conserve l’exportation TorchScript habituelle pour assurer la compatibilité avec l’ancien code C++.
Le déploiement de modèles de vision par ordinateur dans des environnements C++ sans Python nécessite une représentation sérialisée portable. TorchScript assure cette compatibilité pour les applications LibTorch existantes.
Exporte tes modèles Ultralytics YOLO26 vers TorchScript pour les sérialiser et assurer leur compatibilité multiplateforme ainsi qu’un déploiement simplifié. Dans ce guide, nous allons te montrer comment exporter tes modèles YOLO26 au format TorchScript afin de les utiliser plus facilement dans un éventail plus large d’applications.
Pourquoi exporter vers TorchScript ?#
Développé par les créateurs de PyTorch, TorchScript est un outil puissant pour optimiser et déployer des modèles PyTorch sur différentes plateformes. L’exportation de modèles YOLO26 vers TorchScript est essentielle pour passer de la recherche aux applications concrètes. TorchScript, qui fait partie du framework PyTorch, facilite cette transition en permettant d’utiliser des modèles PyTorch dans des environnements qui ne prennent pas en charge Python.
Le processus repose sur deux techniques : le traçage et le scriptage. Le traçage enregistre les opérations pendant l’exécution du modèle, tandis que le scriptage permet de définir des modèles à l’aide d’un sous-ensemble de Python. Ces techniques permettent à des modèles comme YOLO26 de continuer à fonctionner même en dehors de leur environnement Python habituel.
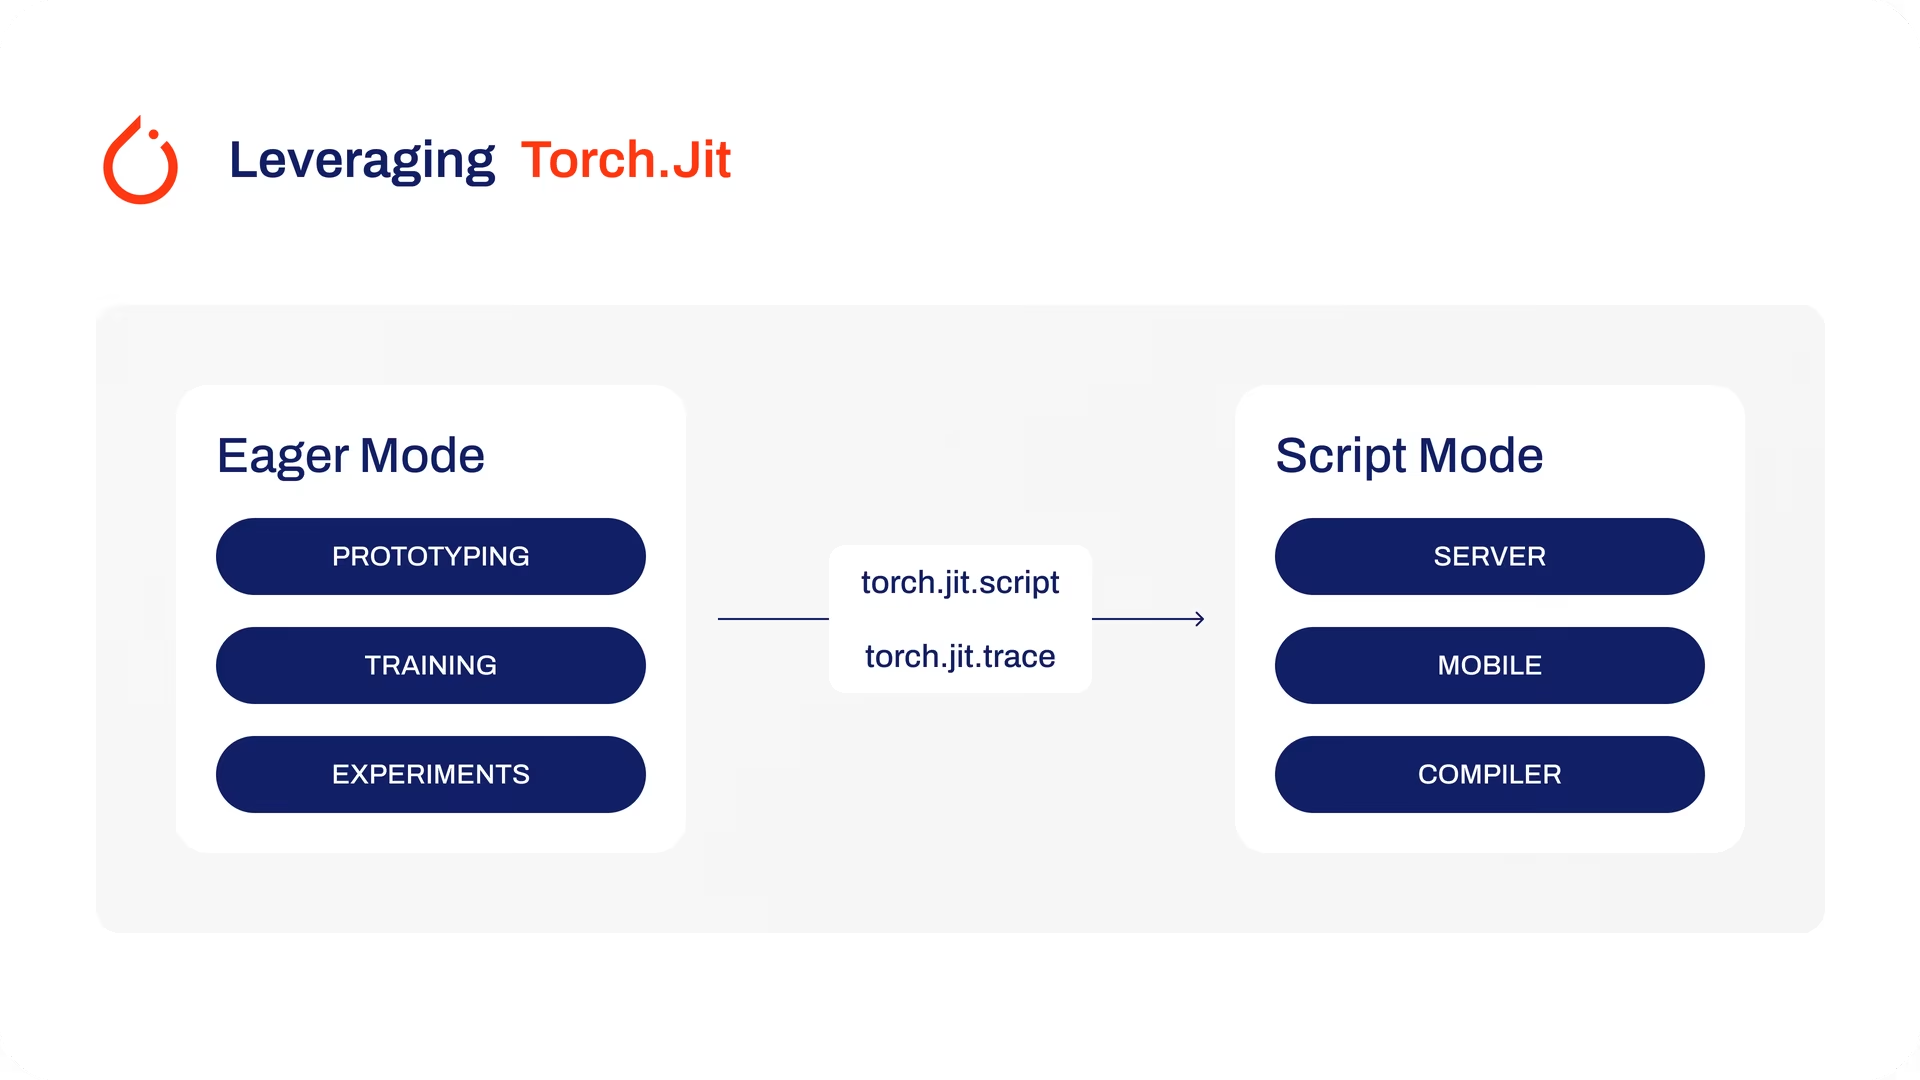
Les modèles TorchScript peuvent également être optimisés à l’aide de techniques comme la fusion d’opérateurs et l’amélioration de l’utilisation de la mémoire, afin de garantir une exécution efficace. L’exportation vers TorchScript peut aussi accélérer l’exécution des modèles sur différentes plateformes matérielles. Elle crée une représentation autonome, prête pour la production, de ton modèle PyTorch, qui peut être intégrée à des environnements C++.
Fonctionnalités clés des modèles TorchScript#
TorchScript, élément clé de l’écosystème PyTorch, offre de puissantes fonctionnalités pour optimiser et déployer des modèles d’apprentissage profond.
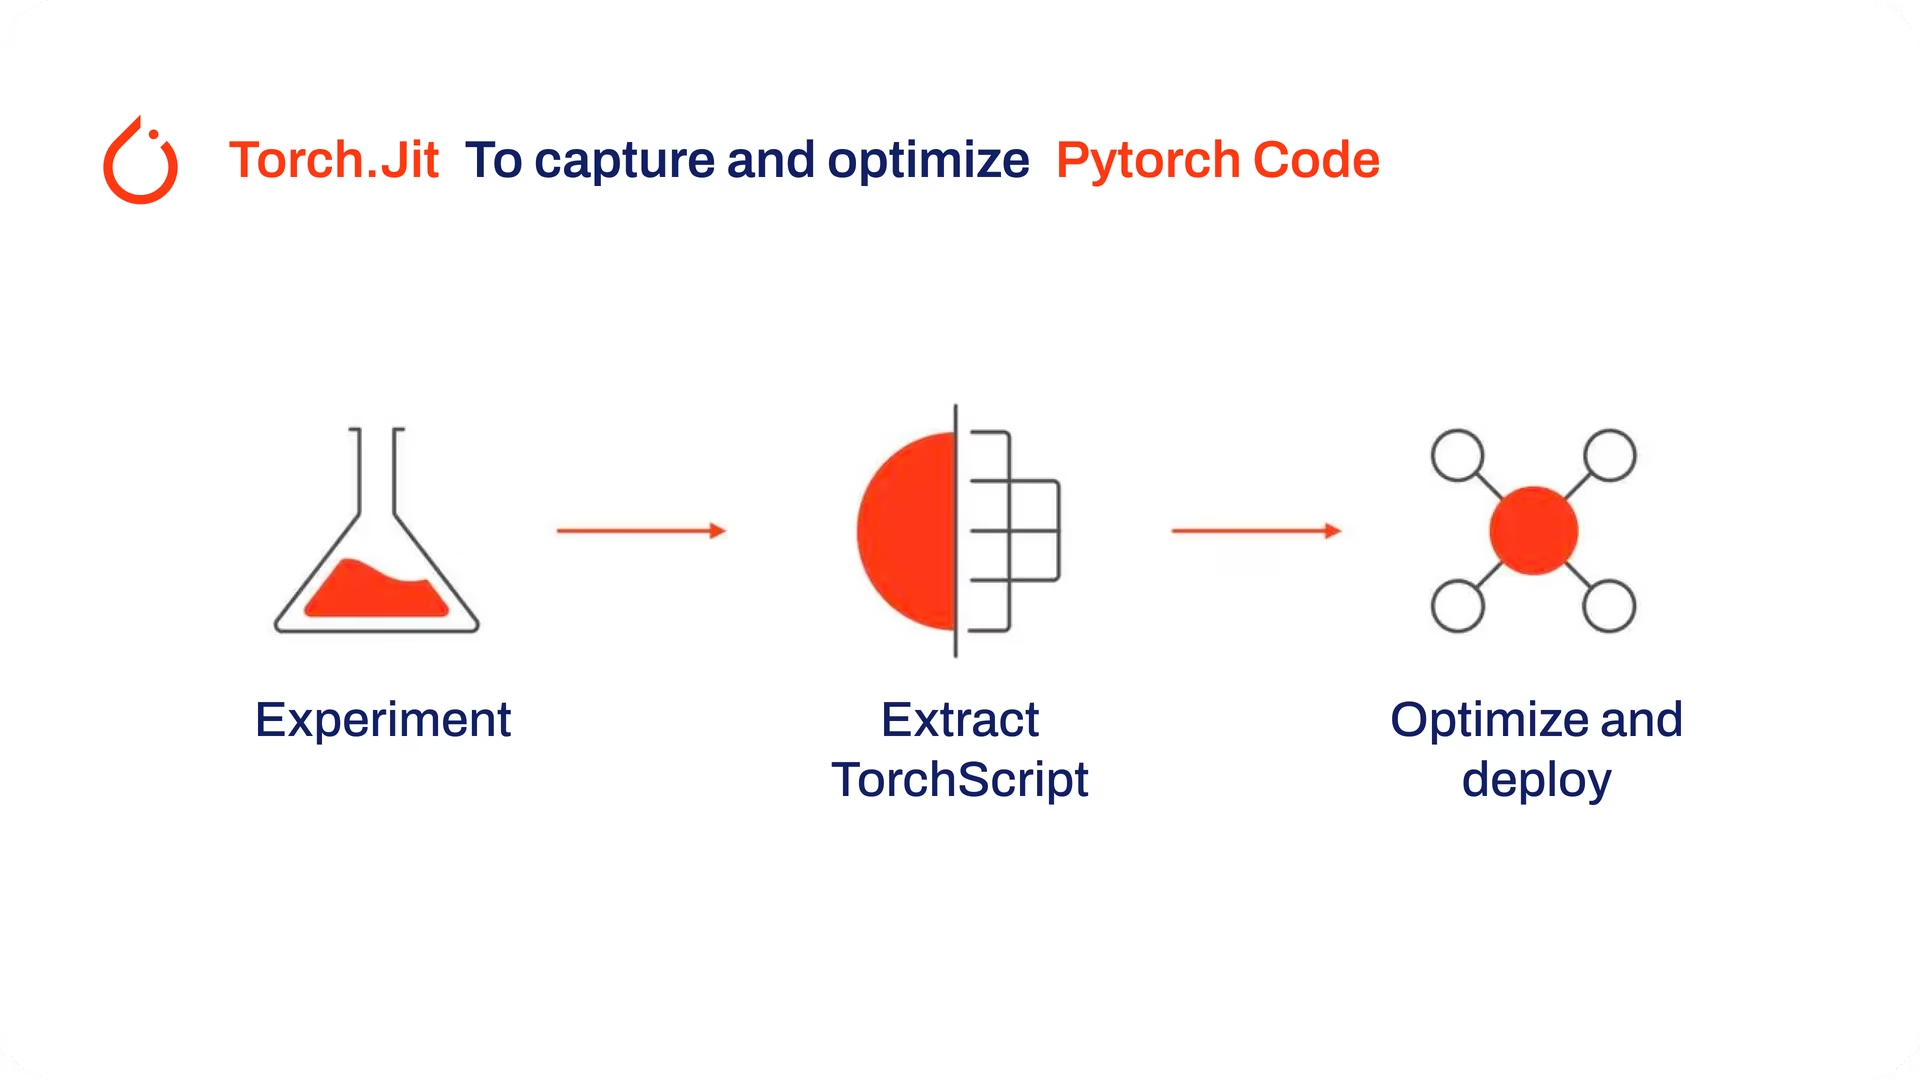
Voici les fonctionnalités clés qui font de TorchScript un outil précieux pour les développeurs :
-
Exécution à graphe statique : TorchScript utilise une représentation à graphe statique des calculs du modèle, contrairement à l’exécution à graphe dynamique de PyTorch. Avec l’exécution à graphe statique, le graphe de calcul est défini et compilé une seule fois avant l’exécution proprement dite, ce qui améliore les performances lors de l’inférence.
-
Sérialisation des modèles : TorchScript permet de sérialiser des modèles PyTorch dans un format indépendant de la plateforme. Les modèles sérialisés peuvent être chargés sans le code Python d’origine, ce qui permet leur déploiement dans différents environnements d’exécution.
-
Compilation JIT : TorchScript utilise la compilation à la volée (JIT) pour convertir les modèles PyTorch en une représentation intermédiaire optimisée. La compilation JIT compile le graphe de calcul du modèle et permet une exécution efficace sur les appareils cibles.
-
Conversion progressive : TorchScript propose une approche de conversion progressive qui te permet de convertir graduellement des parties de ton modèle PyTorch en TorchScript. Cette flexibilité est particulièrement utile pour les modèles complexes ou lorsque tu souhaites optimiser des parties spécifiques du code.
Options de déploiement avec TorchScript#
Avant d’examiner le code permettant d’exporter des modèles YOLO26 au format TorchScript, comprenons où les modèles TorchScript sont généralement utilisés.
TorchScript propose diverses options de déploiement pour les modèles d’apprentissage automatique, notamment :
-
API C++ : le cas d’utilisation le plus courant de TorchScript est son API C++ LibTorch, qui te permet de charger et d’exécuter des modèles TorchScript optimisés directement dans des applications C++. C’est idéal pour les environnements de production où Python n’est pas adapté ou disponible. L’API C++ permet une exécution efficace des modèles TorchScript avec une faible surcharge, afin d’exploiter au maximum leurs performances.
-
Déploiement mobile : pour une inférence à faible latence, hors ligne, et la confidentialité des données sur les appareils mobiles, utilise ExecuTorch, le remplacement de TorchScript Mobile par PyTorch.
-
Déploiement dans le cloud : les modèles TorchScript peuvent être déployés sur des serveurs cloud à l’aide de solutions comme TorchServe. Cette solution propose des fonctionnalités telles que le versionnement des modèles, le traitement par lots et la surveillance des métriques, pour un déploiement évolutif en production. Le déploiement de TorchScript dans le cloud permet de rendre tes modèles accessibles par des API ou d’autres services Web.
Tâches prises en charge#
L’exportation TorchScript prend en charge les sept tâches Ultralytics. La segmentation sémantique et l’estimation de profondeur sont disponibles uniquement avec YOLO26, la seule famille à inclure ces têtes.
| Tâche | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Détecter | ✅ | ✅ | ✅ |
| Segmenter | ✅ | ✅ | ✅ |
| Sémantique | ❌ | ❌ | ✅ |
| Profondeur | ❌ | ❌ | ✅ |
| Classifier | ✅ | ✅ | ✅ |
| Pose | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Exporter vers TorchScript : convertir ton modèle YOLO26#
L’exportation de modèles YOLO26 vers TorchScript facilite leur utilisation dans différents environnements et améliore leur vitesse et leur efficacité d’exécution. C’est une excellente solution pour utiliser plus efficacement les modèles d’apprentissage profond dans des applications concrètes.
Installation#
Pour installer le package requis, exécute :
# Install the required package for YOLO26
pip install ultralytics
Pour obtenir des instructions détaillées et connaître les bonnes pratiques liées à l’installation, consulte notre guide d’installation Ultralytics. Si tu rencontres des difficultés lors de l’installation des packages requis pour YOLO26, consulte notre guide des problèmes courants, qui propose des solutions et des conseils.
Utilisation#
Tous les modèles Ultralytics YOLO26 sont conçus pour prendre en charge l’exportation dès leur installation, ce qui facilite leur intégration à ton flux de déploiement préféré. Tu peux consulter la liste complète des formats d’exportation pris en charge et des options de configuration pour choisir la configuration la mieux adaptée à ton application.
Le format TorchScript prend en charge les modes Export, Predict et Validate. Exporte ton modèle, puis charge le modèle exporté pour effectuer l’inférence ou valider sa précision.
from ultralytics import YOLO

# Charger un modèle YOLO26
model = YOLO("yolo26n.pt")

# Exporter le modèle au format TorchScript
model.export(format="torchscript") # crée 'yolo26n.torchscript'from ultralytics import YOLO
# Charger le modèle TorchScript exporté
model = YOLO("yolo26n.torchscript")
# Exécuter l’inférence
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Charger le modèle TorchScript exporté
model = YOLO("yolo26n.torchscript")
# Valider la précision sur le jeu de données COCO8
metrics = model.val(data="coco8.yaml")Arguments d’exportation#
| Argument | Type | Valeur par défaut | Description |
|---|---|---|---|
format | str | 'torchscript' | Format cible du modèle exporté, qui définit sa compatibilité avec différents environnements de déploiement. |
imgsz | int ou tuple | 640 | Taille d’image souhaitée pour l’entrée du modèle. Peut être un entier pour les images carrées ou un tuple (height, width) pour définir des dimensions spécifiques. |
dynamic | bool | False | Permet d'utiliser des tailles d'entrée dynamiques, offrant ainsi une plus grande flexibilité pour traiter des images de dimensions variables. |
quantize | int ou str | None | Précision de quantification : 16 (FP16) nécessite une exportation sur GPU avec device=0 ; 32/non défini correspond à FP32. Remplace l’option obsolète half. |
nms | bool, facultatif | None | Sélectionne la sortie brute (None, par défaut), NMS intégrée (True) ou la tête sans NMS (False). |
batch | int | 1 | Indique la taille de lot pour l’inférence du modèle exporté ou le nombre maximal d’images que le modèle exporté traitera simultanément en mode predict. |
device | str | None | Définit l’appareil utilisé pour l’export : GPU (device=0), CPU (device=cpu), MPS pour Apple Silicon (device=mps). |
Pour en savoir plus sur le processus d’export, consulte la page de la documentation Ultralytics consacrée à l’export.
Déployer des modèles YOLO26 TorchScript exportés#
Après avoir exporté avec succès tes modèles Ultralytics YOLO26 au format TorchScript, tu peux maintenant les déployer. La première étape recommandée pour exécuter un modèle TorchScript consiste à utiliser la méthode YOLO("model.torchscript"), comme indiqué dans l’extrait de code d’utilisation précédent. Pour obtenir des instructions détaillées sur le déploiement de tes modèles TorchScript dans d’autres contextes, consulte les ressources suivantes :
-
Découvrir le déploiement mobile : utilise le pipeline distinct
torch.export()→.pted’ExecuTorch pour les déploiements mobiles actuels avec PyTorch. -
Maîtriser le déploiement côté serveur : découvre comment déployer des modèles côté serveur avec TorchServe grâce à un tutoriel étape par étape pour un service de modèles évolutif et efficace.
-
Mettre en œuvre le déploiement C++ : explore le tutoriel sur le chargement d’un modèle TorchScript en C++, qui facilite l’intégration de tes modèles TorchScript dans des applications C++ pour améliorer leurs performances et leur polyvalence.
Résumé#
Dans ce guide, nous avons exploré le processus d’exportation des modèles Ultralytics YOLO26 au format TorchScript. En suivant les instructions fournies, tu peux optimiser les performances des modèles YOLO26 et les déployer avec souplesse sur différentes plateformes et dans divers environnements.
Pour en savoir plus sur l’utilisation, consulte la documentation officielle de TorchScript.
Pour en savoir plus sur les autres intégrations Ultralytics YOLO26, consulte également notre page du guide des intégrations. Tu y trouveras de nombreuses ressources et informations utiles.
FAQ#
L’exportation d’un modèle Ultralytics YOLO26 vers TorchScript permet un déploiement flexible et multiplateforme. TorchScript, qui fait partie de l’écosystème PyTorch, permet de sérialiser les modèles, qui peuvent ensuite être exécutés dans des environnements ne prenant pas en charge Python. Il est donc utile pour déployer des modèles dans des environnements C++.
Pour exporter un modèle YOLO26 vers TorchScript, tu peux utiliser l’exemple de code suivant :
Utilisationfrom ultralytics import YOLO # Charger un modèle YOLO26 model = YOLO("yolo26n.pt") # Exporter le modèle au format TorchScript model.export(format="torchscript") # crée 'yolo26n.torchscript' # Charger le modèle TorchScript exporté torchscript_model = YOLO("yolo26n.torchscript") # Exécuter l’inférence results = torchscript_model("https://ultralytics.com/images/bus.jpg")Pour en savoir plus sur le processus d’exportation, consulte la documentation Ultralytics sur l’exportation.
L’utilisation de TorchScript pour déployer des modèles YOLO26 présente plusieurs avantages :
- Portabilité : les modèles exportés peuvent s’exécuter dans des applications C++ sans Python.
- Optimisation : TorchScript prend en charge l’exécution à graphe statique et la compilation à la volée (JIT), qui peuvent optimiser les performances des modèles.
- Intégration multilingage : les modèles TorchScript peuvent être intégrés à d’autres langages de programmation, ce qui améliore leur flexibilité et leur extensibilité.
- Sérialisation : les modèles peuvent être sérialisés pour être chargés et exécutés indépendamment de la plateforme.
Pour en savoir plus sur le déploiement, consulte la documentation de TorchServe et le guide de déploiement C++. Pour le déploiement mobile sur appareil, PyTorch recommande désormais ExecuTorch, qui utilise son propre pipeline distinct
torch.export()→.pteplutôt que TorchScript.Pour installer le paquet requis pour exporter des modèles YOLO26, utilise la commande suivante :
Installation# Install the required package for YOLO26 pip install ultralyticsPour obtenir des instructions détaillées, consulte le guide d’installation d’Ultralytics. En cas de problème pendant l’installation, consulte le guide des problèmes courants.
Après avoir exporté des modèles YOLO26 au format TorchScript, tu peux les déployer sur diverses plateformes :
- API C++ : utilise LibTorch dans les environnements de production où une faible surcharge et une grande efficacité sont essentielles.
- Déploiement mobile : utilise ExecuTorch, le remplaçant pris en charge par PyTorch, avec un pipeline d’export distinct
.pte. - Déploiement cloud : utilise des services comme TorchServe pour un déploiement évolutif côté serveur.
Consulte des recommandations complètes pour déployer des modèles dans ces environnements afin de tirer pleinement parti des fonctionnalités de TorchScript.