Distribuire YOLO26 su dispositivi mobili ed edge con ExecuTorch#
La distribuzione di modelli di visione artificiale su dispositivi edge come smartphone, tablet e sistemi embedded richiede un runtime ottimizzato che bilanci le prestazioni con i vincoli delle risorse. ExecuTorch, la soluzione di PyTorch per l'edge computing, consente un'inferenza efficiente sul dispositivo per i modelli Ultralytics YOLO.
Questa guida illustra come esportare i modelli Ultralytics YOLO nel formato ExecuTorch, così da poterli distribuire su dispositivi mobili ed edge con prestazioni ottimizzate.
Perché esportare in ExecuTorch?#
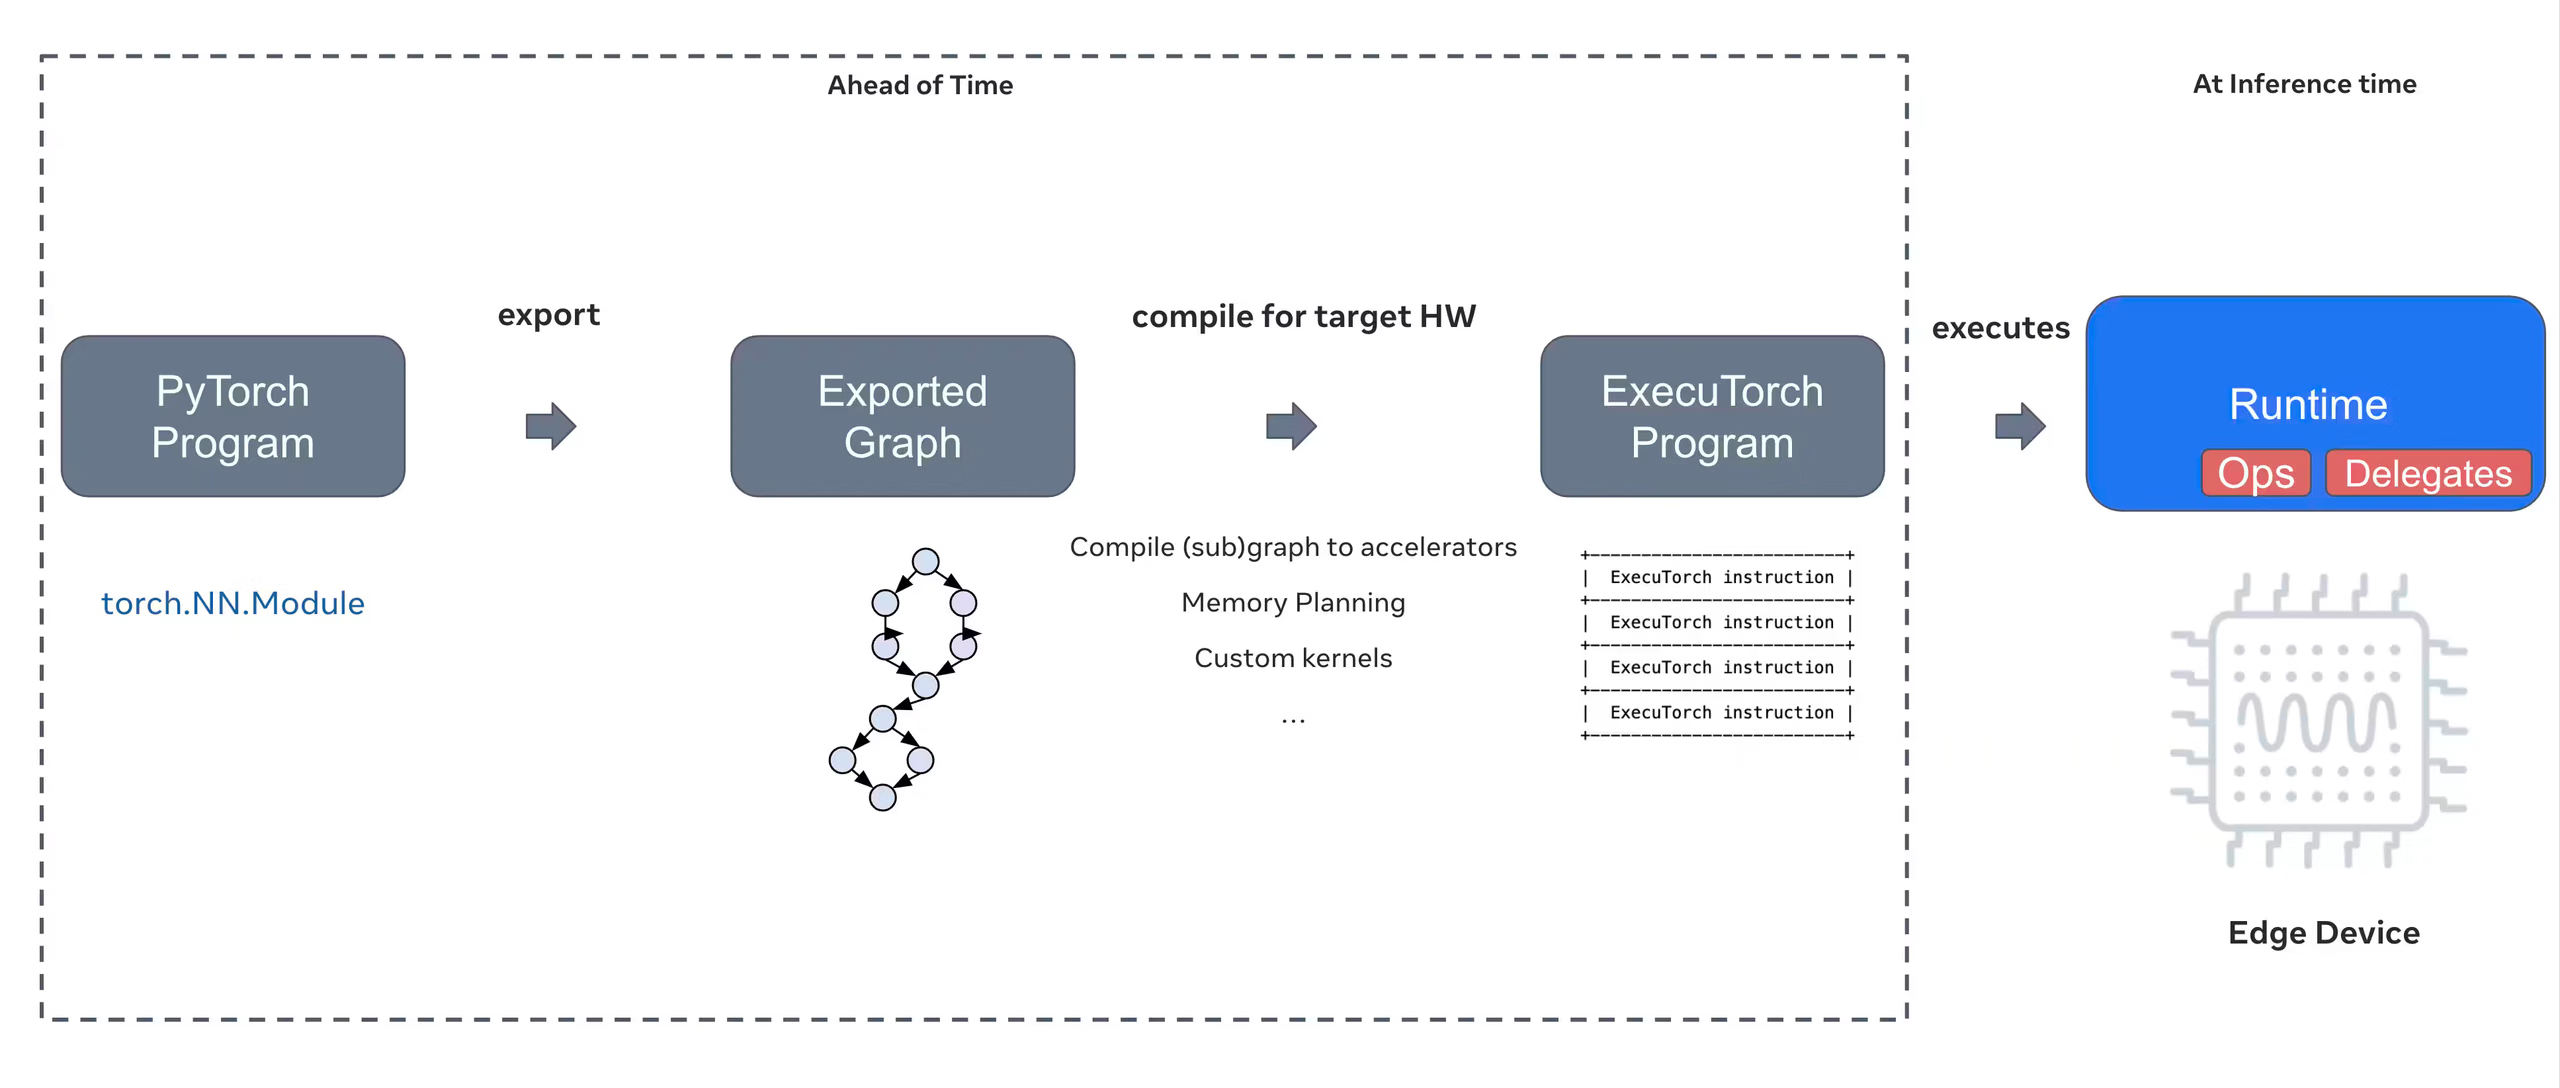
ExecuTorch è la soluzione end-to-end di PyTorch che abilita funzionalità di inferenza sul dispositivo per dispositivi mobili ed edge. Progettato per essere portatile ed efficiente, ExecuTorch può eseguire programmi PyTorch su un'ampia varietà di piattaforme di calcolo.
Funzionalità principali di ExecuTorch#
ExecuTorch offre diverse potenti funzionalità per distribuire i modelli Ultralytics YOLO sui dispositivi edge:
-
Formato del modello portatile: ExecuTorch usa il formato
.pte(PyTorch ExecuTorch), ottimizzato per le dimensioni e la velocità di caricamento sui dispositivi con risorse limitate. -
Backend XNNPACK: l'integrazione predefinita con XNNPACK offre un'inferenza altamente ottimizzata sulle CPU mobili, con prestazioni eccellenti senza richiedere hardware specializzato.
-
Pronto per la quantizzazione: l'ecosistema ExecuTorch supporta tecniche di quantizzazione per ridurre le dimensioni del modello e migliorare la velocità di inferenza; al momento Ultralytics esporta modelli FP32 tramite il backend XNNPACK.
-
Efficienza della memoria: la gestione ottimizzata della memoria riduce l'ingombro in memoria durante l'esecuzione, rendendo il sistema adatto ai dispositivi con RAM limitata.
-
Metadati del modello: i modelli esportati includono i metadati (dimensione delle immagini, nomi delle classi e così via) in un file YAML separato, per semplificare l'integrazione.
Opzioni di distribuzione con ExecuTorch#
I modelli ExecuTorch possono essere distribuiti su diverse piattaforme mobili ed edge:
-
Applicazioni mobili: distribuisci i modelli su applicazioni iOS e Android con prestazioni native, abilitando il rilevamento di oggetti in tempo reale nelle app mobili.
-
Sistemi embedded: esegui i modelli su dispositivi Linux embedded come Raspberry Pi, NVIDIA Jetson e altri sistemi basati su ARM, con prestazioni ottimizzate.
-
Dispositivi di IA edge: distribuisci i modelli su hardware specializzato per l'IA edge usando delegate personalizzati per accelerare l'inferenza.
-
Dispositivi IoT: integra i modelli nei dispositivi IoT per eseguire inferenze sul dispositivo senza richiedere una connessione al cloud.
Attività supportate#
L'esportazione ExecuTorch supporta tutti e sette i task di Ultralytics. La segmentazione semantica e la stima della profondità sono disponibili solo con YOLO26, l'unica famiglia che include queste head.
| Attività | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Rilevamento | ✅ | ✅ | ✅ |
| Segmentazione | ✅ | ✅ | ✅ |
| Semantica | ❌ | ❌ | ✅ |
| Profondità | ❌ | ❌ | ✅ |
| Classificazione | ✅ | ✅ | ✅ |
| Stima della posa | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Esportare i modelli Ultralytics YOLO26 in ExecuTorch#
Convertire i modelli Ultralytics YOLO26 nel formato ExecuTorch consente di distribuirli in modo efficiente su dispositivi mobili ed edge.
Installazione#
L'esportazione ExecuTorch richiede Python 3.10-3.14 e PyTorch >= 2.9.0. Ultralytics installa un pacchetto executorch compatibile quando esporti o carichi un modello ExecuTorch, fissato a executorch<1.5 con versioni di PyTorch precedenti alla 2.13; quindi non aggiornarlo manualmente.
# Install Ultralytics package
pip install ultralytics
Per istruzioni dettagliate e buone pratiche relative al processo di installazione, consulta la nostra guida all'installazione di YOLO26. Se durante l'installazione dei pacchetti necessari per YOLO26 riscontri difficoltà, consulta la nostra guida ai problemi comuni per trovare soluzioni e suggerimenti.
Utilizzo#
Esportare i modelli YOLO26 in ExecuTorch è semplice:
Il formato ExecuTorch supporta le modalità Export, Predict e Validate. Esporta il modello, quindi carica il modello esportato per eseguire inferenze o convalidarne l'accuratezza.
from ultralytics import YOLO

# Carica un modello YOLO26
model = YOLO("yolo26n.pt")

# Esporta il modello nel formato ExecuTorch
model.export(format="executorch") # creates 'yolo26n_executorch_model'from ultralytics import YOLO
# Carica il modello ExecuTorch esportato
model = YOLO("yolo26n_executorch_model")
# Esegui l'inferenza
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Carica il modello ExecuTorch esportato
model = YOLO("yolo26n_executorch_model")
# # Convalida l'accuratezza sul dataset COCO8
metrics = model.val(data="coco8.yaml")Le esportazioni ExecuTorch generano una directory che include un file .pte e i metadati. Usa il runtime ExecuTorch nella tua applicazione mobile o embedded per caricare il modello .pte ed eseguire inferenze.
Argomenti di esportazione#
Quando esporti nel formato ExecuTorch, puoi specificare gli argomenti seguenti:
| Argomento | Tipo | Predefinito | Descrizione |
|---|---|---|---|
format | str | 'executorch' | Formato di destinazione del modello esportato, che definisce la compatibilità con i vari ambienti di distribuzione. |
imgsz | int o tuple | 640 | Dimensione dell'immagine desiderata per l'input del modello. Può essere un intero per immagini quadrate o una tupla (height, width) per dimensioni specifiche. |
quantize | int o str | None | Esportazione FP32 fissa. L'esportazione ExecuTorch non supporta la conversione di precisione FP16, INT8 o W8A16 durante l'esportazione. |
batch | int | 1 | Specifica la dimensione batch per l'inferenza del modello esportato o il numero massimo di immagini che il modello esportato elaborerà contemporaneamente in modalità predict. |
device | str | None | Specifica il dispositivo per l'esportazione: GPU (device=0), CPU (device=cpu), MPS per Apple silicon (device=mps). |
Struttura dell'output#
L'esportazione ExecuTorch crea una directory contenente il modello e i metadati:
yolo26n_executorch_model/
├── model.pte               # ExecuTorch model file
└── metadata.yaml           # Model metadata (classes, image size, etc.)
Usare i modelli ExecuTorch esportati#
Dopo aver esportato il modello, dovrai integrarlo nell'applicazione di destinazione usando il runtime ExecuTorch.
Integrazione mobile#
Per le applicazioni mobili (iOS/Android), dovrai:
- Aggiungi il runtime ExecuTorch: includi la libreria runtime ExecuTorch nel tuo progetto mobile
- Carica il modello: carica il file
.ptenella tua applicazione - Esegui l'inferenza: elabora le immagini e ottieni le previsioni
iOS#
Esempio di integrazione iOS (Objective-C/C++):
// iOS uses C++ APIs for model loading and inference
// See https://pytorch.org/executorch/stable/using-executorch-ios.html for complete examples

#include <executorch/extension/module/module.h>

using namespace ::executorch::extension;

// Load the model
Module module("/path/to/model.pte");

// Create input tensor
float input[1 * 3 * 640 * 640];
auto tensor = from_blob(input, {1, 3, 640, 640});

// Run inference
const auto result = module.forward(tensor);Android#
Aggiungi ExecuTorch Android AAR da Maven Central:
dependencies {
    implementation("org.pytorch:executorch-android:<version>")
}
Esempio di integrazione Android (Kotlin):
import org.pytorch.executorch.EValue
import org.pytorch.executorch.Module
import org.pytorch.executorch.Tensor

// Load the model
val module = Module.load("/path/to/model.pte")

// Prepare input tensor
val inputTensor = Tensor.fromBlob(floatData, longArrayOf(1, 3, 640, 640))
val inputEValue = EValue.from(inputTensor)

// Run inference
val outputs = module.forward(inputEValue)
val scores = outputs[0].toTensor().dataAsFloatArray
Linux embedded#
Per i sistemi Linux embedded, usa l'API C++ di ExecuTorch:
#include <executorch/extension/module/module.h>
#include <executorch/extension/tensor/tensor.h>

using namespace ::executorch::extension;

// Load model
Module module("model.pte");

// Prepare input
std::vector<float> input_data = preprocessImage(image);
auto input_tensor = from_blob(input_data.data(), {1, 3, 640, 640});

// Run inference
const auto outputs = module.forward(input_tensor);
Per maggiori dettagli sull'integrazione di ExecuTorch nelle tue applicazioni, visita la documentazione di ExecuTorch.
Ottimizzazione delle prestazioni#
Ottimizzazione delle dimensioni del modello#
Per ridurre le dimensioni del modello per la distribuzione:
- Usa modelli più piccoli: inizia con YOLO26n (nano) per ridurre al minimo l'ingombro
- Riduci la risoluzione di input: usa immagini di dimensioni inferiori (ad es.
imgsz=320oimgsz=416) - Quantizzazione: applica le tecniche di quantizzazione di ExecuTorch al di fuori di Ultralytics (l'esportazione di Ultralytics in ExecuTorch supporta solo FP32)
Ottimizzazione della velocità di inferenza#
Per un'inferenza più rapida:
- Backend XNNPACK: il backend XNNPACK predefinito offre un'inferenza ottimizzata su CPU
- Accelerazione hardware: usa i delegate specifici della piattaforma (ad es. CoreML per iOS)
- Elaborazione in batch: elabora più immagini quando possibile
Benchmark#
Il team di Ultralytics ha eseguito benchmark sui modelli YOLO26, confrontando velocità e accuratezza tra PyTorch ed ExecuTorch.
| Modello | Formato | Stato | Dimensione (MB) | metrics/mAP50-95(B) | Tempo di inferenza (ms/im) |
|---|---|---|---|---|---|
| YOLO26n | PyTorch | ✅ | 5.3 | 0.4790 | 314.80 |
| YOLO26n | ExecuTorch | ✅ | 9.4 | 0.4800 | 142 |
| YOLO26s | PyTorch | ✅ | 19.5 | 0.5730 | 930.90 |
| YOLO26s | ExecuTorch | ✅ | 36.5 | 0.5780 | 376.1 |
Il tempo di inferenza non include la pre/post-elaborazione.
Risoluzione dei problemi#
Problemi comuni#
Problema: Python version error
Soluzione: ExecuTorch richiede Python dalla versione 3.10 alla 3.14. Crea un ambiente con una versione supportata:
# Using conda
conda create -n executorch python=3.14
conda activate executorch
Per ulteriore assistenza nella risoluzione dei problemi, visita le segnalazioni di problemi su GitHub di Ultralytics oppure la documentazione di ExecuTorch.
Riepilogo#
L'esportazione dei modelli YOLO26 nel formato ExecuTorch consente una distribuzione efficiente su dispositivi mobili ed edge. Grazie all'integrazione nativa con PyTorch, al supporto multipiattaforma e alle prestazioni ottimizzate, ExecuTorch è un'ottima scelta per le applicazioni di AI edge.
Punti chiave:
- ExecuTorch offre una distribuzione edge nativa per PyTorch con prestazioni eccellenti
- L'esportazione è semplice grazie al parametro
format='executorch' - I modelli sono ottimizzati per le CPU dei dispositivi mobili tramite il backend XNNPACK
- Supporta iOS, Android e le piattaforme Linux embedded
- Richiede Python 3.10-3.14 e PyTorch >= 2.9.0
Domande frequenti#
Esporta un modello YOLO26 in ExecuTorch usando Python o CLI:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(format="executorch")
oppure
yolo export model=yolo26n.pt format=executorchL'esportazione in ExecuTorch richiede:
- Python dalla versione 3.10 alla 3.14
- Il pacchetto
executorch, installato automaticamente (executorch<1.5con versioni di PyTorch precedenti alla 2.13, non supportate dai runtime più recenti di ExecuTorch) - PyTorch (installato automaticamente con ultralytics)
Nota: il pacchetto
executorchinclude wheel precompilati (con il backend XNNPACK), quindi durante l'esportazione non è necessario alcun passaggio di compilazione aggiuntivo.I modelli ExecuTorch possono essere caricati direttamente con
YOLO()per eseguire inferenze e convalide in Python (vedi gli esempi di previsione/convalida riportati sopra) e possono anche essere distribuiti su dispositivi mobili ed edge usando le librerie runtime di ExecuTorch.ExecuTorch supporta:
- Dispositivi mobili: iOS e Android
- Linux embedded: Raspberry Pi, NVIDIA Jetson e altri dispositivi ARM
- Desktop: Linux, macOS e Windows (per lo sviluppo)
Sia ExecuTorch sia LiteRT sono ottime soluzioni per la distribuzione su dispositivi mobili:
- ExecuTorch: migliore integrazione con PyTorch, flusso di lavoro nativo per PyTorch ed ecosistema in crescita
- LiteRT: più maturo, supporto hardware più ampio, più esempi di distribuzione e possibilità di eseguire lo stesso modello su Android, iOS e browser
Scegli ExecuTorch se usi già PyTorch e vuoi un percorso di distribuzione nativo. Scegli LiteRT per la massima compatibilità e strumenti più maturi.
Sì! ExecuTorch supporta l'accelerazione hardware tramite diversi backend:
- GPU mobile: tramite delegate Vulkan, Metal o OpenCL
- NPU/DSP: tramite delegate specifici della piattaforma
- Predefinito: XNNPACK per un'inferenza ottimizzata su CPU
Per la configurazione specifica del backend, consulta la documentazione di ExecuTorch.