Esportazione ONNX per i modelli YOLO26
ONNX (scambio aperto di reti neurali) è un formato aperto per modelli che può essere caricato dalla maggior parte dei runtime di inferenza. L'esportazione di un modello Ultralytics YOLO26 con format="onnx" crea un singolo file .onnx, eseguibile con ONNX Runtime su CPU, GPU NVIDIA e AMD, dispositivi Apple con processore Apple silicon e dispositivi Windows.
In breve#
| Proprietà | Dettagli |
|---|---|
argomento format | onnx |
| Output | yolo26n.onnx, un unico file con i nomi delle classi, l'attività e la dimensione dell'immagine salvati come metadati; yolo26n_int8.onnx per un'esportazione quantize=8 calibrata |
| Esecuzione su | CPU, GPU NVIDIA (CUDA), GPU AMD (MIGraphX), Apple silicon (provider di esecuzione Core ML) e dispositivi Windows ML |
| Runtime | ONNX Runtime oppure DNN di OpenCV con dnn=True |
| Precisione | FP32, FP16, INT8. YOLO26n occupa 9,9 MB in FP32, 5,0 MB in FP16 e 3,1 MB in INT8 |
| Sistema per l'esportazione | Linux, macOS o Windows, con o senza GPU |
La Ultralytics Platform può esportare per te un modello addestrato in formato ONNX, così non ti serve un ambiente di esportazione locale.
Guida rapida#
Installa il pacchetto Ultralytics. La prima esportazione installa onnx, onnxslim e onnxruntime se non sono già presenti (onnxruntime-gpu quando esporti con device=0 su una GPU NVIDIA).
pip install ultralyticsPer altri metodi di installazione, consulta la guida all'installazione. Poi esporta il tuo modello e carica il file esportato per eseguire l'inferenza o convalidarne l'accuratezza.
from ultralytics import YOLO

# Carica un modello YOLO26
model = YOLO("yolo26n.pt")

# Esporta il modello in formato ONNX
model.export(format="onnx")  # crea 'yolo26n.onnx'

# Esporta un modello ONNX quantizzato INT8 con dati di calibrazione
model.export(format="onnx", quantize=8, data="coco8.yaml") # crea 'yolo26n_int8.onnx'from ultralytics import YOLO
# Carica il modello ONNX esportato
model = YOLO("yolo26n.onnx")
# Esegui l'inferenza
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Carica il modello ONNX esportato
model = YOLO("yolo26n.onnx")
# # Convalida l'accuratezza sul dataset COCO8
metrics = model.val(data="coco8.yaml")Attività supportate#
L'esportazione ONNX supporta tutte e sette le attività Ultralytics con i modelli YOLOv8, YOLO11 e YOLO26: rilevamento, segmentazione, segmentazione semantica, stima della profondità, classificazione, stima della posa e OBB. La segmentazione semantica e la stima della profondità sono disponibili solo con YOLO26, l'unica famiglia che include queste head.
Argomenti di esportazione#
| Argomento | Tipo | Predefinito | Descrizione |
|---|---|---|---|
format | str | 'onnx' | Formato di destinazione del modello esportato, che definisce la compatibilità con i vari ambienti di distribuzione. |
imgsz | int o tuple | 640 | Dimensione dell'immagine di input del modello: un numero intero per immagini quadrate oppure una tupla (height, width). Se non viene specificata, l'esportazione usa la dimensione usata per addestrare il checkpoint. I checkpoint ufficiali di YOLO26 usano 640 per i modelli di rilevamento, segmentazione, posa e semantici preaddestrati su ADE20K, 1024 per OBB e i modelli semantici preaddestrati su Cityscapes, 768 per la profondità e 224 per la classificazione. |
quantize | int o str | None | Precisione di quantizzazione: 16 (FP16; un'esportazione su CPU mantiene gli input e gli output in FP32, mentre un'esportazione su GPU li converte anch'essi in FP16) oppure 8 (quantizzazione statica INT8 con ONNX Runtime usando immagini di calibrazione da data, che produce un modello _int8.onnx); 32/non impostato corrisponde a FP32. Un checkpoint addestrato con quantize=8 viene esportato in INT8 con quantize non impostato o con 8 (gli altri valori generano un errore), usando nodi Q/DQ basati sugli intervalli presenti nel checkpoint, senza calibrazione e con il semplice nome .onnx. Sostituisce i flag deprecati half/int8. |
data | str | None | File YAML del dataset usato per la calibrazione INT8; per la classificazione si usa invece una directory del dataset o il nome di un dataset integrato. Se omesso con quantize=8, Ultralytics seleziona il dataset di calibrazione predefinito per l'attività del modello; un checkpoint addestrato con quantize=8 non ne ha bisogno. |
fraction | float, int o list | 1.0 | Sottoinsieme di calibrazione espresso come rapporto, numero di immagini o rapporti/conteggi [train, val, test]. Gli elenchi di due elementi lasciano completo test, mentre 0 lo esclude. |
dynamic | bool | False | Rende dinamici gli assi di batch, altezza e larghezza dell'input, così un singolo file accetta diverse dimensioni di batch (fino a batch dell'esportazione con nms=True) e diverse dimensioni delle immagini. Consulta la guida all'esportazione dinamica. |
simplify | bool | True | Semplifica il grafo del modello con onnxslim. |
opset | int | None | Specifica la versione dell'opset ONNX per garantire la compatibilità con diversi parser e runtime ONNX. Se non è impostata, usa l'opset 18 (inferiore con PyTorch < 2.4), fino alla versione onnx installata. Consulta opset minimo. |
nms | bool, facoltativo | None | Seleziona l'output grezzo (None, predefinito), NMS integrata (True) oppure la head senza NMS (False). Consulta il formato di output. |
batch | int | 1 | Dimensione del batch del modello esportato. In un'esportazione statica, questa dimensione del batch è fissata nella forma dell'input. Con dynamic=True e nms=True, impostala sulla dimensione massima del batch che prevedi di usare. |
device | str | None | Dispositivo su cui eseguire l'esportazione: cpu (predefinito, anche su una macchina con GPU), 0 per una GPU CUDA oppure mps per Apple silicon. Modifica il risultato solo per quantize=16; consulta input FP16. |
Per gli argomenti condivisi da tutti i formati, consulta la documentazione della modalità di esportazione.
Quantizzazione INT8#
Per i checkpoint non addestrati con l'addestramento consapevole della quantizzazione, quantize=8 applica la quantizzazione statica di ONNX Runtime solo ai nodi Conv, Gemm e MatMul. Tutti gli altri nodi restano in virgola mobile, comprese le operazioni che compongono output0: le coordinate dei riquadri (in pixel) e i punteggi delle classi (da 0 a 1) condividono quel tensore, quindi una singola scala INT8 per quel tensore arrotonderebbe a zero ogni punteggio di classe. I pesi vengono quantizzati per canale a partire da opset 13. Escludi gli stessi nodi e imposta per_channel=True se esegui quantize_static autonomamente su un modello esportato in FP32:
import onnx
from onnxruntime.quantization import quantize_static

model = "yolo26n.onnx"
exclude = [n.name for n in onnx.load(model).graph.node if n.op_type not in {"Conv", "Gemm", "MatMul"}]
quantize_static(model, "yolo26n_int8.onnx", calibration_reader, nodes_to_exclude=exclude, per_channel=True)
In questo caso, calibration_reader è un onnxruntime.quantization.CalibrationDataReader che restituisce {"images": array} con la dimensione del batch del modello, preelaborato come per l'inferenza: con letterboxing fino alla dimensione di esportazione (ridimensionato e ritagliato al centro per la classificazione), RGB, NCHW, float32 nell'intervallo 0-1.
Un modello INT8 mantiene i tipi di input e output del modello FP32, quindi il codice di inferenza scritto per il modello FP32 funziona senza modifiche. INT8 riduce le dimensioni del file da tre a quattro volte rispetto a FP32, ma nei benchmark è risultato più lento di FP32 con ONNX Runtime sia su GPU che su CPU. Misura la latenza sul tuo hardware di destinazione prima di scegliere una precisione.
Formato di output#
Il modello esportato accetta un input denominato images con forma (batch, 3, height, width), in RGB e ridimensionato nell'intervallo 0-1. L'input è float32, tranne che per le esportazioni su GPU create con quantize=16, che accettano float16. L'argomento nms imposta il layout di output0. Le forme riportate sotto si riferiscono a un modello di rilevamento YOLO26n con 80 classi esportato a imgsz=640:
nms | forma output0 | Contenuti |
|---|---|---|
None (predefinito) | (1, 84, 8400) | Per ciascuno degli 8400 anchor: centro x del riquadro, centro y, larghezza e altezza in pixel dell'input, seguiti dai punteggi delle 80 classi. Applica tu NMS. |
True | (1, 300, 6) | NMS viene eseguita all'interno del modello. Ogni riga è x1, y1, x2, y2, score, class; le righe successive all'ultimo rilevamento contengono zeri. |
False | (1, 300, 6) | Head senza NMS. Ogni riga è x1, y1, x2, y2, score, class, senza passaggio NMS. Filtra tu le righe in base al punteggio. |
Le altre attività usano lo stesso input e i seguenti output. Le forme si riferiscono ai checkpoint ufficiali YOLO26n con la dimensione di esportazione predefinita; per la segmentazione semantica, si usa il checkpoint Cityscapes yolo26n-sem.pt:
| Attività | imgsz predefinito | Output con nms=None | Output con nms=False o nms=True |
|---|---|---|---|
| Rilevamento | 640 | output0 (1, 84, 8400) | output0 (1, 300, 6) |
| Segmentazione | 640 | output0 (1, 116, 8400), output1 (1, 32, 160, 160) | output0 (1, 300, 38), output1 (1, 32, 160, 160) |
| Semantica | 1024 | output0 (1, 1024, 1024), uint8 indice della classe per ogni pixel | Come nms=None |
| Profondità | 768 | output0 (1, 1, 768, 768), mappa di profondità | Come nms=None |
| Classificazione | 224 | output0 (1, 1000), probabilità delle classi dopo softmax | Come nms=None per nms=False; nms=True genera un errore |
| Posa | 640 | output0 (1, 56, 8400) | output0 (1, 300, 57): 6 valori del riquadro, poi 17 punti chiave x 3 |
| OBB | 1024 | output0 (1, 20, 21504) | output0 (1, 300, 7): center x, center y, width, height, score, class, angle (radianti) |
Le righe di segmentazione includono 32 coefficienti della maschera dopo i valori del riquadro, mentre output1 contiene i prototipi della maschera. Nei modelli FP32 e INT8, tutti gli output sono float32, tranne la mappa delle classi semantiche.
Con nms=True, la soglia di confidenza conf (predefinita 0.25), la soglia IoU iou (predefinita 0.5), agnostic_nms e max_det (predefinito 300) sono fissati nel grafo durante l'esportazione. Una soglia conf più bassa al momento della predizione non può ripristinare i rilevamenti già rimossi dal grafo, quindi esporta di nuovo il modello per modificare questi valori. Anche max_det e agnostic_nms si applicano a nms=False: max_det=100 restituisce la forma (1, 100, 6) per output0.
YOLO("yolo26n.onnx") legge il layout dai metadati del file, quindi ti servono queste forme solo se esegui il modello nel tuo codice. Il tuo codice può accedere ai metadati anche come stringhe: names, task, imgsz, stride, batch, end2end e args.
import ast

import onnxruntime as ort

meta = ort.InferenceSession("yolo26n.onnx").get_modelmeta().custom_metadata_map
names = ast.literal_eval(meta["names"])  # {0: 'person', 1: 'bicycle', ...}
imgsz = ast.literal_eval(meta["imgsz"]) # [640, 640]Distribuisci#
YOLO("yolo26n.onnx") esegue il modello con ONNX Runtime e seleziona il provider di esecuzione in base all'argomento device. Su una macchina con GPU CUDA, la GPU viene usata se device non è impostato.
device | Provider di esecuzione |
|---|---|
cpu | CPUExecutionProvider |
0 su una GPU NVIDIA | CUDAExecutionProvider, dal pacchetto onnxruntime-gpu installato al primo utilizzo |
0 su una GPU AMD ROCm | MIGraphXExecutionProvider, consulta Inferenza su GPU AMD con MIGraphX |
mps su Apple silicon | CoreMLExecutionProvider per i nodi con forme statiche; i nodi con forme dinamiche vengono eseguiti su CPUExecutionProvider |
La riga di log Using ONNX Runtime 1.31.1 with CUDAExecutionProvider indica quale provider è attivo. Il comportamento durante l'inferenza dipende dal modo in cui è stato esportato il modello:
- Esportazione statica (predefinita): il modello viene sempre eseguito con
imgszebatchimpostati durante l'esportazione, che Ultralytics legge dai metadati del file. Un valoreimgszpassato apredictviene ignorato. I batch più grandi vengono suddivisi in blocchi della dimensione del batch di esportazione, mentre quelli più piccoli vengono completati con padding: puoi quindi elaborare un numero qualsiasi di immagini. - Esportazione dinamica (
dynamic=True):predictaccetta qualsiasiimgszmultiplo dello stride del modello. La dimensione del batch può variare, ma connms=Trueè limitata al valorebatchusato durante l'esportazione: impostalo quindi sulla dimensione massima del batch che prevedi di usare. - Memoria GPU: con
CUDAExecutionProvider, un modello statico usa il binding IO di ONNX Runtime, che mantiene i tensori di input e output sulla GPU. Un modello dinamico li copia attraverso la memoria della CPU a ogni chiamata. - Thread CPU: Ultralytics limita ONNX Runtime a 8 thread intra-op, oppure al numero di core fisici della CPU disponibili per il processo se è inferiore. Imposta la variabile d'ambiente
ORT_INTRA_OP_NUM_THREADSper usare un numero diverso.
Passa dnn=True a predict o val per eseguire il modello sulla CPU con OpenCV DNN invece che con ONNX Runtime. OpenCV DNN supporta meno opzioni di esportazione; consulta Limitazioni e risoluzione dei problemi.
Per eseguire il modello al di fuori del pacchetto Ultralytics, consulta queste risorse:
- API Python di ONNX Runtime: carica ed esegui un modello ONNX in Python.
- Provider di esecuzione di ONNX Runtime: backend hardware come CUDA, TensorRT, OpenVINO, Core ML e DirectML.
- Esempi Ultralytics: inferenza con ONNX Runtime in Python, C++ e Rust, e inferenza con OpenCV DNN in Python.
- Triton Inference Server: distribuisci il modello ONNX tramite HTTP o gRPC con NVIDIA Triton.
- Distribuzione su dispositivi edge: tutorial su ONNX Runtime per dispositivi IoT e hardware edge.
Inferenza Windows ML#
Su Windows 11 24H2 (build 26100) o versioni successive con Python 3.10+, puoi installare onnxruntime-windowsml in un ambiente separato per consentire a Windows ML di selezionare i provider di esecuzione per il tuo hardware. Installalo al posto di altre build di ONNX Runtime, quindi usa lo stesso modello .onnx esportato con YOLO("model.onnx"). Il backend mantiene il numero di thread PyTorch e le opzioni di sessione fornite, inclusa un’esplicita policy dei provider. Se non fornisci una policy, Windows ML seleziona l’hardware per ottenere le massime prestazioni, anche quando il dispositivo PyTorch è cpu. Misura la latenza delle predizioni sul tuo dispositivo prima di scegliere questo runtime; è facoltativo e non viene installato per impostazione predefinita.
Sulle GPU integrate che condividono l’alimentazione con la CPU, i thread PyTorch inattivi durante il pre-processing e il post-processing possono rallentare l’inferenza di Windows ML. Chiama torch.set_num_threads(1) prima di eseguire le predizioni per ridurre questo effetto. L’impostazione si applica all’intero processo, quindi anche gli altri modelli PyTorch in quel processo vengono eseguiti con un solo thread.
import torch

from ultralytics import YOLO

torch.set_num_threads(1)  # facoltativo, misura sul tuo dispositivo
results = YOLO("yolo26n.onnx")("https://ultralytics.com/images/bus.jpg")
Inferenza su GPU AMD con MIGraphX#
Ultralytics esegue i modelli ONNX esportati su GPU AMD tramite il provider di esecuzione MIGraphX di ONNX Runtime. Su un sistema ROCm (HIP) con Python 3.11 o versione successiva su x86-64, il backend ONNX installa il plugin onnxruntime-ep-migraphx al primo utilizzo e seleziona automaticamente MIGraphXExecutionProvider, senza modifiche al codice; sono supportate tutte le attività di YOLO26. Consulta la guida all'inferenza su GPU AMD per i prerequisiti, l'installazione, l'utilizzo, i benchmark e la cache dei programmi compilati.
Limitazioni e risoluzione dei problemi#
- Opset minimo: l'esportazione non riesce con
ONNX export requires opset>=Nseopsetè troppo basso per il modello. Il minimo è7per la classificazione,9per rilevamento, segmentazione, segmentazione semantica, posa e OBB,11per la stima della profondità e per i modelli di rilevamento, segmentazione, posa e OBB esportati connms=True, e16per RT-DETR. - Input FP16: un modello FP16 esportato su GPU (
quantize=16 device=0) richiede che il tuo codice usi tensori di input FP16. Un modello FP16 esportato su CPU mantiene gli input e gli output in FP32 e li converte all'interno del grafo.YOLO()fornisce il tipo di input corretto a entrambi i modelli, sia su GPU che su CPU. - Nome del file INT8:
quantize=8scriveyolo26n_int8.onnxe rimuove il file FP32 intermedio, quindi per l'inferenza carica il file_int8. Fa eccezione un checkpoint addestrato conquantize=8: l'esportazione scrive i nodi Q/DQ inyolo26n.onnxe salta la calibrazione. - Dimensione della calibrazione INT8: per un checkpoint non addestrato con
quantize=8, l'esportazione mostra un avviso se il sottoinsieme di calibrazione contiene meno di 300 immagini. Per impostazione predefinita, la calibrazione usa il sottoinsiemeval, mentrecoco8.yamlcontiene solo 4 immagini di convalida; usa quindi il tuo dataset per un modello che intendi distribuire. - NMS integrata:
nms=Truerichiede PyTorch 1.13 o versione successiva. Genera'nms=True' is not valid for classification modelsper la classificazione e viene ignorata, con un avviso, per i modelli di segmentazione semantica, stima della profondità e RT-DETR. - Head senza NMS:
nms=Falserichiede un modello con una head senza NMS, come YOLO26 o YOLOv10. Per gli altri modelli, ad esempio YOLO11, l'esportazione mostra l'avvisoThis model has no one-to-one head; using one-to-many outputse scrive l'output grezzo(1, 84, 8400). - GPU non utilizzata: se il log mostra
CUDA requested but CUDAExecutionProvider not available. Using CPU..., la build installata di ONNX Runtime non dispone di un provider CUDA funzionante. Installaonnxruntime-gpual posto dionnxruntimee verifica che le versioni di CUDA e cuDNN corrispondano a quelle del tuo sistema. - OpenCV DNN: con OpenCV 4.14.0,
dnn=Trueesegue i modelli predefiniti,nms=False, INT8 e FP16 esportati su GPU. Non riesce a caricare i modelli esportati connms=True, condynamic=Trueo conquantize=16su CPU. - Forme dinamiche con NMS: se combini
dynamic=Trueconnms=True, imposta anchebatchsulla dimensione massima del batch che prevedi di usare. L'esportazione mostra un avviso sebatchrimane impostato su1. - Semplificazione del grafo: se
onnxslimnon riesce, l'esportazione registra un avviso e salva il modello senza semplificarlo. - Versione IR: l'esportatore limita la versione IR di ONNX a 10, così anche le versioni meno recenti di ONNX Runtime possono caricare il file. Un'esportazione predefinita con opset 18 ha versione IR 8.
Per altri errori, consulta la guida ai problemi comuni.
Benchmark#
YOLO26n è fino al 43% più veloce di YOLO11n con ONNX Runtime su CPU (Intel Xeon CPU @ 2.00 GHz). La pagina del modello YOLO26 riporta la velocità CPU ONNX di ogni modello per tutte le attività, tranne la segmentazione semantica.
Guarda: Test di inferenza ONNX: Ultralytics YOLO26 a confronto con Ultralytics YOLO11 | Inferenza ~43% più veloce con YOLO26 🚀
FP32, FP16 e INT8 con ONNX Runtime#
Le tabelle seguenti confrontano PyTorch con modelli ONNX FP32, FP16 e INT8 per ogni modello di rilevamento YOLO26, eseguiti con CUDAExecutionProvider di ONNX Runtime. Tutti i valori GPU sono stati misurati su una GPU NVIDIA RTX PRO 6000 Blackwell Server Edition.
Millisecondi per immagine; valori inferiori sono migliori. Il formato più veloce per ogni modello è in grassetto.
| Modello | imgsz | PyTorch | ONNX FP32 | ONNX FP16 | ONNX INT8 |
|---|---|---|---|---|---|
| YOLO26n | 640 | 2.85 | 1.96 | 1.88 | 3.73 |
| YOLO26s | 640 | 2.98 | 2.14 | 1.73 | 4.31 |
| YOLO26m | 640 | 3.29 | 3.01 | 2.14 | 5.37 |
| YOLO26l | 640 | 4.70 | 4.09 | 3.08 | 7.51 |
| YOLO26x | 640 | 5.93 | 5.56 | 3.90 | 9.38 |
YOLO26n su CPU (AMD EPYC 9655, PyTorch e ONNX Runtime con 8 thread ciascuno; CPU diversa da quella usata per le tabelle dei modelli YOLO26):
| Metrica | PyTorch | ONNX FP32 | ONNX FP16 | ONNX INT8 |
|---|---|---|---|---|
| Latenza (ms/immagine) | 13.2 | 13.4 | 13.2 | 56.5 |
| mAPval 50-95 | 40.8 | 40.9 | 40.9 | 38.7 |
- FP16 ha dimezzato le dimensioni del file mantenendosi entro 0,1 mAP da FP32 ed è risultato fino a 1,4 volte più veloce di FP32 su GPU, senza accelerazione su CPU.
- INT8 ha prodotto il file più piccolo, ma ha perso da 2,2 a 3,0 mAP ed è risultato più lento di FP32 sia su GPU che su CPU.
Misurazioni effettuate con ultralytics 8.4.211, ONNX Runtime 1.30.0, PyTorch 2.15.0 e CUDA 13.2 su batch=1 il 13 novembre 2026. La latenza è quella della fase di inferenza riportata da val e non include la preelaborazione né la postelaborazione.
Informazioni su ONNX#
ONNX è un progetto comunitario avviato da Facebook e Microsoft, sviluppato oggi con organizzazioni come IBM, Amazon e Google. Definisce un insieme comune di operatori e un formato di file per i modelli di apprendimento automatico, così un modello addestrato in un framework, come PyTorch, può essere eseguito in molti runtime e su numerose piattaforme hardware.
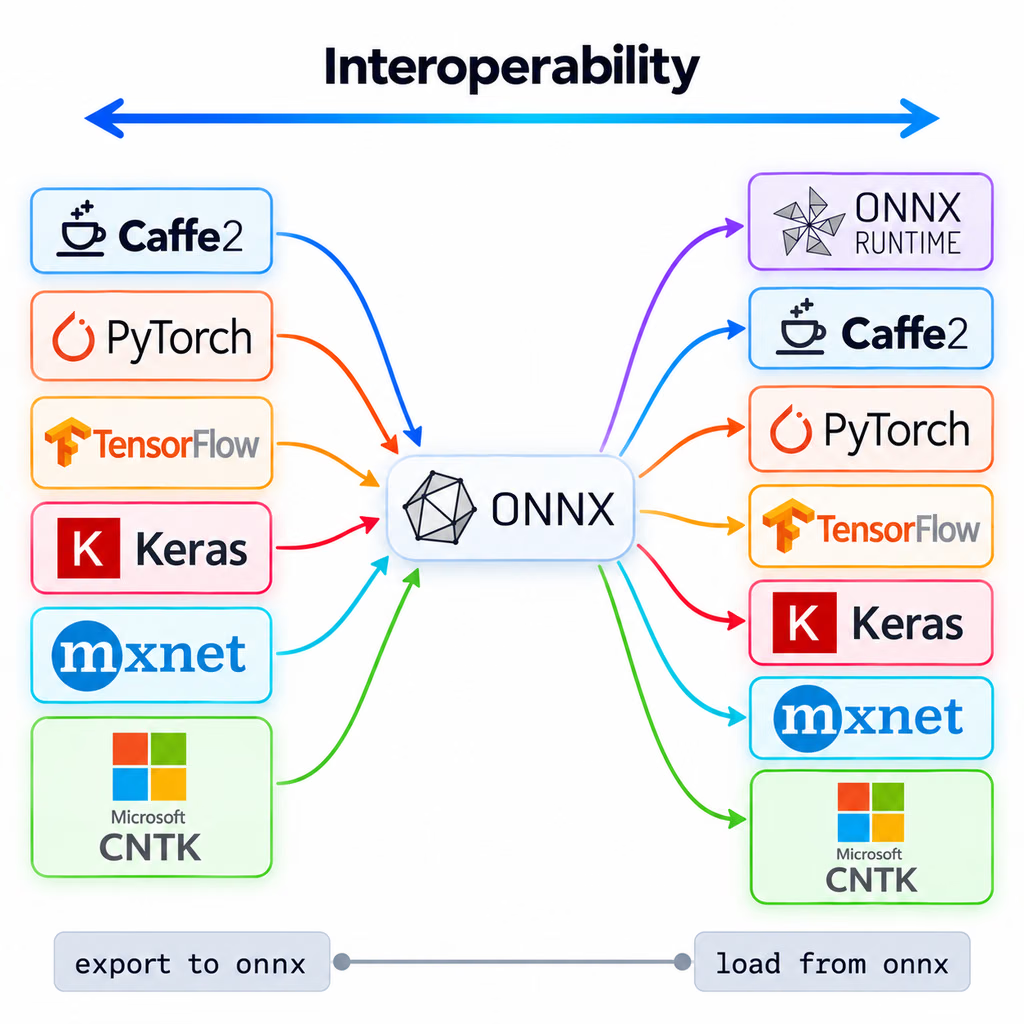
ONNX Runtime è un motore di inferenza multipiattaforma per i modelli ONNX. I suoi provider di esecuzione usano librerie specifiche per l'hardware per eseguire un modello su CPU, GPU e acceleratori dedicati.
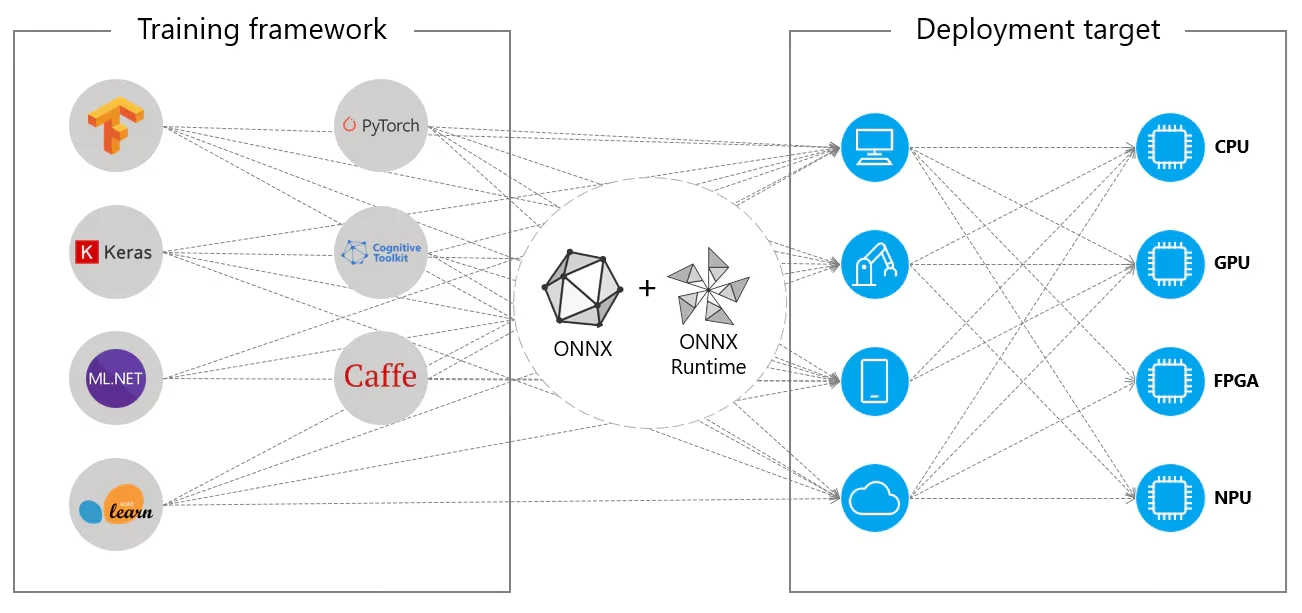
ONNX è anche un passaggio intermedio per altri formati di esportazione Ultralytics, incluso TensorRT, e l'input per le toolchain NPU dei fornitori, come Huawei Ascend, Qualcomm QNN e Rockchip RKNN. Per le specifiche, consulta la documentazione di ONNX.
Domande frequenti#
Lascia
opsetnon impostato, a meno che il tuo runtime non richieda una versione specifica. L'esportatore usa quindi l'opset18con PyTorch 2.4 e versioni successive, l'opset17con PyTorch dalla 1.13 alla 2.3, un opset inferiore con le versioni meno recenti di PyTorch e mai uno superiore a quello supportato dal pacchettoonnxinstallato. Il valore predefinito si ferma a 18 perché il provider CUDA di ONNX Runtime esegue sulla CPU alcuni operatori dell'opset 19 e successivi, comeResize. Imposta un valore inferiore, ad esempioopset=12, se un runtime o convertitore meno recente rifiuta il valore predefinito. Il valore non può essere inferiore all'opset minimo del modello.Dipende dall'argomento
nmscon cui hai eseguito l'esportazione. Un'esportazione predefinita restituisce predizioni grezze che richiedono il filtraggio per confidenza e NMS. Un'esportazione connms=Falseonms=Truerestituisce fino amax_det(300 per impostazione predefinita) rilevamenti finali per immagine, espressi comex1, y1, x2, y2, score, classin pixel dell'immagine di input: devi quindi solo filtrare per punteggio e riportare i riquadri alle dimensioni dell'immagine originale. Le righe OBB contengonocenter x, center y, width, heightal posto degli angoli, oltre all'angolo di rotazione. Consulta il formato dell'output per le forme.Leggere l'output senza NMS con ONNX Runtime# Prima esegui l'esportazione: yolo export model=yolo26n.pt format=onnx nms=False import numpy as np import onnxruntime as ort session = ort.InferenceSession("yolo26n.onnx") # esportato con nms=False image = np.zeros((1, 3, 640, 640), dtype=np.float32) # la tua immagine preprocessata detections = session.run(None, {"images": image})[0][0] # shape (300, 6) detections = detections[detections[:, 4] > 0.25] # mantieni le righe sopra la soglia di confidenzaImposta
dynamic=True. L'inputimagesavrà quindi forma(batch, 3, height, width), con batch, altezza e larghezza dinamici, mentre un rilevamento predefinito (nms=None)output0avrà forma(batch, 84, anchors); lo stesso file accetterà così batch e dimensioni dell'immagine diversi durante l'inferenza. Connms=True, la dimensione del batch è limitata al valorebatchusato durante l'esportazione. Altezza e larghezza devono essere multipli dello stride del modello: 32 per i checkpoint YOLO26 ufficiali, tranne quelli di classificazione. Un modello dinamico non usa il binding IO su CUDA e non viene caricato in OpenCV DNN, quindi mantieni l'esportazione statica predefinita quando la dimensione dell'input è fissa.Esportazione dinamicafrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="onnx", dynamic=True)Usa ONNX quando un unico file deve funzionare su hardware diverso o quando la macchina di distribuzione non è quella su cui esporti. Usa TensorRT per ottenere la latenza più bassa su una specifica GPU NVIDIA: un motore TensorRT viene creato per una sola architettura GPU e una sola versione di TensorRT, quindi non è portabile. Per altre destinazioni, consulta la guida alle opzioni di distribuzione dei modelli.
Sì. ONNX Runtime offre build per web e dispositivi mobili che caricano lo stesso file
.onnx. Esporta connms=Falseper evitare di includere la post-elaborazione nel codice della tua applicazione. Per i telefoni, Core ML su iOS e LiteRT su Android sono i formati nativi.


Commenti77
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
dopeggguy
The parameter "half" bost apperence in train and export, what’s difference. when we using this parameter what should we need attention.
 Glenn JocherUltralytics(modificato)
@dopeggguy Good question—summary: training uses mixed precision via
amp=True(weights stay FP32; compute is FP16 where safe), while export usesquantize=16(the formerhalf=True, now deprecated) to write an FP16 model for runtimes that support FP16. During training preferamp; use FP16 only at export/inference, and don't combine it with INT8 (quantize=8). See the train overview and AMP notes in the Train mode docs and thequantizeoption details in Model Export – Arguments and Configuration – Export Settings.from ultralytics import YOLO # Mixed-precision training (recommended) YOLO("yolo26n.yaml").train(data="data.yaml", amp=True) # FP16 export for FP16-capable runtimes (e.g., CUDA/TensorRT/OpenVINO FP16) YOLO("best.pt").export(format="onnx", quantize=16)yoloModel = YOLO(path_dir) yoloModel.export(format='onnx', dynamic=False, half=True, imgsz=(640, 640))
I'm not sure why. I enabled half=True, but the actual size of the exported model doesn't seem to change at all.
- Glenn JocherUltralytics(modificato)
@dopeggguy
half=Trueis deprecated in favor ofquantize=16. On older releases a CPU-only ONNX export ignored the flag and stayed FP32, so the file size was almost identical. Current releases convert CPU ONNX exports to FP16 too (keeping float32 inputs/outputs), and GPU exports are FP16 natively. If you have a GPU, you can force export on it and re-check:from ultralytics import YOLO YOLO(path_dir).export(format="onnx", imgsz=(640, 640), dynamic=False, quantize=16, device=0)You can then open the ONNX in Netron or inspect it with the
onnxPython API to confirm the weights arefloat16; for pure CPU deployments it is often better to keep ONNX as FP32 or use a CPU‑oriented backend (e.g. OpenVINO) for FP16/INT8 optimization instead, with some general ONNX background outlined in the ONNX: Open Neural Network Exchange overview.
bastinj98
Hi, I trained d a YOLOV8-segn model to detect and segment a single class (nc=1) and then exported in to onnx (simplify, nms, half are all False) with opset = 17. The output shape is 1x37x8400.
I am building a C++ pipeline to use this model to run inference. How can I process this output to get the final segmentation mask ?
NgZiming
I exported a yolo 11 segment model to onnx format, and used onnx-runtime to infer. It responded two ndarrays of shapes (1, 37, 21504) and (1, 32, 256, 256). (imgsz=1024) So, how can i extract masks from these two arrays?
- Glenn JocherUltralytics
@NgZiming 这两个输出正是分割模型的“检测头 + 原型掩码”:
(1, 37, 21504)=4(xywh) + nc + 32(mask系数),(1, 32, 256, 256)为32个原型;掩码可由原型与对应检测的32维系数线性组合并裁剪到框内,最小示例(Python/NumPy)如下:import numpy as np import cv2 def sigmoid(x): return 1 / (1 + np.exp(-x)) def mask_from_outputs(det, proto, img_h, img_w, det_idx): # det: (1, C, N) -> (C, N), proto: (1, 32, 256, 256) -> (32, 256, 256) det = det[0]; proto = proto[0] nm, ph, pw = proto.shape # 32, 256, 256 nc = det.shape[0] - 4 - nm # 1) 取该检测的框、类别分数与32维掩码系数 cx, cy, w, h = det[0, det_idx], det[1, det_idx], det[2, det_idx], det[3, det_idx] coeff = det[4+nc:4+nc+nm, det_idx] # (32,) # 2) 原型 × 系数 -> 原始掩码 (ph, pw) m = sigmoid((proto.reshape(nm, -1).T @ coeff).reshape(ph, pw)) # 3) 可选:按框在原型分辨率下裁剪(坐标为[0,1]比例) x0 = int(max(0, (cx - w/2) * pw)); x1 = int(min(pw, (cx + w/2) * pw)) y0 = int(max(0, (cy - h/2) * ph)); y1 = int(min(ph, (cy + h/2) * ph)) crop = np.zeros_like(m); crop[y0:y1, x0:x1] = m[y0:y1, x0:x1] # 4) 上采样到原图尺寸并二值化 mask = cv2.resize(crop, (img_w, img_h), interpolation=cv2.INTER_LINEAR) return (mask > 0.5).astype(np.uint8)要点:确保与推理时的预处理一致(letterbox 缩放与填充、RGB/归一化等),否则框与掩码会错位。关于分割导出产生两个输出(
output0检测+系数,output1原型)的由来,可见导出实现参考的export_onnx说明:export_onnx 函数参考.1 thanks
- Glenn JocherUltralytics
Glad it helped—if you later need a C++ reference for segmentation mask decoding and preprocessing alignment, the step-by-step overview is in the Segmentation task docs.
 User
I have a question. If it's convenient, please answer it. Thank you! I'm working with cell images, and the image size is 3072*2048. I trained with imagesize=3072, but if I use imagesize=640, I can't detect objects. I can predict with a 3072 imagesize using a pt file, but now I'm trying to switch to C++ and call onnx, and the 3072 inference is very slow. Is this normal?
denni281
You should keep the same preprocess way between python-inference and cpp-inference.
- Glenn JocherUltralytics
@giter915 Yes—running 3072×2048 through ONNX/C++ will be much slower; inference time grows quickly with input area. Two practical options: use a faster backend or reduce effective input while keeping accuracy. For GPU, prefer TensorRT; for CPU, OpenVINO FP16/INT8 gives the largest gains. Examples:
from ultralytics import YOLO

# GPU-optimized
YOLO("best.pt").export(format="engine", imgsz=1536, half=True, dynamic=True)

# CPU-optimized
YOLO("best.pt").export(format="openvino", imgsz=1536, half=True)  # add int8=True with calibration if desired
If you must keep 3072, tile the image (e.g., 1024×1024 patches), run ONNX per tile, then merge detections with NMS in C++; this is a common approach for microscopy. Also ensure preprocessing in C++ exactly matches Python (letterbox padding, RGB order, 1/255 scaling)—agree with @DennisJcy here. For backend choices and supported export targets, see the export formats table in Object Detection – Ultralytics YOLO Docs, and for high‑throughput GPU serving consider Triton Inference Server with YOLO11.
- User
Thank you very much!
- Glenn JocherUltralytics
Glad it helped—one extra tip for ONNX Runtime C++: enable full graph optimizations and tune threads to squeeze more speed from large inputs like 3072×2048.
#include <onnxruntime_cxx_api.h>
#include <thread>

Ort::Env env(ORT_LOGGING_LEVEL_WARNING, "yolo");
Ort::SessionOptions so;
so.SetGraphOptimizationLevel(GraphOptimizationLevel::ORT_ENABLE_ALL);
so.SetIntraOpNumThreads(std::thread::hardware_concurrency());
so.SetInterOpNumThreads(1);  // often fine to leave at 1

Ort::Session session(env, "best.onnx", so);
Hello, I use ultratics to export YOLO11 half-Precision onnx model, but when I load the .onnx model to eval by onnxruntime, exception shows :Unexpected input data type. Actual: (tensor(float16)) , expected: (tensor(float)). And I compare the Float32 and Float16(half) .onnx model,These two files are exactly the same in size and input type.So the "half" keyword doesn't take effect when exporting ONNX, right? I remember Ultralytics didn't have this issue last year.
Here is my python script to export half-precision onnx model:
def main(opt): model = YOLO(opt.model) model.export( format="onnx", # opset=12, simplify=True, dynamic=False, imgsz=opt.imgsz, half=opt.half, batch=opt.batch, ) if __name__ == "__main__": multiprocessing.freeze_support() parser = argparse.ArgumentParser() parser.add_argument( "--model", type=str, default="/home/ultralytics/runs/detect/SHFY/weights/best.pt", ) parser.add_argument("--imgsz", type=int, default=640) parser.add_argument("--half", type=bool, default=True) parser.add_argument("--batch", type=int, default=1) opt, unparsed = parser.parse_known_args() print(opt) main(opt)Fine... It's my fault. My docker environment is Python-3.11.9 torch-2.4.1+cu118 CPU (unknown). The error is made by my cpu environment
- Glenn JocherUltralytics(modificato)
@DennisJcy thanks for the update. On older releases
half=Truehad no effect on CPU ONNX exports, so the file stayed FP32. Current Ultralytics usesquantize=16(replacing the deprecatedhalf) and also converts CPU ONNX exports to FP16 while keeping float32 inputs/outputs, whereas GPU exports (device=0) are FP16 natively and need an FP16-capable ONNX Runtime provider. For CPU-optimized FP16 you can also export OpenVINO. For example:from ultralytics import YOLO # FP16 ONNX YOLO("best.pt").export(format="onnx", quantize=16) # CPU-optimized FP16 (OpenVINO) YOLO("best.pt").export(format="openvino", quantize=16)Details on OpenVINO export are in the export_openvino reference.
ShuaibZyx
def yolo_to_onnx(model_path, input_shape=(600, 600)): # Load the YOLOv8 model model = YOLO(model_path)
# Export the model to ONNX format
model.export(format='onnx',
             imgsz=input_shape,
             dynamic=True,
             batch=1,
             device="0")
Ultralytics YOLOv8.0.220 🚀 Python-3.9.18 torch-2.1.1+cu121 CUDA:0 (Tesla T4, 14931MiB) Model summary (fused): 268 layers, 43610463 parameters, 0 gradients, 164.8 GFLOPs
PyTorch: starting from 'best.pt' with input shape (1, 3, 640, 640) BCHW and output shape(s) (1, 9, 8400) (83.6 MB)
ONNX: starting export with onnx 1.18.0 opset 17... ONNX: export success ✅ 3.3s, saved as 'best.onnx' (166.5 MB) 我的模型在训练时是5个类别的目标检测,导出的模型的输出格式是(1, 9, 8400)。 我想请问您其中9具体代表的是什么呢? 如果是为了预测5个类别(1, 9, 8400)的输出格式是正确的嘛? 期待您的帮助!感谢!
xiaoqiang-l
9指的是:[x,y,w,h,class1_scores,class2_scores,class3_scores,class4_scores,class5_scores],即四个坐标及N个类别分数。 8400指的是:640下采样8倍、16倍、32倍特征图的anchor总数,(640/8)(640/8)+(640/16)(640/16)+(640/32)(640/32)=8080+4040+2020=8400
感谢您的指导!
- Glenn JocherUltralytics
@ShuaibZyx you're welcome! @xiaoqiang-l provided an excellent explanation. Just to confirm, the output shape (1, 9, 8400) is indeed correct for your 5-class detection model - the 9 channels represent the 4 bounding box coordinates (x, y, w, h) plus 5 class confidence scores. The 8400 represents all detection anchors across the three feature map scales (80×80 + 40×40 + 20×20 = 8400 total anchors).
UltralyticsAssistantUltralytics
👋 Hello, thank you for your interest in Ultralytics 🚀! We recommend a visit to the Docs for new users where you can find many Python and CLI usage examples, as well as detailed guides about exporting YOLO models to ONNX and other formats.
If this is a 🐛 Bug Report, please provide a minimum reproducible example to help us debug it.
If you have a custom training ❓ Question or require help with ONNX export, please include as much detail as possible—such as your command, model version, logs, and environment details. Also, check out our Tips for Best Training Results for optimal performance.
Join the Ultralytics community where it suits you best! For real-time chat, head to Discord 🎧. For in-depth discussions, try Discourse, or join the conversation on our Subreddit.
Upgrade
Upgrade to the latest
ultralyticspackage including all requirements in a Python>=3.8 environment with PyTorch>=1.8 to ensure you’re using the most up-to-date features and bug fixes:pip install -U ultralyticsEnvironments
YOLO can be run in these up-to-date verified environments, with all dependencies including CUDA/CUDNN, Python, and PyTorch preinstalled:
- Notebooks with free GPU:


- Google Cloud Deep Learning VM. See GCP Quickstart Guide
- Amazon Deep Learning AMI. See AWS Quickstart Guide
- Docker Image. See Docker Quickstart Guide
Status

If this badge is green, all Ultralytics CI tests are currently passing. CI tests verify correct operation of all YOLO Modes and Tasks on macOS, Windows, and Ubuntu every 24 hours and on every commit.
This is an automated response 🤖. An Ultralytics engineer will review your discussion and assist you soon!
- Glenn JocherUltralytics
Hello! Thanks for your interest in exporting YOLO11 models to ONNX format. This is a great option for deployment across different platforms with performance benefits.
Exporting to ONNX is straightforward with Ultralytics:
from ultralytics import YOLO

# Load model
model = YOLO("yolo11n.pt")  # or your custom trained model

# Export to ONNX with optional parameters
model.export(format="onnx", dynamic=True, simplify=True)  # creates 'yolo11n.onnx'

# Use the exported model
onnx_model = YOLO("yolo11n.onnx")
results = onnx_model("https://ultralytics.com/images/bus.jpg")
ONNX export can provide up to 3x CPU speedup compared to PyTorch models. You can customize the export with several parameters like
half=Truefor FP16 precision,dynamic=Truefor variable input sizes, oropsetto specify the ONNX version.For deployment, you can use ONNX Runtime or integrate with platforms like NVIDIA Triton Inference Server for production-scale serving.
If you have specific questions about exporting your models or encounter any issues during the process, please let us know!
- Notebooks with free GPU:
👋 Hello, thank you for your interest in Ultralytics 🚀! For users exploring ONNX integration and YOLO11, we recommend checking out the Docs where you’ll find dedicated Python and CLI tutorials, as well as specific ONNX integration guidance.
If this is a 🐛 Bug Report, please provide a minimum reproducible example to help us investigate further.
For custom deployment or export ❓ questions, please include as many details as possible, such as your export commands, model versions, and error logs. Make sure you review our Tips for Best Training Results for optimal performance.
Join the Ultralytics community where it suits you best: jump into real-time conversations on Discord 🎧, post or search on Discourse, or connect on our Subreddit.
Upgrade
Upgrade to the latest
ultralyticspackage, including all requirements, in a Python>=3.8 environment with PyTorch>=1.8 to ensure you have the latest features and fixes:pip install -U ultralyticsEnvironments
YOLO can be run in any of the following up-to-date verified environments (with all dependencies including CUDA/CUDNN, Python and PyTorch preinstalled):
- Notebooks with free GPU:
- Google Cloud Deep Learning VM. See GCP Quickstart Guide
- Amazon Deep Learning AMI. See AWS Quickstart Guide
- Docker Image. See Docker Quickstart Guide
Status
If this badge is green, all Ultralytics CI tests are currently passing. CI tests verify correct operation of all YOLO Modes and Tasks on macOS, Windows, and Ubuntu every 24 hours and on every commit.
This is an automated response. An Ultralytics engineer will assist you here soon!
- Glenn JocherUltralytics
Yes, you can adjust the batch size dynamically when exporting to ONNX format by using the
dynamic=Trueparameter in your export call. When this is enabled, the batch dimension becomes dynamic, allowing you to use various batch sizes during inference without reexporting the model.Here's a simple example:
from ultralytics import YOLO

# Load your model
model = YOLO("yolo11n.pt")

# Export with dynamic input size
model.export(format="onnx", dynamic=True)
This creates dynamic dimensions in the exported ONNX model, where the batch dimension (as well as height and width) can vary during inference. The resulting model will be more flexible for production deployments where batch size requirements might change.
- Notebooks with free GPU:
skyceeee
First of all, thank you for everything. Can we adjust the batch size dynamically when exporting the model as onnx?
When I export the YOLOV11 onnx model, I use: model.export(format='onnx', imgsz=640, device='cpu'). Then I use onnxruntime (1.14.0) to deploy it on the C++ side, but an error is reported during runtime: onnxruntime::Model::Model Unsupported model IR version: 9, max supported IR version: 8. Is there any parameter or method to set the exported model to support IR version: 8? Because I cannot upgrade onnxruntime to other higher versions locally, I look forward to your help
- Glenn JocherUltralytics
@xiaoqiang-l to resolve the ONNX IR version compatibility issue, you can specify an older
opsetversion during export. Try addingopset=13to your export command:model.export(format='onnx', imgsz=640, device='cpu', opset=13)This will generate an ONNX model compatible with IR version 8. For detailed version mapping, see the ONNX operator version matrix in the ONNX documentation.
