Esportazione del modello YOLO26 in TorchScript per una distribuzione rapida#
PyTorch ha dichiarato deprecato TorchScript e ne sta gradualmente rimuovendo le funzionalità. Per le nuove distribuzioni su dispositivi mobili ed edge, usa l'integrazione ExecuTorch supportata. Ultralytics mantiene l'esportazione regolare in TorchScript per la compatibilità con il codice C++ legacy.
La distribuzione di modelli di visione artificiale in ambienti C++ senza Python richiede una rappresentazione serializzata portabile. TorchScript garantisce questa compatibilità per le applicazioni LibTorch legacy.
Esporta in TorchScript per serializzare i tuoi modelli Ultralytics YOLO26 e renderli compatibili con più piattaforme e più semplici da distribuire. In questa guida ti mostreremo come esportare i tuoi modelli YOLO26 nel formato TorchScript, così potrai usarli più facilmente in un'ampia gamma di applicazioni.
Perché esportare in TorchScript?#
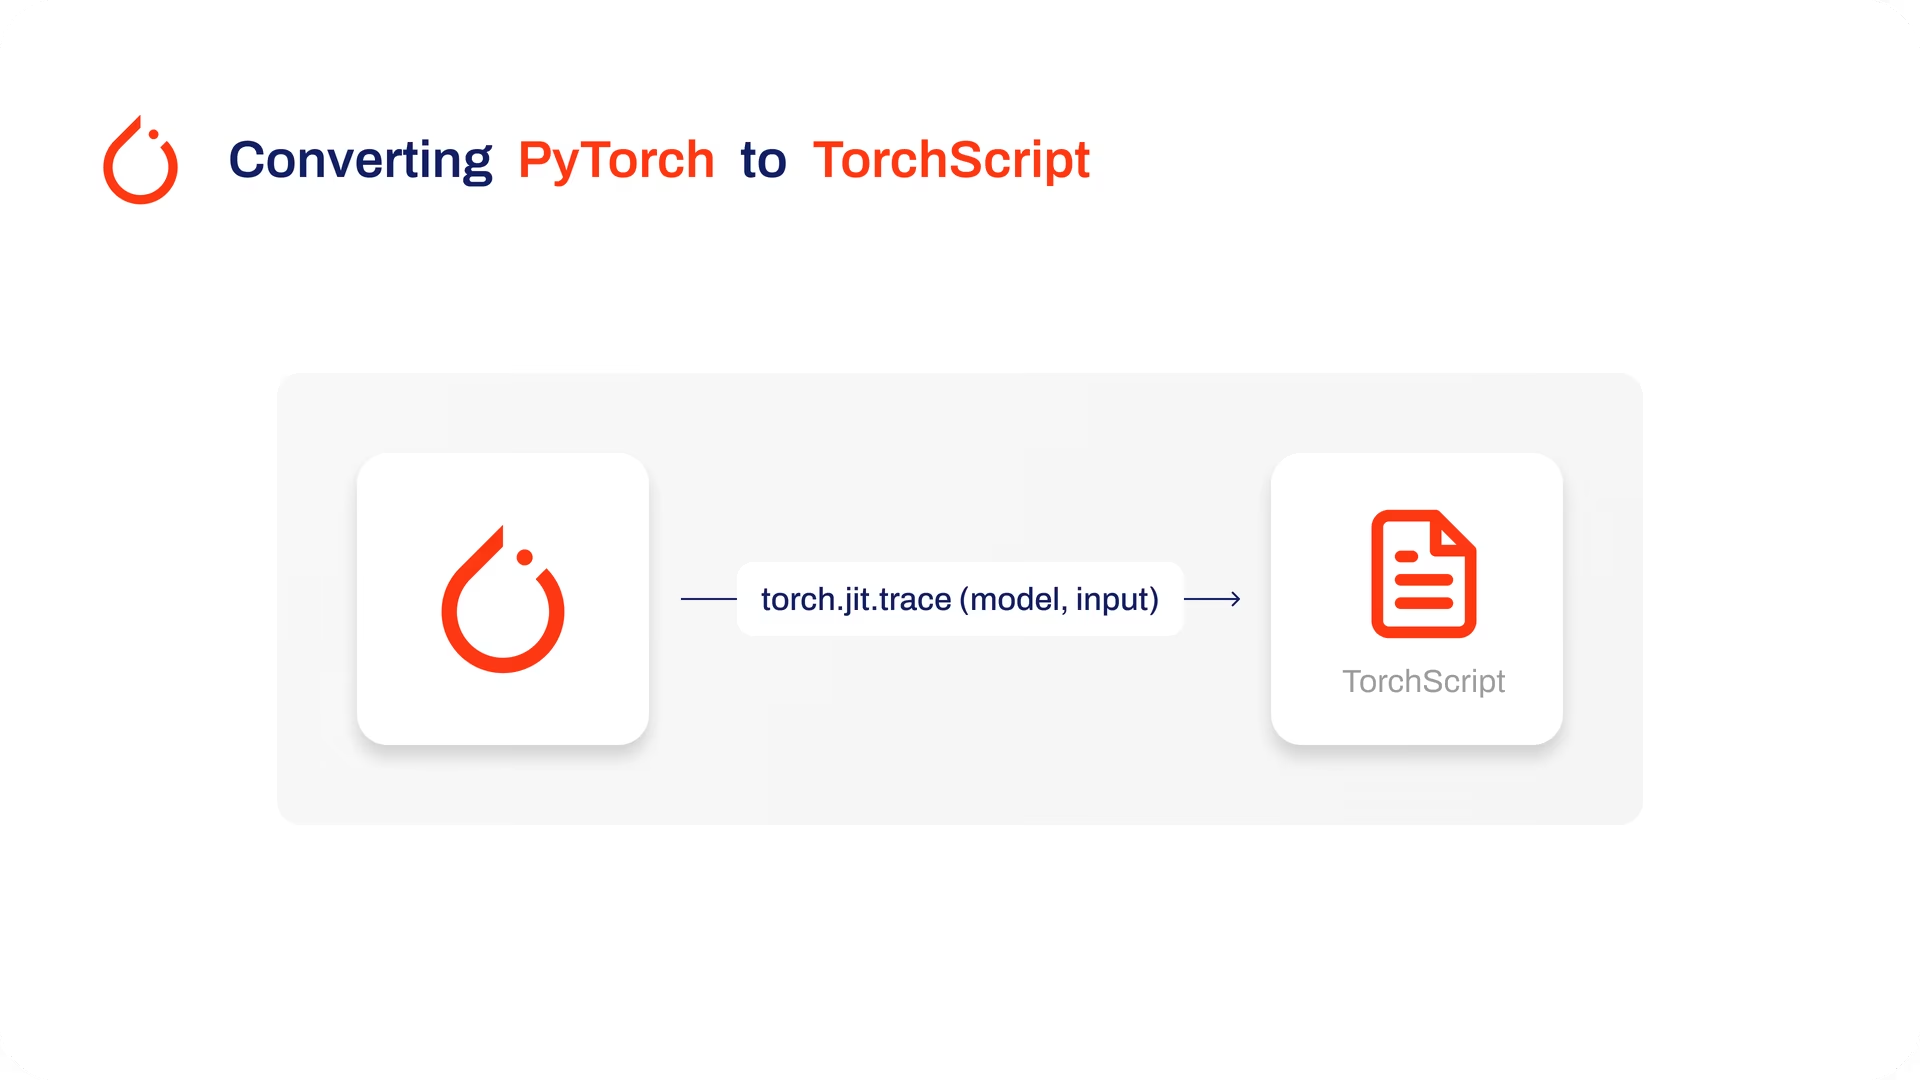
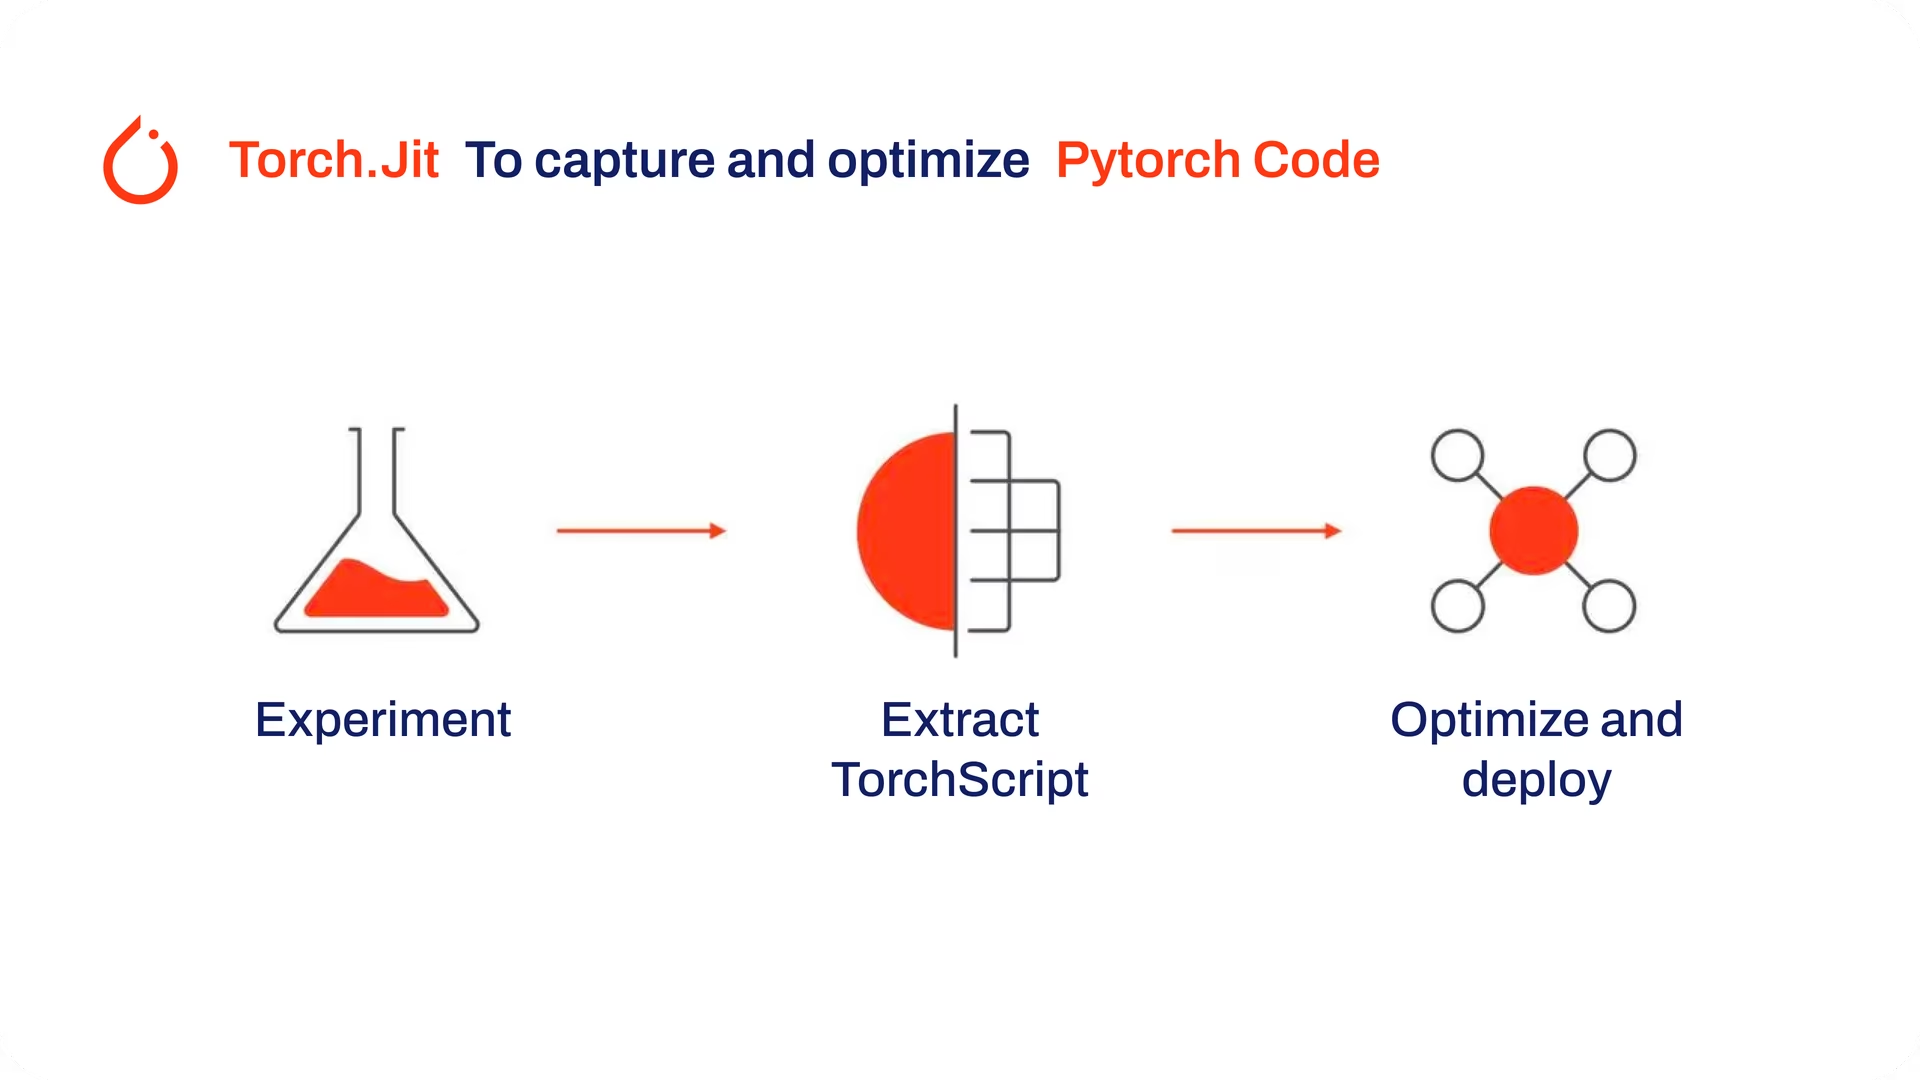
Sviluppato dai creatori di PyTorch, TorchScript è un potente strumento per ottimizzare e distribuire modelli PyTorch su diverse piattaforme. Esportare i modelli YOLO26 in TorchScript è fondamentale per passare dalla ricerca alle applicazioni reali. TorchScript, parte del framework PyTorch, agevola questa transizione consentendo l'uso dei modelli PyTorch in ambienti che non supportano Python.
Il processo prevede due tecniche: tracing e scripting. Il tracing registra le operazioni durante l'esecuzione del modello, mentre lo scripting consente di definire modelli usando un sottoinsieme di Python. Queste tecniche permettono a modelli come YOLO26 di continuare a funzionare anche al di fuori del consueto ambiente Python.
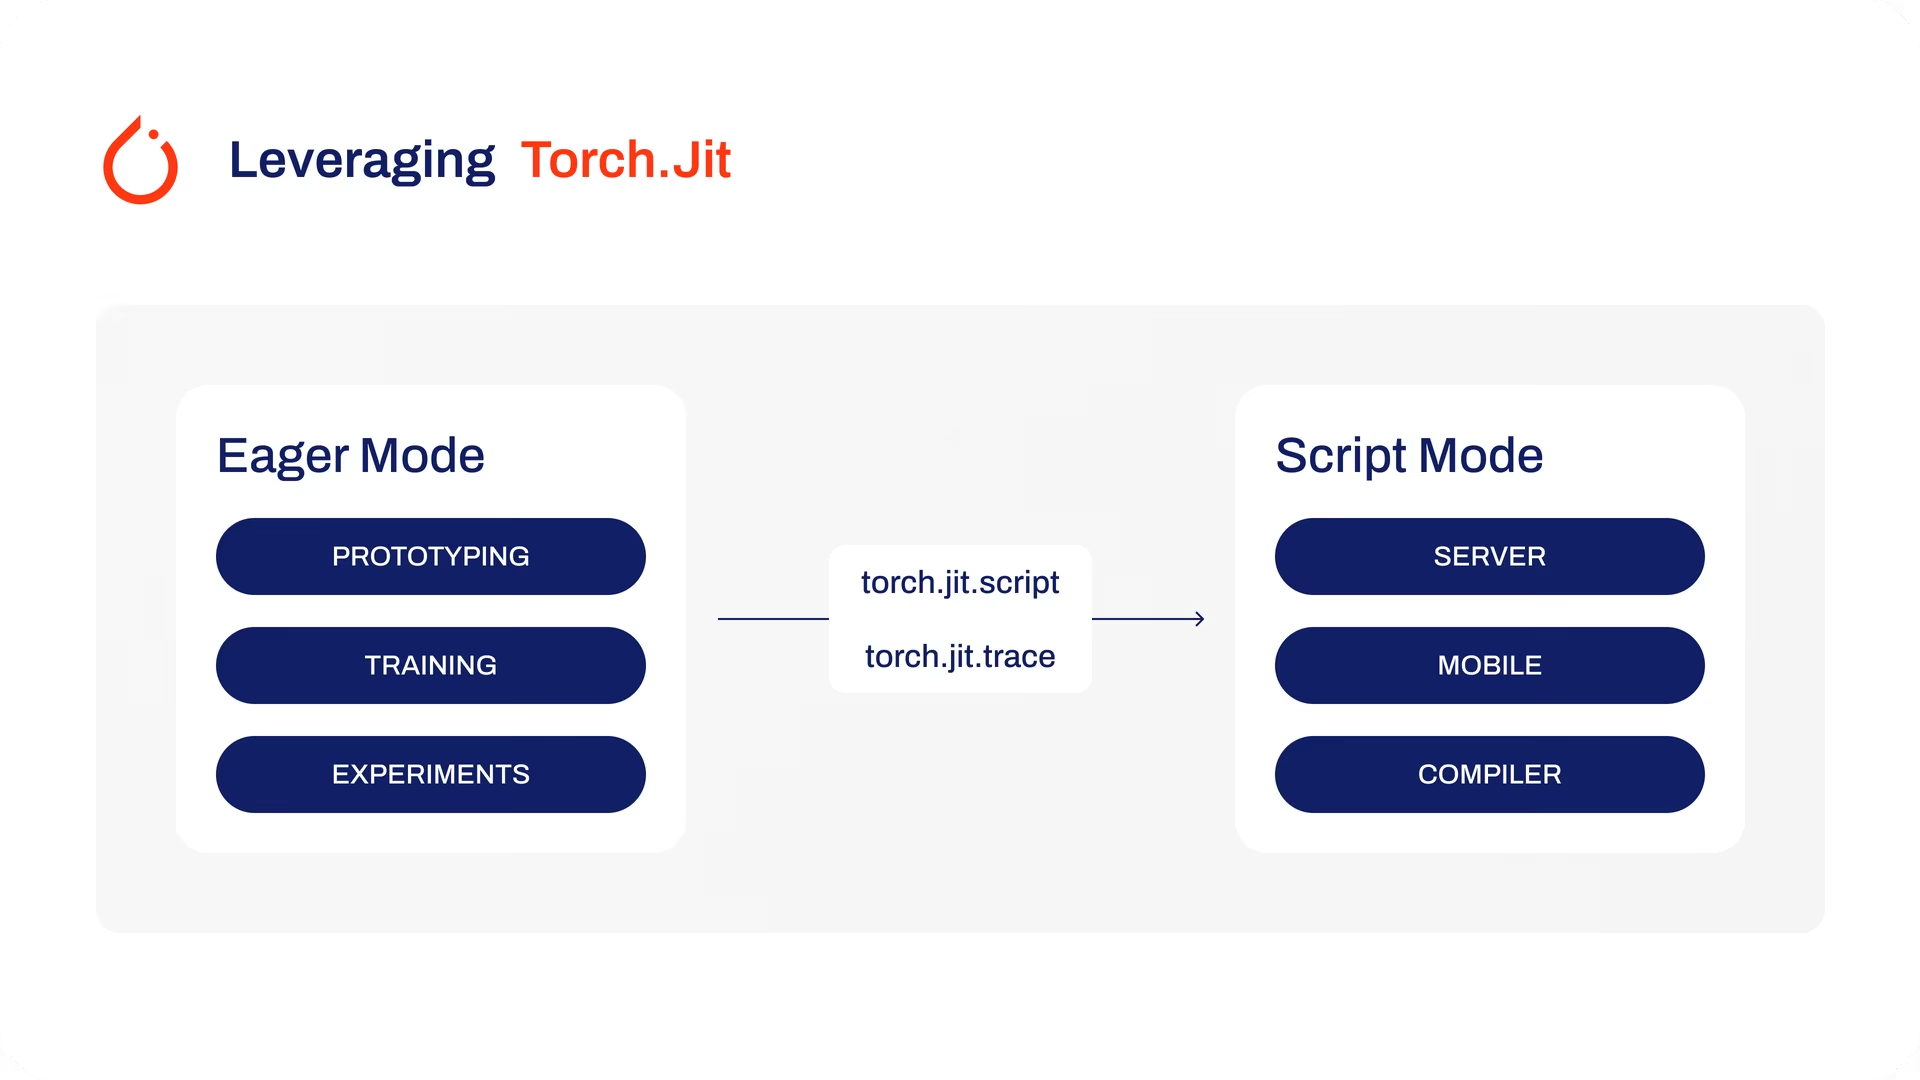
I modelli TorchScript possono essere ottimizzati anche con tecniche come la fusione degli operatori e il miglioramento dell'uso della memoria, così da garantire un'esecuzione efficiente. Un altro vantaggio dell'esportazione in TorchScript è la possibilità di accelerare l'esecuzione dei modelli su diverse piattaforme hardware. Crea una rappresentazione autonoma e pronta per la produzione del tuo modello PyTorch, integrabile in ambienti C++.
Caratteristiche principali dei modelli TorchScript#
TorchScript, elemento fondamentale dell'ecosistema PyTorch, offre potenti funzionalità per ottimizzare e distribuire modelli di deep learning.
Ecco le caratteristiche principali che rendono TorchScript uno strumento prezioso per gli sviluppatori:
-
Esecuzione con grafo statico: TorchScript usa una rappresentazione a grafo statico dei calcoli del modello, diversa dall'esecuzione con grafo dinamico di PyTorch. Nell'esecuzione con grafo statico, il grafo di calcolo viene definito e compilato una sola volta prima dell'esecuzione vera e propria, migliorando così le prestazioni durante l'inferenza.
-
Serializzazione del modello: TorchScript consente di serializzare i modelli PyTorch in un formato indipendente dalla piattaforma. I modelli serializzati possono essere caricati senza richiedere il codice Python originale, consentendo la distribuzione in diversi ambienti di runtime.
-
Compilazione JIT: TorchScript usa la compilazione Just-In-Time (JIT) per convertire i modelli PyTorch in una rappresentazione intermedia ottimizzata. JIT compila il grafo di calcolo del modello, consentendo un'esecuzione efficiente sui dispositivi di destinazione.
-
Conversione graduale: TorchScript offre un approccio di conversione graduale che consente di convertire progressivamente parti del modello PyTorch in TorchScript. Questa flessibilità è particolarmente utile con i modelli complessi o quando vuoi ottimizzare parti specifiche del codice.
Opzioni di distribuzione con TorchScript#
Prima di esaminare il codice per esportare i modelli YOLO26 nel formato TorchScript, vediamo in quali ambiti vengono solitamente usati i modelli TorchScript.
TorchScript offre diverse opzioni per distribuire modelli di machine learning, ad esempio:
-
API C++: il caso d'uso più comune di TorchScript è la sua API C++ LibTorch, che consente di caricare ed eseguire modelli TorchScript ottimizzati direttamente nelle applicazioni C++. È ideale negli ambienti di produzione in cui Python potrebbe non essere adatto o disponibile. L'API C++ offre un'esecuzione efficiente dei modelli TorchScript con un overhead ridotto, massimizzando le prestazioni potenziali.
-
Distribuzione su dispositivi mobili: per l'inferenza a bassa latenza e offline e la privacy dei dati sui dispositivi mobili, usa ExecuTorch, il sostituto di PyTorch per TorchScript Mobile.
-
Distribuzione nel cloud: i modelli TorchScript possono essere distribuiti su server cloud usando soluzioni come TorchServe. Offre funzionalità quali il controllo delle versioni dei modelli, il batching e il monitoraggio delle metriche, per una distribuzione scalabile negli ambienti di produzione. La distribuzione cloud con TorchScript può rendere i tuoi modelli accessibili tramite API o altri servizi web.
Attività supportate#
L'esportazione TorchScript supporta tutti e sette i task Ultralytics. La segmentazione semantica e la stima della profondità sono disponibili solo con YOLO26, l'unica famiglia che include queste head.
| Attività | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Rilevamento | ✅ | ✅ | ✅ |
| Segmentazione | ✅ | ✅ | ✅ |
| Semantica | ❌ | ❌ | ✅ |
| Profondità | ❌ | ❌ | ✅ |
| Classificazione | ✅ | ✅ | ✅ |
| Stima della posa | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Esportazione in TorchScript: conversione del modello YOLO26#
L'esportazione dei modelli YOLO26 in TorchScript ne semplifica l'utilizzo in contesti diversi e aiuta a eseguirli in modo più rapido ed efficiente. È una soluzione ideale per chi vuole usare i modelli di deep learning in modo più efficace nelle applicazioni reali.
Installazione#
Per installare il pacchetto richiesto, esegui:
# Install the required package for YOLO26
pip install ultralytics
Per istruzioni dettagliate e best practice sulla procedura di installazione, consulta la nostra guida all'installazione di Ultralytics. Se durante l'installazione dei pacchetti necessari per YOLO26 riscontri difficoltà, consulta la nostra guida ai problemi comuni per trovare soluzioni e suggerimenti.
Utilizzo#
Tutti i modelli Ultralytics YOLO26 sono progettati per supportare l'esportazione senza configurazioni aggiuntive, semplificando l'integrazione nel workflow di distribuzione che preferisci. Puoi consultare l'elenco completo dei formati di esportazione supportati e delle opzioni di configurazione per scegliere la configurazione più adatta alla tua applicazione.
Il formato TorchScript supporta le modalità Esporta, Prevedi e Convalida. Esporta il modello, quindi carica il modello esportato per eseguire inferenze o convalidarne la precisione.
from ultralytics import YOLO

# Carica un modello YOLO26
model = YOLO("yolo26n.pt")

# Esporta il modello nel formato TorchScript
model.export(format="torchscript") # crea 'yolo26n.torchscript'from ultralytics import YOLO
# Carica il modello TorchScript esportato
model = YOLO("yolo26n.torchscript")
# Esegui l'inferenza
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Carica il modello TorchScript esportato
model = YOLO("yolo26n.torchscript")
# # Convalida l'accuratezza sul dataset COCO8
metrics = model.val(data="coco8.yaml")Argomenti di esportazione#
| Argomento | Tipo | Predefinito | Descrizione |
|---|---|---|---|
format | str | 'torchscript' | Formato di destinazione del modello esportato, che definisce la compatibilità con i vari ambienti di distribuzione. |
imgsz | int o tuple | 640 | Dimensione dell'immagine desiderata per l'input del modello. Può essere un intero per immagini quadrate o una tupla (height, width) per dimensioni specifiche. |
dynamic | bool | False | Consente dimensioni di input dinamiche, aumentando la flessibilità nella gestione di immagini con dimensioni diverse. |
quantize | int o str | None | Precisione della quantizzazione: 16 (FP16) richiede l'esportazione su GPU con device=0; 32/non specificato corrisponde a FP32. Sostituisce il flag deprecato half. |
nms | bool, facoltativo | None | Seleziona l'output grezzo (None, predefinito), NMS integrato (True) oppure la testa senza NMS (False). |
batch | int | 1 | Specifica la dimensione batch per l'inferenza del modello esportato o il numero massimo di immagini che il modello esportato elaborerà contemporaneamente in modalità predict. |
device | str | None | Specifica il dispositivo per l'esportazione: GPU (device=0), CPU (device=cpu), MPS per Apple silicon (device=mps). |
Per ulteriori dettagli sul processo di esportazione, visita la pagina della documentazione Ultralytics dedicata all'esportazione.
Distribuzione dei modelli YOLO26 TorchScript esportati#
Dopo aver esportato correttamente i modelli Ultralytics YOLO26 nel formato TorchScript, puoi distribuirli. Il primo passaggio consigliato per eseguire un modello TorchScript consiste nell'usare il metodo YOLO("model.torchscript"), come illustrato nello snippet di codice d'uso precedente. Per istruzioni dettagliate sulla distribuzione dei modelli TorchScript in altri contesti, consulta le seguenti risorse:
-
Scopri la distribuzione su dispositivi mobili: per l'attuale distribuzione di PyTorch su dispositivi mobili, usa la pipeline separata
torch.export()→.ptedi ExecuTorch. -
Approfondisci la distribuzione lato server: scopri come distribuire modelli lato server con TorchServe grazie a un tutorial dettagliato per un servizio di modelli scalabile ed efficiente.
-
Implementa la distribuzione in C++: approfondisci il tutorial sul caricamento di un modello TorchScript in C++, che facilita l'integrazione dei tuoi modelli TorchScript nelle applicazioni C++ per migliorare prestazioni e versatilità.
Riepilogo#
In questa guida abbiamo esaminato il processo di esportazione dei modelli Ultralytics YOLO26 nel formato TorchScript. Seguendo le istruzioni fornite, puoi ottimizzare le prestazioni dei modelli YOLO26 e ottenere la flessibilità necessaria per distribuirli su diverse piattaforme e in vari ambienti.
Per ulteriori dettagli sull'utilizzo, consulta la documentazione ufficiale di TorchScript.
Inoltre, se vuoi saperne di più sulle altre integrazioni di Ultralytics YOLO26, visita la nostra pagina della guida alle integrazioni. Troverai molte risorse e informazioni utili.
Domande frequenti#
L'esportazione di un modello Ultralytics YOLO26 in TorchScript consente una distribuzione flessibile e multipiattaforma. TorchScript, parte dell'ecosistema PyTorch, permette di serializzare i modelli, che possono quindi essere eseguiti in ambienti privi di supporto per Python. Questa caratteristica è utile per distribuire modelli in ambienti C++.
Per esportare un modello YOLO26 in TorchScript, puoi usare il seguente codice di esempio:
Utilizzofrom ultralytics import YOLO # Carica un modello YOLO26 model = YOLO("yolo26n.pt") # Esporta il modello nel formato TorchScript model.export(format="torchscript") # crea 'yolo26n.torchscript' # Carica il modello TorchScript esportato torchscript_model = YOLO("yolo26n.torchscript") # Esegui l'inferenza results = torchscript_model("https://ultralytics.com/images/bus.jpg")Per ulteriori dettagli sul processo di esportazione, consulta la documentazione Ultralytics sull'esportazione.
L'uso di TorchScript per distribuire i modelli YOLO26 offre diversi vantaggi:
- Portabilità: i modelli esportati possono essere eseguiti in applicazioni C++ senza Python.
- Ottimizzazione: TorchScript supporta l'esecuzione con grafo statico e la compilazione Just-In-Time (JIT), che possono ottimizzare le prestazioni del modello.
- Integrazione tra linguaggi: i modelli TorchScript possono essere integrati in altri linguaggi di programmazione, aumentando flessibilità ed espandibilità.
- Serializzazione: i modelli possono essere serializzati, consentendo il caricamento e l'inferenza indipendenti dalla piattaforma.
Per ulteriori informazioni sulla distribuzione, consulta la documentazione di TorchServe e la guida alla distribuzione in C++. Per la distribuzione mobile su dispositivo, PyTorch ora consiglia ExecuTorch, che utilizza una pipeline separata
torch.export()→.pteanziché TorchScript.Per installare il pacchetto necessario per esportare i modelli YOLO26, usa il seguente comando:
Installazione# Install the required package for YOLO26 pip install ultralyticsPer istruzioni dettagliate, consulta la guida all'installazione di Ultralytics. Se si verificano problemi durante l'installazione, consulta la guida ai problemi comuni.
Dopo aver esportato i modelli YOLO26 nel formato TorchScript, puoi distribuirli su diverse piattaforme:
- API C++: usa LibTorch per ambienti di produzione ad alta efficienza e con overhead ridotto.
- Distribuzione mobile: usa ExecuTorch, il sostituto supportato da PyTorch con una pipeline di esportazione separata
.pte. - Distribuzione cloud: usa servizi come TorchServe per una distribuzione scalabile lato server.
Consulta le linee guida complete per distribuire i modelli in questi ambienti e sfruttare appieno le funzionalità di TorchScript.