ExecuTorchでYOLO26をモバイルおよびエッジにデプロイする#
スマートフォン、タブレット、組み込みシステムなどのエッジデバイスにコンピュータービジョンモデルをデプロイするには、パフォーマンスとリソース制約のバランスを取る最適化済みランタイムが必要です。PyTorchのエッジコンピューティング向けソリューションであるExecuTorchを使うと、Ultralytics YOLOモデルの効率的なオンデバイス推論が可能になります。
このガイドでは、Ultralytics YOLOモデルをExecuTorch形式にエクスポートし、最適化されたパフォーマンスでモバイルデバイスやエッジデバイスにデプロイする方法を説明します。
ExecuTorchにエクスポートする理由#
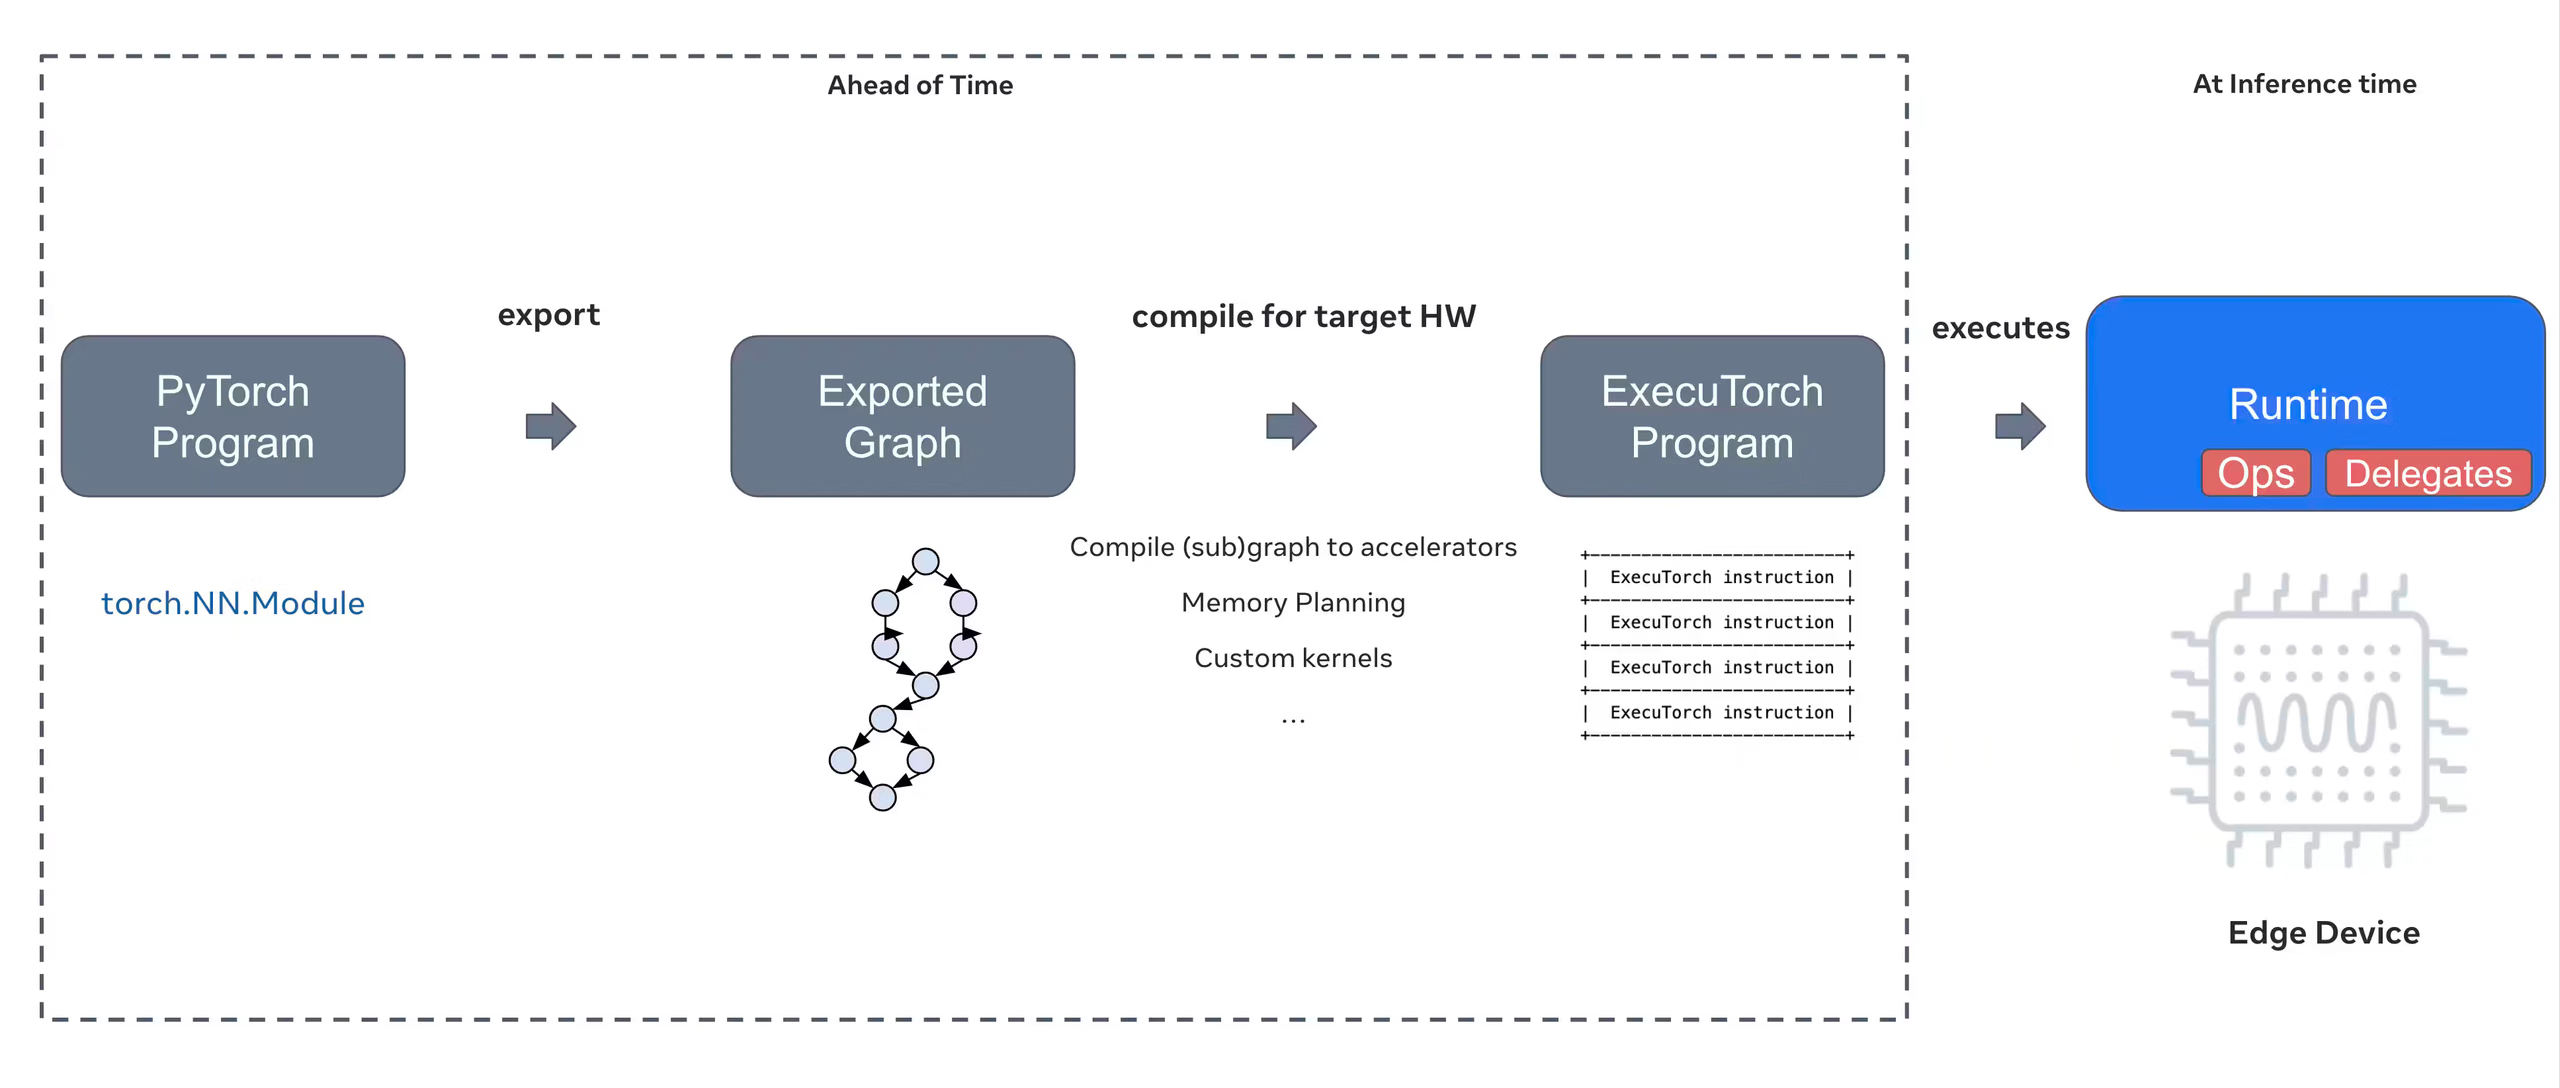
ExecuTorchは、モバイルデバイスやエッジデバイスでオンデバイス推論を可能にするPyTorchのエンドツーエンドソリューションです。移植性と効率性を重視して構築されたExecuTorchを使うと、幅広いコンピューティングプラットフォームでPyTorchプログラムを実行できます。
ExecuTorchの主な機能#
ExecuTorchには、エッジデバイスにUltralytics YOLOモデルをデプロイするための強力な機能がいくつかあります。
-
移植性に優れたモデル形式: ExecuTorchは
.pte(PyTorch ExecuTorch)形式を使用します。この形式は、リソースが限られたデバイスでのサイズと読み込み速度を最適化しています。 -
XNNPACKバックエンド: XNNPACKとの標準連携により、モバイルCPUで推論が高度に最適化され、専用ハードウェアを必要とせずに優れたパフォーマンスを実現します。
-
量子化に対応: ExecuTorchエコシステムは、モデルサイズの縮小と推論速度の向上に役立つ量子化手法をサポートしています。Ultralyticsは現在、XNNPACKバックエンドを介してFP32モデルをエクスポートします。
-
メモリ効率: 最適化されたメモリ管理により実行時のメモリ使用量が抑えられるため、RAMが限られたデバイスに適しています。
-
モデルのメタデータ: エクスポートされたモデルには、簡単に連携できるよう、画像サイズやクラス名などのメタデータが別個のYAMLファイルに含まれます。
ExecuTorchのデプロイオプション#
ExecuTorchモデルは、さまざまなエッジプラットフォームやモバイルプラットフォームにデプロイできます。
-
モバイルアプリケーション: iOSおよびAndroidアプリケーションにネイティブパフォーマンスでデプロイし、モバイルアプリでリアルタイムの物体検出を実現できます。
-
組み込みシステム: Raspberry Pi、NVIDIA Jetsonなどの組み込みLinuxデバイスや、その他のARMベースのシステムで、最適化されたパフォーマンスで実行できます。
-
エッジAIデバイス: カスタムデリゲートを備えた専用エッジAIハードウェアにデプロイし、推論を高速化できます。
-
IoTデバイス: クラウド接続を必要とせずにオンデバイス推論を実行できるよう、IoTデバイスに統合できます。
対応タスク#
ExecuTorchのエクスポートは、Ultralyticsの7つすべてのタスクに対応しています。セマンティックセグメンテーションと深度推定はYOLO26でのみ利用でき、これらのヘッドを搭載しているのはYOLO26ファミリーだけです。
Ultralytics YOLO26モデルをExecuTorchにエクスポートする#
Ultralytics YOLO26モデルをExecuTorch形式に変換すると、モバイルデバイスやエッジデバイスに効率的にデプロイできます。
インストール#
ExecuTorch のエクスポートには Python 3.10~3.14 と PyTorch >= 2.9.0 が必要です。ExecuTorch モデルをエクスポートまたは読み込むと、Ultralytics は互換性のある executorch パッケージをインストールします。PyTorch 2.13 より前のバージョンでは executorch<1.5 に固定されるため、手動でアップグレードしないでください。
# Install Ultralytics package
pip install ultralyticsインストール手順の詳細やベストプラクティスについては、YOLO26のインストールガイドをご覧ください。YOLO26に必要なパッケージのインストール中に問題が発生した場合は、解決策やヒントについてよくある問題のガイドをご確認ください。
使用方法#
YOLO26モデルをExecuTorchにエクスポートする手順は簡単です。
ExecuTorch形式は、エクスポート、予測、検証の各モードをサポートしています。モデルをエクスポートした後、エクスポート済みモデルを読み込んで推論を実行するか、精度を検証します。
from ultralytics import YOLO

# YOLO26モデルを読み込みます
model = YOLO("yolo26n.pt")

# モデルをExecuTorch形式にエクスポートします
model.export(format="executorch") # creates 'yolo26n_executorch_model'from ultralytics import YOLO
# エクスポート済みのExecuTorchモデルを読み込みます
model = YOLO("yolo26n_executorch_model")
# 推論を実行
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# エクスポート済みのExecuTorchモデルを読み込みます
model = YOLO("yolo26n_executorch_model")
# COCO8データセットで精度を検証します
metrics = model.val(data="coco8.yaml")ExecuTorchへのエクスポートでは、.pteファイルとメタデータを含むディレクトリが生成されます。モバイルアプリケーションまたは組み込みアプリケーションでExecuTorchランタイムを使用して、.pteモデルを読み込み、推論を実行します。
エクスポート引数#
ExecuTorch形式にエクスポートする際、次の引数を指定できます。
| 引数 | 種類 | デフォルト | 説明 |
|---|---|---|---|
format | str | 'executorch' | エクスポートしたモデルのターゲットフォーマットです。さまざまなデプロイ環境との互換性を定義します。 |
imgsz | intまたはtuple | 640 | モデル入力の画像サイズです。正方形画像の場合は整数、特定のサイズの場合はタプル(height, width)を指定できます。 |
quantize | intまたはstr | None | FP32でのエクスポートに固定されます。ExecuTorchのエクスポートでは、エクスポート時のFP16、INT8、W8A16への精度変換はサポートされていません。 |
batch | int | 1 | エクスポートモデルのバッチ推論サイズ、またはpredictモードでエクスポートモデルが同時に処理する画像の最大数を指定します。 |
device | str | None | エクスポートに使用するデバイスを指定します。GPU(device=0)、CPU(device=cpu)、Appleシリコン向けMPS(device=mps)から選択します。 |
出力構造#
ExecuTorchへのエクスポートでは、モデルとメタデータを含むディレクトリが作成されます。
yolo26n_executorch_model/
├── model.pte               # ExecuTorch model file
└── metadata.yaml # Model metadata (classes, image size, etc.)エクスポート済みExecuTorchモデルの使用#
モデルをエクスポートした後、ExecuTorchランタイムを使用して対象のアプリケーションに統合する必要があります。
モバイルへの統合#
モバイルアプリケーション(iOS/Android)では、次の作業が必要です。
- ExecuTorchランタイムを追加: ExecuTorchランタイムライブラリをモバイルプロジェクトに含めます
- モデルを読み込み: アプリケーションで
.pteファイルを読み込みます - 推論を実行: 画像を処理して予測結果を取得します
iOS#
iOS統合の例(Objective-C/C++):
// iOS uses C++ APIs for model loading and inference
// See https://pytorch.org/executorch/stable/using-executorch-ios.html for complete examples

#include <executorch/extension/module/module.h>

using namespace ::executorch::extension;

// Load the model
Module module("/path/to/model.pte");

// Create input tensor
float input[1 * 3 * 640 * 640];
auto tensor = from_blob(input, {1, 3, 640, 640});

// Run inference
const auto result = module.forward(tensor);Android#
Maven CentralからExecuTorch Android AARを追加します:
dependencies {
    implementation("org.pytorch:executorch-android:<version>")
}
Android統合の例(Kotlin):
import org.pytorch.executorch.EValue
import org.pytorch.executorch.Module
import org.pytorch.executorch.Tensor

// Load the model
val module = Module.load("/path/to/model.pte")

// Prepare input tensor
val inputTensor = Tensor.fromBlob(floatData, longArrayOf(1, 3, 640, 640))
val inputEValue = EValue.from(inputTensor)

// Run inference
val outputs = module.forward(inputEValue)
val scores = outputs[0].toTensor().dataAsFloatArray組み込みLinux#
組み込みLinuxシステムでは、ExecuTorch C++ APIを使用します:
#include <executorch/extension/module/module.h>
#include <executorch/extension/tensor/tensor.h>

using namespace ::executorch::extension;

// Load model
Module module("model.pte");

// Prepare input
std::vector<float> input_data = preprocessImage(image);
auto input_tensor = from_blob(input_data.data(), {1, 3, 640, 640});

// Run inference
const auto outputs = module.forward(input_tensor);ExecuTorchをアプリケーションに統合する方法の詳細については、ExecuTorchドキュメントをご覧ください。
パフォーマンスの最適化#
モデルサイズの最適化#
デプロイ用にモデルサイズを削減するには、次の方法があります:
- 小型モデルを使用する:最もフットプリントの小さいYOLO26n(nano)から始めます
- 入力解像度を下げる:より小さい画像サイズを使用します(例:
imgsz=320またはimgsz=416) - 量子化:Ultralytics以外でExecuTorchの量子化手法を適用します(UltralyticsのExecuTorchエクスポートはFP32のみです)
推論速度の最適化#
推論を高速化するには、次の方法があります:
- XNNPACKバックエンド:デフォルトのXNNPACKバックエンドにより、最適化されたCPU推論を利用できます
- ハードウェアアクセラレーション:プラットフォーム固有のデリゲートを使用します(例:iOS向けのCoreML)
- バッチ処理:可能な場合は複数の画像を処理します
ベンチマーク#
UltralyticsチームはYOLO26モデルのベンチマークを実施し、PyTorchとExecuTorchの速度と精度を比較しました。
| モデル | 形式 | ステータス | サイズ(MB) | metrics/mAP50-95(B) | 推論時間(ms/im) |
|---|---|---|---|---|---|
| YOLO26n | PyTorch | ✅ | 5.3 | 0.4790 | 314.80 |
| YOLO26n | ExecuTorch | ✅ | 9.4 | 0.4800 | 142 |
| YOLO26s | PyTorch | ✅ | 19.5 | 0.5730 | 930.90 |
| YOLO26s | ExecuTorch | ✅ | 36.5 | 0.5780 | 376.1 |
推論時間には前処理と後処理は含まれません。
トラブルシューティング#
よくある問題#
問題:Python version error
解決策: ExecuTorch には Python 3.10~3.14 が必要です。サポート対象のバージョンで環境を作成します。
# Using conda
conda create -n executorch python=3.14
conda activate executorchトラブルシューティングの詳細については、Ultralytics GitHubのIssueまたはExecuTorchドキュメントをご覧ください。
概要#
YOLO26モデルをExecuTorch形式にエクスポートすると、モバイルデバイスやエッジデバイスに効率よくデプロイできます。PyTorchネイティブの統合、クロスプラットフォーム対応、最適化されたパフォーマンスを備えるExecuTorchは、エッジAIアプリケーションに最適です。
主なポイント:
- ExecuTorchは、優れたパフォーマンスを備えたPyTorchネイティブのエッジデプロイを提供します
format='executorch'パラメーターを使用して簡単にエクスポートできます- XNNPACKバックエンドにより、モデルはモバイルCPU向けに最適化されます
- iOS、Android、組み込みLinuxプラットフォームに対応しています
- Python 3.10~3.14 と PyTorch >= 2.9.0 が必要です
よくある質問#
PythonまたはCLIを使用して、YOLO26モデルをExecuTorchにエクスポートできます:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(format="executorch")
または
yolo export model=yolo26n.pt format=executorchExecuTorchのエクスポートには、次のものが必要です:
- Python 3.10~3.14
- 自動インストールされる
executorchパッケージ(PyTorch 2.13未満ではexecutorch<1.5。新しいExecuTorchランタイムはこれをサポートしていません) - PyTorch(ultralyticsとともに自動インストールされます)
注:
executorchパッケージにはビルド済みのホイール(XNNPACKバックエンドを含む)が用意されているため、エクスポート時に追加のコンパイル手順は必要ありません。ExecuTorchモデルは、Pythonでの推論や検証に
YOLO()を使用して直接読み込めます(上記のPredict/Validateの例を参照)。また、ExecuTorchランタイムライブラリを使用して、モバイルデバイスやエッジデバイスにデプロイすることもできます。ExecuTorchは次の環境に対応しています:
- モバイル:iOSおよびAndroid
- 組み込みLinux:Raspberry Pi、NVIDIA Jetson、その他のARMデバイス
- デスクトップ:Linux、macOS、Windows(開発用)
ExecuTorchとLiteRTは、どちらもモバイルデプロイに適しています:
- ExecuTorch:PyTorchとの統合性が高く、PyTorchネイティブのワークフローを利用でき、エコシステムも拡大しています
- LiteRT:より成熟しており、幅広いハードウェアに対応し、デプロイ例も豊富です。また、Android、iOS、ブラウザーで同じモデルを実行できます
すでにPyTorchを使用していて、ネイティブなデプロイ方法を求める場合はExecuTorchを選択してください。最大限の互換性と成熟したツールを求める場合はLiteRTを選択してください。
はい。ExecuTorchは、さまざまなバックエンドを通じてハードウェアアクセラレーションに対応しています:
- モバイルGPU:Vulkan、Metal、またはOpenCLのデリゲートを使用
- NPU/DSP:プラットフォーム固有のデリゲートを使用
- デフォルト:最適化されたCPU推論向けのXNNPACK
バックエンド固有のセットアップについては、ExecuTorchドキュメントをご覧ください。