YOLOv7: トレーニング可能なBag-of-Freebies#
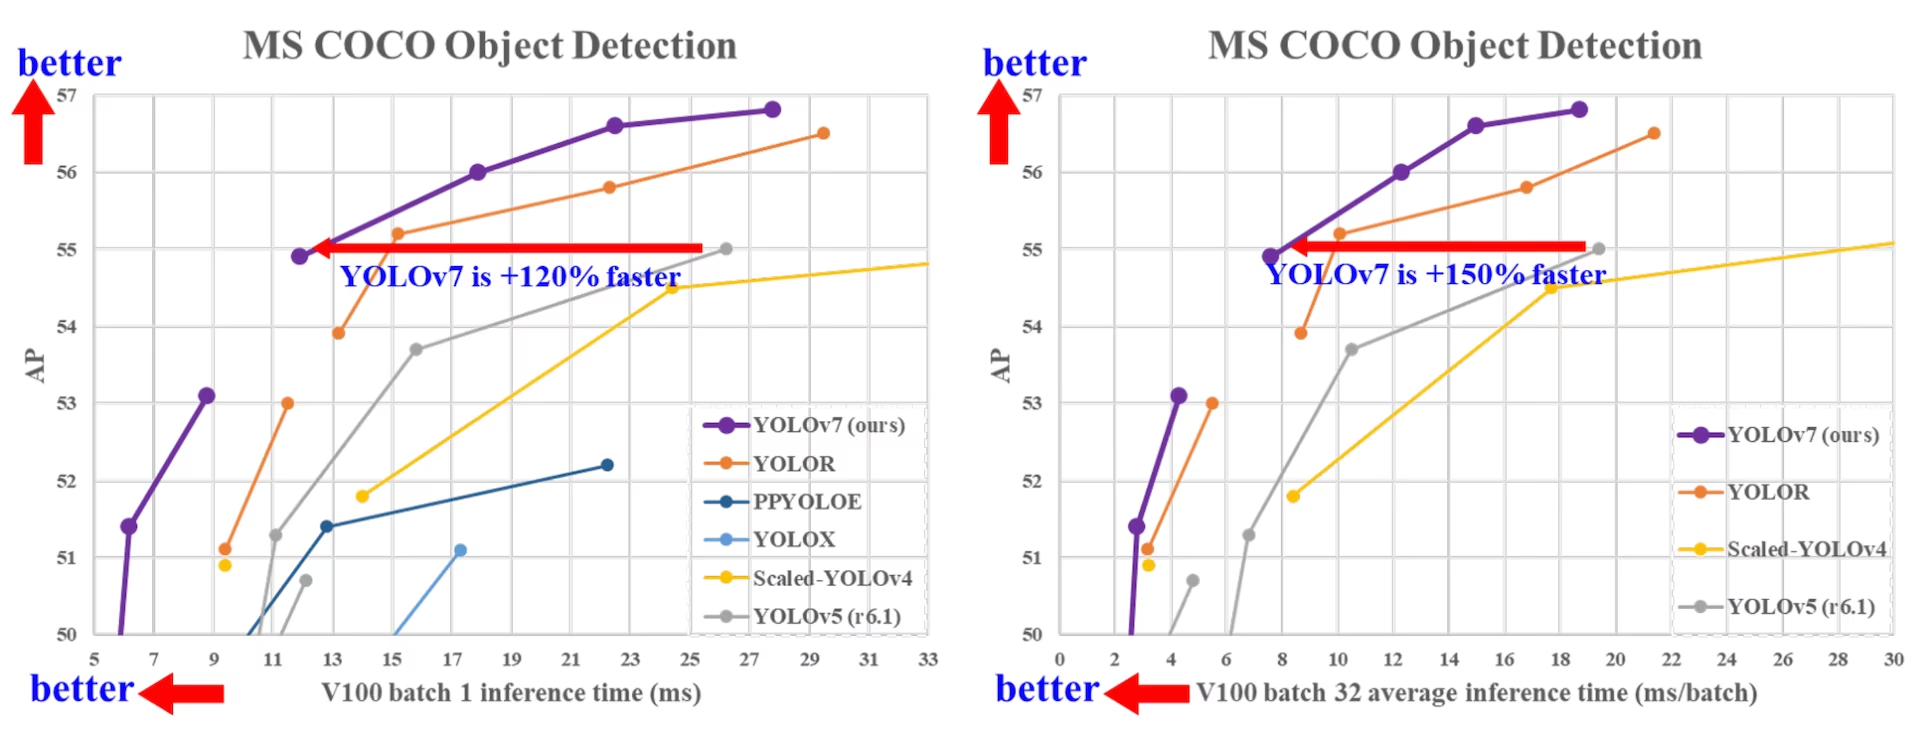
2022年7月にリリースされたYOLOv7は、リリース当時のリアルタイム物体検出における大きな進歩でした。GPU V100で56.8%のAPを達成し、発表時に新たなベンチマークを確立しました。YOLOv7は、速度と精度の両面で、YOLOR、YOLOX、Scaled-YOLOv4、YOLOv5などの同時代の物体検出器を上回りました。このモデルは、他のデータセットや事前学習済み重みを使用せず、MS COCOデータセットのみでゼロから学習されています。YOLOv7のソースコードはGitHubで利用できます。なお、その後、YOLO11やYOLO26などの新しいモデルが、効率性を向上させながらより高い精度を達成しています。
SOTA物体検出器の比較#
YOLOの比較表の結果から、提案手法が速度と精度のトレードオフにおいて総合的に最も優れていることが分かります。YOLOv7-tiny-SiLUとYOLOv5-N (r6.1)を比較すると、提案手法は127 fps高速で、APで10.7%高い精度を達成しています。さらに、YOLOv7は161 fpsのフレームレートで51.4%のAPを達成していますが、同じAPを持つPPYOLOE-Lのフレームレートはわずか78 fpsです。パラメーター使用量の面では、YOLOv7はPPYOLOE-Lより41%少なくなっています。
推論速度114 fpsのYOLOv7-Xと推論速度99 fpsのYOLOv5-L (r6.1)を比較すると、YOLOv7-XはAPを3.9%向上させられます。YOLOv7-Xを同程度の規模のYOLOv5-X (r6.1)と比較すると、YOLOv7-Xの推論速度は31 fps高速です。さらに、パラメーター数と計算量の面では、YOLOv7-XはYOLOv5-X (r6.1)と比較してパラメーターを22%、計算量を8%削減しながら、APを2.2%向上させています(出典)。
| モデル | パラメーター (M) | FLOPs (G) | サイズ (ピクセル) | FPS | APtest / val 50-95 | APtest 50 | APtest 75 | APtest S | APtest M | APtest L |
|---|---|---|---|---|---|---|---|---|---|---|
| YOLOX-S | 9.0 | 26.8 | 640 | 102 | 40.5% / 40.5% | - | - | - | - | - |
| YOLOX-M | 25.3 | 73.8 | 640 | 81 | 47.2% / 46.9% | - | - | - | - | - |
| YOLOX-L | 54.2 | 155.6 | 640 | 69 | 50.1% / 49.7% | - | - | - | - | - |
| YOLOX-X | 99.1 | 281.9 | 640 | 58 | 51.5% / 51.1% | - | - | - | - | - |
| PPYOLOE-S | 7.9 | 17.4 | 640 | 208 | 43.1% / 42.7% | 60.5% | 46.6% | 23.2% | 46.4% | 56.9% |
| PPYOLOE-M | 23.4 | 49.9 | 640 | 123 | 48.9% / 48.6% | 66.5% | 53.0% | 28.6% | 52.9% | 63.8% |
| PPYOLOE-L | 52.2 | 110.1 | 640 | 78 | 51.4% / 50.9% | 68.9% | 55.6% | 31.4% | 55.3% | 66.1% |
| PPYOLOE-X | 98.4 | 206.6 | 640 | 45 | 52.2% / 51.9% | 69.9% | 56.5% | 33.3% | 56.3% | 66.4% |
| YOLOv5-N (r6.1) | 1.9 | 4.5 | 640 | 159 | - / 28.0% | - | - | - | - | - |
| YOLOv5-S (r6.1) | 7.2 | 16.5 | 640 | 156 | - / 37.4% | - | - | - | - | - |
| YOLOv5-M (r6.1) | 21.2 | 49.0 | 640 | 122 | - / 45.4% | - | - | - | - | - |
| YOLOv5-L (r6.1) | 46.5 | 109.1 | 640 | 99 | - / 49.0% | - | - | - | - | - |
| YOLOv5-X (r6.1) | 86.7 | 205.7 | 640 | 83 | - / 50.7% | - | - | - | - | - |
| YOLOR-CSP | 52.9 | 120.4 | 640 | 106 | 51.1% / 50.8% | 69.6% | 55.7% | 31.7% | 55.3% | 64.7% |
| YOLOR-CSP-X | 96.9 | 226.8 | 640 | 87 | 53.0% / 52.7% | 71.4% | 57.9% | 33.7% | 57.1% | 66.8% |
| YOLOv7-tiny-SiLU | 6.2 | 13.8 | 640 | 286 | 38.7% / 38.7% | 56.7% | 41.7% | 18.8% | 42.4% | 51.9% |
| YOLOv7 | 36.9 | 104.7 | 640 | 161 | 51.4% / 51.2% | 69.7% | 55.9% | 31.8% | 55.5% | 65.0% |
| YOLOv7-X | 71.3 | 189.9 | 640 | 114 | 53.1% / 52.9% | 71.2% | 57.8% | 33.8% | 57.1% | 67.4% |
| YOLOv5-N6 (r6.1) | 3.2 | 18.4 | 1280 | 123 | - / 36.0% | - | - | - | - | - |
| YOLOv5-S6 (r6.1) | 12.6 | 67.2 | 1280 | 122 | - / 44.8% | - | - | - | - | - |
| YOLOv5-M6 (r6.1) | 35.7 | 200.0 | 1280 | 90 | - / 51.3% | - | - | - | - | - |
| YOLOv5-L6 (r6.1) | 76.8 | 445.6 | 1280 | 63 | - / 53.7% | - | - | - | - | - |
| YOLOv5-X6 (r6.1) | 140.7 | 839.2 | 1280 | 38 | - / 55.0% | - | - | - | - | - |
| YOLOR-P6 | 37.2 | 325.6 | 1280 | 76 | 53.9% / 53.5% | 71.4% | 58.9% | 36.1% | 57.7% | 65.6% |
| YOLOR-W6 | 79.8 | 453.2 | 1280 | 66 | 55.2% / 54.8% | 72.7% | 60.5% | 37.7% | 59.1% | 67.1% |
| YOLOR-E6 | 115.8 | 683.2 | 1280 | 45 | 55.8% / 55.7% | 73.4% | 61.1% | 38.4% | 59.7% | 67.7% |
| YOLOR-D6 | 151.7 | 935.6 | 1280 | 34 | 56.5% / 56.1% | 74.1% | 61.9% | 38.9% | 60.4% | 68.7% |
| YOLOv7-W6 | 70.4 | 360.0 | 1280 | 84 | 54.9% / 54.6% | 72.6% | 60.1% | 37.3% | 58.7% | 67.1% |
| YOLOv7-E6 | 97.2 | 515.2 | 1280 | 56 | 56.0% / 55.9% | 73.5% | 61.2% | 38.0% | 59.9% | 68.4% |
| YOLOv7-D6 | 154.7 | 806.8 | 1280 | 44 | 56.6% / 56.3% | 74.0% | 61.8% | 38.8% | 60.1% | 69.5% |
| YOLOv7-E6E | 151.7 | 843.2 | 1280 | 36 | 56.8% / 56.8% | 74.4% | 62.1% | 39.3% | 60.5% | 69.0% |
概要#
リアルタイム物体検出は、マルチ物体追跡、自動運転、ロボティクス、医用画像解析など、多くのコンピュータービジョンシステムにおける重要な構成要素です。近年、リアルタイム物体検出の開発では、効率的なアーキテクチャの設計と、さまざまなCPU、GPU、ニューラルプロセッシングユニット(NPU)の推論速度向上に重点が置かれています。YOLOv7は、エッジからクラウドまで、モバイルGPUとGPUの両方のデバイスをサポートしています。
アーキテクチャの最適化に重点を置く従来のリアルタイム物体検出器とは異なり、YOLOv7は学習プロセスの最適化に重点を置いています。これには、推論コストを増加させずに物体検出の精度を向上させるよう設計されたモジュールと最適化手法が含まれます。この概念は「トレーニング可能なBag-of-Freebies」と呼ばれています。
主な特徴#
YOLOv7は、いくつかの主要機能を導入しています。
-
モデルの再パラメーター化: YOLOv7は、勾配伝播パスの概念に基づき、異なるネットワークのレイヤーに適用できる戦略として、計画的に再パラメーター化されたモデルを提案しています。
-
動的ラベル割り当て: 複数の出力レイヤーを持つモデルの学習では、「異なるブランチの出力に対して動的ターゲットをどのように割り当てるか」という新たな問題が生じます。この問題を解決するため、YOLOv7はcoarse-to-fine lead guided label assignmentと呼ばれる新しいラベル割り当て手法を導入しています。
-
拡張スケーリングと複合スケーリング: YOLOv7は、パラメーターと計算量を効果的に活用できるリアルタイム物体検出器向けに、「拡張」および「複合スケーリング」手法を提案しています。
-
効率性: YOLOv7が提案する手法は、最先端のリアルタイム物体検出器のパラメーターを約40%、計算量を50%効果的に削減し、より高速な推論速度と高い検出精度を実現します。
使用例#
Ultralyticsはyolov7.ptの事前学習済み重みやultralytics/cfg/models/v7/のYAMLファイルを公開しておらず、YOLOv7のネイティブなPyTorchによる学習と推論は、Ultralytics Pythonパッケージではサポートされていません。ただし、以下に示すように、upstream YOLOv7 repositoryで学習したYOLOv7チェックポイントをONNXまたはTensorRTにエクスポートすることで、Ultralyticsに取り込めます。
ONNXエクスポート#
UltralyticsでYOLOv7 ONNXモデルを使用するには、次の手順に従います。
-
(オプション)UltralyticsをインストールしてONNXモデルをエクスポートすると、必要な依存関係が自動的にインストールされます。
pip install ultralytics yolo export model=yolo26n.pt format=onnx -
YOLOv7 repoのエクスポーターを使用して、目的のYOLOv7モデルをエクスポートします。
git clone https://github.com/WongKinYiu/yolov7 cd yolov7 python export.py --weights yolov7-tiny.pt --grid --end2end --simplify --topk-all 100 --iou-thres 0.65 --conf-thres 0.35 --img-size 640 640 --max-wh 640 -
次のスクリプトを使用して、Ultralyticsと互換性を持つようにONNXモデルグラフを変更します。
import numpy as np import onnx from onnx import helper, numpy_helper # Load the ONNX model model_path = "yolov7/yolov7-tiny.onnx" # Replace with your model path model = onnx.load(model_path) graph = model.graph # Fix input shape to batch size 1 input_shape = graph.input[0].type.tensor_type.shape input_shape.dim[0].dim_value = 1 # Define the output of the original model original_output_name = graph.output[0].name # Create slicing nodes sliced_output_name = f"{original_output_name}_sliced" # Define initializers for slicing (remove the first value) start = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_start") end = numpy_helper.from_array(np.array([7], dtype=np.int64), name="slice_end") axes = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_axes") steps = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_steps") graph.initializer.extend([start, end, axes, steps]) slice_node = helper.make_node( "Slice", inputs=[original_output_name, "slice_start", "slice_end", "slice_axes", "slice_steps"], outputs=[sliced_output_name], name="SliceNode", ) graph.node.append(slice_node) # Define segment slicing seg1_start = numpy_helper.from_array(np.array([0], dtype=np.int64), name="seg1_start") seg1_end = numpy_helper.from_array(np.array([4], dtype=np.int64), name="seg1_end") seg2_start = numpy_helper.from_array(np.array([4], dtype=np.int64), name="seg2_start") seg2_end = numpy_helper.from_array(np.array([5], dtype=np.int64), name="seg2_end") seg3_start = numpy_helper.from_array(np.array([5], dtype=np.int64), name="seg3_start") seg3_end = numpy_helper.from_array(np.array([6], dtype=np.int64), name="seg3_end") graph.initializer.extend([seg1_start, seg1_end, seg2_start, seg2_end, seg3_start, seg3_end]) # Create intermediate tensors for segments segment_1_name = f"{sliced_output_name}_segment1" segment_2_name = f"{sliced_output_name}_segment2" segment_3_name = f"{sliced_output_name}_segment3" # Add segment slicing nodes graph.node.extend( [ helper.make_node( "Slice", inputs=[sliced_output_name, "seg1_start", "seg1_end", "slice_axes", "slice_steps"], outputs=[segment_1_name], name="SliceSegment1", ), helper.make_node( "Slice", inputs=[sliced_output_name, "seg2_start", "seg2_end", "slice_axes", "slice_steps"], outputs=[segment_2_name], name="SliceSegment2", ), helper.make_node( "Slice", inputs=[sliced_output_name, "seg3_start", "seg3_end", "slice_axes", "slice_steps"], outputs=[segment_3_name], name="SliceSegment3", ), ] ) # Concatenate the segments concat_output_name = f"{sliced_output_name}_concat" concat_node = helper.make_node( "Concat", inputs=[segment_1_name, segment_3_name, segment_2_name], outputs=[concat_output_name], axis=1, name="ConcatSwapped", ) graph.node.append(concat_node) # Reshape to [1, -1, 6] reshape_shape = numpy_helper.from_array(np.array([1, -1, 6], dtype=np.int64), name="reshape_shape") graph.initializer.append(reshape_shape) final_output_name = f"{concat_output_name}_batched" reshape_node = helper.make_node( "Reshape", inputs=[concat_output_name, "reshape_shape"], outputs=[final_output_name], name="AddBatchDimension", ) graph.node.append(reshape_node) # Get the shape of the reshaped tensor shape_node_name = f"{final_output_name}_shape" shape_node = helper.make_node( "Shape", inputs=[final_output_name], outputs=[shape_node_name], name="GetShapeDim", ) graph.node.append(shape_node) # Extract the second dimension dim_1_index = numpy_helper.from_array(np.array([1], dtype=np.int64), name="dim_1_index") graph.initializer.append(dim_1_index) second_dim_name = f"{final_output_name}_dim1" gather_node = helper.make_node( "Gather", inputs=[shape_node_name, "dim_1_index"], outputs=[second_dim_name], name="GatherSecondDim", ) graph.node.append(gather_node) # Subtract from 100 to determine how many values to pad target_size = numpy_helper.from_array(np.array([100], dtype=np.int64), name="target_size") graph.initializer.append(target_size) pad_size_name = f"{second_dim_name}_padsize" sub_node = helper.make_node( "Sub", inputs=["target_size", second_dim_name], outputs=[pad_size_name], name="CalculatePadSize", ) graph.node.append(sub_node) # Build the [2, 3] pad array: # 1st row -> [0, 0, 0] (no padding at the start of any dim) # 2nd row -> [0, pad_size, 0] (pad only at the end of the second dim) pad_starts = numpy_helper.from_array(np.array([0, 0, 0], dtype=np.int64), name="pad_starts") graph.initializer.append(pad_starts) zero_scalar = numpy_helper.from_array(np.array([0], dtype=np.int64), name="zero_scalar") graph.initializer.append(zero_scalar) pad_ends_name = "pad_ends" concat_pad_ends_node = helper.make_node( "Concat", inputs=["zero_scalar", pad_size_name, "zero_scalar"], outputs=[pad_ends_name], axis=0, name="ConcatPadEnds", ) graph.node.append(concat_pad_ends_node) pad_values_name = "pad_values" concat_pad_node = helper.make_node( "Concat", inputs=["pad_starts", pad_ends_name], outputs=[pad_values_name], axis=0, name="ConcatPadStartsEnds", ) graph.node.append(concat_pad_node) # Create Pad operator to pad with zeros pad_output_name = f"{final_output_name}_padded" pad_constant_value = numpy_helper.from_array( np.array([0.0], dtype=np.float32), name="pad_constant_value", ) graph.initializer.append(pad_constant_value) pad_node = helper.make_node( "Pad", inputs=[final_output_name, pad_values_name, "pad_constant_value"], outputs=[pad_output_name], mode="constant", name="PadToFixedSize", ) graph.node.append(pad_node) # Update the graph's final output to [1, 100, 6] new_output_type = onnx.helper.make_tensor_type_proto( elem_type=graph.output[0].type.tensor_type.elem_type, shape=[1, 100, 6] ) new_output = onnx.helper.make_value_info(name=pad_output_name, type_proto=new_output_type) # Replace the old output with the new one graph.output.pop() graph.output.extend([new_output]) # Save the modified model onnx.save(model, "yolov7-ultralytics.onnx") -
その後、変更したONNXモデルを読み込み、Ultralyticsで通常どおり推論を実行できます。
from ultralytics import ASSETS, YOLO

model = YOLO("yolov7-ultralytics.onnx", task="detect")

results = model(ASSETS / "bus.jpg")
TensorRTエクスポート#
-
ONNXエクスポートセクションの手順1~2に従います。
-
TensorRTPythonパッケージをインストールします。pip install tensorrt -
次のスクリプトを実行して、変更したONNXモデルをTensorRTエンジンに変換します。
from ultralytics.utils.export import onnx2engine onnx2engine("yolov7-ultralytics.onnx", quantize=16) -
Ultralyticsでモデルを読み込み、実行します。
from ultralytics import ASSETS, YOLO

model = YOLO("yolov7-ultralytics.engine", task="detect")

results = model(ASSETS / "bus.jpg")
引用と謝辞#
リアルタイム物体検出の分野に多大な貢献をされたYOLOv7の著者の皆様に謝意を表します。
@inproceedings{wang2023yolov7,
  title={YOLOv7: Trainable Bag-of-Freebies Sets New State-of-the-Art for Real-Time Object Detectors},
  author={Wang, Chien-Yao and Bochkovskiy, Alexey and Liao, Hong-Yuan Mark},
  booktitle={Proceedings of the IEEE/CVF conference on Computer Vision and Pattern Recognition (CVPR)},
  pages={7464--7475},
  year={2023}
}YOLOv7の公式論文はCVF 2023 Open Accessで公開され、arXivにはプレプリントが掲載されています。著者らは研究成果を一般公開しており、コードベースはGitHubで利用できます。分野の発展に貢献し、研究成果をより広いコミュニティに公開された著者らの取り組みに感謝します。
FAQ#
2022年7月にリリースされたYOLOv7は、リリース当時、優れた速度と精度を達成した重要なリアルタイム物体検出モデルでした。パラメーター使用量と推論速度の両面で、YOLOX、YOLOv5、PPYOLOEなどの同時代のモデルを上回りました。YOLOv7の特徴的な機能には、推論コストを増加させずに性能を最適化するモデルの再パラメーター化と動的ラベル割り当てがあります。アーキテクチャや他の最先端物体検出器との比較指標について詳しくは、YOLOv7論文を参照してください。
YOLOv7は、モデルの再パラメーター化や動的ラベル割り当てなど、学習プロセスを強化して推論精度を向上させる複数の革新を導入しています。YOLOv5と比較して、YOLOv7は速度と精度を大幅に向上させています。たとえば、YOLOv7-XはYOLOv5-Xと比較して精度を2.2%向上させ、パラメーターを22%削減しています。詳細な比較については、性能表のYOLOv7とSOTA物体検出器の比較を参照してください。
現時点で、UltralyticsはYOLOv7のONNXおよびTensorRT推論のみをサポートしています。YOLOv7のONNXおよびTensorRTエクスポート版をUltralyticsで実行するには、使用例セクションを確認してください。
カスタムYOLOv7モデルをインストールして学習するには、次の手順に従います。
-
YOLOv7リポジトリをクローンします。
git clone https://github.com/WongKinYiu/yolov7 -
クローンしたディレクトリに移動し、依存関係をインストールします。
cd yolov7 pip install -r requirements.txt -
データセットを準備し、リポジトリに記載された使用手順に従ってモデルパラメーターを設定します。 詳細なガイダンスについては、YOLOv7 GitHubリポジトリで最新情報と更新を確認してください。
-
学習後、使用例に示すように、Ultralyticsで使用するためにモデルをONNXまたはTensorRTへエクスポートできます。
-
YOLOv7は、リアルタイム物体検出に革新をもたらす複数の主要機能を提供します。
- モデルの再パラメーター化: 勾配伝播パスを最適化することで、モデルの性能を向上させます。
- 動的ラベル割り当て: coarse-to-fine lead guided手法を使用して、異なるブランチにまたがる出力に動的ターゲットを割り当て、精度を向上させます。
- 拡張スケーリングと複合スケーリング: さまざまなリアルタイムアプリケーション向けにモデルをスケールする際、パラメーターと計算量を効率的に活用します。
- 効率性: 他の最先端モデルと比較してパラメーター数を40%、計算量を50%削減しながら、より高速な推論速度を実現します。
これらの機能の詳細については、YOLOv7概要セクションを参照してください。