Implante o YOLO26 em dispositivos móveis e de borda com ExecuTorch#
A implantação de modelos de visão computacional em dispositivos de borda, como smartphones, tablets e sistemas embarcados, exige um runtime otimizado que equilibre desempenho e limitações de recursos. O ExecuTorch, a solução da PyTorch para computação de borda, permite a inferência eficiente no dispositivo para modelos Ultralytics YOLO.
Este guia explica como exportar modelos Ultralytics YOLO para o formato ExecuTorch, permitindo implantá-los em dispositivos móveis e de borda com desempenho otimizado.
Por que exportar para ExecuTorch?#
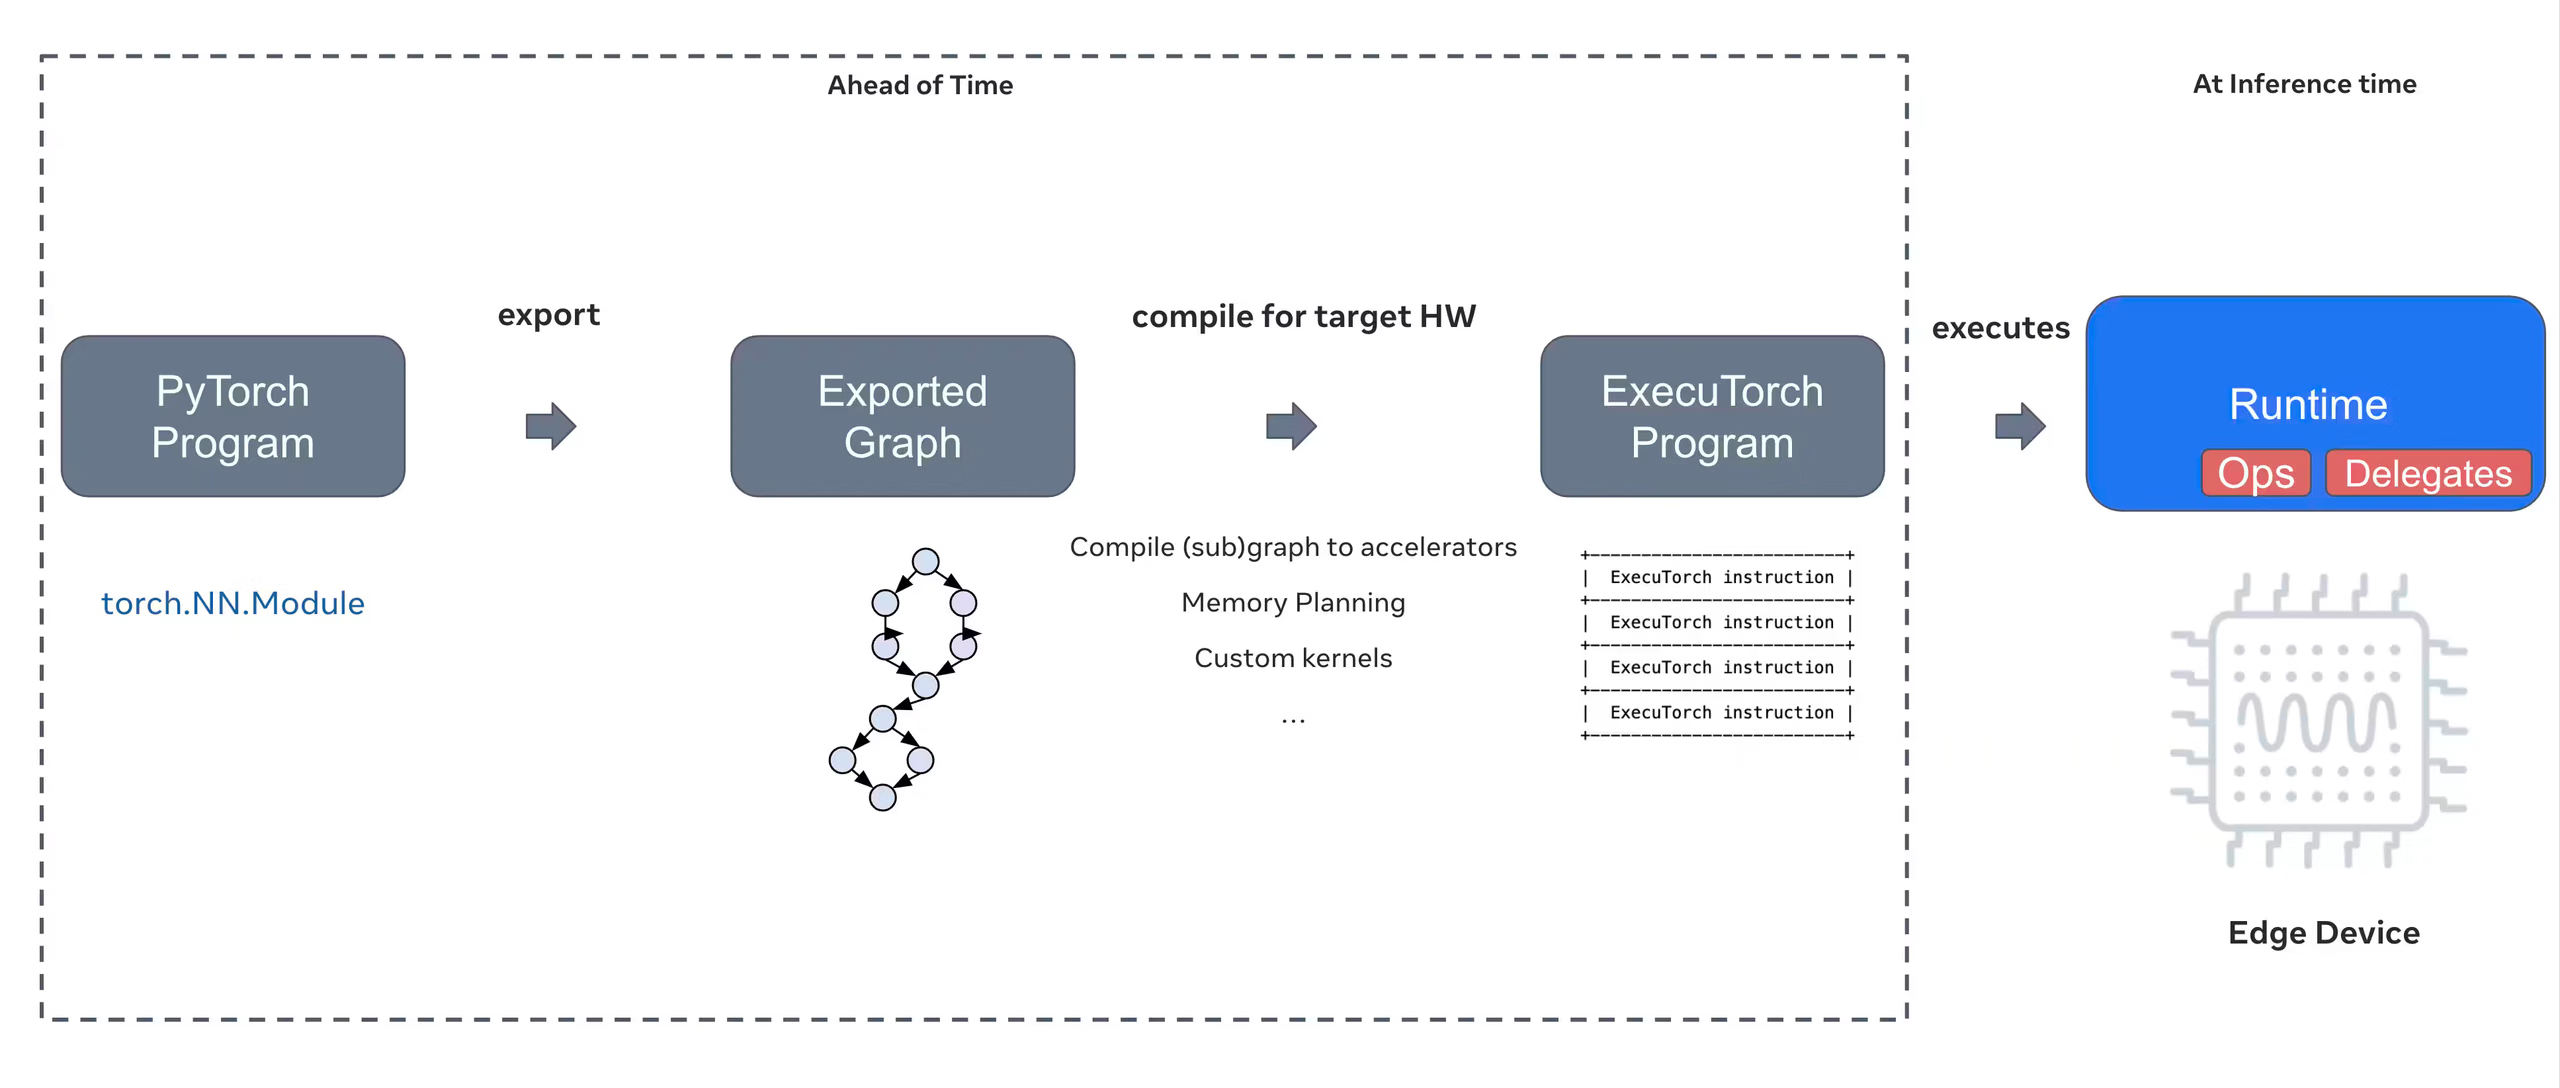
O ExecuTorch é a solução completa da PyTorch para habilitar recursos de inferência no dispositivo em dispositivos móveis e de borda. Desenvolvido para ser portátil e eficiente, o ExecuTorch pode executar programas PyTorch em uma ampla variedade de plataformas computacionais.
Principais recursos do ExecuTorch#
O ExecuTorch oferece vários recursos poderosos para implantar modelos Ultralytics YOLO em dispositivos de borda:
-
Formato de modelo portátil: o ExecuTorch usa o formato
.pte(PyTorch ExecuTorch), otimizado para tamanho e velocidade de carregamento em dispositivos com recursos limitados. -
Backend XNNPACK: a integração padrão com XNNPACK oferece inferência altamente otimizada em CPUs móveis, com excelente desempenho sem exigir hardware especializado.
-
Pronto para quantização: o ecossistema ExecuTorch oferece suporte a técnicas de quantização para reduzir o tamanho do modelo e melhorar a velocidade de inferência; atualmente, a Ultralytics exporta modelos FP32 pelo backend XNNPACK.
-
Eficiência de memória: o gerenciamento de memória otimizado reduz o uso de memória durante a execução, tornando o ExecuTorch adequado para dispositivos com RAM limitada.
-
Metadados do modelo: os modelos exportados incluem metadados (tamanho da imagem, nomes das classes etc.) em um arquivo YAML separado para facilitar a integração.
Opções de implantação com ExecuTorch#
Os modelos ExecuTorch podem ser implantados em várias plataformas móveis e de borda:
-
Aplicativos móveis: implante em aplicativos iOS e Android com desempenho nativo, permitindo a detecção de objetos em tempo real em aplicativos móveis.
-
Sistemas embarcados: execute em dispositivos Linux embarcados, como Raspberry Pi, NVIDIA Jetson e outros sistemas baseados em ARM, com desempenho otimizado.
-
Dispositivos de IA de borda: implante em hardware especializado de IA de borda com delegados personalizados para acelerar a inferência.
-
Dispositivos de IoT: integre a dispositivos de IoT para realizar inferência no dispositivo sem depender de conectividade com a nuvem.
Tarefas suportadas#
A exportação para ExecuTorch oferece suporte a todas as sete tarefas da Ultralytics. A segmentação semântica e a estimativa de profundidade estão disponíveis apenas no YOLO26, a única família que inclui essas cabeças de saída.
| Tarefa | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Detetar | ✅ | ✅ | ✅ |
| Segmentar | ✅ | ✅ | ✅ |
| Semântica | ❌ | ❌ | ✅ |
| Profundidade | ❌ | ❌ | ✅ |
| Classificar | ✅ | ✅ | ✅ |
| Pose | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Exportando modelos Ultralytics YOLO26 para ExecuTorch#
Converter modelos Ultralytics YOLO26 para o formato ExecuTorch permite implantá-los com eficiência em dispositivos móveis e de borda.
Instalação#
A exportação do ExecuTorch requer Python 3.10–3.14 e PyTorch >= 2.9.0. O Ultralytics instala um pacote executorch compatível quando você exporta ou carrega um modelo ExecuTorch, fixado em executorch<1.5 nas versões do PyTorch anteriores à 2.13; portanto, não o atualize manualmente.
# Install Ultralytics package
pip install ultralytics
Para obter instruções detalhadas e práticas recomendadas sobre o processo de instalação, consulte nosso guia de instalação do YOLO26. Se encontrar dificuldades ao instalar os pacotes necessários para o YOLO26, consulte nosso guia de problemas comuns para encontrar soluções e dicas.
Uso#
Exportar modelos YOLO26 para ExecuTorch é simples:
O formato ExecuTorch oferece suporte aos modos Export, Predict e Validate. Exporte seu modelo e, em seguida, carregue o modelo exportado para executar a inferência ou validar sua precisão.
from ultralytics import YOLO

# Carrega um modelo YOLO26
model = YOLO("yolo26n.pt")

# Exporte o modelo para o formato ExecuTorch
model.export(format="executorch") # creates 'yolo26n_executorch_model'from ultralytics import YOLO
# Carregue o modelo ExecuTorch exportado
model = YOLO("yolo26n_executorch_model")
# Executar inferência
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Carregue o modelo ExecuTorch exportado
model = YOLO("yolo26n_executorch_model")
# Validar a precisão no conjunto de dados COCO8
metrics = model.val(data="coco8.yaml")As exportações para ExecuTorch geram um diretório que inclui um arquivo .pte e metadados. Use o runtime ExecuTorch no seu aplicativo móvel ou embarcado para carregar o modelo .pte e realizar inferência.
Argumentos de exportação#
Ao exportar para o formato ExecuTorch, você pode especificar os seguintes argumentos:
| Argumento | Tipo | Padrão | Descrição |
|---|---|---|---|
format | str | 'executorch' | Formato de destino do modelo exportado, que define a compatibilidade com vários ambientes de implantação. |
imgsz | int ou tuple | 640 | Tamanho de imagem desejado para a entrada do modelo. Pode ser um inteiro para imagens quadradas ou uma tupla (height, width) para dimensões específicas. |
quantize | int ou str | None | Exportação FP32 fixa. A exportação para ExecuTorch não oferece suporte à conversão de precisão para FP16, INT8 ou W8A16 durante a exportação. |
batch | int | 1 | Especifica o tamanho do lote de inferência do modelo exportado ou o número máximo de imagens que o modelo exportado processará em simultâneo no modo predict. |
device | str | None | Especifica o dispositivo para exportação: GPU (device=0), CPU (device=cpu), MPS para Apple Silicon (device=mps). |
Estrutura de saída#
A exportação para ExecuTorch cria um diretório que contém o modelo e os metadados:
yolo26n_executorch_model/
├── model.pte               # ExecuTorch model file
└── metadata.yaml           # Model metadata (classes, image size, etc.)
Usando modelos ExecuTorch exportados#
Após exportar seu modelo, você precisará integrá-lo ao aplicativo de destino usando o runtime ExecuTorch.
Integração móvel#
Para aplicativos móveis (iOS/Android), você precisará:
- Adicione o runtime ExecuTorch: inclua a biblioteca de runtime ExecuTorch no seu projeto móvel
- Carregue o modelo: carregue o arquivo
.pteno seu aplicativo - Execute a inferência: processe imagens e obtenha previsões
iOS#
Exemplo de integração com iOS (Objective-C/C++):
// iOS uses C++ APIs for model loading and inference
// See https://pytorch.org/executorch/stable/using-executorch-ios.html for complete examples

#include <executorch/extension/module/module.h>

using namespace ::executorch::extension;

// Load the model
Module module("/path/to/model.pte");

// Create input tensor
float input[1 * 3 * 640 * 640];
auto tensor = from_blob(input, {1, 3, 640, 640});

// Run inference
const auto result = module.forward(tensor);Android#
Adiciona o ExecuTorch Android AAR do Maven Central:
dependencies {
    implementation("org.pytorch:executorch-android:<version>")
}
Exemplo de integração com Android (Kotlin):
import org.pytorch.executorch.EValue
import org.pytorch.executorch.Module
import org.pytorch.executorch.Tensor

// Load the model
val module = Module.load("/path/to/model.pte")

// Prepare input tensor
val inputTensor = Tensor.fromBlob(floatData, longArrayOf(1, 3, 640, 640))
val inputEValue = EValue.from(inputTensor)

// Run inference
val outputs = module.forward(inputEValue)
val scores = outputs[0].toTensor().dataAsFloatArray
Linux embarcado#
Para sistemas Linux embarcados, usa a API C++ do ExecuTorch:
#include <executorch/extension/module/module.h>
#include <executorch/extension/tensor/tensor.h>

using namespace ::executorch::extension;

// Load model
Module module("model.pte");

// Prepare input
std::vector<float> input_data = preprocessImage(image);
auto input_tensor = from_blob(input_data.data(), {1, 3, 640, 640});

// Run inference
const auto outputs = module.forward(input_tensor);
Para mais detalhes sobre a integração do ExecuTorch nas tuas aplicações, consulta a Documentação do ExecuTorch.
Otimização do desempenho#
Otimização do tamanho do modelo#
Para reduzir o tamanho do modelo para implantação:
- Usa modelos menores: começa com YOLO26n (nano) para obter o menor tamanho possível
- Reduz a resolução de entrada: usa imagens menores (por exemplo,
imgsz=320ouimgsz=416) - Quantização: aplica técnicas de quantização do ExecuTorch fora do Ultralytics (a exportação do Ultralytics ExecuTorch só é compatível com FP32)
Otimização da velocidade de inferência#
Para uma inferência mais rápida:
- Backend XNNPACK: o backend XNNPACK predefinido oferece inferência otimizada na CPU
- Aceleração por hardware: usa delegados específicos da plataforma (por exemplo, CoreML para iOS)
- Processamento em lote: processa várias imagens sempre que possível
Benchmarks#
A equipa Ultralytics comparou a velocidade e a precisão dos modelos YOLO26 entre PyTorch e ExecuTorch.
| Modelo | Formato | Status | Tamanho (MB) | metrics/mAP50-95(B) | Tempo de inferência (ms/im) |
|---|---|---|---|---|---|
| YOLO26n | PyTorch | ✅ | 5.3 | 0.4790 | 314.80 |
| YOLO26n | ExecuTorch | ✅ | 9.4 | 0.4800 | 142 |
| YOLO26s | PyTorch | ✅ | 19.5 | 0.5730 | 930.90 |
| YOLO26s | ExecuTorch | ✅ | 36.5 | 0.5780 | 376.1 |
O tempo de inferência não inclui o pré/pós-processamento.
Solução de problemas#
Problemas comuns#
Problema: Python version error
Solução: o ExecuTorch requer Python 3.10 a 3.14. Crie um ambiente com uma versão compatível:
# Using conda
conda create -n executorch python=3.14
conda activate executorch
Para obter mais ajuda na resolução de problemas, visita os problemas do Ultralytics no GitHub ou a Documentação do ExecuTorch.
Resumo#
Exportar modelos YOLO26 para o formato ExecuTorch permite uma implantação eficiente em dispositivos móveis e de borda. Com integração nativa com PyTorch, suporte multiplataforma e desempenho otimizado, o ExecuTorch é uma excelente opção para aplicações de IA de borda.
Principais conclusões:
- O ExecuTorch oferece implantação de borda nativa do PyTorch com excelente desempenho
- A exportação é simples com o parâmetro
format='executorch' - Os modelos são otimizados para CPUs móveis através do backend XNNPACK
- Compatível com as plataformas iOS, Android e Linux embarcado
- Requer Python 3.10–3.14 e PyTorch >= 2.9.0
Perguntas frequentes#
Exporta um modelo YOLO26 para ExecuTorch usando Python ou CLI:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(format="executorch")
ou
yolo export model=yolo26n.pt format=executorchA exportação com ExecuTorch requer:
- Python 3.10 a 3.14
- O pacote
executorch, instalado automaticamente (executorch<1.5em versões do PyTorch anteriores à 2.13, que não são compatíveis com os runtimes mais recentes do ExecuTorch) - PyTorch (instalado automaticamente com o ultralytics)
Nota: o pacote
executorchinclui wheels pré-compilados (com o backend XNNPACK), por isso não é necessário nenhum passo adicional de compilação durante a exportação.Os modelos ExecuTorch podem ser carregados diretamente com
YOLO()para inferência e validação em Python (consulta os exemplos de previsão/validação acima) e também podem ser implantados em dispositivos móveis e de borda usando as bibliotecas de runtime do ExecuTorch.O ExecuTorch é compatível com:
- Dispositivos móveis: iOS e Android
- Linux embarcado: Raspberry Pi, NVIDIA Jetson e outros dispositivos ARM
- Computadores: Linux, macOS e Windows (para desenvolvimento)
Tanto o ExecuTorch como o LiteRT são excelentes para implantação em dispositivos móveis:
- ExecuTorch: melhor integração com PyTorch, fluxo de trabalho nativo do PyTorch e ecossistema em expansão
- LiteRT: mais consolidado, maior suporte a hardware, mais exemplos de implantação e executa o mesmo modelo em Android, iOS e no navegador
Escolhe o ExecuTorch se já usas PyTorch e queres um caminho de implantação nativo. Escolhe o LiteRT para obter a máxima compatibilidade e ferramentas consolidadas.
Sim! O ExecuTorch é compatível com aceleração por hardware através de vários backends:
- GPU móvel: através de delegados Vulkan, Metal ou OpenCL
- NPU/DSP: através de delegados específicos da plataforma
- Predefinido: XNNPACK para inferência otimizada na CPU
Consulta a Documentação do ExecuTorch para ver a configuração específica de cada backend.