Exportação ONNX para modelos YOLO26
ONNX (Intercâmbio Aberto de Redes Neurais) é um formato aberto de modelo que a maioria dos ambientes de inferência consegue carregar. Exportar um modelo Ultralytics YOLO26 com format="onnx" cria um único arquivo .onnx que funciona com o ONNX Runtime em CPUs, GPUs NVIDIA e AMD, Apple silicon e dispositivos Windows.
Visão geral#
| Propriedade | Detalhes |
|---|---|
Argumento format | onnx |
| Saída | yolo26n.onnx, um arquivo com os nomes das classes, a tarefa e o tamanho da imagem armazenados como metadados; yolo26n_int8.onnx para uma exportação quantize=8 calibrada |
| Funciona em | CPUs, GPUs NVIDIA (CUDA), GPUs AMD (MIGraphX), Apple silicon (provedor de execução Core ML) e dispositivos Windows ML |
| Ambiente de execução | ONNX Runtime ou OpenCV DNN com dnn=True |
| Precisão | FP32, FP16, INT8. O YOLO26n tem 9,9 MB em FP32, 5,0 MB em FP16 e 3,1 MB em INT8 |
| Máquina de exportação | Linux, macOS ou Windows, com ou sem GPU |
A Plataforma Ultralytics pode exportar um modelo treinado para ONNX para você, sem que seja necessário configurar um ambiente de exportação local.
Início rápido#
Instale o pacote Ultralytics. Na primeira exportação, os pacotes onnx, onnxslim e onnxruntime são instalados, se estiverem ausentes (onnxruntime-gpu quando você exporta com device=0 em uma GPU NVIDIA).
pip install ultralyticsPara conhecer outros métodos de instalação, consulte o guia de instalação. Em seguida, exporte seu modelo e carregue o arquivo exportado para executar inferências ou validar a precisão.
from ultralytics import YOLO

# Carrega um modelo YOLO26
model = YOLO("yolo26n.pt")

# Exporta o modelo para o formato ONNX
model.export(format="onnx")  # cria 'yolo26n.onnx'

# Exporta um modelo ONNX quantizado em INT8 com dados de calibração
model.export(format="onnx", quantize=8, data="coco8.yaml") # cria 'yolo26n_int8.onnx'from ultralytics import YOLO
# Carrega o modelo ONNX exportado
model = YOLO("yolo26n.onnx")
# Executar inferência
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Carrega o modelo ONNX exportado
model = YOLO("yolo26n.onnx")
# Validar a precisão no conjunto de dados COCO8
metrics = model.val(data="coco8.yaml")Tarefas suportadas#
A exportação ONNX é compatível com todas as sete tarefas da Ultralytics nos modelos YOLOv8, YOLO11 e YOLO26: detecção, segmentação, segmentação semântica, estimativa de profundidade, classificação, estimativa de pose e OBB. A segmentação semântica e a estimativa de profundidade estão disponíveis apenas no YOLO26, a única família que inclui essas cabeças.
Argumentos de exportação#
| Argumento | Tipo | Padrão | Descrição |
|---|---|---|---|
format | str | 'onnx' | Formato de destino do modelo exportado, que define a compatibilidade com vários ambientes de implantação. |
imgsz | int ou tuple | 640 | Tamanho da imagem de entrada do modelo: um inteiro para imagens quadradas ou uma tupla (height, width). Se não for informado, a exportação usa o tamanho com que o checkpoint foi treinado. Os checkpoints oficiais do YOLO26 usam 640 para detecção, segmentação, pose e modelos semânticos pré-treinados no ADE20K, 1024 para OBB e modelos semânticos pré-treinados no Cityscapes, 768 para profundidade e 224 para classificação. |
quantize | int ou str | None | Precisão da quantização: 16 (FP16; uma exportação para CPU mantém as entradas e saídas em FP32, enquanto uma exportação para GPU também as converte para FP16) ou 8 (quantização estática INT8 com o ONNX Runtime, usando imagens de calibração de data e gerando um modelo _int8.onnx); 32/não definido usa FP32. Um checkpoint treinado com quantize=8 é exportado em INT8 com quantize não definido ou como 8 (outros valores geram um erro), usando nós Q/DQ com os intervalos que o checkpoint contém, sem calibração e com o nome simples .onnx. Substitui as flags obsoletas half/int8. |
data | str | None | YAML do conjunto de dados usado para a calibração INT8; para classificação, em vez disso, é necessário um diretório de conjunto de dados ou o nome de um conjunto de dados integrado. Se for omitido com quantize=8, a Ultralytics seleciona o conjunto de dados de calibração padrão para a tarefa do modelo; um checkpoint treinado com quantize=8 não precisa de calibração. |
fraction | float, int ou list | 1.0 | Subconjunto de calibração como proporção, número de imagens ou proporções/contagens [train, val, test]. Listas de dois itens deixam test completo, enquanto 0 o ignora. |
dynamic | bool | False | Torna dinâmicos os eixos de lote, altura e largura da entrada, permitindo que um único arquivo aceite diferentes tamanhos de lote (até o valor de exportação batch com nms=True) e tamanhos de imagem. Consulte a exportação dinâmica. |
simplify | bool | True | Simplifica o grafo do modelo com onnxslim. |
opset | int | None | Especifica a versão do opset ONNX para garantir a compatibilidade com diferentes parsers e ambientes de execução ONNX. Se não for definida, usa o opset 18 (um valor inferior no PyTorch < 2.4), limitado à versão onnx instalada. Consulte o opset mínimo. |
nms | bool, opcional | None | Seleciona a saída bruta (None, padrão), NMS integrado (True) ou a cabeça sem NMS (False). Consulte o formato de saída. |
batch | int | 1 | Tamanho do lote do modelo exportado. Em uma exportação estática, esse tamanho de lote fica fixo na forma da entrada. Com dynamic=True e nms=True, defina o maior tamanho de lote que você pretende usar. |
device | str | None | Dispositivo usado para exportar: cpu (o padrão, também em uma máquina com GPU), 0 para uma GPU CUDA ou mps para Apple silicon. Isso só altera o resultado de quantize=16; consulte Entradas FP16. |
Para consultar os argumentos compartilhados por todos os formatos, veja a documentação do modo de exportação.
Quantização INT8#
Para checkpoints que não foram treinados com treinamento com quantização consciente, quantize=8 aplica quantização estática do ONNX Runtime somente aos nós Conv, Gemm e MatMul. Todos os outros nós permanecem em ponto flutuante, incluindo as operações que montam output0: as coordenadas das caixas (em pixels) e as pontuações das classes (de 0 a 1) compartilham esse tensor, então uma única escala INT8 para ele arredondaria todas as pontuações das classes para zero. Os pesos são quantizados por canal a partir do opset 13. Exclua os mesmos nós e defina per_channel=True se você executar quantize_static por conta própria em um modelo exportado em FP32:
import onnx
from onnxruntime.quantization import quantize_static

model = "yolo26n.onnx"
exclude = [n.name for n in onnx.load(model).graph.node if n.op_type not in {"Conv", "Gemm", "MatMul"}]
quantize_static(model, "yolo26n_int8.onnx", calibration_reader, nodes_to_exclude=exclude, per_channel=True)
Aqui, calibration_reader é um onnxruntime.quantization.CalibrationDataReader que gera {"images": array} com o tamanho de lote do modelo, pré-processado como na inferência: com letterbox para o tamanho de exportação (redimensionado e cortado ao centro para classificação), RGB, NCHW, float32 entre 0 e 1.
Um modelo INT8 mantém os tipos de entrada e saída do modelo FP32, portanto, o código de inferência escrito para o modelo FP32 funciona sem alterações. O INT8 gera um arquivo de três a quatro vezes menor que o FP32, mas apresentou velocidade inferior à do FP32 com o ONNX Runtime na GPU e na CPU nos benchmarks. Meça a latência no hardware de destino antes de escolher uma precisão.
Formato de saída#
O modelo exportado recebe uma entrada chamada images, com forma (batch, 3, height, width), no formato RGB e com valores entre 0 e 1. A entrada é float32, exceto nas exportações para GPU feitas com quantize=16, que recebem float16. O argumento nms define o layout de output0. As formas abaixo correspondem a um modelo de detecção YOLO26n com 80 classes, exportado em imgsz=640:
nms | Forma de output0 | Conteúdo |
|---|---|---|
None (padrão) | (1, 84, 8400) | Para cada uma das 8400 âncoras: centro x da caixa, centro y, largura e altura em pixels da entrada, seguidos por 80 pontuações de classe. Aplique NMS por conta própria. |
True | (1, 300, 6) | A NMS é executada dentro do modelo. Cada linha tem o formato x1, y1, x2, y2, score, class; as linhas após a última detecção contêm zeros. |
False | (1, 300, 6) | Cabeça sem NMS. Cada linha tem o formato x1, y1, x2, y2, score, class, sem etapa de NMS. Filtre as linhas por pontuação por conta própria. |
As outras tarefas usam a mesma entrada e estas saídas. As formas correspondem aos checkpoints oficiais YOLO26n no tamanho de exportação padrão, usando o checkpoint Cityscapes yolo26n-sem.pt para segmentação semântica:
| Tarefa | imgsz padrão | Saída com nms=None | Saída com nms=False ou nms=True |
|---|---|---|---|
| Detecção | 640 | output0 (1, 84, 8400) | output0 (1, 300, 6) |
| Segmentação | 640 | output0 (1, 116, 8400), output1 (1, 32, 160, 160) | output0 (1, 300, 38), output1 (1, 32, 160, 160) |
| Semântica | 1024 | output0 (1, 1024, 1024), uint8 índice da classe de cada pixel | Igual a nms=None |
| Profundidade | 768 | output0 (1, 1, 768, 768), mapa de profundidade | Igual a nms=None |
| Classificação | 224 | output0 (1, 1000), probabilidades de classe após softmax | Igual a nms=None para nms=False; nms=True gera um erro |
| Pose | 640 | output0 (1, 56, 8400) | output0 (1, 300, 57): 6 valores da caixa, seguidos por 17 pontos-chave x 3 |
| OBB | 1024 | output0 (1, 20, 21504) | output0 (1, 300, 7): center x, center y, width, height, score, class, angle (radianos) |
As linhas de segmentação contêm 32 coeficientes de máscara após os valores da caixa, e output1 armazena os protótipos da máscara. Nos modelos FP32 e INT8, todas as saídas são float32, exceto o mapa de classes semântico.
Com nms=True, o limite de confiança conf (padrão 0.25), o limite de IoU iou (padrão 0.5), agnostic_nms e max_det (padrão 300) ficam fixos no grafo durante a exportação. Um valor menor de conf no momento da predição não recupera as detecções que o grafo já removeu; portanto, exporte novamente para alterar esses valores. max_det e agnostic_nms também se aplicam a nms=False: max_det=100 gera a forma (1, 100, 6) de output0.
YOLO("yolo26n.onnx") lê o layout dos metadados do arquivo; portanto, você só precisa dessas formas ao executar o modelo no seu próprio código. Os metadados também estão disponíveis no seu código como strings: names, task, imgsz, stride, batch, end2end e args.
import ast

import onnxruntime as ort

meta = ort.InferenceSession("yolo26n.onnx").get_modelmeta().custom_metadata_map
names = ast.literal_eval(meta["names"])  # {0: 'person', 1: 'bicycle', ...}
imgsz = ast.literal_eval(meta["imgsz"]) # [640, 640]Implantar#
YOLO("yolo26n.onnx") executa o modelo com o ONNX Runtime e seleciona o provedor de execução com base no argumento device. Em uma máquina com GPU CUDA, a GPU é usada quando device não está definido.
device | Provedor de execução |
|---|---|
cpu | CPUExecutionProvider |
0 em uma GPU NVIDIA | CUDAExecutionProvider, do pacote onnxruntime-gpu, instalado no primeiro uso |
0 em uma GPU AMD ROCm | MIGraphXExecutionProvider; consulte Inferência em GPU AMD com MIGraphX |
mps em Apple silicon | CoreMLExecutionProvider para nós com formas estáticas; nós com formas dinâmicas são executados em CPUExecutionProvider |
A linha de registro Using ONNX Runtime 1.31.1 with CUDAExecutionProvider indica qual provedor está ativo. O comportamento durante a inferência depende de como o modelo foi exportado:
- Exportação estática (padrão): o modelo é sempre executado com o tamanho de exportação
imgszebatch, que a Ultralytics lê dos metadados do arquivo. Umimgszpassado parapredicté ignorado. Lotes maiores são divididos em partes do tamanho do lote de exportação, e lotes menores são preenchidos; assim, funciona qualquer número de imagens. - Exportação dinâmica (
dynamic=True):predictaceita qualquerimgszque seja múltiplo do stride do modelo. O tamanho do lote pode variar, mas comnms=Trueele é limitado ao valorbatchusado na exportação; portanto, defina esse valor como o maior tamanho de lote que você pretende usar. - Memória da GPU: com
CUDAExecutionProvider, um modelo estático usa o vínculo de E/S do ONNX Runtime, que mantém os tensores de entrada e saída na GPU. Um modelo dinâmico copia os tensores pela memória da CPU a cada chamada. - Threads da CPU: a Ultralytics limita o ONNX Runtime a 8 threads intra-op ou ao número de núcleos físicos da CPU disponíveis para o processo, se for menor. Defina a variável de ambiente
ORT_INTRA_OP_NUM_THREADSpara usar outro número.
Passe dnn=True para predict ou val para executar o modelo na CPU com OpenCV DNN em vez do ONNX Runtime. O OpenCV DNN é compatível com menos opções de exportação; consulte Limitações e solução de problemas.
Para executar o modelo fora do pacote Ultralytics, consulte estes recursos:
- API Python do ONNX Runtime: carregue e execute um modelo ONNX em Python.
- Provedores de execução do ONNX Runtime: backends de hardware como CUDA, TensorRT, OpenVINO, Core ML e DirectML.
- Exemplos da Ultralytics: inferência com o ONNX Runtime em Python, C++ e Rust, além de inferência com OpenCV DNN em Python.
- Triton Inference Server: disponibilize o modelo ONNX por HTTP ou gRPC com o NVIDIA Triton.
- Implantação em dispositivos de borda: tutoriais do ONNX Runtime para IoT e hardware de borda.
Inferência do Windows ML#
No Windows 11 24H2 (build 26100) ou posterior, com Python 3.10+, podes instalar onnxruntime-windowsml num ambiente separado para permitir que o Windows ML selecione provedores de execução para o teu hardware. Instala-o em vez de outras versões do ONNX Runtime e, em seguida, usa o mesmo modelo exportado .onnx com YOLO("model.onnx"). O backend preserva o número de threads do PyTorch e as opções de sessão fornecidas, incluindo uma política explícita de provedores. Sem uma política fornecida, o Windows ML seleciona o hardware para obter o máximo desempenho, mesmo quando o dispositivo do PyTorch é cpu. Mede a latência de previsão no teu dispositivo antes de escolheres este runtime; é opcional e não é instalado por predefinição.
Em GPUs integradas que partilham energia com a CPU, as threads inativas do PyTorch no pré-processamento e no pós-processamento podem tornar a inferência do Windows ML mais lenta. Chama torch.set_num_threads(1) antes de fazer previsões para reduzir este efeito. A alteração aplica-se a todo o processo, pelo que outros modelos PyTorch nesse processo também são executados com uma única thread.
import torch

from ultralytics import YOLO

torch.set_num_threads(1)  # opcional; mede no teu dispositivo
results = YOLO("yolo26n.onnx")("https://ultralytics.com/images/bus.jpg")
Inferência em GPU AMD com MIGraphX#
A Ultralytics executa modelos ONNX exportados em GPUs AMD por meio do provedor de execução MIGraphX do ONNX Runtime. Em um sistema ROCm (HIP) com Python 3.11 ou posterior em x86-64, o backend ONNX instala o plug-in onnxruntime-ep-migraphx no primeiro uso e seleciona automaticamente MIGraphXExecutionProvider, sem alterações no código; todas as tarefas do YOLO26 são compatíveis. Consulte o guia de inferência em GPU AMD para ver os pré-requisitos, a instalação, o uso, os benchmarks e o cache de programas compilados.
Limitações e solução de problemas#
- Opset mínimo: a exportação falha com
ONNX export requires opset>=Nquandoopseté baixo demais para o modelo. O mínimo é7para classificação,9para detecção, segmentação, segmentação semântica, pose e OBB,11para estimativa de profundidade e para modelos de detecção, segmentação, pose e OBB exportados comnms=True, e16para RT-DETR. - Entradas FP16: um modelo FP16 exportado em uma GPU (
quantize=16 device=0) espera tensores de entrada FP16 no seu próprio código. Um modelo FP16 exportado em uma CPU mantém as entradas e saídas FP32 e faz a conversão dentro do grafo.YOLO()fornece o tipo de entrada correto para ambos, na GPU e na CPU. - Nome do arquivo INT8:
quantize=8gravayolo26n_int8.onnxe remove o arquivo FP32 intermediário; portanto, carregue o arquivo_int8para inferência. A exceção é um checkpoint treinado comquantize=8: sua exportação grava nós Q/DQ emyolo26n.onnxe ignora a calibração. - Tamanho do conjunto de calibração INT8: para um checkpoint não treinado com
quantize=8, a exportação exibe um aviso quando a divisão de calibração tem menos de 300 imagens. Por padrão, a calibração usa a divisãoval, ecoco8.yamltem apenas 4 imagens de validação; por isso, use seu próprio conjunto de dados para um modelo que pretende implantar. - NMS integrado:
nms=Truerequer PyTorch 1.13 ou posterior. Gera'nms=True' is not valid for classification modelspara classificação e é ignorado com um aviso em modelos de segmentação semântica, estimativa de profundidade e RT-DETR. - Cabeça sem NMS:
nms=Falserequer um modelo com cabeça sem NMS, como YOLO26 ou YOLOv10. Para outros modelos, por exemplo, YOLO11, a exportação exibe o avisoThis model has no one-to-one head; using one-to-many outputse grava a saída bruta(1, 84, 8400). - GPU não utilizada: se o registro mostrar
CUDA requested but CUDAExecutionProvider not available. Using CPU..., a compilação instalada do ONNX Runtime não tem um provedor CUDA funcional. Instaleonnxruntime-gpuem vez deonnxruntimee confirme que as versões de CUDA e cuDNN correspondem às do seu sistema. - OpenCV DNN: com o OpenCV 4.14.0,
dnn=Trueexecuta modelos padrão,nms=False, INT8 e FP16 exportados para GPU. Não consegue carregar modelos exportados comnms=True, comdynamic=Trueou comquantize=16na CPU. - Formas dinâmicas com NMS: ao combinar
dynamic=Truecomnms=True, defina tambémbatchcomo o maior tamanho de lote que você pretende usar. A exportação exibe um aviso sebatchpermanecer como1. - Simplificação do grafo: se
onnxslimfalhar, a exportação registra um aviso e salva o modelo sem simplificação. - Versão do IR: o exportador limita a versão do IR ONNX a 10 para que versões mais antigas do ONNX Runtime consigam carregar o arquivo. Uma exportação padrão com opset 18 tem versão IR 8.
Para outros erros, consulte o guia de problemas comuns.
Benchmarks#
O YOLO26n é até 43% mais rápido que o YOLO11n com o ONNX Runtime na CPU (Intel Xeon CPU @ 2.00 GHz). A página do modelo YOLO26 lista a velocidade ONNX na CPU de cada modelo para todas as tarefas, exceto segmentação semântica.
Assista: Teste de inferência ONNX: Ultralytics YOLO26 vs Ultralytics YOLO11 | Inferência ~43% mais rápida com YOLO26 🚀
FP32, FP16 e INT8 com o ONNX Runtime#
As tabelas abaixo comparam PyTorch com modelos ONNX FP32, FP16 e INT8 de todos os modelos de detecção YOLO26, executados com o CUDAExecutionProvider do ONNX Runtime. Todos os valores de GPU foram medidos em uma GPU NVIDIA RTX PRO 6000 Blackwell Server Edition.
Milissegundos por imagem; quanto menor, melhor. O formato mais rápido para cada modelo está em negrito.
| Modelo | imgsz | PyTorch | ONNX FP32 | ONNX FP16 | ONNX INT8 |
|---|---|---|---|---|---|
| YOLO26n | 640 | 2.85 | 1.96 | 1.88 | 3.73 |
| YOLO26s | 640 | 2.98 | 2.14 | 1.73 | 4.31 |
| YOLO26m | 640 | 3.29 | 3.01 | 2.14 | 5.37 |
| YOLO26l | 640 | 4.70 | 4.09 | 3.08 | 7.51 |
| YOLO26x | 640 | 5.93 | 5.56 | 3.90 | 9.38 |
YOLO26n na CPU (AMD EPYC 9655, PyTorch e ONNX Runtime com 8 threads cada; CPU diferente da usada nas tabelas de modelos YOLO26):
| Métrica | PyTorch | ONNX FP32 | ONNX FP16 | ONNX INT8 |
|---|---|---|---|---|
| Latência (ms/imagem) | 13.2 | 13.4 | 13.2 | 56.5 |
| mAPval 50-95 | 40.8 | 40.9 | 40.9 | 38.7 |
- FP16 reduziu o tamanho do arquivo pela metade, com diferença de 0,1 mAP em relação ao FP32, e foi até 1,4 vez mais rápido que o FP32 na GPU, sem ganho de velocidade na CPU.
- INT8 gerou o menor arquivo, mas perdeu de 2,2 a 3,0 mAP e foi mais lento que o FP32 tanto na GPU quanto na CPU.
Medições feitas com ultralytics 8.4.211, ONNX Runtime 1.30.0, PyTorch 2.15.0 e CUDA 13.2 em batch=1, em 13 de novembro de 2026. A latência corresponde à etapa de inferência informada por val e não inclui o pré-processamento nem o pós-processamento.
Sobre ONNX#
ONNX é um projeto comunitário iniciado pelo Facebook e pela Microsoft, desenvolvido atualmente com organizações como IBM, Amazon e Google. Ele define um conjunto comum de operadores e um formato de arquivo para modelos de aprendizado de máquina, permitindo que um modelo treinado em uma estrutura, como PyTorch, seja executado em muitos ambientes de execução e em várias plataformas de hardware.
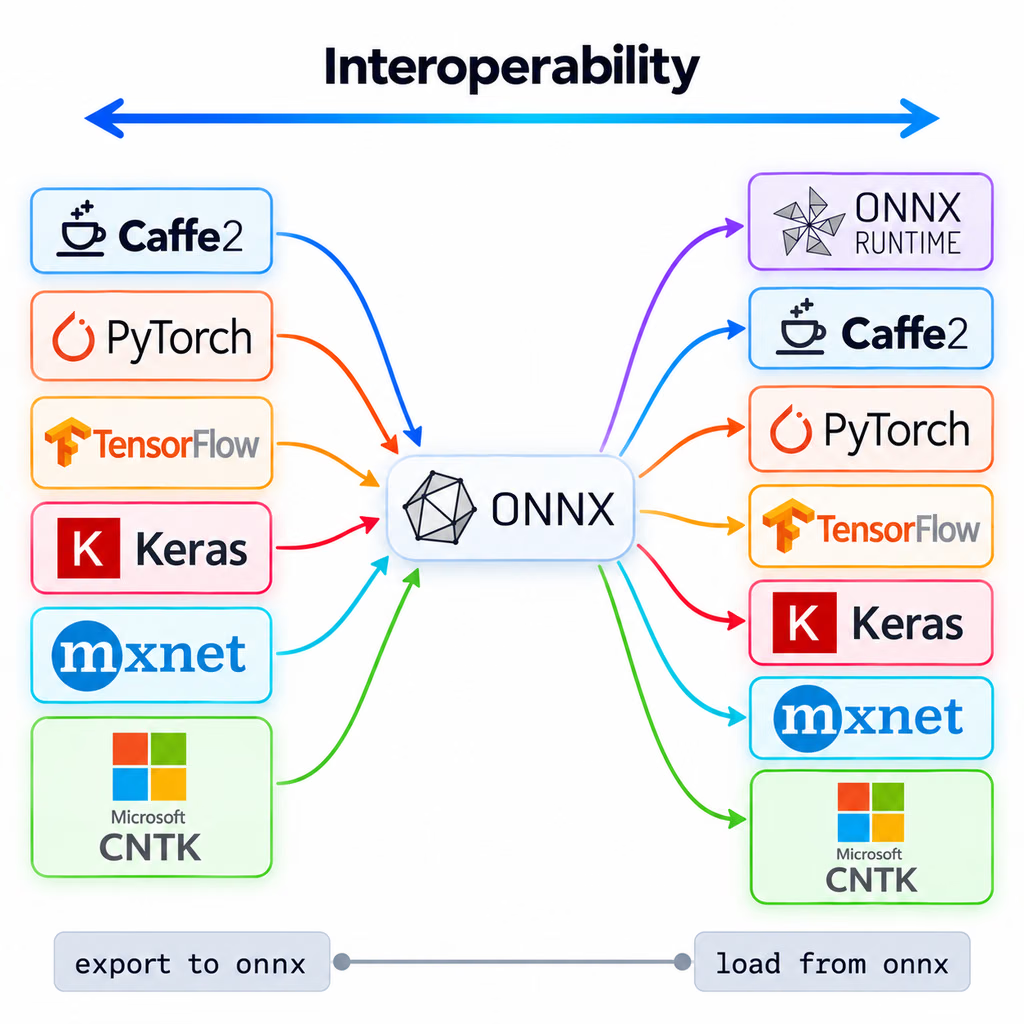
ONNX Runtime é um mecanismo de inferência multiplataforma para modelos ONNX. Seus provedores de execução usam bibliotecas específicas de hardware para executar um modelo em CPUs, GPUs e aceleradores dedicados.
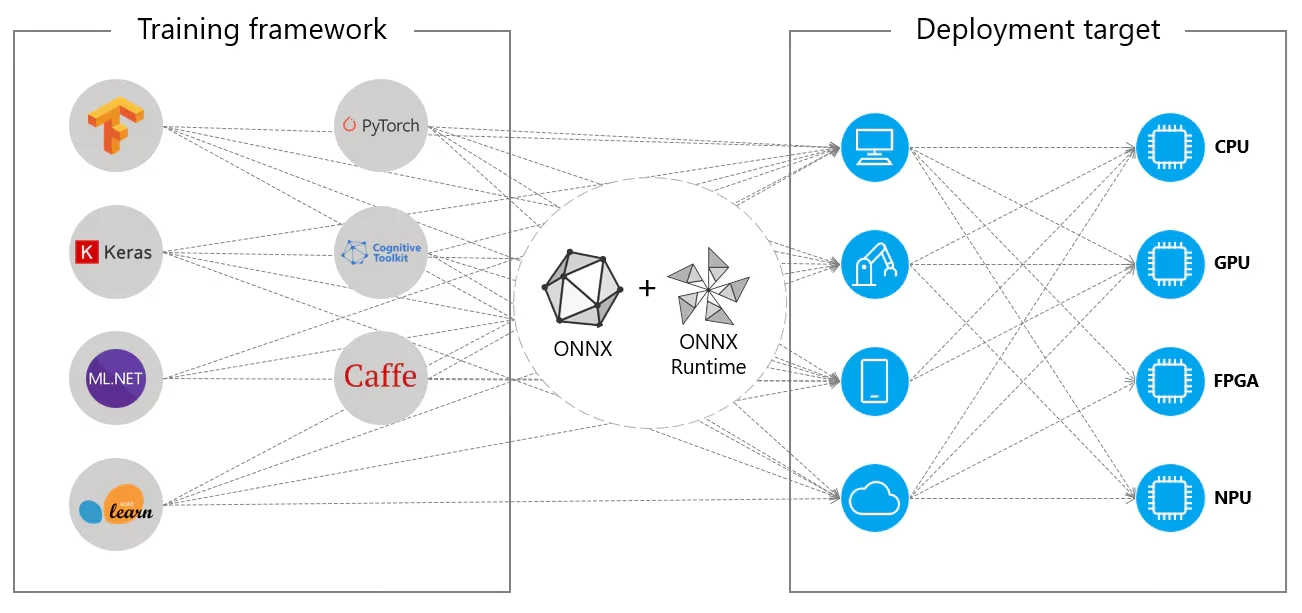
ONNX também é a etapa intermediária para outros formatos de exportação da Ultralytics, incluindo TensorRT, e a entrada para cadeias de ferramentas de NPU de fornecedores, como Huawei Ascend, Qualcomm QNN e Rockchip RKNN. Para ver a especificação, consulte a documentação do ONNX.
Perguntas frequentes#
Deixe
opsetsem definir, a menos que seu ambiente de execução precise de uma versão específica. O exportador usa então o opset18no PyTorch 2.4 e versões posteriores, o opset17no PyTorch 1.13 a 2.3, um opset inferior em versões mais antigas do PyTorch e nunca um opset superior ao suportado pelo pacoteonnxinstalado. O valor padrão é 18 porque o provedor CUDA do ONNX Runtime executa alguns operadores do opset 19 e posteriores, comoResize, na CPU. Defina um valor inferior, por exemploopset=12, quando um ambiente de execução ou conversor mais antigo rejeitar o valor padrão. O valor não pode ser inferior ao opset mínimo do modelo.Isso depende do argumento
nmsusado na exportação. Uma exportação padrão retorna predições brutas que precisam de filtragem por confiança e NMS. Uma exportação comnms=Falseounms=Trueretorna atémax_det(300 por padrão) detecções finais por imagem comox1, y1, x2, y2, score, classem pixels da imagem de entrada; assim, você só precisa filtrar pela pontuação e redimensionar as caixas para a imagem original. As linhas OBB contêmcenter x, center y, width, heightno lugar dos vértices, além do ângulo. Consulte Formato de saída para ver as formas.Ler a saída sem NMS com ONNX Runtime# Exportar primeiro: yolo export model=yolo26n.pt format=onnx nms=False import numpy as np import onnxruntime as ort session = ort.InferenceSession("yolo26n.onnx") # exportado com nms=False image = np.zeros((1, 3, 640, 640), dtype=np.float32) # sua imagem pré-processada detections = session.run(None, {"images": image})[0][0] # shape (300, 6) detections = detections[detections[:, 4] > 0.25] # manter as linhas acima do limiar de confiançaDefina
dynamic=True. A entradaimagesterá então a forma(batch, 3, height, width), com lote, altura e largura dinâmicos, e uma detecção padrão (nms=None)output0terá a forma(batch, 84, anchors), permitindo que o mesmo arquivo aceite diferentes tamanhos de lote e de imagem durante a inferência. Comnms=True, o tamanho do lote fica limitado ao valorbatchusado na exportação. A altura e a largura devem ser múltiplos do stride do modelo, que é 32 para os checkpoints oficiais YOLO26, exceto os de classificação. Um modelo dinâmico não usa vinculação de E/S na CUDA e não carrega no OpenCV DNN; portanto, mantenha a exportação estática padrão quando o tamanho da entrada for fixo.Exportação dinâmicafrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="onnx", dynamic=True)Use ONNX quando um arquivo precisar ser executado em diferentes hardwares ou quando a máquina de implantação não for a máquina usada para exportar. Use TensorRT para obter a menor latência em uma GPU NVIDIA específica: um mecanismo TensorRT é compilado para uma arquitetura de GPU e uma versão do TensorRT e não é portátil. Para outros destinos, consulte o guia de opções de implantação de modelos.
Sim. O ONNX Runtime tem compilações para web e dispositivos móveis que carregam o mesmo arquivo
.onnx. Exporte comnms=Falsepara manter o pós-processamento fora do código da sua aplicação. Em celulares, Core ML no iOS e LiteRT no Android são os formatos nativos.


Comentários77
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
dopeggguy
The parameter "half" bost apperence in train and export, what’s difference. when we using this parameter what should we need attention.
 Glenn JocherUltralytics(editado)
@dopeggguy Good question—summary: training uses mixed precision via
amp=True(weights stay FP32; compute is FP16 where safe), while export usesquantize=16(the formerhalf=True, now deprecated) to write an FP16 model for runtimes that support FP16. During training preferamp; use FP16 only at export/inference, and don't combine it with INT8 (quantize=8). See the train overview and AMP notes in the Train mode docs and thequantizeoption details in Model Export – Arguments and Configuration – Export Settings.from ultralytics import YOLO # Mixed-precision training (recommended) YOLO("yolo26n.yaml").train(data="data.yaml", amp=True) # FP16 export for FP16-capable runtimes (e.g., CUDA/TensorRT/OpenVINO FP16) YOLO("best.pt").export(format="onnx", quantize=16)yoloModel = YOLO(path_dir) yoloModel.export(format='onnx', dynamic=False, half=True, imgsz=(640, 640))
I'm not sure why. I enabled half=True, but the actual size of the exported model doesn't seem to change at all.
- Glenn JocherUltralytics(editado)
@dopeggguy
half=Trueis deprecated in favor ofquantize=16. On older releases a CPU-only ONNX export ignored the flag and stayed FP32, so the file size was almost identical. Current releases convert CPU ONNX exports to FP16 too (keeping float32 inputs/outputs), and GPU exports are FP16 natively. If you have a GPU, you can force export on it and re-check:from ultralytics import YOLO YOLO(path_dir).export(format="onnx", imgsz=(640, 640), dynamic=False, quantize=16, device=0)You can then open the ONNX in Netron or inspect it with the
onnxPython API to confirm the weights arefloat16; for pure CPU deployments it is often better to keep ONNX as FP32 or use a CPU‑oriented backend (e.g. OpenVINO) for FP16/INT8 optimization instead, with some general ONNX background outlined in the ONNX: Open Neural Network Exchange overview.
bastinj98
Hi, I trained d a YOLOV8-segn model to detect and segment a single class (nc=1) and then exported in to onnx (simplify, nms, half are all False) with opset = 17. The output shape is 1x37x8400.
I am building a C++ pipeline to use this model to run inference. How can I process this output to get the final segmentation mask ?
NgZiming
I exported a yolo 11 segment model to onnx format, and used onnx-runtime to infer. It responded two ndarrays of shapes (1, 37, 21504) and (1, 32, 256, 256). (imgsz=1024) So, how can i extract masks from these two arrays?
- Glenn JocherUltralytics
@NgZiming 这两个输出正是分割模型的“检测头 + 原型掩码”:
(1, 37, 21504)=4(xywh) + nc + 32(mask系数),(1, 32, 256, 256)为32个原型;掩码可由原型与对应检测的32维系数线性组合并裁剪到框内,最小示例(Python/NumPy)如下:import numpy as np import cv2 def sigmoid(x): return 1 / (1 + np.exp(-x)) def mask_from_outputs(det, proto, img_h, img_w, det_idx): # det: (1, C, N) -> (C, N), proto: (1, 32, 256, 256) -> (32, 256, 256) det = det[0]; proto = proto[0] nm, ph, pw = proto.shape # 32, 256, 256 nc = det.shape[0] - 4 - nm # 1) 取该检测的框、类别分数与32维掩码系数 cx, cy, w, h = det[0, det_idx], det[1, det_idx], det[2, det_idx], det[3, det_idx] coeff = det[4+nc:4+nc+nm, det_idx] # (32,) # 2) 原型 × 系数 -> 原始掩码 (ph, pw) m = sigmoid((proto.reshape(nm, -1).T @ coeff).reshape(ph, pw)) # 3) 可选:按框在原型分辨率下裁剪(坐标为[0,1]比例) x0 = int(max(0, (cx - w/2) * pw)); x1 = int(min(pw, (cx + w/2) * pw)) y0 = int(max(0, (cy - h/2) * ph)); y1 = int(min(ph, (cy + h/2) * ph)) crop = np.zeros_like(m); crop[y0:y1, x0:x1] = m[y0:y1, x0:x1] # 4) 上采样到原图尺寸并二值化 mask = cv2.resize(crop, (img_w, img_h), interpolation=cv2.INTER_LINEAR) return (mask > 0.5).astype(np.uint8)要点:确保与推理时的预处理一致(letterbox 缩放与填充、RGB/归一化等),否则框与掩码会错位。关于分割导出产生两个输出(
output0检测+系数,output1原型)的由来,可见导出实现参考的export_onnx说明:export_onnx 函数参考.1 thanks
- Glenn JocherUltralytics
Glad it helped—if you later need a C++ reference for segmentation mask decoding and preprocessing alignment, the step-by-step overview is in the Segmentation task docs.
 User
I have a question. If it's convenient, please answer it. Thank you! I'm working with cell images, and the image size is 3072*2048. I trained with imagesize=3072, but if I use imagesize=640, I can't detect objects. I can predict with a 3072 imagesize using a pt file, but now I'm trying to switch to C++ and call onnx, and the 3072 inference is very slow. Is this normal?
denni281
You should keep the same preprocess way between python-inference and cpp-inference.
- Glenn JocherUltralytics
@giter915 Yes—running 3072×2048 through ONNX/C++ will be much slower; inference time grows quickly with input area. Two practical options: use a faster backend or reduce effective input while keeping accuracy. For GPU, prefer TensorRT; for CPU, OpenVINO FP16/INT8 gives the largest gains. Examples:
from ultralytics import YOLO

# GPU-optimized
YOLO("best.pt").export(format="engine", imgsz=1536, half=True, dynamic=True)

# CPU-optimized
YOLO("best.pt").export(format="openvino", imgsz=1536, half=True)  # add int8=True with calibration if desired
If you must keep 3072, tile the image (e.g., 1024×1024 patches), run ONNX per tile, then merge detections with NMS in C++; this is a common approach for microscopy. Also ensure preprocessing in C++ exactly matches Python (letterbox padding, RGB order, 1/255 scaling)—agree with @DennisJcy here. For backend choices and supported export targets, see the export formats table in Object Detection – Ultralytics YOLO Docs, and for high‑throughput GPU serving consider Triton Inference Server with YOLO11.
- User
Thank you very much!
- Glenn JocherUltralytics
Glad it helped—one extra tip for ONNX Runtime C++: enable full graph optimizations and tune threads to squeeze more speed from large inputs like 3072×2048.
#include <onnxruntime_cxx_api.h>
#include <thread>

Ort::Env env(ORT_LOGGING_LEVEL_WARNING, "yolo");
Ort::SessionOptions so;
so.SetGraphOptimizationLevel(GraphOptimizationLevel::ORT_ENABLE_ALL);
so.SetIntraOpNumThreads(std::thread::hardware_concurrency());
so.SetInterOpNumThreads(1);  // often fine to leave at 1

Ort::Session session(env, "best.onnx", so);
Hello, I use ultratics to export YOLO11 half-Precision onnx model, but when I load the .onnx model to eval by onnxruntime, exception shows :Unexpected input data type. Actual: (tensor(float16)) , expected: (tensor(float)). And I compare the Float32 and Float16(half) .onnx model,These two files are exactly the same in size and input type.So the "half" keyword doesn't take effect when exporting ONNX, right? I remember Ultralytics didn't have this issue last year.
Here is my python script to export half-precision onnx model:
def main(opt): model = YOLO(opt.model) model.export( format="onnx", # opset=12, simplify=True, dynamic=False, imgsz=opt.imgsz, half=opt.half, batch=opt.batch, ) if __name__ == "__main__": multiprocessing.freeze_support() parser = argparse.ArgumentParser() parser.add_argument( "--model", type=str, default="/home/ultralytics/runs/detect/SHFY/weights/best.pt", ) parser.add_argument("--imgsz", type=int, default=640) parser.add_argument("--half", type=bool, default=True) parser.add_argument("--batch", type=int, default=1) opt, unparsed = parser.parse_known_args() print(opt) main(opt)Fine... It's my fault. My docker environment is Python-3.11.9 torch-2.4.1+cu118 CPU (unknown). The error is made by my cpu environment
- Glenn JocherUltralytics(editado)
@DennisJcy thanks for the update. On older releases
half=Truehad no effect on CPU ONNX exports, so the file stayed FP32. Current Ultralytics usesquantize=16(replacing the deprecatedhalf) and also converts CPU ONNX exports to FP16 while keeping float32 inputs/outputs, whereas GPU exports (device=0) are FP16 natively and need an FP16-capable ONNX Runtime provider. For CPU-optimized FP16 you can also export OpenVINO. For example:from ultralytics import YOLO # FP16 ONNX YOLO("best.pt").export(format="onnx", quantize=16) # CPU-optimized FP16 (OpenVINO) YOLO("best.pt").export(format="openvino", quantize=16)Details on OpenVINO export are in the export_openvino reference.
ShuaibZyx
def yolo_to_onnx(model_path, input_shape=(600, 600)): # Load the YOLOv8 model model = YOLO(model_path)
# Export the model to ONNX format
model.export(format='onnx',
             imgsz=input_shape,
             dynamic=True,
             batch=1,
             device="0")
Ultralytics YOLOv8.0.220 🚀 Python-3.9.18 torch-2.1.1+cu121 CUDA:0 (Tesla T4, 14931MiB) Model summary (fused): 268 layers, 43610463 parameters, 0 gradients, 164.8 GFLOPs
PyTorch: starting from 'best.pt' with input shape (1, 3, 640, 640) BCHW and output shape(s) (1, 9, 8400) (83.6 MB)
ONNX: starting export with onnx 1.18.0 opset 17... ONNX: export success ✅ 3.3s, saved as 'best.onnx' (166.5 MB) 我的模型在训练时是5个类别的目标检测,导出的模型的输出格式是(1, 9, 8400)。 我想请问您其中9具体代表的是什么呢? 如果是为了预测5个类别(1, 9, 8400)的输出格式是正确的嘛? 期待您的帮助!感谢!
xiaoqiang-l
9指的是:[x,y,w,h,class1_scores,class2_scores,class3_scores,class4_scores,class5_scores],即四个坐标及N个类别分数。 8400指的是:640下采样8倍、16倍、32倍特征图的anchor总数,(640/8)(640/8)+(640/16)(640/16)+(640/32)(640/32)=8080+4040+2020=8400
感谢您的指导!
- Glenn JocherUltralytics
@ShuaibZyx you're welcome! @xiaoqiang-l provided an excellent explanation. Just to confirm, the output shape (1, 9, 8400) is indeed correct for your 5-class detection model - the 9 channels represent the 4 bounding box coordinates (x, y, w, h) plus 5 class confidence scores. The 8400 represents all detection anchors across the three feature map scales (80×80 + 40×40 + 20×20 = 8400 total anchors).
UltralyticsAssistantUltralytics
👋 Hello, thank you for your interest in Ultralytics 🚀! We recommend a visit to the Docs for new users where you can find many Python and CLI usage examples, as well as detailed guides about exporting YOLO models to ONNX and other formats.
If this is a 🐛 Bug Report, please provide a minimum reproducible example to help us debug it.
If you have a custom training ❓ Question or require help with ONNX export, please include as much detail as possible—such as your command, model version, logs, and environment details. Also, check out our Tips for Best Training Results for optimal performance.
Join the Ultralytics community where it suits you best! For real-time chat, head to Discord 🎧. For in-depth discussions, try Discourse, or join the conversation on our Subreddit.
Upgrade
Upgrade to the latest
ultralyticspackage including all requirements in a Python>=3.8 environment with PyTorch>=1.8 to ensure you’re using the most up-to-date features and bug fixes:pip install -U ultralyticsEnvironments
YOLO can be run in these up-to-date verified environments, with all dependencies including CUDA/CUDNN, Python, and PyTorch preinstalled:
- Notebooks with free GPU:


- Google Cloud Deep Learning VM. See GCP Quickstart Guide
- Amazon Deep Learning AMI. See AWS Quickstart Guide
- Docker Image. See Docker Quickstart Guide
Status

If this badge is green, all Ultralytics CI tests are currently passing. CI tests verify correct operation of all YOLO Modes and Tasks on macOS, Windows, and Ubuntu every 24 hours and on every commit.
This is an automated response 🤖. An Ultralytics engineer will review your discussion and assist you soon!
- Glenn JocherUltralytics
Hello! Thanks for your interest in exporting YOLO11 models to ONNX format. This is a great option for deployment across different platforms with performance benefits.
Exporting to ONNX is straightforward with Ultralytics:
from ultralytics import YOLO

# Load model
model = YOLO("yolo11n.pt")  # or your custom trained model

# Export to ONNX with optional parameters
model.export(format="onnx", dynamic=True, simplify=True)  # creates 'yolo11n.onnx'

# Use the exported model
onnx_model = YOLO("yolo11n.onnx")
results = onnx_model("https://ultralytics.com/images/bus.jpg")
ONNX export can provide up to 3x CPU speedup compared to PyTorch models. You can customize the export with several parameters like
half=Truefor FP16 precision,dynamic=Truefor variable input sizes, oropsetto specify the ONNX version.For deployment, you can use ONNX Runtime or integrate with platforms like NVIDIA Triton Inference Server for production-scale serving.
If you have specific questions about exporting your models or encounter any issues during the process, please let us know!
- Notebooks with free GPU:
👋 Hello, thank you for your interest in Ultralytics 🚀! For users exploring ONNX integration and YOLO11, we recommend checking out the Docs where you’ll find dedicated Python and CLI tutorials, as well as specific ONNX integration guidance.
If this is a 🐛 Bug Report, please provide a minimum reproducible example to help us investigate further.
For custom deployment or export ❓ questions, please include as many details as possible, such as your export commands, model versions, and error logs. Make sure you review our Tips for Best Training Results for optimal performance.
Join the Ultralytics community where it suits you best: jump into real-time conversations on Discord 🎧, post or search on Discourse, or connect on our Subreddit.
Upgrade
Upgrade to the latest
ultralyticspackage, including all requirements, in a Python>=3.8 environment with PyTorch>=1.8 to ensure you have the latest features and fixes:pip install -U ultralyticsEnvironments
YOLO can be run in any of the following up-to-date verified environments (with all dependencies including CUDA/CUDNN, Python and PyTorch preinstalled):
- Notebooks with free GPU:
- Google Cloud Deep Learning VM. See GCP Quickstart Guide
- Amazon Deep Learning AMI. See AWS Quickstart Guide
- Docker Image. See Docker Quickstart Guide
Status
If this badge is green, all Ultralytics CI tests are currently passing. CI tests verify correct operation of all YOLO Modes and Tasks on macOS, Windows, and Ubuntu every 24 hours and on every commit.
This is an automated response. An Ultralytics engineer will assist you here soon!
- Glenn JocherUltralytics
Yes, you can adjust the batch size dynamically when exporting to ONNX format by using the
dynamic=Trueparameter in your export call. When this is enabled, the batch dimension becomes dynamic, allowing you to use various batch sizes during inference without reexporting the model.Here's a simple example:
from ultralytics import YOLO

# Load your model
model = YOLO("yolo11n.pt")

# Export with dynamic input size
model.export(format="onnx", dynamic=True)
This creates dynamic dimensions in the exported ONNX model, where the batch dimension (as well as height and width) can vary during inference. The resulting model will be more flexible for production deployments where batch size requirements might change.
- Notebooks with free GPU:
skyceeee
First of all, thank you for everything. Can we adjust the batch size dynamically when exporting the model as onnx?
When I export the YOLOV11 onnx model, I use: model.export(format='onnx', imgsz=640, device='cpu'). Then I use onnxruntime (1.14.0) to deploy it on the C++ side, but an error is reported during runtime: onnxruntime::Model::Model Unsupported model IR version: 9, max supported IR version: 8. Is there any parameter or method to set the exported model to support IR version: 8? Because I cannot upgrade onnxruntime to other higher versions locally, I look forward to your help
- Glenn JocherUltralytics
@xiaoqiang-l to resolve the ONNX IR version compatibility issue, you can specify an older
opsetversion during export. Try addingopset=13to your export command:model.export(format='onnx', imgsz=640, device='cpu', opset=13)This will generate an ONNX model compatible with IR version 8. For detailed version mapping, see the ONNX operator version matrix in the ONNX documentation.
