Как создать семантический поиск изображений с помощью OpenAI CLIP#
Это руководство поможет создать систему семантического поиска по изображениям с помощью OpenAI CLIP и Flask. Объединив визуально-языковые эмбеддинги CLIP с быстрым поиском по косинусному сходству на базе NumPy, ты сможешь создать веб-интерфейс, который находит подходящие изображения по запросам на естественном языке — без меток и категорий.
Смотри: Как работает поиск по сходству | Визуальный поиск с OpenAI CLIP и пакетом Ultralytics 🎉
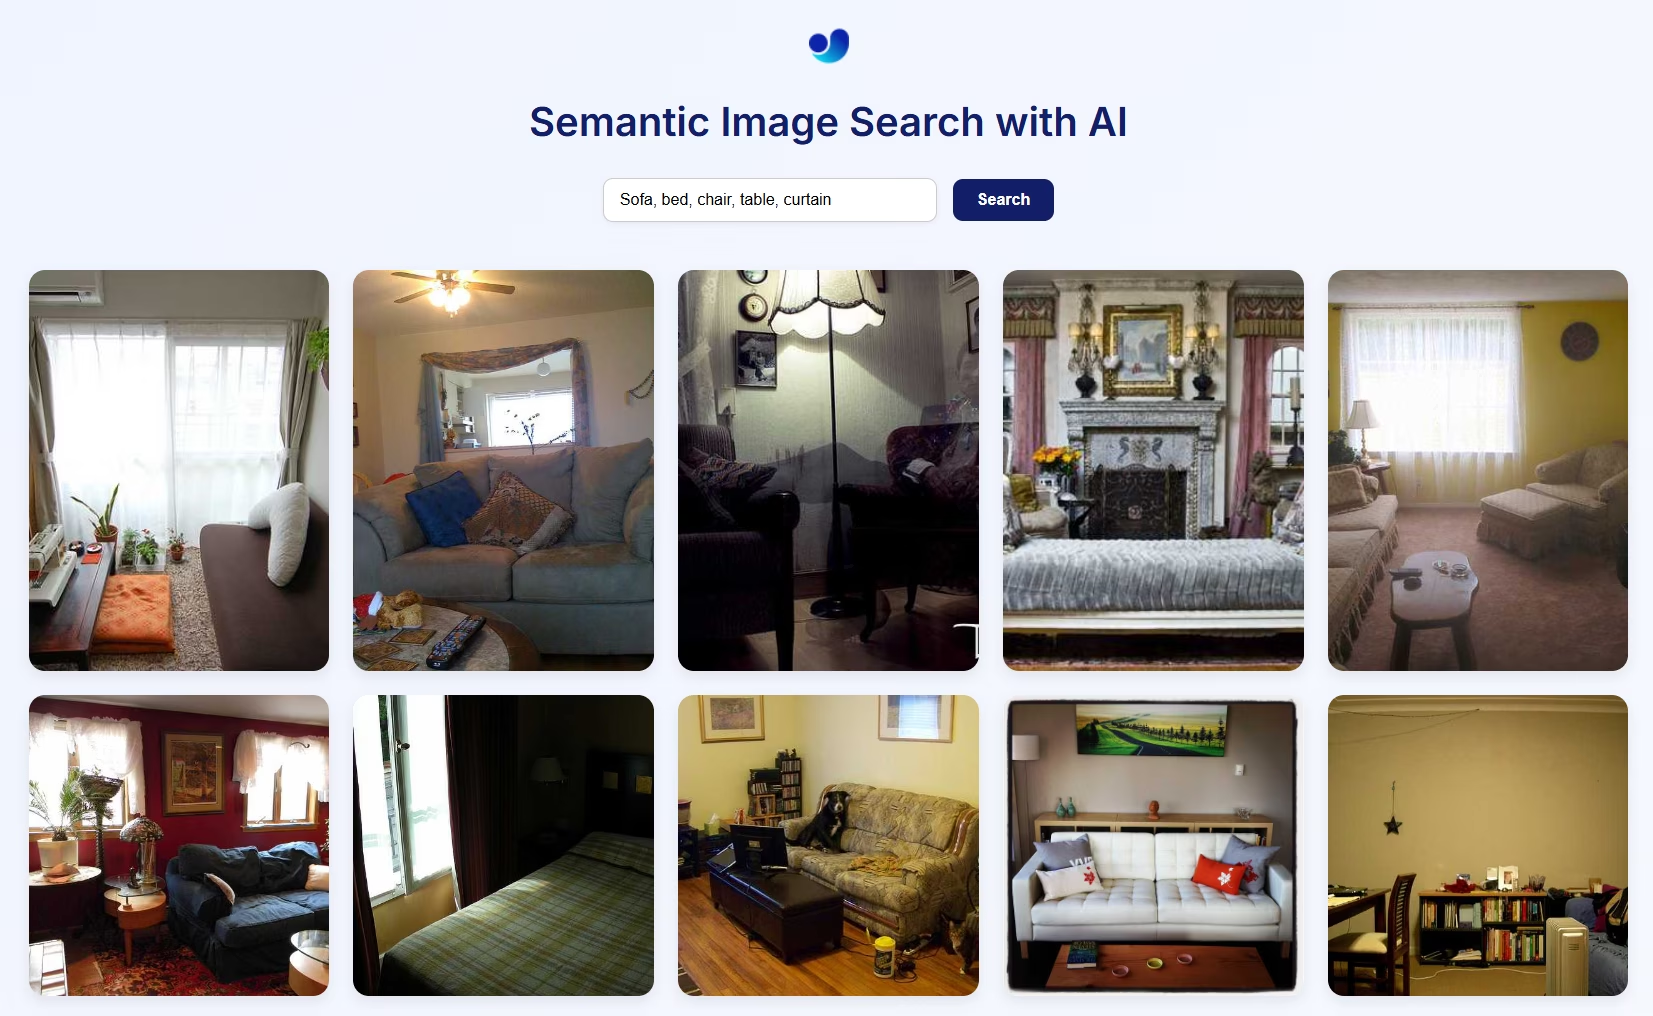
Пакет Ultralytics для Python объединяет весь этот процесс в двух классах, поэтому ты можешь запустить готовое приложение для поиска или программно выполнять запросы всего в несколько строк кода. В этом руководстве рассматриваются преимущества семантического поиска, принцип его работы, запуск веб-приложения, программный поиск и настройка параметров.
Зачем нужен семантический поиск изображений?#
Создание собственной системы семантического поиска по изображениям с CLIP даёт несколько преимуществ:
- Возможности zero-shot: Тебе не нужно обучать модель на своём наборе данных. Обучение CLIP без примеров позволяет искать в любой коллекции изображений, формулируя запросы на естественном языке, и экономит время и ресурсы.
- Понимание, близкое к человеческому: В отличие от поиска по ключевым словам, CLIP понимает семантический контекст и находит изображения по абстрактным, эмоциональным или описывающим отношения запросам, например «счастливый ребёнок на природе» или «футуристический городской пейзаж ночью».
- Без меток и метаданных: Для этого подхода нужны только исходные изображения. CLIP генерирует эмбеддинги без ручной разметки.
- Лёгкий и точный поиск: Одно умножение нормализованной матрицы в NumPy ранжирует все изображения по косинусному сходству, обеспечивая точные результаты в реальном времени для тысяч эмбеддингов. При этом не нужно устанавливать или обслуживать дополнительные поисковые зависимости.
- Применение в разных областях: Будь то личный фотоархив, инструмент для поиска творческих идей, поисковая система товаров или система рекомендаций произведений искусства — один и тот же стек можно адаптировать с минимальными изменениями.
Как работает семантический поиск изображений#
В этом процессе используются три компонента, каждый из которых отвечает за один этап преобразования изображений и текста в ранжированные результаты:
- CLIP использует энкодер изображений (например, ResNet или ViT) и текстовый энкодер на базе Transformer для языка, проецируя их в общее мультимодальное пространство эмбеддингов. Это позволяет напрямую сравнивать текст и изображения по косинусному сходству.
- NumPy хранит эмбеддинги изображений в одном массиве и сравнивает их с эмбеддингом запроса с помощью одного умножения матриц. В результате возвращаются ближайшие векторы по косинусному сходству без дополнительной зависимости для индексации.
- Flask предоставляет простой веб-интерфейс для ввода запросов на естественном языке и отображения семантически подходящих изображений из индекса.
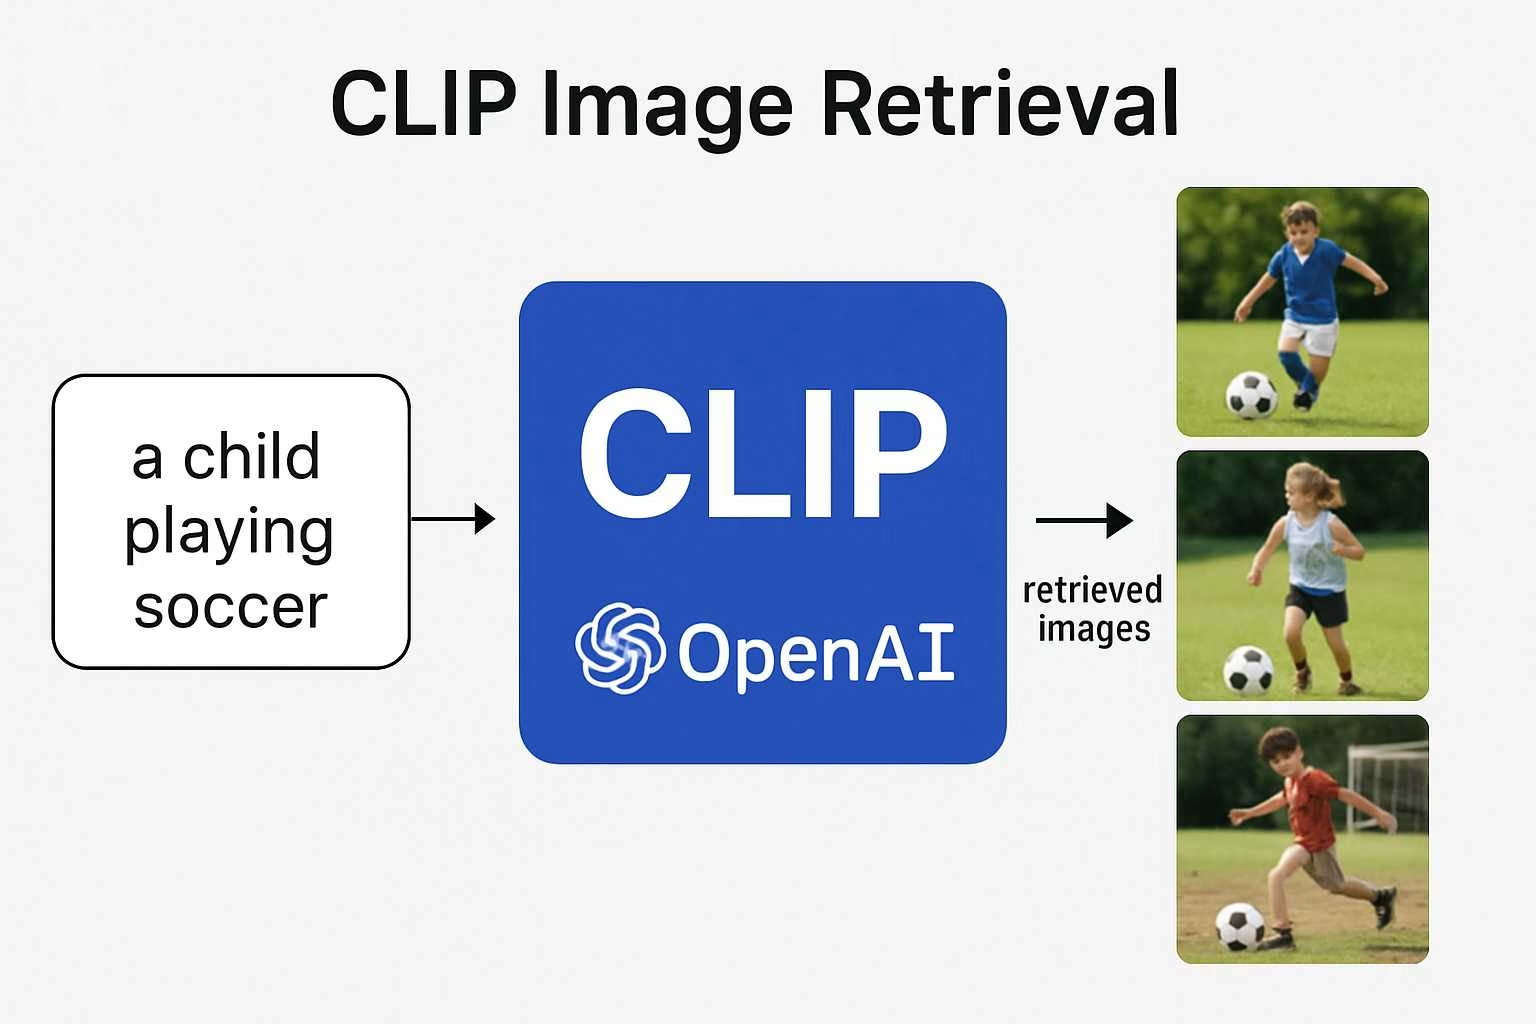
Поскольку изображения и текст отображаются в одном векторном пространстве, поиск работает в режиме zero-shot: тебе не нужны метки или категории — достаточно изображений и удачно сформулированного запроса.
Запуск веб-приложения семантического поиска#
Класс SearchApp запускает полноценный интерфейс Flask. При первом запуске он загружает образцы изображений, создаёт индекс эмбеддингов и открывает страницу, где можно ввести запрос и просмотреть ранжированные результаты.
from ultralytics import solutions

app = solutions.SearchApp(
    data="images",  # замени на путь к каталогу с изображениями, чтобы создать поисковый движок на их основе
    device="cpu",  # укажи устройство для обработки, например "cpu" или "cuda"
)

app.run(debug=False)  # Для тестирования также можно использовать аргумент `debug=True`
Программный поиск изображений#
Класс VisualAISearch выполняет все серверные операции без веб-уровня:
- При каждом запуске строит индекс эмбеддингов на основе локальных изображений.
- Извлекает эмбеддинги изображений и текста с помощью CLIP.
- Выполняет поиск по сходству, используя косинусное сходство.
Передай поисковому модулю запрос на естественном языке, чтобы получить список имён файлов подходящих изображений, отсортированный по степени сходства:
from ultralytics import solutions

searcher = solutions.VisualAISearch(
    data="images",  # замени на путь к каталогу с изображениями, чтобы создать поисковый движок на их основе
    device="cpu",  # укажи устройство для обработки, например "cpu" или "cuda"
)

results = searcher("a dog sitting on a bench")

# Ранжированные результаты:
# - 000000546829.jpg | Similarity: 0.3269
# - 000000549220.jpg | Similarity: 0.2899
# - 000000517069.jpg | Similarity: 0.2761
# - 000000029393.jpg | Similarity: 0.2742
# - 000000534270.jpg | Similarity: 0.2680
Настройка параметров VisualAISearch#
В таблице ниже перечислены доступные параметры VisualAISearch:
| Аргумент | Тип | По умолчанию | Описание |
|---|---|---|---|
data | str | 'images' | Путь к каталогу с изображениями для индексации и поиска. |
device | str | 'cpu' | Устройство для инференса CLIP (например, cpu, cuda, 0). |
Чтобы искать изображения в масштабах промышленной эксплуатации без управления локальными файлами, можно упорядочить изображения и управлять их версиями на Ultralytics Platform, прежде чем индексировать их с помощью CLIP.
Заключение#
С помощью CLIP и пакета Ultralytics для Python можно всего в несколько строк создать движок семантического поиска изображений в режиме zero-shot — как веб-приложение Flask или программный поисковый бэкенд. Затем укажи собственный каталог изображений в data, чтобы проиндексировать его, и изучи другие решения Ultralytics Solutions, чтобы расширить возможности своих рабочих процессов компьютерного зрения.
Часто задаваемые вопросы#
CLIP (предварительное обучение на основе контрастивного сопоставления текста и изображений) — это модель, разработанная OpenAI, которая учится связывать визуальную и языковую информацию. Модель обучена на огромном наборе изображений с подписями на естественном языке. Благодаря такому обучению она преобразует изображения и текст в общее пространство эмбеддингов, позволяя напрямую сравнивать их с помощью векторного сходства.
CLIP выделяется способностью к обобщению. Вместо обучения только на конкретных метках или задачах модель учится непосредственно на естественном языке. Благодаря этому она обрабатывает гибкие запросы, например «мужчина катается на гидроцикле» или «сюрреалистичный мир сновидений», и подходит для самых разных задач — от классификации до творческого семантического поиска — без дополнительного обучения.
После того как CLIP преобразует изображения в эмбеддинги, пакет Ultralytics нормализует их по L2 и сохраняет в одном массиве NumPy. Запрос ранжируется с помощью одного умножения матриц, которое вычисляет косинусное сходство между эмбеддингом запроса и эмбеддингом каждого изображения, а затем сортирует результаты. Этот полный перебор обеспечивает точный и быстрый поиск в типичных коллекциях изображений, не требуя установки или управления дополнительной векторной базой данных.
Хотя CLIP разработан OpenAI, пакет Ultralytics для Python объединяет генерацию эмбеддингов, индексирование и поиск по косинусному сходству в полноценный конвейер семантического поиска по изображениям, для которого достаточно нескольких строк кода:
from ultralytics import solutions

searcher = solutions.VisualAISearch(
    data="images",  # замени на путь к каталогу с изображениями, чтобы создать поисковый движок на их основе
    device="cpu",  # укажи устройство для обработки, например "cpu" или "cuda"
)

results = searcher("a dog sitting on a bench")
Эта высокоуровневая реализация выполняет следующие задачи:
- Генерация эмбеддингов изображений и текста на основе CLIP.
- Создание и управление индексом эмбеддингов.
- Эффективный семантический поиск по косинусному сходству.
- Загрузка и визуализация изображений из каталогов.
Да. В текущей конфигурации используется Flask с простым интерфейсом на HTML, но ты можешь заменить его собственным HTML-кодом или создать более динамичный интерфейс на React, Vue или другом фронтенд-фреймворке. Flask может выступать в роли серверного API для твоего интерфейса.
Напрямую — нет. Простое решение — извлечь из видео отдельные кадры (например, по одному в секунду), рассматривать их как самостоятельные изображения и передавать в систему. Так поисковый движок сможет семантически индексировать визуальные фрагменты видео.