Экспорт PyTorch ExecuTorch
ExecuTorch — это среда выполнения PyTorch для локального инференса на телефонах, встраиваемых платах и других периферийных устройствах. Экспорт модели Ultralytics YOLO26 с помощью format="executorch" создаёт каталог yolo26n_executorch_model/, содержащий программу .pte для XNNPACK — бэкенда ExecuTorch для ARM- и x86-процессоров — в формате FP32 или INT8.
Краткий обзор#
| Свойство | Описание |
|---|---|
Аргумент format | executorch |
| Результат | yolo26n_executorch_model/ — каталог с model.pte и metadata.yaml |
| Поддерживаемые устройства | ARM- и x86-процессоры через XNNPACK: устройства Android и iOS, платы со встроенным Linux, например Raspberry Pi, настольные компьютеры |
| Среда выполнения | ExecuTorch: пакет Python executorch или библиотеки ExecuTorch для Android, iOS и C++ |
| Точность | FP32 (по умолчанию) и INT8. Размер YOLO26n составляет 9.9 MB в FP32 и 3.2 MB в INT8 |
| Среда для экспорта | Linux x86-64 и macOS на Apple silicon, Python 3.10 или новее и PyTorch 2.9 или новее. Для экспорта не нужен GPU |
Ultralytics Platform может экспортировать обученную модель в ExecuTorch, поэтому локальная среда для экспорта тебе не понадобится.
Быстрый старт#
Установи пакет Ultralytics в виртуальную среду, например в Linux или macOS:
python3 -m venv executorch-env && source executorch-env/bin/activate
pip install ultralytics
При первом экспорте устанавливаются пакет executorch и необходимые ему пакеты, например torchao: в средах, использованных для этой страницы, устанавливалось от 23 до 43 пакетов, и ни один из них не заменил уже установленный пакет. В журнале экспорта появляется сообщение Restart runtime or rerun command for updates to take effect, после чего экспорт завершается в том же запуске.
Чтобы установить executorch до первого экспорта, вместо этого выполни pip install "ultralytics[export-executorch]"; эта команда также ограничивает numpy версией 2.3.5 или более ранней, и экспорт уже ничего не устанавливает. Для установки репозитория в режиме редактирования используй pip install -e ".[export-base,export-executorch]". Для экспорта нужны следующие версии:
| Требование | Версия |
|---|---|
| Python | 3.10 или новее для FP32 и 3.11 или новее для INT8. Экспорт FP32 выполнялся со всеми версиями от 3.10 до 3.15, а экспорт INT8 — с версиями от 3.11 до 3.15. В Python 3.10 pip устанавливает PyTorch 2.14.1 и executorch 1.5.1, которые поддерживают только экспорт FP32 |
| PyTorch | 2.9.0 или новее для FP32 — именно такую версию проверяет экспорт; самая ранняя версия, с которой выполнялся экспорт для этой страницы, — 2.12.1. Для INT8 нужен PyTorch 2.15.0 — версия, необходимая для executorch 1.6.0 |
executorch | Устанавливается при первом экспорте. Для INT8 нужна версия 1.6.0 или новее. При первом экспорте устанавливалась версия 1.6.0 с PyTorch 2.15.0, 1.5.1 с PyTorch 2.13.0 и 2.14.1, а также 1.3.1 с PyTorch 2.12.1; для версий PyTorch ниже 2.13 Ultralytics устанавливает executorch старше версии 1.5 |
| Операционная система | executorch 1.6.0 содержит пакеты для Linux x86-64 и ARM64 с glibc 2.28 или новее, macOS 14 или новее на Apple silicon и Windows x86-64. Экспорт для этой страницы выполнялся на Ubuntu 24.04 x86-64 и macOS 27 на Apple M4; Linux ARM64 и Windows не проверялись |
Другие способы установки описаны в руководстве по установке. Затем экспортируй модель и загрузи экспортированный каталог, чтобы выполнить инференс или проверить точность:
from ultralytics import YOLO

# Загрузи модель YOLO26
model = YOLO("yolo26n.pt")

# Экспортируй модель в формат ExecuTorch
model.export(format="executorch")  # creates 'yolo26n_executorch_model/'
На общем сервере AMD EPYC 9655 экспорт YOLO26n в FP32 занимал от 9 до 12 с при установленном executorch и от 19 до 29 с при первом экспорте в новой среде, который также устанавливает этот пакет. Экспорт YOLO26n в INT8 занимал от 20 до 25 с с 4 калибровочными изображениями coco8.yaml и от 55 до 60 с с 500 изображениями COCO. Экспорт YOLO26x в INT8 с 500 изображениями занял 267 с. Экспортированная модель запускается на компьютере, где выполнялся экспорт, поэтому её можно проверить там:
from ultralytics import YOLO

# Загрузи экспортированную модель ExecuTorch
model = YOLO("yolo26n_executorch_model")

# Выполнить инференс
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Загрузи экспортированную модель ExecuTorch
model = YOLO("yolo26n_executorch_model")
# Проверить точность на наборе данных COCO8
metrics = model.val(data="coco8.yaml")Поддерживаемые задачи#
Экспорт в ExecuTorch поддерживает все семь задач Ultralytics: детекция, сегментация, семантическая сегментация, оценка глубины, классификация, оценка позы и OBB. Семантическая сегментация и оценка глубины доступны только в YOLO26 — единственном семействе с такими головами. Для этой страницы контрольная точка YOLO26n для каждой задачи экспортировалась в FP32 и INT8 и запускалась на компьютере, где выполнялся экспорт; то же самое сделали с моделями детекции YOLO11 и YOLOv10. Модели детекции YOLOv8 и YOLOv5 экспортировались и запускались в FP32. Экспорт RT-DETR доступен только в FP32; см. Ограничения и устранение неполадок.
Аргументы экспорта#
| Аргумент | Тип | По умолчанию | Описание |
|---|---|---|---|
format | str | 'executorch' | Целевой формат экспортируемой модели, определяющий совместимость с различными средами развертывания. |
imgsz | int или tuple | 640 | Размер входного изображения модели, фиксируемый в файле .pte: целое число для квадратных изображений или кортеж (height, width). Если значение не указано, при экспорте используется размер, на котором обучалась контрольная точка. В официальных контрольных точках YOLO26 для моделей детекции, сегментации и позы, а также семантических моделей, предварительно обученных на ADE20K, используется 640; для моделей OBB и семантических моделей, предварительно обученных на Cityscapes, — 1024; для глубины — 768, для классификации — 224. |
quantize | int или str | None | Точность: 8 (статический INT8 с калибровкой на data) или 32/не задано (FP32). Параметры 16, 'w8a16' и 'w8a32' вызывают ошибку; см. Точность. Заменяет устаревшие флаги half/int8. |
data | str | None | YAML-файл набора данных с изображениями для калибровки quantize=8; для классификации вместо него указывают каталог набора данных или встроенное имя набора данных. Если параметр не задан, Ultralytics использует небольшой набор данных задачи по умолчанию, например coco8.yaml для детекции. См. Калибровка. |
split | str | 'val' | Раздел набора данных, на котором выполняется калибровка экспорта. |
fraction | float, int или list | 1.0 | Подмножество для калибровки: доля, количество изображений (целые числа больше 1) или список [train, val, test]; в последнем случае используется запись для разбиения калибровки. |
batch | int | 1 | Размер батча экспортированной модели, зафиксированный во входной форме. Также размер батча, используемый для калибровки. |
nms | bool, необязательно | None | Модели детекции, сегментации, оценки позы и OBB всегда экспортируют необработанный выход, для которого требуется NMS: True (встроенная NMS) и False (голова без NMS) недоступны; см. Формат выходных данных. |
device | str | None | Экспорт всегда выполняется на CPU независимо от переданного значения. |
Аргументы, общие для всех форматов, описаны в документации по режиму экспорта.
Точность#
quantize задаёт точность весов и активаций — значений, передаваемых между слоями:
quantize | Результат |
|---|---|
не задано или 32 | FP32 model.pte. Размер YOLO26n — 9.9 MB |
8 | INT8 model.pte, калибровка на data. Размер YOLO26n — 3.2 MB |
16 | Завершается с ошибкой quantize=16 (FP16) is not supported; format='executorch' supports quantize=8 (INT8), 32 or None (FP32). |
'w8a32' | Завершается с ошибкой quantize='w8a32' is not supported; format='executorch' supports quantize=8 (INT8), 32 or None (FP32). |
'w8a16' | Завершается с ошибкой quantize='w8a16' is not supported; format='executorch' supports quantize=8 (INT8), 32 or None (FP32). |
- INT8: статическая квантизация с помощью квантизатора XNNPACK для ExecuTorch: 8-битные веса с одним масштабным коэффициентом на выходной канал и 8-битные активации, диапазоны значений которых экспорт измеряет по калибровочным изображениям.
- Голова FP32: в моделях детекции, сегментации, оценки позы и OBB голова остаётся в FP32, поскольку единый 8-битный масштабный коэффициент для координат рамок и оценок классов округлил бы оценки до нуля. Модели семантической сегментации, оценки глубины и классификации квантуются полностью.
- Входы и выходы: вход и выходы в обеих точностях остаются
float32, поэтому код, написанный для модели FP32, без изменений работает с моделью INT8.
Размеры model.pte для официальных контрольных точек YOLO26n с размером изображения экспорта по умолчанию, в MB (10^6 байт). В журнале экспорта указывается размер всего каталога в MiB, например (9.4 MB) и (3.1 MB) для модели детекции:
| Задача | imgsz по умолчанию | FP32 | INT8 |
|---|---|---|---|
| Обнаружение | 640 | 9.9 | 3.2 |
| Сегментация | 640 | 11.1 | 4.5 |
| Семантическая | 1024 | 6.3 | 1.7 |
| Глубина | 768 | 20.8 | 5.4 |
| Классификация | 224 | 11.3 | 3.0 |
| Поза | 640 | 11.9 | 5.3 |
| OBB | 1024 | 10.2 | 3.6 |
Калибровка#
При экспорте quantize=8 модель обрабатывает каждую полную пачку раздела val набора данных data или выбранного с помощью split, чтобы измерить диапазоны активаций. Передай data с изображениями, похожими на данные для развёртывания, и используй fraction, чтобы ограничить их количество:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# Выполнить калибровку на 10% валидационных изображений COCO (500 изображений); замени coco.yaml на собственный датасет
model.export(format="executorch", quantize=8, data="coco.yaml", fraction=0.1)  # creates 'yolo26n_executorch_model/'

# Загрузить экспортированную модель INT8 и выполнить инференс
model = YOLO("yolo26n_executorch_model")
results = model("https://ultralytics.com/images/bus.jpg")- Набор данных по умолчанию: если не задан
data, экспорт выводит сообщениеINT8 export requires a missing 'data' arg for calibration. Using default 'data=coco8.yaml'.и выполняет калибровку на небольшом наборе данных задачи по умолчанию:coco8.yaml,coco8-seg.yaml,cityscapes8.yaml,depth8.yaml,imagenet10,coco8-pose.yamlилиdota8.yaml. Этого достаточно, чтобы проверить экспорт. - Предупреждение о размере калибровочного набора: если изображений меньше 300, экспорт выводит предупреждение, например
>300 images recommended for INT8 calibration, found 4 images. fraction: коэффициент или количество изображений. Иfraction=0.5, иfraction=2выбрали 2 из 4 валидационных изображенийcoco8.yaml, аfraction=0.1выбирает первые 500 из 5000 отсортированных валидационных изображенийcoco.yaml.split:split="train"выполняет калибровку на обучающих изображениях. Если в наборе данных нет указанного раздела, возникает ошибкаcoco8.yaml 'test:' images not found.batch: калибровка выполняется пачками размера, заданного для экспорта; неполная последняя пачка отбрасывается. Если изображений меньше, чем нужно для одной пачки, они повторяются, чтобы заполнить её.- Влияние калибровочных изображений: на 500 валидационных изображениях COCO YOLO26n достигла 42.0 mAP50-95 в FP32, а в INT8 — 41.2 при калибровке на 4 изображениях
coco8.yaml, 41.6 на 128 изображенияхcoco128.yamlи 41.3 на других 500 валидационных изображениях COCO; см. Тесты производительности. Другие модели и задачи могут реагировать сильнее, поэтому перед развёртыванием проверь INT8-модель на собственных данных.
Формат вывода#
Экспорт сохраняет один каталог, предварительно удаляя существующий каталог с таким именем:
| Файл | Содержимое |
|---|---|
model.pte | Программа ExecuTorch с одним методом forward, преобразованная для бэкенда XNNPACK |
metadata.yaml | Названия классов, задача, размер изображения, размер пакета, шаг и аргументы экспорта, которые Ultralytics считывает при загрузке модели |
Модель принимает один вход с формой (batch, 3, height, width): RGB, каналы в начале (NCHW), float32, значения в диапазоне 0–1. Ultralytics изменяет размер каждого изображения до заданного, добавляя серые поля (letterbox; для моделей классификации вместо этого меняется размер и выполняется центральная обрезка); координаты рамок в выходных данных относятся к изображению с полями. Выходы float32 зависят от задачи. Формы ниже указаны для официальных контрольных точек YOLO26n с размером экспорта по умолчанию и контрольной точки Cityscapes yolo26n-sem.pt для семантической сегментации:
| Задача | imgsz по умолчанию | Выходы |
|---|---|---|
| Обнаружение | 640 | (1, 84, 8400) |
| Сегментация | 640 | (1, 116, 8400) и (1, 32, 160, 160) |
| Семантическая | 1024 | (1, 19, 1024, 1024): оценка для каждого класса и пикселя |
| Глубина | 768 | (1, 1, 768, 768): карта глубины |
| Классификация | 224 | (1, 1000): вероятности классов |
| Поза | 640 | (1, 56, 8400): 4 значения рамки, оценка 1 класса, затем 17 ключевых точек по 3 значения |
| OBB | 1024 | (1, 20, 21504): 4 значения рамки, 15 оценок классов, затем угол |
- Необработанный выход: модели детекции, сегментации, оценки позы и OBB записывают выход с формой
(batch, values, anchors). Для каждой опорной точки следуют центр рамки x, центр y, ширина и высота в пикселях входного изображения, затем оценки классов и значения задачи (32 коэффициента маски, 17 ключевых точек по 3 значения или угол OBB в радианах). Примени NMS к этому выходу самостоятельно. Формат данных каждой задачи см. в разделе Формат выходных данных ONNX. - RT-DETR: выход RT-DETR-L вместо этого имеет форму
(1, 300, 6). nms: выход одинаков при любом значенииnms. Для моделей с головой без NMS, таких как YOLO26,nms=FalseвыводитThis export format does not support end2end models, disabling the end2end branch., аnms=Trueвыводитformat=executorch does not support embedded NMS; using nms=None.- Сегментация: 32 коэффициента маски — это последние 32 значения каждой опорной точки, а во втором выходе содержатся прототипы масок.
- Семантическая сегментация: выход содержит оценку для каждого класса и пикселя, а не карту классов, как в экспорте ONNX, поэтому в собственном коде вычисли argmax по оси классов.
В таблице ниже сравниваются необработанные выходы с выходами экспорта ONNX той же контрольной точки для одного изображения bus.jpg. В столбце FP32 указана наибольшая абсолютная разница для любого значения выхода, где значения рамок измеряются в пикселях; в столбце INT8 — корреляция первого выхода с выходом ONNX:
| Задача | FP32 относительно ONNX | INT8 относительно ONNX |
|---|---|---|
| Обнаружение | 0.0099 | 0.9997 |
| Сегментация | 0.0054 | 0.9998, прототипы 0.9852 |
| Семантическая | Один и тот же класс на каждом пикселе | Один и тот же класс на 98.3% пикселей |
| Глубина | 0.0001 | 0.5483 |
| Классификация | меньше 0.0001 | 0.9604, тот же класс top-1 |
| Поза | 0.0034 | 0.9996 |
| OBB | 0.0168 | 0.9998 |
INT8 изменяет выходы, причём степень изменений зависит от задачи и калибровочных изображений. Приведённая выше модель глубины калибровалась на 4 изображениях depth8.yaml и на этой фотографии улицы сильно отличается от ONNX; однако на 4 валидационных изображениях depth8.yaml, то есть изображениях, на которых выполнялась калибровка, delta1 составила 0.85005 против 0.8535 у модели FP32. Перед развёртыванием проверь INT8-модель на собственных данных.
YOLO("yolo26n_executorch_model") считывает структуру данных из metadata.yaml, поэтому эти сведения нужны только при запуске файла .pte в собственном коде. Среди ключей metadata.yaml — names, task, imgsz, stride, batch, end2end, args и, для моделей позы, kpt_shape.
Запуск с помощью среды выполнения ExecuTorch#
Чтобы запускать модель вне пакета Ultralytics, загрузи model.pte с помощью среды выполнения пакета Python executorch:
# Экспортируй сначала: yolo export model=yolo26n.pt format=executorch
import torch
import yaml
from executorch.runtime import Runtime

program = Runtime.get().load_program("yolo26n_executorch_model/model.pte")
method = program.load_method("forward")

image = torch.zeros(1, 3, 640, 640)  # твоё изображение после letterbox-преобразования до 640x640: RGB, NCHW, float32, 0-1
output = method.execute([image])[0]  # необработанные предсказания, форма (1, 84, 8400)
assert tuple(output.shape) == (1, 84, 8400)

with open("yolo26n_executorch_model/metadata.yaml") as f:
names = yaml.safe_load(f)["names"] # {0: 'person', 1: 'bicycle', ...}Разверни#
YOLO("yolo26n_executorch_model") запускает model.pte с помощью среды выполнения пакета Python executorch, который Ultralytics устанавливает при первом использовании; вычисления выполняются на CPU через XNNPACK. Это работает и на компьютере, где выполнялся экспорт, поэтому модель можно проверить до копирования на устройство:
- Фиксированная форма входа: модель всегда запускается с
imgszиbatch, заданными при экспорте; Ultralytics считывает их изmetadata.yaml. Параметрimgsz, переданный вpredictилиval, игнорируется; чтобы изменить его, выполни экспорт заново. Пачки меньшего размера дополняются до размера пачки экспорта, а код Ultralytics разбивает более крупные пачки на части этого размера, поэтому можно использовать любое количество изображений. device: модель работает на CPU. На устройствах Apple с чипами Appledevice="mps"обнаружил на одном изображении те же объекты, что иdevice="cpu". На хосте с CUDAdevice=0для этого формата заменяется на CPU и тоже обнаружил те же объекты, что иdevice="cpu".- Потоки CPU: число потоков зависит от количества CPU, доступных процессу. На сервере Linux с 384 логическими CPU у процесса, запускавшего только среду выполнения ExecuTorch, было 126 потоков, а один инференс YOLO26n в FP32 занимал от 20 до 21 мс. При ограничении до 8 CPU с помощью
taskset -c 0-7у процесса было 15 потоков, а инференс занимал 8 мс; при 4 CPU — от 10 до 11 мс, а при 1 CPU и одном потоке — от 31 до 32 мс. На компьютере с большим количеством ядер ограничь число CPU процесса: в Linux с помощьюtasksetили в Docker с помощью--cpuset-cpus. - Имя каталога: передавай каталог, а не файл
.pte, и оставляй_executorch_modelв его имени, поскольку Ultralytics определяет формат по этому фрагменту; см. Ограничения и устранение неполадок. - Один файл
.pteв каждом каталоге: Ultralytics загружает первый файл.pte, найденный в каталоге и его подкаталогах, поэтому оставь там только один такой файл. metadata.yaml: Ultralytics считывает из него имена классов, задачу и размер входного изображения. Без этого файла модель детекции YOLO26n, экспортированная с размером 640, всё равно загружалась, но имена классов отображались какclass0,class1и так далее; другие задачи и размеры не проверялись. Скопируй на устройство весь каталог.
Интеграция в мобильные приложения#
В приложении для Android или iOS добавь в проект библиотеку среды выполнения ExecuTorch, загрузи model.pte и передай ей изображение, предварительно обработанное, как описано в разделе Формат выходных данных; код приложения применяет NMS к необработанному выходу моделей детекции, сегментации, оценки позы и OBB. Примеры из этого раздела и раздела Встраиваемый Linux не проверялись для этой страницы.
iOS#
Среда выполнения ExecuTorch для iOS — это пакет Swift, для которого требуется iOS 17 или новее. Бэкенд XNNPACK — отдельный продукт этого пакета, backend_xnnpack; приложение связывает его с библиотекой среды выполнения executorch с помощью флага компоновщика -all_load; см. Использование ExecuTorch в iOS. Пример интеграции с iOS (Objective-C/C++):
// iOS uses C++ APIs for model loading and inference
// See https://docs.pytorch.org/executorch/stable/using-executorch-ios.html for complete examples

#include <executorch/extension/module/module.h>

using namespace ::executorch::extension;

// Load the model
Module module("/path/to/model.pte");

// Create input tensor
float input[1 * 3 * 640 * 640];
auto tensor = from_blob(input, {1, 3, 640, 640});

// Run inference
const auto result = module.forward(tensor);Android#
Добавь ExecuTorch Android AAR из Maven Central: в нём поставляются библиотеки arm64-v8a и x86_64, а также бэкенд XNNPACK:
dependencies {
    implementation("org.pytorch:executorch-android:<version>")
}
Пример интеграции с Android (Kotlin):
import org.pytorch.executorch.EValue
import org.pytorch.executorch.Module
import org.pytorch.executorch.Tensor

// Load the model
val module = Module.load("/path/to/model.pte")

// Prepare input tensor
val inputTensor = Tensor.fromBlob(floatData, longArrayOf(1, 3, 640, 640))
val inputEValue = EValue.from(inputTensor)

// Run inference
val outputs = module.forward(inputEValue)
val predictions = outputs[0].toTensor().dataAsFloatArray
Встраиваемый Linux#
На плате с Python, например Raspberry Pi с 64-разрядной операционной системой, установи пакет с помощью pip install ultralytics и загрузи каталог через YOLO(), как описано в Кратком руководстве; пакеты executorch для ARM Linux доступны только для 64-разрядной архитектуры. Для этой страницы запуск на плате не проверялся. В приложении на C++ используй API ExecuTorch для C++:
#include <executorch/extension/module/module.h>
#include <executorch/extension/tensor/tensor.h>

using namespace ::executorch::extension;

// Load model
Module module("model.pte");

// Prepare input
std::vector<float> input_data = preprocessImage(image);
auto input_tensor = from_blob(input_data.data(), {1, 3, 640, 640});

// Run inference
const auto outputs = module.forward(input_tensor);
Руководства по развертыванию#
- Использование ExecuTorch в Android и в iOS: добавь среду выполнения в приложение и вызывай её из Kotlin, Java, Swift или Objective-C.
- Использование ExecuTorch с C++: API
Moduleи цели сборки для среды выполнения, бэкенда XNNPACK и пула потоков. - Бэкенд XNNPACK: поддерживаемые бэкендом архитектуры CPU и схемы квантизации.
- Raspberry Pi: настрой Ultralytics на платах Raspberry Pi.
- Ultralytics и ExecuTorch: обзор интеграции в блоге Ultralytics.
- Варианты развёртывания моделей: сравнение ExecuTorch с другими форматами экспорта.
Ограничения и устранение неполадок#
- INT8 в Python 3.10 или с PyTorch старше версии 2.15: экспорт завершается ошибкой
INT8 export requires executorch>=1.6.0. Дляexecutorch1.6.0 требуются PyTorch 2.15.0 и Python 3.11 или новее, поэтому во всех остальных случаях pip устанавливает более старую версиюexecutorch: 1.5.1 в Python 3.10 и с PyTorch 2.13.0, а также 1.3.1 с PyTorch 2.12.1. Экспорт FP32 работает в этих средах; модель детекции YOLO26n в INT8, экспортированная с помощьюexecutorch1.6.0, дала одинаковые детекции одного изображения со средами выполнения 1.5.1 (PyTorch 2.13.0) и 1.3.1 (PyTorch 2.12.1). Чтобы экспортировать в INT8, используй Python 3.11 или новее с PyTorch 2.15.0. - PyTorch старше версии 2.9: экспорт завершается ошибкой
ExecuTorch requires torch>=2.9.0 but torch==2.8.0+cu128 is installed. Это происходит после обычной установки в Python 3.9, когда pip устанавливает PyTorch 2.8.0. Используй Python 3.10 или новее. - Обновление
executorchвручную: Ultralytics устанавливает версиюexecutorch, совместимую с установленным PyTorch, а для PyTorch ниже 2.13 — версию старше 1.5, поскольку новые среды выполнения, согласно коду Ultralytics, там не работают. Не обновляй отдельноexecutorch. - Автоматическая установка отключена: при
YOLO_AUTOINSTALL=falseи обычномpip install ultralyticsэкспорт выводит сообщениеUltralytics requirement ['executorch'] not found, AutoUpdate disabled by YOLO_AUTOINSTALL=Falseи завершается с ошибкойNo module named 'executorch'. Сначала установи пакет с помощьюpip install "ultralytics[export-executorch]"; после этого для экспорта установка не потребуется. - Передача файла
.pte:YOLO("yolo26n_executorch_model/model.pte")загружается, но при первом предсказании возникает ошибкаacceptable suffix is {'.pt'}, not .pte. Передавай каталог. - Каталог выходных данных: каждый экспорт одной контрольной точки записывает один и тот же каталог
yolo26n_executorch_model/независимо отimgsz,batchилиquantizeи предварительно удаляет существующий каталог со всем его содержимым. Перед экспортом второго варианта переименуй каталог и сохрани_executorch_modelв его имени, напримерyolo26n_int8_executorch_model/: копия с именемyolo26n_etзавершилась ошибкойis not a supported model format. - Голова без NMS и встроенная NMS: оба варианта недоступны, а
nms=Falseиnms=Trueзаписывают необработанный выход; см. Формат выходных данных. Чтобы получить модель без NMS для телефона, см. LiteRT или Core ML. - Фиксированная входная форма:
dynamic=Trueзавершается с ошибкойargument 'dynamic' is not supported for format='executorch'. Повтори экспорт, чтобы изменить размер изображения или размер пакета. - RT-DETR в INT8: экспорт
quantize=8для RT-DETR-L завершился ошибкойMissing out variants: {'quantized_decomposed::dequantize_per_channel'}в обоих запусках из двух. Экспорт FP32 работает. - Контрольные точки, обученные с
quantize=8: контрольная точка, дообученная с помощью обучения с учетом квантования, завершается с ошибкойformat='executorch' cannot export a QAT model: its Q/DQ ranges are only read by the 'onnx' and 'engine' backends. Вместо нее экспортируй контрольную точку, от которой ты начал дообучение, указавquantize=8. - Windows и Linux ARM64: у
executorchесть пакеты для обеих платформ, но экспорт на них не проверялся для этой страницы, а тесты Ultralytics пропускают экспорт ExecuTorch в Windows.
Другие ошибки описаны в руководстве по распространённым проблемам.
Бенчмарки#
Команда Ultralytics провела тестирование моделей YOLO26 на Raspberry Pi 5, сравнив скорость и точность PyTorch и ExecuTorch.
| Модель | Формат | Статус | Размер (МБ) | metrics/mAP50-95(B) | Время инференса (мс/изобр.) |
|---|---|---|---|---|---|
| YOLO26n | PyTorch | ✅ | 5.3 | 0.4790 | 314.80 |
| YOLO26n | ExecuTorch | ✅ | 9.4 | 0.4800 | 142 |
| YOLO26s | PyTorch | ✅ | 19.5 | 0.5730 | 930.90 |
| YOLO26s | ExecuTorch | ✅ | 36.5 | 0.5780 | 376.1 |
Тестирование выполнено с Ultralytics 8.4.9
Время инференса не включает пред- и постобработку.
Эта таблица была составлена с предыдущей версией и не измерялась повторно для этой страницы; набор данных для валидации и размер изображения не указаны. В столбце Size приведён размер всего каталога экспорта в MiB (2^20 байт); текущий экспорт YOLO26n также занимает 9.4 в этих единицах и 9.9 MB в таблице размеров ниже. В руководстве по Raspberry Pi ExecuTorch сравнивается с семью другими форматами на той же плате.
FP32 и INT8 на серверном CPU#
В таблицах ниже PyTorch сравнивается с моделями ExecuTorch FP32 и INT8 для всех моделей детекции YOLO26 на CPU компьютера, где выполнялся экспорт, — общем с другими задачами сервере AMD EPYC 9655. Для таблицы задержек каждый процесс был ограничен 8 CPU с помощью taskset -c 0-7 — именно такое число потоков Ultralytics задаёт для PyTorch, поскольку среда выполнения ExecuTorch работает медленнее при использовании всех 384 логических CPU этого сервера; см. Развёртывание. Результаты относятся к этой конфигурации.
Миллисекунд на изображение, меньше — лучше; среднее по двум запускам. Для каждой модели самый быстрый формат выделен жирным.
| Модель | imgsz | PyTorch | ExecuTorch FP32 | ExecuTorch INT8 |
|---|---|---|---|---|
| YOLO26n | 640 | 9.7 | 10.4 | 8.6 |
| YOLO26s | 640 | 22.7 | 24.2 | 16.4 |
| YOLO26m | 640 | 53.8 | 61.1 | 33.8 |
| YOLO26l | 640 | 63.9 | 73.1 | 38.3 |
| YOLO26x | 640 | 117.2 | 150.7 | 68.0 |
- INT8 был самым быстрым форматом для всех моделей при 8 CPU: он работал в 1.2–2.2 раза быстрее ExecuTorch FP32, файл был в 3.0–3.4 раза меньше, а mAP снизился на 0.2–0.8.
- FP32 обеспечил ту же точность, что и экспорт ONNX, и работал на 7–29% медленнее PyTorch.
- Все CPU: без ограничений, на всех 384 логических CPU, YOLO26n обрабатывалась за 19.2 мс в FP32 и 22.6 мс в INT8, по одному запуску для каждого формата; для всех моделей, кроме YOLO26x, INT8 работал медленнее FP32.
Измерено с ultralytics 8.4.215, executorch 1.6.0, PyTorch 2.15.0 и ONNX Runtime 1.32.0 на batch=1. Точность измерялась на последних 500 изображениях COCO val2017 в отсортированном порядке, поэтому она отличается от значений для всего валидационного набора на странице модели YOLO26; модели INT8 калибровались на первых 500 изображениях с помощью data=coco.yaml fraction=0.1. Задержка показывает этап инференса, который сообщает val, и не включает предобработку или постобработку; результаты двух запусков различались максимум на 8%.
Об ExecuTorch#
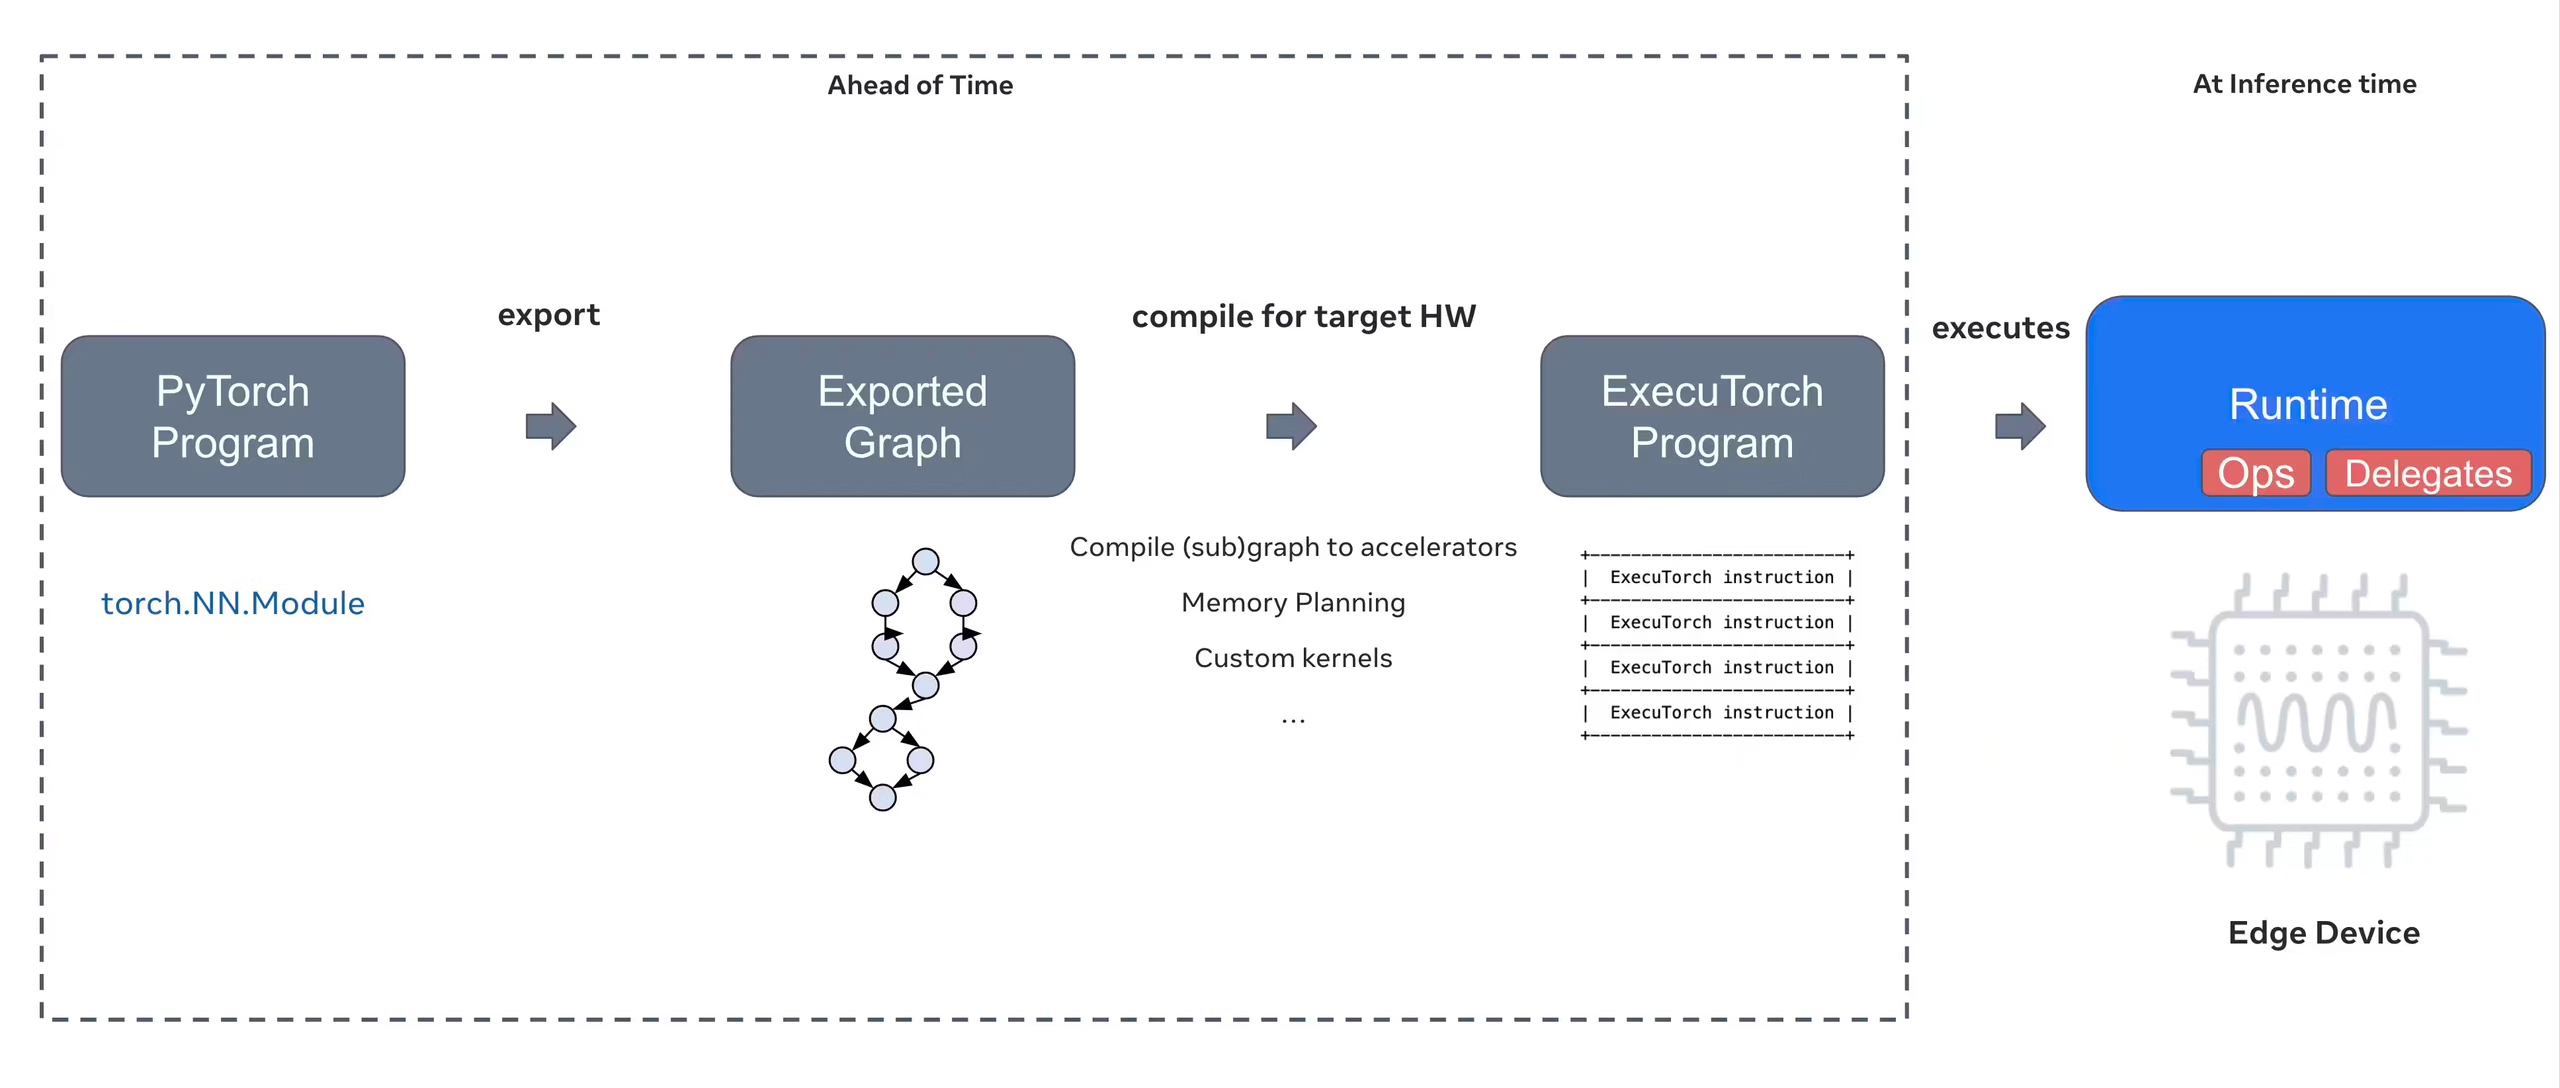
ExecuTorch — среда выполнения PyTorch для локального инференса на устройстве. Модель захватывается с помощью torch.export, преобразуется для бэкенда целевого оборудования и сохраняется как программа .pte, которую выполняет компактная среда выполнения C++. Экспорт Ultralytics преобразует модели для XNNPACK — бэкенда ExecuTorch для ARM- и x86-процессоров.
Часто задаваемые вопросы#
Нет. Экспорт преобразует модель только для XNNPACK, который работает на CPU. У ExecuTorch есть и другие бэкенды, например Core ML, Vulkan и Qualcomm AI Engine, но модель должна быть преобразована для них при экспорте, а Ultralytics этого не делает. Чтобы использовать GPU или NPU с экспортом Ultralytics, см. Core ML для устройств Apple, Qualcomm QNN для NPU Snapdragon и LiteRT для GPU Android.
Оба формата работают на процессорах телефонов через XNNPACK. Экспорт в LiteRT также поддерживает квантование, которому не нужны калибровочные данные (
w8a32), голову YOLO26 без NMS, делегаты GPU и плагин Ultralytics для Flutter, который запускает модели на Android. ExecuTorch подходит приложению, в котором уже используется среда выполнения ExecuTorch, например для других моделей PyTorch; при экспорте записывается необработанный выход, поэтому приложение само применяет NMS.ExecuTorch — актуальный способ переноса PyTorch на мобильные и встраиваемые устройства: он захватывает модель с помощью
torch.exportи запускает файл.pte. TorchScript — более ранний формат, поддержку которого PyTorch прекратил; Ultralytics сохраняет экспорт для существующих развертываний на C++.


Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.