如何使用 OpenAI CLIP 构建语义图像搜索#
本指南将带你使用 OpenAI CLIP 和 Flask 构建语义图像搜索引擎。将 CLIP 的视觉语言嵌入与由 NumPy 驱动的快速余弦相似度搜索相结合,你就可以构建一个 Web 界面,根据自然语言查询检索相关图像,无需标签或类别。
观看: 相似度搜索的工作原理 | 使用 OpenAI CLIP 和 Ultralytics Package 进行视觉搜索 🎉
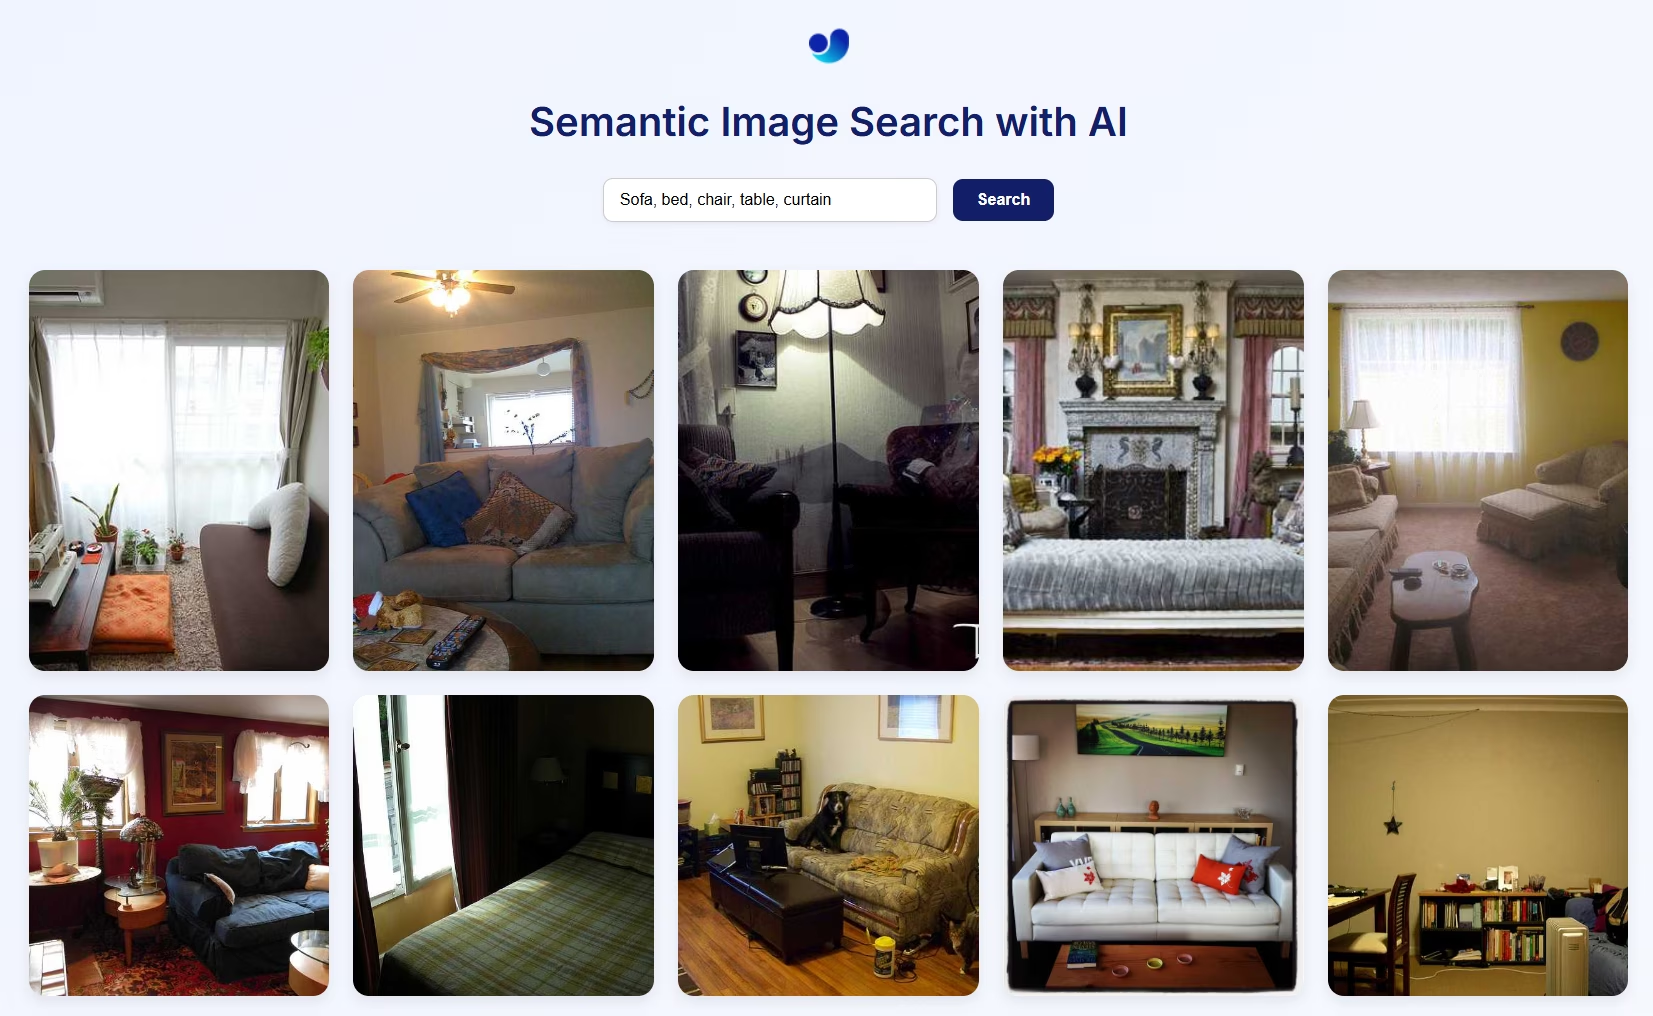
Ultralytics Python 包通过两个类封装了整个流程,因此你只需几行代码,就能启动可用的搜索应用,或以编程方式运行查询。本指南涵盖语义搜索的用途、工作原理、运行 Web 应用、以编程方式搜索以及配置参数。
为什么要使用语义图像搜索?#
使用 CLIP 构建自己的语义图像搜索系统有几个显著优势:
- 零样本能力:你无需使用自己的数据集进行训练。CLIP 的零样本学习让你可以使用自由形式的自然语言查询任意图像集合,从而节省时间和资源。
- 类人的理解能力:与关键词搜索不同,CLIP 能理解语义上下文,并根据抽象、情感或关系类查询检索图像,例如“自然中的快乐孩子”或“夜晚的未来主义城市天际线”。
- 无需标签或元数据:这种方法只需要原始图像。CLIP 无需人工标注即可生成嵌入。
- 轻量且精确的搜索:在 NumPy 中进行一次归一化矩阵乘法,就能按余弦相似度对所有图像排序,在数千个嵌入中实时返回精确结果,无需安装或管理额外的搜索依赖项。
- 跨领域应用:无论你要构建个人照片档案、创意灵感工具、产品搜索引擎还是艺术推荐系统,同一套技术栈都能以极少的调整适应需求。
语义图像搜索的工作原理#
该流程包含三个组件,分别负责将图像和文本转换为排序结果的一个阶段:
- CLIP 使用视觉编码器(例如 ResNet 或 ViT)处理图像,并使用基于 Transformer 的文本编码器处理语言,将两者映射到同一个多模态嵌入空间。这样就可以使用余弦相似度直接比较文本和图像。
- NumPy 将图像嵌入存储为单个数组,并通过一次矩阵乘法将其与查询嵌入进行比较排名,无需额外的索引依赖项,即可按余弦相似度返回最接近的向量。
- Flask 提供简单的 Web 界面,用于提交自然语言查询,并从索引中显示语义匹配的图像。
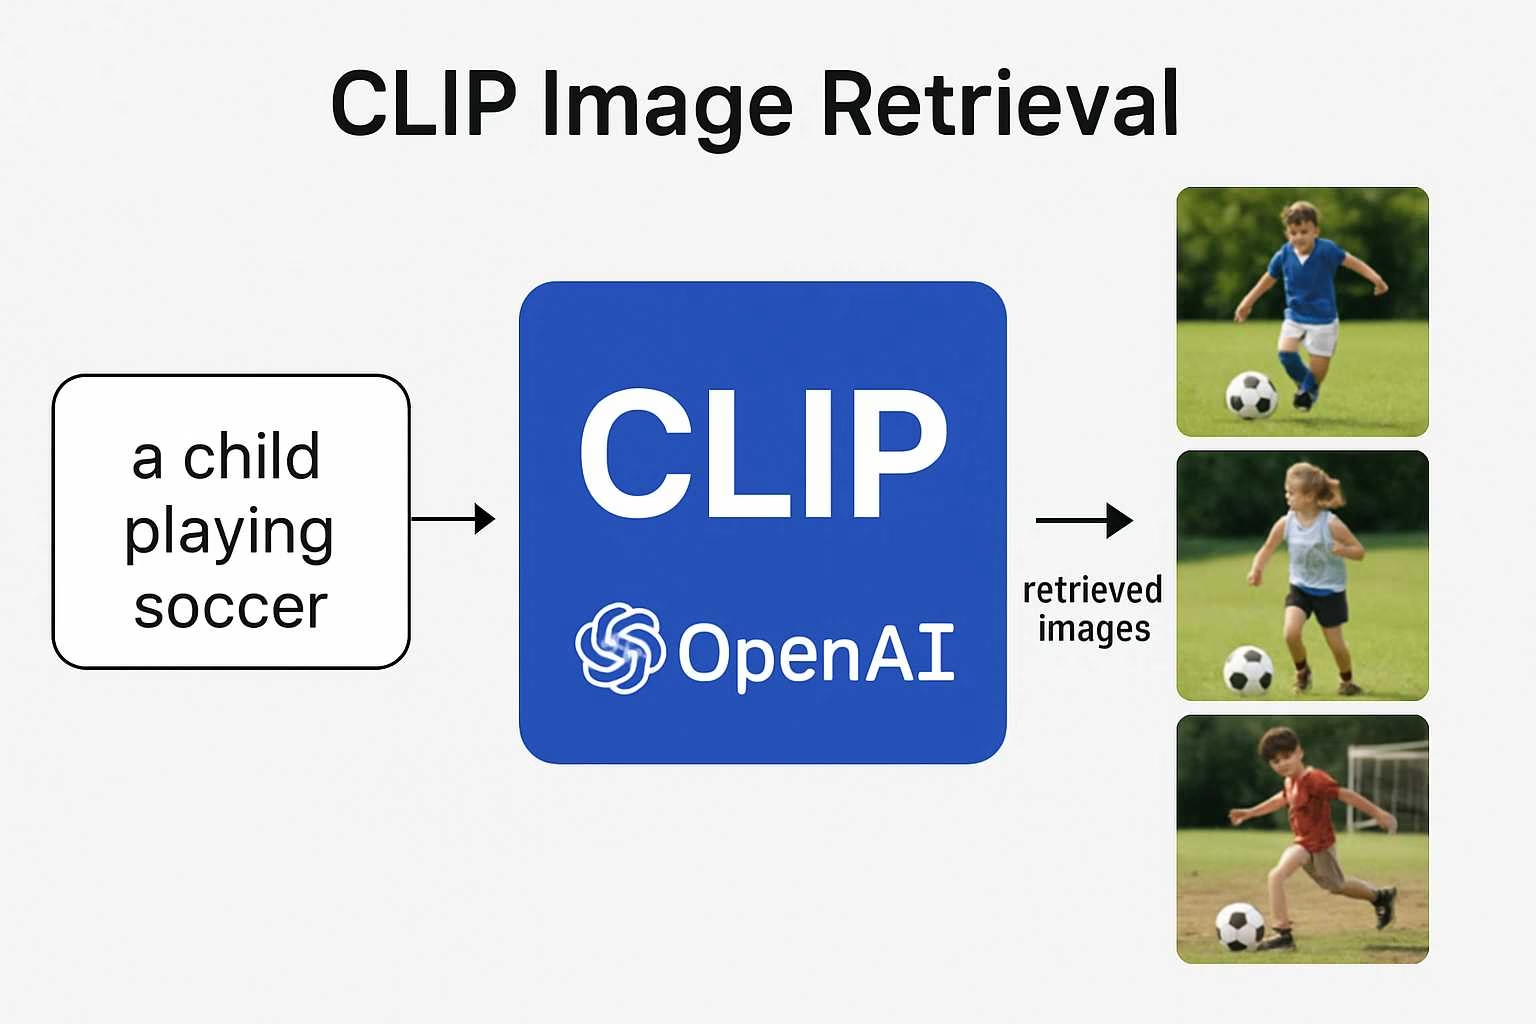
由于图像和文本都映射到同一个向量空间,检索过程是零样本的:你不需要标签或类别,只需要图像数据和合适的提示词。
运行语义搜索 Web 应用#
SearchApp 类会启动完整的 Flask 界面。首次运行时,它会下载一组示例图像、构建嵌入索引,并提供一个页面,让你输入查询并查看排序结果。
图像路径警告
如果使用自己的图像,请务必提供图像目录的绝对路径。否则,由于 Flask 文件服务的限制,图像可能不会显示在网页上。
from ultralytics import solutions

app = solutions.SearchApp(
    data="images",  # 替换为用于使用自己的图像构建搜索引擎的路径
    device="cpu",  # 配置处理设备,例如 "cpu" 或 "cuda"
)

app.run(debug=False) # 你也可以使用 `debug=True` 参数进行测试以编程方式搜索图像#
VisualAISearch 类会执行所有后端操作,无需 Web 层:
- 从本地图像加载或构建嵌入索引。
- 使用 CLIP 提取图像和文本嵌入。
- 使用余弦相似度执行相似性搜索。
使用自然语言查询调用搜索器,即可获取按相似度排序的匹配图像文件名列表:
from ultralytics import solutions

searcher = solutions.VisualAISearch(
    data="images",  # 替换为用于使用自己的图像构建搜索引擎的路径
    device="cpu",  # 配置处理设备,例如 "cpu" 或 "cuda"
)

results = searcher("a dog sitting on a bench")

# 排序结果:
# - 000000546829.jpg | Similarity: 0.3269
# - 000000549220.jpg | Similarity: 0.2899
# - 000000517069.jpg | Similarity: 0.2761
# - 000000029393.jpg | Similarity: 0.2742
# - 000000534270.jpg | Similarity: 0.2680
配置 VisualAISearch 参数#
下表列出了 VisualAISearch 的可用参数:
| 参数 | 类型 | 默认值 | 说明 |
|---|---|---|---|
data | str | 'images' | 用于建立索引和执行搜索的图像目录路径。 |
device | str | 'cpu' | 用于 CLIP 推理的设备(例如 cpu、cuda、0)。 |
若要以生产规模搜索图像集合,而无需管理本地文件,你可以先在 Ultralytics Platform 中整理图像并进行版本管理,然后再使用 CLIP 为图像建立索引。
结论#
借助 CLIP 和 Ultralytics Python 包,只需几行代码,你就可以搭建零样本语义图像搜索引擎,既可以将其作为 Flask Web 应用,也可以作为编程式搜索后端。从这里开始,将 data 指向自己的图像目录以建立索引,然后探索其他 Ultralytics 解决方案,进一步扩展计算机视觉工作流。
常见问题#
CLIP 的突出之处在于它的泛化能力。它并非只针对特定标签或任务进行训练,而是从自然语言本身学习。因此,它可以处理“一个男人在骑水上摩托”或“超现实的梦境”等灵活查询,无需重新训练,就能胜任从分类到创意语义搜索的各种任务。
虽然 CLIP 由 OpenAI 开发,但 Ultralytics Python 包将嵌入生成、索引和余弦相似度搜索封装为完整的语义图像搜索流程,只需几行代码即可运行:
from ultralytics import solutions

searcher = solutions.VisualAISearch(
    data="images",  # 替换为用于使用自己的图像构建搜索引擎的路径
    device="cpu",  # 配置处理设备,例如 "cpu" 或 "cuda"
)

results = searcher("a dog sitting on a bench")
这种高级实现负责处理:
- 基于 CLIP 生成图像和文本嵌入。
- 创建和管理嵌入索引。
- 使用余弦相似度进行高效语义搜索。
- 基于目录加载图像并进行可视化。
可以。当前配置使用 Flask 和基础 HTML 前端,但你可以替换为自己的 HTML,或使用 React、Vue 等前端框架构建更动态的界面。Flask 可以作为自定义界面的后端 API。
不能直接搜索。一个简单的变通方法是从视频中提取单独的帧(例如每秒提取一帧),将它们作为独立图像处理,然后输入系统。这样,搜索引擎就能为视频中的视觉片段建立语义索引。