مجموعة بيانات Caltech-101#
تُعد مجموعة بيانات Caltech-101 معيارًا كلاسيكيًا لـتصنيف الصور، وتتضمن 9,144 صورة موزعة على 101 فئة من الأغراض، بالإضافة إلى فئة واحدة للخلفية. وتضم كل فئة نحو 40 إلى 800 صورة لأغراض من العالم الحقيقي — مثل الحيوانات والمركبات والأدوات المنزلية والأشخاص — ما يجعلها معيارًا صغيرًا نسبيًا لكنه صعب لنماذج التعرّف على الأغراض.
استكشف Caltech-101 على منصة Ultralytics لمعاينة العينات، وفحص إحصاءات مجموعة البيانات، واستنساخها للتدريب.
لا تتضمن Caltech-101 تقسيمًا محددًا مسبقًا إلى مجموعتي التدريب والتحقق. تقسّم أوامر التدريب أدناه البيانات تلقائيًا إلى 80% للتدريب و20% للتحقق، لذلك لا حاجة إلى إعداد يدوي.
الميزات الرئيسية#
- تضم Caltech-101 عدد 9,144 صورة ملونة موزعة على 101 فئة من الأغراض، بالإضافة إلى فئة واحدة
BACKGROUND_Google(102 مجلدًا للفئات إجمالًا). - تشمل الفئات مجموعة واسعة من الأغراض من العالم الحقيقي، بما فيها الحيوانات والمركبات والأدوات المنزلية والأشخاص.
- تضم كل فئة نحو 40 إلى 800 صورة، لذا فإن أحجام الفئات غير متوازنة.
- تختلف أحجام الصور، ويبلغ قياس معظمها نحو 300x200 بكسل (دقة متوسطة).
- تُستخدم Caltech-101 على نطاق واسع لتقييم معايير تصنيف الصور وخوارزميات التعرّف على الأغراض.
بنية مجموعة البيانات#
تُوزّع Caltech-101 ضمن 102 مجلد — مجلد لكل فئة، تشمل 101 فئة من الأغراض بالإضافة إلى فئة BACKGROUND_Google — من دون تقسيم محدد مسبقًا إلى مجموعتي التدريب والتحقق. عند بدء التدريب، تقسّم Ultralytics الصور تلقائيًا كي تتدرب النماذج على الفئات الـ102 جميعها من دون أي إعداد يدوي:
- الفئات: 102 (101 فئة من الأغراض + فئة واحدة للخلفية)
- إجمالي الصور: 9,144
- تقسيم التدريب/التحقق: تلقائي بنسبة 80% / 20% (نحو 7,280 للتدريب، ونحو 1,864 للتحقق)
- الصور لكل فئة: نحو 40 إلى 800 (غير متوازنة)
التطبيقات#
يُستخدم Caltech-101 على نطاق واسع لتدريب نماذج تصنيف الصور والتعرّف على الأجسام وتقييمها، بما في ذلك الشبكات العصبية الالتفافية (CNNs) وآلات المتجهات الداعمة (SVMs). ويجعل تنوع الفئات واتساق الصور الموسومة منه معيارًا شائعًا لأبحاث التعلم الآلي والرؤية الحاسوبية والنماذج الأولية.
الاستخدام#
درّب نموذج YOLO على Caltech-101 لمدة 100 حقبة بحجم صور 416. للاطلاع على القائمة الكاملة للوسائط المتاحة، راجع صفحة التدريب ودليل مهمة تصنيف الصور.
from ultralytics import YOLO
# تحميل نموذج
model = YOLO("yolo26n-cls.pt") # تحميل نموذج مدرّب مسبقًا (موصى به للتدريب)
# تدريب النموذج
results = model.train(data="caltech101", epochs=100, imgsz=416)صور وتعليقات توضيحية نموذجية#
تحتوي مجموعة بيانات Caltech-101 على صور ملونة عالية الجودة لأجسام متنوعة، ما يوفر مجموعة بيانات منظمة جيدًا لمهام تصنيف الصور. فيما يلي بعض أمثلة الصور من مجموعة البيانات:
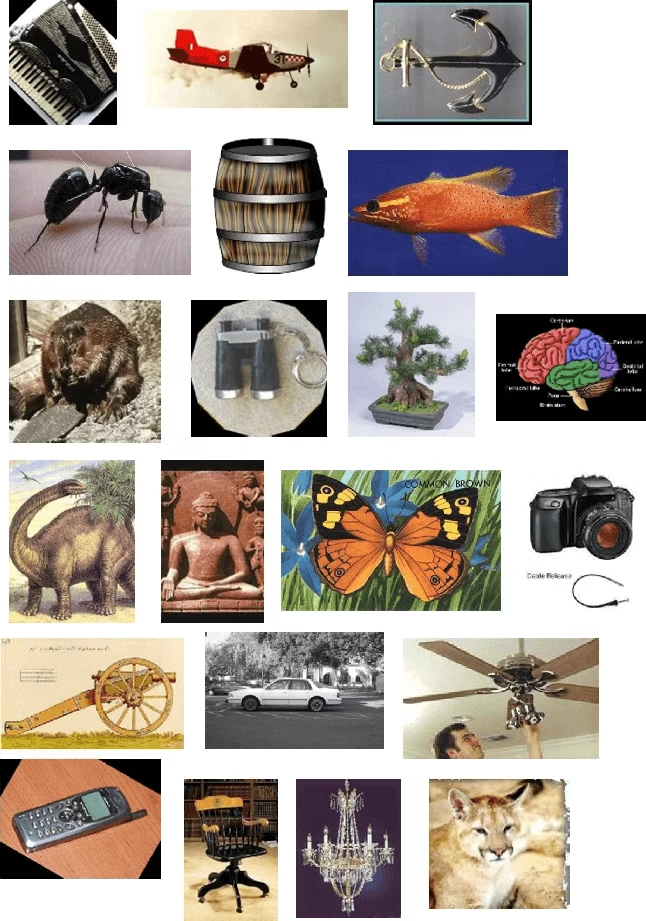
تُظهر العينات تنوع الفئات والتأطير الطبيعي والمتمركز المعتاد في Caltech-101، ما يجعلها نقطة انطلاق واضحة لتدريب نماذج قوية للتعرّف على الأجسام.
الاستشهادات والشكر والتقدير#
إذا استخدمت مجموعة بيانات Caltech-101 في أبحاثك أو أعمال التطوير، فيُرجى الاستشهاد بالورقة البحثية التالية:
@article{fei2007learning,
  title={Learning generative visual models from few training examples: An incremental Bayesian approach tested on 101 object categories},
  author={Fei-Fei, Li and Fergus, Rob and Perona, Pietro},
  journal={Computer vision and Image understanding},
  volume={106},
  number={1},
  pages={59--70},
  year={2007},
  publisher={Elsevier}
}
نود الإشادة بـ Li Fei-Fei وRob Fergus وPietro Perona لإنشائهم مجموعة بيانات Caltech-101 وصيانتها بوصفها موردًا قيّمًا لمجتمع أبحاث التعلم الآلي والرؤية الحاسوبية. لمزيد من المعلومات عن مجموعة بيانات Caltech-101 ومنشئيها، تفضل بزيارة موقع مجموعة بيانات Caltech-101.
الأسئلة الشائعة#
تُستخدم مجموعة بيانات Caltech-101 على نطاق واسع لتدريب نماذج تصنيف الصور والتعرّف على الأجسام وقياس أدائها. وهي تضم 9,144 صورة موزعة على 101 فئة من الأجسام، بالإضافة إلى فئة للخلفية، ما يوفر معيارًا صعبًا لتقييم خوارزميات مثل الشبكات العصبية الالتفافية (CNNs) وآلات المتجهات الداعمة (SVMs).
لتدريب نموذج Ultralytics YOLO على Caltech-101، استخدم مقتطفات التعليمات البرمجية أدناه. تُنزّل مجموعة البيانات تلقائيًا عند استخدامها للمرة الأولى. للاطلاع على القائمة الكاملة للوسائط، راجع صفحة التدريب الخاصة بالنموذج.
مثال على التدريبfrom ultralytics import YOLO # تحميل نموذج model = YOLO("yolo26n-cls.pt") # تحميل نموذج مدرّب مسبقًا (موصى به للتدريب) # تدريب النموذج results = model.train(data="caltech101", epochs=100, imgsz=416)تضم Caltech-101 101 فئة من الأجسام، بالإضافة إلى فئة
BACKGROUND_Google، أي 102 مجلدًا للفئات و9,144 صورة إجمالًا. عند التدريب باستخدام Ultralytics، يتعلم النموذج الفئات الـ102 جميعها. أحجام الفئات غير متوازنة، إذ تتراوح بين نحو 40 و800 صورة لكل فئة.لا تتضمن Caltech-101 تقسيمًا محددًا مسبقًا. عند التدريب للمرة الأولى، تقسمها Ultralytics تلقائيًا إلى 80% للتدريب و20% للتحقق — نحو 7,280 صورة للتدريب و1,864 صورة للتحقق — لذلك لا تحتاج إلى إنشاء التقسيمات يدويًا. للتحكم في التقسيم بنفسك، نظّم الصور في مجلدي
train/وval/قبل التدريب.نعم. تتيح لك منصة Ultralytics إدارة مجموعات البيانات وتدريب نماذج تصنيف الصور ونشرها دون الحاجة إلى كتابة كثير من التعليمات البرمجية. وهي طريقة مريحة لإجراء تجارب Caltech-101 على السحابة، ويمكنك استكشاف مزيد من الخيارات في نظرة عامة على مجموعات بيانات التصنيف.