PASCAL-VOC-Datensatz#
Der Datensatz PASCAL VOC (visuelle Objektklassen) ist ein klassischer Benchmark für die Objekterkennung mit 20 alltäglichen Objektklassen. Die Ultralytics-Konfiguration VOC.yaml führt die Trainings- und Validierungssplits VOC2007 und VOC2012 zu einem Trainingssatz mit 16.551 Bildern zusammen, wertet anhand der 4.952 öffentlich annotierten VOC2007-Testbilder aus und lädt bei der ersten Verwendung alles automatisch herunter (2,8 GB).
Ansehen: So trainierst du Ultralytics YOLO mit dem Pascal-VOC-Datensatz | Objekterkennung | Computer Vision 🚀
Die PASCAL-VOC-Wettbewerbe fanden von 2005 bis 2012 statt und prägten die Bewertung von Modellen zur Objekterkennung: Der Benchmark umfasst Aufgaben zur Bildklassifizierung, Objekterkennung und Segmentierung und machte die mittlere durchschnittliche Präzision (mAP) als Standardmetrik für die Objekterkennung bekannt. Die Ultralytics-Konfiguration VOC.yaml verwendet die Annotationen zur Objekterkennung und konvertiert beim Download die ursprünglichen Begrenzungsrahmen aus XML ins YOLO-Format.
Wichtige Funktionen#
- 20 alltägliche Objektklassen: Personen; sechs Tiere (Vogel, Katze, Kuh, Hund, Pferd, Schaf); sieben Fahrzeuge (Flugzeug, Fahrrad, Boot, Bus, Auto, Motorrad, Zug) und sechs Innenraumobjekte (Flasche, Stuhl, Esstisch, Topfpflanze, Sofa, Fernseher).
- Zwei Wettbewerbsgenerationen zusammengeführt: Das Training vereint den Trainings- und Validierungssplit von VOC2007 (5.011 Bilder) mit dem Trainings- und Validierungssplit von VOC2012 (11.540 Bilder).
- Standardisierte Auswertung: Dank jahrzehntelang veröffentlichter VOC-Basiswerte eignet sich der Datensatz gut als Referenz für den Vergleich von Objekterkennungsmodellen.
- Für YOLO vorbereitet: Das Downloadskript lädt die Archive herunter und konvertiert die Annotationen automatisch – eine manuelle Vorbereitung ist nicht nötig.
Datensatzstruktur#
Die Ultralytics-Konfiguration VOC.yaml definiert die folgenden Splits:
| Aufteilung | Bilder | Quelle |
|---|---|---|
| Trainieren | 16,551 | VOC2007 trainval (5.011) + VOC2012 trainval (11.540) |
| Validierung | 4,952 | VOC2007 test, verwendet zur Auswertung während des Trainings |
| Test | 4,952 | Dieselben VOC2007-Testbilder – die Konfiguration definiert keinen separaten zurückgehaltenen Split |
Die Annotationen der VOC2007-Testbilder wurden nach dem Wettbewerb des entsprechenden Jahres öffentlich freigegeben. Dadurch kann dieser Split als beschrifteter Validierungssatz dienen. Die Annotationen der VOC2012-Testbilder bleiben zurückgehalten – Ergebnisse dazu können nur über den offiziellen PASCAL-Auswertungsserver bewertet werden – und sind daher nicht Teil dieser Konfiguration.
Der automatische Konverter überspringt Objekte, die in den ursprünglichen VOC-XML-Annotationen mit difficult markiert sind. Deshalb weichen die Instanzzahlen pro Klasse geringfügig von den offiziellen VOC-Statistiken ab.
Sieh dir VOC auf der Ultralytics-Plattform an, um die Bilder mit eingeblendeten Annotationen zu durchsuchen, die Klassenverteilung und Begrenzungsrahmen-Wärmekarten auf dem Tab Charts anzusehen und den Datensatz zu klonen, um dein eigenes Modell in der Cloud zu trainieren.
Anwendungsfälle#
In den Jahren vor dem größeren COCO-Datensatz war PASCAL VOC der wichtigste Benchmark für die Forschung zur Objekterkennung: Detektoren wie Faster R-CNN und SSD veröffentlichten ihre ersten Ergebnisse darauf, und Ultralytics YOLO-Modelle lassen sich direkt damit trainieren. Heute wird der Datensatz weiterhin häufig verwendet für:
- Vergleiche neuer Architekturen zur Objekterkennung mit einer langen Reihe veröffentlichter Basiswerte
- Schnelle Experimente und Lehrveranstaltungen – mit 16.551 Trainingsbildern lässt sich das Modell deutlich schneller trainieren als mit COCO
- Studien zum Transferlernen mit einer kompakten, gut verstandenen Auswahl alltäglicher Klassen
YAML-Datei des Datensatzes#
Die Datei VOC.yaml definiert die Datensatzkonfiguration – die Datensatzpfade, die 20 Klassennamen und das Skript für den automatischen Download und die Konvertierung. Sie wird im Ultralytics-Repository unter https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/VOC.yaml gepflegt.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# PASCAL VOC dataset https://www.robots.ox.ac.uk/~vgg/projects/pascal/VOC by University of Oxford
# Documentation: https://docs.ultralytics.com/datasets/detect/voc
# Example usage: yolo train data=VOC.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── VOC ← downloads here (2.8 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: VOC
train: # train images (relative to 'path') 16551 images
  - images/train2012
  - images/train2007
  - images/val2012
  - images/val2007
val: # val images (relative to 'path') 4952 images
  - images/test2007
test: # test images (optional)
  - images/test2007

# Classes
names:
  0: aeroplane
  1: bicycle
  2: bird
  3: boat
  4: bottle
  5: bus
  6: car
  7: cat
  8: chair
  9: cow
  10: diningtable
  11: dog
  12: horse
  13: motorbike
  14: person
  15: pottedplant
  16: sheep
  17: sofa
  18: train
  19: tvmonitor

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import xml.etree.ElementTree as ET
  from pathlib import Path

  from ultralytics.utils.downloads import download
  from ultralytics.utils import ASSETS_URL, TQDM

  def convert_label(path, lb_path, year, image_id):
      """Converts XML annotations from VOC format to YOLO format by extracting bounding boxes and class IDs."""

      def convert_box(size, box):
          dw, dh = 1.0 / size[0], 1.0 / size[1]
          x, y, w, h = (box[0] + box[1]) / 2.0 - 1, (box[2] + box[3]) / 2.0 - 1, box[1] - box[0], box[3] - box[2]
          return x * dw, y * dh, w * dw, h * dh

      with open(path / f"VOC{year}/Annotations/{image_id}.xml") as in_file, open(lb_path, "w", encoding="utf-8") as out_file:
          tree = ET.parse(in_file)
          root = tree.getroot()
          size = root.find("size")
          w = int(size.find("width").text)
          h = int(size.find("height").text)

          names = list(yaml["names"].values())  # names list
          for obj in root.iter("object"):
              cls = obj.find("name").text
              if cls in names and int(obj.find("difficult").text) != 1:
                  xmlbox = obj.find("bndbox")
                  bb = convert_box((w, h), [float(xmlbox.find(x).text) for x in ("xmin", "xmax", "ymin", "ymax")])
                  cls_id = names.index(cls)  # class id
                  out_file.write(" ".join(str(a) for a in (cls_id, *bb)) + "\n")

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  urls = [
      f"{ASSETS_URL}/VOCtrainval_06-Nov-2007.zip",  # 446MB, 5011 images
      f"{ASSETS_URL}/VOCtest_06-Nov-2007.zip",  # 438MB, 4952 images
      f"{ASSETS_URL}/VOCtrainval_11-May-2012.zip",  # 1.95GB, 17125 images
  ]
  download(urls, dir=dir / "images", threads=3, exist_ok=True)  # download and unzip over existing (required)

  # Convert
  path = dir / "images/VOCdevkit"
  for year, image_set in ("2012", "train"), ("2012", "val"), ("2007", "train"), ("2007", "val"), ("2007", "test"):
      imgs_path = dir / "images" / f"{image_set}{year}"
      lbs_path = dir / "labels" / f"{image_set}{year}"
      imgs_path.mkdir(exist_ok=True, parents=True)
      lbs_path.mkdir(exist_ok=True, parents=True)

      with open(path / f"VOC{year}/ImageSets/Main/{image_set}.txt") as f:
          image_ids = f.read().strip().split()
      for id in TQDM(image_ids, desc=f"{image_set}{year}"):
          f = path / f"VOC{year}/JPEGImages/{id}.jpg"  # old img path
          lb_path = (lbs_path / f.name).with_suffix(".txt")  # new label path
          f.rename(imgs_path / f.name)  # move image
convert_label(path, lb_path, year, id) # convert labels to YOLO formatVerwendung#
VOC wird beim ersten Training automatisch heruntergeladen – drei Archive mit insgesamt 2,8 GB – und benötigt während des Entpackens und der Konvertierung ungefähr 6 GB freien Speicherplatz.
Um ein YOLO26n-Modell 100 Epochen lang mit einer Bildgröße von 640 auf dem VOC-Datensatz zu trainieren, kannst du die folgenden Codebeispiele verwenden. Eine umfassende Liste der verfügbaren Argumente findest du auf der Seite zum Training des Modells.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n.pt")  # ein vortrainiertes Modell laden (für das Training empfohlen)

# Modell trainieren – der Datensatz wird beim ersten Ausführen automatisch heruntergeladen
results = model.train(data="VOC.yaml", epochs=100, imgsz=640)
Beispielbilder und Annotationen#
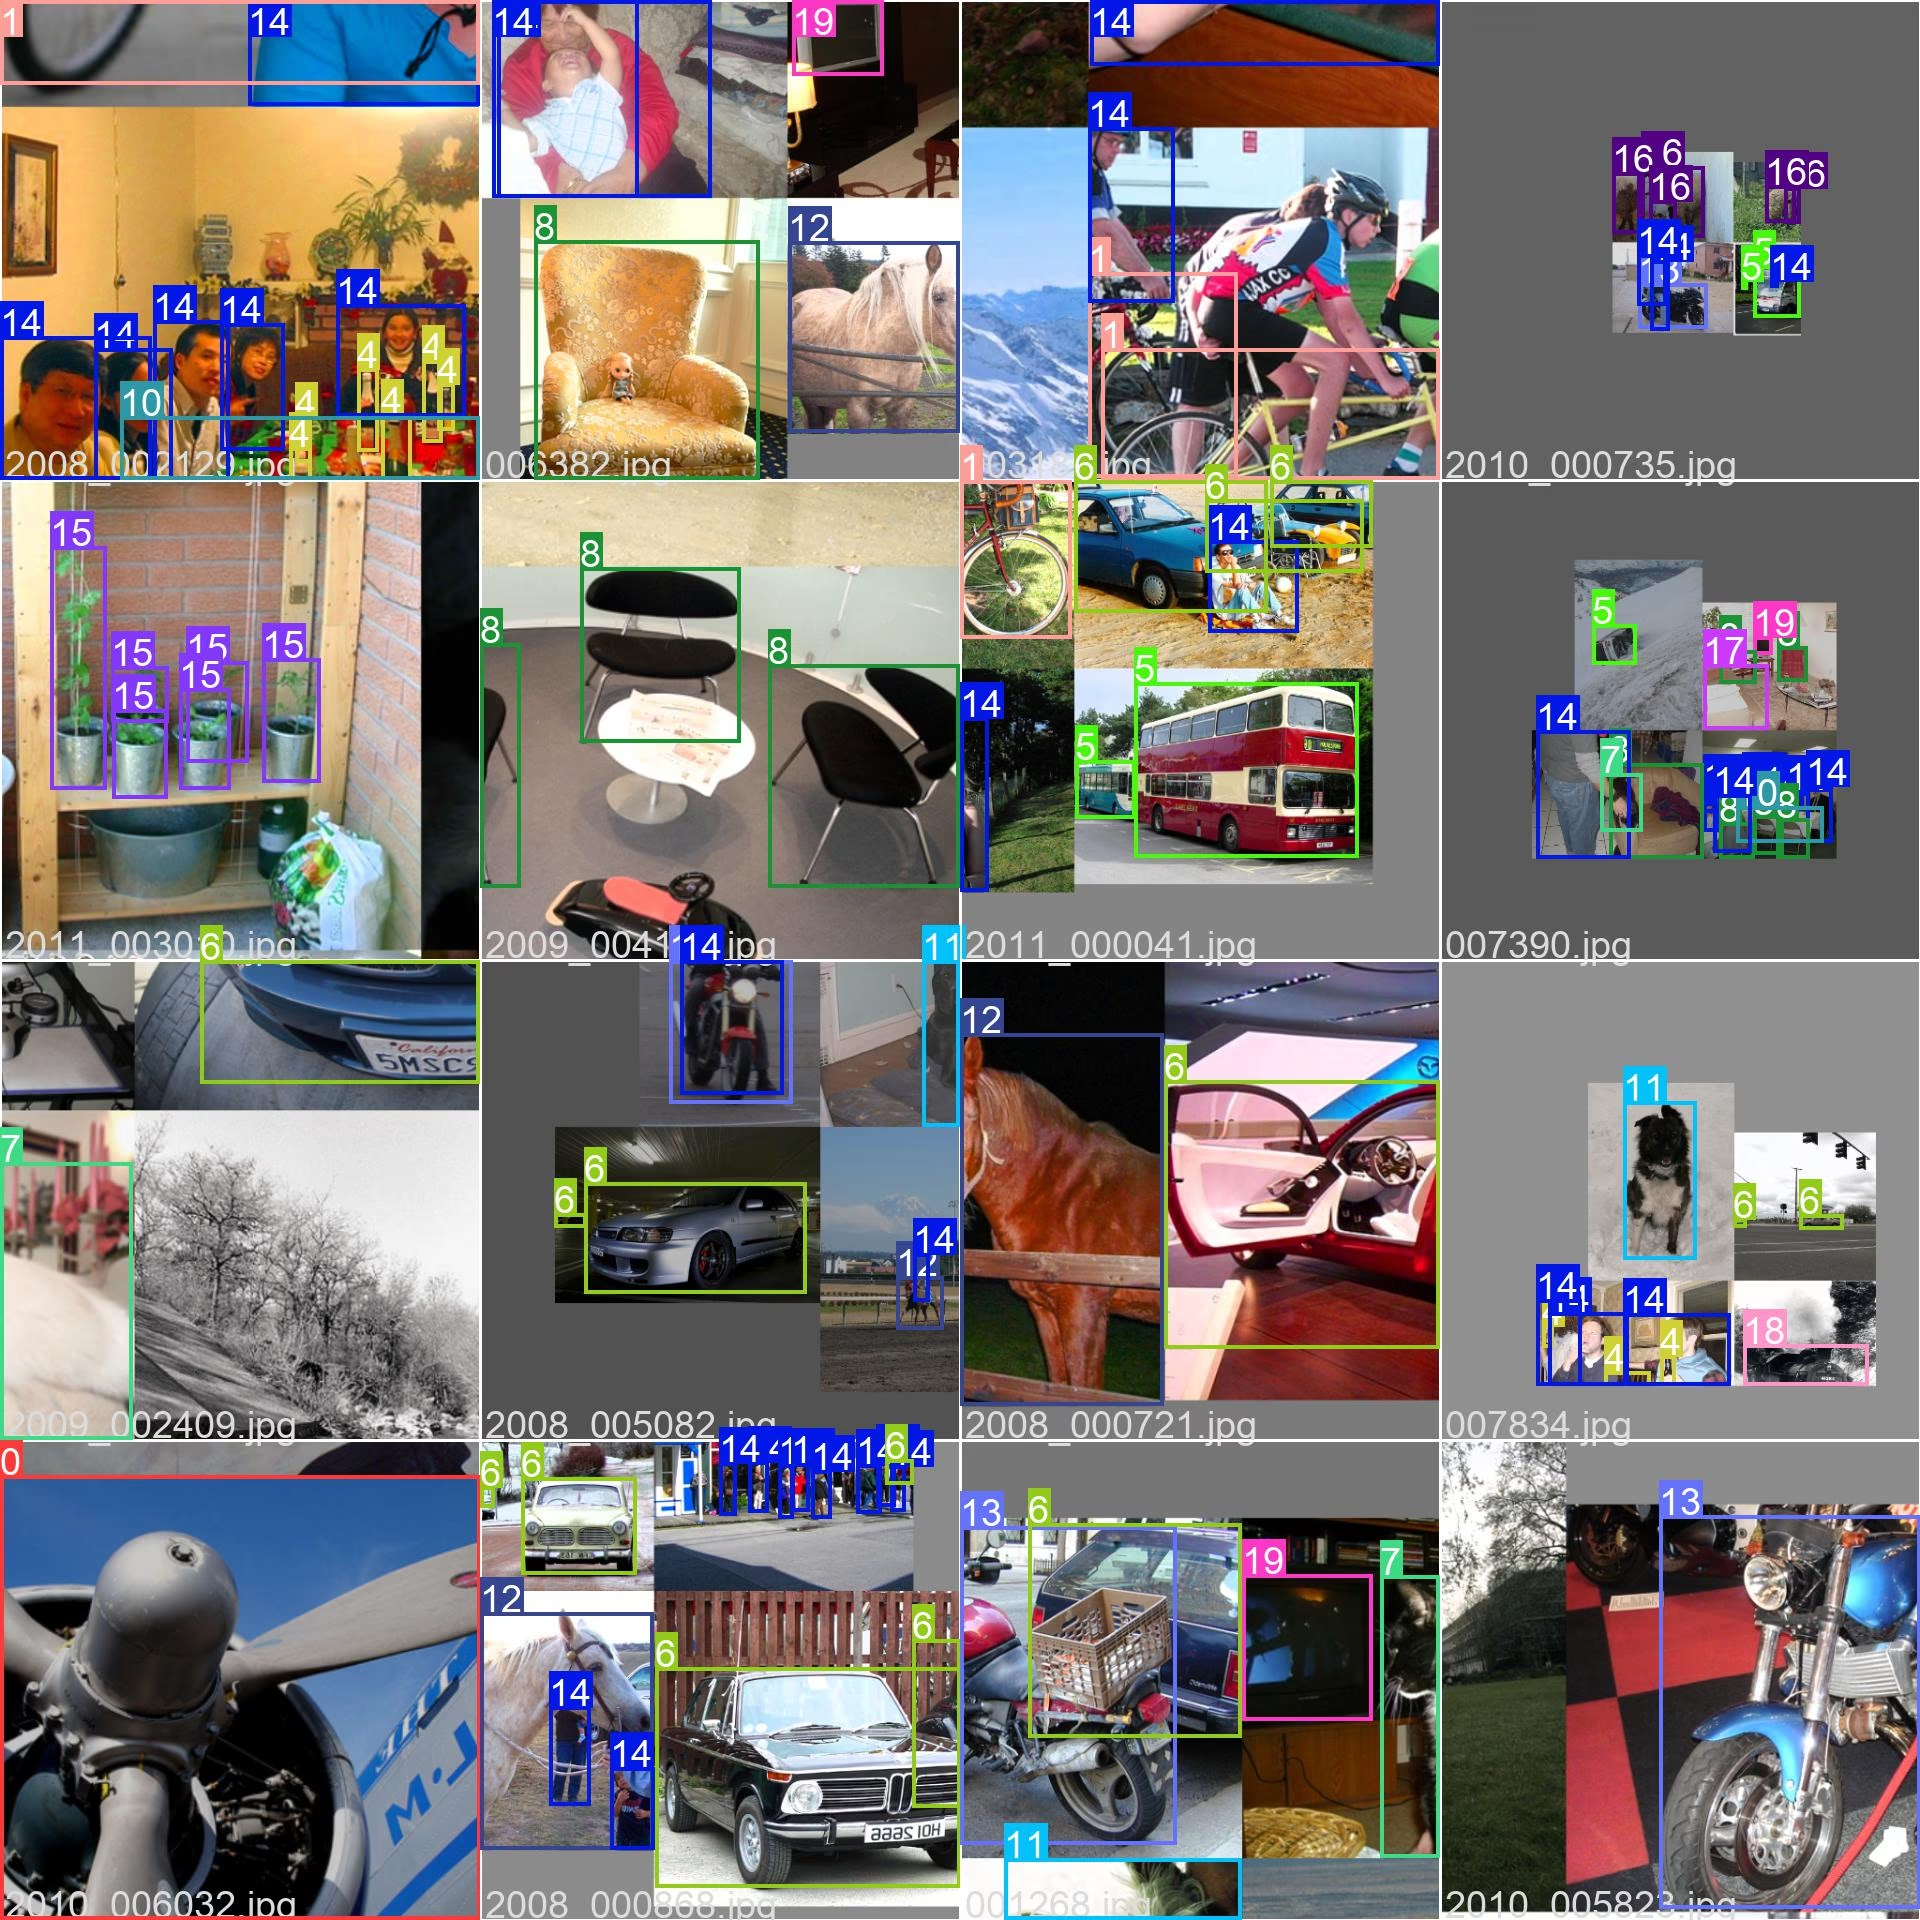
Das folgende Bild zeigt einen mosaikierten Trainingsbatch aus dem VOC-Datensatz. Beim Mosaikverfahren werden mehrere Bilder zu einer einzelnen Trainingsprobe kombiniert. Dadurch erhöhen sich die Vielfalt der Objekte, Maßstäbe und Szenenkontexte, die das Modell in jedem Batch sieht. Weitere Informationen findest du im YOLO-Leitfaden zur Datenerweiterung.
Zitate und Danksagungen#
Wenn du den VOC-Datensatz in deiner Forschung oder Entwicklungsarbeit verwendest, zitiere bitte die folgende Arbeit:
@article{everingham2010pascal,
  author={Everingham, Mark and Van Gool, Luc and Williams, Christopher K. I. and Winn, John and Zisserman, Andrew},
  journal={International Journal of Computer Vision},
  title={The Pascal Visual Object Classes (VOC) Challenge},
  year={2010},
  volume={88},
  number={2},
  pages={303-338},
  doi={10.1007/s11263-009-0275-4}}
Wir möchten dem PASCAL VOC Consortium dafür danken, dass es diese wertvolle Ressource für die Computer-Vision-Community geschaffen hat und pflegt. Weitere Informationen zum VOC-Datensatz und seinen Erstellern findest du auf der Website des PASCAL-VOC-Datensatzes.
Häufig gestellte Fragen#
PASCAL VOC wird zum Trainieren und Benchmarking von Objekterkennungsmodellen mit 20 alltäglichen Objektklassen wie Person, Auto, Hund und Stuhl verwendet. Da der Datensatz kompakt und vollständig annotiert ist und auf jahrelang veröffentlichten Baselines beruht, wird er häufig zur Validierung neuer Architekturen, für Kursprojekte und für schnelle Studien zum Transfer Learning eingesetzt.
Die Ultralytics-VOC-Konfiguration enthält 21.503 Bilder: 16.551 zum Trainieren (VOC2007 trainval + VOC2012 trainval) und 4.952 zur Validierung (der VOC2007-Testsatz). Alle Teilmengen verwenden dieselben 20 Klassen. Die vollständige Aufschlüsselung findest du unter Datensatzstruktur.
VOC wird beim ersten Training mit
data="VOC.yaml"automatisch heruntergeladen – manuelle Schritte sind nicht erforderlich. Das Skript lädt drei Archive (2,8 GB) aus den Release-Dateien von Ultralytics auf GitHub herunter und konvertiert die XML-Annotationen ins YOLO-Format.Trainiere ein YOLO26n-Modell 100 Epochen lang mit VOC und einer Bildgröße von 640:
Trainingsbeispielfrom ultralytics import YOLO # Ein Modell laden model = YOLO("yolo26n.pt") # ein vortrainiertes Modell laden (für das Training empfohlen) # Das Modell trainieren results = model.train(data="VOC.yaml", epochs=100, imgsz=640)Ausführliche Konfigurationen findest du auf der Seite Training und in den Tipps zum Modelltraining.
Beide Wettbewerbe verwenden dieselben 20 Klassen, enthalten aber unterschiedliche Bilder. VOC2007 umfasst 5.011 trainval-Bilder sowie einen Testsatz mit 4.952 Bildern, dessen Annotationen öffentlich verfügbar sind. VOC2012 umfasst 11.540 trainval-Bilder; die Annotationen des Testsatzes werden jedoch zurückgehalten und ausschließlich über den offiziellen Bewertungsserver ausgewertet. Die Ultralytics-Konfiguration
VOC.yamlführt beide trainval-Teilmengen zum Trainieren zusammen und validiert anhand des VOC2007-Testsatzes.VOC ist kleiner und einfacher: 20 Klassen und 21.503 Bilder im Vergleich zu COCO mit 80 Klassen und 330.000 Bildern. VOC-Ergebnisse werden traditionell als mAP bei 0.5 IoU angegeben, während COCO den mAP über IoU-Schwellenwerte von 0.5 bis 0.95 mittelt. Mit VOC lässt sich deutlich schneller trainieren, weshalb sich der Datensatz für schnelle Experimente eignet. Der COCO-Datensatz ist der Standard für Benchmarking im Produktionsmaßstab.
Nein –
VOC.yamlist eine Konfiguration ausschließlich für Objekterkennung: Der Konverter extrahiert Begrenzungsrahmen aus den VOC-XML-Annotationen, die im ursprünglichen Benchmark enthaltenen Segmentierungsmasken werden jedoch nicht konvertiert. Für das Training eines Modells zur Instanzsegmentierung verwendest du einen Datensatz mit Polygonbeschriftungen, etwa COCO-Seg, zusammen mit einemyolo26n-seg.pt-Modell.