Exportación a Intel OpenVINO#
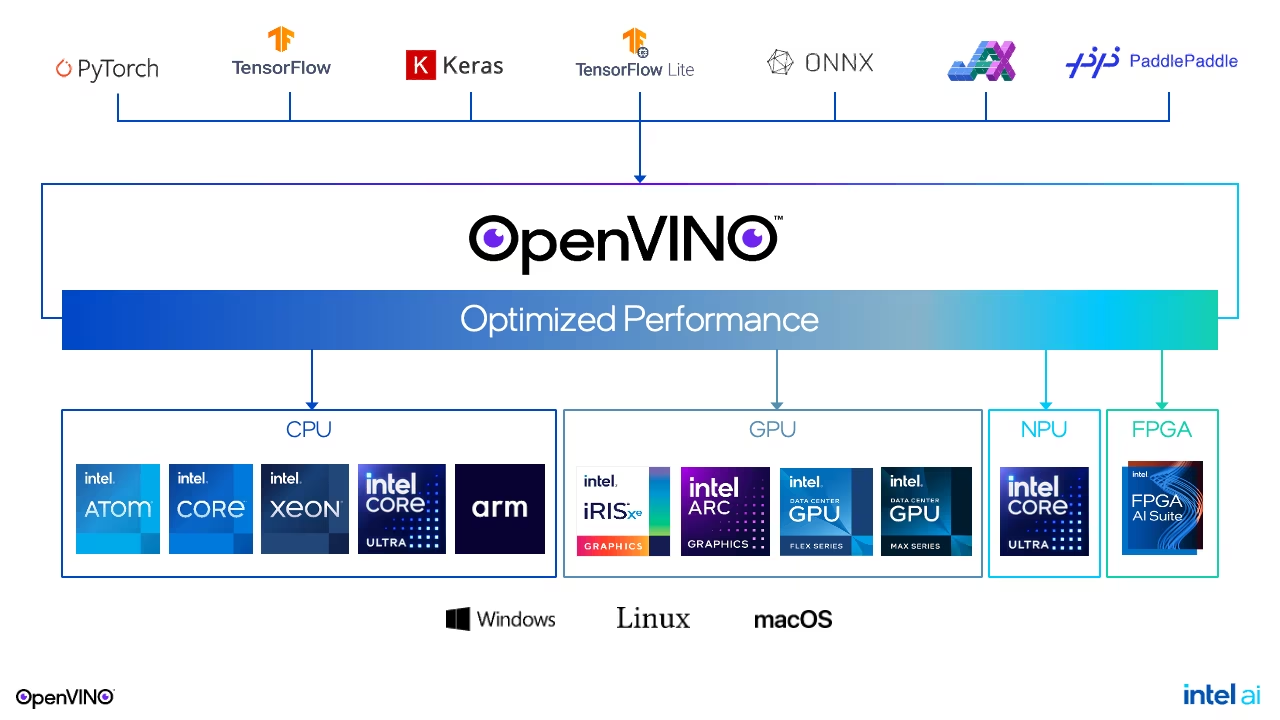
En esta guía explicamos cómo exportar modelos YOLO26 al formato OpenVINO, que puede ofrecer hasta 3 veces más velocidad en CPU, además de acelerar la inferencia de YOLO en el hardware GPU y NPU de Intel.
OpenVINO, abreviatura de kit de herramientas de inferencia visual abierta y optimización de redes neuronales, es un completo kit de herramientas para optimizar e implementar modelos de inferencia de IA. Aunque el nombre incluye «Visual», OpenVINO también admite diversas tareas adicionales, como el lenguaje, el audio y las series temporales.
Ver: Cómo exportar Ultralytics YOLO26 al formato Intel OpenVINO para acelerar la inferencia 🚀
Tareas compatibles#
La exportación a OpenVINO es compatible con las siete tareas de Ultralytics. La segmentación semántica y la estimación de profundidad solo están disponibles con YOLO26, la única familia que incluye esos cabezales.
| Tarea | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Detectar | ✅ | ✅ | ✅ |
| Segmentar | ✅ | ✅ | ✅ |
| Semántica | ❌ | ❌ | ✅ |
| Profundidad | ❌ | ❌ | ✅ |
| Clasificar | ✅ | ✅ | ✅ |
| Pose | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Instalación#
Instala las dependencias de exportación de OpenVINO con:
pip install "ultralytics[export-openvino]"Estas dependencias también se incluyen en ultralytics[export] y se instalan automáticamente cuando se necesitan para una exportación.
Ejemplos de uso#
El formato OpenVINO admite los modos Exportar, Predecir y Validar. Exporta el modelo y, después, cárgalo para ejecutar inferencias o validar su precisión en una CPU Intel, una GPU integrada o discreta, o una NPU.
from ultralytics import YOLO

# Carga un modelo YOLO26
model = YOLO("yolo26n.pt")

# Exporta el modelo al formato OpenVINO
model.export(format="openvino") # creates 'yolo26n_openvino_model/'from ultralytics import YOLO
# Carga el modelo OpenVINO exportado
model = YOLO("yolo26n_openvino_model/")
# Ejecutar inferencia
results = model("https://ultralytics.com/images/bus.jpg")
# Ejecuta inferencias en un dispositivo concreto. Dispositivos disponibles: ["intel:gpu", "intel:npu", "intel:cpu"]
results = model("https://ultralytics.com/images/bus.jpg", device="intel:gpu")from ultralytics import YOLO
# Carga el modelo OpenVINO exportado
model = YOLO("yolo26n_openvino_model/")
# Valida la precisión con el conjunto de datos COCO8
metrics = model.val(data="coco8.yaml")Argumentos de exportación#
| Argumento | Tipo | Predeterminado | Descripción |
|---|---|---|---|
format | str | 'openvino' | Formato de destino del modelo exportado, que define su compatibilidad con distintos entornos de implementación. |
imgsz | int o tuple | 640 | Tamaño de imagen deseado para la entrada del modelo. Puede ser un número entero para imágenes cuadradas o una tupla (height, width) para dimensiones específicas. |
quantize | int o str | None | Precisión de cuantización: 16 (FP16) o 8 (INT8/PTQ; requiere calibración data/fraction); 32/sin definir corresponde a FP32. Sustituye las opciones obsoletas half/int8. |
dynamic | bool | False | Permite tamaños de entrada dinámicos, lo que aumenta la flexibilidad para trabajar con imágenes de distintas dimensiones. |
nms | bool, opcional | None | Selecciona la salida sin procesar (None, predeterminada), NMS integrada (True) o el cabezal sin NMS (False). |
batch | int | 1 | Especifica el tamaño del lote de inferencia del modelo exportado o el número máximo de imágenes que el modelo exportado procesará simultáneamente en el modo predict. |
data | str | None | Ruta al archivo YAML del conjunto de datos, imprescindible para la cuantización; en clasificación, en su lugar se indica un directorio del conjunto de datos o el nombre de un conjunto de datos integrado. Si se omite con quantize=8, Ultralytics selecciona el conjunto de datos de calibración predeterminado para la tarea del modelo. |
fraction | float, int o list | 1.0 | Subconjunto de calibración expresado como proporción, número de imágenes o proporciones/recuentos [train, val, test]. Las listas de dos elementos dejan completo test, mientras que 0 lo omite. |
device | str | None | Especifica el dispositivo para la exportación: CPU (device=cpu) o MPS para Apple silicon (device=mps). |
Para obtener más información sobre el proceso de exportación, visita la página de documentación de Ultralytics sobre exportación.
OpenVINO™ es compatible con la mayoría de los procesadores Intel®, pero, para garantizar un rendimiento óptimo:
-
Comprueba la compatibilidad con OpenVINO™ Comprueba si tu chip Intel® es oficialmente compatible con OpenVINO™ en la lista de compatibilidad de Intel.
-
Identifica el acelerador Averigua si tu procesador incluye una NPU (unidad de procesamiento neuronal) o una GPU integrada consultando la guía de hardware de Intel.
-
Instala los controladores más recientes Si tu chip es compatible con una NPU o una GPU, pero OpenVINO™ no la detecta, quizá tengas que instalar o actualizar los controladores correspondientes. Sigue las instrucciones de instalación de los controladores para habilitar toda la aceleración.
Sigue estos tres pasos para asegurarte de que OpenVINO™ funciona de forma óptima en tu hardware Intel®.
Ventajas de OpenVINO#
- Rendimiento: OpenVINO ofrece inferencias de alto rendimiento al aprovechar la potencia de las CPU, las GPU integradas y discretas y las FPGA de Intel.
- Compatibilidad con la ejecución heterogénea: OpenVINO ofrece una API que permite escribir una vez e implementar en cualquier hardware Intel compatible (CPU, GPU, FPGA, VPU, etc.).
- Optimizador de modelos: OpenVINO incluye un optimizador de modelos que importa, convierte y optimiza modelos de frameworks populares de aprendizaje profundo, como PyTorch, TensorFlow, TensorFlow Lite, Keras, ONNX, PaddlePaddle y Caffe.
- Facilidad de uso: el kit de herramientas incluye una amplia colección de cuadernos de tutorial (incluida la optimización de YOLO26) que enseñan distintos aspectos del kit.
Estructura de exportación de OpenVINO#
Al exportar un modelo al formato OpenVINO, se crea un directorio que contiene lo siguiente:
- Archivo XML: describe la topología de la red.
- Archivo BIN: contiene los datos binarios de los pesos y sesgos.
- Archivo de metadatos:
metadata.yamlalmacena metadatos del modelo, como los nombres de las clases, el tamaño de la imagen y la tarea, que Ultralytics lee al cargar el modelo.
Puedes utilizar estos archivos para ejecutar inferencias con OpenVINO Runtime.
Uso de la exportación a OpenVINO en la implementación#
Una vez que hayas exportado correctamente el modelo al formato OpenVINO, tienes dos opciones principales para ejecutar inferencias:
-
Utiliza el paquete
ultralytics, que proporciona una API de alto nivel y encapsula OpenVINO Runtime. -
Utiliza el paquete nativo
openvinopara tener un control más avanzado o personalizado sobre el comportamiento de la inferencia.
Inferencia con Ultralytics#
El paquete ultralytics te permite ejecutar fácilmente inferencias con el modelo OpenVINO exportado mediante el método predict. También puedes especificar el dispositivo de destino (por ejemplo, intel:gpu, intel:npu, intel:cpu) con el argumento device.
from ultralytics import YOLO

# Carga el modelo OpenVINO exportado
ov_model = YOLO("yolo26n_openvino_model/")  # la ruta de tu modelo OpenVINO exportado
# Ejecuta inferencias con el modelo exportado
ov_model.predict(device="intel:gpu")  # especifica el dispositivo en el que quieres ejecutar inferencias
Este método es ideal para crear prototipos rápidamente o para implementar el modelo cuando no necesitas tener un control total sobre el flujo de inferencia.
Inferencia con OpenVINO Runtime#
OpenVINO Runtime ofrece una API unificada para ejecutar inferencias en todo el hardware Intel compatible. También proporciona funciones avanzadas, como el equilibrio de carga entre el hardware Intel y la ejecución asíncrona. Para obtener más información sobre cómo ejecutar inferencias, consulta los cuadernos de YOLO26.
Recuerda que necesitarás los archivos XML y BIN, así como cualquier configuración específica de la aplicación, como el tamaño de entrada o el factor de escala para la normalización, entre otros, para configurar y utilizar correctamente el modelo con Runtime.
En tu aplicación de implementación, normalmente seguirías estos pasos:
- Inicializa OpenVINO creando
core = Core(). - Carga el modelo con el método
core.read_model(). - Compila el modelo con la función
core.compile_model(). - Prepara la entrada (imagen, texto, audio, etc.).
- Ejecuta inferencias con
compiled_model(input_data).
Para ver pasos más detallados y fragmentos de código, consulta la documentación de OpenVINO o el tutorial de la API.
Pruebas de rendimiento de YOLO26 con OpenVINO#
El equipo de Ultralytics comparó YOLO26 en distintos formatos de modelo y niveles de precisión, y evaluó la velocidad y la precisión en diferentes dispositivos Intel compatibles con OpenVINO.
-
Los resultados de las pruebas de rendimiento que se muestran a continuación son orientativos y pueden variar según la configuración exacta del hardware y el software de un sistema, así como la carga de trabajo del sistema en el momento de realizar las pruebas.
-
Todas las pruebas de rendimiento se ejecutaron con la versión 2026.2.1 del paquete Python
openvino. -
Los modelos YOLO26 en NPU solo son compatibles con sistemas Intel® Core™ Ultra™ de las series 2xxV y 3xx, y posteriores.
Intel® Core™ Ultra#
La serie Intel® Core™ Ultra™ establece un nuevo referente en computación de alto rendimiento y está diseñada para satisfacer las necesidades cambiantes de los usuarios actuales, desde jugadores y creadores hasta profesionales que aprovechan la IA. Esta gama de nueva generación es mucho más que una serie de CPU tradicional: combina núcleos de CPU potentes, capacidades de GPU integrada de alto rendimiento y una unidad de procesamiento neuronal (NPU) dedicada en un solo chip, para ofrecer una solución unificada para cargas de trabajo informáticas diversas e intensivas.
La arquitectura Intel® Core Ultra™ se basa en un diseño híbrido que permite ofrecer un rendimiento excepcional en tareas de procesamiento tradicionales, cargas de trabajo aceleradas por GPU y operaciones basadas en IA. La inclusión de la NPU mejora la inferencia de IA en el dispositivo, lo que permite un aprendizaje automático y un procesamiento de datos más rápidos y eficientes en una amplia variedad de aplicaciones.
La familia Core Ultra™ incluye diversos modelos adaptados a distintas necesidades de rendimiento, desde diseños de bajo consumo hasta variantes de alta potencia con la designación «H», ideales para portátiles y formatos compactos que requieren una gran capacidad de cálculo. En toda la gama, los usuarios se benefician de la integración sinérgica de CPU, GPU y NPU, que ofrece una eficiencia, una capacidad de respuesta y una aptitud para la multitarea extraordinarias.
Como parte de la innovación continua de Intel, la serie Core Ultra™ establece un nuevo estándar para la informática preparada para el futuro. Con varios modelos disponibles y más por llegar, esta serie pone de manifiesto el compromiso de Intel con el desarrollo de soluciones de vanguardia para la próxima generación de dispositivos inteligentes mejorados con IA.
Las pruebas de rendimiento que se muestran a continuación se realizaron en Intel® Core™ Ultra™ X7 358H, Intel® Core™ Ultra™ 7 258V e Intel® Core™ Ultra™ 7 155H con precisiones FP32, FP16 e INT8.
Intel® Core™ Ultra™ X7 358H#
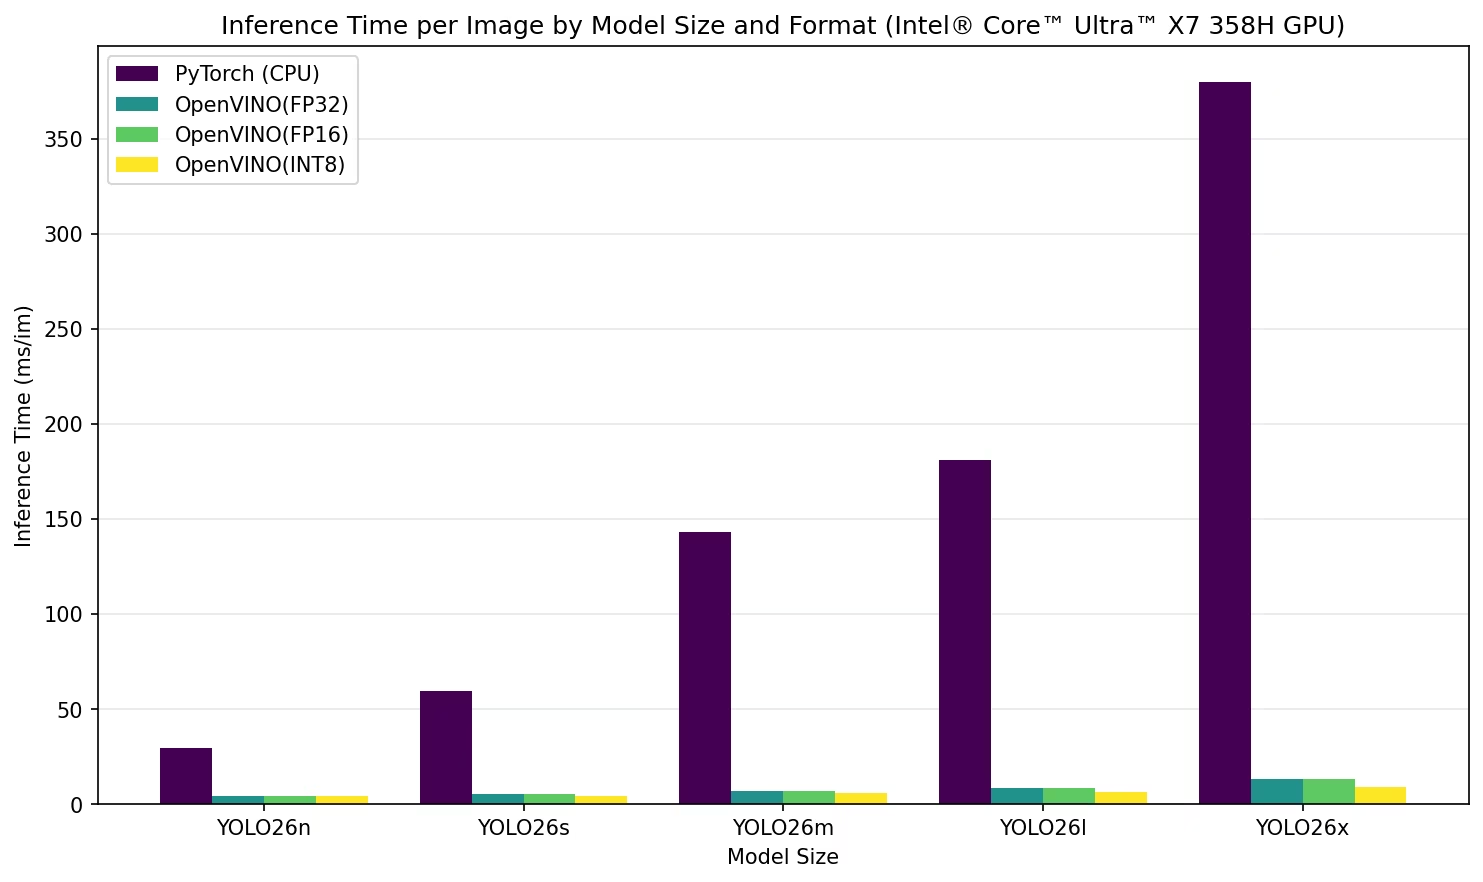
Resultados detallados de las pruebas de rendimiento
| Modelo | Formato | Precisión | Estado | Tamaño (MB) | metrics/mAP50-95(B) | Tiempo de inferencia (ms/im) |
|---|---|---|---|---|---|---|
| YOLO26n | PyTorch (CPU) | FP32 | ✅ | 5.3 | 0.4765 | 29.28 |
| YOLO26n | OpenVINO | FP32 | ✅ | 9.7 | 0.4762 | 4.09 |
| YOLO26n | OpenVINO | FP16 | ✅ | 5.1 | 0.4762 | 4.03 |
| YOLO26n | OpenVINO | INT8 | ✅ | 3.2 | 0.4634 | 4.24 |
| YOLO26s | PyTorch (CPU) | FP32 | ✅ | 19.5 | 0.5703 | 59.32 |
| YOLO26s | OpenVINO | FP32 | ✅ | 36.7 | 0.5616 | 5.08 |
| YOLO26s | OpenVINO | FP16 | ✅ | 18.7 | 0.5616 | 5.14 |
| YOLO26s | OpenVINO | INT8 | ✅ | 10.0 | 0.5462 | 4.47 |
| YOLO26m | PyTorch (CPU) | FP32 | ✅ | 42.2 | 0.6196 | 143.21 |
| YOLO26m | OpenVINO | FP32 | ✅ | 78.4 | 0.6166 | 7.1 |
| YOLO26m | OpenVINO | FP16 | ✅ | 39.5 | 0.6166 | 7.06 |
| YOLO26m | OpenVINO | INT8 | ✅ | 20.6 | 0.6055 | 5.61 |
| YOLO26l | PyTorch (CPU) | FP32 | ✅ | 50.7 | 0.6215 | 181.16 |
| YOLO26l | OpenVINO | FP32 | ✅ | 95.3 | 0.6205 | 8.45 |
| YOLO26l | OpenVINO | FP16 | ✅ | 48.1 | 0.6205 | 8.49 |
| YOLO26l | OpenVINO | INT8 | ✅ | 25.2 | 0.5938 | 6.25 |
| YOLO26x | PyTorch (CPU) | FP32 | ✅ | 113.2 | 0.6512 | 379.75 |
| YOLO26x | OpenVINO | FP32 | ✅ | 213.3 | 0.6568 | 13.03 |
| YOLO26x | OpenVINO | FP16 | ✅ | 107.1 | 0.6568 | 12.98 |
| YOLO26x | OpenVINO | INT8 | ✅ | 54.8 | 0.6385 | 8.74 |
Intel® Core™ Ultra™ 7 258V#
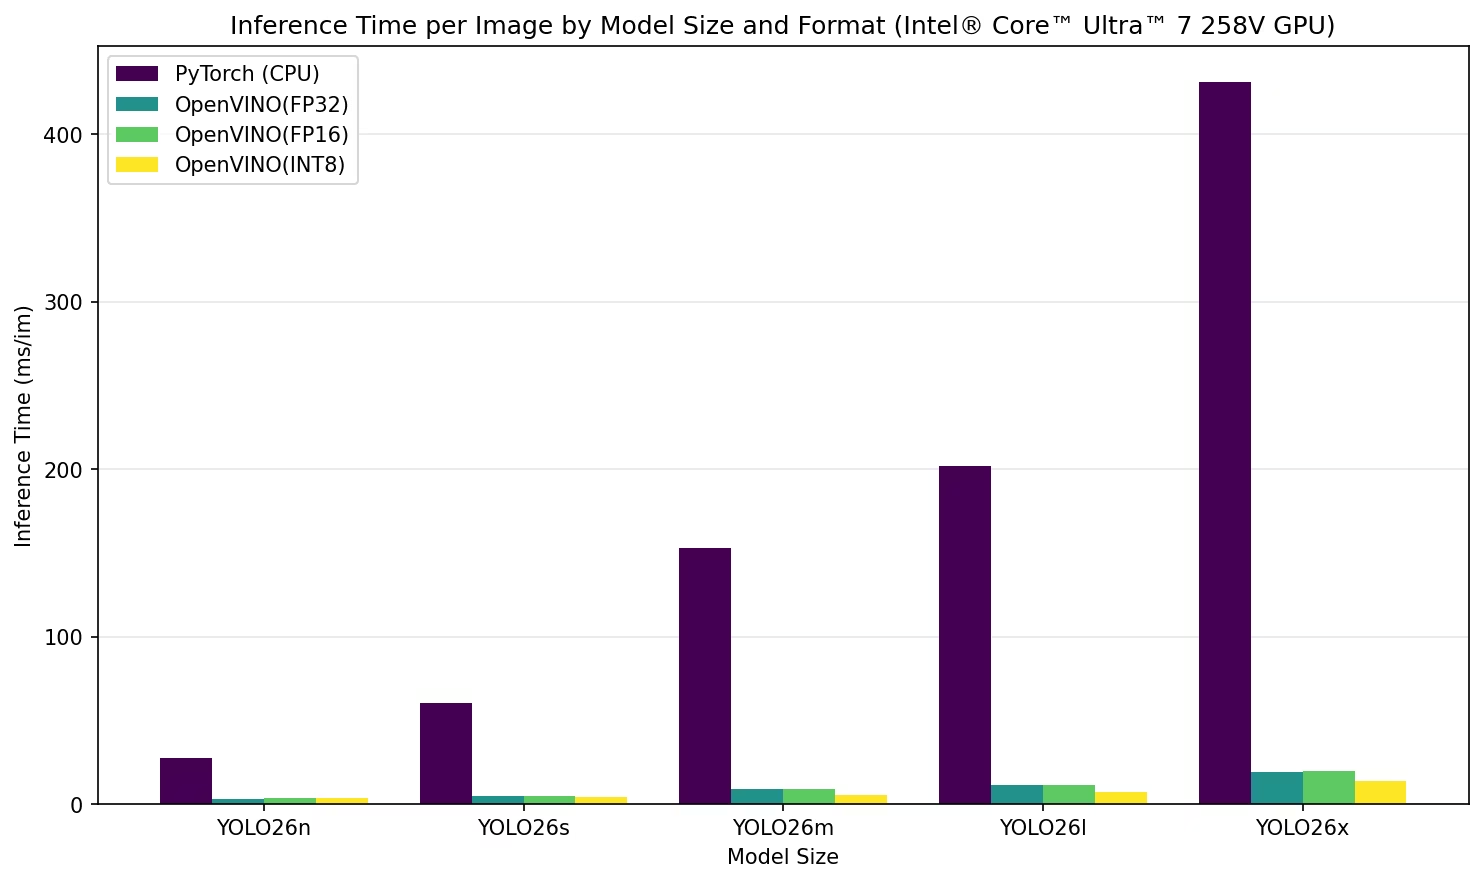
Resultados detallados de las pruebas de rendimiento
| Modelo | Formato | Precisión | Estado | Tamaño (MB) | metrics/mAP50-95(B) | Tiempo de inferencia (ms/im) |
|---|---|---|---|---|---|---|
| YOLO26n | PyTorch (CPU) | FP32 | ✅ | 5.3 | 0.4765 | 27.33 |
| YOLO26n | OpenVINO | FP32 | ✅ | 9.6 | 0.4764 | 3.33 |
| YOLO26n | OpenVINO | FP16 | ✅ | 5.1 | 0.4764 | 3.34 |
| YOLO26n | OpenVINO | INT8 | ✅ | 3.2 | 0.4634 | 3.46 |
| YOLO26s | PyTorch (CPU) | FP32 | ✅ | 19.5 | 0.5703 | 60.2 |
| YOLO26s | OpenVINO | FP32 | ✅ | 36.7 | 0.5616 | 4.66 |
| YOLO26s | OpenVINO | FP16 | ✅ | 18.6 | 0.5616 | 4.65 |
| YOLO26s | OpenVINO | INT8 | ✅ | 10.0 | 0.5462 | 3.99 |
| YOLO26m | PyTorch (CPU) | FP32 | ✅ | 42.2 | 0.6196 | 152.87 |
| YOLO26m | OpenVINO | FP32 | ✅ | 78.4 | 0.6168 | 9.03 |
| YOLO26m | OpenVINO | FP16 | ✅ | 39.5 | 0.6168 | 8.98 |
| YOLO26m | OpenVINO | INT8 | ✅ | 20.6 | 0.6055 | 5.7 |
| YOLO26l | PyTorch (CPU) | FP32 | ✅ | 50.7 | 0.6215 | 201.57 |
| YOLO26l | OpenVINO | FP32 | ✅ | 95.3 | 0.6203 | 11.32 |
| YOLO26l | OpenVINO | FP16 | ✅ | 48.1 | 0.6203 | 11.36 |
| YOLO26l | OpenVINO | INT8 | ✅ | 25.2 | 0.5938 | 7.45 |
| YOLO26x | PyTorch (CPU) | FP32 | ✅ | 113.2 | 0.6512 | 431.04 |
| YOLO26x | OpenVINO | FP32 | ✅ | 213.2 | 0.6568 | 19.08 |
| YOLO26x | OpenVINO | FP16 | ✅ | 107.1 | 0.6568 | 19.63 |
| YOLO26x | OpenVINO | INT8 | ✅ | 54.8 | 0.6385 | 13.69 |
Intel® Core™ Ultra™ 7 155H#
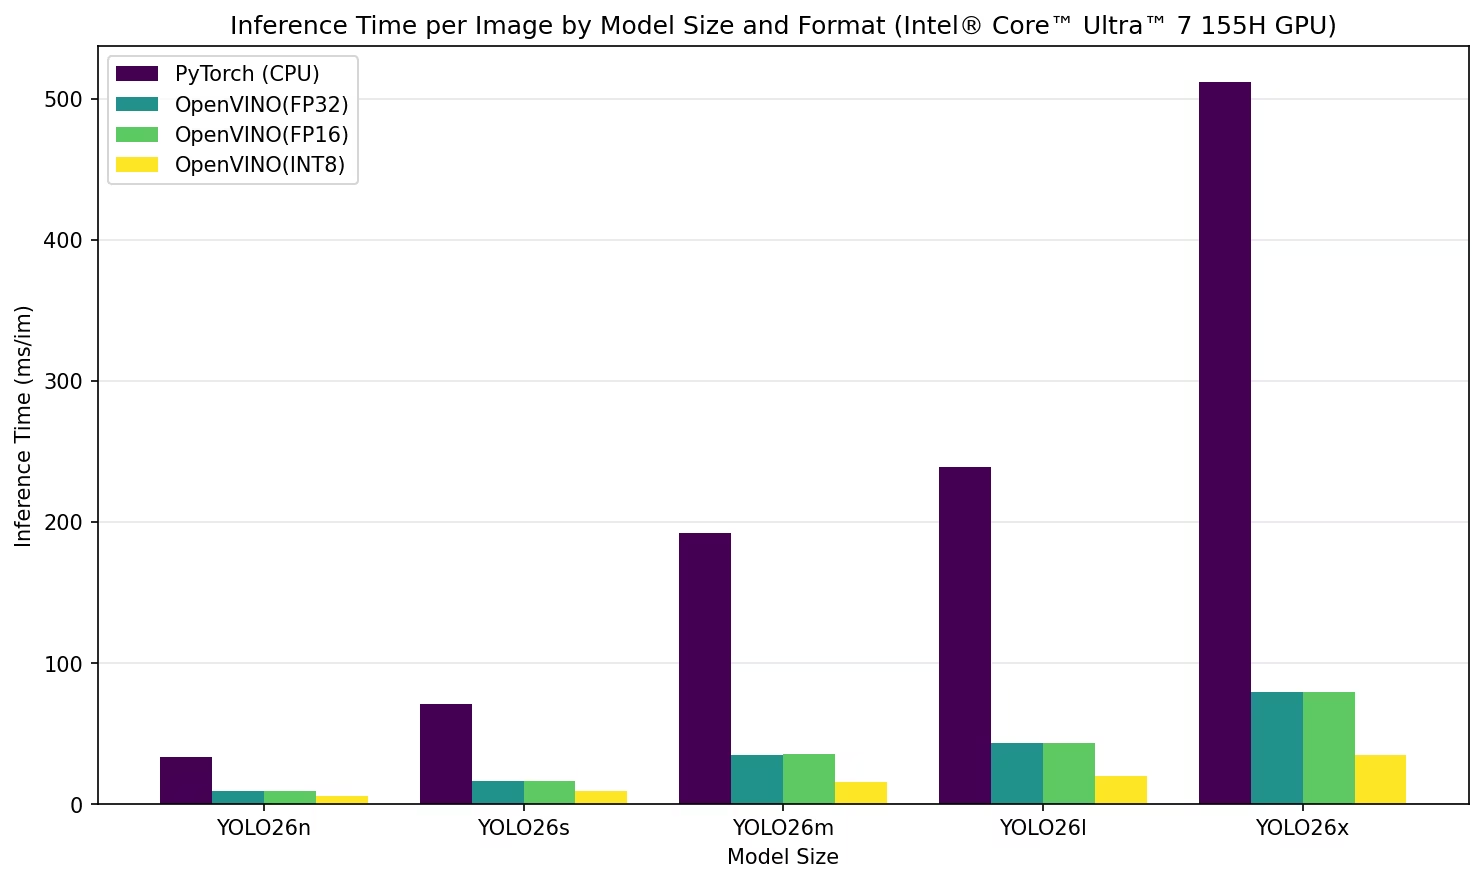
Resultados detallados de las pruebas de rendimiento
| Modelo | Formato | Precisión | Estado | Tamaño (MB) | metrics/mAP50-95(B) | Tiempo de inferencia (ms/im) |
|---|---|---|---|---|---|---|
| YOLO26n | PyTorch (CPU) | FP32 | ✅ | 5.3 | 0.4765 | 33.19 |
| YOLO26n | OpenVINO | FP32 | ✅ | 9.6 | 0.4758 | 9.13 |
| YOLO26n | OpenVINO | FP16 | ✅ | 5.1 | 0.4758 | 9.07 |
| YOLO26n | OpenVINO | INT8 | ✅ | 3.2 | 0.4573 | 5.79 |
| YOLO26s | PyTorch (CPU) | FP32 | ✅ | 19.5 | 0.5703 | 70.92 |
| YOLO26s | OpenVINO | FP32 | ✅ | 36.7 | 0.5616 | 16.37 |
| YOLO26s | OpenVINO | FP16 | ✅ | 18.6 | 0.5616 | 16.65 |
| YOLO26s | OpenVINO | INT8 | ✅ | 10.0 | 0.545 | 9.27 |
| YOLO26m | PyTorch (CPU) | FP32 | ✅ | 42.2 | 0.6196 | 192.45 |
| YOLO26m | OpenVINO | FP32 | ✅ | 78.4 | 0.6167 | 34.47 |
| YOLO26m | OpenVINO | FP16 | ✅ | 39.5 | 0.6167 | 35.71 |
| YOLO26m | OpenVINO | INT8 | ✅ | 20.6 | 0.6039 | 15.46 |
| YOLO26l | PyTorch (CPU) | FP32 | ✅ | 50.7 | 0.6215 | 239.19 |
| YOLO26l | OpenVINO | FP32 | ✅ | 95.3 | 0.621 | 43.24 |
| YOLO26l | OpenVINO | FP16 | ✅ | 48.1 | 0.621 | 43.4 |
| YOLO26l | OpenVINO | INT8 | ✅ | 25.2 | 0.5999 | 19.72 |
| YOLO26x | PyTorch (CPU) | FP32 | ✅ | 113.2 | 0.6512 | 511.89 |
| YOLO26x | OpenVINO | FP32 | ✅ | 213.2 | 0.6552 | 79.49 |
| YOLO26x | OpenVINO | FP16 | ✅ | 107.1 | 0.6552 | 79.45 |
| YOLO26x | OpenVINO | INT8 | ✅ | 54.8 | 0.642 | 34.66 |
Reproduce nuestros resultados#
Para reproducir las pruebas de rendimiento de Ultralytics anteriores en todos los formatos de exportación, ejecuta este código:
from ultralytics import YOLO

# Carga un modelo YOLO26n de PyTorch
model = YOLO("yolo26n.pt")

# Prueba la velocidad y la precisión de YOLO26n en el conjunto de datos COCO128 con todos los formatos de exportación
results = model.benchmark(data="coco128.yaml")
Ten en cuenta que los resultados de las pruebas de rendimiento pueden variar según la configuración exacta del hardware y el software de un sistema, así como la carga de trabajo del sistema en el momento de realizarlas. Para obtener los resultados más fiables, utiliza un conjunto de datos con un gran número de imágenes, por ejemplo, data='coco.yaml' (5000 imágenes de validación).
Conclusión#
Los resultados de las pruebas comparativas demuestran claramente las ventajas de exportar el modelo YOLO26 al formato OpenVINO. En distintos modelos y plataformas de hardware, el formato OpenVINO supera sistemáticamente a otros formatos en velocidad de inferencia, al tiempo que mantiene una precisión comparable.
Las pruebas comparativas ponen de relieve la eficacia de OpenVINO como herramienta para implementar modelos de aprendizaje profundo. Al convertir los modelos al formato OpenVINO, los desarrolladores pueden mejorar significativamente el rendimiento, lo que facilita la implementación de estos modelos en aplicaciones del mundo real.
Para obtener información e instrucciones más detalladas sobre el uso de OpenVINO, consulta la documentación oficial de OpenVINO.
Preguntas frecuentes#
Exportar modelos YOLO26 al formato OpenVINO puede mejorar significativamente la velocidad de la CPU y habilitar la aceleración de GPU y NPU en hardware Intel. Para exportar, puedes usar Python o CLI, como se muestra a continuación:
Ejemplofrom ultralytics import YOLO # Carga un modelo YOLO26n de PyTorch model = YOLO("yolo26n.pt") # Exporta el modelo model.export(format="openvino") # creates 'yolo26n_openvino_model/'Para obtener más información, consulta la documentación sobre formatos de exportación.
El kit de herramientas OpenVINO de Intel ofrece varias ventajas con los modelos YOLO26:
- Rendimiento: consigue hasta 3 veces más velocidad en la inferencia con CPU y aprovecha las GPU y NPU de Intel para acelerar el proceso.
- Optimizador de modelos: convierte, optimiza y ejecuta modelos de marcos de trabajo populares como PyTorch, TensorFlow y ONNX.
- Facilidad de uso: hay una amplia colección de cuadernos de tutoriales para ayudarte a empezar, incluidos algunos para YOLO26.
- Ejecución heterogénea: implementa modelos en distintos tipos de hardware Intel con una API unificada.
Para ver comparaciones detalladas del rendimiento, visita nuestra sección de pruebas comparativas.
Tras exportar un modelo YOLO26n al formato OpenVINO, puedes ejecutar la inferencia con Python o CLI:
Ejemplofrom ultralytics import YOLO # Carga el modelo OpenVINO exportado ov_model = YOLO("yolo26n_openvino_model/") # Ejecutar inferencia results = ov_model("https://ultralytics.com/images/bus.jpg")Consulta nuestra documentación del modo de predicción para obtener más información.
Ultralytics YOLO26 está optimizado para la detección de objetos en tiempo real con gran precisión y velocidad. En concreto, al combinarlo con OpenVINO, YOLO26 ofrece:
- Hasta 3 veces más velocidad en las CPU Intel
- Implementación sencilla en GPU y NPU Intel
- Precisión uniforme y comparable en distintos formatos de exportación
Para un análisis exhaustivo del rendimiento, consulta nuestras pruebas comparativas detalladas de YOLO26 en distintos tipos de hardware.
Sí, puedes comparar el rendimiento de los modelos YOLO26 en varios formatos, como PyTorch, TorchScript, ONNX y OpenVINO. Usa el siguiente fragmento de código para ejecutar las pruebas comparativas en el conjunto de datos que elijas:
Ejemplofrom ultralytics import YOLO # Carga un modelo YOLO26n de PyTorch model = YOLO("yolo26n.pt") # Compara la velocidad y la precisión de YOLO26n en el conjunto de datos COCO8 para todos los formatos de exportación results = model.benchmark(data="coco8.yaml")Para consultar los resultados detallados de las pruebas comparativas, visita nuestra sección de pruebas comparativas y la documentación sobre formatos de exportación.