Descubre cómo exportar YOLO26 al formato TF SavedModel#
Implementar modelos de aprendizaje automático puede ser complicado. Sin embargo, utilizar un formato de modelo eficiente y flexible puede facilitarte el trabajo. TF SavedModel es el formato de serialización estándar de TensorFlow para guardar y cargar modelos de aprendizaje automático de forma coherente. Es como una maleta para los modelos TensorFlow: facilita transportarlos y utilizarlos en distintos dispositivos y sistemas.
Aprender a exportar modelos Ultralytics YOLO26 a TF SavedModel puede ayudarte a implementar modelos fácilmente en distintas plataformas y entornos. En esta guía, te explicamos cómo convertir tus modelos al formato TF SavedModel para simplificar la ejecución de inferencias en distintos dispositivos.
¿Por qué exportar a TF SavedModel?#
El formato TensorFlow SavedModel forma parte del ecosistema TensorFlow desarrollado por Google, como se muestra a continuación. Está diseñado para guardar y serializar modelos TensorFlow de forma sencilla. Contiene todos los detalles de los modelos, como la arquitectura, los pesos e incluso la información de compilación. Esto facilita compartirlos, implementarlos y seguir entrenándolos en distintos entornos.
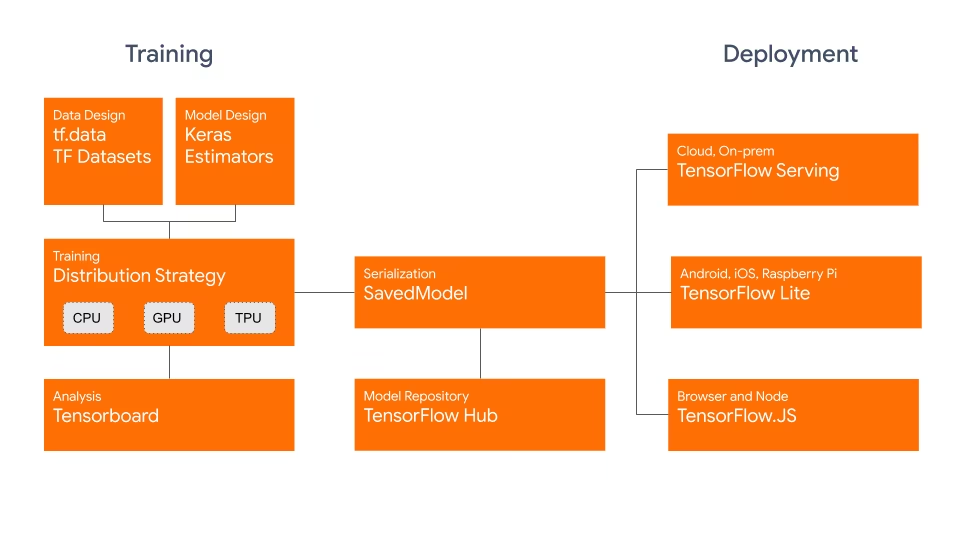
TF SavedModel tiene una ventaja clave: su compatibilidad. Funciona bien con TensorFlow Serving, LiteRT (antes TensorFlow Lite) y TensorFlow.js. Esta compatibilidad facilita compartir e implementar modelos en distintas plataformas, incluidas aplicaciones web y móviles. El formato TF SavedModel resulta útil tanto para la investigación como para la producción. Ofrece una forma unificada de gestionar tus modelos y garantiza que estén listos para cualquier aplicación.
Características principales de TF SavedModel#
Estas son las características principales que convierten TF SavedModel en una gran opción para desarrolladores de IA:
-
Portabilidad: TF SavedModel proporciona un formato de serialización independiente del lenguaje, recuperable y hermético. Permite que los sistemas y herramientas de nivel superior generen, consuman y transformen modelos TensorFlow. Los modelos SavedModel se pueden compartir e implementar fácilmente en distintas plataformas y entornos.
-
Facilidad de implementación: TF SavedModel agrupa el grafo de cálculo, los parámetros entrenados y los metadatos necesarios en un solo paquete. Se puede cargar fácilmente y utilizar para ejecutar inferencias sin necesitar el código original con el que se creó el modelo. Esto facilita y agiliza la implementación de modelos TensorFlow en distintos entornos de producción.
-
Gestión de recursos: TF SavedModel admite la inclusión de recursos externos, como vocabularios, embeddings o tablas de búsqueda. Estos recursos se almacenan junto a la definición del grafo y las variables para garantizar que estén disponibles al cargar el modelo. Esta función simplifica la gestión y distribución de modelos que dependen de recursos externos.
Opciones de implementación con TF SavedModel#
Antes de explicar el proceso para exportar modelos YOLO26 al formato TF SavedModel, veamos algunos escenarios habituales de implementación en los que se utiliza este formato.
TF SavedModel ofrece distintas opciones para implementar tus modelos de aprendizaje automático:
-
TensorFlow Serving: TensorFlow Serving es un sistema flexible y de alto rendimiento diseñado para entornos de producción. Admite TF SavedModel de forma nativa, lo que facilita implementar y servir tus modelos en plataformas en la nube, servidores locales o dispositivos edge.
-
Plataformas en la nube: Los principales proveedores de servicios en la nube, como Google Cloud Platform (GCP), Amazon Web Services (AWS) y Microsoft Azure, ofrecen servicios para implementar y ejecutar modelos TensorFlow, incluidos los modelos TF SavedModel. Estos servicios proporcionan una infraestructura escalable y gestionada que te permite implementar y ampliar tus modelos fácilmente.
-
Dispositivos móviles y embebidos: LiteRT (antes TensorFlow Lite), una solución ligera para ejecutar modelos de aprendizaje automático en dispositivos móviles, embebidos y de IoT, admite la conversión de modelos TF SavedModel al formato LiteRT. Esto te permite implementar tus modelos en una amplia gama de dispositivos, desde teléfonos inteligentes y tabletas hasta microcontroladores y dispositivos edge.
-
TensorFlow Runtime: TensorFlow Runtime (
tfrt) es un entorno de ejecución de alto rendimiento para ejecutar grafos TensorFlow. Proporciona API de nivel inferior para cargar y ejecutar modelos TF SavedModel en entornos C++. TensorFlow Runtime ofrece un rendimiento superior al del entorno de ejecución estándar de TensorFlow. Es adecuado para implementaciones que requieren inferencias de baja latencia y una integración estrecha con bases de código C++ existentes.
Tareas compatibles#
La exportación a TF SavedModel admite las siete tareas de Ultralytics. La segmentación semántica y la estimación de profundidad solo están disponibles con YOLO26, la única familia que incluye esas cabezas.
| Tarea | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Detectar | ✅ | ✅ | ✅ |
| Segmentar | ✅ | ✅ | ✅ |
| Semántica | ❌ | ❌ | ✅ |
| Profundidad | ❌ | ❌ | ✅ |
| Clasificar | ✅ | ✅ | ✅ |
| Pose | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Exportar modelos YOLO26 a TF SavedModel#
Al exportar modelos YOLO26 al formato TF SavedModel, aumentas su adaptabilidad y facilitas su implementación en distintas plataformas.
Instalación#
Para instalar el paquete necesario, ejecuta:
# Install the required package for YOLO26
pip install ultralytics
Para obtener instrucciones detalladas y buenas prácticas relacionadas con el proceso de instalación, consulta nuestra guía de instalación de Ultralytics. Si tienes dificultades al instalar los paquetes necesarios para YOLO26, consulta nuestra guía sobre problemas habituales, donde encontrarás soluciones y consejos.
Uso#
Todos los modelos Ultralytics YOLO26 están diseñados para admitir la exportación desde el primer momento, lo que facilita su integración en el flujo de trabajo de implementación que prefieras. Puedes consultar la lista completa de formatos de exportación y opciones de configuración compatibles para elegir la configuración más adecuada para tu aplicación.
El formato TF SavedModel admite los modos Exportar, Predecir y Validar. Exporta tu modelo y, después, carga el modelo exportado para ejecutar inferencias o validar su precisión.
from ultralytics import YOLO

# Carga un modelo YOLO26
model = YOLO("yolo26n.pt")

# Exporta el modelo al formato TF SavedModel
model.export(format="saved_model") # creates 'yolo26n_saved_model'from ultralytics import YOLO
# Carga el modelo TF SavedModel exportado
model = YOLO("./yolo26n_saved_model")
# Ejecutar inferencia
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Carga el modelo TF SavedModel exportado
model = YOLO("./yolo26n_saved_model")
# Valida la precisión con el conjunto de datos COCO8
metrics = model.val(data="coco8.yaml")Argumentos de exportación#
| Argumento | Tipo | Predeterminado | Descripción |
|---|---|---|---|
format | str | 'saved_model' | Formato de destino del modelo exportado, que define su compatibilidad con distintos entornos de implementación. |
imgsz | int o tuple | 640 | Tamaño de imagen deseado para la entrada del modelo. Puede ser un número entero para imágenes cuadradas o una tupla (height, width) para dimensiones específicas. |
quantize | int o str | None | Precisión de cuantización: 8 (INT8/PTQ; necesita calibración data/fraction) o 32/sin definir (FP32). La exportación a SavedModel no admite FP16. Sustituye el indicador obsoleto int8. |
opset | int | None | Especifica la versión del conjunto de operaciones de ONNX para el grafo ONNX intermedio. Si no se establece, se utiliza la última versión compatible. |
nms | bool, opcional | None | Selecciona la salida sin procesar (None, predeterminada), NMS integrada (True) o el cabezal sin NMS (False). |
batch | int | 1 | Especifica el tamaño del lote de inferencia del modelo exportado o el número máximo de imágenes que el modelo exportado procesará simultáneamente en el modo predict. |
data | str | None | Ruta al archivo YAML del conjunto de datos, imprescindible para la cuantización; en clasificación, en su lugar se indica un directorio del conjunto de datos o el nombre de un conjunto de datos integrado. Si se omite con quantize=8, Ultralytics selecciona el conjunto de datos de calibración predeterminado para la tarea del modelo. |
fraction | float, int o list | 1.0 | Subconjunto de calibración expresado como proporción, número de imágenes o proporciones/recuentos [train, val, test]. Las listas de dos elementos dejan completo test, mientras que 0 lo omite. |
device | str | None | Especifica el dispositivo para la exportación: CPU (device=cpu) o MPS para Apple silicon (device=mps). |
Para obtener más información sobre el proceso de exportación, visita la página de documentación de Ultralytics sobre exportación.
Implementar modelos YOLO26 TF SavedModel exportados#
Ahora que has exportado tu modelo YOLO26 al formato TF SavedModel, el siguiente paso es implementarlo. El primer paso recomendado para ejecutar un modelo TF SavedModel es utilizar el método YOLO("yolo26n_saved_model/"), como se muestra en el fragmento de código de uso anterior.
Para obtener instrucciones detalladas sobre cómo implementar tus modelos TF SavedModel, consulta estos recursos:
-
TensorFlow Serving: Aquí encontrarás la documentación para desarrolladores sobre cómo implementar tus modelos TF SavedModel con TensorFlow Serving.
-
Ejecutar un TensorFlow SavedModel en Node.js: Una entrada del blog de TensorFlow sobre cómo ejecutar directamente un TensorFlow SavedModel en Node.js sin convertirlo.
-
Despliegue en la nube: Una entrada del blog de TensorFlow sobre el despliegue de un modelo TensorFlow SavedModel en Cloud AI Platform.
Resumen#
En esta guía, hemos visto cómo exportar modelos Ultralytics YOLO26 al formato TF SavedModel. Al exportar a TF SavedModel, obtienes la flexibilidad de optimizar, desplegar y escalar tus modelos YOLO26 en una amplia variedad de plataformas.
Para obtener más información sobre el uso, visita la documentación oficial de TF SavedModel.
Para obtener más información sobre la integración de Ultralytics YOLO26 con otras plataformas y frameworks, no olvides consultar nuestra página de guías de integración. Incluye recursos muy útiles para sacar el máximo partido a YOLO26 en tus proyectos.
Preguntas frecuentes#
Exportar un modelo Ultralytics YOLO al formato TensorFlow SavedModel es muy sencillo. Puedes hacerlo con Python o con CLI:
Exportar YOLO26 a TF SavedModelfrom ultralytics import YOLO # Carga un modelo YOLO26 model = YOLO("yolo26n.pt") # Exporta el modelo al formato TF SavedModel model.export(format="saved_model") # creates 'yolo26n_saved_model' # Cargar el TF SavedModel exportado para la inferencia tf_savedmodel_model = YOLO("./yolo26n_saved_model") results = tf_savedmodel_model("https://ultralytics.com/images/bus.jpg")Consulta la documentación de exportación de Ultralytics para obtener más información.
El formato TensorFlow SavedModel ofrece varias ventajas para el despliegue de modelos:
- Portabilidad: Proporciona un formato independiente del lenguaje, lo que facilita compartir y desplegar modelos en distintos entornos.
- Compatibilidad: Se integra sin problemas con herramientas como TensorFlow Serving, LiteRT y TensorFlow.js, esenciales para desplegar modelos en distintas plataformas, incluidas aplicaciones web y móviles.
- Encapsulación completa: Codifica la arquitectura del modelo, los pesos y la información de compilación, lo que facilita compartirlo y continuar su entrenamiento.
Para conocer más ventajas y opciones de despliegue, consulta las opciones de despliegue de modelos Ultralytics YOLO.
TF SavedModel se puede desplegar en distintos entornos, entre ellos:
- TensorFlow Serving: Ideal para entornos de producción que requieren servir modelos de forma escalable y con alto rendimiento.
- Plataformas en la nube: Admite los principales servicios en la nube, como Google Cloud Platform (GCP), Amazon Web Services (AWS) y Microsoft Azure, para desplegar modelos de forma escalable.
- Dispositivos móviles e integrados: El uso de LiteRT (antes TensorFlow Lite) para convertir TF SavedModels permite desplegarlos en dispositivos móviles, dispositivos IoT y microcontroladores.
- Entorno de ejecución de TensorFlow: Para entornos C++ que necesitan inferencia de baja latencia y mejor rendimiento.
Para conocer las opciones de despliegue en detalle, visita las guías oficiales sobre el despliegue de modelos TensorFlow.
Para exportar modelos YOLO26, tienes que instalar el paquete
ultralytics. Ejecuta el siguiente comando en el terminal:pip install ultralyticsPara consultar instrucciones de instalación más detalladas y buenas prácticas, visita nuestra guía de instalación de Ultralytics. Si tienes algún problema, consulta nuestra guía de problemas frecuentes.
El formato TF SavedModel resulta útil para los desarrolladores de IA por las siguientes características:
- Portabilidad: Permite compartir y desplegar modelos fácilmente en distintos entornos.
- Facilidad de despliegue: Agrupa el grafo computacional, los parámetros entrenados y los metadatos en un único paquete, lo que simplifica la carga y la inferencia.
- Gestión de recursos: Admite recursos externos, como vocabularios, y garantiza que estén disponibles al cargar el modelo.
Para obtener más información, consulta la documentación oficial de TensorFlow.