YOLOv7 : ensemble d’astuces entraînables
Sorti en juillet 2022, YOLOv7 représentait une avancée importante dans la détection d'objets en temps réel au moment de sa publication. Il a atteint un AP de 56,8 %, la plus grande précision parmi les détecteurs en temps réel fonctionnant à 30 FPS ou plus sur un GPU V100 lors de son lancement. YOLOv7 surpassait les détecteurs d'objets contemporains tels que YOLOR, YOLOX, Scaled-YOLOv4 et YOLOv5 en vitesse et en précision. Le modèle est entraîné à partir de zéro sur le jeu de données MS COCO, sans utiliser d'autres jeux de données ni de poids préentraînés. Le code source de YOLOv7 est disponible sur GitHub. Note que des modèles plus récents comme YOLO26 et YOLO11 ont depuis atteint une précision supérieure avec une meilleure efficacité.
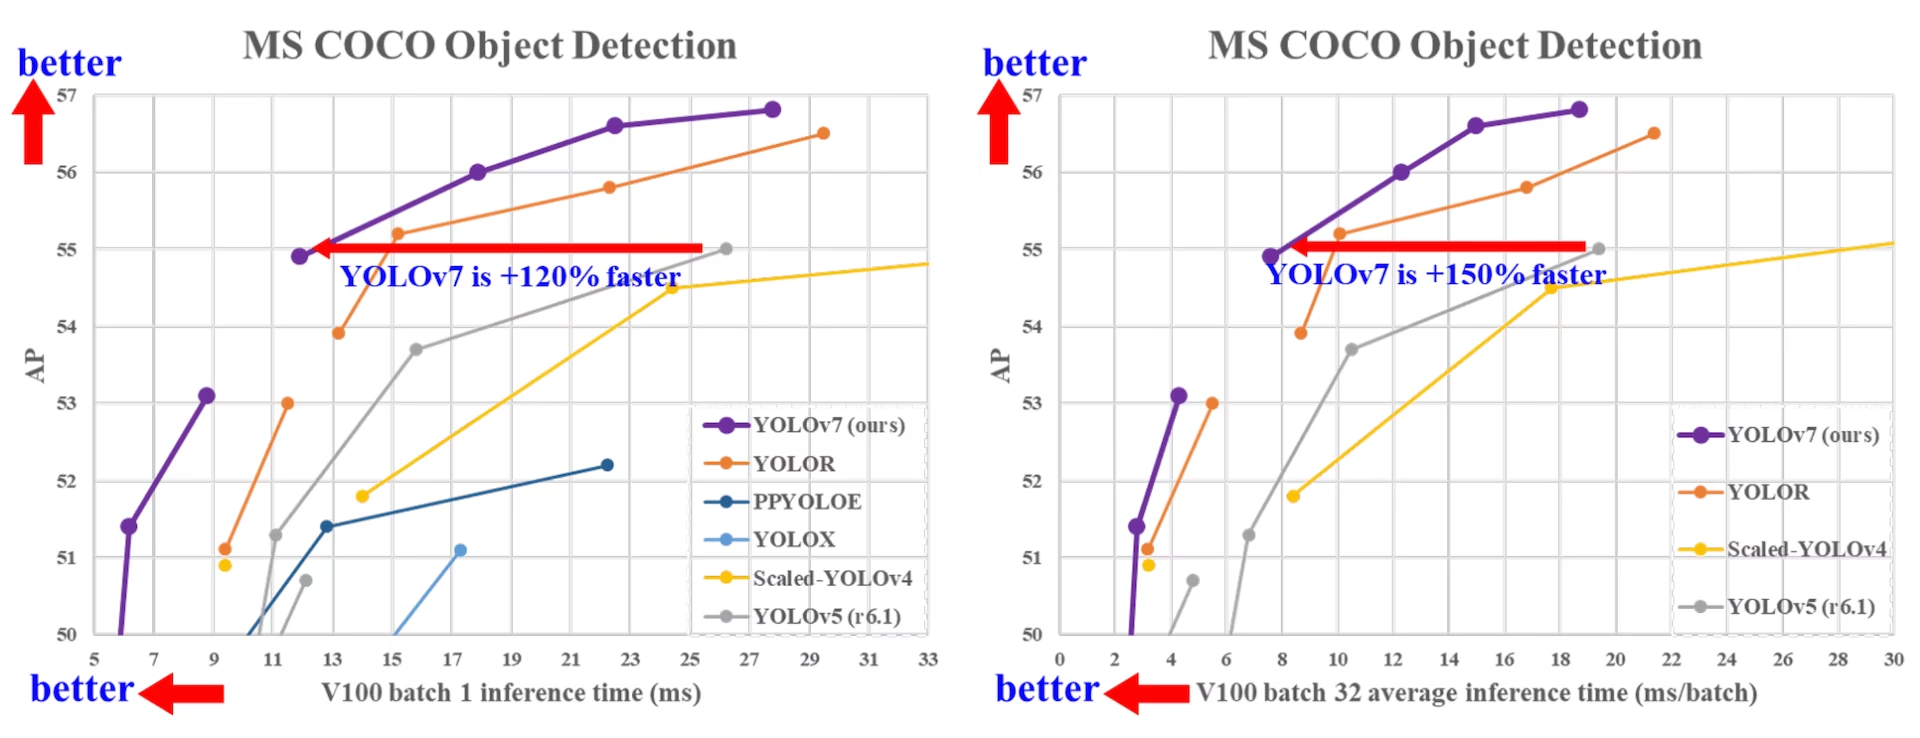
Comparaison des détecteurs d’objets de pointe#
Selon le tableau comparatif de l'article sur YOLOv7, YOLOv7 présente le meilleur compromis global entre vitesse et précision. Par rapport à YOLOv5-N (r6.1), YOLOv7-tiny-SiLU est 127 fps plus rapide et offre un AP supérieur de 10,7 %. De plus, YOLOv7 atteint un AP de 51,4 % à 161 fps, tandis que PPYOLOE-L atteint le même AP à seulement 78 fps ; YOLOv7 utilise aussi 41 % de paramètres en moins que PPYOLOE-L.
Par rapport à YOLOv5-L (r6.1) à 99 fps, YOLOv7-X fonctionne à 114 fps et améliore l'AP de 3,9 %. Par rapport à YOLOv5-X (r6.1), de taille similaire, YOLOv7-X est 31 fps plus rapide, utilise 22 % de paramètres en moins et nécessite 8 % de calculs en moins, tout en améliorant l'AP de 2,2 % (Source).
| Modèle | Paramètres (M) | FLOPs (G) | Taille (pixels) | FPS | APtest / validation50-95 | APtest50 | APtest75 | APtestS | APtestM | APtestL |
|---|---|---|---|---|---|---|---|---|---|---|
| YOLOX-S | 9.0 | 26.8 | 640 | 102 | 40.5% / 40.5% | - | - | - | - | - |
| YOLOX-M | 25.3 | 73.8 | 640 | 81 | 47.2% / 46.9% | - | - | - | - | - |
| YOLOX-L | 54.2 | 155.6 | 640 | 69 | 50.1% / 49.7% | - | - | - | - | - |
| YOLOX-X | 99.1 | 281.9 | 640 | 58 | 51.5% / 51.1% | - | - | - | - | - |
| PPYOLOE-S | 7.9 | 17.4 | 640 | 208 | 43.1% / 42.7% | 60.5% | 46.6% | 23.2% | 46.4% | 56.9% |
| PPYOLOE-M | 23.4 | 49.9 | 640 | 123 | 48.9% / 48.6% | 66.5% | 53.0% | 28.6% | 52.9% | 63.8% |
| PPYOLOE-L | 52.2 | 110.1 | 640 | 78 | 51.4% / 50.9% | 68.9% | 55.6% | 31.4% | 55.3% | 66.1% |
| PPYOLOE-X | 98.4 | 206.6 | 640 | 45 | 52.2% / 51.9% | 69.9% | 56.5% | 33.3% | 56.3% | 66.4% |
| YOLOv5-N (r6.1) | 1.9 | 4.5 | 640 | 159 | - / 28.0% | - | - | - | - | - |
| YOLOv5-S (r6.1) | 7.2 | 16.5 | 640 | 156 | - / 37.4% | - | - | - | - | - |
| YOLOv5-M (r6.1) | 21.2 | 49.0 | 640 | 122 | - / 45.4% | - | - | - | - | - |
| YOLOv5-L (r6.1) | 46.5 | 109.1 | 640 | 99 | - / 49.0% | - | - | - | - | - |
| YOLOv5-X (r6.1) | 86.7 | 205.7 | 640 | 83 | - / 50.7% | - | - | - | - | - |
| YOLOR-CSP | 52.9 | 120.4 | 640 | 106 | 51.1% / 50.8% | 69.6% | 55.7% | 31.7% | 55.3% | 64.7% |
| YOLOR-CSP-X | 96.9 | 226.8 | 640 | 87 | 53.0% / 52.7% | 71.4% | 57.9% | 33.7% | 57.1% | 66.8% |
| YOLOv7-tiny-SiLU | 6.2 | 13.8 | 640 | 286 | 38.7% / 38.7% | 56.7% | 41.7% | 18.8% | 42.4% | 51.9% |
| YOLOv7 | 36.9 | 104.7 | 640 | 161 | 51.4% / 51.2% | 69.7% | 55.9% | 31.8% | 55.5% | 65.0% |
| YOLOv7-X | 71.3 | 189.9 | 640 | 114 | 53.1% / 52.9% | 71.2% | 57.8% | 33.8% | 57.1% | 67.4% |
| YOLOv5-N6 (r6.1) | 3.2 | 18.4 | 1280 | 123 | - / 36.0% | - | - | - | - | - |
| YOLOv5-S6 (r6.1) | 12.6 | 67.2 | 1280 | 122 | - / 44.8% | - | - | - | - | - |
| YOLOv5-M6 (r6.1) | 35.7 | 200.0 | 1280 | 90 | - / 51.3% | - | - | - | - | - |
| YOLOv5-L6 (r6.1) | 76.8 | 445.6 | 1280 | 63 | - / 53.7% | - | - | - | - | - |
| YOLOv5-X6 (r6.1) | 140.7 | 839.2 | 1280 | 38 | - / 55.0% | - | - | - | - | - |
| YOLOR-P6 | 37.2 | 325.6 | 1280 | 76 | 53.9% / 53.5% | 71.4% | 58.9% | 36.1% | 57.7% | 65.6% |
| YOLOR-W6 | 79.8 | 453.2 | 1280 | 66 | 55.2% / 54.8% | 72.7% | 60.5% | 37.7% | 59.1% | 67.1% |
| YOLOR-E6 | 115.8 | 683.2 | 1280 | 45 | 55.8% / 55.7% | 73.4% | 61.1% | 38.4% | 59.7% | 67.7% |
| YOLOR-D6 | 151.7 | 935.6 | 1280 | 34 | 56.5% / 56.1% | 74.1% | 61.9% | 38.9% | 60.4% | 68.7% |
| YOLOv7-W6 | 70.4 | 360.0 | 1280 | 84 | 54.9% / 54.6% | 72.6% | 60.1% | 37.3% | 58.7% | 67.1% |
| YOLOv7-E6 | 97.2 | 515.2 | 1280 | 56 | 56.0% / 55.9% | 73.5% | 61.2% | 38.0% | 59.9% | 68.4% |
| YOLOv7-D6 | 154.7 | 806.8 | 1280 | 44 | 56.6% / 56.3% | 74.0% | 61.8% | 38.8% | 60.1% | 69.5% |
| YOLOv7-E6E | 151.7 | 843.2 | 1280 | 36 | 56.8% / 56.8% | 74.4% | 62.1% | 39.3% | 60.5% | 69.0% |
Présentation#
La détection d'objets en temps réel est un élément important de nombreux systèmes de vision par ordinateur, notamment le suivi multi-objets, la conduite autonome, la robotique et l'analyse d'images médicales. Ces dernières années, le développement de la détection d'objets en temps réel s'est concentré sur la conception d'architectures efficaces et l'amélioration de la vitesse d'inférence de divers CPU, GPU et unités de traitement neuronal (NPU). YOLOv7 prend en charge les appareils équipés d'un GPU mobile ou d'un GPU, de l'edge au cloud.
Contrairement aux détecteurs d'objets traditionnels en temps réel, qui se concentrent sur l'optimisation de l'architecture, YOLOv7 met l'accent sur l'optimisation du processus d'entraînement. Celle-ci comprend des modules et des méthodes d'optimisation conçus pour améliorer la précision de la détection d'objets sans augmenter le coût d'inférence, un concept appelé « sac d'astuces entraînables ».
Fonctionnalités clés#
YOLOv7 introduit plusieurs fonctionnalités clés :
-
Reparamétrisation du modèle : YOLOv7 propose un modèle reparamétrisé selon une stratégie planifiée, applicable aux couches de différents réseaux et fondée sur le concept de chemin de propagation du gradient.
-
Attribution dynamique des étiquettes : L'entraînement du modèle avec plusieurs couches de sortie soulève un nouveau problème : « Comment attribuer des cibles dynamiques aux sorties des différentes branches ? » Pour le résoudre, YOLOv7 introduit une nouvelle méthode d'attribution des étiquettes, appelée attribution guidée de type « coarse-to-fine lead ».
-
Mise à l'échelle étendue et composée : YOLOv7 propose des méthodes d'« extension » et de « mise à l'échelle composée » pour les détecteurs d'objets en temps réel, afin d'exploiter efficacement les paramètres et les calculs.
-
Efficacité : la méthode proposée par YOLOv7 réduit d'environ 40 % le nombre de paramètres et de 50 % les calculs par rapport aux détecteurs d'objets en temps réel de pointe, tout en offrant une inférence plus rapide et une meilleure précision de détection.
Exemples d'utilisation#
Ultralytics ne publie pas de poids préentraînés yolov7.pt ni de fichiers YAML ultralytics/cfg/models/v7/, et l'entraînement ainsi que l'inférence natifs de YOLOv7 avec PyTorch ne sont pas pris en charge par le package Python Ultralytics. Cependant, tu peux importer dans Ultralytics un point de contrôle YOLOv7 entraîné dans le dépôt YOLOv7 en amont en l'exportant au format ONNX ou TensorRT, comme indiqué ci-dessous.
Exportation ONNX#
Pour utiliser un modèle ONNX YOLOv7 avec Ultralytics :
-
(Facultatif) Installe Ultralytics et exporte un modèle ONNX pour que les dépendances requises soient installées automatiquement :
pip install ultralytics yolo export model=yolo26n.pt format=onnx -
Exporte le modèle YOLOv7 souhaité à l'aide de l'exportateur du dépôt YOLOv7 :
git clone https://github.com/WongKinYiu/yolov7 cd yolov7 python export.py --weights yolov7-tiny.pt --grid --end2end --simplify --topk-all 100 --iou-thres 0.65 --conf-thres 0.35 --img-size 640 640 --max-wh 640 -
Modifie le graphe du modèle ONNX pour le rendre compatible avec Ultralytics à l'aide du script suivant :
import numpy as np import onnx from onnx import helper, numpy_helper # Load the ONNX model model_path = "yolov7/yolov7-tiny.onnx" # Replace with your model path model = onnx.load(model_path) graph = model.graph # Fix input shape to batch size 1 input_shape = graph.input[0].type.tensor_type.shape input_shape.dim[0].dim_value = 1 # Define the output of the original model original_output_name = graph.output[0].name # Create slicing nodes sliced_output_name = f"{original_output_name}_sliced" # Define initializers for slicing (remove the first value) start = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_start") end = numpy_helper.from_array(np.array([7], dtype=np.int64), name="slice_end") axes = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_axes") steps = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_steps") graph.initializer.extend([start, end, axes, steps]) slice_node = helper.make_node( "Slice", inputs=[original_output_name, "slice_start", "slice_end", "slice_axes", "slice_steps"], outputs=[sliced_output_name], name="SliceNode", ) graph.node.append(slice_node) # Define segment slicing seg1_start = numpy_helper.from_array(np.array([0], dtype=np.int64), name="seg1_start") seg1_end = numpy_helper.from_array(np.array([4], dtype=np.int64), name="seg1_end") seg2_start = numpy_helper.from_array(np.array([4], dtype=np.int64), name="seg2_start") seg2_end = numpy_helper.from_array(np.array([5], dtype=np.int64), name="seg2_end") seg3_start = numpy_helper.from_array(np.array([5], dtype=np.int64), name="seg3_start") seg3_end = numpy_helper.from_array(np.array([6], dtype=np.int64), name="seg3_end") graph.initializer.extend([seg1_start, seg1_end, seg2_start, seg2_end, seg3_start, seg3_end]) # Create intermediate tensors for segments segment_1_name = f"{sliced_output_name}_segment1" segment_2_name = f"{sliced_output_name}_segment2" segment_3_name = f"{sliced_output_name}_segment3" # Add segment slicing nodes graph.node.extend( [ helper.make_node( "Slice", inputs=[sliced_output_name, "seg1_start", "seg1_end", "slice_axes", "slice_steps"], outputs=[segment_1_name], name="SliceSegment1", ), helper.make_node( "Slice", inputs=[sliced_output_name, "seg2_start", "seg2_end", "slice_axes", "slice_steps"], outputs=[segment_2_name], name="SliceSegment2", ), helper.make_node( "Slice", inputs=[sliced_output_name, "seg3_start", "seg3_end", "slice_axes", "slice_steps"], outputs=[segment_3_name], name="SliceSegment3", ), ] ) # Concatenate the segments concat_output_name = f"{sliced_output_name}_concat" concat_node = helper.make_node( "Concat", inputs=[segment_1_name, segment_3_name, segment_2_name], outputs=[concat_output_name], axis=1, name="ConcatSwapped", ) graph.node.append(concat_node) # Reshape to [1, -1, 6] reshape_shape = numpy_helper.from_array(np.array([1, -1, 6], dtype=np.int64), name="reshape_shape") graph.initializer.append(reshape_shape) final_output_name = f"{concat_output_name}_batched" reshape_node = helper.make_node( "Reshape", inputs=[concat_output_name, "reshape_shape"], outputs=[final_output_name], name="AddBatchDimension", ) graph.node.append(reshape_node) # Get the shape of the reshaped tensor shape_node_name = f"{final_output_name}_shape" shape_node = helper.make_node( "Shape", inputs=[final_output_name], outputs=[shape_node_name], name="GetShapeDim", ) graph.node.append(shape_node) # Extract the second dimension dim_1_index = numpy_helper.from_array(np.array([1], dtype=np.int64), name="dim_1_index") graph.initializer.append(dim_1_index) second_dim_name = f"{final_output_name}_dim1" gather_node = helper.make_node( "Gather", inputs=[shape_node_name, "dim_1_index"], outputs=[second_dim_name], name="GatherSecondDim", ) graph.node.append(gather_node) # Subtract from 100 to determine how many values to pad target_size = numpy_helper.from_array(np.array([100], dtype=np.int64), name="target_size") graph.initializer.append(target_size) pad_size_name = f"{second_dim_name}_padsize" sub_node = helper.make_node( "Sub", inputs=["target_size", second_dim_name], outputs=[pad_size_name], name="CalculatePadSize", ) graph.node.append(sub_node) # Build the [2, 3] pad array: # 1st row -> [0, 0, 0] (no padding at the start of any dim) # 2nd row -> [0, pad_size, 0] (pad only at the end of the second dim) pad_starts = numpy_helper.from_array(np.array([0, 0, 0], dtype=np.int64), name="pad_starts") graph.initializer.append(pad_starts) zero_scalar = numpy_helper.from_array(np.array([0], dtype=np.int64), name="zero_scalar") graph.initializer.append(zero_scalar) pad_ends_name = "pad_ends" concat_pad_ends_node = helper.make_node( "Concat", inputs=["zero_scalar", pad_size_name, "zero_scalar"], outputs=[pad_ends_name], axis=0, name="ConcatPadEnds", ) graph.node.append(concat_pad_ends_node) pad_values_name = "pad_values" concat_pad_node = helper.make_node( "Concat", inputs=["pad_starts", pad_ends_name], outputs=[pad_values_name], axis=0, name="ConcatPadStartsEnds", ) graph.node.append(concat_pad_node) # Create Pad operator to pad with zeros pad_output_name = f"{final_output_name}_padded" pad_constant_value = numpy_helper.from_array( np.array([0.0], dtype=np.float32), name="pad_constant_value", ) graph.initializer.append(pad_constant_value) pad_node = helper.make_node( "Pad", inputs=[final_output_name, pad_values_name, "pad_constant_value"], outputs=[pad_output_name], mode="constant", name="PadToFixedSize", ) graph.node.append(pad_node) # Update the graph's final output to [1, 100, 6] new_output_type = onnx.helper.make_tensor_type_proto( elem_type=graph.output[0].type.tensor_type.elem_type, shape=[1, 100, 6] ) new_output = onnx.helper.make_value_info(name=pad_output_name, type_proto=new_output_type) # Replace the old output with the new one graph.output.pop() graph.output.extend([new_output]) # Save the modified model onnx.save(model, "yolov7-ultralytics.onnx") -
Tu peux ensuite charger le modèle ONNX modifié et exécuter normalement l'inférence avec celui-ci dans Ultralytics :
from ultralytics import ASSETS, YOLO

model = YOLO("yolov7-ultralytics.onnx", task="detect")

results = model(ASSETS / "bus.jpg")
Exportation TensorRT#
-
Suis les étapes 1 et 2 de la section Exportation ONNX.
-
Installe le package Python
TensorRT:pip install tensorrt -
Exécute le script suivant pour convertir le modèle ONNX modifié en moteur TensorRT :
from ultralytics.utils.export import onnx2engine onnx2engine("yolov7-ultralytics.onnx", quantize=16) -
Charge et exécute le modèle dans Ultralytics :
from ultralytics import ASSETS, YOLO

model = YOLO("yolov7-ultralytics.engine", task="detect")

results = model(ASSETS / "bus.jpg")
Citations et remerciements#
Nous tenons à saluer les auteurs de YOLOv7 pour leurs contributions majeures au domaine de la détection d'objets en temps réel :
@inproceedings{wang2023yolov7,
  title={YOLOv7: Trainable Bag-of-Freebies Sets New State-of-the-Art for Real-Time Object Detectors},
  author={Wang, Chien-Yao and Bochkovskiy, Alexey and Liao, Hong-Yuan Mark},
  booktitle={Proceedings of the IEEE/CVF conference on Computer Vision and Pattern Recognition (CVPR)},
  pages={7464--7475},
  year={2023}
}
L'article officiel sur YOLOv7 a été publié à CVPR 2023 et est disponible sur CVF Open Access, avec une prépublication sur arXiv. Les auteurs ont rendu leur travail public, et le code source est accessible sur GitHub. Nous saluons leurs efforts pour faire progresser le domaine et rendre leur travail accessible à l'ensemble de la communauté.
FAQ#
Lancé en juillet 2022, YOLOv7 était un modèle de détection d’objets en temps réel qui atteignait une vitesse et une précision de pointe à sa sortie. Il surpassait les modèles contemporains tels que YOLOX, YOLOv5 et PPYOLOE, tant en nombre de paramètres qu’en vitesse d’inférence. Les caractéristiques distinctives de YOLOv7 incluent la reparamétrisation du modèle et l’assignation dynamique des étiquettes, qui optimisent ses performances sans augmenter les coûts d’inférence.
YOLOv7 introduit plusieurs innovations, notamment la reparamétrisation du modèle et l'attribution dynamique des étiquettes, qui améliorent le processus d'entraînement et la précision de l'inférence. Par rapport à YOLOv5, YOLOv7 augmente considérablement la vitesse et la précision. Par exemple, YOLOv7-X améliore la précision de 2,2 % et réduit le nombre de paramètres de 22 % par rapport à YOLOv5-X. Tu trouveras des comparaisons détaillées dans le tableau des performances Comparaison de YOLOv7 avec les détecteurs d'objets de pointe.
À ce jour, Ultralytics prend uniquement en charge l'inférence YOLOv7 au format ONNX et TensorRT. Pour exécuter avec Ultralytics la version YOLOv7 exportée au format ONNX ou TensorRT, consulte la section Exemples d'utilisation.
Pour installer et entraîner un modèle YOLOv7 personnalisé, suis ces étapes :
-
Clone le dépôt YOLOv7 :
git clone https://github.com/WongKinYiu/yolov7 -
Accède au répertoire cloné et installe les dépendances :
cd yolov7 pip install -r requirements.txt -
Prépare ton jeu de données et configure les paramètres du modèle selon les instructions d’utilisation fournies dans le dépôt.
-
Après l'entraînement, tu peux exporter le modèle au format ONNX ou TensorRT pour l'utiliser dans Ultralytics, comme indiqué dans les Exemples d'utilisation.
-
YOLOv7 introduit plusieurs fonctionnalités clés pour la détection d’objets en temps réel :
- Reparamétrisation du modèle : améliore les performances du modèle en optimisant les chemins de propagation du gradient.
- Attribution dynamique des étiquettes : utilise une méthode guidée de type « coarse-to-fine lead » pour attribuer des cibles dynamiques aux sorties des différentes branches, ce qui améliore la précision.
- Mise à l'échelle étendue et composée : exploite efficacement les paramètres et les calculs pour adapter le modèle à différentes applications en temps réel.
- Efficacité : réduit le nombre de paramètres de 40 % et les calculs de 50 % par rapport aux autres modèles de pointe, tout en offrant une vitesse d'inférence supérieure.


Commentaires2
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
naps22
YOLOv7's approach as a trainable bag-of-freebies really stands out, especially in how it optimizes performance without additional inference cost. It's impressive how techniques like re-parameterization and dynamic label assignment enhance accuracy. However, after doing a YOLOv8 comparison, it’s clear that while YOLOv8 brings some architectural improvements and streamlined workflows, YOLOv7 still holds strong in many real-time detection scenarios due to its training-time flexibility.
 Glenn JocherUltralytics(modifié)
You're absolutely right about YOLOv7's innovative "trainable bag-of-freebies" approach - it was a game-changing concept that improved accuracy purely through training optimizations rather than architectural changes. The re-parameterization and dynamic label assignment techniques were particularly clever solutions that set new standards for efficiency.
While YOLOv7 remains excellent for real-time detection scenarios, you might want to explore YOLO26 as well - it's our latest model that builds upon these innovations with even better performance across detection, segmentation, and other tasks, all within the streamlined Ultralytics framework.