Dataset COCO#
Il dataset COCO (oggetti comuni nel contesto) è un dataset su larga scala per il rilevamento e la segmentazione degli oggetti e per il captioning. È progettato per incoraggiare la ricerca su un'ampia varietà di categorie di oggetti e viene comunemente utilizzato per il benchmarking dei modelli di computer vision. È un dataset essenziale per ricercatori e sviluppatori che lavorano su attività di rilevamento e segmentazione degli oggetti e di stima della posa.
Watch: Ultralytics COCO Dataset Overview
Modelli COCO pretrained#
| Modello | dimensione (pixel) | mAPval 50-95 | mAPval 50-95(e2e) | Velocità CPU ONNX (ms) | Velocità T4 TensorRT10 (ms) | parametri (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|
| YOLO26n | 640 | 40.9 | 40.1 | 38.9 ± 0.7 | 1.7 ± 0.0 | 2.4 | 5.5 |
| YOLO26s | 640 | 48.6 | 47.8 | 87.2 ± 0.9 | 2.5 ± 0.0 | 9.5 | 20.9 |
| YOLO26m | 640 | 53.1 | 52.5 | 220.0 ± 1.4 | 4.7 ± 0.1 | 20.4 | 68.4 |
| YOLO26l | 640 | 55.0 | 54.4 | 286.2 ± 2.0 | 6.2 ± 0.2 | 24.8 | 86.8 |
| YOLO26x | 640 | 57.5 | 56.9 | 525.8 ± 4.0 | 11.8 ± 0.2 | 55.7 | 194.4 |
Funzionalità principali#
- COCO contiene 330K immagini, di cui 200K dispongono di annotazioni per attività di rilevamento e segmentazione degli oggetti e di captioning.
- Il dataset comprende 80 categorie di oggetti, inclusi oggetti comuni come automobili, biciclette e animali, oltre a categorie più specifiche come ombrelli, borse e attrezzature sportive.
- Le annotazioni includono riquadri di delimitazione degli oggetti, maschere di segmentazione e didascalie per ogni immagine.
- COCO fornisce metriche di valutazione standardizzate come la precisione media (mAP) per il rilevamento degli oggetti e il recall medio (mAR) per le attività di segmentazione, rendendolo adatto al confronto delle prestazioni dei modelli.
Struttura del dataset#
Il dataset COCO è suddiviso in tre sottoinsiemi:
- Train2017: 118.287 immagini per l'addestramento di modelli di rilevamento e segmentazione degli oggetti e di captioning.
- Val2017: 5.000 immagini utilizzate per la convalida durante l'addestramento del modello.
- Test2017: 20.288 immagini test-dev utilizzate per il benchmarking dei modelli addestrati. Le annotazioni di riferimento per questo sottoinsieme non sono disponibili pubblicamente e i risultati vengono inviati al server di valutazione COCO per la valutazione delle prestazioni.
Applicazioni#
Il dataset COCO è ampiamente utilizzato per addestrare e valutare modelli di deep learning nel rilevamento degli oggetti (come Ultralytics YOLO, Faster R-CNN e SSD), nella segmentazione delle istanze (come Mask R-CNN) e nel rilevamento dei keypoint (come OpenPose). L'ampia varietà di categorie di oggetti del dataset, l'elevato numero di immagini annotate e le metriche di valutazione standardizzate lo rendono una risorsa essenziale per ricercatori e professionisti della computer vision.
Le annotazioni esportate dagli strumenti di labeling in formato COCO JSON seguono questa stessa struttura. Per addestrare il modello sui tuoi dati in formato COCO, consulta Converti le annotazioni COCO in YOLO.
YAML del dataset#
Un file YAML viene utilizzato per definire la configurazione del dataset. Contiene informazioni sui percorsi, sulle classi e su altri dati rilevanti del dataset. Nel caso del dataset COCO, il file coco.yaml è gestito all'indirizzo https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO 2017 dataset https://cocodataset.org by Microsoft
# Documentation: https://docs.ultralytics.com/datasets/detect/coco
# Example usage: yolo train data=coco.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco ← downloads here (20.3 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco # dataset root dir
train: train2017.txt # train images (relative to 'path') 118287 images
val: val2017.txt # val images (relative to 'path') 5000 images
test: test-dev2017.txt # 20288 of 40670 images, submit via https://cocodataset.org/#detection-eval

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: |
  from pathlib import Path

  from ultralytics.utils import ASSETS_URL
  from ultralytics.utils.downloads import download

  # Download labels
  segments = True  # segment or box labels
  dir = Path(yaml["path"])  # dataset root dir
  urls = [ASSETS_URL + ("/coco2017labels-segments.zip" if segments else "/coco2017labels.zip")]  # labels
  download(urls, dir=dir.parent)

  # Download data (test2017.zip excluded: ground truth is withheld, only used for the eval-server test-dev split)
  urls = [
      "http://images.cocodataset.org/zips/train2017.zip",  # 19G, 118k images
      "http://images.cocodataset.org/zips/val2017.zip",  # 1G, 5k images
  ]
download(urls, dir=dir / "images", threads=3)Utilizzo#
I dati di addestramento e convalida COCO2017 (20,3 GB) vengono scaricati automaticamente la prima volta che avvii l'addestramento. Per addestrare un modello YOLO26n su COCO per 100 epoche con una dimensione delle immagini di 640, puoi utilizzare i seguenti frammenti di codice. Per un elenco completo degli argomenti disponibili, consulta la pagina Addestramento del modello. Puoi anche eseguire l'addestramento su COCO nel cloud con Ultralytics Platform.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="coco.yaml", epochs=100, imgsz=640)
Immagini ed esempi di annotazioni#
Il dataset COCO contiene un'ampia varietà di immagini con diverse categorie di oggetti e scene complesse. Ecco alcuni esempi di immagini del dataset, con le relative annotazioni:
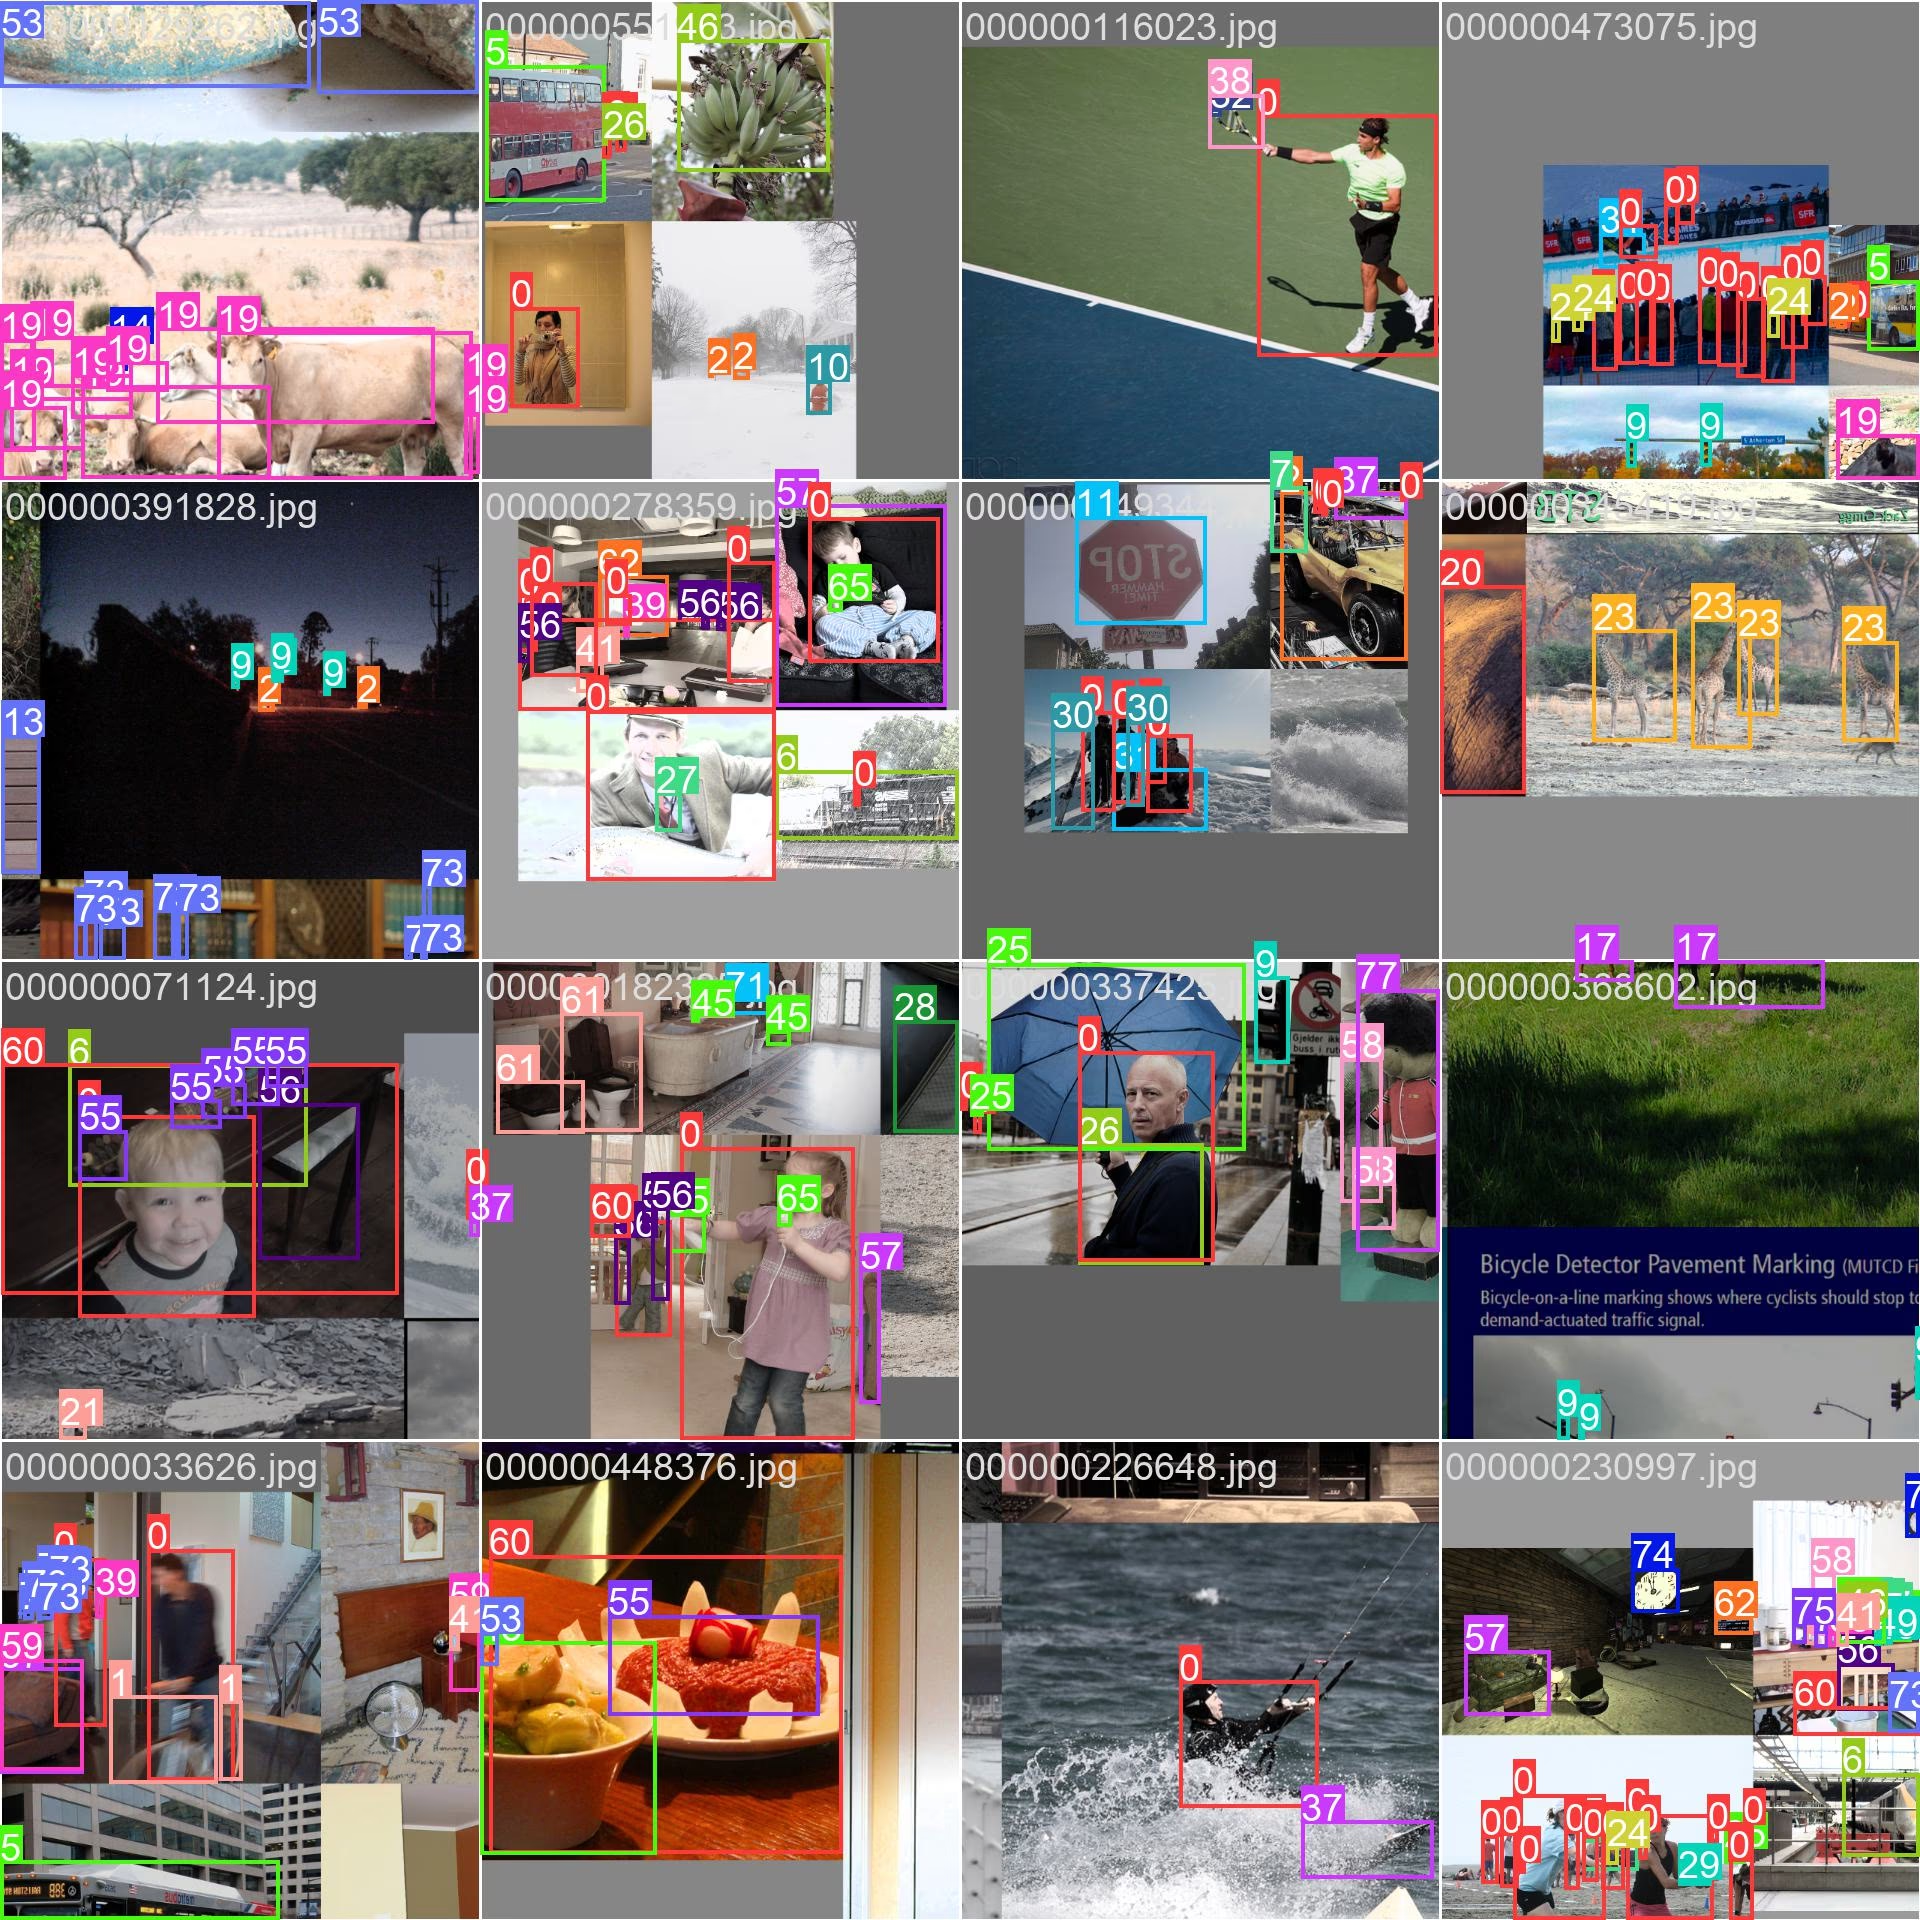
- Immagine a mosaico: questa immagine mostra un batch di addestramento composto da immagini del dataset unite a mosaico. La composizione a mosaico è una tecnica utilizzata durante l'addestramento che combina più immagini in un'unica immagine per aumentare la varietà di oggetti e scene all'interno di ogni batch di addestramento. Questo contribuisce a migliorare la capacità del modello di generalizzare a diverse dimensioni degli oggetti, proporzioni e contesti.
L'esempio mostra la varietà e la complessità delle immagini nel dataset COCO e i vantaggi dell'utilizzo della composizione a mosaico durante il processo di addestramento.
Citazioni e ringraziamenti#
Se utilizzi il dataset COCO nelle tue attività di ricerca o sviluppo, cita il seguente articolo:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Desideriamo ringraziare il COCO Consortium per aver creato e mantenuto questa preziosa risorsa per la comunità della computer vision. Per ulteriori informazioni sul dataset COCO e sui suoi creatori, visita il sito web del dataset COCO.
FAQ#
Il dataset COCO (oggetti comuni nel contesto) è un dataset su larga scala utilizzato per il rilevamento degli oggetti, la segmentazione e il captioning. Contiene 330K immagini con annotazioni dettagliate per 80 categorie di oggetti, il che lo rende essenziale per il benchmarking e l'addestramento dei modelli di computer vision. I ricercatori utilizzano COCO grazie alla varietà delle sue categorie e alle metriche di valutazione standardizzate, come la precisione media (mAP).
Per addestrare un modello YOLO26 utilizzando il dataset COCO, puoi usare i seguenti frammenti di codice:
Esempio di addestramentofrom ultralytics import YOLO # Load a model model = YOLO("yolo26n.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="coco.yaml", epochs=100, imgsz=640)Per ulteriori dettagli sugli argomenti disponibili, consulta la pagina Addestramento.
Il dataset COCO include:
- 330K immagini, di cui 200K annotate per il rilevamento e la segmentazione degli oggetti e il captioning.
- 80 categorie di oggetti, da elementi comuni come automobili e animali a categorie specifiche come borse e attrezzature sportive.
- Metriche di valutazione standardizzate per il rilevamento degli oggetti (mAP) e la segmentazione (recall medio, mAR).
- Tecnica di composizione a mosaico nei batch di addestramento per migliorare la capacità di generalizzazione del modello tra diverse dimensioni degli oggetti e contesti.
I modelli YOLO26 pretrained sul dataset COCO possono essere scaricati dai link forniti nella documentazione. Tra gli esempi:
Questi modelli differiscono per dimensioni, mAP e velocità di inferenza, offrendo opzioni per diversi requisiti di prestazioni e risorse.
Il dataset COCO è suddiviso in tre sottoinsiemi:
- Train2017: 118.287 immagini per l'addestramento.
- Val2017: 5.000 immagini per la convalida durante l'addestramento.
- Test2017: 20.288 immagini test-dev per il benchmarking dei modelli addestrati. I risultati devono essere inviati al server di valutazione COCO per la valutazione delle prestazioni.
Il file di configurazione YAML del dataset è disponibile all'indirizzo coco.yaml e definisce percorsi, classi e dettagli del dataset.