Esportazione Intel OpenVINO#
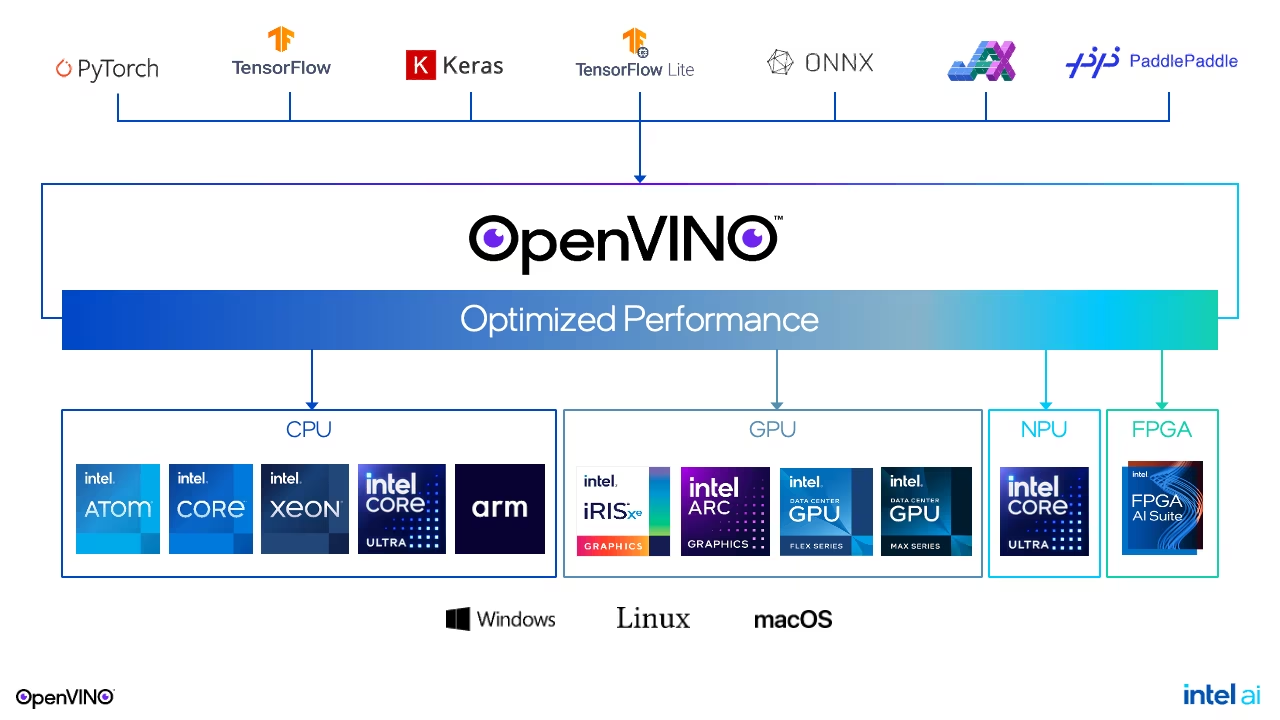
In questa guida vediamo come esportare i modelli YOLO26 nel formato OpenVINO, che può offrire un'accelerazione della CPU fino a 3 volte superiore, e come accelerare l'inferenza YOLO sull'hardware GPU e NPU Intel.
OpenVINO, abbreviazione di Open Visual Inference & ottimizzazione delle reti neurali, è un toolkit completo per ottimizzare e distribuire modelli di inferenza AI. Anche se il nome contiene la parola Visual, OpenVINO supporta anche diverse altre attività, tra cui linguaggio, audio e serie temporali.
Guarda: Come esportare Ultralytics YOLO26 nel formato Intel OpenVINO per inferenze più veloci 🚀
Attività supportate#
L'esportazione OpenVINO supporta tutte e sette le attività di Ultralytics. La segmentazione semantica e la stima della profondità sono disponibili solo con YOLO26, l'unica famiglia che include queste head.
| Attività | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Rilevamento | ✅ | ✅ | ✅ |
| Segmentazione | ✅ | ✅ | ✅ |
| Semantica | ❌ | ❌ | ✅ |
| Profondità | ❌ | ❌ | ✅ |
| Classificazione | ✅ | ✅ | ✅ |
| Stima della posa | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Installazione#
Installa le dipendenze necessarie per l'esportazione OpenVINO con:
pip install "ultralytics[export-openvino]"Queste dipendenze sono incluse anche in ultralytics[export] e vengono installate automaticamente quando sono necessarie per un'esportazione.
Esempi d'uso#
Il formato OpenVINO supporta le modalità Export, Predict e Validate. Esporta il modello, quindi carica il modello esportato per eseguire l'inferenza o convalidarne la precisione su CPU Intel, GPU integrata o discreta oppure NPU.
from ultralytics import YOLO

# Carica un modello YOLO26
model = YOLO("yolo26n.pt")

# Esporta il modello nel formato OpenVINO
model.export(format="openvino") # creates 'yolo26n_openvino_model/'from ultralytics import YOLO
# Carica il modello OpenVINO esportato
model = YOLO("yolo26n_openvino_model/")
# Esegui l'inferenza
results = model("https://ultralytics.com/images/bus.jpg")
# Esegui l'inferenza su un dispositivo specifico; dispositivi disponibili: ["intel:gpu", "intel:npu", "intel:cpu"]
results = model("https://ultralytics.com/images/bus.jpg", device="intel:gpu")from ultralytics import YOLO
# Carica il modello OpenVINO esportato
model = YOLO("yolo26n_openvino_model/")
# # Convalida l'accuratezza sul dataset COCO8
metrics = model.val(data="coco8.yaml")Argomenti di esportazione#
| Argomento | Tipo | Predefinito | Descrizione |
|---|---|---|---|
format | str | 'openvino' | Formato di destinazione del modello esportato, che definisce la compatibilità con i vari ambienti di distribuzione. |
imgsz | int o tuple | 640 | Dimensione dell'immagine desiderata per l'input del modello. Può essere un intero per immagini quadrate o una tupla (height, width) per dimensioni specifiche. |
quantize | int o str | None | Precisione di quantizzazione: 16 (FP16) oppure 8 (INT8/PTQ; richiede la calibrazione data/fraction); 32/non impostato corrisponde a FP32. Sostituisce i flag deprecati half/int8. |
dynamic | bool | False | Consente dimensioni di input dinamiche, aumentando la flessibilità nella gestione di immagini con dimensioni diverse. |
nms | bool, facoltativo | None | Seleziona l'output grezzo (None, predefinito), NMS integrato (True) oppure la testa senza NMS (False). |
batch | int | 1 | Specifica la dimensione batch per l'inferenza del modello esportato o il numero massimo di immagini che il modello esportato elaborerà contemporaneamente in modalità predict. |
data | str | None | Percorso al file YAML del dataset, indispensabile per la quantizzazione; per la classificazione, invece, accetta una directory del dataset o il nome di un dataset integrato. Se omesso insieme a quantize=8, Ultralytics seleziona il dataset di calibrazione predefinito per l'attività del modello. |
fraction | float, int o list | 1.0 | Sottoinsieme di calibrazione espresso come rapporto, numero di immagini o rapporti/conteggi [train, val, test]. Gli elenchi di due elementi lasciano completo test, mentre 0 lo esclude. |
device | str | None | Specifica il dispositivo per l'esportazione: CPU (device=cpu), MPS per Apple silicon (device=mps). |
Per ulteriori dettagli sul processo di esportazione, visita la pagina della documentazione Ultralytics dedicata all'esportazione.
OpenVINO™ è compatibile con la maggior parte dei processori Intel®, ma per garantire prestazioni ottimali:
-
Verifica il supporto di OpenVINO™ Controlla se il tuo chip Intel® è ufficialmente supportato da OpenVINO™ consultando l'elenco di compatibilità Intel.
-
Individua l'acceleratore Consulta la guida all'hardware Intel per verificare se il tuo processore include una NPU (unità di elaborazione neurale) o una GPU integrata.
-
Installa i driver più recenti Se il tuo chip supporta una NPU o una GPU ma OpenVINO™ non la rileva, potrebbe essere necessario installare o aggiornare i driver associati. Segui le istruzioni per l'installazione dei driver per abilitare l'accelerazione completa.
Seguendo questi tre passaggi, puoi assicurarti che OpenVINO™ funzioni in modo ottimale sul tuo hardware Intel®.
Vantaggi di OpenVINO#
- Prestazioni: OpenVINO offre inferenze ad alte prestazioni sfruttando la potenza di CPU Intel, GPU integrate e discrete e FPGA.
- Supporto per l'esecuzione eterogenea: OpenVINO offre un'API che ti permette di scrivere il codice una sola volta e distribuirlo su qualsiasi hardware Intel supportato (CPU, GPU, FPGA, VPU ecc.).
- Ottimizzatore di modelli: OpenVINO include un ottimizzatore di modelli che importa, converte e ottimizza modelli provenienti da diffusi framework di deep learning, come PyTorch, TensorFlow, TensorFlow Lite, Keras, ONNX, PaddlePaddle e Caffe.
- Facilità d'uso: il toolkit include un'ampia raccolta di notebook con tutorial (tra cui l'ottimizzazione di YOLO26) che illustrano diversi aspetti del toolkit.
Struttura dell'esportazione OpenVINO#
Quando esporti un modello nel formato OpenVINO, ottieni una directory che contiene:
- File XML: descrive la topologia della rete.
- File BIN: contiene i dati binari dei pesi e dei bias.
- File di metadati:
metadata.yamlcontiene metadati del modello, come i nomi delle classi, le dimensioni delle immagini e l'attività, che Ultralytics legge quando carica il modello.
Puoi usare questi file per eseguire inferenze con OpenVINO Runtime.
Usare l'esportazione OpenVINO in fase di distribuzione#
Dopo aver esportato correttamente il modello nel formato OpenVINO, hai due opzioni principali per eseguire l'inferenza:
-
Usa il pacchetto
ultralytics, che offre un'API di alto livello e integra OpenVINO Runtime. -
Usa il pacchetto nativo
openvinoper un controllo più avanzato o personalizzato sul comportamento dell'inferenza.
Inferenza con Ultralytics#
Il pacchetto ultralytics ti permette di eseguire facilmente inferenze con il modello OpenVINO esportato tramite il metodo predict. Puoi anche specificare il dispositivo di destinazione (ad es. intel:gpu, intel:npu, intel:cpu) usando l'argomento device.
from ultralytics import YOLO

# Carica il modello OpenVINO esportato
ov_model = YOLO("yolo26n_openvino_model/")  # il percorso del modello OpenVINO esportato
# Esegui l'inferenza con il modello esportato
ov_model.predict(device="intel:gpu")  # specifica il dispositivo su cui vuoi eseguire l'inferenza
Questo approccio è ideale per la prototipazione rapida o la distribuzione quando non hai bisogno del pieno controllo sulla pipeline di inferenza.
Inferenza con OpenVINO Runtime#
OpenVINO Runtime offre un'API unificata per eseguire inferenze su tutto l'hardware Intel supportato. Offre anche funzionalità avanzate, come il bilanciamento del carico tra dispositivi Intel e l'esecuzione asincrona. Per ulteriori informazioni sull'esecuzione delle inferenze, consulta i notebook YOLO26.
Ricorda che ti serviranno i file XML e BIN, oltre a eventuali impostazioni specifiche dell'applicazione, come la dimensione dell'input e il fattore di scala per la normalizzazione, per configurare correttamente il modello e usarlo con Runtime.
Nell'applicazione di distribuzione, in genere dovrai seguire questi passaggi:
- Inizializza OpenVINO creando
core = Core(). - Carica il modello usando il metodo
core.read_model(). - Compila il modello usando la funzione
core.compile_model(). - Prepara l'input (immagine, testo, audio ecc.).
- Esegui l'inferenza usando
compiled_model(input_data).
Per istruzioni dettagliate ed esempi di codice, consulta la documentazione OpenVINO o il tutorial dell'API.
Benchmark OpenVINO YOLO26#
Il team Ultralytics ha eseguito benchmark su YOLO26 in diversi formati di modello e livelli di precisione, valutando velocità e accuratezza su diversi dispositivi Intel compatibili con OpenVINO.
-
I risultati dei benchmark riportati di seguito sono indicativi e possono variare in base alla configurazione esatta di hardware e software del sistema, nonché al carico di lavoro del sistema al momento dell'esecuzione dei benchmark.
-
Tutti i benchmark sono stati eseguiti con la versione 2026.2.1 del pacchetto Python
openvino2026.2.1. -
I modelli YOLO26 su NPU sono supportati solo sui sistemi Intel® Core™ Ultra™ serie 2xxV e serie 3xx o successive.
Intel® Core™ Ultra#
La serie Intel® Core™ Ultra™ definisce un nuovo punto di riferimento per il calcolo ad alte prestazioni ed è progettata per soddisfare le esigenze in continua evoluzione degli utenti moderni: dai gamer e dai creator ai professionisti che sfruttano l'AI. Questa linea di nuova generazione va oltre le tradizionali serie di CPU: combina potenti core CPU, capacità GPU integrate ad alte prestazioni e un'unità di elaborazione neurale (NPU) dedicata in un unico chip, offrendo una soluzione unificata per carichi di lavoro di calcolo diversificati e intensivi.
Il cuore dell'architettura Intel® Core Ultra™ è un design ibrido che offre prestazioni eccezionali nelle attività di elaborazione tradizionali, nei carichi di lavoro accelerati dalla GPU e nelle operazioni basate sull'AI. L'integrazione della NPU migliora l'inferenza AI sul dispositivo, consentendo un apprendimento automatico e un'elaborazione dei dati più rapidi ed efficienti in un'ampia gamma di applicazioni.
La famiglia Core Ultra™ comprende diversi modelli pensati per esigenze prestazionali differenti, da design a basso consumo a varianti ad alta potenza contrassegnate dalla lettera "H", ideali per laptop e formati compatti che richiedono una notevole potenza di calcolo. Tutti i modelli beneficiano della sinergia tra CPU, GPU e NPU integrate, offrendo efficienza, reattività e capacità multitasking notevoli.
Nell'ambito della continua innovazione di Intel, la serie Core Ultra™ definisce un nuovo standard per il calcolo pronto per il futuro. Con diversi modelli già disponibili e altri in arrivo, questa serie sottolinea l'impegno di Intel nel fornire soluzioni all'avanguardia per la prossima generazione di dispositivi intelligenti potenziati dall'AI.
I benchmark riportati di seguito sono stati eseguiti su Intel® Core™ Ultra™ X7 358H, Intel® Core™ Ultra™ 7 258V e Intel® Core™ Ultra™ 7 155H con precisione FP32, FP16 e INT8.
Intel® Core™ Ultra™ X7 358H#
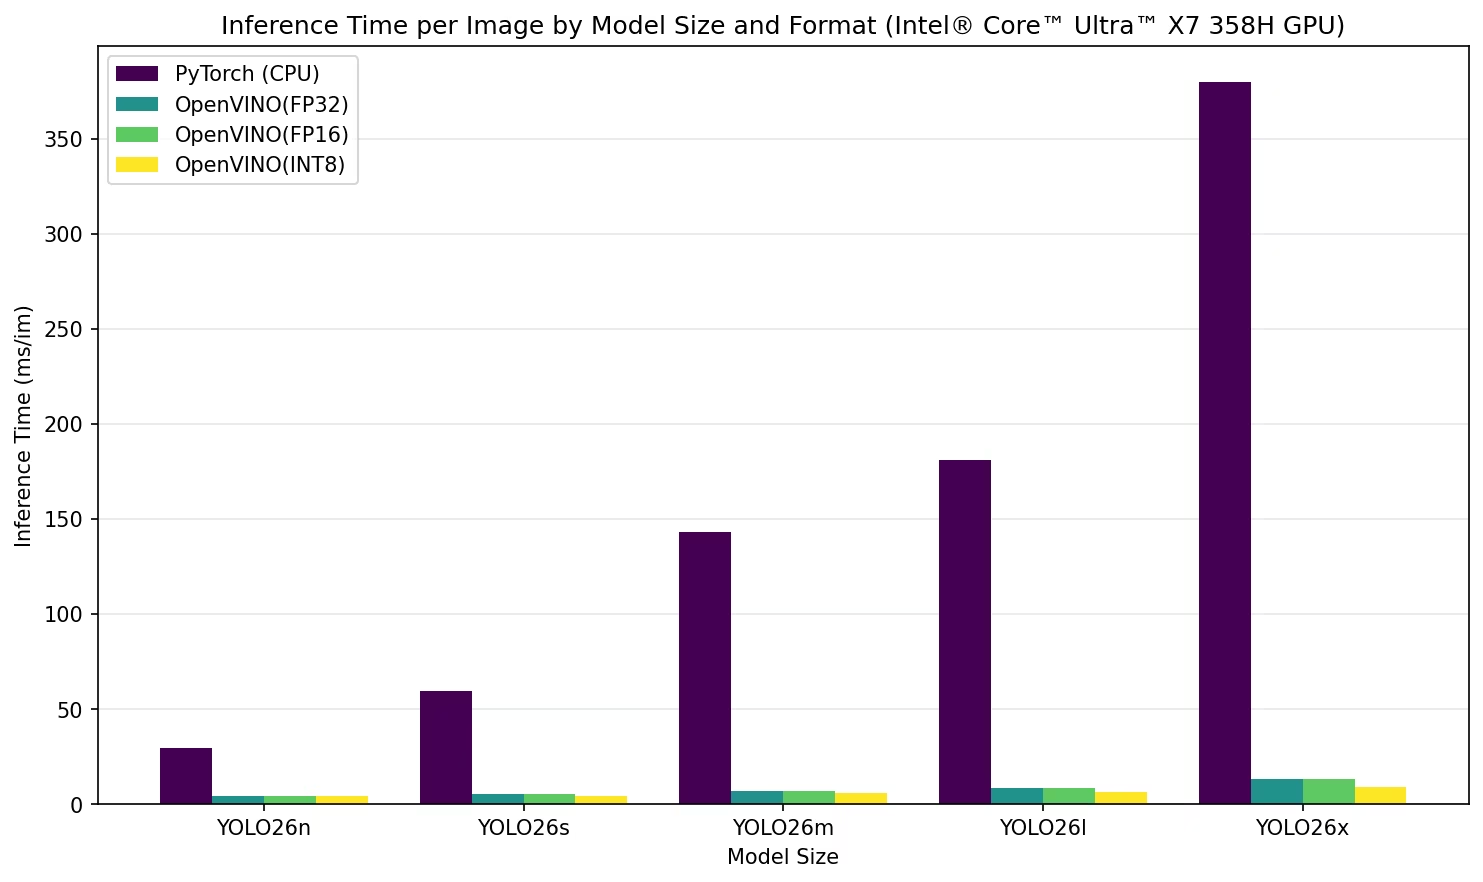
Risultati dettagliati dei benchmark
| Modello | Formato | Precisione | Stato | Dimensione (MB) | metrics/mAP50-95(B) | Tempo di inferenza (ms/im) |
|---|---|---|---|---|---|---|
| YOLO26n | PyTorch (CPU) | FP32 | ✅ | 5.3 | 0.4765 | 29.28 |
| YOLO26n | OpenVINO | FP32 | ✅ | 9.7 | 0.4762 | 4.09 |
| YOLO26n | OpenVINO | FP16 | ✅ | 5.1 | 0.4762 | 4.03 |
| YOLO26n | OpenVINO | INT8 | ✅ | 3.2 | 0.4634 | 4.24 |
| YOLO26s | PyTorch (CPU) | FP32 | ✅ | 19.5 | 0.5703 | 59.32 |
| YOLO26s | OpenVINO | FP32 | ✅ | 36.7 | 0.5616 | 5.08 |
| YOLO26s | OpenVINO | FP16 | ✅ | 18.7 | 0.5616 | 5.14 |
| YOLO26s | OpenVINO | INT8 | ✅ | 10.0 | 0.5462 | 4.47 |
| YOLO26m | PyTorch (CPU) | FP32 | ✅ | 42.2 | 0.6196 | 143.21 |
| YOLO26m | OpenVINO | FP32 | ✅ | 78.4 | 0.6166 | 7.1 |
| YOLO26m | OpenVINO | FP16 | ✅ | 39.5 | 0.6166 | 7.06 |
| YOLO26m | OpenVINO | INT8 | ✅ | 20.6 | 0.6055 | 5.61 |
| YOLO26l | PyTorch (CPU) | FP32 | ✅ | 50.7 | 0.6215 | 181.16 |
| YOLO26l | OpenVINO | FP32 | ✅ | 95.3 | 0.6205 | 8.45 |
| YOLO26l | OpenVINO | FP16 | ✅ | 48.1 | 0.6205 | 8.49 |
| YOLO26l | OpenVINO | INT8 | ✅ | 25.2 | 0.5938 | 6.25 |
| YOLO26x | PyTorch (CPU) | FP32 | ✅ | 113.2 | 0.6512 | 379.75 |
| YOLO26x | OpenVINO | FP32 | ✅ | 213.3 | 0.6568 | 13.03 |
| YOLO26x | OpenVINO | FP16 | ✅ | 107.1 | 0.6568 | 12.98 |
| YOLO26x | OpenVINO | INT8 | ✅ | 54.8 | 0.6385 | 8.74 |
Intel® Core™ Ultra™ 7 258V#
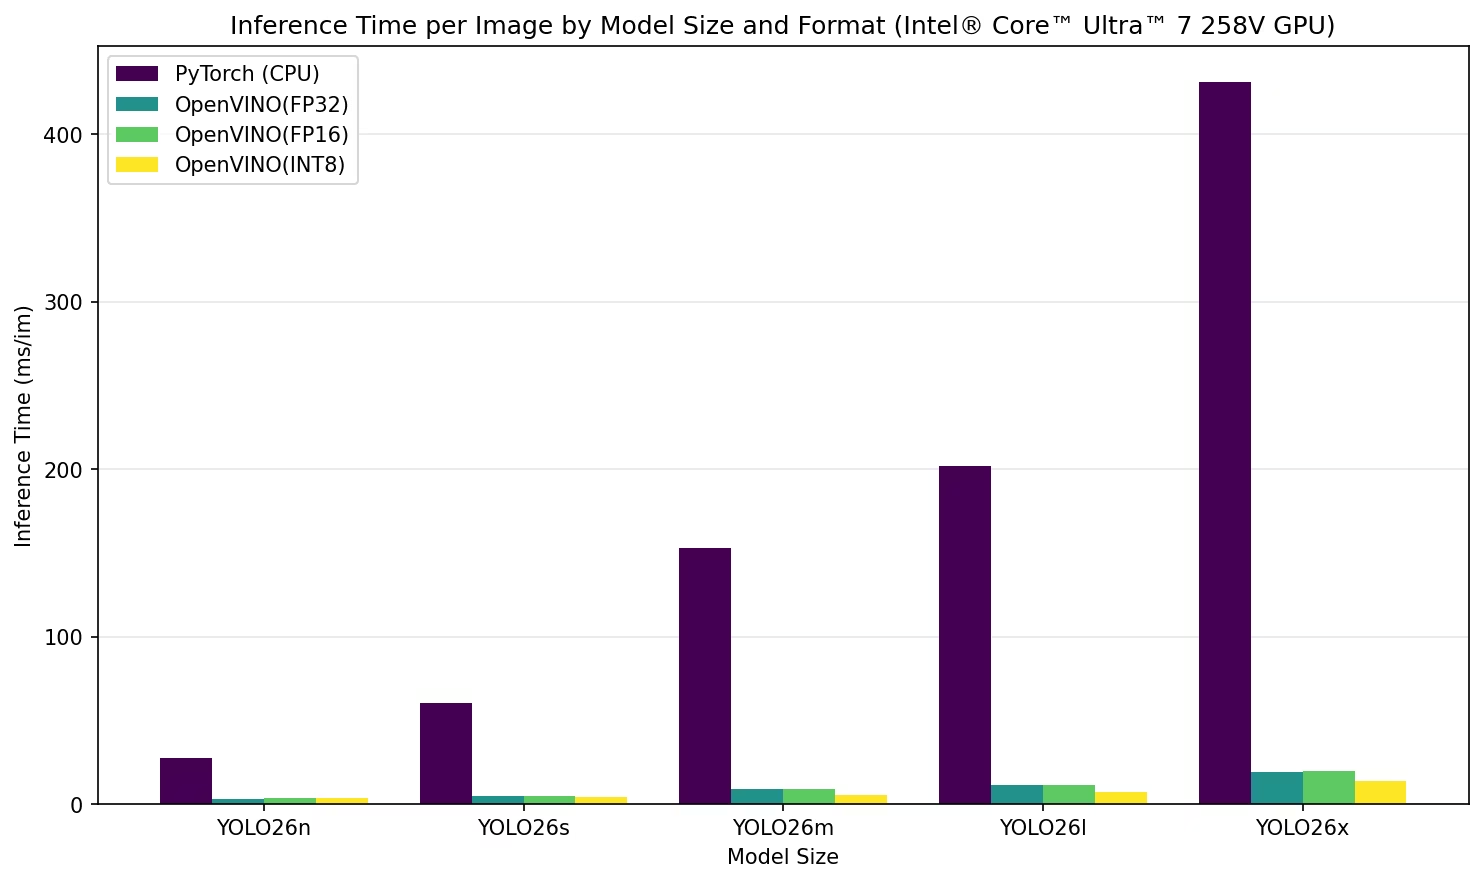
Risultati dettagliati dei benchmark
| Modello | Formato | Precisione | Stato | Dimensione (MB) | metrics/mAP50-95(B) | Tempo di inferenza (ms/im) |
|---|---|---|---|---|---|---|
| YOLO26n | PyTorch (CPU) | FP32 | ✅ | 5.3 | 0.4765 | 27.33 |
| YOLO26n | OpenVINO | FP32 | ✅ | 9.6 | 0.4764 | 3.33 |
| YOLO26n | OpenVINO | FP16 | ✅ | 5.1 | 0.4764 | 3.34 |
| YOLO26n | OpenVINO | INT8 | ✅ | 3.2 | 0.4634 | 3.46 |
| YOLO26s | PyTorch (CPU) | FP32 | ✅ | 19.5 | 0.5703 | 60.2 |
| YOLO26s | OpenVINO | FP32 | ✅ | 36.7 | 0.5616 | 4.66 |
| YOLO26s | OpenVINO | FP16 | ✅ | 18.6 | 0.5616 | 4.65 |
| YOLO26s | OpenVINO | INT8 | ✅ | 10.0 | 0.5462 | 3.99 |
| YOLO26m | PyTorch (CPU) | FP32 | ✅ | 42.2 | 0.6196 | 152.87 |
| YOLO26m | OpenVINO | FP32 | ✅ | 78.4 | 0.6168 | 9.03 |
| YOLO26m | OpenVINO | FP16 | ✅ | 39.5 | 0.6168 | 8.98 |
| YOLO26m | OpenVINO | INT8 | ✅ | 20.6 | 0.6055 | 5.7 |
| YOLO26l | PyTorch (CPU) | FP32 | ✅ | 50.7 | 0.6215 | 201.57 |
| YOLO26l | OpenVINO | FP32 | ✅ | 95.3 | 0.6203 | 11.32 |
| YOLO26l | OpenVINO | FP16 | ✅ | 48.1 | 0.6203 | 11.36 |
| YOLO26l | OpenVINO | INT8 | ✅ | 25.2 | 0.5938 | 7.45 |
| YOLO26x | PyTorch (CPU) | FP32 | ✅ | 113.2 | 0.6512 | 431.04 |
| YOLO26x | OpenVINO | FP32 | ✅ | 213.2 | 0.6568 | 19.08 |
| YOLO26x | OpenVINO | FP16 | ✅ | 107.1 | 0.6568 | 19.63 |
| YOLO26x | OpenVINO | INT8 | ✅ | 54.8 | 0.6385 | 13.69 |
Intel® Core™ Ultra™ 7 155H#
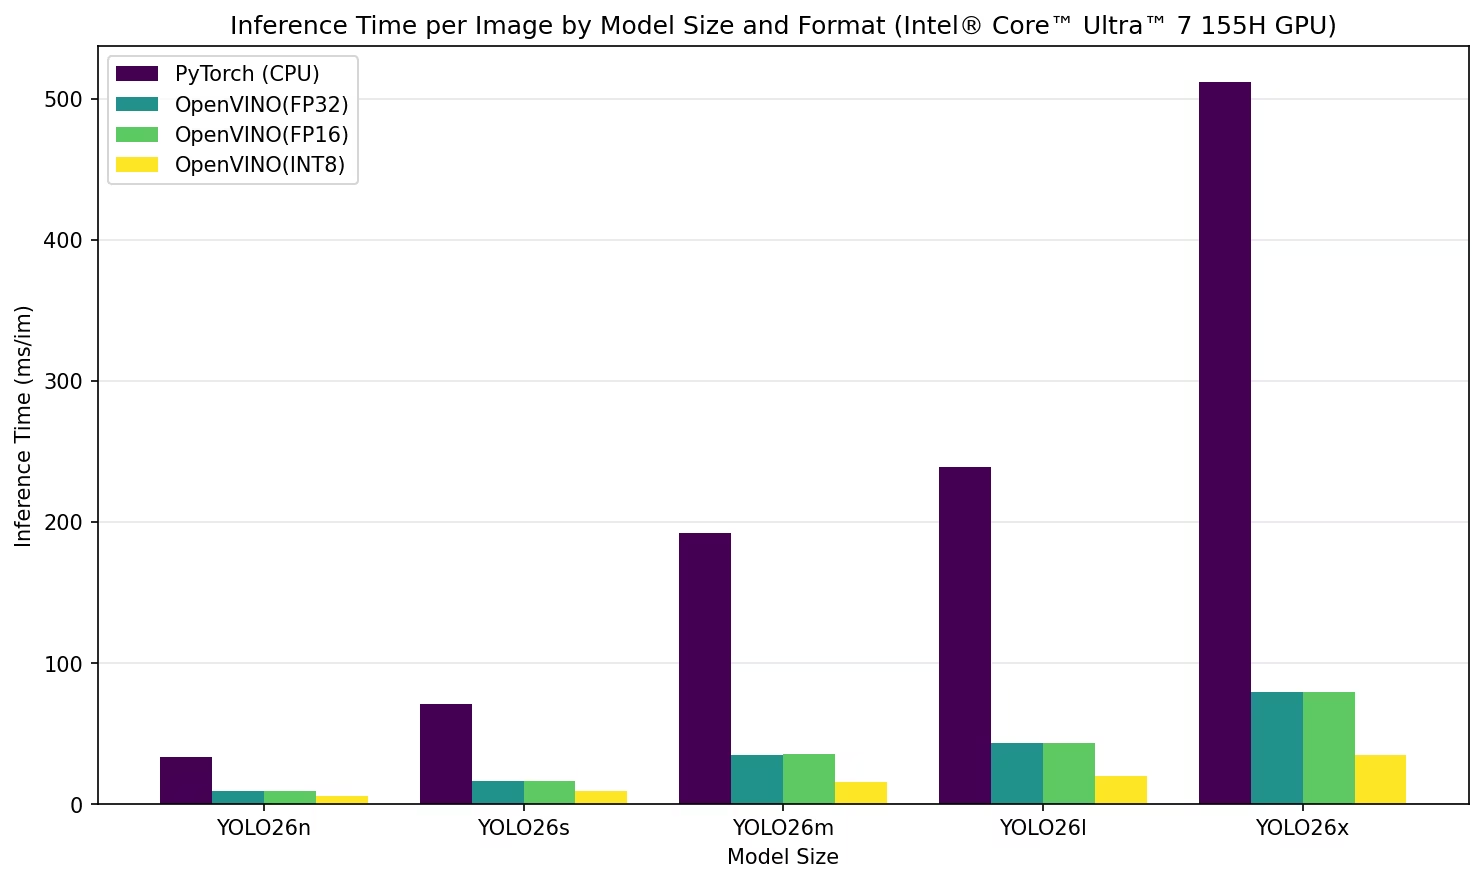
Risultati dettagliati dei benchmark
| Modello | Formato | Precisione | Stato | Dimensione (MB) | metrics/mAP50-95(B) | Tempo di inferenza (ms/im) |
|---|---|---|---|---|---|---|
| YOLO26n | PyTorch (CPU) | FP32 | ✅ | 5.3 | 0.4765 | 33.19 |
| YOLO26n | OpenVINO | FP32 | ✅ | 9.6 | 0.4758 | 9.13 |
| YOLO26n | OpenVINO | FP16 | ✅ | 5.1 | 0.4758 | 9.07 |
| YOLO26n | OpenVINO | INT8 | ✅ | 3.2 | 0.4573 | 5.79 |
| YOLO26s | PyTorch (CPU) | FP32 | ✅ | 19.5 | 0.5703 | 70.92 |
| YOLO26s | OpenVINO | FP32 | ✅ | 36.7 | 0.5616 | 16.37 |
| YOLO26s | OpenVINO | FP16 | ✅ | 18.6 | 0.5616 | 16.65 |
| YOLO26s | OpenVINO | INT8 | ✅ | 10.0 | 0.545 | 9.27 |
| YOLO26m | PyTorch (CPU) | FP32 | ✅ | 42.2 | 0.6196 | 192.45 |
| YOLO26m | OpenVINO | FP32 | ✅ | 78.4 | 0.6167 | 34.47 |
| YOLO26m | OpenVINO | FP16 | ✅ | 39.5 | 0.6167 | 35.71 |
| YOLO26m | OpenVINO | INT8 | ✅ | 20.6 | 0.6039 | 15.46 |
| YOLO26l | PyTorch (CPU) | FP32 | ✅ | 50.7 | 0.6215 | 239.19 |
| YOLO26l | OpenVINO | FP32 | ✅ | 95.3 | 0.621 | 43.24 |
| YOLO26l | OpenVINO | FP16 | ✅ | 48.1 | 0.621 | 43.4 |
| YOLO26l | OpenVINO | INT8 | ✅ | 25.2 | 0.5999 | 19.72 |
| YOLO26x | PyTorch (CPU) | FP32 | ✅ | 113.2 | 0.6512 | 511.89 |
| YOLO26x | OpenVINO | FP32 | ✅ | 213.2 | 0.6552 | 79.49 |
| YOLO26x | OpenVINO | FP16 | ✅ | 107.1 | 0.6552 | 79.45 |
| YOLO26x | OpenVINO | INT8 | ✅ | 54.8 | 0.642 | 34.66 |
Riproduci i nostri risultati#
Per riprodurre i benchmark Ultralytics riportati sopra su tutti i formati di esportazione, esegui questo codice:
from ultralytics import YOLO

# Carica un modello YOLO26n PyTorch
model = YOLO("yolo26n.pt")

# Esegui il benchmark di velocità e accuratezza di YOLO26n sul dataset COCO128 per tutti i formati di esportazione
results = model.benchmark(data="coco128.yaml")
Tieni presente che i risultati dei benchmark possono variare in base alla configurazione esatta di hardware e software del sistema, nonché al carico di lavoro del sistema al momento dell'esecuzione dei benchmark. Per ottenere i risultati più affidabili, usa un dataset con un numero elevato di immagini, ad esempio data='coco.yaml' (5000 immagini di validazione).
Conclusione#
I risultati dei benchmark dimostrano chiaramente i vantaggi dell'esportazione del modello YOLO26 nel formato OpenVINO. Con diversi modelli e piattaforme hardware, il formato OpenVINO offre costantemente una velocità di inferenza superiore rispetto agli altri formati, mantenendo un'accuratezza comparabile.
I benchmark evidenziano l'efficacia di OpenVINO come strumento per distribuire modelli di deep learning. Convertendo i modelli nel formato OpenVINO, gli sviluppatori possono ottenere notevoli miglioramenti delle prestazioni, semplificando la distribuzione dei modelli nelle applicazioni reali.
Per informazioni più dettagliate e istruzioni sull'uso di OpenVINO, consulta la documentazione ufficiale di OpenVINO.
Domande frequenti#
L'esportazione dei modelli YOLO26 nel formato OpenVINO può migliorare significativamente la velocità della CPU e abilitare l'accelerazione tramite GPU e NPU su hardware Intel. Per esportare, puoi usare Python oppure la CLI, come mostrato di seguito:
Esempiofrom ultralytics import YOLO # Carica un modello YOLO26n PyTorch model = YOLO("yolo26n.pt") # Esporta il modello model.export(format="openvino") # creates 'yolo26n_openvino_model/'Per ulteriori informazioni, consulta la documentazione sui formati di esportazione.
L'uso del toolkit OpenVINO di Intel con i modelli YOLO26 offre diversi vantaggi:
- Prestazioni: ottieni un'accelerazione fino a 3x nell'inferenza su CPU e sfrutta le GPU e le NPU Intel per accelerarla.
- Model Optimizer: converti, ottimizza ed esegui modelli provenienti da framework diffusi come PyTorch, TensorFlow e ONNX.
- Facilità d'uso: è disponibile un'ampia raccolta di notebook tutorial per aiutare gli utenti a iniziare, inclusi quelli per YOLO26.
- Esecuzione eterogenea: distribuisci modelli su vari dispositivi hardware Intel con un'API unificata.
Per confronti dettagliati delle prestazioni, visita la nostra sezione dei benchmark.
Dopo aver esportato un modello YOLO26n nel formato OpenVINO, puoi eseguire l'inferenza con Python o la CLI:
Esempiofrom ultralytics import YOLO # Carica il modello OpenVINO esportato ov_model = YOLO("yolo26n_openvino_model/") # Esegui l'inferenza results = ov_model("https://ultralytics.com/images/bus.jpg")Per ulteriori dettagli, consulta la documentazione sulla modalità predict.
Ultralytics YOLO26 è ottimizzato per il rilevamento di oggetti in tempo reale, con elevata accuratezza e velocità. In particolare, abbinato a OpenVINO, YOLO26 offre:
- Accelerazione fino a 3x sulle CPU Intel
- Distribuzione fluida su GPU e NPU Intel
- Accuratezza costante e comparabile tra diversi formati di esportazione
Per un'analisi approfondita delle prestazioni, consulta i nostri benchmark dettagliati di YOLO26 eseguiti su hardware diversi.
Sì, puoi eseguire benchmark dei modelli YOLO26 in diversi formati, tra cui PyTorch, TorchScript, ONNX e OpenVINO. Usa il seguente frammento di codice per eseguire i benchmark sul dataset che preferisci:
Esempiofrom ultralytics import YOLO # Carica un modello YOLO26n PyTorch model = YOLO("yolo26n.pt") # Esegui benchmark della velocità e dell'accuratezza di YOLO26n sul dataset COCO8 per tutti i formati di esportazione results = model.benchmark(data="coco8.yaml")Per risultati dettagliati dei benchmark, consulta la nostra sezione dei benchmark e la documentazione sui formati di esportazione.