Scopri come esportare da YOLO26 nel formato TF SavedModel
Distribuire modelli di machine learning può essere complicato. Tuttavia, un formato modello efficiente e flessibile può semplificarti il lavoro. TF SavedModel è il formato di serializzazione standard di TensorFlow per salvare e caricare i modelli di machine learning in modo coerente. Confeziona un modello TensorFlow affinché possa essere trasferito e usato su dispositivi e sistemi diversi.
Esportare i modelli Ultralytics YOLO26 in TF SavedModel può aiutarti a distribuirli su piattaforme e ambienti diversi. Questa guida spiega come convertire i modelli nel formato TF SavedModel, semplificando l'inferenza sui diversi dispositivi.
Perché esportare in TF SavedModel?#
Il formato TensorFlow SavedModel fa parte dell'ecosistema TensorFlow sviluppato da Google, come mostrato di seguito. È progettato per salvare e serializzare i modelli TensorFlow. Racchiude tutte le informazioni del modello, come l'architettura, i pesi e persino le informazioni di compilazione. In questo modo, è facile condividere e distribuire i modelli e continuare ad addestrarli in ambienti diversi.
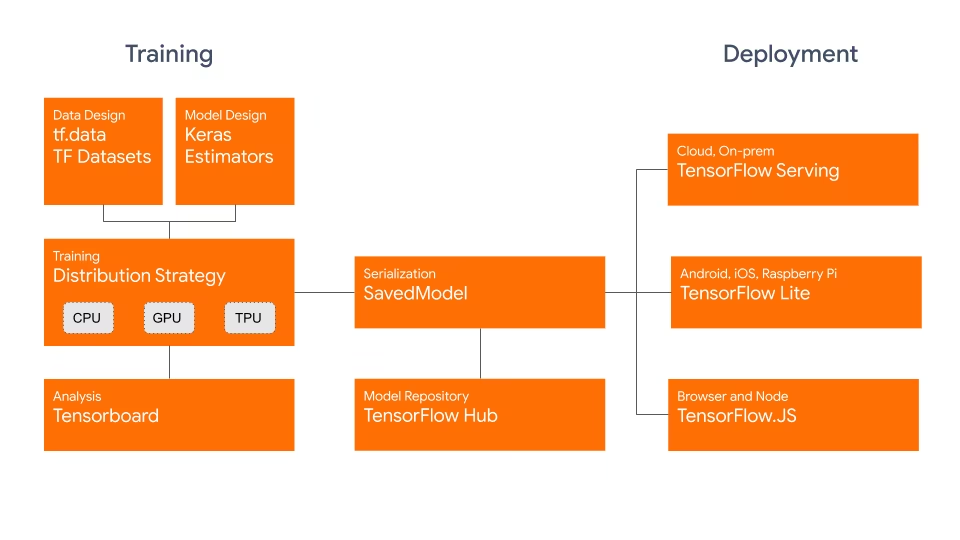
TF SavedModel offre un vantaggio fondamentale: la compatibilità. Funziona bene con TensorFlow Serving, LiteRT (in precedenza TensorFlow Lite) e TensorFlow.js. Questa compatibilità semplifica la condivisione e la distribuzione dei modelli su diverse piattaforme, comprese le applicazioni web e mobili. Il formato TF SavedModel è utile sia per la ricerca sia per la produzione. Offre un metodo unificato per gestire i modelli in diverse applicazioni.
Caratteristiche principali di TF SavedModel#
Ecco le caratteristiche principali che rendono TF SavedModel un'ottima opzione per gli sviluppatori AI:
-
Portabilità: TF SavedModel offre un formato di serializzazione indipendente dal linguaggio, recuperabile e autonomo. Consente a sistemi e strumenti di livello superiore di generare, usare e trasformare modelli TensorFlow. I SavedModel possono essere condivisi e distribuiti facilmente su piattaforme e ambienti diversi.
-
Facilità di distribuzione: TF SavedModel raggruppa in un unico pacchetto il grafo di calcolo, i parametri addestrati e i metadati necessari. Puoi caricarli e usarli facilmente per le inferenze senza il codice originale usato per creare il modello. Questo rende semplice ed efficiente distribuire modelli TensorFlow in diversi ambienti di produzione.
-
Gestione degli asset: TF SavedModel supporta l'inclusione di asset esterni, come vocabolari, embedding o tabelle di ricerca. Questi asset vengono archiviati insieme alla definizione del grafo e alle variabili, così da essere disponibili quando si carica il modello. Questa funzionalità semplifica la gestione e la distribuzione dei modelli che dipendono da risorse esterne.
Opzioni di distribuzione con TF SavedModel#
Prima di esportare i modelli YOLO26 nel formato TF SavedModel, ecco alcuni scenari tipici di distribuzione in cui si usa questo formato.
TF SavedModel offre diverse opzioni per distribuire i tuoi modelli di apprendimento automatico:
-
TensorFlow Serving: TensorFlow Serving è un sistema flessibile e ad alte prestazioni, progettato per servire modelli in ambienti di produzione. Supporta nativamente TF SavedModel, facilitando la distribuzione e la messa a disposizione dei modelli su piattaforme cloud, server on-premise o dispositivi edge come la Raspberry Pi.
-
Piattaforme cloud: I principali provider cloud, come Google Cloud Platform (GCP), Amazon Web Services (AWS) e Microsoft Azure, offrono servizi per distribuire ed eseguire modelli TensorFlow, inclusi i TF SavedModel. Questi servizi forniscono un'infrastruttura gestita e scalabile, che ti consente di distribuire e scalare facilmente i modelli.
-
Dispositivi mobili e integrati: LiteRT (in precedenza TensorFlow Lite), una soluzione leggera per eseguire modelli di apprendimento automatico su dispositivi mobili, integrati e IoT, supporta la conversione dei TF SavedModel nel formato LiteRT. In questo modo puoi distribuire i modelli su un'ampia gamma di dispositivi, dagli smartphone e tablet ai microcontrollori e dispositivi edge.
-
TensorFlow Runtime: TensorFlow Runtime (
tfrt) è un runtime ad alte prestazioni per l'esecuzione di grafi TensorFlow. Offre API di basso livello per caricare ed eseguire TF SavedModel in ambienti C++. TensorFlow Runtime offre prestazioni migliori rispetto al runtime TensorFlow standard. È adatto agli scenari di distribuzione che richiedono inferenze a bassa latenza e una stretta integrazione con le codebase C++ esistenti.
Attività supportate#
L'esportazione TF SavedModel supporta tutti e sette i task di Ultralytics. La segmentazione semantica e la stima della profondità sono disponibili solo con YOLO26, l'unica famiglia che include queste head.
| Attività | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Rilevamento | ✅ | ✅ | ✅ |
| Segmentazione | ✅ | ✅ | ✅ |
| Semantica | ❌ | ❌ | ✅ |
| Profondità | ❌ | ❌ | ✅ |
| Classificazione | ✅ | ✅ | ✅ |
| Stima della posa | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Esportazione dei modelli YOLO26 in TF SavedModel#
Esportando i modelli YOLO26 nel formato TF SavedModel, ne aumenti l'adattabilità e ne semplifichi la distribuzione su varie piattaforme.
Installazione#
Per installare il pacchetto richiesto, esegui:
# Install the required package for YOLO26
pip install ultralytics
Per istruzioni dettagliate e best practice sulla procedura di installazione, consulta la nostra guida all'installazione di Ultralytics. Se durante l'installazione dei pacchetti necessari per YOLO26 riscontri difficoltà, consulta la nostra guida ai problemi comuni per trovare soluzioni e suggerimenti.
L'esportazione TF SavedModel non è supportata su macOS con Python 3.13 o versioni successive.
Utilizzo#
Tutti i modelli Ultralytics YOLO26 sono progettati per supportare l'esportazione senza configurazioni aggiuntive, semplificando l'integrazione nel workflow di distribuzione che preferisci. Puoi consultare l'elenco completo dei formati di esportazione supportati e delle opzioni di configurazione per scegliere la configurazione più adatta alla tua applicazione.
Il formato TF SavedModel supporta le modalità Export, Predict e Validate. Esporta il modello, quindi carica il modello esportato per eseguire inferenze o convalidarne la precisione.
from ultralytics import YOLO

# Carica un modello YOLO26
model = YOLO("yolo26n.pt")

# Esporta il modello nel formato TF SavedModel
model.export(format="saved_model") # creates 'yolo26n_saved_model'from ultralytics import YOLO
# Carica il modello TF SavedModel esportato
model = YOLO("./yolo26n_saved_model")
# Esegui l'inferenza
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Carica il modello TF SavedModel esportato
model = YOLO("./yolo26n_saved_model")
# # Convalida l'accuratezza sul dataset COCO8
metrics = model.val(data="coco8.yaml")Argomenti di esportazione#
| Argomento | Tipo | Predefinito | Descrizione |
|---|---|---|---|
format | str | 'saved_model' | Formato di destinazione del modello esportato, che definisce la compatibilità con i vari ambienti di distribuzione. |
imgsz | int o tuple | 640 | Dimensione dell'immagine desiderata per l'input del modello. Può essere un intero per immagini quadrate o una tupla (height, width) per dimensioni specifiche. |
quantize | int o str | None | Precisione della quantizzazione: 8 mantiene il SavedModel in FP32 e aggiunge file INT8 .tflite accanto a esso (calibrati con data/fraction), oppure 32/non impostato (FP32). FP16 non è supportato per l'esportazione SavedModel. Sostituisce il flag deprecato int8. |
opset | int | None | Specifica la versione dell'opset ONNX per il grafo ONNX intermedio. Se non è impostata, viene usato l'opset 18 (inferiore con PyTorch < 2.4), limitato alla versione onnx installata. RT-DETR usa 19. |
nms | bool, facoltativo | None | Seleziona l'output grezzo (None, predefinito), NMS integrato (True) oppure la testa senza NMS (False). |
batch | int | 1 | Specifica la dimensione batch per l'inferenza del modello esportato o il numero massimo di immagini che il modello esportato elaborerà contemporaneamente in modalità predict. |
data | str | None | Percorso al file YAML del dataset, indispensabile per la quantizzazione; per la classificazione, invece, accetta una directory del dataset o il nome di un dataset integrato. Se omesso insieme a quantize=8, Ultralytics seleziona il dataset di calibrazione predefinito per l'attività del modello. |
fraction | float, int o list | 1.0 | Sottoinsieme di calibrazione espresso come rapporto, numero di immagini o rapporti/conteggi [train, val, test]. Gli elenchi di due elementi lasciano completo test, mentre 0 lo esclude. |
device | str | None | Specifica il dispositivo per l'esportazione: CPU (device=cpu), MPS per Apple silicon (device=mps). |
Per ulteriori dettagli sul processo di esportazione, visita la pagina della documentazione Ultralytics dedicata all'esportazione.
Distribuzione dei modelli YOLO26 TF SavedModel esportati#
Ora che hai esportato il modello YOLO26 nel formato TF SavedModel, il passaggio successivo è distribuirlo. Il primo passaggio principale e consigliato per eseguire un modello TF SavedModel è usare il metodo YOLO("yolo26n_saved_model/"), come mostrato in precedenza nello snippet di codice.
Per istruzioni dettagliate sulla distribuzione dei modelli TF SavedModel, consulta le risorse seguenti:
-
TensorFlow Serving: documentazione per sviluppatori sulla distribuzione dei modelli TF SavedModel con TensorFlow Serving.
-
Eseguire un TensorFlow SavedModel in Node.js: un post del blog TensorFlow che spiega come eseguire direttamente un TensorFlow SavedModel in Node.js senza convertirlo.
-
Distribuzione sul cloud: un post sul blog di TensorFlow sulla distribuzione sul Cloud AI Platform di un modello TensorFlow SavedModel.
Riepilogo#
In questa guida abbiamo esplorato come esportare i modelli Ultralytics YOLO26 nel formato TF SavedModel. Esportando nel formato TF SavedModel, puoi ottimizzare, distribuire e scalare i tuoi modelli YOLO26 su un'ampia gamma di piattaforme.
Per ulteriori dettagli sull'utilizzo, consulta la documentazione ufficiale di TF SavedModel.
Domande frequenti#
Esportare un modello Ultralytics YOLO nel formato TensorFlow SavedModel è semplice. Puoi farlo con Python o CLI:
Esportazione di YOLO26 in TF SavedModelfrom ultralytics import YOLO # Carica un modello YOLO26 model = YOLO("yolo26n.pt") # Esporta il modello nel formato TF SavedModel model.export(format="saved_model") # creates 'yolo26n_saved_model' # Carica il TF SavedModel esportato per l'inferenza tf_savedmodel_model = YOLO("./yolo26n_saved_model") results = tf_savedmodel_model("https://ultralytics.com/images/bus.jpg")Per ulteriori dettagli, consulta la documentazione sull'esportazione di Ultralytics.
Il formato TensorFlow SavedModel offre diversi vantaggi per la distribuzione dei modelli:
- Portabilità: offre un formato indipendente dal linguaggio, che semplifica la condivisione e la distribuzione dei modelli in ambienti diversi.
- Compatibilità: funziona con strumenti come TensorFlow Serving, LiteRT e TensorFlow.js, essenziali per distribuire modelli su varie piattaforme, incluse applicazioni web e mobile.
- Incapsulamento completo: codifica l'architettura del modello, i pesi e le informazioni di compilazione, semplificando la condivisione e la continuazione dell'addestramento.
Per scoprire altri vantaggi e opzioni di distribuzione, consulta le opzioni di distribuzione dei modelli Ultralytics YOLO.
TF SavedModel può essere distribuito in diversi ambienti, tra cui:
- TensorFlow Serving: ideale per gli ambienti di produzione che richiedono la distribuzione di modelli scalabile e ad alte prestazioni.
- Piattaforme cloud: supporta i principali servizi cloud, come Google Cloud Platform (GCP), Amazon Web Services (AWS) e Microsoft Azure, per una distribuzione scalabile dei modelli.
- Dispositivi mobili ed embedded: usando LiteRT (in precedenza TensorFlow Lite) per convertire i TF SavedModel, puoi distribuirli su dispositivi mobili, dispositivi IoT e microcontrollori.
- TensorFlow Runtime: per gli ambienti C++ che richiedono inferenze a bassa latenza e prestazioni migliori.
Per conoscere nel dettaglio le opzioni di distribuzione, consulta le guide ufficiali sulla distribuzione dei modelli TensorFlow.
Per esportare i modelli YOLO26, devi installare il pacchetto
ultralytics. Esegui il seguente comando nel terminale:pip install ultralyticsPer istruzioni di installazione più dettagliate e best practice, consulta la nostra guida all'installazione di Ultralytics. Se riscontri problemi, consulta la nostra guida ai problemi comuni.
Il formato TF SavedModel è utile per gli sviluppatori di AI grazie alle seguenti caratteristiche:
- Portabilità: consente la condivisione e la distribuzione in diversi ambienti.
- Semplicità di distribuzione: racchiude il grafo computazionale, i parametri addestrati e i metadati in un unico pacchetto, semplificando il caricamento e l'inferenza.
- Gestione degli asset: supporta asset esterni come i vocabolari, garantendone la disponibilità al caricamento del modello.
Per ulteriori dettagli, consulta la documentazione ufficiale di TensorFlow.


Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.