YOLOv7: Bag-of-Freebies addestrabile#
YOLOv7, rilasciato nel luglio 2022, ha rappresentato un significativo progresso nel rilevamento di oggetti in tempo reale al momento del suo rilascio. Ha raggiunto un AP del 56.8% sulla GPU V100, stabilendo nuovi benchmark al momento della sua introduzione. YOLOv7 ha superato i rilevatori di oggetti contemporanei come YOLOR, YOLOX, Scaled-YOLOv4 e YOLOv5 in termini di velocità e accuratezza. Il modello è addestrato da zero sul dataset MS COCO, senza utilizzare altri dataset né pesi preaddestrati. Il codice sorgente di YOLOv7 è disponibile su GitHub. Nota che modelli più recenti come YOLO11 e YOLO26 hanno da allora raggiunto un'accuratezza superiore con un'efficienza migliorata.
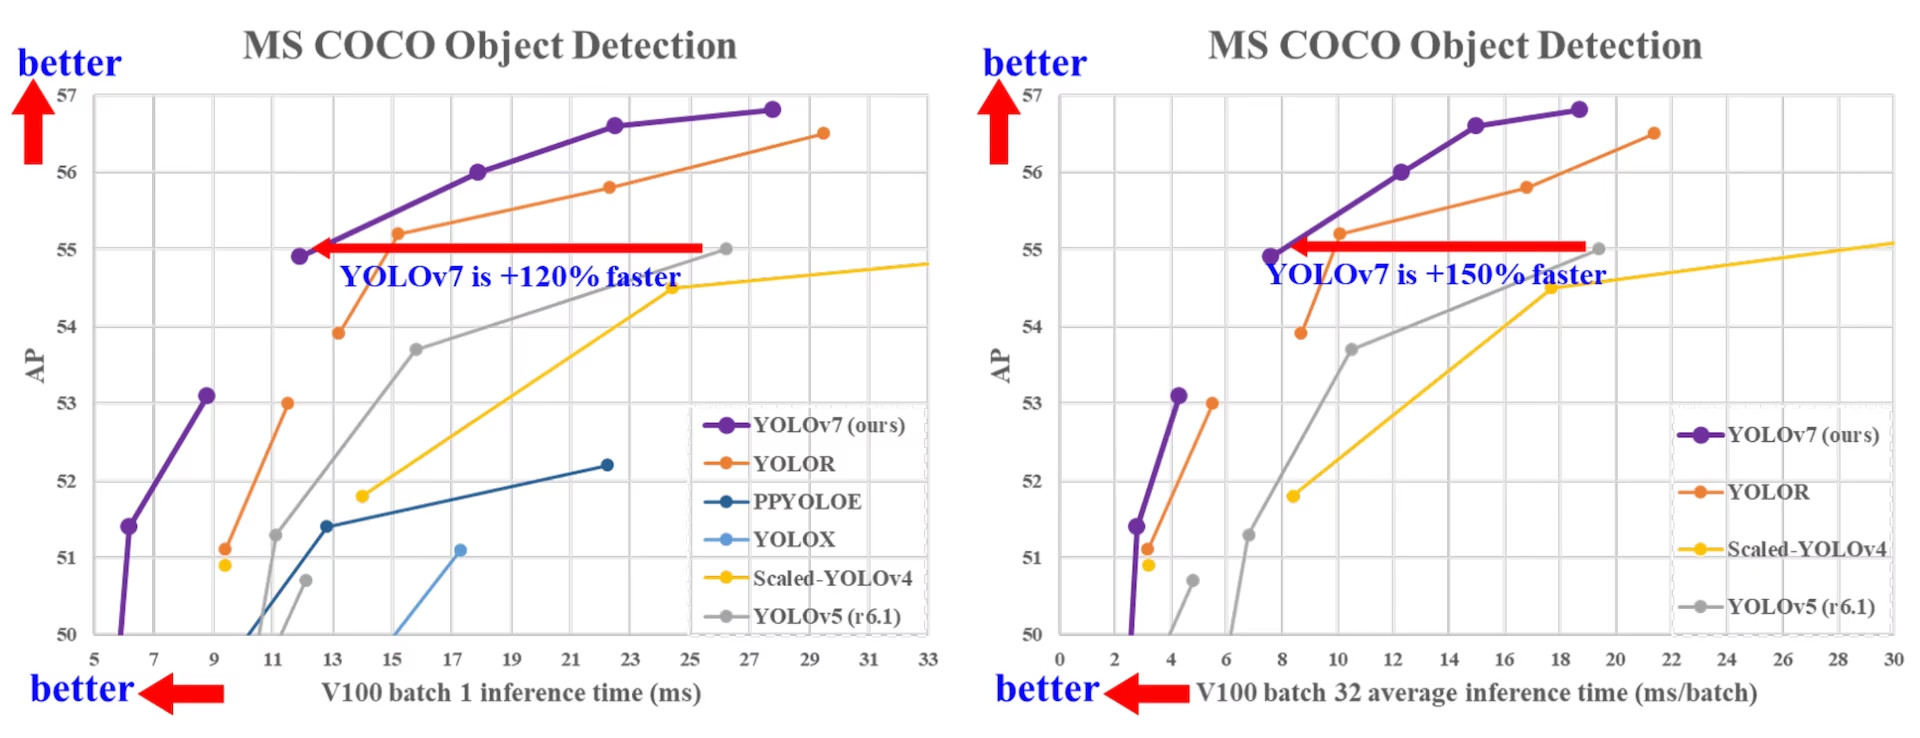
Confronto tra i rilevatori di oggetti SOTA#
Dai risultati della tabella comparativa di YOLO sappiamo che il metodo proposto offre complessivamente il miglior compromesso tra velocità e precisione. Confrontando YOLOv7-tiny-SiLU con YOLOv5-N (r6.1), il nostro metodo è più veloce di 127 fps e più preciso del 10.7% in AP. Inoltre, YOLOv7 raggiunge il 51.4% di AP a una frequenza di 161 fps, mentre PPYOLOE-L, con lo stesso AP, raggiunge solo 78 fps. In termini di numero di parametri, YOLOv7 ne usa il 41% in meno rispetto a PPYOLOE-L.
Confrontando YOLOv7-X, con una velocità di inferenza di 114 fps, con YOLOv5-L (r6.1), che raggiunge 99 fps, YOLOv7-X può migliorare l'AP del 3.9%. Se si confronta YOLOv7-X con YOLOv5-X (r6.1) di dimensioni simili, la velocità di inferenza di YOLOv7-X è superiore di 31 fps. Inoltre, in termini di numero di parametri e calcolo, YOLOv7-X riduce i parametri del 22% e il calcolo dell'8% rispetto a YOLOv5-X (r6.1), migliorando però l'AP del 2.2% (Fonte).
| Modello | Parametri (M) | FLOPs (G) | Dimensioni (pixel) | FPS | APtest / val 50-95 | APtest 50 | APtest 75 | APtest S | APtest M | APtest L |
|---|---|---|---|---|---|---|---|---|---|---|
| YOLOX-S | 9.0 | 26.8 | 640 | 102 | 40.5% / 40.5% | - | - | - | - | - |
| YOLOX-M | 25.3 | 73.8 | 640 | 81 | 47.2% / 46.9% | - | - | - | - | - |
| YOLOX-L | 54.2 | 155.6 | 640 | 69 | 50.1% / 49.7% | - | - | - | - | - |
| YOLOX-X | 99.1 | 281.9 | 640 | 58 | 51.5% / 51.1% | - | - | - | - | - |
| PPYOLOE-S | 7.9 | 17.4 | 640 | 208 | 43.1% / 42.7% | 60.5% | 46.6% | 23.2% | 46.4% | 56.9% |
| PPYOLOE-M | 23.4 | 49.9 | 640 | 123 | 48.9% / 48.6% | 66.5% | 53.0% | 28.6% | 52.9% | 63.8% |
| PPYOLOE-L | 52.2 | 110.1 | 640 | 78 | 51.4% / 50.9% | 68.9% | 55.6% | 31.4% | 55.3% | 66.1% |
| PPYOLOE-X | 98.4 | 206.6 | 640 | 45 | 52.2% / 51.9% | 69.9% | 56.5% | 33.3% | 56.3% | 66.4% |
| YOLOv5-N (r6.1) | 1.9 | 4.5 | 640 | 159 | - / 28.0% | - | - | - | - | - |
| YOLOv5-S (r6.1) | 7.2 | 16.5 | 640 | 156 | - / 37.4% | - | - | - | - | - |
| YOLOv5-M (r6.1) | 21.2 | 49.0 | 640 | 122 | - / 45.4% | - | - | - | - | - |
| YOLOv5-L (r6.1) | 46.5 | 109.1 | 640 | 99 | - / 49.0% | - | - | - | - | - |
| YOLOv5-X (r6.1) | 86.7 | 205.7 | 640 | 83 | - / 50.7% | - | - | - | - | - |
| YOLOR-CSP | 52.9 | 120.4 | 640 | 106 | 51.1% / 50.8% | 69.6% | 55.7% | 31.7% | 55.3% | 64.7% |
| YOLOR-CSP-X | 96.9 | 226.8 | 640 | 87 | 53.0% / 52.7% | 71.4% | 57.9% | 33.7% | 57.1% | 66.8% |
| YOLOv7-tiny-SiLU | 6.2 | 13.8 | 640 | 286 | 38.7% / 38.7% | 56.7% | 41.7% | 18.8% | 42.4% | 51.9% |
| YOLOv7 | 36.9 | 104.7 | 640 | 161 | 51.4% / 51.2% | 69.7% | 55.9% | 31.8% | 55.5% | 65.0% |
| YOLOv7-X | 71.3 | 189.9 | 640 | 114 | 53.1% / 52.9% | 71.2% | 57.8% | 33.8% | 57.1% | 67.4% |
| YOLOv5-N6 (r6.1) | 3.2 | 18.4 | 1280 | 123 | - / 36.0% | - | - | - | - | - |
| YOLOv5-S6 (r6.1) | 12.6 | 67.2 | 1280 | 122 | - / 44.8% | - | - | - | - | - |
| YOLOv5-M6 (r6.1) | 35.7 | 200.0 | 1280 | 90 | - / 51.3% | - | - | - | - | - |
| YOLOv5-L6 (r6.1) | 76.8 | 445.6 | 1280 | 63 | - / 53.7% | - | - | - | - | - |
| YOLOv5-X6 (r6.1) | 140.7 | 839.2 | 1280 | 38 | - / 55.0% | - | - | - | - | - |
| YOLOR-P6 | 37.2 | 325.6 | 1280 | 76 | 53.9% / 53.5% | 71.4% | 58.9% | 36.1% | 57.7% | 65.6% |
| YOLOR-W6 | 79.8 | 453.2 | 1280 | 66 | 55.2% / 54.8% | 72.7% | 60.5% | 37.7% | 59.1% | 67.1% |
| YOLOR-E6 | 115.8 | 683.2 | 1280 | 45 | 55.8% / 55.7% | 73.4% | 61.1% | 38.4% | 59.7% | 67.7% |
| YOLOR-D6 | 151.7 | 935.6 | 1280 | 34 | 56.5% / 56.1% | 74.1% | 61.9% | 38.9% | 60.4% | 68.7% |
| YOLOv7-W6 | 70.4 | 360.0 | 1280 | 84 | 54.9% / 54.6% | 72.6% | 60.1% | 37.3% | 58.7% | 67.1% |
| YOLOv7-E6 | 97.2 | 515.2 | 1280 | 56 | 56.0% / 55.9% | 73.5% | 61.2% | 38.0% | 59.9% | 68.4% |
| YOLOv7-D6 | 154.7 | 806.8 | 1280 | 44 | 56.6% / 56.3% | 74.0% | 61.8% | 38.8% | 60.1% | 69.5% |
| YOLOv7-E6E | 151.7 | 843.2 | 1280 | 36 | 56.8% / 56.8% | 74.4% | 62.1% | 39.3% | 60.5% | 69.0% |
Panoramica#
Il rilevamento di oggetti in tempo reale è una componente importante in molti sistemi di visione artificiale, tra cui il tracciamento di oggetti multipli, la guida autonoma, la robotica e l'analisi di immagini mediche. Negli ultimi anni, lo sviluppo del rilevamento di oggetti in tempo reale si è concentrato sulla progettazione di architetture efficienti e sul miglioramento della velocità di inferenza di varie CPU, GPU e unità di elaborazione neurale (NPUs). YOLOv7 supporta sia i dispositivi GPU mobili sia quelli GPU, dall'edge al cloud.
A differenza dei rilevatori di oggetti tradizionali in tempo reale, che si concentrano sull'ottimizzazione dell'architettura, YOLOv7 introduce un'attenzione particolare all'ottimizzazione del processo di addestramento. Questa comprende moduli e metodi di ottimizzazione progettati per migliorare la precisione del rilevamento di oggetti senza aumentare il costo di inferenza, un concetto noto come "trainable bag-of-freebies".
Funzionalità principali#
YOLOv7 introduce diverse funzionalità chiave:
-
Riparametrizzazione del modello: YOLOv7 propone un modello riparametrizzato pianificato, una strategia applicabile ai livelli di diverse reti basata sul concetto di percorso di propagazione del gradiente.
-
Assegnazione dinamica delle etichette: L'addestramento del modello con più livelli di output pone una nuova questione: "Come assegnare obiettivi dinamici agli output dei diversi rami?" Per risolvere questo problema, YOLOv7 introduce un nuovo metodo di assegnazione delle etichette chiamato assegnazione guidata delle etichette dai livelli grossolani a quelli fini.
-
Ridimensionamento esteso e composto: YOLOv7 propone metodi di "estensione" e "ridimensionamento composto" per il rilevatore di oggetti in tempo reale, che consentono di sfruttare efficacemente i parametri e la potenza di calcolo.
-
Efficienza: Il metodo proposto da YOLOv7 può ridurre efficacemente di circa il 40% i parametri e del 50% la potenza di calcolo rispetto ai rilevatori di oggetti in tempo reale più avanzati, offrendo al contempo una maggiore velocità di inferenza e una precisione di rilevamento superiore.
Esempi d'uso#
Ultralytics non pubblica pesi preaddestrati yolov7.pt né file YAML ultralytics/cfg/models/v7/, e il pacchetto Python di Ultralytics non supporta l'addestramento e l'inferenza nativi di YOLOv7 con PyTorch. Tuttavia, puoi importare in Ultralytics un checkpoint YOLOv7 addestrato nel repository YOLOv7 upstream, esportandolo in ONNX o TensorRT, come mostrato di seguito.
Esportazione ONNX#
Per usare un modello YOLOv7 ONNX con Ultralytics:
-
(Facoltativo) Installa Ultralytics ed esporta un modello ONNX per installare automaticamente le dipendenze necessarie:
pip install ultralytics yolo export model=yolo26n.pt format=onnx -
Esporta il modello YOLOv7 desiderato usando l'esportatore nel repository YOLOv7:
git clone https://github.com/WongKinYiu/yolov7 cd yolov7 python export.py --weights yolov7-tiny.pt --grid --end2end --simplify --topk-all 100 --iou-thres 0.65 --conf-thres 0.35 --img-size 640 640 --max-wh 640 -
Modifica il grafo del modello ONNX per renderlo compatibile con Ultralytics usando il seguente script:
import numpy as np import onnx from onnx import helper, numpy_helper # Load the ONNX model model_path = "yolov7/yolov7-tiny.onnx" # Replace with your model path model = onnx.load(model_path) graph = model.graph # Fix input shape to batch size 1 input_shape = graph.input[0].type.tensor_type.shape input_shape.dim[0].dim_value = 1 # Define the output of the original model original_output_name = graph.output[0].name # Create slicing nodes sliced_output_name = f"{original_output_name}_sliced" # Define initializers for slicing (remove the first value) start = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_start") end = numpy_helper.from_array(np.array([7], dtype=np.int64), name="slice_end") axes = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_axes") steps = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_steps") graph.initializer.extend([start, end, axes, steps]) slice_node = helper.make_node( "Slice", inputs=[original_output_name, "slice_start", "slice_end", "slice_axes", "slice_steps"], outputs=[sliced_output_name], name="SliceNode", ) graph.node.append(slice_node) # Define segment slicing seg1_start = numpy_helper.from_array(np.array([0], dtype=np.int64), name="seg1_start") seg1_end = numpy_helper.from_array(np.array([4], dtype=np.int64), name="seg1_end") seg2_start = numpy_helper.from_array(np.array([4], dtype=np.int64), name="seg2_start") seg2_end = numpy_helper.from_array(np.array([5], dtype=np.int64), name="seg2_end") seg3_start = numpy_helper.from_array(np.array([5], dtype=np.int64), name="seg3_start") seg3_end = numpy_helper.from_array(np.array([6], dtype=np.int64), name="seg3_end") graph.initializer.extend([seg1_start, seg1_end, seg2_start, seg2_end, seg3_start, seg3_end]) # Create intermediate tensors for segments segment_1_name = f"{sliced_output_name}_segment1" segment_2_name = f"{sliced_output_name}_segment2" segment_3_name = f"{sliced_output_name}_segment3" # Add segment slicing nodes graph.node.extend( [ helper.make_node( "Slice", inputs=[sliced_output_name, "seg1_start", "seg1_end", "slice_axes", "slice_steps"], outputs=[segment_1_name], name="SliceSegment1", ), helper.make_node( "Slice", inputs=[sliced_output_name, "seg2_start", "seg2_end", "slice_axes", "slice_steps"], outputs=[segment_2_name], name="SliceSegment2", ), helper.make_node( "Slice", inputs=[sliced_output_name, "seg3_start", "seg3_end", "slice_axes", "slice_steps"], outputs=[segment_3_name], name="SliceSegment3", ), ] ) # Concatenate the segments concat_output_name = f"{sliced_output_name}_concat" concat_node = helper.make_node( "Concat", inputs=[segment_1_name, segment_3_name, segment_2_name], outputs=[concat_output_name], axis=1, name="ConcatSwapped", ) graph.node.append(concat_node) # Reshape to [1, -1, 6] reshape_shape = numpy_helper.from_array(np.array([1, -1, 6], dtype=np.int64), name="reshape_shape") graph.initializer.append(reshape_shape) final_output_name = f"{concat_output_name}_batched" reshape_node = helper.make_node( "Reshape", inputs=[concat_output_name, "reshape_shape"], outputs=[final_output_name], name="AddBatchDimension", ) graph.node.append(reshape_node) # Get the shape of the reshaped tensor shape_node_name = f"{final_output_name}_shape" shape_node = helper.make_node( "Shape", inputs=[final_output_name], outputs=[shape_node_name], name="GetShapeDim", ) graph.node.append(shape_node) # Extract the second dimension dim_1_index = numpy_helper.from_array(np.array([1], dtype=np.int64), name="dim_1_index") graph.initializer.append(dim_1_index) second_dim_name = f"{final_output_name}_dim1" gather_node = helper.make_node( "Gather", inputs=[shape_node_name, "dim_1_index"], outputs=[second_dim_name], name="GatherSecondDim", ) graph.node.append(gather_node) # Subtract from 100 to determine how many values to pad target_size = numpy_helper.from_array(np.array([100], dtype=np.int64), name="target_size") graph.initializer.append(target_size) pad_size_name = f"{second_dim_name}_padsize" sub_node = helper.make_node( "Sub", inputs=["target_size", second_dim_name], outputs=[pad_size_name], name="CalculatePadSize", ) graph.node.append(sub_node) # Build the [2, 3] pad array: # 1st row -> [0, 0, 0] (no padding at the start of any dim) # 2nd row -> [0, pad_size, 0] (pad only at the end of the second dim) pad_starts = numpy_helper.from_array(np.array([0, 0, 0], dtype=np.int64), name="pad_starts") graph.initializer.append(pad_starts) zero_scalar = numpy_helper.from_array(np.array([0], dtype=np.int64), name="zero_scalar") graph.initializer.append(zero_scalar) pad_ends_name = "pad_ends" concat_pad_ends_node = helper.make_node( "Concat", inputs=["zero_scalar", pad_size_name, "zero_scalar"], outputs=[pad_ends_name], axis=0, name="ConcatPadEnds", ) graph.node.append(concat_pad_ends_node) pad_values_name = "pad_values" concat_pad_node = helper.make_node( "Concat", inputs=["pad_starts", pad_ends_name], outputs=[pad_values_name], axis=0, name="ConcatPadStartsEnds", ) graph.node.append(concat_pad_node) # Create Pad operator to pad with zeros pad_output_name = f"{final_output_name}_padded" pad_constant_value = numpy_helper.from_array( np.array([0.0], dtype=np.float32), name="pad_constant_value", ) graph.initializer.append(pad_constant_value) pad_node = helper.make_node( "Pad", inputs=[final_output_name, pad_values_name, "pad_constant_value"], outputs=[pad_output_name], mode="constant", name="PadToFixedSize", ) graph.node.append(pad_node) # Update the graph's final output to [1, 100, 6] new_output_type = onnx.helper.make_tensor_type_proto( elem_type=graph.output[0].type.tensor_type.elem_type, shape=[1, 100, 6] ) new_output = onnx.helper.make_value_info(name=pad_output_name, type_proto=new_output_type) # Replace the old output with the new one graph.output.pop() graph.output.extend([new_output]) # Save the modified model onnx.save(model, "yolov7-ultralytics.onnx") -
Puoi quindi caricare il modello ONNX modificato ed eseguirne normalmente l'inferenza con Ultralytics:
from ultralytics import ASSETS, YOLO

model = YOLO("yolov7-ultralytics.onnx", task="detect")

results = model(ASSETS / "bus.jpg")
Esportazione TensorRT#
-
Segui i passaggi 1-2 della sezione Esportazione ONNX.
-
Installa il pacchetto Python
TensorRT:pip install tensorrt -
Esegui il seguente script per convertire il modello ONNX modificato in un motore TensorRT:
from ultralytics.utils.export import onnx2engine onnx2engine("yolov7-ultralytics.onnx", quantize=16) -
Carica ed esegui il modello in Ultralytics:
from ultralytics import ASSETS, YOLO

model = YOLO("yolov7-ultralytics.engine", task="detect")

results = model(ASSETS / "bus.jpg")
Citazioni e ringraziamenti#
Desideriamo ringraziare gli autori di YOLOv7 per il loro importante contributo al campo del rilevamento di oggetti in tempo reale:
@inproceedings{wang2023yolov7,
  title={YOLOv7: Trainable Bag-of-Freebies Sets New State-of-the-Art for Real-Time Object Detectors},
  author={Wang, Chien-Yao and Bochkovskiy, Alexey and Liao, Hong-Yuan Mark},
  booktitle={Proceedings of the IEEE/CVF conference on Computer Vision and Pattern Recognition (CVPR)},
  pages={7464--7475},
  year={2023}
}
L'articolo ufficiale su YOLOv7 è stato pubblicato su CVF 2023 Open Access, con una versione preliminare su arXiv. Gli autori hanno reso pubblica la loro ricerca e il codice è disponibile su GitHub. Apprezziamo il loro impegno nel far progredire il settore e nel rendere il loro lavoro accessibile alla comunità più ampia.
Domande frequenti#
YOLOv7, rilasciato a luglio 2022, è stato un importante modello per il rilevamento di oggetti in tempo reale, che al momento del rilascio ha raggiunto un'eccellente velocità e precisione. Ha superato modelli contemporanei come YOLOX, YOLOv5 e PPYOLOE sia nell'uso dei parametri sia nella velocità di inferenza. Le caratteristiche distintive di YOLOv7 includono la riparametrizzazione del modello e l'assegnazione dinamica delle etichette, che ne ottimizzano le prestazioni senza aumentare i costi di inferenza. Per ulteriori dettagli tecnici sull'architettura e sulle metriche di confronto con altri rilevatori di oggetti all'avanguardia, consulta l'articolo su YOLOv7.
YOLOv7 introduce diverse innovazioni, tra cui la riparametrizzazione del modello e l'assegnazione dinamica delle etichette, che migliorano il processo di addestramento e la precisione dell'inferenza. Rispetto a YOLOv5, YOLOv7 aumenta notevolmente la velocità e la precisione. Ad esempio, YOLOv7-X migliora la precisione del 2,2% e riduce i parametri del 22% rispetto a YOLOv5-X. Puoi trovare confronti dettagliati nella tabella delle prestazioni Confronto tra YOLOv7 e i rilevatori di oggetti SOTA.
Al momento, Ultralytics supporta solo l'inferenza YOLOv7 ONNX e TensorRT. Per eseguire con Ultralytics la versione di YOLOv7 esportata in ONNX o TensorRT, consulta la sezione Esempi d'uso.
Per installare e addestrare un modello YOLOv7 personalizzato, segui questi passaggi:
-
Clona il repository YOLOv7:
git clone https://github.com/WongKinYiu/yolov7 -
Apri la directory clonata e installa le dipendenze:
cd yolov7 pip install -r requirements.txt -
Prepara il dataset e configura i parametri del modello secondo le istruzioni per l'uso fornite nel repository. Per ulteriori indicazioni, visita il repository YOLOv7 su GitHub per le informazioni e gli aggiornamenti più recenti.
-
Dopo l'addestramento, puoi esportare il modello in ONNX o TensorRT per usarlo in Ultralytics, come mostrato negli Esempi d'uso.
-
YOLOv7 offre diverse funzionalità chiave che rivoluzionano il rilevamento di oggetti in tempo reale:
- Riparametrizzazione del modello: Migliora le prestazioni del modello ottimizzando i percorsi di propagazione del gradiente.
- Assegnazione dinamica delle etichette: Usa un metodo guidato dai livelli grossolani a quelli fini per assegnare obiettivi dinamici agli output dei diversi rami, migliorando la precisione.
- Ridimensionamento esteso e composto: Sfrutta in modo efficiente i parametri e la potenza di calcolo per adattare il modello a diverse applicazioni in tempo reale.
- Efficienza: Riduce del 40% il numero di parametri e del 50% la potenza di calcolo rispetto ad altri modelli all'avanguardia, ottenendo al contempo velocità di inferenza maggiori.
Per ulteriori dettagli su queste funzionalità, consulta la sezione Panoramica di YOLOv7.