Documentazione di riferimento REST API
Ultralytics Platform offre una REST API per accedere in modo programmatico a dataset, immagini, progetti, modelli, addestramento, esportazioni e distribuzioni.
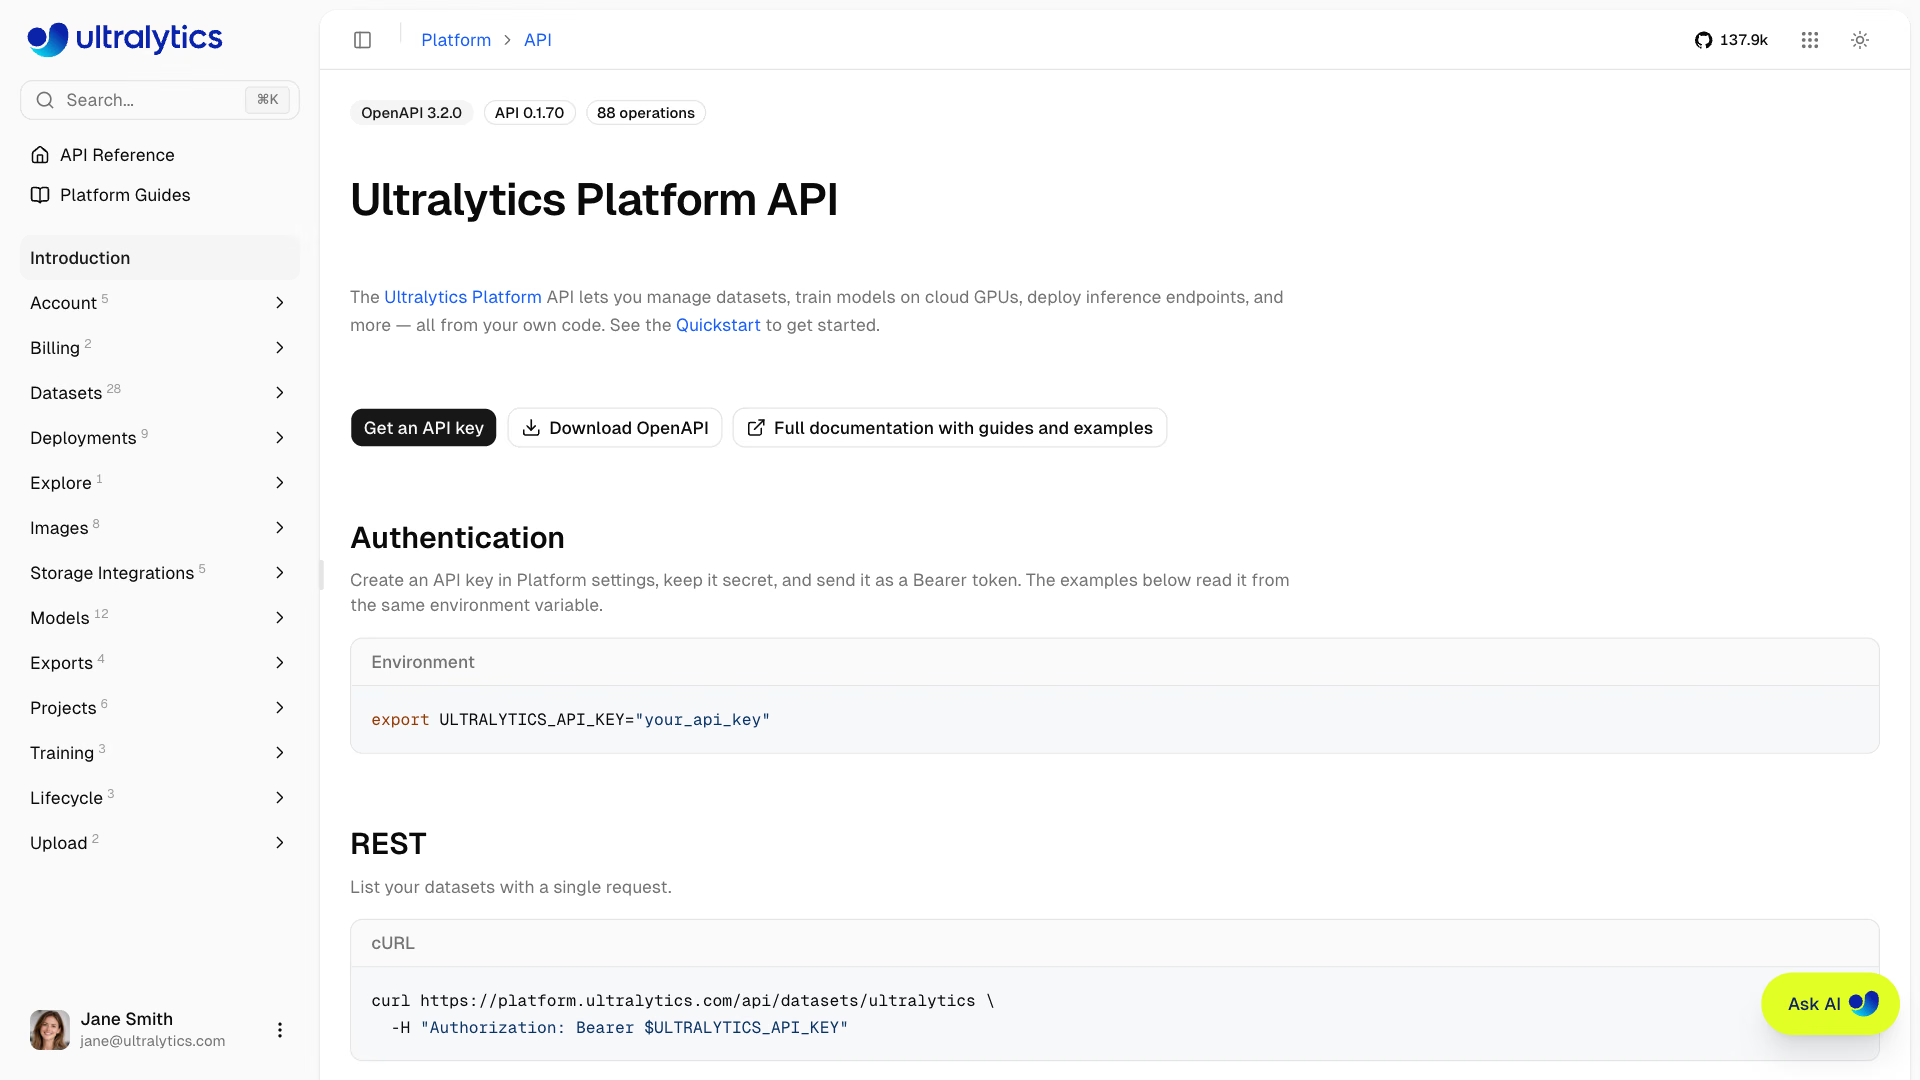
# List the datasets owned by a workspace
curl -H "Authorization: Bearer YOUR_API_KEY" \
  https://platform.ultralytics.com/api/datasets/YOUR_USERNAME
Ogni endpoint riportato di seguito elenca la chiamata client.<resource>.<method>(...) dal SDK ultralytics-platform, generato dallo stesso contratto di questo documento di riferimento.
Questa pagina è una visita guidata dell'API. Il documento di riferimento generato e sempre aggiornato si trova all'indirizzo platform.ultralytics.com/api/docs e il documento OpenAPI 3.2 leggibile dalle macchine che lo alimenta è pubblicato all'indirizzo platform.ultralytics.com/openapi.json. Entrambi vengono generati direttamente dal contratto lato server, quindi sono autorevoli ogni volta che questa pagina e lo schema non concordano.
Panoramica dell'API#
L'API è organizzata attorno alle risorse principali della Platform:
| Risorsa | Descrizione | Operazioni principali |
|---|---|---|
| Dataset | Raccolte di immagini etichettate | CRUD, acquisizione, versioni, classi, suddivisioni, clonazione, copia |
| Immagini | Immagini e annotazioni individuali | Lettura, annotazione, modifica della suddivisione, eliminazione, annotazione automatica, sfocatura dei volti |
| Progetti | Aree di lavoro per i modelli | CRUD, clonazione |
| Modelli | Checkpoint addestrati | CRUD, predizione, download, clonazione, stato dell'addestramento |
| Addestramento | Job di addestramento su GPU cloud | Disponibilità della GPU, avvio, avanzamento, annullamento |
| Esportazioni | Job di conversione del formato | Crea, elenca, stato, annulla, collegamento per dispositivi mobili |
| Distribuzioni | Endpoint di inferenza dedicati | Creazione, aggiornamento, avvio/arresto, predizione, metriche, log |
| Agenti | Flussi di lavoro visivi salvati | Elenco, salvataggio, eliminazione |
| Cestino | Risorse eliminate in modo reversibile | Elenco, ripristino, eliminazione definitiva |
| Archiviazione | Integrazioni con l'archiviazione cloud | Connessione, individuazione, esplorazione, disconnessione |
| Account | Piano, crediti, archiviazione, profilo | Riepilogo account, chiavi API, utilizzo dell'archiviazione, ricerca utenti |
| Fatturazione | Utilizzo del piano e registro | Riepilogo dell'utilizzo, transazioni |
| Esplora | Ricerca di contenuti pubblici | Cerca progetti, dataset, modelli e immagini |
Autenticazione#
La maggior parte degli endpoint richiede una chiave API. Gli endpoint che espongono contenuti pubblici — lettura di un dataset, progetto o modello pubblico, elenco di immagini di dataset pubblici, esecuzione dell'inferenza su un modello pubblico o ricerca in Explore — accettano anche richieste anonime e restituiscono semplicemente più risultati quando viene fornita una chiave.
Ottieni una chiave API#
- Vai a
Settings>API Keys - Fai clic su
Add Key, mantieniUltralyticscome provider, inserisci un nome e fai clic suCreate Key - Copia la chiave generata
Consulta Chiavi API per istruzioni dettagliate.
Intestazione di autorizzazione#
Includi la tua chiave API come token bearer:
Authorization: Bearer YOUR_API_KEYLe chiavi API sono composte dal prefisso letterale ul_ seguito da 40 caratteri esadecimali, per un totale di 43 caratteri (ad esempio ul_a1b2c3d4e5f6789012345678901234567890abcd). Le richieste con un'intestazione mancante, una chiave non valida o una chiave revocata restituiscono 401. Tieni segreta la tua chiave: non inserirla mai nel controllo versione né condividerla pubblicamente.
Esempio#
curl -H "Authorization: Bearer YOUR_API_KEY" \
  https://platform.ultralytics.com/api/account/summary
URL di base#
Tutti gli endpoint API utilizzano:
https://platform.ultralytics.com/apiPercorsi delle risorse#
La maggior parte delle risorse viene identificata usando gli stessi nomi leggibili che compaiono negli URL della Platform, non tramite ID di database:
| Risorsa | Percorso | Esempio |
|---|---|---|
| Dataset | /api/datasets/{owner}/{dataset} | /api/datasets/acme-vision/warehouse |
| Progetto | /api/projects/{owner}/{project} | /api/projects/acme-vision/inspection |
| Modello | /api/models/{owner}/{project}/{model} | /api/models/acme-vision/inspection/v3 |
| Distribuzione | /api/deployments/{owner}/{deployment} | /api/deployments/acme-vision/edge-1 |
| Immagine | /api/images/{imageId} | /api/images/65f1c0a2b3d4e5f601234567 |
| Agente | /api/workflows?id={agentId} | /api/workflows?id=65f1c0a2b3d4e5f601234567 |
{owner}è un nome utente personale o un identificativo di area di lavoro del team: 4-32 caratteri, alfanumerici minuscoli con trattini singoli tra i segmenti.{dataset},{project},{model}e{deployment}seguono lo stesso formato con lettere minuscole e trattini, fino a 128 caratteri.{imageId},{exportId}e{agentId}sono ID esadecimali di 24 caratteri restituiti dall'API.- Rinominando una risorsa tramite
PATCHaggiorni contemporaneamente ilnamevisualizzato e il nome nell'URL; la risposta restituisce il nome corrente nell'URL così puoi continuare a seguirlo.
A parte la API Agents, non esiste alcun parametro di query owner. I percorsi con ambito dell'area di lavoro includono il proprietario nel percorso, mentre gli endpoint con ambito dell'account (/api/account/summary, /api/api-keys, /api/storage, /api/billing/*, /api/trash, /api/integrations/buckets) operano sull'area di lavoro che ha emesso la chiave API. Per operare su un'area di lavoro del team, usa una chiave API creata in quell'area di lavoro oppure passa owner all'API Agents.
Limiti di frequenza#
L'API applica limiti a finestra mobile per ogni chiave API. Ogni route rientra in una categoria, e ciascuna categoria ha un contatore indipendente: quindi 20 richieste di predizione non consumano la quota predefinita.
| Categoria | Limite | Ambito |
|---|---|---|
| Predefinito | 100 richieste/min | Tutte le route non elencate di seguito |
| Addestramento | 10 richieste/min | POST /api/training/start |
| Carica | 10 richieste/min | URL di caricamento firmati, completamento del caricamento e acquisizione di dataset |
| Predizione | 20 richieste/min | Inferenza di modelli e distribuzioni tramite route API della Platform |
| Esporta | 20 richieste/min | Elenco e creazione di esportazioni di modelli, creazione o aggiornamento di versioni di dataset; la lettura di un'esportazione di dataset (GET) e di una singola esportazione di modello usa il limite predefinito |
| Download | 30 richieste/min | Download di file di modelli |
| Modifica | 10 richieste/min | Elenco di chiavi API, elenco o connessione di integrazioni di archiviazione cloud, individuazione di posizioni di archiviazione e aggiornamenti delle distribuzioni (PATCH) |
| Idratazione | 20 richieste/min | POST /api/datasets/{owner}/{dataset}/images (recupero di un insieme selezionato di immagini) e GET /api/images/{imageId}/similar |
| Raggruppamento | 10 richieste/min | GET /api/datasets/{owner}/{dataset}/images/clustering e GET /api/models/{owner}/{project}/{model}/similar-images |
Le route della Platform accessibili solo dal browser, come il checkout dei pagamenti e la gestione dei team, hanno limiti specifici che non si applicano al traffico con chiave API.
Quando viene applicato un limite, l'API restituisce 429 sia negli header sia nel corpo JSON:
Retry-After: 12
X-RateLimit-Reset: 2026-02-21T12:34:56.000Z
{
"error": "Rate limit exceeded, wait 12s",
"retryAfter": 12,
"resetAt": "2026-02-21T12:34:56.000Z"
}Endpoint dedicati (illimitati)#
Gli endpoint dedicati non sono soggetti ai limiti di frequenza delle chiavi API della Platform quando chiami direttamente serviceUrl del deployment (ad esempio, https://predict-abc123.run.app/predict). Il throughput dipende quindi dalla configurazione del servizio distribuito.
Quando ricevi un 429, attendi Retry-After secondi (o fino a X-RateLimit-Reset) prima di riprovare. Consulta le FAQ sui limiti di frequenza per un'implementazione del backoff esponenziale.
Formato della risposta#
Risposte positive#
Le risposte sono oggetti JSON con campi specifici per la risorsa. Non esiste un involucro generico: gli endpoint di elenco restituiscono una raccolta con un nome, spesso insieme ai conteggi, mentre le operazioni di modifica restituiscono gli identificatori modificati.
{
    "datasets": [{ "id": "65f1c0a2b3d4e5f601234567", "owner": "acme-vision", "dataset": "warehouse" }],
    "total": 1,
    "region": "us"
}
Anche gli elenchi di risorse, le risposte di creazione e clonazione e alcune letture, come deployment, archiviazione e cestino, includono region (us, eu o ap), la regione di archiviazione per quell'area di lavoro.
Risposte di errore#
Ogni risposta di errore è un oggetto JSON con un messaggio error:
{
    "error": "Dataset not found"
}| Stato HTTP | Significato |
|---|---|
200 | Operazione riuscita |
201 | Data di creazione |
202 | Accettata, l'elaborazione continua in modo asincrono |
400 | Percorso, query o corpo della richiesta non valido |
401 | Autenticazione mancante o non valida |
402 | Crediti insufficienti (addestramento) |
403 | Autorizzazioni, piano o quota insufficienti |
404 | Risorsa non trovata |
409 | Conflitto con lo stato corrente (nome duplicato, processo in corso) |
413 | Input di previsione troppo grande |
422 | Le classi del modello non corrispondono al dataset oppure manca una chiave del provider, o questa è stata rifiutata (annotazione automatica) |
429 | Limite di frequenza superato |
500 | Errore del server |
502 | Chiamata al provider o al servizio upstream non riuscita |
503 | Servizio dipendente temporaneamente non disponibile |
Paginazione#
Lo stile di paginazione dipende dalla raccolta:
| Stile | Endpoint | Parametri |
|---|---|---|
| Solo limite | Elenchi di dataset, progetti, modelli, esportazioni e deployment | limit |
| Offset e limite | Immagini dei dataset, clustering delle immagini, ricerca in Explore | offset, limit, più hasMore nella risposta |
| Cursore | Immagini dei dataset (dataset di grandi dimensioni) | cursor, includeTotal, più nextCursor |
| Numero di pagina | Cestino | page, limit, più totalPages |
| Token di pagina opaco | Log del deployment | pageToken, più nextPageToken |
API dei dataset#
Crea, esplora e gestisci dataset di immagini etichettate per addestrare modelli YOLO. Consulta la documentazione sui dataset.
Elenca i dataset#
GET /api/datasets/{owner}Python SDK: client.datasets.list(owner)
Restituisce i dataset pubblici del proprietario e i dataset privati quando la tua chiave può accedere a quell'area di lavoro.
Parametri di query:
| Parametro | Tipo | Descrizione |
|---|---|---|
limit | int | Numero massimo di dataset da restituire (predefinito: 1000, massimo: 1000) |
includeSamples | booleano | Includi anteprime delle immagini di esempio (predefinito: true) |
includeImageUrls | booleano | Includi URL di ripiego per immagini di esempio a dimensione intera (predefinito: false) |
curl -H "Authorization: Bearer YOUR_API_KEY" \
  "https://platform.ultralytics.com/api/datasets/acme-vision?limit=10&includeSamples=false"
Risposta:
{
    "datasets": [
        {
            "id": "65f1c0a2b3d4e5f601234567",
            "owner": "acme-vision",
            "dataset": "warehouse",
            "name": "Warehouse",
            "task": "detect",
            "visibility": "private",
            "imageCount": 1000,
            "classCount": 2,
            "classNames": ["person", "forklift"],
            "splits": { "train": 800, "val": 200, "test": 0, "labeled": 1000 },
            "annotationCount": 5400,
            "starCount": 3,
            "isStarred": false,
            "status": "ready",
            "createdAt": "2026-01-15T10:00:00Z",
            "updatedAt": "2026-01-16T08:30:00Z"
        }
    ],
    "total": 1,
    "region": "us"
}
Ottieni dataset#
GET /api/datasets/{owner}/{dataset}Python SDK: client.datasets.retrieve(owner, dataset)
Restituisce l'intero oggetto dataset sotto una chiave dataset, inclusi classNames, splits, versions, source e l'oggetto metadata definito dall'utente. Durante l'elaborazione dell'importazione di almeno 10.000 immagini, anche gli editor ricevono processingProgress con stage, percent e, se noti, processed, total e objects (oggetti cloud analizzati).
Crea dataset#
POST /api/datasetsPython SDK: client.datasets.create(dataset=..., name=...)
Corpo:
{
    "dataset": "warehouse",
    "name": "Warehouse",
    "task": "detect",
    "description": "Forklift and pedestrian safety dataset",
    "classNames": ["person", "forklift"],
    "visibility": "private",
    "metadata": { "location": "factory-1", "reviewed": true },
    "owner": "acme-vision"
}| Campo | Tipo | Obbligatorio | Descrizione |
|---|---|---|---|
dataset | stringa | Sì | Nome del dataset utilizzato negli URL della Platform (minuscolo, con trattini, massimo 128 caratteri) |
name | stringa | Sì | Nome visualizzato (massimo 100 caratteri) |
description | stringa | No | Descrizione (massimo 1000 caratteri) |
task | stringa | No | Tipo di attività (predefinito: detect) |
classNames | array | No | Nomi delle classi nell'ordine dell'indice (massimo 25.000); nessun duplicato, senza distinzione tra maiuscole e minuscole oltre i 2 caratteri |
format | stringa | No | Formato delle annotazioni: yolo (predefinito), coco, raw, ndjson |
visibility | stringa | No | public o private (predefinito: la visibilità predefinita dell'area di lavoro) |
blurFaces | booleano | No | Sfoca i volti nelle immagini caricate nel dataset (vedi Sfocatura dei volti) |
tags | array | No | Fino a 50 tag di 50 caratteri ciascuno |
license | stringa | No | Identificatore della licenza del dataset |
metadata | oggetto | No | Metadati JSON personalizzati |
owner | stringa | No | Identificativo dell'area di lavoro del team; per impostazione predefinita viene usata la tua area di lavoro personale |
Uno slug dataset già esistente nell'area di lavoro, anche se si trova nel cestino, restituisce 409.
Valori task validi durante la creazione o l'aggiornamento di un dataset: detect, segment, semantic, depth, classify, pose e obb. I dataset di profondità non hanno classi.
Risposta (201):
{
    "id": "65f1c0a2b3d4e5f601234567",
    "owner": "acme-vision",
    "dataset": "warehouse",
    "region": "us"
}
Aggiorna dataset#
PATCH /api/datasets/{owner}/{dataset}Python SDK: client.datasets.update(owner, dataset)
Corpo (aggiornamento parziale):
{
    "name": "Warehouse Safety",
    "description": "New description",
    "visibility": "public",
    "metadata": { "location": "factory-2", "reviewed": true }
}
Campi accettati: name, description, visibility, metadata, tags, classNames, classColors, format, task, license, iconColor, iconLetter, starred, blurFaces, kptSkeletonId (assegna un modello di scheletro di posa a un dataset di pose) e initializeClassNames (l'aggiornamento restituisce 409, a meno che il dataset non abbia ancora classi o annotazioni). Invia un oggetto metadata vuoto ({}) per cancellare i metadati personalizzati. Le chiavi dei metadati possono contenere al massimo 128 caratteri e l'oggetto serializzato al massimo 500.000 caratteri.
Risposta:
{
    "success": true,
    "dataset": "warehouse-safety"
}
La ridenominazione modifica il nome nell'URL, quindi usa il valore dataset restituito per le richieste successive.
Eliminare un dataset#
DELETE /api/datasets/{owner}/{dataset}Python SDK: client.datasets.delete(owner, dataset)
Sposta il dataset nel cestino, dove può essere recuperato per 30 giorni.
Clonare un dataset#
POST /api/datasets/{owner}/{dataset}/clonePython SDK: client.datasets.clone(owner, dataset)
Copia un dataset accessibile, incluse le immagini e le etichette, nel tuo spazio di lavoro personale o in uno spazio di lavoro del team. Le opzioni facoltative splits (train, val, test) o imageIds (fino a 1.000) clonano solo una parte del dataset; version clona una versione salvata anziché le immagini attuali; annotations: false copia le immagini senza etichette; into aggiunge le immagini senza etichette a un dataset che possiedi, invece di crearne uno nuovo. version non può essere combinato con splits, imageIds, into o annotations: false.
Corpo facoltativo (tutti i campi sono facoltativi):
{
    "dataset": "warehouse-copy",
    "name": "Warehouse Copy",
    "description": "Cloned for experimentation",
    "visibility": "private",
    "license": "CC-BY-4.0",
    "owner": "acme-vision"
}
Risposta (201): id, owner, dataset, name, imageCount, classCount e region. I dataset basati su una fonte di archiviazione collegata, oppure un dataset into in elaborazione o connesso, restituiscono 409. Senza visibility, la clonazione è privata se la visibilità predefinita dello spazio di lavoro di destinazione è Privata; altrimenti mantiene la visibilità dell'origine.
Scarica un'esportazione del dataset#
GET /api/datasets/{owner}/{dataset}/exportPython SDK: client.datasets.export(owner, dataset)
Restituisce un URL firmato per il download in formato NDJSON. Ometti v per esportare lo stato corrente del dataset, riutilizzando l'esportazione memorizzata nella cache se non è cambiato nulla dalla sua generazione.
Parametri di query:
| Parametro | Tipo | Descrizione |
|---|---|---|
v | intero | Numero della versione salvata (indice a partire da 1). Omettilo per il dataset corrente. |
Risposta:
{
    "downloadUrl": "https://storage.googleapis.com/...&signature=...",
    "cached": true
}
Se richiedi una versione specifica, vengono restituiti downloadUrl e version invece di cached.
Crea versione del dataset#
POST /api/datasets/{owner}/{dataset}/exportPython SDK: client.datasets.create_export(owner, dataset)
Crea una versione numerata e immutabile del dataset. Richiede l'accesso come editor. Imposta download su false per salvare la versione senza preparare un download NDJSON; in tal caso, downloadUrl viene omesso. L'SDK accetta download da ultralytics-platform>=0.1.73.
Corpo (facoltativo):
{
    "description": "Added 500 training images",
    "download": true
}
Risposta:
{
    "version": 3,
    "downloadUrl": "https://storage.googleapis.com/...&signature=...",
    "reused": false
}
reused è true quando il dataset corrisponde a una versione esistente, ad esempio subito dopo il ripristino; viene restituita quella versione e, se ne invii una, la relativa descrizione viene aggiornata.
Aggiorna la descrizione della versione#
PATCH /api/datasets/{owner}/{dataset}/exportPython SDK: client.datasets.update_export(owner, dataset, version=..., description=...)
Corpo:
{
    "version": 2,
    "description": "Fixed mislabeled classes"
}
Risposta: {"ok": true}
Ripristina versione del dataset#
POST /api/datasets/{owner}/{dataset}/restorePython SDK: client.datasets.restore(owner, dataset, version=...)
Ricrea immagini, annotazioni e classi da una versione salvata senza copiare i dati delle immagini.
Corpo:
{
    "version": 2
}
Risposta: {"version": 2, "imageCount": 1000}
Confronta versioni del dataset#
GET /api/datasets/{owner}/{dataset}/versions/compare?base={from}&head={to}SDK Python: client.datasets.compare(owner, dataset, base=1, head=2) (ultralytics-platform>=0.1.73)
| Parametro | Tipo | Descrizione |
|---|---|---|
base | int | Versione di partenza del confronto |
head | int | Versione di arrivo del confronto |
cursor | stringa | nextCursor della pagina precedente |
hash | stringa | hash di un elemento: restituisci quell'immagine così come è archiviata in ciascuna versione, non le modifiche |
Risposta (ridotta):
{
    "summary": { "added": 0, "removed": 1, "modified": 1, "moved": 1, "labelsAdded": 1, "labelsRemoved": 2 },
    "items": [
        {
            "hash": "b5c605c133f84c3024af7e652b135501",
            "name": "000000000042",
            "change": "moved",
            "base": { "split": "val", "labelCount": 1 },
            "head": { "split": "test", "labelCount": 1 }
        }
    ]
}
summary compare solo nella prima pagina e contiene i totali esatti, oltre a un header che elenca le classi aggiunte, rimosse o rinominate e gli altri campi del dataset che presentano differenze. change di ciascun elemento è added, removed, modified (con il fields modificato) oppure moved (split modificato), mentre labelsRemoved include le etichette delle immagini rimosse. Se presente, passa nextCursor come cursor per la pagina successiva. Con hash, la risposta è versions: l'immagine così come è archiviata in ciascuna versione, con le relative etichette e un imageUrl firmato. È possibile usare entrambi gli ordini; invertendo base e head, un'immagine rimossa viene segnalata come aggiunta. I confronti usano il limite di frequenza predefinito e le richieste senza hash sono inoltre limitate a 10 al minuto per utente e dataset, indipendentemente dalla chiave API utilizzata.
Ottieni statistiche del dataset#
GET /api/datasets/{owner}/{dataset}/class-statsPython SDK: client.datasets.class_stats(owner, dataset)
Restituisce i conteggi delle annotazioni per classe, gli istogrammi di immagini e annotazioni e le mappe di calore. I dataset di grandi dimensioni vengono campionati; in questo caso, sampleSize indica quante immagini hanno contribuito.
Risposta (abbreviata):
{
    "classes": [{ "classId": 0, "count": 1500, "imageCount": 450 }],
    "imageStats": {
        "widthHistogram": [{ "bin": 640, "count": 120, "size": 1 }],
        "heightHistogram": [{ "bin": 480, "count": 95, "size": 1 }],
        "pointsHistogram": [{ "bin": 4, "count": 200, "size": 1 }],
        "formatDistribution": { "jpg": 900, "png": 100 },
        "fileSizeHistogram": [{ "bin": 250000, "count": 300, "size": 50000 }],
        "objectsPerImageHistogram": [{ "bin": 5, "count": 210, "size": 1 }],
        "bboxWidthHistogram": [{ "bin": 120, "count": 340, "size": 20 }],
        "bboxHeightHistogram": [{ "bin": 90, "count": 300, "size": 20 }]
    },
    "locationHeatmap": {
        "bins": [
            [5, 10],
            [8, 3]
        ],
        "maxCount": 50
    },
    "dimensionHeatmap": {
        "bins": [
            [2, 5],
            [3, 1]
        ],
        "maxCount": 12,
        "minWidth": 10,
        "maxWidth": 1920,
        "minHeight": 10,
        "maxHeight": 1080
    },
    "classNames": ["person", "forklift"],
    "cached": true,
    "sampleSize": null
}
Gestisci le classi#
Unisci le classi (riassegna le annotazioni a una classe di destinazione, quindi rimuovi quelle di origine):
POST /api/datasets/{owner}/{dataset}/classes/mergePython SDK: client.datasets.merge_classes(owner, dataset, source_class_ids=..., target_class_id=...)
{
    "sourceClassIds": [2, 4],
    "targetClassId": 1
}
Elimina le classi (le relative annotazioni vengono eliminate e gli ID delle classi rimanenti diminuiscono):
POST /api/datasets/{owner}/{dataset}/classes/deletePython SDK: client.datasets.delete_classes(owner, dataset, class_ids=...)
{
    "classIds": [2, 4]
}
Entrambe le operazioni restituiscono success, i valori aggiornati classNames e classColors e un riepilogo delle modifiche apportate (mergedClassIds e targetClassId, oppure deletedClassIds e deletedAnnotations).
Poiché gli ID rimanenti cambiano dopo un'unione o un'eliminazione, queste operazioni non sono idempotenti. Recupera di nuovo il dataset per ottenere gli indici delle classi correnti prima di eseguire un'altra operazione sulle classi.
Rid ridistribuisci le suddivisioni#
POST /api/datasets/{owner}/{dataset}/splits/redistributePython SDK: client.datasets.redistribute_splits(owner, dataset, train=..., val=..., test=...)
Riassegna casualmente le immagini alle suddivisioni. Le tre percentuali devono totalizzare 100.
{
    "train": 80,
    "val": 20,
    "test": 0
}
Risposta: success, i conteggi risultanti di splits e modified (numero di immagini spostate).
Embedding del dataset#
GET /api/datasets/{owner}/{dataset}/embeddings
POST /api/datasets/{owner}/{dataset}/embeddings
DELETE /api/datasets/{owner}/{dataset}/embeddings
SDK Python: client.datasets.embeddings(owner, dataset), client.datasets.create_embeddings(owner, dataset), client.datasets.delete_embeddings(owner, dataset)
GET restituisce il riepilogo dell'analisi (analyzedAt, embeddingsCount, latestImageAt, activeJob). POST mette in coda un'analisi di embedding e restituisce 202 con un jobId, oppure 409 se le funzionalità di IA dello spazio di archiviazione del dataset sono disattivate o se si tratta di un'installazione locale. DELETE annulla il processo attivo e restituisce l'ID del processo annullato oppure null.
Raggruppamento delle immagini#
GET /api/datasets/{owner}/{dataset}/images/clusteringPython SDK: client.datasets.clustering(owner, dataset)
Restituisce la proiezione UMAP 2D di un'analisi completata, suddivisa in pagine con offset e limit (valore predefinito e massimo 50.000). Ogni voce contiene id, umapX, umapY, cluster, split, classIds, width, height, bytes, labelCount, labeled e missing. cluster indica l'isola visiva del punto, classificata per dimensione (0 = più grande, -1 = dispersa), oppure null per le proiezioni analizzate prima dell'introduzione del raggruppamento.
Elenca i modelli addestrati su un dataset#
GET /api/datasets/{owner}/{dataset}/modelsPython SDK: client.datasets.models(owner, dataset)
Risposta:
{
    "models": [
        {
            "id": "65f1c0a2b3d4e5f601234599",
            "owner": "acme-vision",
            "project": "inspection",
            "model": "v3",
            "name": "v3",
            "status": "completed",
            "task": "detect",
            "epochs": 100,
            "bestEpoch": 87,
            "metrics": { "mAP50": 0.85, "mAP50-95": 0.72, "precision": 0.88, "recall": 0.81 },
            "startedAt": "2026-01-14T22:00:00Z",
            "completedAt": "2026-01-15T10:00:00Z",
            "createdAt": "2026-01-14T21:55:00Z"
        }
    ],
    "count": 1
}
Elenca le immagini del dataset#
GET /api/datasets/{owner}/{dataset}/imagesPython SDK: client.datasets.images(owner, dataset)
Parametri di query:
| Parametro | Tipo | Descrizione |
|---|---|---|
limit | int | Numero massimo di immagini da restituire (predefinito: 50, massimo: 5000) |
offset | int | Numero di immagini da saltare (predefinito: 0) |
cursor | stringa | ID dell'ultima immagine della pagina precedente, per la paginazione con cursore |
includeTotal | booleano | Includi il conteggio totale delle corrispondenze (predefinito: true) |
split | stringa | Filtra per suddivisione: train, val, test |
hasLabel | booleano | Filtra in base allo stato delle annotazioni |
hasError | booleano | Filtra in base allo stato degli errori di elaborazione |
classIds | stringa | ID delle classi separati da virgole; restituisce le immagini che ne contengono almeno uno |
search | stringa | Corrispondenza parziale nel nome file, nel nome della classe e nei metadati personalizzati (massimo 200 caratteri); un termine che termina con un'estensione di file immagine, ad esempio img_0042.jpg, cerca solo nei nomi dei file |
q | stringa | Ordina per pertinenza invece che per sort: corrispondenze testuali, poi fino a 1.000 elementi simili; un ID, un hash o un nome file funge da search (massimo 200 caratteri) |
sort | stringa | newest (predefinito), oldest, name-asc, name-desc, height-asc, height-desc, width-asc, width-desc, size-asc, size-desc, labels-asc, labels-desc |
includeThumbnails | booleano | Includi gli URL firmati delle miniature (predefinito: true) |
includeImageUrls | booleano | Includi gli URL firmati delle immagini a dimensione intera (predefinito: false) |
includeLabels | booleano | Includi le annotazioni di anteprima con limite massimo (predefinito: false) |
Risposta:
{
    "images": [
        {
            "id": "65f1c0a2b3d4e5f601234567",
            "hash": "9f2c1d4b6a8e0f3c5d7b9a1e2f4c6d8b",
            "ext": "jpg",
            "name": "aisle-04",
            "thumbnailUrl": "https://storage.googleapis.com/...&signature=...",
            "width": 1920,
            "height": 1080,
            "split": "train",
            "labelCount": 6,
            "bytes": 284213,
            "error": null
        }
    ],
    "total": 1000,
    "hasMore": true,
    "classes": ["person", "forklift"],
    "errorCount": 0,
    "nextCursor": "65f1c0a2b3d4e5f601234567"
}
Ottieni le immagini selezionate#
POST /api/datasets/{owner}/{dataset}/imagesPython SDK: client.datasets.selected_images(owner, dataset, image_ids=...)
Restituisce la stessa struttura dei dati dell'immagine per un massimo di 1.000 ID immagine forniti e accetta gli stessi parametri di filtro e query URL dell'operazione di elenco.
{
    "imageIds": ["65f1c0a2b3d4e5f601234567", "65f1c0a2b3d4e5f601234568"]
}
Copia o sposta immagini#
POST /api/datasets/{owner}/{dataset}/images/adoptSDK Python: client.datasets.adopt_images(owner, dataset, image_ids=..., release=...) (ultralytics-platform>=0.1.50)
Copia fino a 1.000 immagini da altri dataset in questo dataset, come fa la funzione dell'app copia e incolla, e restituisce il numero adopted.
{
    "imageIds": ["65f1c0a2b3d4e5f601234567"],
    "release": false,
    "classMapping": { "person": 0, "vase": null }
}
Impostando release o classMapping si mantengono le etichette e le suddivisioni dei dataset che puoi modificare: release: false copia le immagini e release: true le sposta fuori dal dataset di origine. Se ometti entrambi i campi, vengono importate immagini train senza etichette, come avviene copiando da una sorgente di sola lettura; lo spostamento da una sorgente di sola lettura restituisce 403. Le immagini esistenti vengono ignorate; se si mantengono etichette e suddivisioni, i duplicati vengono verificati all'interno della suddivisione di destinazione. Le classi vengono abbinate per nome, senza distinzione tra maiuscole e minuscole per i nomi di più di due caratteri; 422 restituisce le classi di origine che non trovano corrispondenza in unmatchedClasses, mentre classMapping associa ognuna a un indice di classe, a un nuovo nome di classe oppure a null per eliminarne le etichette. 409 indica che la destinazione è un dataset collegato o che una sorgente o destinazione è occupata. Se si mantengono etichette e suddivisioni, attività, canali immagine, impostazioni della posa o scale di profondità incompatibili restituiscono anch'essi 409, anche per immagini senza etichette.
Acquisisci i dati del dataset#
POST /api/datasets/{owner}/{dataset}/ingestPython SDK: client.datasets.ingest(owner, dataset, body=...)
Elabora un caricamento completato, un archivio remoto o una sorgente di archiviazione connessa in un dataset esistente. Specifica esattamente una sorgente:
| Campo | Tipo | Descrizione |
|---|---|---|
sessionId | stringa | Sessione di caricamento da POST /api/upload/signed-url; l'acquisizione verifica e completa il caricamento se non è stato chiamato POST /api/upload/complete |
sourceUrl | stringa | URL HTTP o HTTPS pubblico di un file ZIP, TAR, TAR.GZ, TGZ o NDJSON (massimo 4096 caratteri) |
reference | oggetto | Una sorgente connessa: archiviazione cloud (provider: "cloud", integrationId, target, prefix) oppure On Premise (provider: "local", keyId, root, prefix) |
targetSplit | stringa | train, val o test; sostituisce la struttura delle suddivisioni dell'archivio |
conflictPolicy | stringa | skip, keep_both o replace per i conflitti relativi al nome file o al contenuto |
classMapping | oggetto | Associa i nomi delle classi in ingresso a un indice di classe, al nome di una classe esistente o nuova oppure a null per ignorarli |
imageMetadata | oggetto | Metadati personalizzati associati al percorso relativo di ciascuna immagine nell'archivio o al valore file di NDJSON |
Le sessioni di caricamento sono associate a un dataset tramite assetId passato a POST /api/upload/signed-url; l'acquisizione rifiuta una sessione appartenente a un dataset diverso.
Corpo (archivio caricato):
{
    "sessionId": "session_abc123",
    "targetSplit": "train"
}
Corpo (archivio remoto o NDJSON):
{
    "sourceUrl": "https://example.com/my-dataset.zip"
}
Corpo (importazione di etichette in un'acquisizione successiva):
{
    "sessionId": "session_abc123",
    "classMapping": { "person": 0, "automobile": "forklift", "background": null }
}
Corpo (associazione di metadati per immagine):
{
    "sessionId": "session_abc123",
    "imageMetadata": {
        "airbus-wing.jpg": { "aircraft": { "family": "A350" }, "inspectionStatus": "reviewed" },
        "images/tail.jpg": { "aircraft": { "family": "A320" }, "inspectionSeverity": 2 }
    }
}
Le chiavi dei metadati devono corrispondere al percorso normalizzato all'interno dell'archivio, incluse le cartelle. Per le importazioni NDJSON, ogni record può includere un proprio oggetto metadata, che ha la precedenza su una voce imageMetadata corrispondente. I percorsi dell'archivio sono limitati a 1.024 caratteri, le chiavi dei metadati di primo livello a 128 caratteri e ciascun oggetto di metadati, così come l'intera mappa imageMetadata, a 500.000 caratteri serializzati.
La prima importazione crea automaticamente le classi dall'archivio. Nelle importazioni successive, le classi dell'archivio non specificate in classMapping vengono abbinate per nome alle classi esistenti del dataset, senza distinzione tra maiuscole e minuscole per i nomi di più di due caratteri; le classi senza corrispondenza vengono aggiunte come nuove classi. Le etichette vengono ignorate solo per le classi associate esplicitamente a null.
Risposta (201):
{
    "jobId": "65f1c0a2b3d4e5f6012345aa",
    "status": "queued"
}
Carica un'immagine con metadati usando Python
Lo stesso codice gestisce un gruppo di immagini: aggiungi altri file allo ZIP e le relative voci a imageMetadata.
import io
import zipfile
from pathlib import Path

import requests

api = "https://platform.ultralytics.com/api"
headers = {"Authorization": "Bearer YOUR_API_KEY"}
owner, dataset = "acme-vision", "warehouse"
dataset_id = "65f1c0a2b3d4e5f601234567"  # id returned by POST /api/datasets
image_path = Path("airbus-wing.jpg")

archive = io.BytesIO()
with zipfile.ZipFile(archive, "w", zipfile.ZIP_DEFLATED) as zf:
    zf.write(image_path, image_path.name)
data = archive.getvalue()

signed = requests.post(
    f"{api}/upload/signed-url",
    headers=headers,
    json={
        "assetType": "datasets",
        "assetId": dataset_id,
        "filename": "images.zip",
        "contentType": "application/zip",
        "totalBytes": len(data),
    },
)
signed.raise_for_status()
upload = signed.json()

headers_put = {"Content-Type": "application/zip", **upload.get("headers", {})}
requests.put(upload["uploadUrl"], headers=headers_put, data=data).raise_for_status()
requests.post(
    f"{api}/upload/complete",
    headers=headers,
    json={"sessionId": upload["sessionId"]},
).raise_for_status()

ingest = requests.post(
    f"{api}/datasets/{owner}/{dataset}/ingest",
    headers=headers,
    json={
        "sessionId": upload["sessionId"],
        "imageMetadata": {
            "airbus-wing.jpg": {
                "aircraft": {"family": "A350", "section": "wing"},
                "inspectionStatus": "reviewed",
            }
        },
    },
)
ingest.raise_for_status()
print(ingest.json())
API delle immagini#
Esamina, annota, sposta ed elimina le immagini del dataset usando il relativo ID immagine di 24 caratteri. Consulta la documentazione sulle annotazioni.
Ottieni immagine#
GET /api/images/{imageId}Python SDK: client.images.retrieve(image_id)
Restituisce l'oggetto metadata (personalizzato, definito dall'utente), properties (nome file, hash, dimensioni, suddivisione, conteggi, timestamp), labels e classNames del dataset.
Aggiorna immagine#
PATCH /api/images/{imageId}Python SDK: client.images.update(image_id, body=...)
Sostituisce le annotazioni oppure i metadati personalizzati: invia una sola delle due strutture, non entrambe.
Corpo (annotazioni):
{
    "labels": [
        { "classId": 0, "bbox": [0.5, 0.5, 0.2, 0.3] },
        { "classId": 1, "segments": [0.1, 0.2, 0.3, 0.2, 0.2, 0.4] }
    ]
}
Corpo (metadati):
{
    "metadata": { "location": "strasbourg", "reviewed": true }
}Le coordinate delle etichette usano i valori normalizzati YOLO compresi tra 0 e 1. Le bounding box usano [x_center, y_center, width, height]. Le etichette di segmentazione usano segments, un elenco appiattito di vertici dei poligoni [x1, y1, x2, y2, ...]. Le etichette delle pose usano keypoints in un'unica struttura piatta coerente: coppie [x1, y1, x2, y2, ...] o terne [x1, y1, v1, x2, y2, v2, ...], dove la visibilità è convenzionalmente 0, 1 o 2. Le bounding box orientate usano i vertici obb. Le coordinate salvate vengono arrotondate a 5 cifre decimali e ogni immagine può contenere al massimo 10.000 annotazioni.
Elimina immagine#
DELETE /api/images/{imageId}Python SDK: client.images.delete(image_id)
Elimina definitivamente un'immagine e le relative annotazioni.
Annota automaticamente un'immagine#
POST /api/images/{imageId}/predictPython SDK: client.images.predict(image_id, model_id=...)
Esegue il modello sull'immagine e restituisce le annotazioni previste. Non le salva: quando il risultato ti soddisfa, scrivilo di nuovo con PATCH /api/images/{imageId}.
| Campo | Tipo | Obbligatorio | Descrizione |
|---|---|---|---|
modelId | stringa | Sì | URI del modello completo, ul://{owner}/{project}/{model} oppure un ID di modello basato su prompt di classe per un dataset di rilevamento con 1–200 classi (yoloe26x con visualPrompts supporta anche dataset di segmentazione e OBB): un modello ospitato (qwen, gemma, nemotron, moondream, wevisone, florence2, owlv2, yoloe26x, sam3, sam3.1, groundingdino) oppure un ID di modello di un provider a pagamento dall'enum modelId in openapi.json |
confidence | float | No | Soglia di confidenza, 0.01–1.0 (predefinita: 0.25); ignorata dai modelli con prompt di classe senza visualPrompts, che usano soglie specifiche del modello |
iou | float | No | Soglia IoU per la soppressione dei non massimi, da 0.0 a 0.95 (predefinita: 0.5); ignorata dai modelli con prompt di classe senza visualPrompts |
visualPrompts | array | No | Con modelId yoloe26x su un dataset di rilevamento, segmentazione o OBB, da 1 a 200 oggetti di annotazione (classId più bbox, segments o obb) provenienti da questa immagine, oppure dall'immagine referenceImageId, le cui classi il modello ritrova nell'immagine |
referenceImageId | stringa | No | Con visualPrompts, l'ID dell'immagine dello stesso dataset su cui sono disegnati i prompt, quando non è l'immagine su cui viene eseguita la predizione |
classMapping | array | No | Per un modello YOLO, l'indice della classe del dataset per ciascuna classe del modello, nell'ordine, oppure null per escludere quella classe; una lunghezza errata o un indice non compreso tra le classi del dataset restituisce 400. Ignorato dai modelli con prompt di classe e non consentito con visualPrompts |
Risposta: success, predictions (oggetti di annotazione), confidences (punteggi allineati per indice, vuoto per i modelli con prompt di classe senza visualPrompts), modelUsed, inferenceTime, usage ([input tokens, output tokens], quando un modello linguistico li segnala), per i modelli con prompt di classe partial (true quando un limite di output o di tempo ha interrotto la risposta, o si sospetta che sia successo, quindi le annotazioni restituite potrebbero omettere oggetti) e, per i modelli di provider a pagamento, un campo facoltativo cost (il costo stimato del provider in USD addebitato alla tua chiave del provider, omesso se non è disponibile una stima). Un modello YOLO le cui classi non corrispondono al dataset restituisce 422, così come un modello con prompt di classe usato su un dataset diverso da quello di rilevamento o con un numero di classi fuori dall'intervallo 1–200 (a meno che non usi visualPrompts), visualPrompts con un altro modello o un'altra attività, un classId sconosciuto, un prompt troppo piccolo o esterno all'immagine oppure classMapping; anche un modello di provider a pagamento senza una chiave del provider salvata in Impostazioni > Chiavi API dello spazio di lavoro del dataset restituisce code: missing_provider_api_key. Un referenceImageId che non è un'immagine di questo dataset restituisce 404. Un errore del provider include il messaggio del provider: 422 quando il provider risponde con 400, 401, 402, 403 o 404 (una chiave, un modello o una richiesta rifiutati, oppure un saldo del provider non pagato; code: provider_refused per tutti tranne 400), 429 per il limite di frequenza e 503 per qualsiasi altro errore del provider. I dataset di profondità restituiscono 400. I dataset On Premise, i dataset di archiviazione cloud con le funzionalità AI disattivate o le cui credenziali sono disconnesse, e i dataset con più di 3 canali immagine restituiscono 409.
Trova immagini simili#
GET /api/images/{imageId}/similarPython SDK: client.images.find_similar_images(image_id)
Restituisce fino a 24 images visivamente simili dai dataset pubblici e dai tuoi dataset e da quelli del tuo team, ciascuno con score (0-1), un thumbnailUrl con segno e il dataset di origine (owner, dataset, license). Il dataset di origine e i dataset che contengono una copia dell'immagine di ricerca vengono esclusi; includeSourceDataset=true li include ed esclude solo le copie. license (identificatori separati da virgole da Licenze disponibili, con None per i dataset senza licenza) e publicOnly=true (solo dataset pubblici) restringono la ricerca, che continua a restituire fino a 24 immagini. È necessaria una chiave API con accesso in visualizzazione all'immagine; un'immagine a cui non è ancora stato assegnato un embedding viene prima sottoposta a embedding e 503 indica che la preparazione non è riuscita, quindi riprova. Il dataset di un'immagine su cloud storage è incluso solo per il relativo workspace e 409 indica che le funzionalità AI dello spazio di archiviazione dell'immagine sono disattivate o che il dataset è On Premise.
Annota automaticamente un dataset#
POST /api/datasets/{owner}/{dataset}/predict/batchSDK Python: client.datasets.create_batch(owner, dataset, body={...}) (ultralytics-platform>=0.1.57)
Salva una versione del dataset (i dataset di archiviazione cloud non ne hanno una), quindi mette in coda un'esecuzione che etichetta le immagini senza etichette del dataset con il modello e restituisce 202. Il corpo della richiesta accetta gli stessi campi modelId, confidence, iou e classMapping dell'endpoint per una singola immagine, oltre a includeAnnotated (predefinito false) per annotare anche le immagini che hanno già etichette. Con modelId yoloe26x, visualPrompts e referenceImageId (obbligatorio insieme a questi; 422 senza, 404 se l'immagine non è più nel dataset) trovano oggetti simili agli esempi nelle immagini dell'esecuzione (solo quelle senza etichette, a meno che non sia attivo includeAnnotated), nei dataset di rilevamento, segmentazione e OBB; gli esempi vengono codificati una sola volta all'avvio dell'esecuzione. Un modello basato su prompt di classe rileva le classi del dataset senza punteggi di confidenza; un modello a pagamento di un provider richiede una chiave del provider salvata nell'area di lavoro del dataset, in Settings > API Keys (422, code: missing_provider_api_key, prima che l'esecuzione venga accettata). Le etichette esistenti non vengono mai modificate; le predizioni che si sovrappongono a un'etichetta esistente della stessa classe oltre iou vengono ignorate; l'addebito dell'esecuzione si basa sulle immagini effettivamente elaborate. 402 indica che il saldo non copre il costo stimato; 409 indica che il dataset non è pronto, che le sue funzionalità AI di archiviazione sono disattivate o che è On Premise, che non restano immagini da annotare oppure che è già in corso un'altra esecuzione; 422 indica che il dataset non ha classi oppure che è stato fornito un dataset non di rilevamento o con un numero di classi fuori dall'intervallo 1–200 a un modello basato su prompt di classe: crea le classi con l' endpoint delle classi prima di chiamare questo endpoint, proprio come fa il passaggio Map classes dell'app prima di avviare un'esecuzione.
GET sullo stesso percorso (client.datasets.batch(owner, dataset)) restituisce l'esecuzione in corso e il relativo avanzamento oppure l'ultima esecuzione completata finché non viene chiusa; i relativi results includono partialImages se l'esecuzione del modello generativo ha conservato solo le bounding box complete dell'output troncato. DELETE (client.datasets.delete_batch(owner, dataset)) annulla un'esecuzione in corso oppure regola la fatturazione e chiude il riepilogo dell'esecuzione completata.
Lo stesso endpoint sfoca i volti con "operation": "blur", confidence (predefinito 0.25) e boxScale (0.5–1.5, predefinito 1); imageId limita l'esecuzione a una sola immagine. Non crea versioni e non modifica mai le etichette. Invia "preview": true per elaborare fino a sei immagini senza modificarle, quindi invia il valore restituito jobId come previewJobId con le stesse impostazioni per applicare le modifiche; un'anteprima già applicata non può essere riutilizzata e restituisce 409. Mentre un'anteprima è in attesa, passa il relativo ID come previewJobId a DELETE per eliminarla.
{ "operation": "blur", "confidence": 0.25, "boxScale": 1, "preview": true }Sposta immagini in blocco#
PATCH /api/images/bulkPython SDK: client.images.update_bulk(image_ids=..., split=...)
Sposta fino a 1.000 immagini da un dataset a una suddivisione diversa.
{
    "imageIds": ["65f1c0a2b3d4e5f601234567"],
    "split": "val",
    "conflictPolicy": "skip"
}
I conflitti relativi al nome file o al contenuto restituiscono 409 finché non scegli un conflictPolicy valido per l'intero gruppo tra skip, keep_both o replace. La risposta riporta modifiedCount, skippedCount e targetSplit.
Elimina immagini in blocco#
DELETE /api/images/bulkPython SDK: client.images.delete_bulk(image_ids=...)
{
    "imageIds": ["65f1c0a2b3d4e5f601234567", "65f1c0a2b3d4e5f601234568"]
}
Elimina fino a 1.000 immagini da un singolo dataset e restituisce deletedCount e deletedImageIds.
Ottieni URL firmati delle immagini#
POST /api/images/urlsPython SDK: client.images.urls(image_ids=...)
Restituisce URL temporanei firmati per un massimo di 100 ID immagine di un singolo dataset.
{
    "imageIds": ["65f1c0a2b3d4e5f601234567"]
}
Risposta: urls, thumbnails e depths (anteprime del target di profondità per immagini di profondità appaiate), tutti associati all'ID immagine.
API dei progetti#
Organizza i tuoi modelli in progetti. Ogni modello appartiene a un progetto. Consulta la documentazione sui progetti.
Elenca i progetti#
GET /api/projects/{owner}Python SDK: client.projects.list(owner)
Parametri di query:
| Parametro | Tipo | Descrizione |
|---|---|---|
limit | int | Numero massimo di progetti da restituire (predefinito: 20, massimo: 500) |
Ottieni progetto#
GET /api/projects/{owner}/{project}Python SDK: client.projects.retrieve(owner, project)
Restituisce l'oggetto project, un array models di riepiloghi per modello (stato, metriche, epoche, pesi, argomenti di addestramento) e isOwner. Passa search (massimo 200 caratteri) per filtrare models in base al nome del modello o ai metadati.
Crea un progetto#
POST /api/projectsPython SDK: client.projects.create(project=..., name=...)
| Campo | Tipo | Obbligatorio | Descrizione |
|---|---|---|---|
project | stringa | Sì | Nome del progetto utilizzato negli URL della Platform |
name | stringa | Sì | Nome visualizzato (massimo 100 caratteri) |
description | stringa | No | Descrizione (massimo 1000 caratteri) |
visibility | stringa | No | public o private (predefinito: la visibilità predefinita dell'area di lavoro) |
tags | array | No | Fino a 50 tag |
license | stringa | No | Identificatore della licenza del progetto |
metadata | oggetto | No | Metadati JSON personalizzati |
owner | stringa | No | Identificativo dell'area di lavoro del team; per impostazione predefinita viene usata la tua area di lavoro personale |
curl -X POST \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "project": "inspection",
    "name": "Inspection",
    "description": "Detection experiments",
    "metadata": {"department": "manufacturing", "cost_center": "cv-01"}
  }' \
  https://platform.ultralytics.com/api/projects
Risposta (201): id, owner, project, region.
Uno slug project già esistente nell'area di lavoro, anche se si trova nel cestino, restituisce 409.
Aggiorna progetto#
PATCH /api/projects/{owner}/{project}Python SDK: client.projects.update(owner, project)
Campi accettati: name, description, visibility, metadata, tags, license, archived, iconColor, iconLetter, viewPreferences e starred.
{
    "metadata": { "department": "research", "program": "inspection" }
}
Invia un oggetto metadata vuoto ({}) per cancellarlo. I metadati del progetto rispettano gli stessi limiti dei metadati del dataset: 128 caratteri per la chiave e 500.000 caratteri per l'oggetto serializzato. Una modifica a name che cambia lo slug restituisce 409 mentre un modello qualsiasi del progetto sta avviando l'addestramento.
Elimina progetto#
DELETE /api/projects/{owner}/{project}Python SDK: client.projects.delete(owner, project)
Sposta il progetto e i relativi modelli nel cestino, restituendo cascadedModels, ed elimina definitivamente le relative distribuzioni. Il ripristino del progetto non ripristina le distribuzioni. 502 indica che la pulizia delle distribuzioni non è stata completata; i modelli restano nel Cestino finché l'operazione non riesce.
Clona progetto#
POST /api/projects/{owner}/{project}/clonePython SDK: client.projects.clone(owner, project)
Clona un progetto accessibile e i relativi modelli completati. Il corpo facoltativo accetta project, name, description, visibility, license, una destinazione owner e models, un elenco di nomi di modelli da clonare al posto di tutti i modelli completati. Se non specifichi visibility, il clone è privato quando la visibilità predefinita dell'area di lavoro di destinazione è Privato; altrimenti mantiene la visibilità del progetto di origine. Se i modelli del clone superassero il limite di modelli dell'area di lavoro di destinazione, viene restituito 403 e non viene copiato nulla.
API dei modelli#
Gestisci i modelli YOLO addestrati: visualizza le metriche, scarica i pesi, esegui inferenze e monitora l'addestramento. Consulta la documentazione sui modelli.
Elenca i modelli in un progetto#
GET /api/models/{owner}/{project}Python SDK: client.models.list(owner, project)
I modelli elencati non includono i valori di convalida plots e trainResults; Ottieni il modello li restituisce.
Parametri di query:
| Parametro | Tipo | Descrizione |
|---|---|---|
limit | int | Numero massimo di modelli da restituire (predefinito: 20, massimo: 100) |
Ottieni modello#
GET /api/models/{owner}/{project}/{model}Python SDK: client.models.retrieve(owner, project, model)
Parametri di query:
| Parametro | Tipo | Descrizione |
|---|---|---|
analysis | int | Imposta su 1 per restituire l'analisi di convalida per immagine anziché il modello |
La risposta predefinita contiene l'oggetto model: stato, attività, metriche, trainArgs, trainResults, classNames, computeCost, metadata e altro, oltre a isOwner.
Crea modello#
POST /api/modelsPython SDK: client.models.create(body=...)
Crea un record di modello non addestrato a cui puoi associare i pesi o che puoi addestrare.
| Campo | Tipo | Obbligatorio | Descrizione |
|---|---|---|---|
project | stringa | Sì | Nome del progetto di destinazione |
owner | stringa | No | Identificativo dell'area di lavoro; per impostazione predefinita, è la tua area di lavoro personale |
model | stringa | No | Nome del modello usato negli URL della Platform; viene generato se omesso |
name | stringa | No | Nome visualizzato (accettato solo insieme a model) |
description | stringa | No | Descrizione (massimo 1000 caratteri) |
task | stringa | No | detect, segment, semantic, depth, classify, pose o obb |
metadata | oggetto | No | Metadati JSON personalizzati |
trainArgs | oggetto | No | Argomenti di addestramento da registrare |
metrics | oggetto | No | Metriche come mAP50, mAP50-95, precision, recall |
epochs | numero | No | Numero di epoche per un modello già addestrato |
version | stringa | No | Etichetta della versione (massimo 50 caratteri) |
Risposta (201): id, owner, project, model, name, region. La risposta include lo slug e il nome visualizzato del modello selezionati dopo aver risolto i conflitti di denominazione.
Per associare i pesi .pt, richiedi un URL di caricamento firmato con assetType: "models" e id di questo modello come assetId, PUT il file all'URL restituito, quindi chiama POST /api/upload/complete con sessionId restituito.
Aggiorna modello#
PATCH /api/models/{owner}/{project}/{model}Python SDK: client.models.update(owner, project, model)
I campi accettati includono name, description, color, metadata, status, license, datasetSlug, trainArgs, trainResults, epochs, bestEpoch, bestFitness, version, trainingError e starred. Se invii solo projectId, il modello viene spostato in un altro progetto dello stesso proprietario; la risposta restituisce slug del modello nel progetto di destinazione, renamed: true se lo slug è già utilizzato nel progetto di destinazione e 409 mentre il modello è ancora in fase di addestramento. Una modifica a name che cambia lo slug restituisce 409 durante l'avvio dell'addestramento.
{
    "metadata": { "release": "candidate-3", "reviewed": true }
}
metadata personalizzato è separato dai campi gestiti dall'addestramento, come trainArgs, environment e trainResults, e usa gli stessi limiti di dimensione dei metadati del dataset.
Elimina il modello#
DELETE /api/models/{owner}/{project}/{model}Python SDK: client.models.delete(owner, project, model)
Sposta il modello nel cestino per 30 giorni ed elimina definitivamente tutte le distribuzioni che lo utilizzano, comprese quelle sostitutive in attesa. Il ripristino del modello non ripristina le distribuzioni.
Scarica i file del modello#
GET /api/models/{owner}/{project}/{model}/filesPython SDK: client.models.files(owner, project, model)
Restituisce URL firmati di breve durata per i pesi del modello, che prendono il nome dal modello ({model}.pt).
{
    "files": [
        {
            "name": "my-model.pt",
            "size": 6534127,
            "downloadUrl": "https://storage.googleapis.com/...&signature=..."
        }
    ]
}
Trova immagini simili alle peggiori immagini di convalida#
GET /api/models/{owner}/{project}/{model}/similar-imagesPython SDK: client.models.find_similar_training_images(owner, project, model)
Restituisce fino a 100 images, con lo stesso formato di Trova immagini simili, che somigliano alle immagini di validazione con i risultati peggiori in questo ciclo di training, escludendo le immagini già presenti nel dataset di training. Passa hashes (separati da virgole, fino a 100) per cercare a partire da un sottoinsieme delle immagini peggiori e license o publicOnly per restringere la ricerca come in Trova immagini simili. È necessaria una chiave API con accesso al workspace del modello. L'elenco è vuoto se il ciclo non ha registrato risultati per immagine; 404 indica inoltre che agli embedding delle immagini peggiori non è ancora stato assegnato un embedding: esegui prima l'embedding del dataset sul dataset di training.
Clona modello#
POST /api/models/{owner}/{project}/{model}/clonePython SDK: client.models.clone(owner, project, model, project_body=...)
Copia un modello accessibile in un progetto esistente.
{
    "owner": "acme-vision",
    "project": "inspection",
    "model": "v3-copy",
    "name": "V3 Copy",
    "description": "Cloned from a public model"
}| Campo | Tipo | Obbligatorio | Descrizione |
|---|---|---|---|
project | stringa | Sì | Nome del progetto di destinazione |
owner | stringa | No | Area di lavoro di destinazione; per impostazione predefinita, quella personale |
model | stringa | No | Nome del modello di destinazione |
name | stringa | No | Nome visualizzato di destinazione |
description | stringa | No | Descrizione del clone |
Esegui l'inferenza#
POST /api/models/{owner}/{project}/{model}/predictPython SDK: client.models.predict(owner, project, model, body=...)
È possibile eseguire previsioni con i modelli pubblici senza autenticazione. Per i modelli privati e condivisi è necessaria una chiave API con accesso al progetto principale.
Modulo multipart:
| Parametro | Tipo | Predefinito | Intervallo | Descrizione |
|---|---|---|---|---|
file | file | - | - | File immagine o video (obbligatorio se non è impostato source) |
conf | float | 0.25 | 0.01 – 1.0 | Soglia minima di confidenza |
iou | float | 0.5 | 0.0 – 0.95 | Soglia IoU di NMS |
imgsz | int | - | 32 – 1280 | Dimensione dell'immagine di input in pixel; per impostazione predefinita usa la dimensione di addestramento del modello (640 se non disponibile) |
normalize | bool | false | - | Restituisce le coordinate del riquadro di delimitazione nell'intervallo da 0 a 1 |
decimals | int | 5 | 0 – 10 | Precisione decimale dei valori delle coordinate |
vid_stride | int | 1 | ≥ 1 | Esegue la previsione su un frame video ogni N; viene ignorato per le immagini |
bits | int | 8 | 8, 12, 16 | Quantizzazione della mappa di profondità, solo per i modelli di profondità |
source | stringa | - | - | URL dell'immagine o stringa base64 (in alternativa a file); massimo 4.096 caratteri tramite l'API Platform |
Fornisci file oppure source. I modelli di profondità accettano anche bits (8, 12 o 16) per selezionare la quantizzazione PNG della mappa di profondità. Le richieste che superano i limiti di input del servizio restituiscono 413.
curl -X POST \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -F "file=@image.jpg" \
  -F "conf=0.5" \
  https://platform.ultralytics.com/api/models/acme-vision/inspection/v3/predict
Risposta:
Ogni voce in images contiene shape, speed, results (fino a 1.000 per immagine, 300 per i modelli RT-DETR) e, per le attività di previsione densa, un payload PNG semantic_mask o depth (i valori di profondità sono pixel × max / divisor, con divisore 255 per la mappa predefinita a 8 bit e 65535 quando bits è 12 o 16). L'oggetto metadata riporta il numero di immagini, i tempi di esecuzione delle funzioni, l'attività e le versioni del servizio. I percorsi interni dei modelli non vengono mai restituiti.
{
    "images": [
        {
            "shape": [1080, 1920],
            "speed": { "preprocess": 2.1, "inference": 12.4, "postprocess": 1.3 },
            "results": [
                {
                    "class": 0,
                    "name": "person",
                    "confidence": 0.92,
                    "box": { "x1": 100, "y1": 50, "x2": 300, "y2": 400 }
                }
            ]
        }
    ],
    "metadata": {
        "imageCount": 1,
        "functionTimeAlive": 184.2,
        "functionTimeCall": 0.31,
        "task": "detect",
        "version": { "ultralytics": "8.4.120" }
    }
}
Controlla l'avanzamento dell'addestramento#
GET /api/models/{owner}/{project}/{model}/trainingPython SDK: client.models.training(owner, project, model)
Restituisce job, che contiene lo stato, l'avanzamento delle epoche, i tempi, i dettagli di calcolo, gli argomenti di addestramento, le metriche delle epoche e i dettagli sicuri degli errori, oppure null se il modello non è mai stato addestrato. I modelli nei progetti pubblici sono accessibili senza autenticazione.
Annulla addestramento#
DELETE /api/models/{owner}/{project}/{model}/trainingPython SDK: client.models.delete_training(owner, project, model)
Termina l'istanza di calcolo in esecuzione e contrassegna il processo come annullato. Restituisce 409 quando l'addestramento non è più attivo.
API di addestramento#
Avvia l'addestramento YOLO su GPU cloud e monitora l'avanzamento in tempo reale. Consulta la documentazione sull'addestramento cloud.
Ottieni disponibilità GPU#
GET /api/training/gpu-availabilityPython SDK: client.training.gpu_availability()
Restituisce lo stato attuale delle scorte, indicizzato per ID GPU. È pubblico e non richiede autenticazione; passa managed=true per includere la capacità di addestramento gestita, che richiede una chiave API.
Avvia l'addestramento#
POST /api/training/startPython SDK: client.training.start(model_id=..., train_args=...)
| Campo | Tipo | Obbligatorio | Descrizione |
|---|---|---|---|
modelId | stringa | Sì | ID del modello da addestrare |
trainArgs | oggetto | Sì | Argomenti di addestramento YOLO; sono obbligatori model, data e epochs. data è un URI di dataset ul://username/datasets/slug o un file YAML di dataset integrato, come coco8.yaml |
gpuType | stringa | No | GPU cloud da usare (predefinita: rtx-4090) |
captureDatasetVersion | booleano | No | Salva una versione immutabile del dataset per questa esecuzione (predefinito: false) |
curl -X POST \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "modelId": "65f1c0a2b3d4e5f601234599",
    "gpuType": "rtx-4090",
    "trainArgs": {
      "model": "yolo26n.pt",
      "data": "ul://acme-vision/datasets/warehouse",
      "epochs": 100,
      "imgsz": 640,
      "batch": 16
    }
  }' \
  https://platform.ultralytics.com/api/training/start
Risposta:
{
    "modelId": "65f1c0a2b3d4e5f601234599",
    "status": "starting",
    "gpuType": "rtx-4090",
    "estimatedCost": { "pricePerHour": 0.89, "gpuMemoryGb": 24 },
    "billing": {
        "estimatedCostCents": 178,
        "estimatedCostDisplay": "$1.78",
        "balanceCents": 2500
    }
}
L'addestramento restituisce 400 quando data è un ID dataset o un percorso di dataset Platform senza ul://, oppure quando il task del modello non può addestrare il task del dataset; restituisce 402 se il saldo dei crediti è troppo basso, 409 se le funzionalità AI dell'archiviazione cloud del dataset sono disattivate o se l'archiviazione è disconnessa e 503 se non è disponibile capacità per la GPU richiesta.
Sono disponibili 26 tipi di GPU, da rtx-2000-ada a b300, tra cui rtx-4090, l40s, a100-80gb-pcie, a100-80gb-sxm, rtx-pro-6000, h100-sxm, h200-sxm e b200. Consulta Addestramento cloud per l'elenco completo.
API delle esportazioni#
Converti i modelli in formati ottimizzati come ONNX, TensorRT, CoreML e LiteRT per la distribuzione su dispositivi edge.
Elenca esportazioni#
GET /api/models/{owner}/{project}/{model}/exportsPython SDK: client.exports.list(owner, project, model)
Parametri di query:
| Parametro | Tipo | Descrizione |
|---|---|---|
status | stringa | Filtra per queued, starting, running, completed, failed o cancelled |
limit | int | Numero massimo di esportazioni da restituire (predefinito: 20, massimo: 100) |
Crea esportazione#
POST /api/models/{owner}/{project}/{model}/exportsPython SDK: client.exports.create(owner, project, model, format=...)
| Campo | Tipo | Obbligatorio | Descrizione |
|---|---|---|---|
format | stringa | Sì | Formato di esportazione di destinazione (vedi la tabella seguente) |
gpuType | stringa | Condizionale | Obbligatorio quando format è engine; usa una GPU o una piattaforma Jetson supportata |
args | oggetto | No | Opzioni di esportazione: imgsz, quantize, dynamic, simplify, opset, conf, iou, batch, workspace, nms, optimize e name (dispositivo di destinazione per RKNN, QNN, Hailo, Ascend e Xilinx) |
curl -X POST \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"format": "onnx", "args": {"imgsz": 640, "quantize": 16}}' \
  https://platform.ultralytics.com/api/models/acme-vision/inspection/v3/exports
Ogni formato supporta solo le opzioni indicate nella colonna Argomenti della tabella di esportazione qui sotto: se un formato non supporta un valore non predefinito di batch, dynamic, opset, simplify, workspace o optimize, restituisce 400. Le esportazioni imx sono solo INT8 e disponibili per i modelli di rilevamento, segmentazione, classificazione e stima della posa; un modello il cui nome identifica un modello YOLO diverso da YOLOv8n o YOLO11n restituisce 400.
Risposta (201): id, format, status (queued o running), region e gpuType per le esportazioni TensorRT. Se è già in corso un'esportazione dello stesso formato per il modello, una nuova richiesta restituisce 409, qualunque sia il suo args.
Formati supportati:
Usa l'argomento format della tabella di esportazione condivisa qui sotto. PyTorch è il formato di origine e non è un formato di destinazione per l'esportazione tramite API.
| Formato | Argomento format | Modello | Metadati | Argomenti |
|---|---|---|---|---|
| PyTorch | - | yolo26n.pt | ✅ | - |
| TorchScript | torchscript | yolo26n.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n_ncnn_model/ | ✅ | imgsz, quantize, device |
| IMX500 | imx | yolo11n_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n_executorch_model/ | ✅ | imgsz, quantize, batch, data, fraction, device |
| Axelera | axelera | yolo26n_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
| NXP | nxp | yolo26n_nxp.tflite | ✅ | imgsz, quantize, data, fraction, device |
nms=None restituisce per impostazione predefinita output grezzi per la NMS esterna (YOLO26 mantiene la propria head senza NMS su Axelera). Imposta nms=False per selezionare una head senza NMS disponibile; i formati non supportati usano il proprio percorso di output nativo. Le voci nms qui sopra identificano i formati che possono incorporare la NMS con nms=True.
Ottieni stato esportazione#
GET /api/models/{owner}/{project}/{model}/exports/{exportId}Python SDK: client.exports.retrieve(owner, project, model, export_id)
Restituisce l'oggetto export con status, format, args, gpuType (solo TensorRT), le marche temporali e, una volta completata, un oggetto file contenente size, downloadUrl e downloadFilename.
Crea un link di importazione per dispositivi mobili#
POST /api/models/{owner}/{project}/{model}/exports/{exportId}/mobileSDK Python: non ancora disponibile; invia direttamente la richiesta HTTP.
Restituisce importUrl e expiresAt per aprire un'esportazione completata in CoreML, Core AI o LiteRT nell'app Ultralytics YOLO. Il link scade dopo 24 ore e chiunque ne disponga può scaricare l'esportazione fino a quel momento. Un'esportazione incompleta o incompatibile restituisce 409.
Annulla o elimina esportazione#
DELETE /api/models/{owner}/{project}/{model}/exports/{exportId}Python SDK: client.exports.delete(owner, project, model, export_id)
Annulla un'esportazione attiva oppure elimina un'esportazione completata e il relativo file. La risposta indica quale operazione è stata eseguita:
{
    "success": true,
    "action": "cancelled"
}
API delle distribuzioni#
Distribuisci i modelli su endpoint di inferenza dedicati, con controlli dello stato di salute e monitoraggio. Consulta la documentazione sugli endpoint.
Elenca distribuzioni#
GET /api/deployments/{owner}Python SDK: client.deployments.list(owner)
Parametri di query:
| Parametro | Tipo | Descrizione |
|---|---|---|
status | stringa | creating, deploying, ready, stopping, stopped o failed |
model | stringa | Filtra per {project}/{model}, ad esempio inspection/v3 |
limit | int | Numero massimo di distribuzioni da restituire (predefinito: 20, massimo: 100) |
Chi effettua richieste in forma anonima deve filtrare per un singolo modello pubblico; per elencare un'intera area di lavoro è necessaria l'autenticazione.
Crea distribuzione#
POST /api/deployments/{owner}Python SDK: client.deployments.create(owner, project=..., model=..., deployment=..., name=..., region=...)
Corpo:
{
    "project": "inspection",
    "model": "v3",
    "deployment": "edge-1",
    "name": "Edge 1",
    "region": "us-central1"
}| Campo | Tipo | Obbligatorio | Descrizione |
|---|---|---|---|
project | stringa | Sì | Progetto che contiene il modello |
model | stringa | Sì | Modello da distribuire |
deployment | stringa | Sì | Nome della distribuzione usato negli URL della Platform |
name | stringa | Sì | Nome visualizzato |
region | stringa | Sì | Una delle 42 aree di distribuzione supportate |
cpu | numero | No | Core vCPU: 1 (predefinito), 2, 4, 6 o 8 |
memoryGi | numero | No | Memoria in GiB: 2 (predefinita), 4, 8, 16, 24 o 32 |
Risposta (201): id, deployment, status (creating), message e region.
La dimensione predefinita di 1 vCPU / 2 GiB si riduce a zero quando è inattiva e può usufruire di una quota gratuita per le distribuzioni; le altre dimensioni prevedono prezzi a consumo. I valori correnti sono restituiti nell'oggetto resources per ogni distribuzione consultata.
Scegli un'area geografica vicina ai tuoi utenti per ridurre al minimo la latenza. L'interfaccia utente della Platform mostra le stime di latenza per tutte le 42 aree disponibili.
Ottieni distribuzione#
GET /api/deployments/{owner}/{deployment}Python SDK: client.deployments.retrieve(owner, deployment)
Restituisce l'oggetto deployment con status, statusMessage, region, serviceUrl, resources e metadata personalizzato, oltre a camera e cameraApplying per il proprietario.
Aggiorna una distribuzione#
PATCH /api/deployments/{owner}/{deployment}Python SDK: client.deployments.update(owner, deployment, body=...)
Invia uno dei seguenti corpi:
{ "name": "Edge 1 (primary)" }La ridenominazione imposta nell'URL il valore deployment su uno slug derivato dal nuovo nome, restituito come deployment; il vecchio percorso restituisce 404 e serviceUrl rimane invariato. Un oggetto metadata vuoto cancella i metadati personalizzati. La sostituzione distribuisce una nuova revisione mantenendo invariati l'ID della distribuzione, la regione e l'URL dell'endpoint; se la distribuzione non riesce, la revisione esistente resta attiva. Il modello sostitutivo deve essere un modello completato con pesi accessibili con la tua chiave. L'azione della telecamera salva una telecamera RTSP o RTSPS su cui un endpoint pronto con risorse personalizzate continua a eseguire l'inferenza (vedi Telecamera in background); "url": null la rimuove, così come il ripristino delle dimensioni predefinite, mentre il salvataggio di una telecamera su un endpoint con dimensioni predefinite restituisce 403. Una modifica della telecamera restituisce 202 con status ready durante l'applicazione: interroga la distribuzione finché cameraApplying non è più true, quindi controlla camera; se la modifica non riesce, la telecamera precedente viene mantenuta e viene impostato statusMessage. Le operazioni completate restituiscono 200 con status ready oppure stopped; le altre operazioni ancora in fase di distribuzione restituiscono 202 con deploying o stopping.
Elimina distribuzione#
DELETE /api/deployments/{owner}/{deployment}Python SDK: client.deployments.delete(owner, deployment)
Rimuove definitivamente l'endpoint di inferenza.
Controllo dello stato#
GET /api/deployments/{owner}/{deployment}/healthPython SDK: client.deployments.health(owner, deployment)
Invia richieste di ping all'endpoint e lo riscalda, restituendo healthy, latencyMs e il codice upstream status.
Esegui inferenza su una distribuzione#
POST /api/deployments/{owner}/{deployment}/predictPython SDK: client.deployments.predict(owner, deployment, body=...)
Instrada un'immagine o un video attraverso l'endpoint dedicato. I contratti di richiesta e risposta corrispondono a quelli dell'inferenza del modello. I flussi delle telecamere non vengono inoltrati tramite proxy; inviali all'URL dell'endpoint come descritto in Inferenza da telecamera in diretta.
Modulo multipart:
| Parametro | Tipo | Predefinito | Intervallo | Descrizione |
|---|---|---|---|---|
file | file | - | - | File immagine o video (obbligatorio se non è impostato source) |
conf | float | 0.25 | 0.01 – 1.0 | Soglia minima di confidenza |
iou | float | 0.5 | 0.0 – 0.95 | Soglia IoU di NMS |
imgsz | int | - | 32 – 1280 | Dimensione dell'immagine di input in pixel; per impostazione predefinita usa la dimensione di addestramento del modello (640 se non disponibile) |
normalize | bool | false | - | Restituisce le coordinate del riquadro di delimitazione nell'intervallo da 0 a 1 |
decimals | int | 5 | 0 – 10 | Precisione decimale dei valori delle coordinate |
vid_stride | int | 1 | ≥ 1 | Esegue la previsione su un frame video ogni N; viene ignorato per le immagini |
bits | int | 8 | 8, 12, 16 | Quantizzazione della mappa di profondità, solo per i modelli di profondità |
source | stringa | - | - | URL dell'immagine o stringa base64 (in alternativa a file); massimo 4.096 caratteri tramite l'API Platform |
Ottieni metriche#
GET /api/deployments/{owner}/{deployment}/metricsPython SDK: client.deployments.metrics(owner, deployment)
Parametri di query:
| Parametro | Tipo | Descrizione |
|---|---|---|
range | stringa | 1h, 6h, 24h (predefinito), 7d o 30d |
sparkline | booleano | Restituisce il riepilogo compatto del dashboard anziché le serie complete (predefinito: false) |
view | stringa | overview restituisce solo le metriche di richieste, errori e latenza P95 |
La risposta completa contiene summary (totale delle richieste, tasso di errore, latenza media e p50/p95/p99) e timeSeries (richieste, errori, latenza, CPU, memoria, numero di istanze). La risposta con mini-grafico restituisce requests24h (conteggi orari delle richieste; le ore senza richieste vengono omesse), totalRequests, errorRate e avgLatencyMs (la media delle latenze P95 orarie). Con view=overview, summary contiene totalRequests, errorRate, e p95LatencyMs, mentre timeSeries contiene requests, errors e latencyP95.
Ottieni log#
GET /api/deployments/{owner}/{deployment}/logsPython SDK: client.deployments.logs(owner, deployment)
Parametri di query:
| Parametro | Tipo | Descrizione |
|---|---|---|
severity | stringa | Separati da virgole: DEBUG, INFO, NOTICE, WARNING, ERROR, CRITICAL, ALERT, EMERGENCY |
limit | int | Voci da restituire (predefinito: 50, max: 200) |
pageToken | stringa | Token di paginazione di una risposta precedente |
API degli agenti#
Salva e gestisci i flussi di lavoro degli agenti. L'API memorizza le definizioni degli agenti; le esecuzioni vengono avviate nell'area di lavoro degli agenti, dove https://platform.ultralytics.com/agents?workflow={id} apre un agente salvato. I metodi dell'SDK Python richiedono ultralytics-platform>=0.1.74.
Ogni operazione accetta un parametro di query facoltativo owner con il nome utente di un'area di lavoro a cui appartieni (predefinito: la tua). Per elencare gli elementi serve l'accesso di visualizzazione; per salvare ed eliminare serve l'accesso di modifica.
Elenca agenti#
GET /api/workflowsPython SDK: client.agents.list()
| Parametro | Tipo | Descrizione |
|---|---|---|
owner | stringa | Nome utente dell'area di lavoro (predefinito: il tuo) |
id | stringa | Restituisce un agente con il relativo graph |
search | stringa | Filtra per nome dell'agente |
La risposta elenca fino a 100 agenti in workflows, dal più recente aggiornato al meno recente, ciascuno con id, username, name, version, createdAt e updatedAt. Se richiedi un id, viene restituito anche graph dell'agente.
Salva un agente#
PUT /api/workflowsPython SDK: client.agents.save(name=..., graph=..., version=...)
Invia version: 0 per creare un agente. Per aggiornarne uno, invia id e version restituito dall'ultima operazione di elenco o salvataggio; un version non aggiornato restituisce 409, quindi elenca nuovamente l'agente e riprova. Un grafo le cui connessioni formano un ciclo o assegnano a un blocco più di un input restituisce 400.
from ultralytics_platform import Platform

def block(node_id, kind, x, config):
    return {
        "id": node_id,
        "type": "agent",
        "position": {"x": x, "y": 0},
        "data": {"label": kind, "type": kind, "config": config},
    }

graph = {
    "nodes": [
        block("images", "Dataset", 0, {"dataset": "official:coco8", "split": "val", "maxInputs": 2}),
        block("yolo", "YOLO", 220, {"model": "ul://ultralytics/yolo26/yolo26n", "task": "detect"}),
        block("output", "Output", 440, {}),
    ],
    "edges": [{"id": "e1", "source": "images", "target": "yolo"}, {"id": "e2", "source": "yolo", "target": "output"}],
    "templateId": "",
}

with Platform() as client:
    saved = client.agents.save(name="Detect COCO8", graph=graph, version=0)
    print(saved["id"], saved["version"], saved["errors"])
La risposta restituisce id dell'agente, il suo nuovo version e errors: i blocchi che l'area di lavoro segnalerebbe, ad esempio un blocco Dataset senza un dataset selezionato. L'agente viene salvato in ogni caso. Consulta openapi.json per tutti i tipi di blocco e le relative configurazioni.
Elimina un agente#
DELETE /api/workflows?id={id}Python SDK: client.agents.delete(id=...)
Elimina l'agente e annulla le sue esecuzioni attive. Gli agenti eliminati non compaiono nel Cestino e non possono essere ripristinati.
API del cestino#
Visualizza, ripristina ed elimina definitivamente progetti, dataset e modelli eliminati logicamente. Gli elementi vengono rimossi automaticamente dopo 30 giorni. Consulta la documentazione del cestino.
Elenca cestino#
GET /api/trashPython SDK: client.lifecycle.trash()
Parametri di query:
| Parametro | Tipo | Descrizione |
|---|---|---|
type | stringa | all (predefinito), project, dataset o model |
page | int | Numero di pagina (predefinito: 1) |
limit | int | Elementi per pagina (predefinito: 50, max: 200) |
id | stringa | Con type project o model, visualizza in anteprima i modelli e le distribuzioni interessati dall'eliminazione |
La risposta include items (ciascuno con daysRemaining), total, page, limit, totalPages e un summary con i totali per tipo. Con id, restituisce invece resources: i modelli interessati e le distribuzioni che verrebbero eliminati definitivamente.
Ripristina elemento#
POST /api/trashPython SDK: client.lifecycle.restore(id=..., type=...)
{
    "id": "65f1c0a2b3d4e5f601234567",
    "type": "dataset"
}
Il ripristino di un progetto ripristina anche i modelli che erano stati spostati nel cestino insieme a esso, indicati come restoredModels.
Elimina definitivamente#
DELETE /api/trashPython SDK: client.lifecycle.delete_trash(body=...)
Elimina un elemento:
{
    "id": "65f1c0a2b3d4e5f601234567",
    "type": "dataset"
}
Oppure svuota l'intero cestino:
{
    "all": true
}
La risposta riporta deletedCount e, se pertinenti, cascadedModels e survivingDeployments.
L'eliminazione definitiva non può essere annullata. La risorsa e tutti i dati associati vengono rimossi.
API di caricamento#
Carica i file direttamente nell'archiviazione cloud usando URL firmati. Il completamento del caricamento di un modello collega i relativi pesi; il completamento del caricamento di un archivio di dataset lo verifica e, successivamente, passi la sessione a ingestione del dataset, che completa a sua volta il caricamento se salti questo passaggio. Consulta la documentazione sui dati.
Ottieni URL di caricamento firmato#
POST /api/upload/signed-urlPython SDK: client.upload.signed_url(body=...)
Corpo:
{
    "assetType": "datasets",
    "assetId": "65f1c0a2b3d4e5f601234567",
    "filename": "warehouse.zip",
    "contentType": "application/zip",
    "totalBytes": 52428800
}| Campo | Tipo | Obbligatorio | Descrizione |
|---|---|---|---|
assetType | stringa | Sì | datasets o models |
assetId | stringa | Sì | ID del dataset o modello di destinazione |
filename | stringa | Sì | Nome file originale (max 256 caratteri) |
contentType | stringa | Sì | Tipo MIME |
totalBytes | numero | Sì | Dimensione del file in byte |
Quando assetType è datasets, filename deve terminare con .zip, .tar, .tar.gz, .tgz o .ndjson. Prima di caricarle, raccogli le immagini sciolte in un archivio.
Risposta:
{
    "sessionId": "session_abc123",
    "uploadUrl": "https://storage.googleapis.com/...&signature=...",
    "expiresAt": "2026-02-22T12:00:00Z",
    "headers": { "x-goog-if-generation-match": "0" }
}
Carica il file con una richiesta PUT a uploadUrl, usando lo stesso Content-Type dichiarato e tutte le intestazioni restituite in headers. Gli URL di caricamento dei dataset sono validi per 12 ore e consentono solo la creazione: una seconda richiesta PUT allo stesso URL restituisce 412, mentre una richiesta PUT senza le intestazioni restituite restituisce 400.
Completa caricamento#
POST /api/upload/completePython SDK: client.upload.complete(session_id=...)
{
    "sessionId": "session_abc123",
    "md5": "<optional md5 hex>"
}
Risposta: success e un oggetto file con size e contentType. Per i modelli, questa operazione collega i pesi; per gli archivi di dataset, chiama poi ingest per avviare l'elaborazione.
Se viene fornito md5, viene confrontato con l'oggetto memorizzato. In caso di mancata corrispondenza viene restituito 400; per una sessione non ancora completata, il file caricato viene anche eliminato e la sessione rimane incompleta: richiedi quindi un nuovo URL firmato e carica nuovamente il file. Una sessione di dataset completata può essere completata di nuovo finché l'archivio esiste, ma i completamenti concorrenti con hash diversi restituiscono 409; le sessioni dei modelli vengono eliminate al completamento. checksum viene memorizzato come metadato del file del modello e non viene verificato.
API delle integrazioni di archiviazione#
Collega gli account Google Cloud Storage, Amazon S3 o Azure Blob Storage, consultali come origini dei dataset e attiva o disattiva le relative funzionalità AI. Consulta la documentazione sulle integrazioni.
Per individuare e collegare l'archiviazione serve l'accesso di amministratore dell'area di lavoro e un piano Pro o Enterprise (403 altrimenti); per elencare le integrazioni e sfogliare gli oggetti serve l'accesso di modifica.
Elenca integrazioni#
GET /api/integrations/bucketsPython SDK: client.storage_integrations.list()
Restituisce integrations, ciascuno con id, provider, credentialIdentity, targets, processing (indica se le funzionalità AI sono attive) e createdAt. Le credenziali non vengono mai restituite.
Individua posizioni#
POST /api/integrations/buckets/discoverPython SDK: client.storage_integrations.discover(body=...)
Elenca i bucket o i container accessibili con le credenziali fornite, senza salvarle.
{
    "provider": "gcs",
    "credentials": {
        "client_email": "svc@project.iam.gserviceaccount.com",
        "private_key": "-----BEGIN PRIVATE KEY-----\n...",
        "project_id": "my-project"
    }
}
Risposta: {"targets": ["my-bucket", "another-bucket"]}
Collega archiviazione#
POST /api/integrations/bucketsPython SDK: client.storage_integrations.create(body=...)
Stessi schemi delle credenziali usati per il rilevamento, più un array obbligatorio targets con da 1 a 50 nomi di bucket o container. Restituisce 201 con l'integrazione salvata. La connessione verifica l'accesso in scrittura per ogni destinazione senza scrivere nulla. Le credenziali temporanee S3 (chiavi di accesso ASIA) vengono rifiutate.
Sfoglia oggetti#
GET /api/integrations/buckets/{id}/objectsPython SDK: client.storage_integrations.objects(id, target=...)
Parametri di query:
| Parametro | Tipo | Obbligatorio | Descrizione |
|---|---|---|---|
target | stringa | Sì | Nome del bucket o container |
prefix | stringa | No | Prefisso della cartella (max 1024 caratteri) |
cursor | stringa | No | Cursore di paginazione del provider di una pagina precedente |
Restituisce entries (ogni kind è folder o file) e un cursor facoltativo per la pagina successiva.
Imposta le funzionalità AI#
PATCH /api/integrations/buckets/{id}Python SDK: client.storage_integrations.update(id, processing=False)
Attiva ({"processing": true}) o disattiva le funzionalità AI per ogni destinazione dell'integrazione e restituisce l'integrazione aggiornata. La disattivazione interrompe l'avvio di nuove attività. Richiede l'accesso di amministratore del workspace.
Disconnetti archiviazione#
DELETE /api/integrations/buckets/{id}Python SDK: client.storage_integrations.delete(id)
Rimuove le credenziali salvate senza eliminare i dati del provider. I dataset collegati rimangono visibili, ma i relativi file restano inaccessibili finché non viene ricollegato lo stesso account di archiviazione. Richiede l'accesso di amministratore dell'area di lavoro.
API di importazione dei dataset#
Importa dataset da servizi di terze parti. Consulta le integrazioni Roboflow e Label Studio.
Visualizza in anteprima un'importazione Roboflow#
POST /api/integrations/roboflow/previewPython SDK: client.datasets.preview_roboflow(api_key=...)
Risolve una chiave API Roboflow in un piano di importazione: dettagli dell'area di lavoro, newDatasets da importare, importedDatasets la cui versione più recente è già stata importata, conteggi dei progetti già importati (skippedCount), senza versione, non supportati e non risolti, bytesTotal e il margine disponibile del tuo storage. I nuovi dataset includono la dimensione della loro esportazione sizeBytes; i dataset già importati la includono se è ancora possibile calcolarla. apiKey è facoltativo: se non lo specifichi, viene usata la chiave Roboflow salvata nell'area di lavoro; se non è disponibile nessuna delle due, la richiesta restituisce 400. La chiave inviata dal proprietario dell'area di lavoro viene salvata per l'area di lavoro dopo aver risolto un'area di lavoro Roboflow.
{
    "apiKey": "ROBOFLOW_API_KEY"
}
Importa da Roboflow#
POST /api/integrations/roboflow/importPython SDK: client.datasets.import_roboflow(api_key=..., items=...)
Mette in coda i processi di importazione per un massimo di 500 versioni di progetti Roboflow selezionate, usando gli elementi restituiti dall'anteprima. apiKey è facoltativo e, come nell'anteprima, usa la chiave salvata se non ne specifichi una; tuttavia, non viene mai salvato.
{
    "apiKey": "ROBOFLOW_API_KEY",
    "items": [
        {
            "workspace": "my-workspace",
            "projectId": "warehouse-safety",
            "projectName": "Warehouse Safety",
            "projectType": "object-detection",
            "latestVersion": 4
        }
    ]
}
Risposta (201): array imported, failed e skipped. Le importazioni richiedono spazio di archiviazione disponibile e ogni dataset deve rispettare il limite di dimensione per importazione previsto dal tuo piano.
Visualizza l'anteprima di un'importazione da Label Studio#
POST /api/integrations/label-studio/previewPython SDK: client.datasets.preview_label_studio(api_key=...)
Elenca i progetti nell'account Label Studio in hosting connesso come piano di importazione: newDatasets e importedDatasets (ognuno con projectId, projectName, il valore previsto task e imageCount), unsupportedCount per i progetti la cui configurazione delle etichette non può essere importata e il tuo storage. apiKey è un token facoltativo di accesso personale o legacy di Label Studio: in sua assenza viene usato il token salvato nello spazio di lavoro e, se non è disponibile nessuno dei due, la richiesta restituisce 409. Solo il proprietario dello spazio di lavoro può inviare un token, che viene salvato per lo spazio di lavoro quando viene restituito l'elenco dei progetti; chiunque altro ne invii uno riceve 403.
{
    "apiKey": "LABEL_STUDIO_ACCESS_TOKEN"
}
Importa da Label Studio#
POST /api/integrations/label-studio/importPython SDK: client.datasets.import_label_studio(project_ids=...)
Accoda un'importazione di dataset per ciascuno dei massimo 500 ID di progetto Label Studio, usando il token salvato nello spazio di lavoro. L'attività viene riletta dalla configurazione delle etichette di ogni progetto, quindi non può essere scelta nella richiesta.
{
    "projectIds": [101, 102]
}
Risposta (201): array imported, failed e skipped. Le importazioni richiedono spazio di archiviazione disponibile; ogni progetto riceve una quota uguale, fino al limite di dimensione per importazione previsto dal tuo piano.
API dell'account#
Esamina il tuo account Platform, le chiavi, l'archiviazione e i profili pubblici. Consulta la documentazione delle impostazioni.
Riepilogo account#
GET /api/account/summaryPython SDK: client.account.summary()
Restituisce il piano, il saldo dei crediti e il conteggio delle risorse per l'area di lavoro che ha generato la chiave.
{
    "username": "acme-vision",
    "name": "Acme Vision",
    "accountType": "team",
    "plan": "pro",
    "creditsCents": 2500,
    "counts": { "projects": 4, "datasets": 7, "models": 21 },
    "teams": []
}Per un account personale, teams elenca le aree di lavoro dei team a cui appartieni, ciascuna con il tuo role e un deniedReason quando l'area di lavoro è al momento inaccessibile, ad esempio dopo la scadenza del piano. Le aree di lavoro dei team restituiscono un elenco vuoto.
Elenca chiavi API#
GET /api/api-keysPython SDK: client.account.api_keys()
Restituisce keys con keyId, name, keyPrefix e createdAt per l'area di lavoro della chiave. Le richieste autenticate con chiave API ricevono solo metadati; i valori completi delle chiavi sono visibili al proprietario dell'area di lavoro in Impostazioni > Chiavi API nell'interfaccia utente Platform, dove è anche possibile creare e revocare le chiavi.
Verifica utilizzo archiviazione#
GET /api/storagePython SDK: client.account.storage()
Parametri di query:
| Parametro | Tipo | Descrizione |
|---|---|---|
details | booleano | Includi i dieci maggiori consumatori di spazio di archiviazione (predefinito: false) |
Risposta:
{
    "tier": "pro",
    "usage": {
        "storage": { "current": 1073741824, "limit": 536870912000, "percent": 0 },
        "datasets": { "current": 2, "limit": -1, "percent": 0 },
        "models": { "current": 4, "limit": 500, "percent": 1 }
    },
    "breakdown": {
        "byCategory": {
            "datasets": { "bytes": 536870912, "count": 2 },
            "models": { "bytes": 268435456, "count": 4 },
            "exports": { "bytes": 268435456, "count": 3 }
        },
        "topItems": [
            {
                "_id": "65f1c0a2b3d4e5f601234567",
                "name": "Warehouse",
                "slug": "warehouse",
                "sizeBytes": 536870912,
                "type": "dataset"
            }
        ]
    },
    "region": "us",
    "username": "acme-vision",
    "updatedAt": "2026-01-15T10:00:00Z"
}
usage riporta i conteggi di projects, datasets, models, images, annotations e deployments, e i byte per storage. Un limit pari a -1 indica un valore illimitato, mentre percent è una percentuale intera del limite.
Ottieni un profilo utente pubblico#
GET /api/usersPython SDK: client.account.profile(username=...)
Parametri di query:
| Parametro | Tipo | Obbligatorio | Descrizione |
|---|---|---|---|
username | stringa | Sì | Nome utente da cercare |
Restituisce il profilo pubblico user con followerCount e, per chi effettua chiamate autenticato, isFollowed.
Segui o smetti di seguire un utente#
PATCH /api/usersPython SDK: client.account.follow(username=..., followed=...)
{
    "username": "target-user",
    "followed": true
}
Risposta: followed e il valore aggiornato di followerCount.
API di fatturazione#
Controlla l'utilizzo del piano e il registro dei crediti. Consulta la documentazione sulla fatturazione.
Gli importi di fatturazione sono numeri interi espressi in centesimi di dollaro statunitense, dove 100 = $1.00.
Visualizzare piano e utilizzo#
GET /api/billing/usage-summaryPython SDK: client.billing.usage_summary()
Restituisce plan (ID, stato, ciclo di fatturazione, fine del periodo), metrics (limite e utilizzo dello spazio di archiviazione), trainingCredit, features, creditsCents e il numero di postazioni.
Visualizzare le transazioni#
GET /api/billing/transactionsPython SDK: client.billing.transactions()
Parametri di query:
| Parametro | Tipo | Descrizione |
|---|---|---|
from | stringa | Timestamp della prima transazione (ISO 8601) |
to | stringa | Timestamp dell'ultima transazione (ISO 8601) |
Ogni transazione include id, type (ad esempio purchase, training, monthly_grant o refund), amountCents, balanceAfter, createdAt, un receiptUrl facoltativo e il contesto del modello per gli addebiti di addestramento. I dettagli interni di fatturazione non vengono mai restituiti.
API Esplora#
Cerca progetti, dataset e modelli pubblici condivisi dalla community oppure cerca immagini in base a ciò che mostrano o usando una foto. Consulta la documentazione di Esplora.
Cercare contenuti pubblici#
GET /api/explore/searchPython SDK: client.explore.search()
Parametri di query:
| Parametro | Tipo | Descrizione |
|---|---|---|
q | stringa | Termine di ricerca (max 200 caratteri); per dataset e modelli, prima viene cercata una corrispondenza testuale, poi i dataset le cui immagini corrispondono (o i modelli addestrati su di essi) |
type | stringa | all (predefinito; progetti e dataset), projects, datasets, models o images (ignora sort) |
sort | stringa | relevance (predefinito), newest, oldest, stars, name-asc, name-desc, count-desc, count-asc; relevance classifica le corrispondenze di dataset e modelli per q, altrimenti li ordina dal più recente al meno recente |
offset | int | Risultati da ignorare (predefinito: 0) |
limit | int | Numero massimo di risultati per tipo di risorsa (predefinito: 20, max: 100) |
task | stringa | Filtri delle attività separati da virgole: detect, segment, semantic, depth, classify, pose, obb |
license | stringa | Identificatori di licenza separati da virgole, ad esempio CC-BY-4.0,MIT; le immagini ereditano la licenza del proprio dataset |
author | stringa | Filtro per nome utente del proprietario |
starred | booleano | Restituisci solo i contenuti aggiunti ai preferiti dall'utente autenticato; richiede una chiave API |
minImages | int | Restituisce solo i dataset con almeno questo numero di immagini; con type=images, solo le immagini provenienti da tali dataset |
maxImages | int | Restituisce solo i dataset con al massimo questo numero di immagini; con type=images, solo le immagini provenienti da tali dataset |
Risposta: projects, datasets e hasMore. type=images restituisce i risultati corrispondenti in images, ordinati dal più pertinente in poi; ciascuno include la propria origine dataset e una somiglianza da 0 a 1 score. Con q, cerca nei dataset pubblici e anche nei tuoi dataset e in quelli del team, se invii una chiave API. Senza q, elenca un'immagine da ciascuno dei più recenti dataset pubblici, senza ordinarle, con score 1, rispettando i filtri.
type=models restituisce i modelli pubblici in models, uno per dataset di addestramento (o per progetto se non ne hanno uno), ad eccezione dei modelli ufficiali @ultralytics, che mantengono ciascuno una voce distinta; i cloni e i modelli il cui addestramento non è terminato vengono esclusi. Con q, vengono prima i modelli ufficiali corrispondenti, poi i modelli il cui nome o progetto corrisponde e infine i modelli addestrati sui dataset pubblici con le immagini più pertinenti. Senza q, elenca i modelli addestrati su dataset pubblici, dal più recente al meno recente. Tiene conto di task e author e ordina per relevance, newest o oldest; con gli altri ordinamenti, elenca i più recenti per primi.
curl "https://platform.ultralytics.com/api/explore/search?type=datasets&task=detect&sort=stars&limit=20"Cerca per immagine#
POST /api/explore/searchSDK Python: client.explore.search_by_image() (ultralytics-platform>=0.1.107)
Invia una foto come image codificato in base64 (massimo 3 MiB, mai memorizzato) nel corpo JSON con type images (predefinito), datasets, o models e uno qualsiasi tra sort, offset, limit, task, license, author, starred, minImages e maxImages da Cerca contenuti pubblici. La risposta ha la stessa struttura e una richiesta che invia image restituisce anche un vector: invialo al posto di image per ottenere altre pagine, applicare altri filtri o usare un altro type, così la foto viene letta una sola volta. type=images restituisce immagini con punteggio, come avviene per una ricerca testuale; type=datasets restituisce dataset pubblici con immagini corrispondenti, prima quelli più pertinenti in base a sort=relevance (con gli altri ordinamenti vengono ordinati normalmente); tali immagini sono mostrate per prime nella scheda sampleImages di ciascun dataset; type=models restituisce i modelli pubblici addestrati su quei dataset, a partire dai più pertinenti. Ogni richiesta che invia image rientra anche in un limite separato di 20 al minuto per utente (per indirizzo IP se non è presente una chiave API). 400 indica parametri non validi o una foto illeggibile, mentre 503 indica che la ricerca è occupata: riprova tra poco.
SDK Python#
ultralytics-platform è un client Python con tipi, generato dal contratto OpenAPI, con un metodo per ogni endpoint (client.datasets.list, client.models.predict, client.exports.create, ...). Ogni metodo accetta i parametri del percorso in modo posizionale, gli altri input come argomenti con nome, e timeout e extra_headers facoltativi per ogni richiesta.
pip install "ultralytics-platform>=0.1.45" # Python 3.11+from ultralytics_platform import Platform
with Platform() as client: # legge ULTRALYTICS_API_KEY o la chiave salvata da yolo login
dataset = client.datasets.retrieve("acme-vision", "warehouse")
images = client.datasets.images("acme-vision", "warehouse", limit=10)
export = client.exports.create("acme-vision", "inspection", "v3", format="onnx")AsyncPlatform espone la stessa struttura di risorse per il codice async/await; le risposte non riuscite generano APIError con status_code, body e json analizzato, mentre gli errori di connessione generano APIConnectionError. Consulta il repository dell'SDK per il README completo.
Integrazione Python#
Per i flussi di lavoro di addestramento e inferenza, usa il pacchetto Python Ultralytics, che gestisce automaticamente autenticazione, caricamenti e trasmissione di metriche in tempo reale. Con Python 3.11+, pip install ultralytics installa anche l'SDK ultralytics-platform. Quando model.train(project=...) è destinato a Platform, i callback di addestramento trasmettono gli eventi tramite client.training.metrics() dell'SDK e richiedono gli URL per caricare i checkpoint tramite client.models.upload_checkpoint(), le operazioni POST /api/webhooks/training/metrics e POST /api/webhooks/models/upload del documento OpenAPI, quindi non devi effettuare chiamate direttamente.
Installazione e configurazione#
L'integrazione con Platform richiede Python>=3.11 e ultralytics>=8.4.120:
pip install "ultralytics>=8.4.120"Verifica l'installazione:
yolo checkAutenticazione#
yolo login YOUR_API_KEYUso dei dataset della Platform#
Fai riferimento ai dataset con URI ul://:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# Addestra sul tuo dataset Platform
model.train(
    data="ul://your-username/datasets/your-dataset",
    epochs=100,
    imgsz=640,
)
Formato URI:
| Schema | Descrizione |
|---|---|
ul://username/datasets/slug | Dataset |
ul://username/project/model-name | Modello specifico |
ul://ultralytics/yolo26/yolo26n | Modello ufficiale |
Invio a Platform#
Invia i risultati a un progetto Platform:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# I risultati vengono sincronizzati automaticamente con Platform
model.train(
    data="coco8.yaml",
    epochs=100,
    project="your-username/my-project",
    name="experiment-1",
)
Elementi sincronizzati:
- Metriche di addestramento (in tempo reale)
- Pesi del modello finali
- Grafici di convalida
- L'output della console
- Metriche di sistema
- Argomenti di addestramento e ambiente host (nome host, sistema operativo, Python, hardware, commit git, riga di comando)
Esempi di API#
Carica un modello da Platform:
# Il tuo modello
model = YOLO("ul://username/project/model-name")

# Modello ufficiale
model = YOLO("ul://ultralytics/yolo26/yolo26n")
Esegui l'inferenza:
results = model("image.jpg")

# Accedi ai risultati
for r in results:
    boxes = r.boxes  # Riquadri di rilevamento
    masks = r.masks  # Maschere di segmentazione
    keypoints = r.keypoints  # Keypoint di posa
    probs = r.probs  # Probabilità di classificazione
Esporta il modello:
# Esporta in ONNX
model.export(format="onnx", imgsz=640, quantize=16)

# Esporta in TensorRT
model.export(format="engine", imgsz=640, quantize=16)

# Esporta in CoreML
model.export(format="coreml", imgsz=640)  # usa imgsz=224 per la classificazione
Convalida:
metrics = model.val(data="ul://username/datasets/my-dataset")

print(f"mAP50: {metrics.box.map50}")
print(f"mAP50-95: {metrics.box.map}")
Domande frequenti#
Usa gli stessi segmenti del proprietario e del nome che compaiono nell'URL di Platform. Un modello all'indirizzo
https://platform.ultralytics.com/acme-vision/inspection/v3corrisponde aGET /api/models/acme-vision/inspection/v3. Gli ID del database vengono comunque restituiti nelle risposte (comeid) e alcuni endpoint li accettano direttamente: gli endpoint per le immagini accettano unimageId, i caricamenti accettano unassetIdePOST /api/training/startaccetta unmodelId.Dipende dalla raccolta. La maggior parte degli endpoint per gli elenchi accetta
limit:curl -H "Authorization: Bearer YOUR_API_KEY" \ "https://platform.ultralytics.com/api/datasets/acme-vision?limit=50"Le immagini dei dataset, il clustering e la ricerca di Esplora usano
offsetconlimite riportanohasMore:curl "https://platform.ultralytics.com/api/explore/search?type=datasets&offset=20&limit=20&sort=stars"Per scorrere insiemi di immagini molto grandi, è preferibile usare il cursore restituito come
nextCursor:curl -H "Authorization: Bearer YOUR_API_KEY" \ "https://platform.ultralytics.com/api/datasets/acme-vision/warehouse/images?limit=1000&includeTotal=false&cursor=NEXT_CURSOR"Il cestino usa
page, mentre i log delle distribuzioni usanopageToken, un valore opaco restituito comenextPageToken.Sì. Ogni operazione in questa pagina è una semplice richiesta HTTPS e il contratto completo è pubblicato in formato OpenAPI 3.2 all'indirizzo platform.ultralytics.com/openapi.json, che puoi fornire a un generatore di client per qualsiasi linguaggio. Il pacchetto
ultralytics-platformè proprio questo: un client con tipi generato dal contratto, mentre il pacchettoultralyticsaggiunge la trasmissione di metriche in tempo reale e il caricamento automatico dei modelli per l'addestramento e l'inferenza. I flussi dell'account disponibili solo tramite sessione del browser, come il pagamento della fatturazione e la gestione del team, restano nell'interfaccia utente di Platform.Usa l'header
Retry-Afterdella risposta429per attendere il tempo necessario:import time import requests def api_request_with_retry(url, headers, max_retries=3): for attempt in range(max_retries): response = requests.get(url, headers=headers) if response.status_code != 429: return response wait = int(response.headers.get("Retry-After", 2**attempt)) time.sleep(wait) raise RuntimeError("Rate limit exceeded")404significa che la risorsa non esiste o non è visibile in alcun modo alla tua chiave.403significa che la risorsa è stata trovata, ma l'azione richiede più autorizzazioni di quelle concesse alla tua chiave: accesso di modifica per modificare un dataset, accesso del proprietario per eliminare una distribuzione, accesso di amministratore per scollegare lo spazio di archiviazione oppure un piano o una quota superiore per esportazioni e distribuzioni.Lettura di dataset, progetti e modelli pubblici, incluse le relative immagini, gli URL firmati delle immagini, le statistiche delle classi, lo stato degli embedding, il layout del clustering, i modelli addestrati su un dataset e l'elenco delle esportazioni; controllo dei progressi dell'addestramento di un modello pubblico; download dei file di un modello pubblico; creazione di un link di importazione per dispositivi mobili per l'esportazione di un modello pubblico; esecuzione dell'inferenza su un modello pubblico; consultazione del profilo di un utente pubblico; elencazione delle distribuzioni filtrate per un singolo modello pubblico e ricerca in Explore.
GET /api/training/gpu-availabilityè completamente pubblico, a meno che tu non richieda capacità gestita. Per tutto il resto è necessaria una chiave; fornendone una su un endpoint pubblico, vengono inoltre resorse accessibili le tue risorse private.


Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.