Distribuzione#
Ultralytics Platform offre opzioni complete per la distribuzione dei modelli per portare in produzione i tuoi modelli YOLO. Prova i modelli con l'inferenza nel browser, distribuiscili su endpoint dedicati in 42 regioni globali e monitora le prestazioni in tempo reale.
Watch: Get Started with Ultralytics Platform - Deploy
Panoramica#
La sezione Distribuzione ti aiuta a:
- Provare i modelli direttamente nel browser con la scheda
Predict - Distribuire su endpoint dedicati in 42 regioni globali
- Monitorare le metriche delle richieste, i log, i controlli di integrità e le previsioni temporanee su ogni endpoint dedicato
- Scegliere le risorse: gli endpoint predefiniti si ridimensionano fino a zero; le dimensioni personalizzate mantengono un'istanza attiva con fatturazione basata sul tempo di attività
Opzioni di distribuzione#
Ultralytics Platform offre diversi metodi di distribuzione:
| Opzione | Descrizione | Ideale per |
|---|---|---|
| Scheda Previsioni | Inferenza nel browser con immagini, webcam ed esempi | Sviluppo, convalida |
| Inferenza condivisa | Servizio multi-tenant in 3 regioni dati | Uso limitato, test |
| Endpoint dedicati | Servizi single-tenant in 42 regioni | Produzione, bassa latenza |
| Esportazione | Scarica i pesi in 21 formati per l'esecuzione locale o su dispositivi edge | Offline, sul dispositivo |
Flusso di lavoro#
graph LR
    A[✅ Test]:::start --> B[⚙️ Configure]:::proc
    B --> C[🌐 Deploy]:::proc
    C --> D[📊 Monitor]:::out

    classDef start fill:#4CAF50,color:#fff
    classDef proc fill:#2196F3,color:#fff
classDef out fill:#9C27B0,color:#fff| Fase | Descrizione |
|---|---|
| Test | Convalida il modello con la scheda Predict |
| Configura | Seleziona un modello, una regione, la CPU e la memoria; controlla i prezzi e il nome della distribuzione |
| Distribuisci | Crea un endpoint dedicato dalla scheda Deploy |
| Monitora | Esamina le metriche dell'endpoint e le previsioni temporanee in Monitoraggio |
Architettura#
Inferenza condivisa#
Il servizio di inferenza condivisa viene eseguito in 3 regioni principali. Le richieste a un modello vengono instradate al servizio nella regione dati di quel modello, così i risultati rimangono nella regione in cui è archiviato il modello:
graph TB
    User[User Request]:::start --> API[Platform API]:::proc
    API --> Router{Model Data Region}:::decide
    Router -->|US models| US["US Predict Service<br/>Iowa"]:::out
    Router -->|EU models| EU["EU Predict Service<br/>Belgium"]:::out
    Router -->|AP models| AP["AP Predict Service<br/>Taiwan"]:::out

    classDef start fill:#4CAF50,color:#fff
    classDef proc fill:#2196F3,color:#fff
    classDef decide fill:#FF9800,color:#fff
classDef out fill:#9C27B0,color:#fff| Regione | Etichetta | Posizione | Ideale per |
|---|---|---|---|
| US | Americhe | Iowa, Stati Uniti | Utenti delle Americhe, prestazioni ottimali per le Americhe |
| EU | Europa, Medio Oriente e Africa | Belgio, Europa | Utenti europei, conformità al GDPR |
| AP | Asia-Pacifico | Taiwan, Asia-Pacifico | Utenti dell'Asia-Pacifico, latenza minima nell'area APAC |
Endpoint dedicati#
Distribuisci in 42 regioni nel mondo su Ultralytics Cloud:
- Americhe: 14 regioni
- Europa: 13 regioni
- Asia-Pacifico: 12 regioni
- Medio Oriente e Africa: 3 regioni
Ogni endpoint è un servizio single-tenant con:
- CPU e memoria configurabili, con prezzi mostrati prima della distribuzione
- Ridimensionamento fino a zero per le risorse predefinite; un'istanza attiva per le risorse personalizzate, con addebito basato sul tempo di attività
- URL univoco dell'endpoint con un riferimento API interattivo dedicato all'indirizzo
/docs - Associazione a una chiave API dedicata, in modo che solo quella chiave possa chiamare l'endpoint
- Monitoraggio, log e controlli di integrità indipendenti
Scheda Distribuzioni#
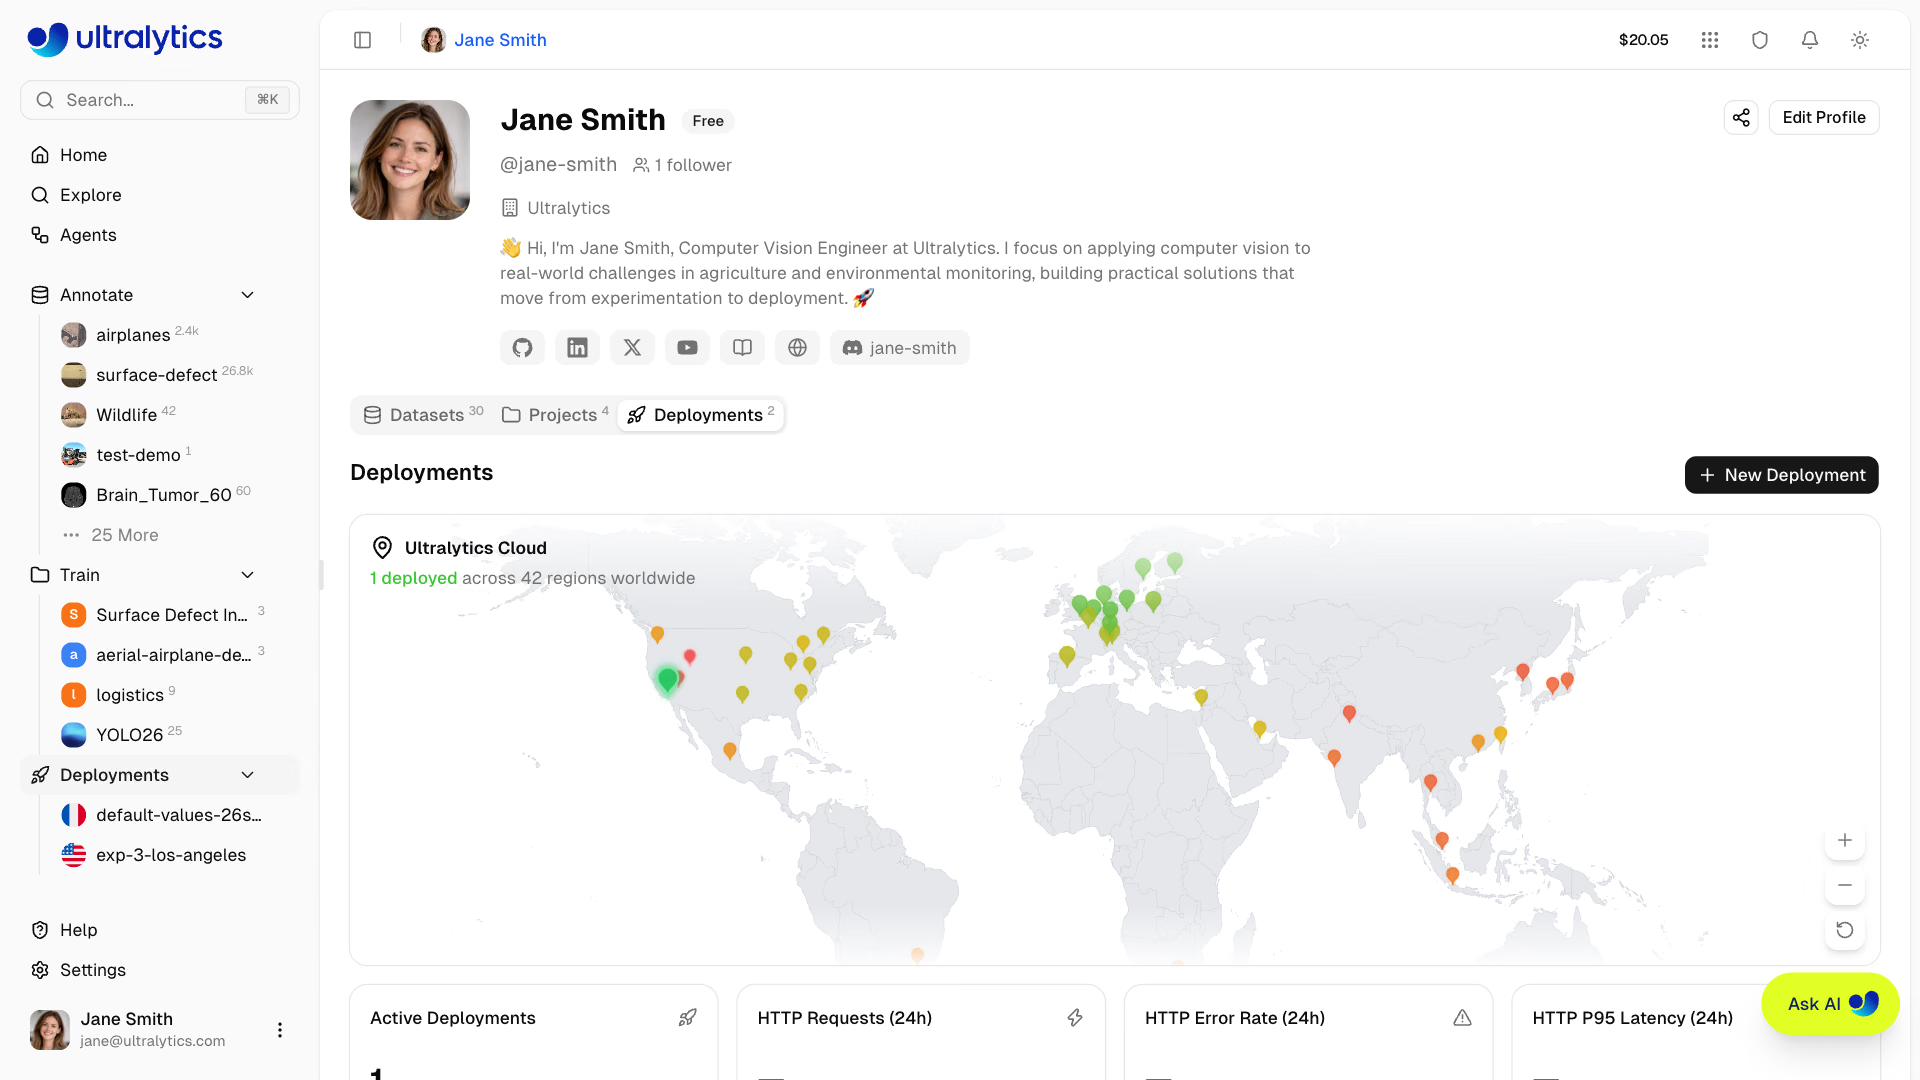
Tutte le tue distribuzioni sono elencate nella scheda Distribuzioni del tuo profilo (/{username}?tab=deployments), accanto a Dataset e Progetti. La sezione Distribuzioni della barra laterale elenca le tue distribuzioni, ciascuna con un collegamento alla relativa pagina, un pulsante + per crearne una e un collegamento alla scheda completa. La scheda mostra:
- Mappa mondiale con indicatori delle regioni di distribuzione; fai clic su una regione per aprire la finestra di dialogo
New Deployment - Schede di panoramica: distribuzioni attive, richieste HTTP (24 ore), percentuale di errori HTTP (24 ore), latenza HTTP P95 (24 ore)
- Elenco delle distribuzioni con ricerca, ordinamento e tre modalità di visualizzazione: schede, compatta e tabella; ogni distribuzione rimanda alla propria pagina con le schede
Overview,Monitoring,PredicteLogs - Pulsante Nuova distribuzione per creare endpoint da qualsiasi modello completato
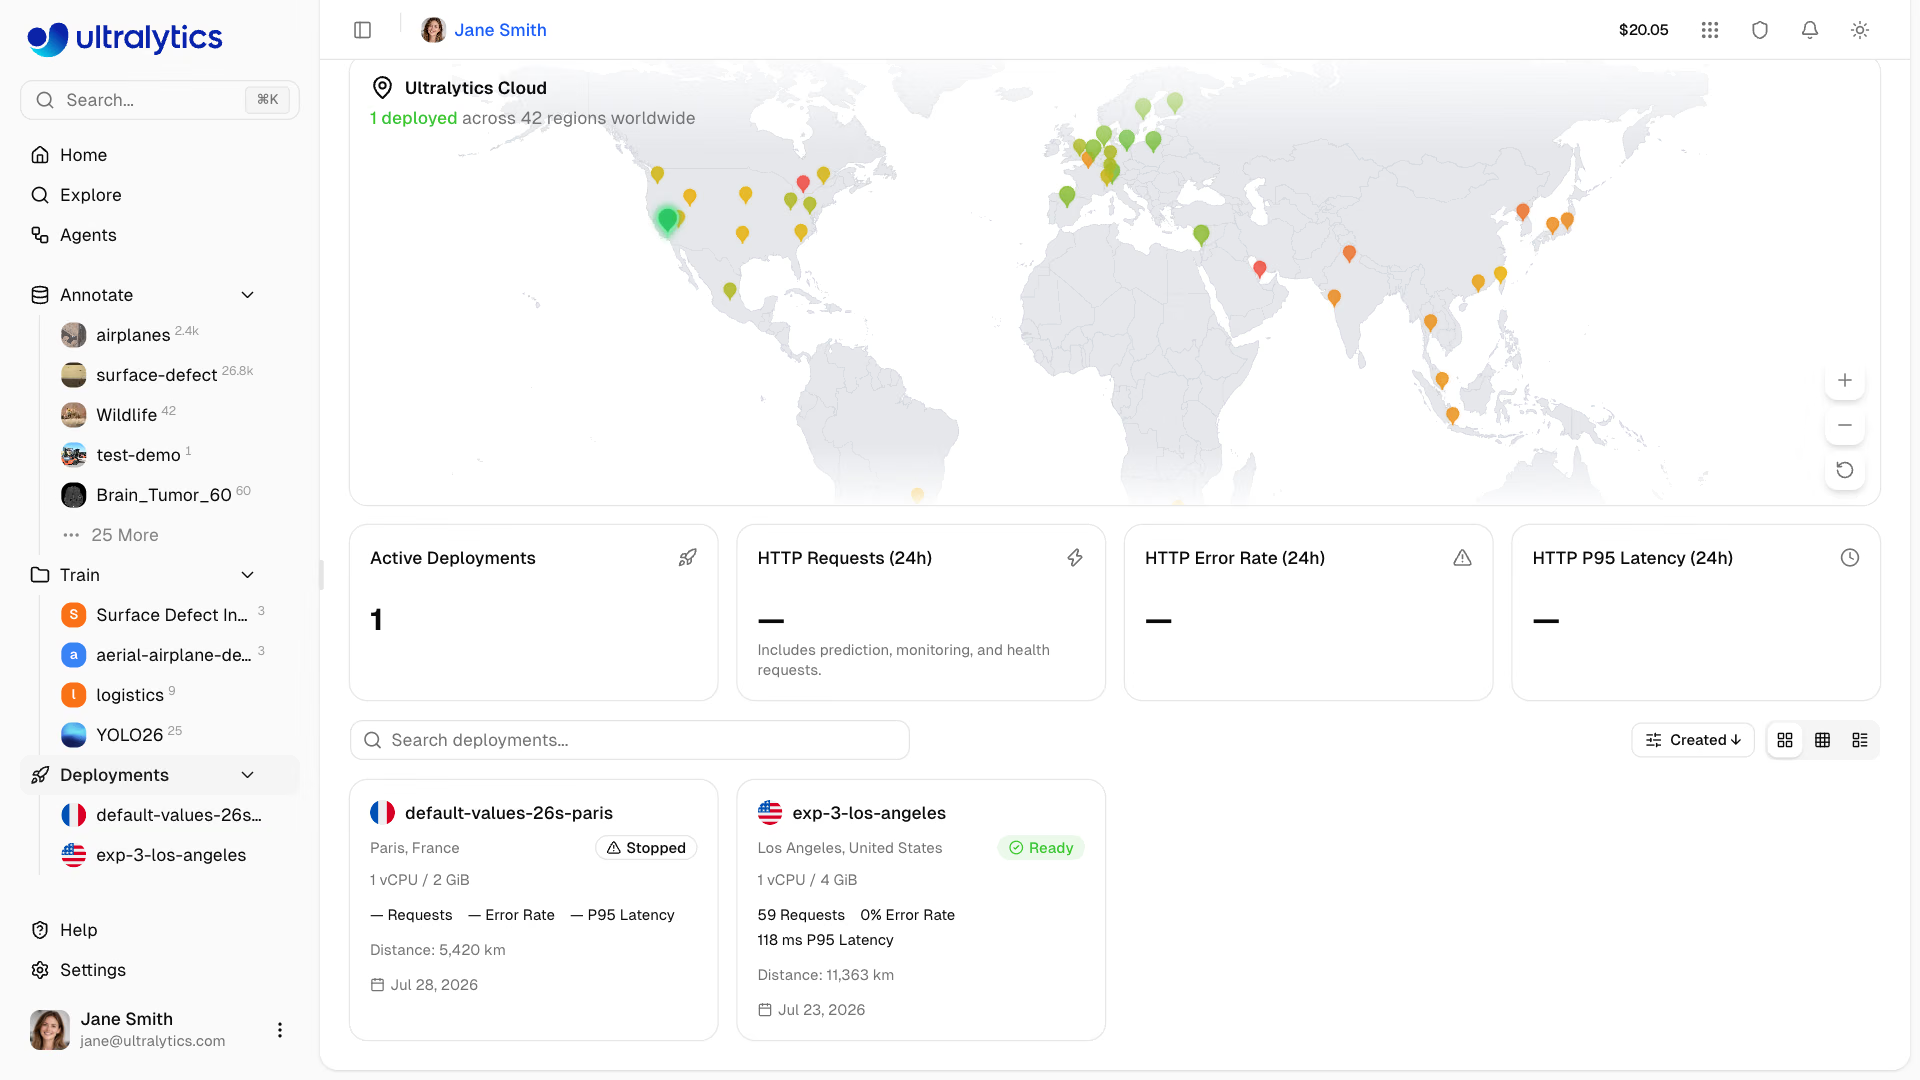
La scheda si aggiorna automaticamente e con maggiore frequenza mentre una distribuzione cambia stato (creating, deploying o stopping). Per i dettagli, consulta Monitoraggio.
Ogni endpoint dedicato pronto fornisce grafici e immagini di esempio conservati solo nella memoria dell'istanza che gestisce le richieste. L'arresto, il riavvio, la ridistribuzione, il ridimensionamento o la sostituzione del modello possono cancellare questi dati. Per conservarli, salva gli esempi in un dataset e attendi il completamento dell'importazione. Consulta Monitoraggio.
Funzionalità principali#
Copertura globale#
Distribuisci vicino ai tuoi utenti con 42 regioni che coprono:
- Nord America, Sud America
- Europa, Medio Oriente, Africa
- Asia-Pacifico, Oceania
Comportamento di ridimensionamento#
Attualmente, gli endpoint si comportano così:
- Risorse predefinite: gli endpoint inattivi si ridimensionano fino a zero e si avviano a freddo alla richiesta successiva
- Risorse personalizzate: un'istanza rimane attiva e accumula addebiti per il tempo di attività finché non viene arrestata
- Una sola istanza attiva: attualmente, ogni endpoint gestisce le richieste da un'unica istanza con tutti i piani
- Limitazione del carico: le richieste ricevono risposte
429quando l'endpoint raggiunge temporaneamente la capacità massima — consulta Richieste dirette agli endpoint - Timeout delle richieste: le richieste dirette agli endpoint hanno una durata massima di 1 ora; consulta Inferenza per gli input supportati
Distribuzione regionale#
Usa la latenza misurata per regione per posizionare un endpoint vicino ai suoi chiamanti. La latenza effettiva dell'inferenza dipende dal modello, dalle dimensioni dell'input, dallo stato dell'endpoint e dal percorso di rete.
Controlli di integrità#
Ogni distribuzione in esecuzione include un controllo automatico di integrità con:
- Indicatore di stato attuale (integro/non integro)
- Visualizzazione della latenza di risposta
- Nuovi tentativi automatici quando lo stato non è integro, che si interrompono quando torna integro
- Pulsante per ripetere manualmente il controllo
Avvio rapido#
Crea una distribuzione:
- Addestra o carica un modello in un progetto
- Vai alla scheda Distribuisci del modello
- Fai clic su Distribuisci per una regione nella tabella della latenza
- Controlla CPU, memoria, prezzi e nome nella finestra di dialogo della distribuzione
- Fai clic su Crea distribuzione e attendi che lo stato della distribuzione diventi Pronto
Model → Deploy tab → Deploy in a region → Review configuration → Create DeploymentIl nome della distribuzione viene generato dal nome del modello e dalla città della regione e può essere modificato prima della distribuzione. Una volta completata la distribuzione, usa l'URL dell'endpoint con la tua chiave API per inviare richieste di inferenza da qualsiasi applicazione.
Link rapidi#
- Inferenza: prova i modelli nel browser
- Endpoint: distribuisci endpoint dedicati
- Monitoraggio: monitora le prestazioni della distribuzione
Domande frequenti#
Funzionalità Condivisa Dedicata Servizio Condiviso tra gli utenti della Platform Dedicato a una sola distribuzione Ridimensionamento Gestito dalla Platform Predefinito: si ridimensiona fino a zero; personalizzato: rimane attivo Regioni 3 regioni dati Scegli tra 42 regioni di distribuzione URL API del modello della Platform URL dell'endpoint di distribuzione generato Test Scheda Predictdel modelloScheda o API Predictdella pagina della distribuzioneLimiti di frequenza 20 richieste al minuto Nessun limite di frequenza della Platform per le chiamate dirette Autenticazione Qualsiasi chiave API dello spazio di lavoro Solo la chiave API associata al deployment Il deployment rimane nello stato di creazione o di deployment mentre il servizio si avvia. Diventa utilizzabile quando lo stato passa a Pronto; i tempi variano in base al modello e alla regione e sono in genere di alcuni minuti.
Sì, ogni modello può avere più endpoint in regioni diverse. Il numero di deployment è limitato dal piano: Free
3, Pro10, Enterpriseunlimited. La quota viene addebitata allo spazio di lavoro proprietario del modello e ogni endpoint serve esattamente un modello alla volta: usa la sostituzione del modello per sostituire il modello senza modificare l'URL.Gli endpoint con risorse predefinite si ridimensionano a zero quando sono inattivi:
- L'endpoint si ridimensiona dopo un periodo di inattività
- La prima richiesta avvia un avvio a freddo
- Le richieste successive sono rapide
Le prime richieste dopo un periodo di inattività avviano un avvio a freddo. Aprendo la pagina del deployment viene eseguito un controllo dello stato che riscalda l'endpoint, così l'endpoint risponde rapidamente a una previsione di test subito dopo.
Gli endpoint con risorse personalizzate rimangono attivi e vengono addebitati per il tempo di attività, compreso il tempo di inattività. Arresta un endpoint per interrompere l'addebito del tempo di attività.