YOLO26 모델 형식에서 TF.js 모델 형식으로 내보내기#
Ultralytics 8.4.83부터 tfjs(TensorFlow.js) 내보내기 형식이 제거되고 통합 Google LiteRT 형식으로 대체되었습니다. LiteRT는 LiteRT.js(WebGPU 가속 지원)를 통해 브라우저에서 실행되며, 단일 .tflite 모델로 TF.js가 처리하던 브라우저 내 및 Node.js 사용 사례에 더해 모바일, 임베디드, 엣지 환경도 지원합니다.
format="tfjs"은 계속 작동하지만 지원 중단 경고를 표시하고 대신 LiteRT 모델을 내보냅니다. 앞으로는 format="litert"를 사용하세요. 최신 내보내기 안내와 브라우저 배포 방법은 LiteRT 내보내기 가이드를 참조하세요.
머신러닝 모델을 브라우저나 Node.js에서 직접 배포하는 일은 까다로울 수 있습니다. 사용자의 장치에서 대화형 애플리케이션을 로컬로 실행할 수 있도록 모델 형식이 더 빠른 성능에 최적화되어 있는지 확인해야 합니다. TensorFlow.js 또는 TF.js 모델 형식은 전력 소비를 최소화하면서 빠른 성능을 제공하도록 설계되었습니다.
'TF.js 모델 형식으로 내보내기' 기능을 사용하면 Ultralytics YOLO26 모델을 최적화하여 고속 로컬 객체 탐지 추론을 수행할 수 있습니다. 이 가이드에서는 모델을 TF.js 형식으로 변환하는 방법을 안내하여 다양한 로컬 브라우저와 Node.js 애플리케이션에서 모델이 원활하게 작동하도록 지원합니다.
TF.js로 내보내야 하는 이유는 무엇인가요?#
TensorFlow 생태계의 일부로 TensorFlow 팀이 개발한 TensorFlow.js로 머신러닝 모델을 내보내면 머신러닝 애플리케이션 배포에 여러 이점이 있습니다. 민감한 데이터를 장치에 보관하여 사용자의 개인정보 보호와 보안을 강화할 수 있습니다. 아래 이미지는 TensorFlow.js 아키텍처와 머신러닝 모델이 웹 브라우저 및 Node.js에서 변환되고 배포되는 방식을 보여줍니다.
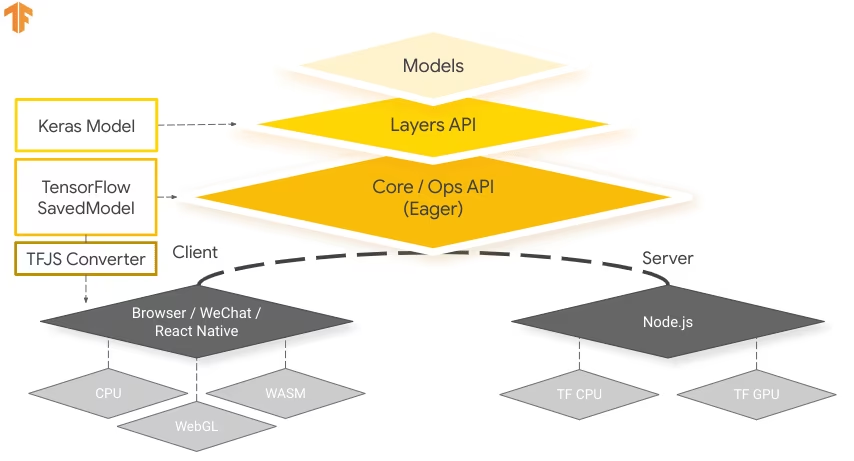
모델을 로컬에서 실행하면 지연 시간이 줄어들고 사용자 경험이 향상됩니다. TensorFlow.js는 오프라인 기능도 제공하므로 인터넷에 연결되지 않은 상태에서도 애플리케이션을 사용할 수 있습니다. TF.js는 확장성을 고려해 설계되었으며 GPU 가속을 지원하므로 리소스가 제한된 장치에서도 복잡한 모델을 효율적으로 실행할 수 있습니다.
TF.js의 주요 기능#
TF.js를 개발자를 위한 강력한 도구로 만드는 주요 기능은 다음과 같습니다:
-
크로스 플랫폼 지원: TensorFlow.js는 브라우저 및 Node.js 환경 모두에서 사용할 수 있어 다양한 플랫폼에 유연하게 배포할 수 있습니다. 이를 통해 개발자는 애플리케이션을 더 쉽게 개발하고 배포할 수 있습니다.
-
다중 백엔드 지원: TensorFlow.js는 CPU, GPU 가속을 위한 WebGL, 네이티브에 가까운 실행 속도를 제공하는 WebAssembly(WASM), 고급 브라우저 기반 머신러닝 기능을 제공하는 WebGPU 등 다양한 계산 백엔드를 지원합니다.
-
오프라인 기능: TensorFlow.js를 사용하면 인터넷 연결 없이 브라우저에서 모델을 실행할 수 있으므로 오프라인에서도 작동하는 애플리케이션을 개발할 수 있습니다.
TensorFlow.js를 사용한 배포 옵션#
YOLO26 모델을 TF.js 형식으로 내보내는 과정을 살펴보기 전에, 이 형식을 사용하는 일반적인 배포 시나리오를 알아보겠습니다.
TF.js는 머신러닝 모델 배포를 위한 다양한 옵션을 제공합니다:
-
브라우저 내 ML 애플리케이션: 브라우저에서 머신러닝 모델을 직접 실행하는 웹 애플리케이션을 구축할 수 있습니다. 서버 측 계산이 필요하지 않으므로 서버 부하가 줄어듭니다.
-
Node.js 애플리케이션: TensorFlow.js는 Node.js 환경에 배포하는 것도 지원하므로 서버 측 머신러닝 애플리케이션을 개발할 수 있습니다. 서버의 처리 성능이나 서버 측 데이터에 대한 액세스가 필요한 애플리케이션에 특히 유용합니다.
-
Chrome 확장 프로그램: TensorFlow.js를 사용해 Chrome 확장 프로그램을 만드는 것도 흥미로운 배포 시나리오입니다. 예를 들어, 사용자가 웹페이지의 이미지에서 마우스 오른쪽 버튼을 클릭하면 사전 학습된 ML 모델로 이미지를 분류하는 확장 프로그램을 개발할 수 있습니다. TensorFlow.js를 일상적인 웹 브라우징 환경에 통합하면 머신러닝을 바탕으로 즉각적인 인사이트나 기능 향상을 제공할 수 있습니다.
YOLO26 모델을 TensorFlow.js로 내보내기#
YOLO26 모델을 TF.js로 변환하면 모델 호환성과 배포 유연성을 높일 수 있습니다.
설치#
필수 패키지를 설치하려면 다음을 실행하세요:
# Install the required package for YOLO26
pip install ultralytics
설치 절차에 대한 자세한 지침과 모범 사례는 Ultralytics 설치 가이드를 참조하세요. YOLO26에 필요한 패키지를 설치하는 중 문제가 발생하면 해결 방법과 팁을 확인할 수 있는 일반적인 문제 가이드를 참조하세요.
사용법#
모든 Ultralytics YOLO26 모델은 별도의 설정 없이 내보내기를 지원하도록 설계되어 있어 원하는 배포 워크플로에 쉽게 통합할 수 있습니다. 애플리케이션에 가장 적합한 설정을 선택하려면 지원되는 내보내기 형식 및 구성 옵션 전체 목록을 확인하세요.
이제 tfjs 인수는 로컬에서 내보내기, 예측, 검증 모드를 지원하고 LiteRT.js를 통해 브라우저에서 실행되는 LiteRT .tflite 모델을 내보냅니다. 현재 브라우저 및 장치 내 배포 방법은 LiteRT 내보내기 가이드를 참조하세요.
from ultralytics import YOLO

# YOLO26 모델 로드
model = YOLO("yolo26n.pt")

# TF.js를 대체하는 LiteRT 형식으로 모델 내보내기
model.export(format="litert", imgsz=640) # 분류에는 imgsz=224 사용내보낸 LiteRT .tflite 모델은 yolo predict 및 yolo val로 직접 로드되며, LiteRT.js를 통해 브라우저에서 실행됩니다. LiteRT 내보내기 가이드를 참조하세요.
내보내기 인수#
| 인수 | 유형 | 기본값 | 설명 |
|---|---|---|---|
format | str | 'litert' | 내보낸 모델의 대상 형식입니다. 지원 중단된 'tfjs' 값은 LiteRT를 내보냅니다. |
imgsz | int 또는 tuple | 640 | 모델 입력에 사용할 이미지 크기입니다. 정사각형 이미지에는 정수를 사용하고, 특정 크기에는 튜플 (height, width)을 사용할 수 있습니다. |
quantize | int 또는 str | None | 양자화 정밀도: 8(정적 INT8, int8 가중치 + int8 활성화, 보정용 data/fraction 필요), 'w8a16'(정적, int8 가중치 + int16 활성화, 보정용 data/fraction 필요), 'w8a32'(동적 INT8, int8 가중치 + FP32 활성화, 보정 불필요) 또는 32/미설정(FP32)입니다. FP16은 별도로 내보내지 않습니다. GPU 대리자를 사용하면 FP32 모델이 자동으로 FP16으로 실행됩니다. 지원 중단된 half/int8 플래그를 대체합니다. |
batch | int | 1 | 내보내기 모델의 배치 추론 크기 또는 predict 모드에서 내보낸 모델이 동시에 처리할 최대 이미지 수를 지정합니다. |
data | str | None | 양자화에 필요한 데이터셋 YAML 경로입니다. 분류의 경우 데이터셋 디렉터리 또는 기본 제공 데이터셋 이름을 사용합니다. quantize=8 또는 'w8a16'가 지정되지 않으면 Ultralytics가 모델 작업에 맞는 기본 보정 데이터셋을 선택합니다. |
fraction | float, int 또는 list | 1.0 | 비율, 이미지 수 또는 [train, val, test] 비율/개수로 지정하는 보정 하위 집합입니다. 항목이 두 개인 목록에서는 test이 전체로 설정되고, 0는 건너뜁니다. |
device | str | None | 내보내기에 사용할 디바이스를 지정합니다. CPU는 device=cpu, Apple 실리콘용 MPS는 device=mps입니다. |
내보내기 프로세스에 관한 자세한 내용은 내보내기에 관한 Ultralytics 문서 페이지를 참조하세요.
내보낸 YOLO26 TensorFlow.js 모델 배포#
YOLO26 모델을 내보냈다면 다음 단계는 모델을 배포하는 것입니다. 내보내기를 통해 장치 내에서 실행되고 LiteRT.js를 통해 브라우저에서도 실행되는 LiteRT .tflite 모델이 생성됩니다. 현재 배포 방법은 LiteRT 내보내기 가이드를 참조하세요.
참고로 기존 TensorFlow.js 런타임 리소스는 다음과 같습니다:
-
Chrome 확장 프로그램: TF.js 모델을 Chrome 확장 프로그램에 배포하는 방법에 관한 개발자 문서입니다.
-
Node.js에서 TensorFlow.js 실행: Node.js에서 TensorFlow.js를 직접 실행하는 방법을 다룬 TensorFlow 블로그 게시물입니다.
-
TensorFlow.js 배포 - 클라우드 플랫폼의 Node 프로젝트: TensorFlow.js 모델을 클라우드 플랫폼에 배포하는 방법을 다룬 TensorFlow 블로그 게시물입니다.
요약#
이 가이드에서는 Ultralytics YOLO26 모델을 TensorFlow.js 형식으로 내보내는 방법을 알아보았습니다. TF.js로 내보내면 다양한 플랫폼에서 YOLO26 모델을 유연하게 최적화하고 배포하며 확장할 수 있습니다.
사용 방법에 관한 자세한 내용은 TensorFlow.js 공식 문서를 참조하세요.
Ultralytics YOLO26을 다른 플랫폼 및 프레임워크와 통합하는 방법은 통합 가이드 페이지를 확인하세요. 이 페이지에는 프로젝트에서 YOLO26을 최대한 활용하는 데 도움이 되는 유용한 자료가 포함되어 있습니다.
자주 묻는 질문#
Ultralytics YOLO26 모델을 TensorFlow.js(TF.js) 형식으로 간편하게 내보낼 수 있습니다. 다음 단계를 따르세요:
사용법from ultralytics import YOLO # YOLO26 모델 로드 model = YOLO("yolo26n.pt") # TF.js를 대체하는 LiteRT 형식으로 모델 내보내기 model.export(format="litert", imgsz=640) # 분류에는 imgsz=224 사용 # 내보낸 '.tflite' 모델은 LiteRT.js를 통해 브라우저에서 실행하거나 yolo predict/val을 사용해 로컬에서 실행할 수 있습니다.지원되는 내보내기 옵션에 관한 자세한 내용은 배포 옵션에 관한 Ultralytics 문서 페이지를 참조하세요.
YOLO26 모델을 TensorFlow.js로 내보내면 다음과 같은 여러 이점이 있습니다:
- 로컬 실행: 브라우저나 Node.js에서 모델을 직접 실행할 수 있어 지연 시간이 줄고 사용자 경험이 향상됩니다.
- 크로스 플랫폼 지원: TF.js는 여러 환경을 지원하므로 유연하게 배포할 수 있습니다.
- 오프라인 기능: 인터넷 연결 없이도 애플리케이션을 실행할 수 있어 안정성과 개인정보 보호를 보장합니다.
- GPU 가속: WebGL을 활용한 GPU 가속으로 리소스가 제한된 장치에서도 성능을 최적화합니다.
TensorFlow.js는 브라우저와 Node.js 환경에서 ML 모델을 효율적으로 실행하도록 특별히 설계되었습니다. 브라우저 기반 애플리케이션에 제공하는 이점은 다음과 같습니다:
- 지연 시간 감소: 머신러닝 모델을 로컬에서 실행하므로 서버 측 계산에 의존하지 않고 즉각적인 결과를 제공합니다.
- 개인정보 보호 강화: 민감한 데이터를 사용자의 장치에 보관하여 보안 위험을 최소화합니다.
- 오프라인 사용 지원: 인터넷 연결 없이도 모델을 실행할 수 있어 일관된 기능을 제공합니다.
- 다중 백엔드 지원: CPU, WebGL, WebAssembly(WASM), WebGPU 등의 백엔드를 제공하여 다양한 계산 요구 사항에 유연하게 대응합니다.
TF.js에 대해 더 알고 싶으신가요? TensorFlow.js 공식 가이드를 확인하세요.
TensorFlow.js의 주요 기능은 다음과 같습니다:
- 크로스 플랫폼 지원: TF.js는 웹 브라우저와 Node.js 모두에서 사용할 수 있어 폭넓은 배포 유연성을 제공합니다.
- 다중 백엔드: CPU, GPU 가속을 위한 WebGL, WebAssembly(WASM), 고급 작업을 위한 WebGPU를 지원합니다.
- 오프라인 기능: 인터넷 연결 없이 브라우저에서 모델을 직접 실행할 수 있어 반응성이 뛰어난 웹 애플리케이션 개발에 적합합니다.
배포 시나리오와 자세한 내용은 TensorFlow.js를 사용한 배포 옵션 섹션을 참조하세요.
예. TensorFlow.js를 사용하면 YOLO26 모델을 Node.js 환경에 배포할 수 있습니다. 이를 통해 서버의 처리 성능과 서버 측 데이터 액세스의 이점을 활용하는 서버 측 머신러닝 애플리케이션을 구축할 수 있습니다. 일반적인 사용 사례로는 실시간 데이터 처리와 백엔드 서버의 머신러닝 파이프라인이 있습니다.
Node.js 배포를 시작하려면 TensorFlow의 Node.js에서 TensorFlow.js 실행 가이드를 참조하세요.