모델 학습
Ultralytics Platform은 실험 구성부터 실시간 지표 스트리밍을 지원하는 클라우드 학습 작업 실행까지, YOLO 모델 학습을 위한 도구를 제공합니다.
시청: Ultralytics Platform 시작하기 - 학습
개요#
학습 섹션에서 다음을 수행할 수 있습니다.
- 손쉬운 관리를 위해 모델을 프로젝트별로 구성합니다
- 클라우드 GPU에서 클릭 한 번으로 학습합니다
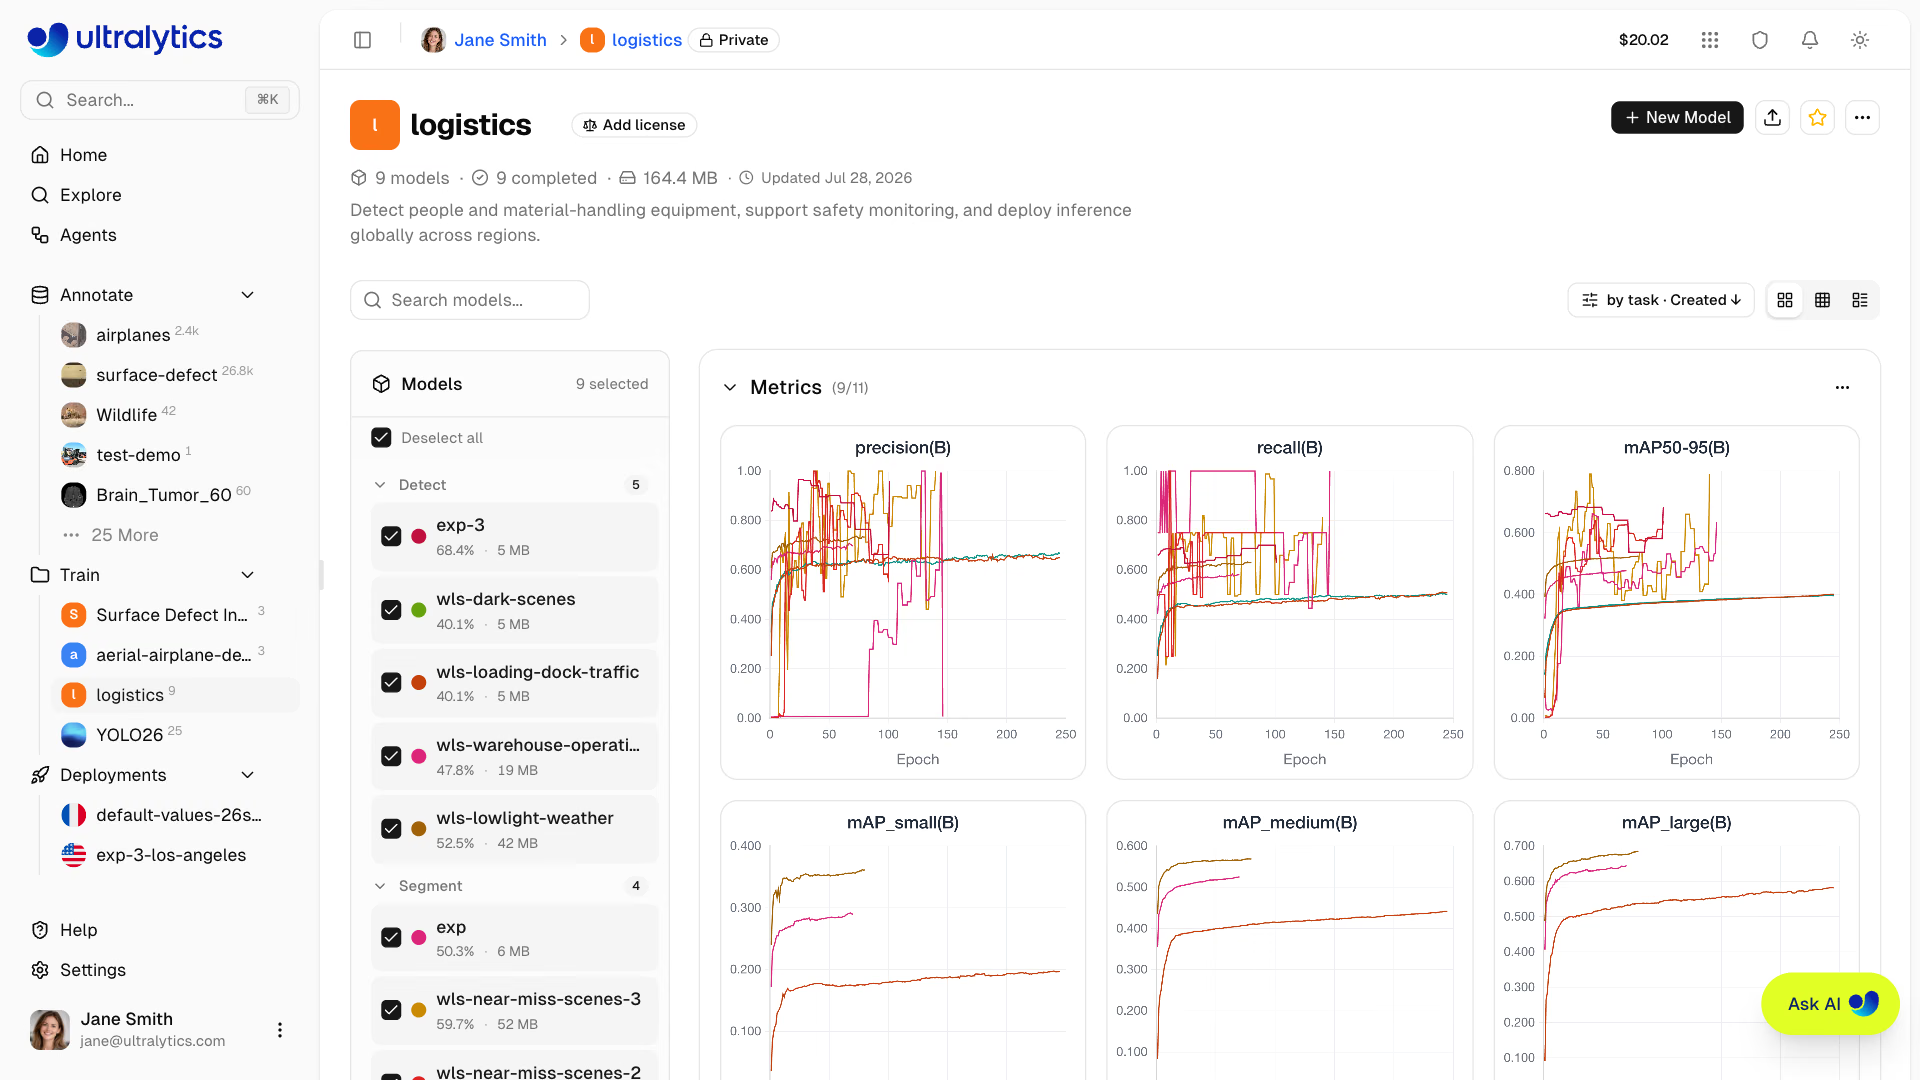
- 학습 중 실시간 메트릭을 모니터링합니다
- 실험 전반에서 모델 성능을 비교합니다
- 23가지 배포 형식으로 내보내기(지원되는 형식 참조)
워크플로#
| 단계 | 설명 |
|---|---|
| 프로젝트 | 관련 모델을 구성할 워크스페이스를 만듭니다 |
| 구성 | 데이터셋, 기본 모델, 학습 파라미터를 선택합니다 |
| 학습 | 클라우드 GPU 또는 로컬 하드웨어에서 실행합니다 |
| 모니터링 | 실시간 손실 곡선과 메트릭을 확인합니다 |
| 내보내기 | 23가지 배포 형식으로 변환(자세히 알아보기) |
학습 옵션#
Ultralytics Platform은 여러 학습 방식을 지원합니다.
| 메서드 | 설명 | 권장 용도 |
|---|---|---|
| 클라우드 학습 | Ultralytics Cloud GPU에서 학습합니다 | 로컬 GPU 불필요, 확장성 제공 |
| 로컬 학습 | 로컬에서 학습하고 메트릭을 플랫폼으로 스트리밍합니다 | 기존 하드웨어 활용, 개인정보 보호 |
| Colab 학습 | 플랫폼 통합 기능과 함께 Google Colab을 사용합니다 | 무료 GPU 액세스 |
RTX PRO 6000보다 저렴한 GPU를 선택하고 Ultralytics 관리 용량이 비어 있으면 Platform은 선택한 GPU의 시간당 요금으로 청구하면서 작업을 RTX PRO 6000에서 실행합니다. 실행을 더 빨리 완료하고 선택한 GPU에서 실행할 때보다 비용을 절감할 수 있습니다. 업그레이드로 인해 시간이 늘거나 비용이 추가되지는 않습니다.
GPU 옵션#
Ultralytics Cloud에서 클라우드 학습에 사용할 수 있는 GPU:
| GPU | 세대 | VRAM | 권장 용도 |
|---|---|---|---|
| RTX 2000 Ada | Ada | 16 GB | 소규모 데이터셋, 테스트 |
| RTX A4500 | Ampere | 20 GB | 소규모~중규모 데이터셋 |
| RTX A5000 | Ampere | 24 GB | 중규모 데이터셋 |
| RTX 4000 Ada | Ada | 20 GB | 중규모 데이터셋 |
| RTX 3090 | Ampere | 24 GB | 일반 학습 |
| RTX PRO 4000 | Blackwell | 24 GB | 저예산 Blackwell |
| L4 | Ada | 24 GB | 추론 최적화 |
| A40 | Ampere | 48 GB | 더 큰 배치 크기 |
| RTX A6000 | Ampere | 48 GB | 대형 모델 |
| RTX PRO 4500 | Blackwell | 32 GB | 뛰어난 가격 대비 성능 |
| L40 | Ada | 48 GB | 대형 모델 |
| RTX 4090 | Ada | 24 GB | 일반 학습 |
| RTX PRO 5000 | Blackwell | 48 GB | 대규모 배치 학습 |
| RTX 6000 Ada | Ada | 48 GB | 대규모 배치 학습 |
| L40S | Ada | 48 GB | 대규모 배치 학습 |
| RTX 5090 | Blackwell | 32 GB | 최신 소비자용 세대 |
| A100 PCIe | Ampere | 80 GB | 프로덕션 학습 |
| A100 SXM | Ampere | 80 GB | 프로덕션 학습 |
| RTX PRO 6000 | Blackwell | 96 GB | 기본 권장 옵션 |
| H100 PCIe | Hopper | 80 GB | 고성능 학습 |
| H100 NVL | Hopper | 94 GB | 최고 성능 |
| H200 NVL | Hopper | 143 GB | 최대 메모리 |
| H100 SXM | Hopper | 80 GB | 가장 빠른 학습 |
| H200 SXM | Hopper | 141 GB | 최고 성능 |
| B200 | Blackwell | 180 GB | 대형 모델(Pro+) |
| B300 | Blackwell | 288 GB | 최대 규모 모델(Pro+) |
현재 시간당 요금은 학습 대화상자의 GPU 선택기와 요금 페이지에 표시됩니다.
B200 및 B300 GPU를 사용하려면 Pro 또는 Enterprise 플랜이 필요합니다. 그 외 모든 GPU는 Free를 포함한 모든 플랜에서 사용할 수 있습니다.
신규 계정에는 학습용 가입 크레딧이 제공됩니다. 자세한 내용은 결제를 확인하세요.
실시간 메트릭#
모델의 Train 탭에서 실시간 지표와 사용 가능한 검증 결과를 확인하세요:
| 하위 탭 | 메트릭 |
|---|---|
| 메트릭 | 작업 지표(감지의 mAP50, mAP50-95, 정밀도, 재현율), 학습/검증 손실, 학습률 |
| 검증 | 사용 가능한 경우 기록된 검증 그래프 및 이미지별 분석 |
| 콘솔 | ANSI 색상과 자동 오류 감지 기능을 지원하는 실시간 학습 로그 |
| 시스템 | GPU 사용률, GPU 메모리 및 온도, CPU, RAM, 네트워크 및 디스크 I/O |
최고 체크포인트(최고 fitness를 기록한 에포크인 best.pt)는 학습 실행 중 주기적으로 Platform에 업로드되며 실행 종료 시에도 다시 업로드됩니다. 따라서 다운로드, 내보내기, 배포에는 항상 지금까지 생성된 최적의 에포크가 사용됩니다. 취소된 실행은 업로드가 완료된 마지막 체크포인트를 유지합니다.
빠른 시작#
1분 이내에 클라우드 학습을 시작할 수 있습니다.
- 사이드바에서 프로젝트를 만듭니다
- New Model을 클릭합니다
- 모델, 데이터셋, GPU를 선택합니다
- Start Training을 클릭합니다
빠른 링크#
- 프로젝트: 모델과 실험을 구성합니다
- 모델: 학습된 체크포인트를 관리합니다
- 클라우드 학습: 클라우드 GPU에서 학습합니다
- AutoTrain: Ask AI를 사용해 실험을 실행하고 모델을 비교합니다
자주 묻는 질문#
학습 시간은 다음에 따라 달라집니다.
- 데이터셋 크기(이미지 수)
- 모델 크기(n, s, m, l, x)
- 에포크 수
- 선택한 GPU 유형
현재 예상치에 따르면 RTX PRO 6000에서 이미지 1000개, YOLO26n, 100 epochs를 학습하는 데 약 6분이 소요되며, RTX 4090에서 이미지 500개, YOLO26n, 50 epochs를 학습하는 데 약 2분이 소요됩니다. 실제 소요 시간은 달라질 수 있으므로, 선택한 데이터셋과 구성에 대한 실시간 예상치를 학습 대화상자에서 확인하세요.
예. 동시 클라우드 학습 한도는 플랜에 따라 다릅니다. Free는 3개, Pro는 10개를 허용하며 Enterprise는 제한이 없습니다. 추가 병렬 학습이 필요하다면 여러 머신에서 원격 학습을 사용하세요.
학습에 실패하면 다음과 같이 처리됩니다.
- 모델이 실패로 표시되고 컴퓨팅 인스턴스가 종료됩니다
- 모델 페이지에는 캡처된 오류가 포함된 오류 배너, 콘솔 출력 링크, AI로 진단 및 Retry Training 작업(Editor 역할 이상)이 표시됩니다. 이 작업을 선택하면 동일한 구성으로 학습 대화상자가 다시 열립니다.
- 4시간 동안 활동 보고가 없는 실행은 자동으로 실패로 표시되고 해당 컴퓨팅 리소스가 해제됩니다
- 클라우드 컴퓨팅이 시작된 경우 경과된 GPU 사용 시간이 청구되며, 컴퓨팅 시작 전에 발생한 실패에는 GPU 사용 요금이 부과되지 않습니다
시나리오 권장 GPU 대부분의 학습 작업 RTX PRO 6000 대규모 데이터셋 또는 배치 크기 H100 SXM 또는 H200 비용 절감 중시 RTX 4090


댓글
질문을 하거나 결과를 공유하거나 다른 사람을 도와주세요.