Implantação
A Ultralytics Platform oferece várias opções de implementação de modelos para colocares os teus modelos YOLO em produção. Testa modelos com inferência no navegador, implementa-os em endpoints dedicados distribuídos por 42 regiões globais e acompanha o desempenho dos endpoints em tempo real.
Assista: Comece a usar a plataforma Ultralytics: implantação
Visão geral#
A seção Implantação ajuda você a:
- Testar modelos diretamente no navegador usando a aba
Predict - Implantar em endpoints dedicados em 42 regiões do mundo
- Monitorar métricas de solicitações, registros, verificações de integridade e previsões temporárias em cada endpoint dedicado
- Escolher recursos: os endpoints padrão reduzem a escala a zero; os tamanhos personalizados mantêm uma instância ativa com cobrança pelo tempo de atividade
Opções de implantação#
A Ultralytics Platform oferece vários caminhos de implantação:
| Opção | Descrição | Ideal para |
|---|---|---|
| Aba Predict | Imagem, webcam, exemplos; câmara IP nos teus próprios endpoints | Desenvolvimento, validação |
| Inferência compartilhada | Serviço multi-inquilino em 3 regiões de dados | Uso leve, testes |
| Endpoints dedicados | Serviços de inquilino único em 42 regiões | Produção, baixa latência |
| Exportação | Baixe pesos nos 23 formatos para execução local ou na borda | Off-line, no dispositivo |
Fluxo de trabalho#
| Estágio | Descrição |
|---|---|
| Teste | Valide o modelo usando a aba Predict |
| Configurar | Selecione um modelo, uma região, uma CPU e a memória; confira os preços e o nome da implantação |
| Implantar | Crie um endpoint dedicado na aba Deploy |
| Monitorar | Inspecione as métricas do endpoint e as previsões temporárias em Monitoramento |
Arquitetura#
Inferência compartilhada#
O serviço de inferência compartilhada funciona em 3 regiões principais. As solicitações a um modelo são encaminhadas ao serviço na sua região de dados, para que os resultados permaneçam na região onde o modelo está armazenado:
| Região | Rótulo | Localização | Ideal para |
|---|---|---|---|
| US | Américas | Iowa, EUA | Usuários das Américas; menor latência para as Américas |
| EU | Europa, Oriente Médio e África | Bélgica, Europa | Usuários europeus; conformidade com o GDPR |
| AP | Ásia-Pacífico | Taiwan, Ásia-Pacífico | Usuários da Ásia-Pacífico; menor latência na região APAC |
Endpoints dedicados#
Implante em 42 regiões do mundo na Ultralytics Cloud:
- Américas: 14 regiões
- Europa: 13 regiões
- Ásia-Pacífico: 12 regiões
- Oriente Médio e África: 3 regiões
Cada endpoint é um serviço de inquilino único com:
- CPU e memória configuráveis, com preços exibidos antes da implantação
- Redução da escala a zero para recursos padrão; instância ativa com cobrança pelo tempo de atividade para recursos personalizados
- URL de endpoint exclusiva com referência interativa da API própria em
/docs - Vinculação à própria chave de API, para que somente essa chave possa chamar o endpoint
- Monitoramento, registros e verificações de integridade independentes
Aba Deployments#
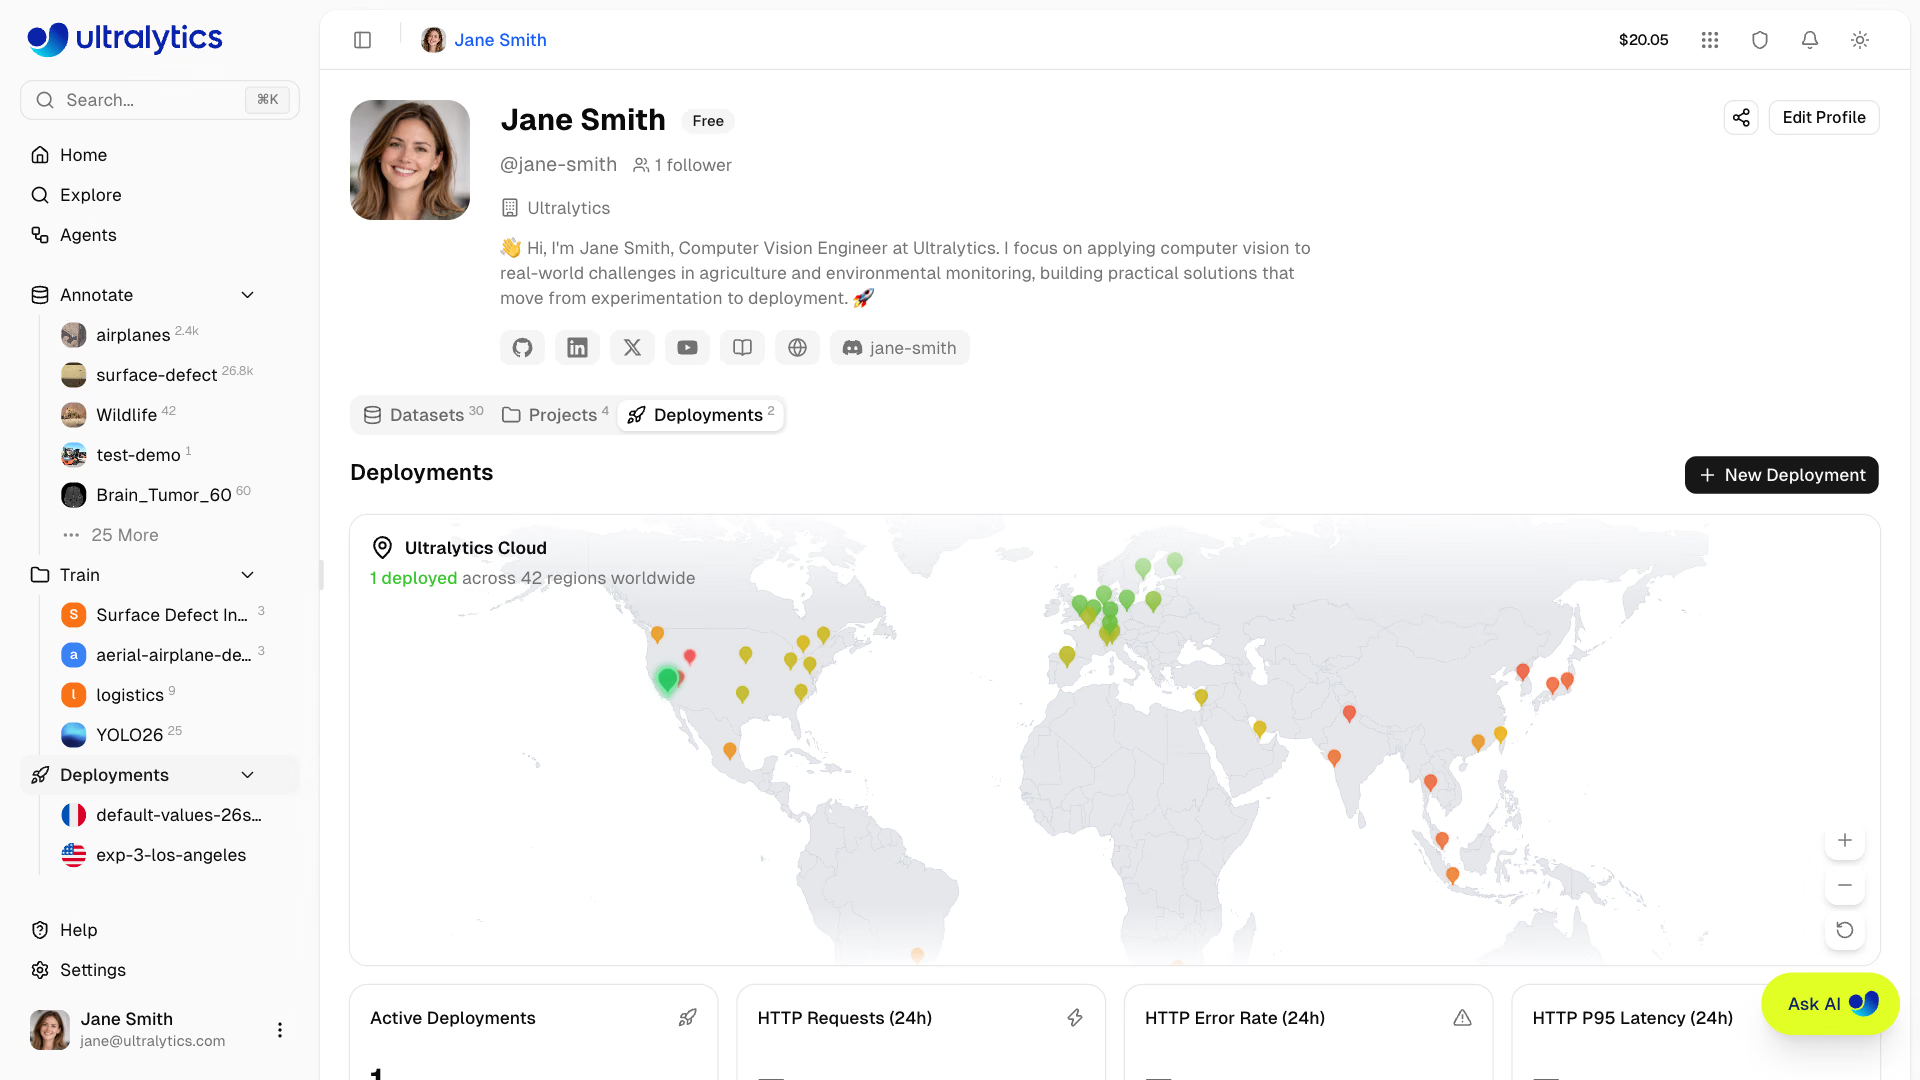
Todas as suas implantações aparecem na aba Deployments do seu perfil (/{username}?tab=deployments), ao lado de Datasets e Projects. A seção Deployments da barra lateral lista suas implantações, cada uma com um link para sua página, um botão + para criar uma implantação e um link para a aba completa. A aba mostra:
- Mapa-múndi com marcadores das regiões implantadas; clique em uma região para abrir a caixa de diálogo
New Deployment - Cartões de visão geral: implantações ativas, solicitações HTTP (24 h), taxa de erros HTTP (24 h), latência HTTP P95 (24 h)
- Lista de implantações com pesquisa, classificação e três modos de visualização: cartões, compacta e tabela; cada implantação tem um link para sua própria página, com as abas
Overview,Monitoring,PredicteLogs - Botão Nova implantação para criar endpoints a partir de qualquer modelo concluído
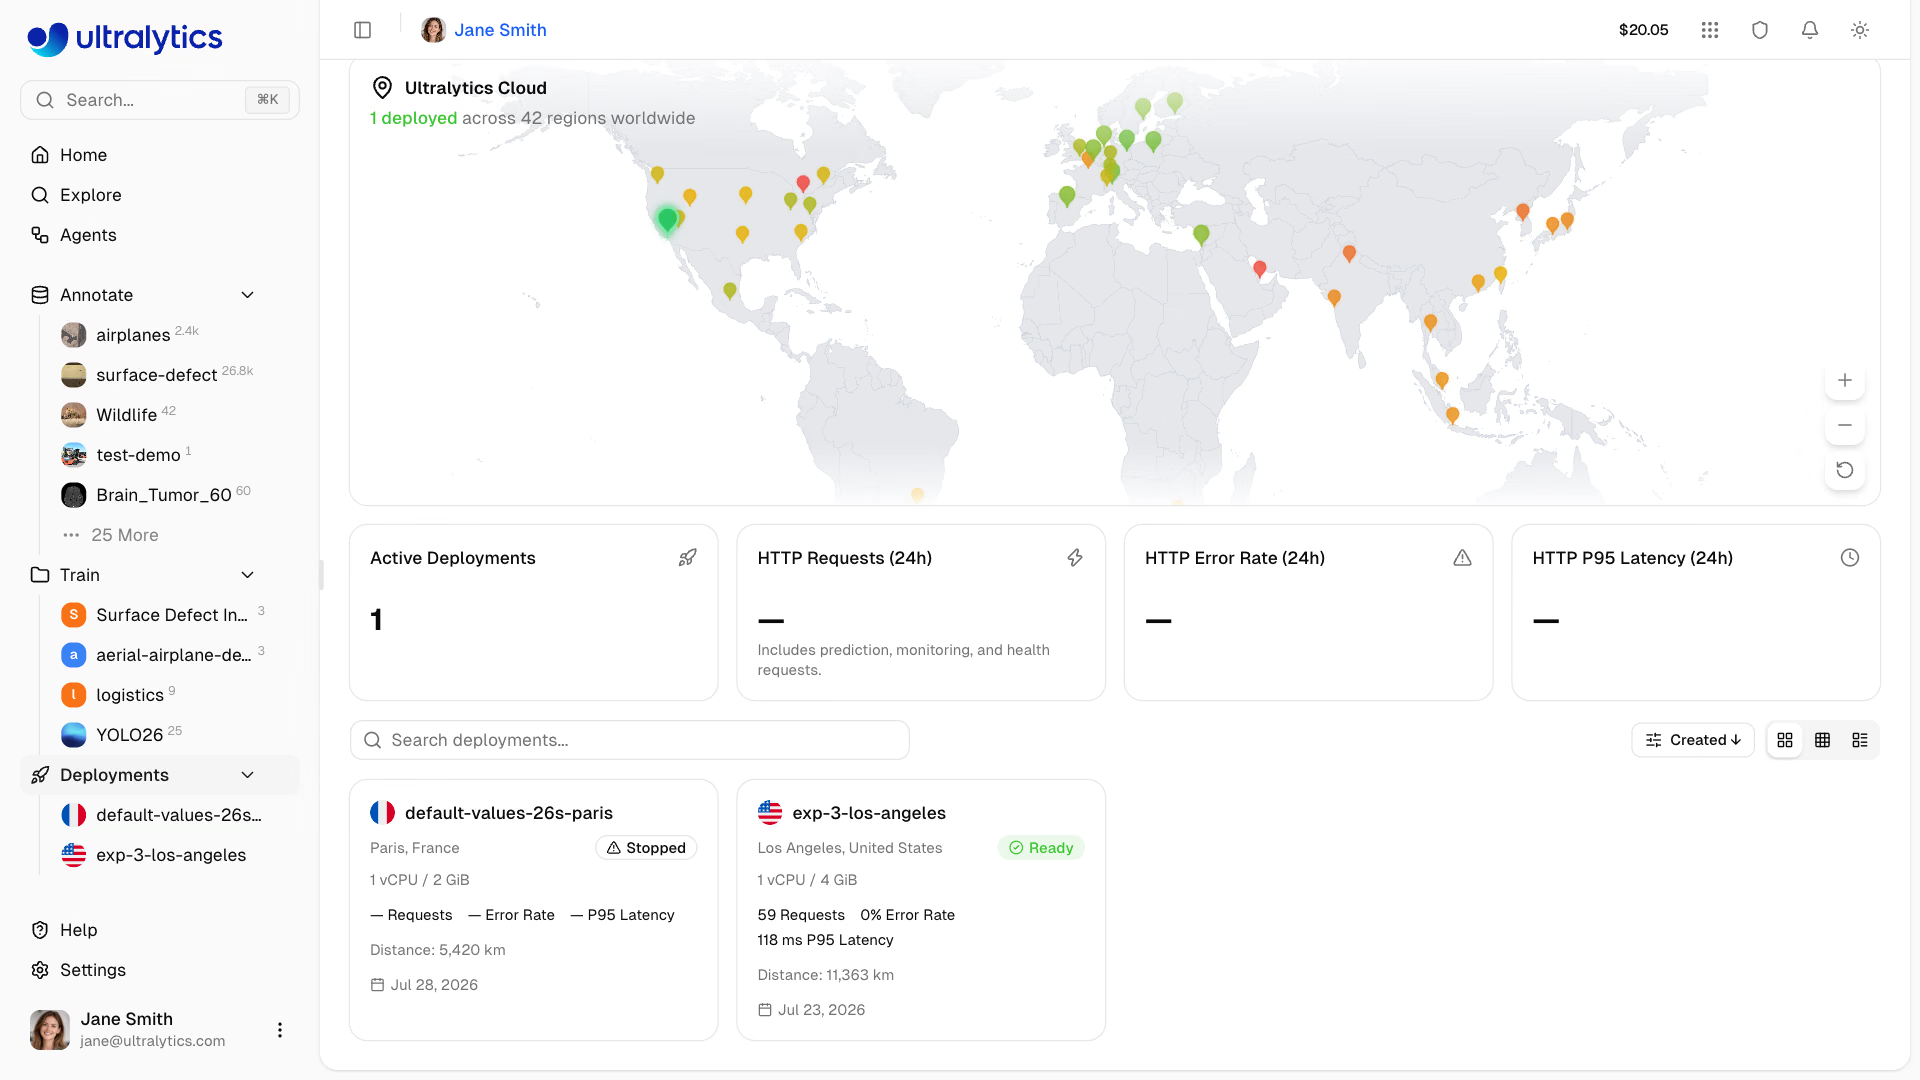
A aba é atualizada automaticamente e com mais frequência enquanto uma implantação está mudando de estado (creating, deploying ou stopping). Consulte Monitoramento para mais detalhes.
Cada endpoint dedicado pronto oferece gráficos e imagens de exemplo armazenados apenas na memória da instância de serviço. Parar, reiniciar, implantar novamente, redimensionar ou substituir o modelo pode apagar esses dados. Salve os exemplos em um conjunto de dados e aguarde a conclusão da ingestão para mantê-los. Consulte Monitoramento.
Principais funcionalidades#
Cobertura global#
Implante perto dos seus usuários com 42 regiões que abrangem:
- América do Norte, América do Sul
- Europa, Oriente Médio, África
- Ásia-Pacífico, Oceania
Comportamento de escalabilidade#
Atualmente, os endpoints funcionam da seguinte forma:
- Recursos padrão: endpoints ociosos reduzem a escala a zero e iniciam a frio na próxima solicitação
- Recursos personalizados: uma instância permanece ativa e acumula cobranças pelo tempo de atividade até ser parada
- Uma única instância ativa: atualmente, cada endpoint atende a todas as solicitações a partir de uma única instância, em todos os planos
- Limitação de carga: as solicitações recebem respostas
429quando o endpoint está temporariamente no limite da capacidade — consulte Solicitações diretas a endpoints - Tempo limite da solicitação: as solicitações diretas ao endpoint têm duração máxima de 1 hora; consulte Inferência para ver as entradas compatíveis
Implantação regional#
Usa a latência medida por região para posicionar um endpoint perto dos respetivos clientes. A latência de inferência real depende do modelo, do tamanho da entrada, do estado do endpoint e do percurso da rede.
Verificações de integridade#
Cada implantação em execução inclui uma verificação automática de integridade com:
- Indicador de status em tempo real (saudável/não saudável)
- Exibição da latência de resposta
- Nova tentativa automática quando não está saudável, interrompida assim que fica saudável
- Botão para verificar novamente manualmente
Início rápido#
Criar uma implantação:
- Treine ou carregue um modelo em um projeto
- Acede ao separador Deploy do modelo
- Clica em Deploy para uma região na tabela de latência
- Revê a CPU, a memória, o preço e o nome na caixa de diálogo de implementação
- Clica em Create Deployment e aguarda até o estado da implementação passar a Ready
Model → Deploy tab → Deploy in a region → Review configuration → Create DeploymentO nome da implementação é gerado a partir do nome do modelo e da cidade da região, e pode ser editado antes da implementação. Depois da implementação, usa o URL do endpoint com a tua chave de API para enviar pedidos de inferência a partir de qualquer aplicação.
Links rápidos#
- Inferência: testa modelos no browser
- Endpoints: implementa endpoints dedicados
- Monitoramento: acompanhe o desempenho das implantações
Perguntas frequentes#
Compartilhe a página do modelo, não uma implantação. Quando o projeto do modelo é público, qualquer pessoa com o link pode executar o modelo pela aba
Predictno navegador, sem precisar de conta ou chave de API: abra a abaPredicte clique em Compartilhar > Copiar link. As previsões anônimas são limitadas por taxa por endereço IP. As páginas de implantação são visíveis apenas para o seu espaço de trabalho, e um endpoint dedicado aceita apenas a chave de API vinculada a ele.A implementação permanece no estado de criação ou implementação enquanto o serviço é iniciado. Fica disponível quando o estado passa a Ready; o tempo varia consoante o modelo e a região e, normalmente, demora alguns minutos.
Sim, cada modelo pode ter vários endpoints em regiões diferentes. O número de implementações é limitado pelo plano: Free
3, Pro10, Enterpriseunlimited. A quota é cobrada ao espaço de trabalho que detém o modelo, e cada endpoint serve exatamente um modelo de cada vez — usa a substituição de modelo para o trocar sem alterar o URL.Os endpoints com recursos predefinidos reduzem a zero quando ficam inativos:
- O endpoint reduz a capacidade após um período de inatividade
- O primeiro pedido inicia um arranque a frio
- Os pedidos seguintes são rápidos
Os primeiros pedidos após um período de inatividade iniciam um arranque a frio. Abrir a página de implementação executa uma verificação de integridade que mantém o endpoint ativo, para que uma previsão de teste seja rápida logo a seguir.
Os endpoints com recursos personalizados permanecem ativos e são cobrados pelo tempo de atividade, incluindo o tempo de inatividade. Para interromper a cobrança pelo tempo de atividade, para o endpoint.


Comentários
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.