Treinamento de modelos
A Ultralytics Platform oferece ferramentas para treinar modelos YOLO, desde a organização de experiências até à execução de tarefas de treino na cloud com transmissão de métricas em tempo real.
Assista: Comece a usar a plataforma Ultralytics: treinamento
Visão geral#
A seção Treinamento ajuda você a:
- Organizar modelos em projetos para facilitar o gerenciamento
- Treinar em GPUs na nuvem com um único clique
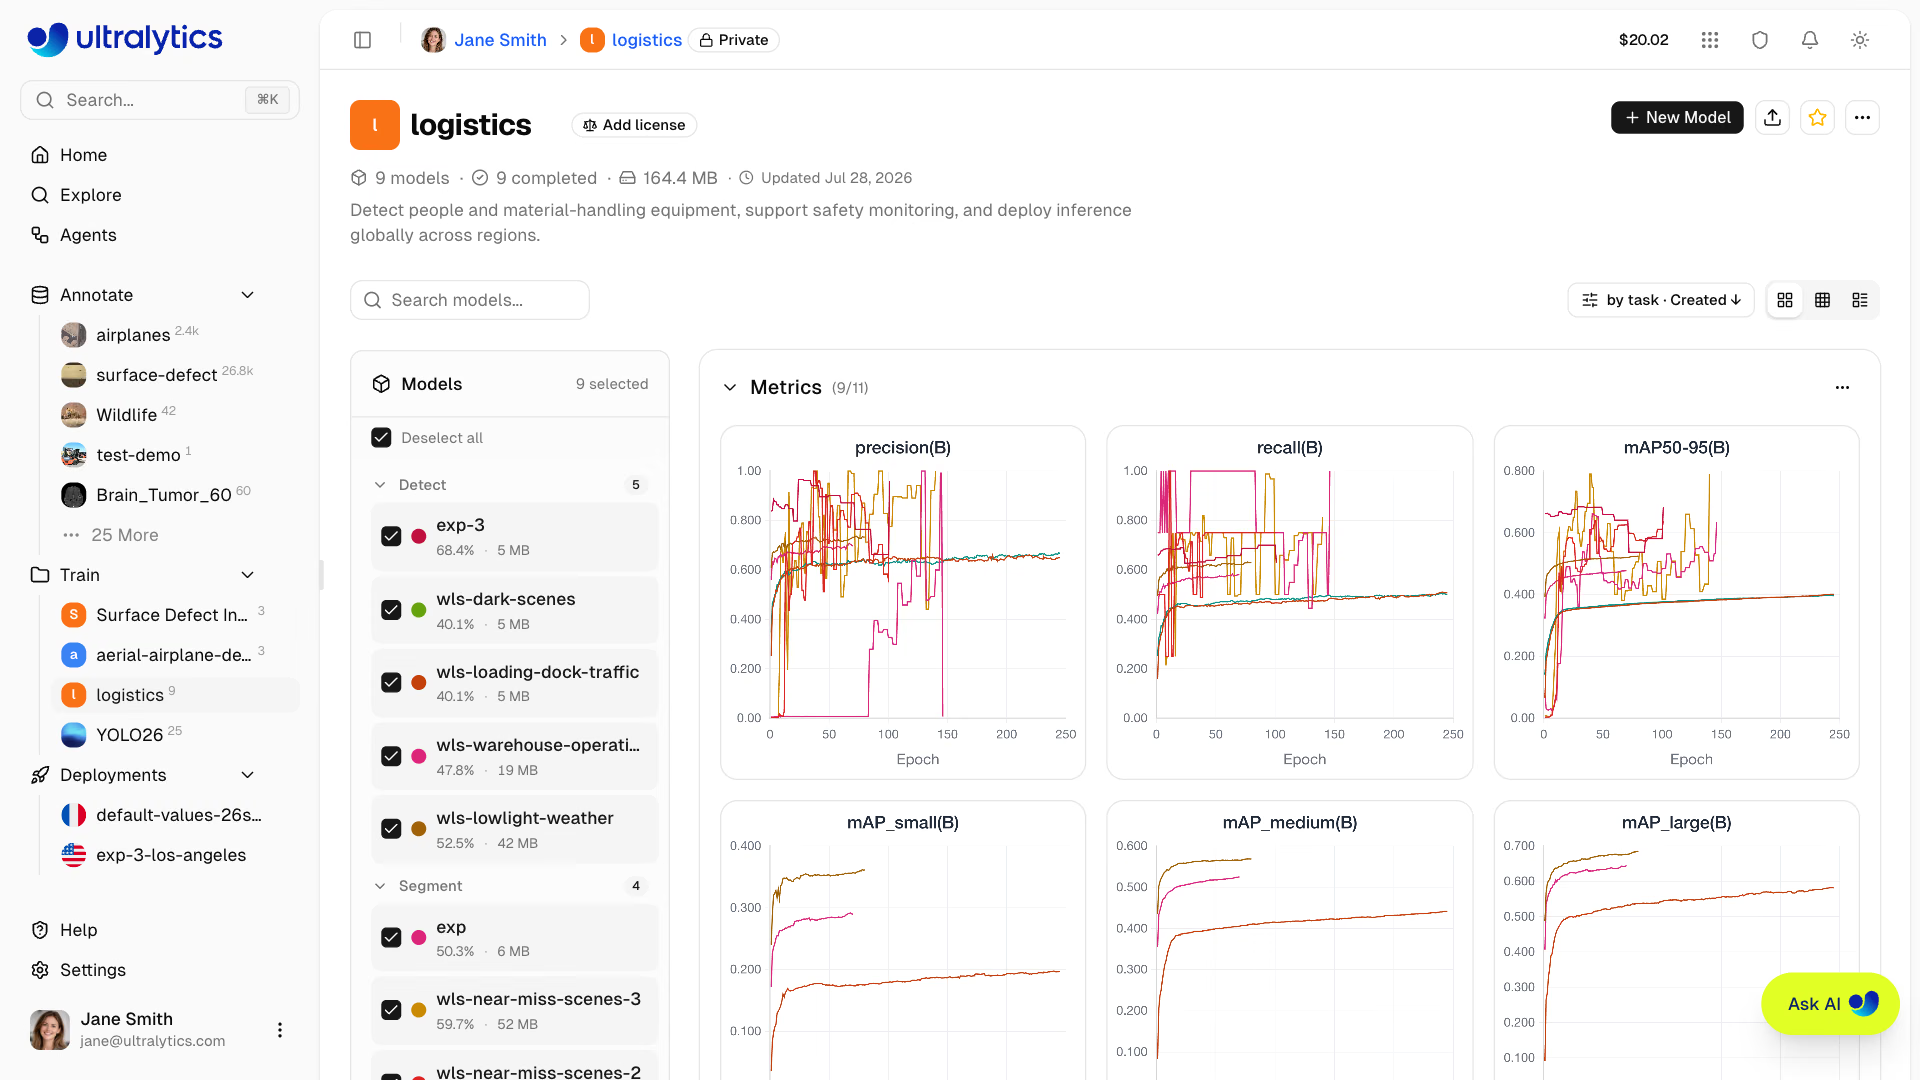
- Monitorar métricas em tempo real durante o treinamento
- Comparar o desempenho dos modelos entre experimentos
- Exporte para 23 formatos de implantação (consulte formatos compatíveis)
Fluxo de trabalho#
| Estágio | Descrição |
|---|---|
| Projeto | Crie um espaço de trabalho para organizar modelos relacionados |
| Configurar | Selecione o conjunto de dados, o modelo base e os parâmetros de treinamento |
| Treinar | Execute em GPUs na nuvem ou no seu hardware local |
| Monitorar | Veja curvas de perda e métricas em tempo real |
| Exportar | Converta para 23 formatos de implantação (detalhes) |
Opções de treinamento#
A Ultralytics Platform é compatível com várias abordagens de treinamento:
| Método | Descrição | Ideal para |
|---|---|---|
| Treinamento na nuvem | Treine nas GPUs da Ultralytics Cloud | Sem GPU local, com escalabilidade |
| Treinamento local | Treine localmente e transmita métricas para a plataforma | Hardware existente, privacidade |
| Treinamento no Colab | Use o Google Colab com integração à plataforma | Acesso gratuito a GPU |
Quando você seleciona uma GPU mais barata que a RTX PRO 6000 e há capacidade gerenciada pela Ultralytics disponível, a Platform executa sua tarefa em uma RTX PRO 6000, mas cobra a tarifa por hora da GPU selecionada. As execuções podem terminar mais rápido e custar menos do que custariam na GPU selecionada — a atualização nunca aumenta o tempo nem o custo.
Opções de GPU#
GPUs disponíveis para treinamento na nuvem da Ultralytics Cloud:
| GPU | Geração | VRAM | Ideal para |
|---|---|---|---|
| RTX 2000 Ada | Ada | 16 GB | Conjuntos de dados pequenos, testes |
| RTX A4500 | Ampere | 20 GB | Conjuntos de dados pequenos e médios |
| RTX A5000 | Ampere | 24 GB | Conjuntos de dados médios |
| RTX 4000 Ada | Ada | 20 GB | Conjuntos de dados médios |
| RTX 3090 | Ampere | 24 GB | Treinamento geral |
| RTX PRO 4000 | Blackwell | 24 GB | Blackwell econômica |
| L4 | Ada | 24 GB | Otimizada para inferência |
| A40 | Ampere | 48 GB | Tamanhos de lote maiores |
| RTX A6000 | Ampere | 48 GB | Modelos grandes |
| RTX PRO 4500 | Blackwell | 32 GB | Ótima relação preço/desempenho |
| L40 | Ada | 48 GB | Modelos grandes |
| RTX 4090 | Ada | 24 GB | Treinamento geral |
| RTX PRO 5000 | Blackwell | 48 GB | Treinamento com lotes grandes |
| RTX 6000 Ada | Ada | 48 GB | Treinamento com lotes grandes |
| L40S | Ada | 48 GB | Treinamento com lotes grandes |
| RTX 5090 | Blackwell | 32 GB | Geração mais recente para consumidores |
| A100 PCIe | Ampere | 80 GB | Treinamento em produção |
| A100 SXM | Ampere | 80 GB | Treinamento em produção |
| RTX PRO 6000 | Blackwell | 96 GB | Padrão recomendado |
| H100 PCIe | Hopper | 80 GB | Treinamento de alto desempenho |
| H100 NVL | Hopper | 94 GB | Desempenho máximo |
| H200 NVL | Hopper | 143 GB | Memória máxima |
| H100 SXM | Hopper | 80 GB | Treinamento mais rápido |
| H200 SXM | Hopper | 141 GB | Desempenho máximo |
| B200 | Blackwell | 180 GB | Modelos grandes (Pro+) |
| B300 | Blackwell | 288 GB | Os maiores modelos (Pro+) |
Os preços atuais por hora são exibidos no seletor de GPU da janela de treinamento e na página de preços.
As GPUs B200 e B300 exigem um plano Pro ou Enterprise. Todas as outras GPUs estão disponíveis em todos os planos, inclusive no Free.
Novas contas recebem créditos de cadastro para treinamento. Consulte Faturamento para ver os detalhes.
Métricas em tempo real#
No separador Treino do modelo, consulta as métricas em tempo real e os resultados de validação disponíveis:
| Subaba | Métricas |
|---|---|
| Métricas | Métricas da tarefa (mAP50, mAP50-95, precisão, revocação para detecção), perdas de treino/validação, taxa de aprendizado |
| Validação | Gráficos de validação registados e análise por imagem, quando disponíveis |
| Console | Registros de treinamento ao vivo com cores ANSI e detecção automática de erros |
| Sistema | Utilização da GPU, memória e temperatura da GPU, CPU, RAM, rede e E/S de disco |
O melhor ponto de verificação (best.pt, a época com o maior fitness) é enviado periodicamente para a Platform enquanto o treinamento está em execução e novamente quando a execução termina. Assim, o download, a exportação e a implantação sempre usam a melhor época produzida até então. As execuções canceladas mantêm o último ponto de verificação cujo envio foi concluído.
Início rápido#
Comece a treinar na nuvem em menos de um minuto:
- Crie um projeto na barra lateral
- Clique em New Model
- Selecione um modelo, um conjunto de dados e uma GPU
- Clique em Start Training
Links rápidos#
- Projetos: organize seus modelos e experimentos
- Modelos: gerencie pontos de verificação treinados
- Treinamento na nuvem: treine em GPUs na nuvem
- AutoTrain: use o Ask AI para executar experimentos e comparar modelos
Perguntas frequentes#
O tempo de treinamento depende de:
- Tamanho do conjunto de dados (número de imagens)
- Tamanho do modelo (n, s, m, l, x)
- Número de épocas
- Tipo de GPU selecionada
O estimador atual prevê cerca de 6 minutos para 1000 imagens, YOLO26n e 100 épocas na RTX PRO 6000, e cerca de 2 minutos para 500 imagens, YOLO26n e 50 épocas na RTX 4090. A duração real varia; consulta a estimativa em tempo real na janela de treinamento para o conjunto de dados e a configuração selecionados.
Sim. Os limites de treinamento simultâneo na nuvem dependem do seu plano: o Free permite 3, o Pro permite 10 e o Enterprise é ilimitado. Para executar mais treinamentos em paralelo, use o treinamento remoto em várias máquinas.
Se o treinamento falhar:
- O modelo é marcado como com falha e a instância de computação é encerrada
- A página do modelo apresenta uma faixa de erro com o erro capturado, um link para a saída da consola e as ações Diagnosticar com IA e Tentar novamente o treino (função de Editor ou superior), que volta a abrir a caixa de diálogo de treino com a mesma configuração
- Uma execução que não informar atividade por 4 horas é marcada automaticamente como com falha e seus recursos de computação são liberados
- Se a computação na nuvem tiver sido iniciada, o tempo de GPU decorrido será cobrado; falhas ocorridas antes do início da computação não geram cobranças pelo uso da GPU
Cenário GPU recomendada A maioria das tarefas de treinamento RTX PRO 6000 Conjuntos de dados ou tamanhos de lote grandes H100 SXM ou H200 Prioridade ao orçamento RTX 4090


Comentários
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.