Экспорт в Intel OpenVINO#
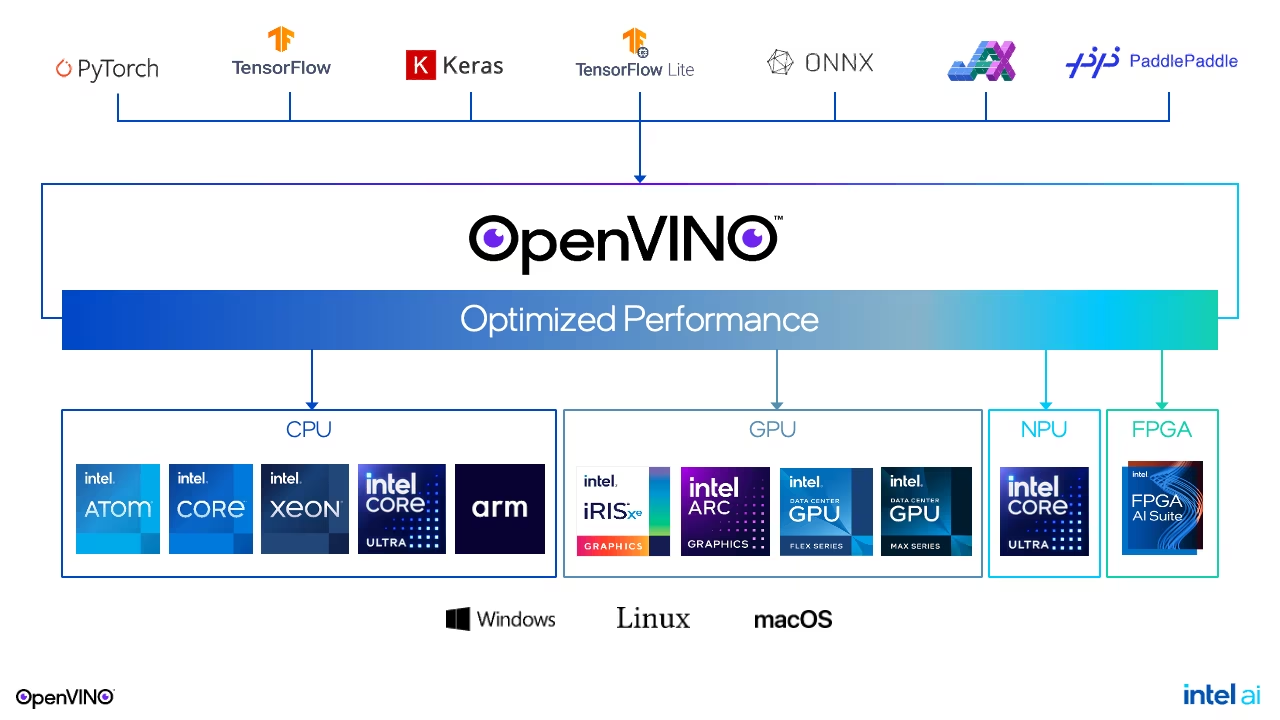
В этом руководстве мы расскажем, как экспортировать модели YOLO26 в формат OpenVINO, который может ускорить вычисления на CPU до 3 раз, а также ускорить инференс YOLO на оборудовании Intel с GPU и NPU.
OpenVINO, сокращение от Open Visual Inference & Neural Network Optimization toolkit, — это комплексный набор инструментов для оптимизации и развёртывания моделей инференса ИИ. Несмотря на слово Visual в названии, OpenVINO также поддерживает другие задачи, включая обработку языка, аудио, временных рядов и т. д.
Смотри: Как экспортировать Ultralytics YOLO26 в формат Intel OpenVINO для ускорения инференса 🚀
Поддерживаемые задачи#
Экспорт в OpenVINO поддерживает все семь задач Ultralytics. Семантическая сегментация и оценка глубины доступны только в YOLO26 — единственном семействе, в котором предусмотрены соответствующие выходные блоки.
| Задача | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Обнаружение | ✅ | ✅ | ✅ |
| Сегментация | ✅ | ✅ | ✅ |
| Семантическая сегментация | ❌ | ❌ | ✅ |
| Глубина | ❌ | ❌ | ✅ |
| Классификация | ✅ | ✅ | ✅ |
| Оценка позы | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Установка#
Установи зависимости для экспорта в OpenVINO:
pip install "ultralytics[export-openvino]"Эти зависимости также входят в ultralytics[export] и устанавливаются автоматически, когда нужны для экспорта.
Примеры использования#
Формат OpenVINO поддерживает режимы Export, Predict и Validate. Экспортируй модель, затем загрузи её, чтобы выполнить инференс или проверить точность на CPU, встроенном или дискретном GPU либо NPU Intel.
from ultralytics import YOLO

# Загрузи модель YOLO26
model = YOLO("yolo26n.pt")

# Экспортировать модель в формат OpenVINO
model.export(format="openvino") # creates 'yolo26n_openvino_model/'from ultralytics import YOLO
# Загрузи экспортированную модель OpenVINO
model = YOLO("yolo26n_openvino_model/")
# Выполнить инференс
results = model("https://ultralytics.com/images/bus.jpg")
# Выполни инференс на указанном устройстве; доступны устройства: ["intel:gpu", "intel:npu", "intel:cpu"]
results = model("https://ultralytics.com/images/bus.jpg", device="intel:gpu")from ultralytics import YOLO
# Загрузи экспортированную модель OpenVINO
model = YOLO("yolo26n_openvino_model/")
# Проверить точность на наборе данных COCO8
metrics = model.val(data="coco8.yaml")Аргументы экспорта#
| Аргумент | Тип | По умолчанию | Описание |
|---|---|---|---|
format | str | 'openvino' | Целевой формат экспортируемой модели, определяющий совместимость с различными средами развертывания. |
imgsz | int или tuple | 640 | Заданный размер изображения на входе модели. Можно указать целое число для квадратных изображений или кортеж (height, width) для конкретных размеров. |
quantize | int или str | None | Точность квантования: 16 (FP16) или 8 (INT8/PTQ; требуется калибровка data/fraction); 32/неуказанное значение соответствует FP32. Заменяет устаревшие флаги half/int8. |
dynamic | bool | False | Позволяет использовать динамические размеры входных данных, повышая гибкость при обработке изображений разных размеров. |
nms | bool, необязательно | None | Выбери необработанный выход (None, по умолчанию), встроенный NMS (True) или голову без NMS (False). |
batch | int | 1 | Задаёт размер пакета изображений для инференса экспортированной модели или максимальное количество изображений, которые экспортированная модель будет обрабатывать одновременно в режиме predict. |
data | str | None | Путь к YAML-файлу набора данных, необходимому для квантования; для классификации вместо него укажи каталог набора данных или название встроенного набора данных. Если не указать этот параметр вместе с quantize=8, Ultralytics выберет набор данных для калибровки по умолчанию для соответствующей задачи модели. |
fraction | float, int или list | 1.0 | Подмножество для калибровки, заданное как доля, количество изображений или [train, val, test] отношения/количества. Если список содержит два элемента, test остаётся без изменений, а 0 пропускает его. |
device | str | None | Указывает устройство для экспорта: CPU (device=cpu), MPS для Apple silicon (device=mps). |
Подробнее о процессе экспорта смотри на странице документации Ultralytics об экспорте.
OpenVINO™ совместим с большинством процессоров Intel®, но для оптимальной работы:
-
Проверь поддержку OpenVINO™ Узнай, поддерживается ли твой чип Intel® официально в OpenVINO™, с помощью списка совместимости Intel.
-
Определи тип ускорителя Проверь, есть ли в процессоре встроенный NPU (нейронный процессор) или GPU (встроенный GPU), воспользовавшись руководством Intel по оборудованию.
-
Установи последние версии драйверов Если твой чип поддерживает NPU или GPU, но OpenVINO™ не обнаруживает его, возможно, нужно установить или обновить соответствующие драйверы. Следуй инструкциям по установке драйверов, чтобы задействовать аппаратное ускорение в полной мере.
Выполнив эти три шага, ты обеспечишь оптимальную работу OpenVINO™ на оборудовании Intel®.
Преимущества OpenVINO#
- Производительность: OpenVINO обеспечивает высокую скорость инференса, используя возможности CPU, встроенных и дискретных GPU, а также FPGA Intel.
- Поддержка гетерогенного выполнения: OpenVINO предоставляет API, позволяющий один раз написать код и развернуть его на любом поддерживаемом оборудовании Intel (CPU, GPU, FPGA, VPU и т. д.).
- Оптимизатор моделей: OpenVINO предоставляет оптимизатор моделей, который импортирует, преобразует и оптимизирует модели из популярных фреймворков глубокого обучения, таких как PyTorch, TensorFlow, TensorFlow Lite, Keras, ONNX, PaddlePaddle и Caffe.
- Простота использования: в комплект входит большая коллекция учебных ноутбуков, в том числе ноутбук по оптимизации YOLO26, которые знакомят с различными возможностями набора инструментов.
Структура экспорта OpenVINO#
При экспорте модели в формат OpenVINO создаётся каталог со следующими файлами:
- Файл XML: описывает топологию сети.
- Файл BIN: содержит двоичные данные весов и смещений.
- Файл метаданных:
metadata.yamlсодержит метаданные модели, такие как названия классов, размер изображения и задача; Ultralytics считывает их при загрузке модели.
Эти файлы можно использовать для выполнения инференса с помощью OpenVINO Runtime.
Использование экспорта OpenVINO при развёртывании#
После успешного экспорта модели в формат OpenVINO у тебя есть два основных способа выполнить инференс:
-
Используй пакет
ultralytics: он предоставляет API высокого уровня и обёртку над OpenVINO Runtime. -
Для более гибкого управления поведением инференса используй нативный пакет
openvino.
Инференс с Ultralytics#
Пакет ultralytics позволяет легко выполнять инференс с экспортированной моделью OpenVINO с помощью метода predict. Также можно указать целевое устройство (например, intel:gpu, intel:npu, intel:cpu) с помощью аргумента device.
from ultralytics import YOLO

# Загрузи экспортированную модель OpenVINO
ov_model = YOLO("yolo26n_openvino_model/")  # путь к экспортированной модели OpenVINO
# Выполни инференс с экспортированной моделью
ov_model.predict(device="intel:gpu")  # укажи устройство, на котором нужно выполнить инференс
Этот подход отлично подходит для быстрого прототипирования или развёртывания, когда полный контроль над конвейером инференса не требуется.
Инференс с OpenVINO Runtime#
OpenVINO Runtime предоставляет единый API для инференса на всех поддерживаемых устройствах Intel. Он также предлагает расширенные возможности, например балансировку нагрузки между устройствами Intel и асинхронное выполнение. Дополнительные сведения о запуске инференса смотри в ноутбуках YOLO26.
Помни: для правильной настройки модели и работы с ней в Runtime тебе понадобятся файлы XML и BIN, а также параметры приложения, например размер входных данных, коэффициент масштабирования для нормализации и т. д.
В приложении для развёртывания обычно выполняют следующие шаги:
- Инициализируй OpenVINO, создав
core = Core(). - Загрузи модель с помощью метода
core.read_model(). - Скомпилируй модель с помощью функции
core.compile_model(). - Подготовь входные данные (изображение, текст, аудио и т. д.).
- Выполни инференс с помощью
compiled_model(input_data).
Подробные инструкции и примеры кода смотри в документации OpenVINO или руководстве по API.
Результаты тестирования YOLO26 с OpenVINO#
Команда Ultralytics протестировала YOLO26 в различных форматах модели и с разной точностью, оценив скорость и точность на разных устройствах Intel, совместимых с OpenVINO.
-
Приведённые ниже результаты тестирования предназначены для справки. Они могут различаться в зависимости от конкретной конфигурации оборудования и программного обеспечения, а также текущей нагрузки на систему во время тестирования.
-
Все тесты проводились с помощью пакета Python
openvinoверсии 2026.2.1. -
Модели YOLO26 поддерживаются на NPU только в системах Intel® Core™ Ultra™ серий 2xxV и 3xx, а также в более новых системах.
Intel® Core™ Ultra#
Серия Intel® Core™ Ultra™ задаёт новый уровень высокопроизводительных вычислений и создана с учётом меняющихся потребностей современных пользователей — от геймеров и авторов контента до специалистов, использующих ИИ. Это поколение выходит за рамки традиционной серии CPU: в одном чипе сочетаются мощные ядра CPU, высокопроизводительный встроенный GPU и специализированный нейронный процессор (NPU), образуя универсальное решение для разнообразных ресурсоёмких задач.
В основе архитектуры Intel® Core Ultra™ лежит гибридная конструкция, обеспечивающая высокую производительность при выполнении традиционных вычислительных задач, нагрузок с ускорением на GPU и операций на основе ИИ. NPU ускоряет инференс ИИ непосредственно на устройстве, делая машинное обучение и обработку данных быстрее и эффективнее в самых разных приложениях.
Семейство Core Ultra™ включает модели для разных требований к производительности: от энергоэффективных решений до мощных вариантов с обозначением «H», идеально подходящих для ноутбуков и компактных устройств, которым нужна высокая вычислительная мощность. Благодаря сочетанию CPU, GPU и NPU пользователи получают высокую эффективность, отзывчивость и возможности многозадачности.
Серия Core Ultra™ — часть постоянной работы Intel над инновациями и новый ориентир для вычислительных систем будущего. Доступно несколько моделей, и скоро появятся новые; эта серия подтверждает стремление Intel создавать передовые решения для нового поколения интеллектуальных устройств с расширенными возможностями ИИ.
Приведённые ниже тесты выполнены на Intel® Core™ Ultra™ X7 358H, Intel® Core™ Ultra™ 7 258V и Intel® Core™ Ultra™ 7 155H с точностью FP32, FP16 и INT8.
Intel® Core™ Ultra™ X7 358H#
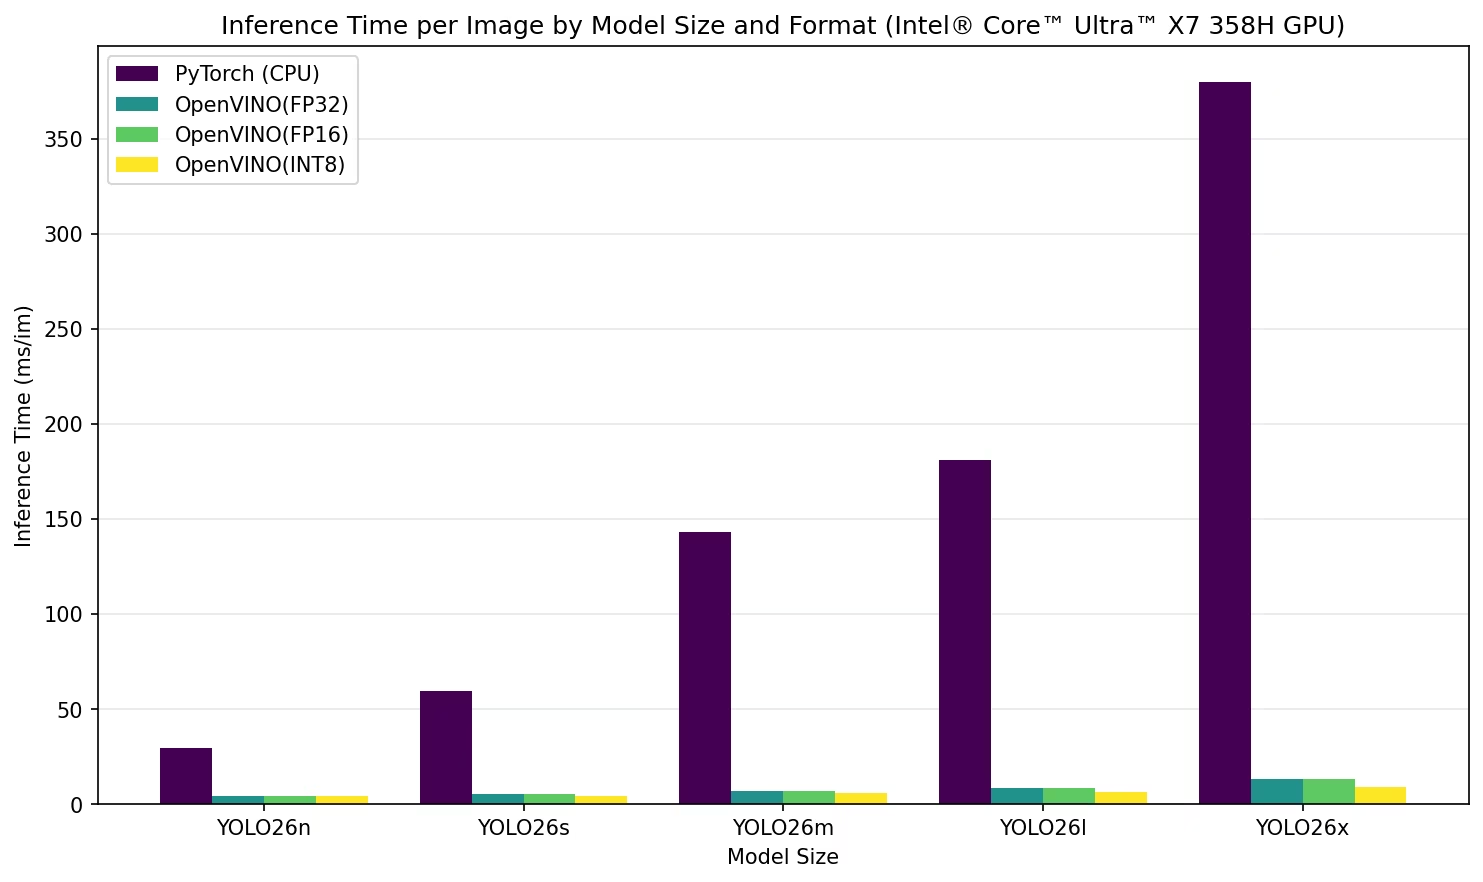
Подробные результаты тестирования
| Модель | Формат | Точность | Статус | Размер (МБ) | metrics/mAP50-95(B) | Время инференса (мс/изобр.) |
|---|---|---|---|---|---|---|
| YOLO26n | PyTorch (CPU) | FP32 | ✅ | 5.3 | 0.4765 | 29.28 |
| YOLO26n | OpenVINO | FP32 | ✅ | 9.7 | 0.4762 | 4.09 |
| YOLO26n | OpenVINO | FP16 | ✅ | 5.1 | 0.4762 | 4.03 |
| YOLO26n | OpenVINO | INT8 | ✅ | 3.2 | 0.4634 | 4.24 |
| YOLO26s | PyTorch (CPU) | FP32 | ✅ | 19.5 | 0.5703 | 59.32 |
| YOLO26s | OpenVINO | FP32 | ✅ | 36.7 | 0.5616 | 5.08 |
| YOLO26s | OpenVINO | FP16 | ✅ | 18.7 | 0.5616 | 5.14 |
| YOLO26s | OpenVINO | INT8 | ✅ | 10.0 | 0.5462 | 4.47 |
| YOLO26m | PyTorch (CPU) | FP32 | ✅ | 42.2 | 0.6196 | 143.21 |
| YOLO26m | OpenVINO | FP32 | ✅ | 78.4 | 0.6166 | 7.1 |
| YOLO26m | OpenVINO | FP16 | ✅ | 39.5 | 0.6166 | 7.06 |
| YOLO26m | OpenVINO | INT8 | ✅ | 20.6 | 0.6055 | 5.61 |
| YOLO26l | PyTorch (CPU) | FP32 | ✅ | 50.7 | 0.6215 | 181.16 |
| YOLO26l | OpenVINO | FP32 | ✅ | 95.3 | 0.6205 | 8.45 |
| YOLO26l | OpenVINO | FP16 | ✅ | 48.1 | 0.6205 | 8.49 |
| YOLO26l | OpenVINO | INT8 | ✅ | 25.2 | 0.5938 | 6.25 |
| YOLO26x | PyTorch (CPU) | FP32 | ✅ | 113.2 | 0.6512 | 379.75 |
| YOLO26x | OpenVINO | FP32 | ✅ | 213.3 | 0.6568 | 13.03 |
| YOLO26x | OpenVINO | FP16 | ✅ | 107.1 | 0.6568 | 12.98 |
| YOLO26x | OpenVINO | INT8 | ✅ | 54.8 | 0.6385 | 8.74 |
Intel® Core™ Ultra™ 7 258V#
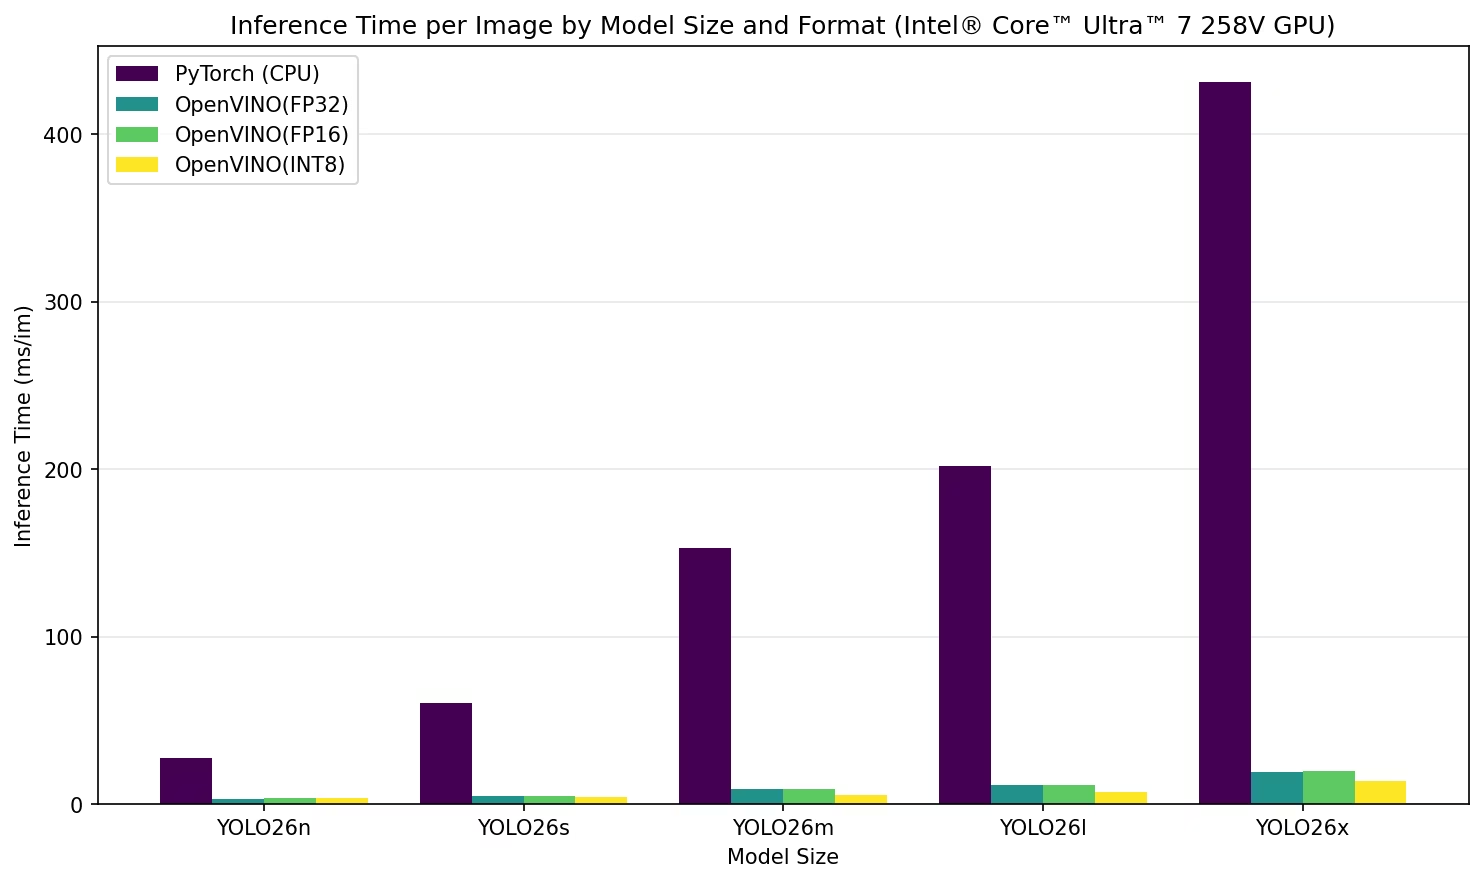
Подробные результаты тестирования
| Модель | Формат | Точность | Статус | Размер (МБ) | metrics/mAP50-95(B) | Время инференса (мс/изобр.) |
|---|---|---|---|---|---|---|
| YOLO26n | PyTorch (CPU) | FP32 | ✅ | 5.3 | 0.4765 | 27.33 |
| YOLO26n | OpenVINO | FP32 | ✅ | 9.6 | 0.4764 | 3.33 |
| YOLO26n | OpenVINO | FP16 | ✅ | 5.1 | 0.4764 | 3.34 |
| YOLO26n | OpenVINO | INT8 | ✅ | 3.2 | 0.4634 | 3.46 |
| YOLO26s | PyTorch (CPU) | FP32 | ✅ | 19.5 | 0.5703 | 60.2 |
| YOLO26s | OpenVINO | FP32 | ✅ | 36.7 | 0.5616 | 4.66 |
| YOLO26s | OpenVINO | FP16 | ✅ | 18.6 | 0.5616 | 4.65 |
| YOLO26s | OpenVINO | INT8 | ✅ | 10.0 | 0.5462 | 3.99 |
| YOLO26m | PyTorch (CPU) | FP32 | ✅ | 42.2 | 0.6196 | 152.87 |
| YOLO26m | OpenVINO | FP32 | ✅ | 78.4 | 0.6168 | 9.03 |
| YOLO26m | OpenVINO | FP16 | ✅ | 39.5 | 0.6168 | 8.98 |
| YOLO26m | OpenVINO | INT8 | ✅ | 20.6 | 0.6055 | 5.7 |
| YOLO26l | PyTorch (CPU) | FP32 | ✅ | 50.7 | 0.6215 | 201.57 |
| YOLO26l | OpenVINO | FP32 | ✅ | 95.3 | 0.6203 | 11.32 |
| YOLO26l | OpenVINO | FP16 | ✅ | 48.1 | 0.6203 | 11.36 |
| YOLO26l | OpenVINO | INT8 | ✅ | 25.2 | 0.5938 | 7.45 |
| YOLO26x | PyTorch (CPU) | FP32 | ✅ | 113.2 | 0.6512 | 431.04 |
| YOLO26x | OpenVINO | FP32 | ✅ | 213.2 | 0.6568 | 19.08 |
| YOLO26x | OpenVINO | FP16 | ✅ | 107.1 | 0.6568 | 19.63 |
| YOLO26x | OpenVINO | INT8 | ✅ | 54.8 | 0.6385 | 13.69 |
Intel® Core™ Ultra™ 7 155H#
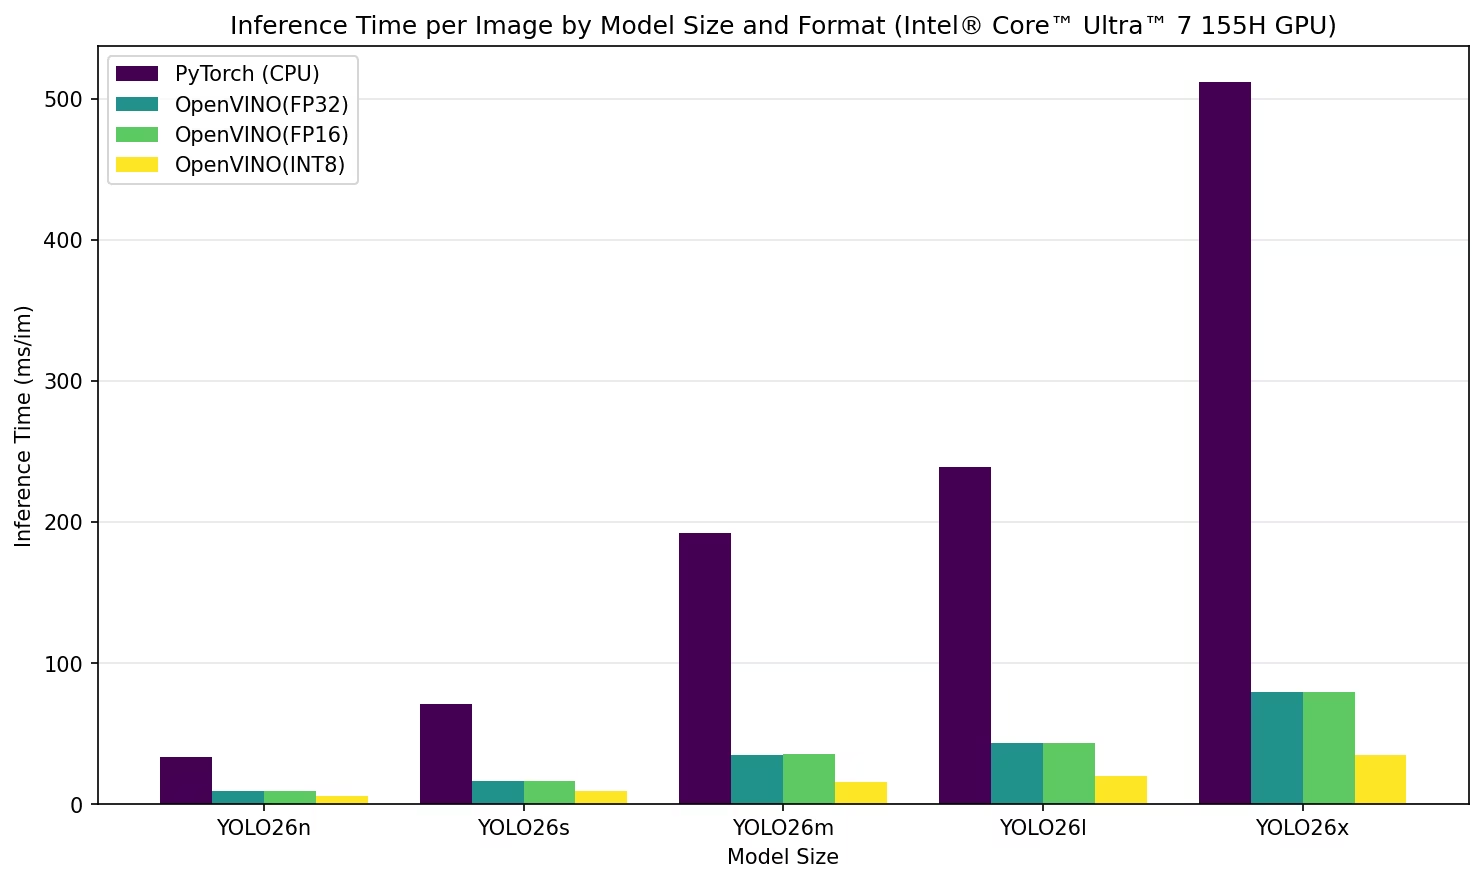
Подробные результаты тестирования
| Модель | Формат | Точность | Статус | Размер (МБ) | metrics/mAP50-95(B) | Время инференса (мс/изобр.) |
|---|---|---|---|---|---|---|
| YOLO26n | PyTorch (CPU) | FP32 | ✅ | 5.3 | 0.4765 | 33.19 |
| YOLO26n | OpenVINO | FP32 | ✅ | 9.6 | 0.4758 | 9.13 |
| YOLO26n | OpenVINO | FP16 | ✅ | 5.1 | 0.4758 | 9.07 |
| YOLO26n | OpenVINO | INT8 | ✅ | 3.2 | 0.4573 | 5.79 |
| YOLO26s | PyTorch (CPU) | FP32 | ✅ | 19.5 | 0.5703 | 70.92 |
| YOLO26s | OpenVINO | FP32 | ✅ | 36.7 | 0.5616 | 16.37 |
| YOLO26s | OpenVINO | FP16 | ✅ | 18.6 | 0.5616 | 16.65 |
| YOLO26s | OpenVINO | INT8 | ✅ | 10.0 | 0.545 | 9.27 |
| YOLO26m | PyTorch (CPU) | FP32 | ✅ | 42.2 | 0.6196 | 192.45 |
| YOLO26m | OpenVINO | FP32 | ✅ | 78.4 | 0.6167 | 34.47 |
| YOLO26m | OpenVINO | FP16 | ✅ | 39.5 | 0.6167 | 35.71 |
| YOLO26m | OpenVINO | INT8 | ✅ | 20.6 | 0.6039 | 15.46 |
| YOLO26l | PyTorch (CPU) | FP32 | ✅ | 50.7 | 0.6215 | 239.19 |
| YOLO26l | OpenVINO | FP32 | ✅ | 95.3 | 0.621 | 43.24 |
| YOLO26l | OpenVINO | FP16 | ✅ | 48.1 | 0.621 | 43.4 |
| YOLO26l | OpenVINO | INT8 | ✅ | 25.2 | 0.5999 | 19.72 |
| YOLO26x | PyTorch (CPU) | FP32 | ✅ | 113.2 | 0.6512 | 511.89 |
| YOLO26x | OpenVINO | FP32 | ✅ | 213.2 | 0.6552 | 79.49 |
| YOLO26x | OpenVINO | FP16 | ✅ | 107.1 | 0.6552 | 79.45 |
| YOLO26x | OpenVINO | INT8 | ✅ | 54.8 | 0.642 | 34.66 |
Воспроизведение наших результатов#
Чтобы повторить приведённые выше тесты Ultralytics для всех форматов экспорта, выполни этот код:
from ultralytics import YOLO

# Загрузи модель YOLO26n в формате PyTorch
model = YOLO("yolo26n.pt")

# Сравнение скорости и точности YOLO26n на наборе данных COCO128 для всех форматов экспорта
results = model.benchmark(data="coco128.yaml")
Учти, что результаты тестирования могут различаться в зависимости от точной конфигурации оборудования и программного обеспечения, а также текущей нагрузки на систему во время тестирования. Для наиболее надёжных результатов используй набор данных с большим количеством изображений, например data='coco.yaml' (5000 изображений для проверки).
Заключение#
Результаты бенчмаркинга наглядно демонстрируют преимущества экспорта модели YOLO26 в формат OpenVINO. На разных моделях и аппаратных платформах формат OpenVINO стабильно превосходит другие форматы по скорости инференса, сохраняя сопоставимую точность.
Результаты бенчмаркинга подтверждают эффективность OpenVINO как инструмента для развертывания моделей глубокого обучения. Преобразуя модели в формат OpenVINO, разработчики могут значительно повысить производительность и упростить развертывание этих моделей в реальных приложениях.
Подробнее о работе с OpenVINO и инструкциях см. в официальной документации OpenVINO.
Часто задаваемые вопросы#
Экспорт моделей YOLO26 в формат OpenVINO может значительно повысить скорость работы на CPU и обеспечить ускорение на GPU и NPU на оборудовании Intel. Для экспорта можно использовать Python или CLI, как показано ниже:
Примерfrom ultralytics import YOLO # Загрузи модель YOLO26n в формате PyTorch model = YOLO("yolo26n.pt") # Экспортировать модель model.export(format="openvino") # creates 'yolo26n_openvino_model/'Подробнее см. в документации по форматам экспорта.
Использование набора инструментов Intel OpenVINO с моделями YOLO26 дает несколько преимуществ:
- Производительность: ускорение инференса на CPU до 3 раз и использование GPU и NPU Intel для ускорения.
- Оптимизатор моделей: преобразование, оптимизация и выполнение моделей из популярных фреймворков, таких как PyTorch, TensorFlow и ONNX.
- Простота использования: доступна большая коллекция обучающих ноутбуков, которые помогут начать работу, в том числе ноутбуки для YOLO26.
- Гетерогенное выполнение: развертывание моделей на различном оборудовании Intel с использованием единого API.
Подробное сравнение производительности см. в разделе бенчмаркинга.
После экспорта модели YOLO26n в формат OpenVINO можно запустить инференс с помощью Python или CLI:
Примерfrom ultralytics import YOLO # Загрузи экспортированную модель OpenVINO ov_model = YOLO("yolo26n_openvino_model/") # Выполнить инференс results = ov_model("https://ultralytics.com/images/bus.jpg")Подробнее см. в нашей документации по режиму predict.
Ultralytics YOLO26 оптимизирована для обнаружения объектов в реальном времени с высокой точностью и скоростью. В частности, в сочетании с OpenVINO YOLO26 обеспечивает:
- Ускорение до 3 раз на CPU Intel
- Простое развертывание на GPU и NPU Intel
- Стабильную и сопоставимую точность в различных форматах экспорта
Подробный анализ производительности на разном оборудовании см. в нашем детальном бенчмаркинге YOLO26.
Да, можно сравнить производительность моделей YOLO26 в различных форматах, включая PyTorch, TorchScript, ONNX и OpenVINO. Используй следующий фрагмент кода, чтобы запустить бенчмаркинг на выбранном наборе данных:
Примерfrom ultralytics import YOLO # Загрузи модель YOLO26n в формате PyTorch model = YOLO("yolo26n.pt") # Сравнение скорости и точности YOLO26n на наборе данных COCO8 для всех форматов экспорта results = model.benchmark(data="coco8.yaml")Подробные результаты бенчмаркинга см. в разделе бенчмаркинга и в документации по форматам экспорта.