Обучение моделей
Ultralytics Platform предоставляет инструменты для обучения моделей YOLO: от организации экспериментов до запуска облачных заданий обучения с передачей метрик в реальном времени.
Смотри: Начало работы с платформой Ultralytics — обучение
Обзор#
Раздел «Обучение» помогает тебе:
- Организовывать модели в проекты для удобного управления
- Обучать модели на облачных GPU одним нажатием
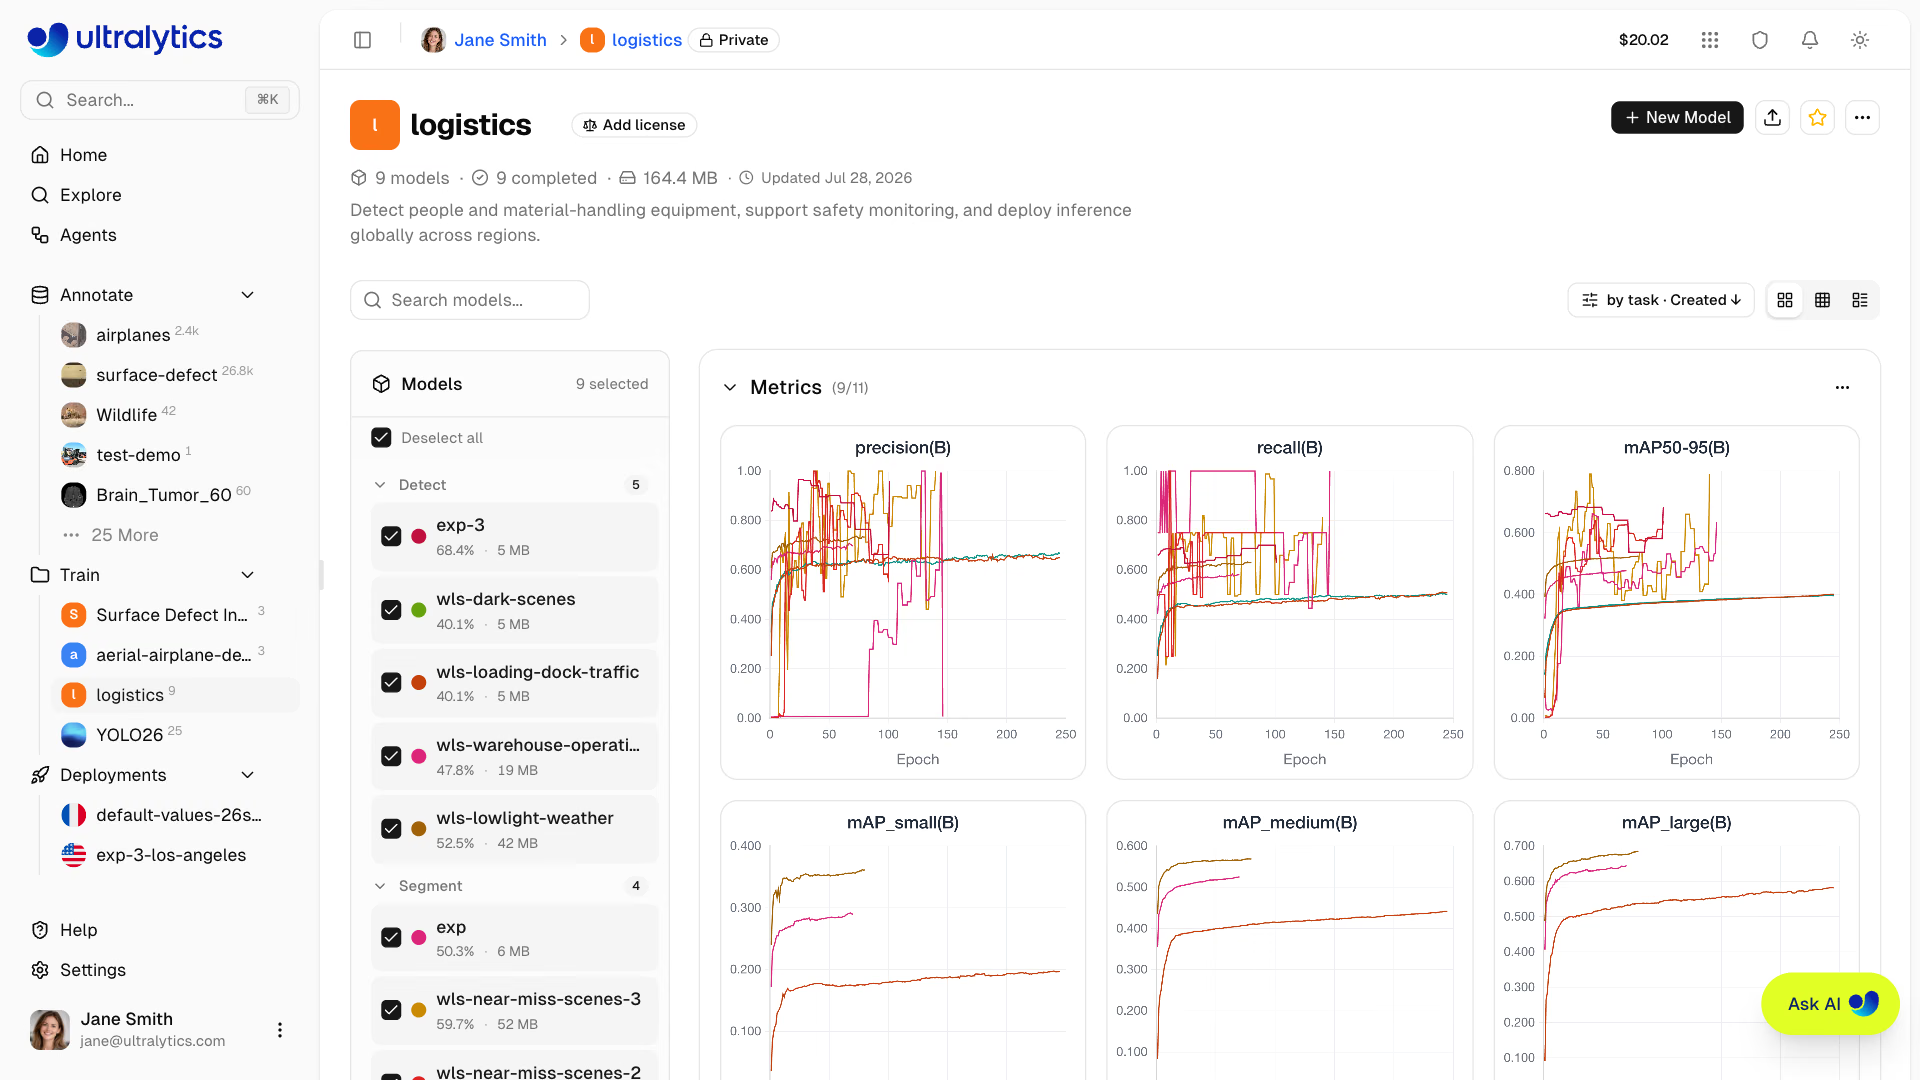
- Отслеживать метрики в реальном времени во время обучения
- Сравнивать производительность моделей в разных экспериментах
- Экспорт в 23 формата развёртывания (см. поддерживаемые форматы)
Рабочий процесс#
| Этап | Описание |
|---|---|
| Проект | Создай рабочую область для организации связанных моделей |
| Настройка | Выбери датасет, базовую модель и параметры обучения |
| Обучение | Запусти обучение на облачных GPU или локальном оборудовании |
| Мониторинг | Просматривай кривые потерь и метрики в реальном времени |
| Экспорт | Преобразование в 23 формата развёртывания (подробности) |
Варианты обучения#
Ultralytics Platform поддерживает несколько способов обучения:
| Метод | Описание | Оптимальный вариант для |
|---|---|---|
| Обучение в облаке | Обучай модели на облачных GPU Ultralytics | Нет локального GPU, возможность масштабирования |
| Локальное обучение | Обучай модели локально и передавай метрики на платформу | Собственное оборудование, конфиденциальность |
| Обучение в Colab | Используй Google Colab с интеграцией платформы | Бесплатный доступ к GPU |
Если ты выбираешь GPU дешевле RTX PRO 6000, а мощности под управлением Ultralytics свободны, платформа запускает задачу на RTX PRO 6000, но начисляет оплату по почасовому тарифу выбранного тобой GPU. Обучение может завершиться быстрее и обойтись дешевле, чем на выбранном GPU; обновление не увеличивает ни время, ни стоимость.
Варианты GPU#
Доступные GPU для облачного обучения в Ultralytics Cloud:
| GPU | Поколение | Видеопамять | Оптимальный вариант для |
|---|---|---|---|
| RTX 2000 Ada | Ada | 16 GB | Небольшие датасеты, тестирование |
| RTX A4500 | Ampere | 20 GB | Небольшие и средние датасеты |
| RTX A5000 | Ampere | 24 GB | Средние датасеты |
| RTX 4000 Ada | Ada | 20 GB | Средние датасеты |
| RTX 3090 | Ampere | 24 GB | Обучение общего назначения |
| RTX PRO 4000 | Blackwell | 24 GB | Бюджетный вариант Blackwell |
| L4 | Ada | 24 GB | Оптимизирована для инференса |
| A40 | Ampere | 48 GB | Больший размер батча |
| RTX A6000 | Ampere | 48 GB | Большие модели |
| RTX PRO 4500 | Blackwell | 32 GB | Отличное соотношение цены и производительности |
| L40 | Ada | 48 GB | Большие модели |
| RTX 4090 | Ada | 24 GB | Обучение общего назначения |
| RTX PRO 5000 | Blackwell | 48 GB | Обучение с большим размером батча |
| RTX 6000 Ada | Ada | 48 GB | Обучение с большим размером батча |
| L40S | Ada | 48 GB | Обучение с большим размером батча |
| RTX 5090 | Blackwell | 32 GB | Последнее поколение потребительских GPU |
| A100 PCIe | Ampere | 80 GB | Обучение для production-среды |
| A100 SXM | Ampere | 80 GB | Обучение для production-среды |
| RTX PRO 6000 | Blackwell | 96 GB | Рекомендуемый вариант по умолчанию |
| H100 PCIe | Hopper | 80 GB | Высокопроизводительное обучение |
| H100 NVL | Hopper | 94 GB | Максимальной производительности |
| H200 NVL | Hopper | 143 GB | Максимальный объем памяти |
| H100 SXM | Hopper | 80 GB | Самое быстрое обучение |
| H200 SXM | Hopper | 141 GB | Максимальной производительности |
| B200 | Blackwell | 180 GB | Крупные модели (Pro+) |
| B300 | Blackwell | 288 GB | Самые крупные модели (Pro+) |
Текущие почасовые цены указаны в диалоге обучения в списке выбора GPU и на странице с ценами.
Для GPU B200 и B300 требуется тариф Pro или Enterprise. Все остальные GPU доступны на всех тарифах, включая Free.
Новые аккаунты получают бонусные кредиты для обучения. Подробности смотри в разделе Оплата.
Метрики в реальном времени#
На вкладке модели Train смотри метрики в реальном времени и доступные результаты валидации:
| Подвкладка | Метрики |
|---|---|
| Метрики | Метрики задачи (mAP50, mAP50-95, точность и полнота для обнаружения объектов), потери на обучении/валидации, скорость обучения |
| Валидация | Записанные графики валидации и анализ отдельных изображений, если доступны |
| Консоль | Текущие журналы обучения с цветовой разметкой ANSI и автоматическим обнаружением ошибок |
| Система | Загрузка и температура GPU, память GPU, CPU, RAM, сеть и дисковый ввод-вывод |
Лучшая контрольная точка (best.pt, эпоха с наибольшим значением fitness) периодически загружается на платформу во время обучения, а затем ещё раз по завершении задачи. Поэтому для загрузки, экспорта и развёртывания всегда используется лучшая на данный момент эпоха. Если задача отменена, сохраняется последняя контрольная точка, загрузка которой завершилась.
Быстрый старт#
Начни облачное обучение менее чем за минуту:
- Создай проект на боковой панели
- Нажми New Model
- Выбери модель, датасет и GPU
- Нажми Start Training
Полезные ссылки#
- Проекты: упорядочивай модели и эксперименты
- Модели: управление обученными контрольными точками
- Облачное обучение: обучай модели на облачных GPU
- AutoTrain: используй Ask AI для запуска экспериментов и сравнения моделей
Часто задаваемые вопросы#
Время обучения зависит от:
- Размера датасета (количества изображений)
- Размер модели (n, s, m, l, x)
- Количества эпох
- Выбранного типа GPU
Текущая оценка показывает около 6 минут для 1000 изображений, YOLO26n, 100 эпох на RTX PRO 6000 и около 2 минут для 500 изображений, YOLO26n, 50 эпох на RTX 4090. Фактическая длительность может отличаться; используй актуальную оценку в диалоге обучения для выбранного набора данных и конфигурации.
Да. Ограничения на одновременное облачное обучение зависят от твоего тарифа: Free позволяет запускать 3 задачи, Pro — 10, а Enterprise не ограничивает их количество. Чтобы запускать больше задач параллельно, используй удалённое обучение на нескольких машинах.
Если обучение завершится с ошибкой:
- Модель получит статус ошибки, а вычислительный экземпляр будет остановлен
- На странице модели отображается баннер ошибки с перехваченным сообщением об ошибке, ссылкой на вывод консоли, а также действиями Диагностировать с помощью ИИ и Повторить обучение (для роли редактора или выше), которое повторно открывает диалог обучения с той же конфигурацией
- Если задача не сообщает об активности в течение 4 часов, она автоматически помечается как завершившаяся с ошибкой, а её вычислительные ресурсы освобождаются
- Если облачные вычисления уже начались, оплачивается фактическое время работы GPU; за сбои до начала вычислений плата за использование GPU не взимается
Сценарий Рекомендуемый GPU Большинство задач обучения RTX PRO 6000 Большие датасеты или размеры пакетов H100 SXM или H200 Для тех, кто хочет сэкономить RTX 4090


Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.