En İyi YOLOv5 Eğitim Sonuçları İçin İpuçları
Bu kılavuz, YOLOv5 ile en iyi mAP ve eğitim sonuçlarını nasıl elde edebileceğini açıklar.
Veri kümen yeterince büyük ve iyi etiketlenmişse, çoğu zaman modellerde veya eğitim ayarlarında değişiklik yapmadan iyi sonuçlar alabilirsin. İlk denemende iyi sonuç alamazsan iyileştirme için uygulayabileceğin adımlar olabilir; ancak değişiklikleri değerlendirmeden önce her zaman varsayılan ayarların tümüyle eğitim yapmanı öneririz. Bu, performans için bir temel oluşturup iyileştirilebilecek alanları belirlemene yardımcı olur.
Eğitim sonuçların hakkında soruların varsa, yararlı bir yanıt alabilmek için mümkün olduğunca fazla bilgi ver. Eğitim kayıpları, doğrulama kayıpları, P, R ve mAP sonuç grafiklerini; PR eğrisini; karışıklık matrisini; eğitim mozaiklerini; test sonuçlarını ve labels.png gibi veri kümesi istatistiklerini içeren görüntüleri paylaş. Bunların tümü project/name dizininde, genellikle yolov5/runs/train/exp konumunda bulunur.
Aşağıdaki bölümlerde YOLOv5 eğitim sonuçlarını etkileyen temel etkenler ele alınır.
Veri kümesi#
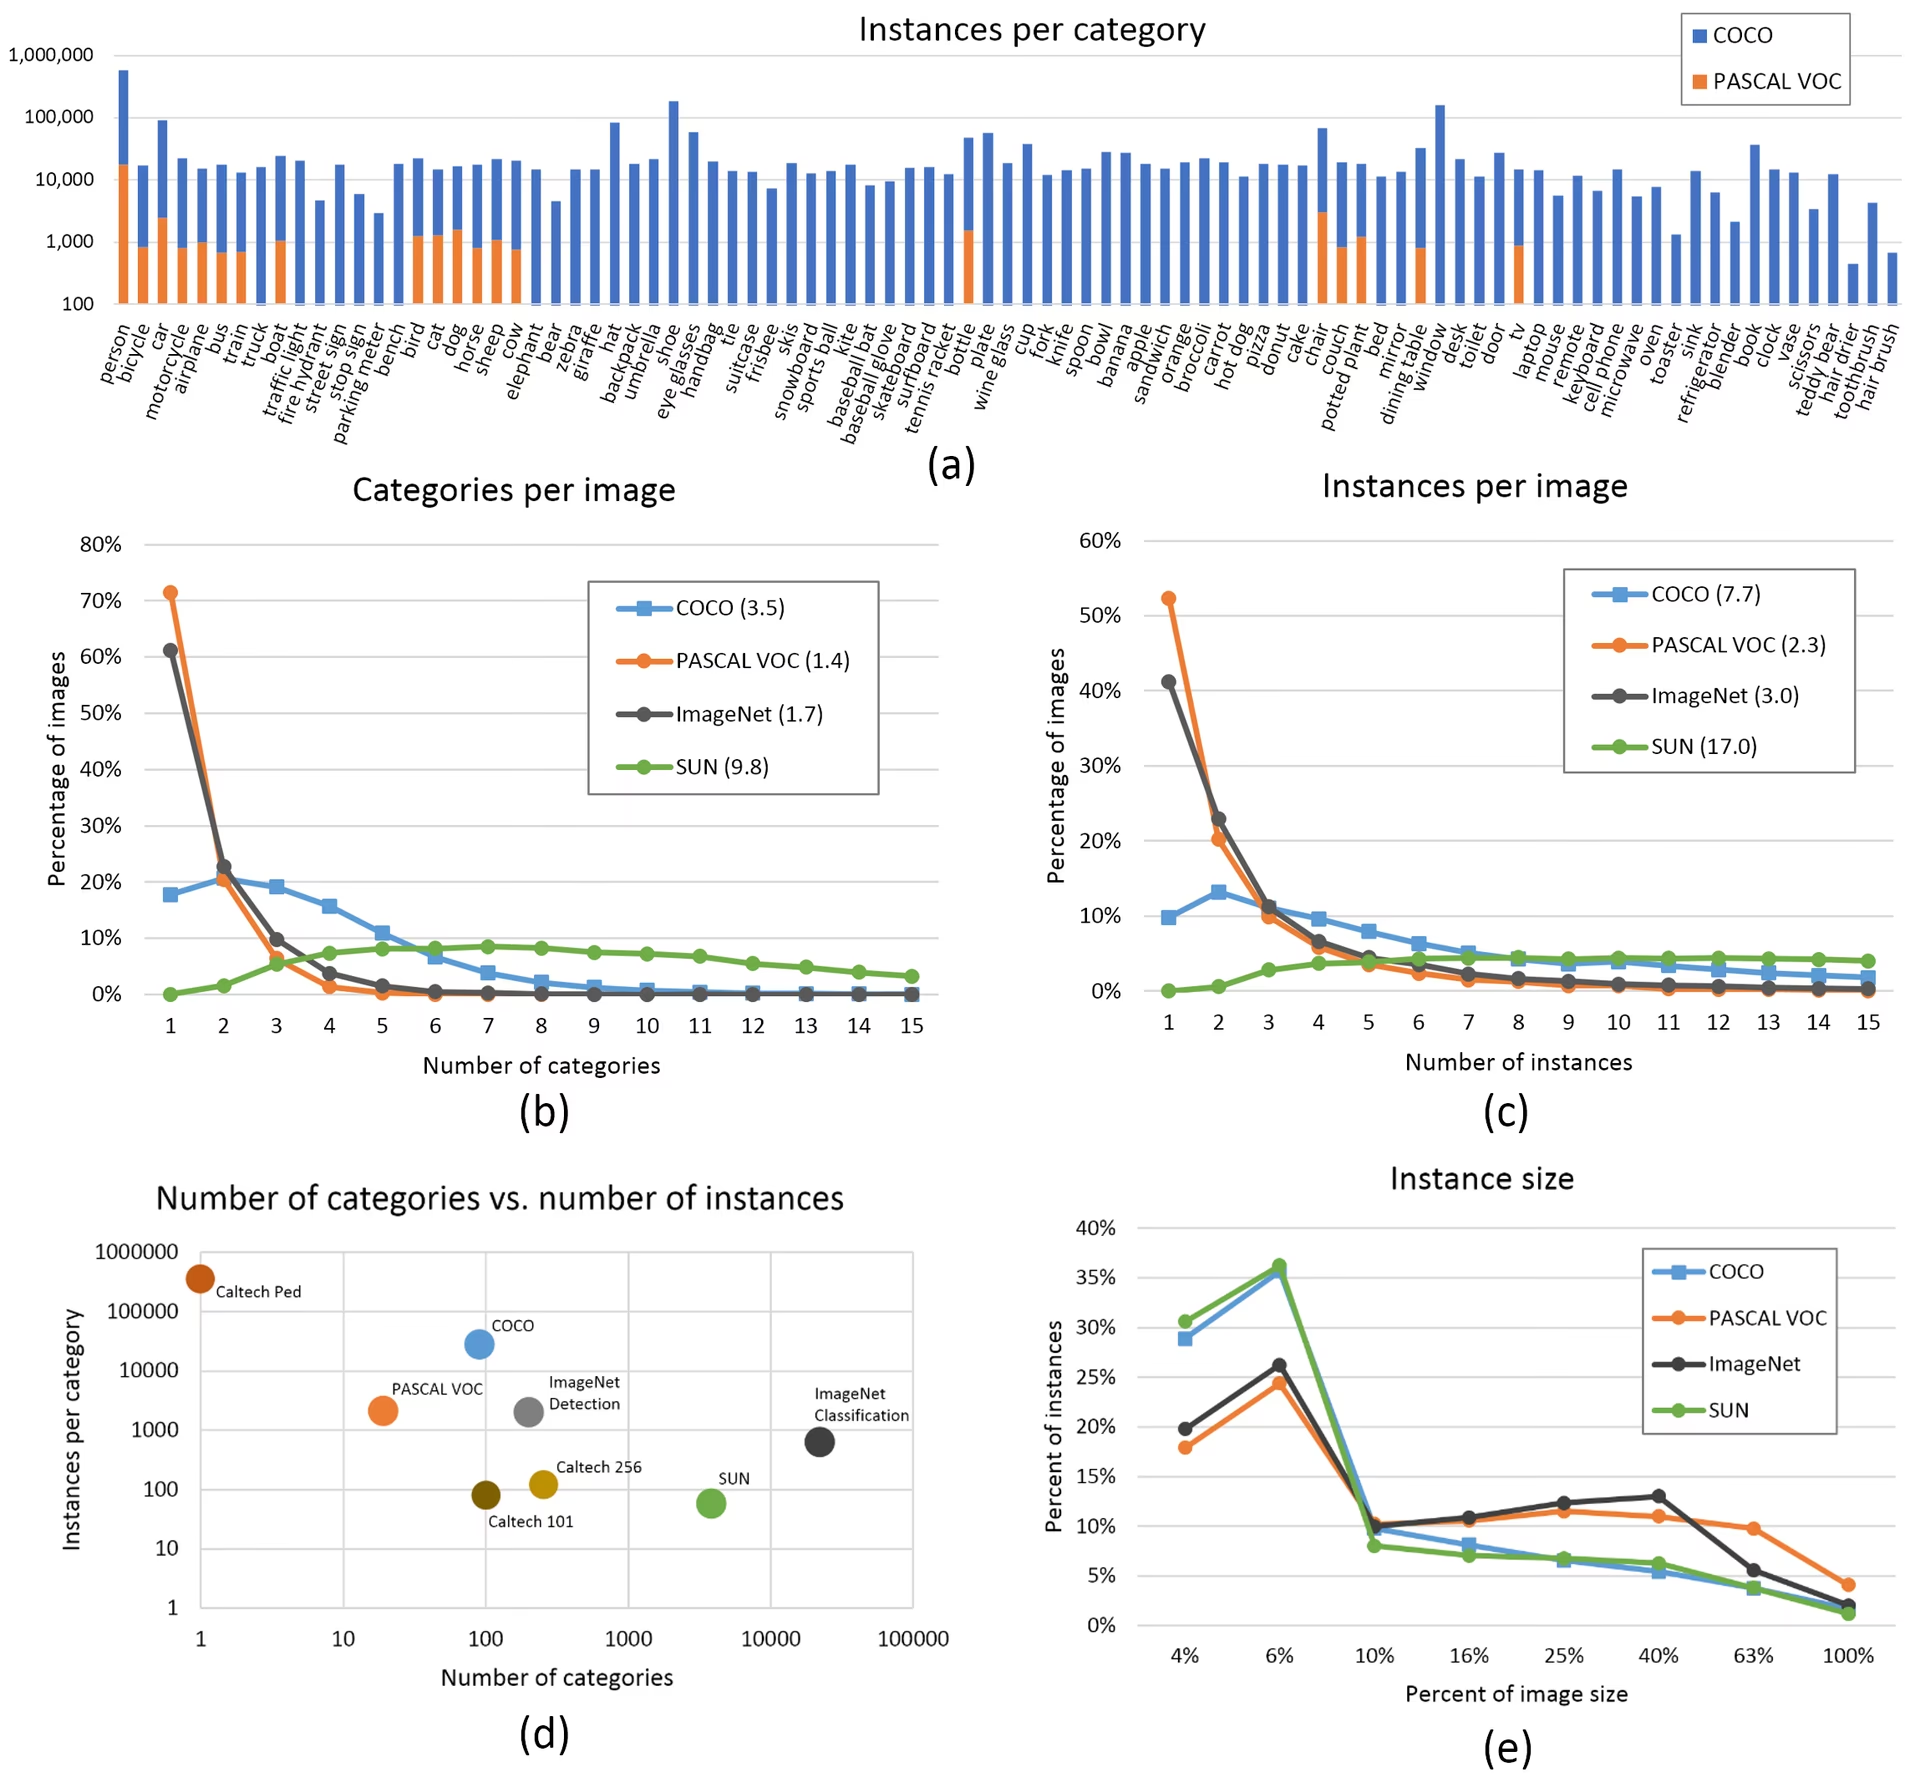
- Sınıf başına görsel. Sınıf başına ≥ 1500 görsel önerilir
- Sınıf başına örnek. Sınıf başına ≥ 10000 örnek (etiketlenmiş nesne) önerilir
- Görsel çeşitliliği. Dağıtım ortamını temsil etmelidir. Gerçek dünyadaki kullanım durumları için günün farklı saatlerinden, farklı mevsimlerden, farklı hava koşullarından, farklı ışıklandırmalardan, farklı açılardan ve farklı kaynaklardan (çevrimiçi toplanmış, yerel olarak derlenmiş, farklı kameralarla çekilmiş vb.) görseller kullanmanı öneririz.
- Etiket tutarlılığı. Tüm görsellerdeki tüm sınıfların tüm örnekleri etiketlenmelidir. Kısmi etiketleme işe yaramaz.
- Etiket doğruluğu. Etiketler her nesneyi yakından çevrelemelidir. Bir nesne ile sınırlayıcı kutusu arasında boşluk olmamalıdır. Hiçbir nesne etiketsiz bırakılmamalıdır.
- Eğitim/doğrulama bölme disiplini. Aşırı iyimser metrikleri önlemek için doğrulama ve test görsellerinin eğitim kümesinde hiç yer almadığından emin ol. Bölümler arasındaki sınıf dağılımlarını benzer tut.
- Etiketleri doğrulama. Etiketlerinin doğru göründüğünü doğrulamak için eğitim başlangıcında
train_batch*.jpgmozaiklerini görüntüle. - Arka plan görselleri. Arka plan görselleri, yanlış pozitifleri (FP) azaltmak için veri kümesine eklenen, nesne içermeyen görsellerdir. Yanlış pozitifleri azaltmaya yardımcı olmak için yaklaşık %0-10 oranında arka plan görseli kullanmanı öneririz (referans olması açısından COCO'da toplamın %1'ine denk gelen 1000 arka plan görseli bulunur). Arka plan görselleri için etiket gerekmez.
Model Seçimi#
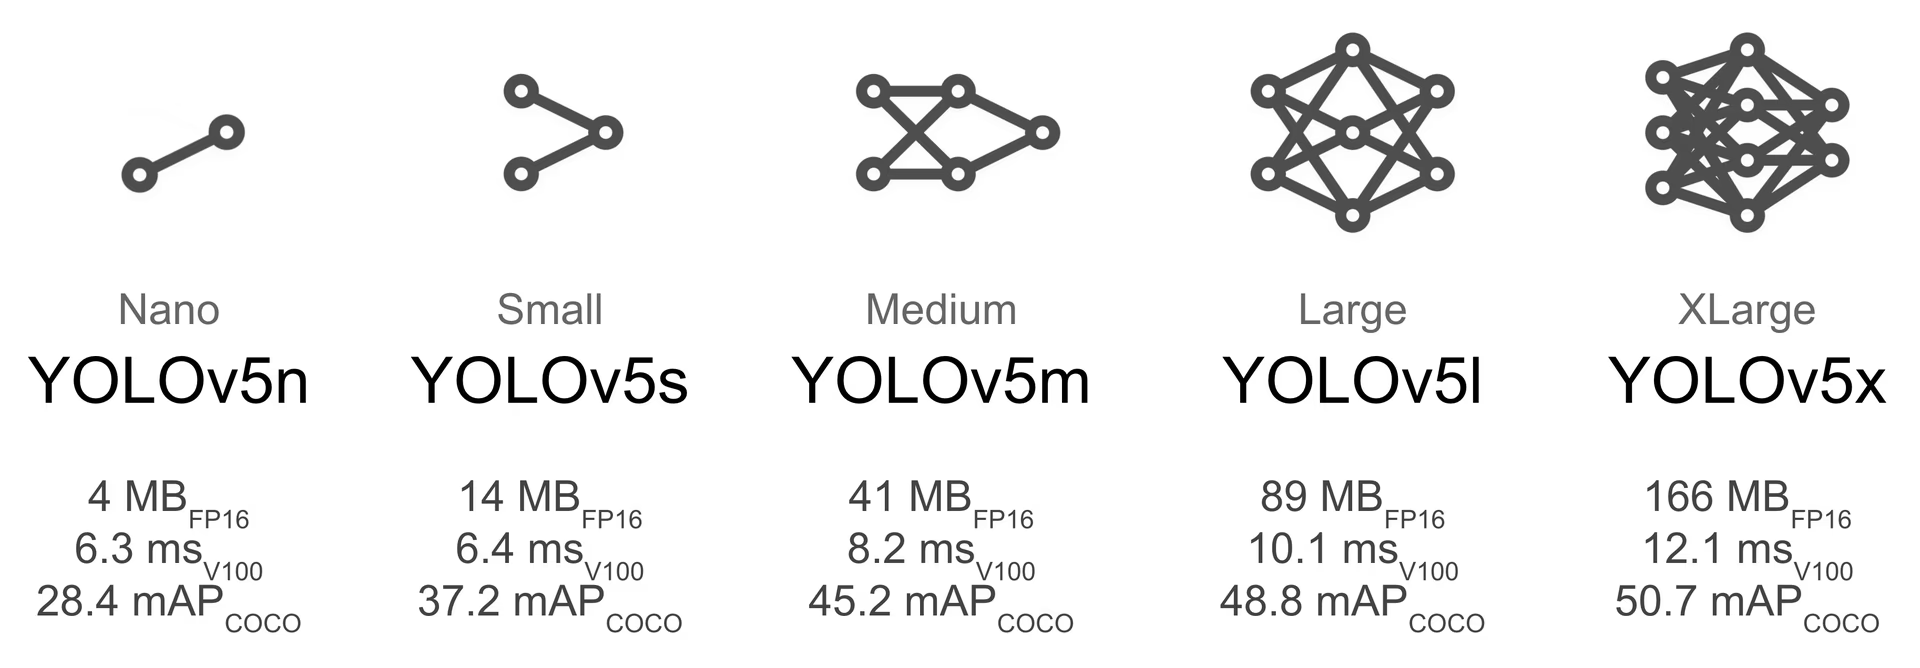
YOLOv5x ve YOLOv5x6 gibi daha büyük modeller, neredeyse her durumda daha iyi sonuçlar verir; ancak daha fazla parametreye sahiptir, eğitim için daha fazla CUDA belleği gerektirir ve daha yavaş çalışır. Mobil dağıtımlar için YOLOv5s/m, bulut dağıtımları için YOLOv5l/x modellerini öneririz.
-
Önceden eğitilmiş ağırlıklarla başla. Küçük ve orta büyüklükteki veri kümeleri için önerilir (ör. VOC, VisDrone, GlobalWheat). Model adını
--weightsbağımsız değişkenine ver. Modeller en son YOLOv5 sürümünden otomatik olarak indirilir.python train.py --data custom.yaml --weights yolov5s.pt python train.py --data custom.yaml --weights yolov5m.pt python train.py --data custom.yaml --weights yolov5l.pt python train.py --data custom.yaml --weights yolov5x.pt python train.py --data custom.yaml --weights custom_pretrained.pt -
Sıfırdan başla. Büyük veri kümeleri için önerilir (ör. COCO, Objects365, OIv6). İlgilendiğin model mimarisinin YAML dosyasını, boş bir
--weights ''bağımsız değişkeniyle birlikte belirt:python train.py --data custom.yaml --weights '' --cfg yolov5s.yaml python train.py --data custom.yaml --weights '' --cfg yolov5m.yaml python train.py --data custom.yaml --weights '' --cfg yolov5l.yaml python train.py --data custom.yaml --weights '' --cfg yolov5x.yaml
Eğitim Ayarları#
Herhangi bir değişiklik yapmadan önce, bir performans başlangıç noktası oluşturmak için önce varsayılan ayarlarla eğitim yap. train.py ayarlarının tam listesi train.py argparser'ında bulunabilir.
- Epoch sayısı. 300 epoch ile başla. Model erken aşamada aşırı öğrenirse epoch sayısını azaltabilirsin. 300 epoch sonrasında aşırı öğrenme görülmüyorsa eğitimi, örneğin 600 veya 1200 epoch boyunca sürdür.
- Görüntü boyutu. COCO,
--img 640doğal çözünürlüğünde eğitilir; ancak veri kümesindeki küçük nesne sayısı fazla olduğundan--img 1280gibi daha yüksek çözünürlüklerde eğitimden fayda görebilir. Çok sayıda küçük nesne içeren özel veri kümeleri, doğal veya daha yüksek çözünürlükte eğitimden fayda görür. En iyi çıkarım sonuçları, eğitimde kullanılan--imgile aynı boyutta elde edilir. Örneğin--img 1280boyutunda eğitim yaparsan test ve algılama işlemlerini de--img 1280boyutunda yapmalısın. - Yığın boyutu. Donanımının desteklediği en büyük
--batch-sizedeğerini kullan. Küçük yığın boyutları, zayıf yığın normalizasyonu istatistiklerine yol açar ve bunlardan kaçınılmalıdır. GPU'n için en uygun yığın boyutunu otomatik olarak seçmek üzere--batch-size -1kullanabilirsin. - Öğrenme oranı. Varsayılan öğrenme oranı zamanlaması çoğu durumda iyi çalışır. Daha hızlı yakınsama için
--cos-lrbayrağını kullanarak kosinüs öğrenme oranı zamanlamasını etkinleştirebilirsin; bu yöntem epoch'lar boyunca kosinüs eğrisini izleyerek öğrenme oranını kademeli olarak düşürür. - Veri artırma. YOLOv5, birden fazla eğitim görselini birleştiren mozaik gibi çeşitli veri artırma teknikleri içerir. Eğitimi kararlı hâle getirmeye yardımcı olmak için
--hypdosyandakimosaichiperparametresiyle veri artırma düzeyini ayarla. - Hiperparametreler. Varsayılan hiperparametreler hyp.scratch-low.yaml dosyasındadır. Herhangi bir değişiklik yapmayı düşünmeden önce varsayılan hiperparametrelerle eğitim yapmanı öneririz. Genel olarak veri artırma hiperparametrelerini artırmak aşırı uyumu azaltıp geciktirerek daha uzun eğitimlere ve daha yüksek son mAP değerlerine olanak tanır.
hyp['obj']gibi loss bileşeni katsayısı hiperparametrelerini azaltmak, ilgili loss bileşenlerindeki aşırı uyumu azaltmaya yardımcı olur. Bu hiperparametreleri otomatik olarak optimize etme yöntemi için Hiperparametre Evrimi Öğreticimize bak. - Karma duyarlıklı eğitim. Desteklenen bir GPU algılandığında YOLOv5 Otomatik Karma Duyarlılığı (AMP) otomatik olarak etkinleştirir; böylece model doğruluğundan ödün vermeden eğitim hızlanır ve bellek kullanımı azalır.
- Çoklu GPU ile eğitim. Birden fazla GPU'n varsa, eğitim süresini önemli ölçüde azaltabilecek Dağıtık Veri Paralel eğitimi
python -m torch.distributed.run --nproc_per_node 4 train.py ... --device 0,1,2,3ile başlat. - Erken durdurma. Doğrulama metrikleri 50 epoch boyunca iyileşmezse eğitimi durdurmak, zaman kazanmak ve aşırı uyumu önlemek için
--patience 50kullan.
Gelişmiş Optimizasyon Teknikleri#
- Aktarım öğrenimi. Özel veri kümeleri için önceden eğitilmiş ağırlıklarla başla ve modeli belirli görevine uyarlamak üzere isteğe bağlı olarak
--freezeile katmanları dondur. - Model budama. Eğitimden sonra, doğrulukta çok az kayıp yaşarken gereksiz ağırlıkları sıfırlamak için modelini budamayı düşün; ardından hız kazanımlarından yararlanmak için modeli seyreklik farkındalığına sahip bir çalışma zamanı ortamında kullanıma sun.
- Model topluluğu. Kritik uygulamalarda farklı yapılandırmalarla birden fazla model eğit ve daha yüksek doğruluk elde etmek için tahminlerini birleştir.
- Test zamanı artırımı. Girdi görüntüsünün çevrilmiş ve yeniden ölçeklendirilmiş sürümlerinden elde edilen tahminleri birleştirerek tahmin doğruluğunu artırmak için çıkarım sırasında TTA'yı
--augmentile etkinleştir.
Ek Okumalar#
Daha fazla bilgi edinmek istersen, başlangıç için Karpathy'nin Sinir Ağlarını Eğitme Reçetesi iyi bir kaynaktır; bu kaynakta, tüm makine öğrenimi alanlarında geniş ölçüde geçerli eğitim fikirleri yer alır.
İyi şanslar; başka soruların olursa bize bildir.
Sık Sorulan Sorular#
Eğitim kaybı azalmaya devam ederken doğrulama kaybı artmaya başlarsa modelin aşırı öğreniyor olabilir. Doğrulama mAP değerini izle: eğitim kaybı iyileşmeyi sürdürürken bu değer sabitlenir veya düşerse aşırı öğrenmenin işaretidir. Çözümler arasında daha fazla eğitim verisi eklemek, veri artırmayı artırmak veya düzenlileştirme teknikleri uygulamak yer alır.
En uygun yığın boyutu GPU belleğine bağlıdır. Daha büyük yığın boyutları genellikle daha iyi yığın normalizasyonu istatistikleri ve eğitim kararlılığı sağlar. Bellek yetersizliği yaşamadan donanımının destekleyebileceği en büyük yığın boyutunu kullan. Kurulumun için en uygun yığın boyutunu otomatik olarak belirlemek üzere
--batch-size -1kullanabilirsin.Eğitimi hızlandırmak için şunları dene: DDP ile birden fazla GPU kullan, veri kümeni
--cacheile önbelleğe al ve toplu iş boyutunu optimize et (desteklenen GPU'larda karma duyarlık otomatik olarak etkinleştirilir). Mutlak doğruluk kritik değilse YOLOv5s gibi daha küçük bir model varyantı kullanmayı da değerlendirebilirsin.


Yorumlar
Bir soru sor, sonuçlarını paylaş veya başka birine yardım et.