YOLOv5 için Hiperparametre Evrimi#
📚 Bu kılavuzda YOLOv5 için hiperparametre evrimi 🚀 açıklanmaktadır. Hiperparametre evrimi, optimizasyon için bir Genetik Algoritma (GA) kullanan bir Hiperparametre Optimizasyonu yöntemidir.
Makine öğrenmesindeki hiperparametreler eğitimin çeşitli yönlerini kontrol eder ve bunlar için en uygun değerleri bulmak zor olabilir. Izgara araması gibi geleneksel yöntemler şu nedenlerle hızla uygulanamaz hâle gelebilir:
- Yüksek boyutlu arama uzayı
- Boyutlar arasındaki bilinmeyen korelasyonlar
- Her noktadaki uygunluğun değerlendirilmesinin yüksek maliyetli olması
Bu durum, genetik algoritmaları hiperparametre aramaları için uygun bir seçenek hâline getirir.
Başlamadan Önce#
Depoyu klonla ve Python>=3.8.0 ortamında, PyTorch>=1.8 dahil olmak üzere requirements.txt dosyasını yükle. Modeller ve veri kümeleri, en güncel YOLOv5 sürümünden otomatik olarak indirilir.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
1. Hiperparametreleri Başlatma#
YOLOv5, çeşitli eğitim ayarları için kullanılan yaklaşık 30 hiperparametreye sahiptir. Bunlar *.yaml dosyalarında, /data/hyps dizininde tanımlanır. Daha iyi başlangıç tahminleri daha iyi nihai sonuçlar sağlayacağından, evrim sürecinden önce bu değerleri doğru şekilde başlatmak önemlidir. Emin değilsen varsayılan değerleri kullanabilirsin; bu değerler YOLOv5 COCO eğitimini sıfırdan gerçekleştirmek üzere optimize edilmiştir.
# YOLOv5 🚀 by Ultralytics, AGPL-3.0 license
# Hyperparameters for low-augmentation COCO training from scratch
# python train.py --batch 64 --cfg yolov5n6.yaml --weights '' --data coco.yaml --img 640 --epochs 300 --linear
# See tutorials for hyperparameter evolution https://github.com/ultralytics/yolov5#tutorials

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.01 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
2. Uygunluğu Tanımlama#
Uygunluk, maksimize etmeye çalıştığımız değerdir. YOLOv5'te varsayılan bir uygunluk fonksiyonunu metriklerin ağırlıklı kombinasyonu olarak tanımlarız: mAP@0.5 ağırlığın %10'una katkıda bulunur ve mAP@0.5:0.95 kalan %90'a katkıda bulunur; kesinlik (P) ve duyarlılık (R) hariç tutulmuştur. Bunları uygun gördüğün şekilde ayarlayabilir veya utils/metrics.py dosyasındaki varsayılan uygunluk tanımını kullanabilirsin (önerilir). Bu uygunluk, hangi sonucun hyp_evolve.yaml dosyasına kaydedileceğine karar verir; genetik algoritmanın kendisi ebeveynleri ve elitleri yalnızca mAP@0.5 değerine göre sıralar, bu nedenle bu ağırlıkları değiştirmek ebeveyn seçimini değiştirmez.
def fitness(x):
    """Return model fitness as the sum of weighted metrics [P, R, mAP@0.5, mAP@0.5:0.95]."""
    w = [0.0, 0.0, 0.1, 0.9]  # weights for [P, R, mAP@0.5, mAP@0.5:0.95]
    return (x[:, :4] * w).sum(1)
3. Evrim#
Evrim, iyileştirmeye çalıştığımız bir temel senaryo etrafında gerçekleştirilir. Bu örnekteki temel senaryo, önceden eğitilmiş YOLOv5s kullanılarak COCO128 veri kümesinin 10 epoch boyunca ince ayarlanmasıdır. Temel senaryonun eğitim komutu şöyledir:
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cacheBu senaryoya özgü hiperparametreleri, Bölüm 1. içinde tanımlanan başlangıç değerlerimizden başlayarak ve Bölüm 2. içinde tanımlanan uygunluğu en üst düzeye çıkararak evrimleştirmek için --evolve ekle:
# Single-GPU
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --evolve

# Multi-GPU with delay
for i in {0..7}; do
  sleep $((30 * i)) # 30-second delay (optional)
  echo "Starting GPU $i..."
  nohup python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log" &
done

# Continuous training (use with caution)
# for i in {0..7}; do
#   sleep $((30 * i))  # 30-second delay (optional)
#   echo "Starting continuous training on GPU $i..."
#   (
#     while true; do
#       python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log"
#     done
#   ) &
# done
Varsayılan evrim ayarları 300 nesil boyunca çalışır ve her nesil, popülasyondaki 50 bireyin her biri için temel senaryoyu bir kez eğitir. Nesilleri --evolve argümanı üzerinden değiştirebilirsin, yani python train.py --evolve 1000.
Ana genetik operatörler çaprazlama ve mutasyondur. Her nesil her bireyi eğitir ve bireyi mAP@0.5 değerine göre puanlar, en uygun elitlerin ebeveyn havuzuna eklendiği turnuva seçimi ile ebeveynleri seçer ve evrim ilerledikçe uyum sağlayan oranlarla çaprazlama ve mutasyon yoluyla bir sonraki popülasyonu oluşturur. Sonuçlar runs/evolve/exp/evolve.csv dosyasına kaydedilir ve en yüksek uygunluğa sahip yavrular her nesilde runs/evolve/exp/hyp_evolve.yaml olarak kaydedilir:
# YOLOv5 Hyperparameter Evolution Results
# Best generation: 287
# Last generation: 300
#    metrics/precision,       metrics/recall,      metrics/mAP_0.5, metrics/mAP_0.5:0.95,         val/box_loss,         val/obj_loss,         val/cls_loss
#              0.54634,              0.55625,              0.58201,              0.33665,             0.056451,             0.042892,             0.013441

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.2 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
En iyi sonuçlar için en az 300 nesillik evrim öneririz. Temel senaryo binlerce kez eğitildiği ve muhtemelen yüzlerce veya binlerce GPU saati gerektirebileceği için evrimin genellikle maliyetli ve zaman alıcı olduğunu unutma.
Evrim tamamlandığında, örneğin python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt ile eğitimi kaydedilen dosyaya yönlendirerek keşfedilen ayarları yeniden kullanabilirsin.
4. Görselleştir#
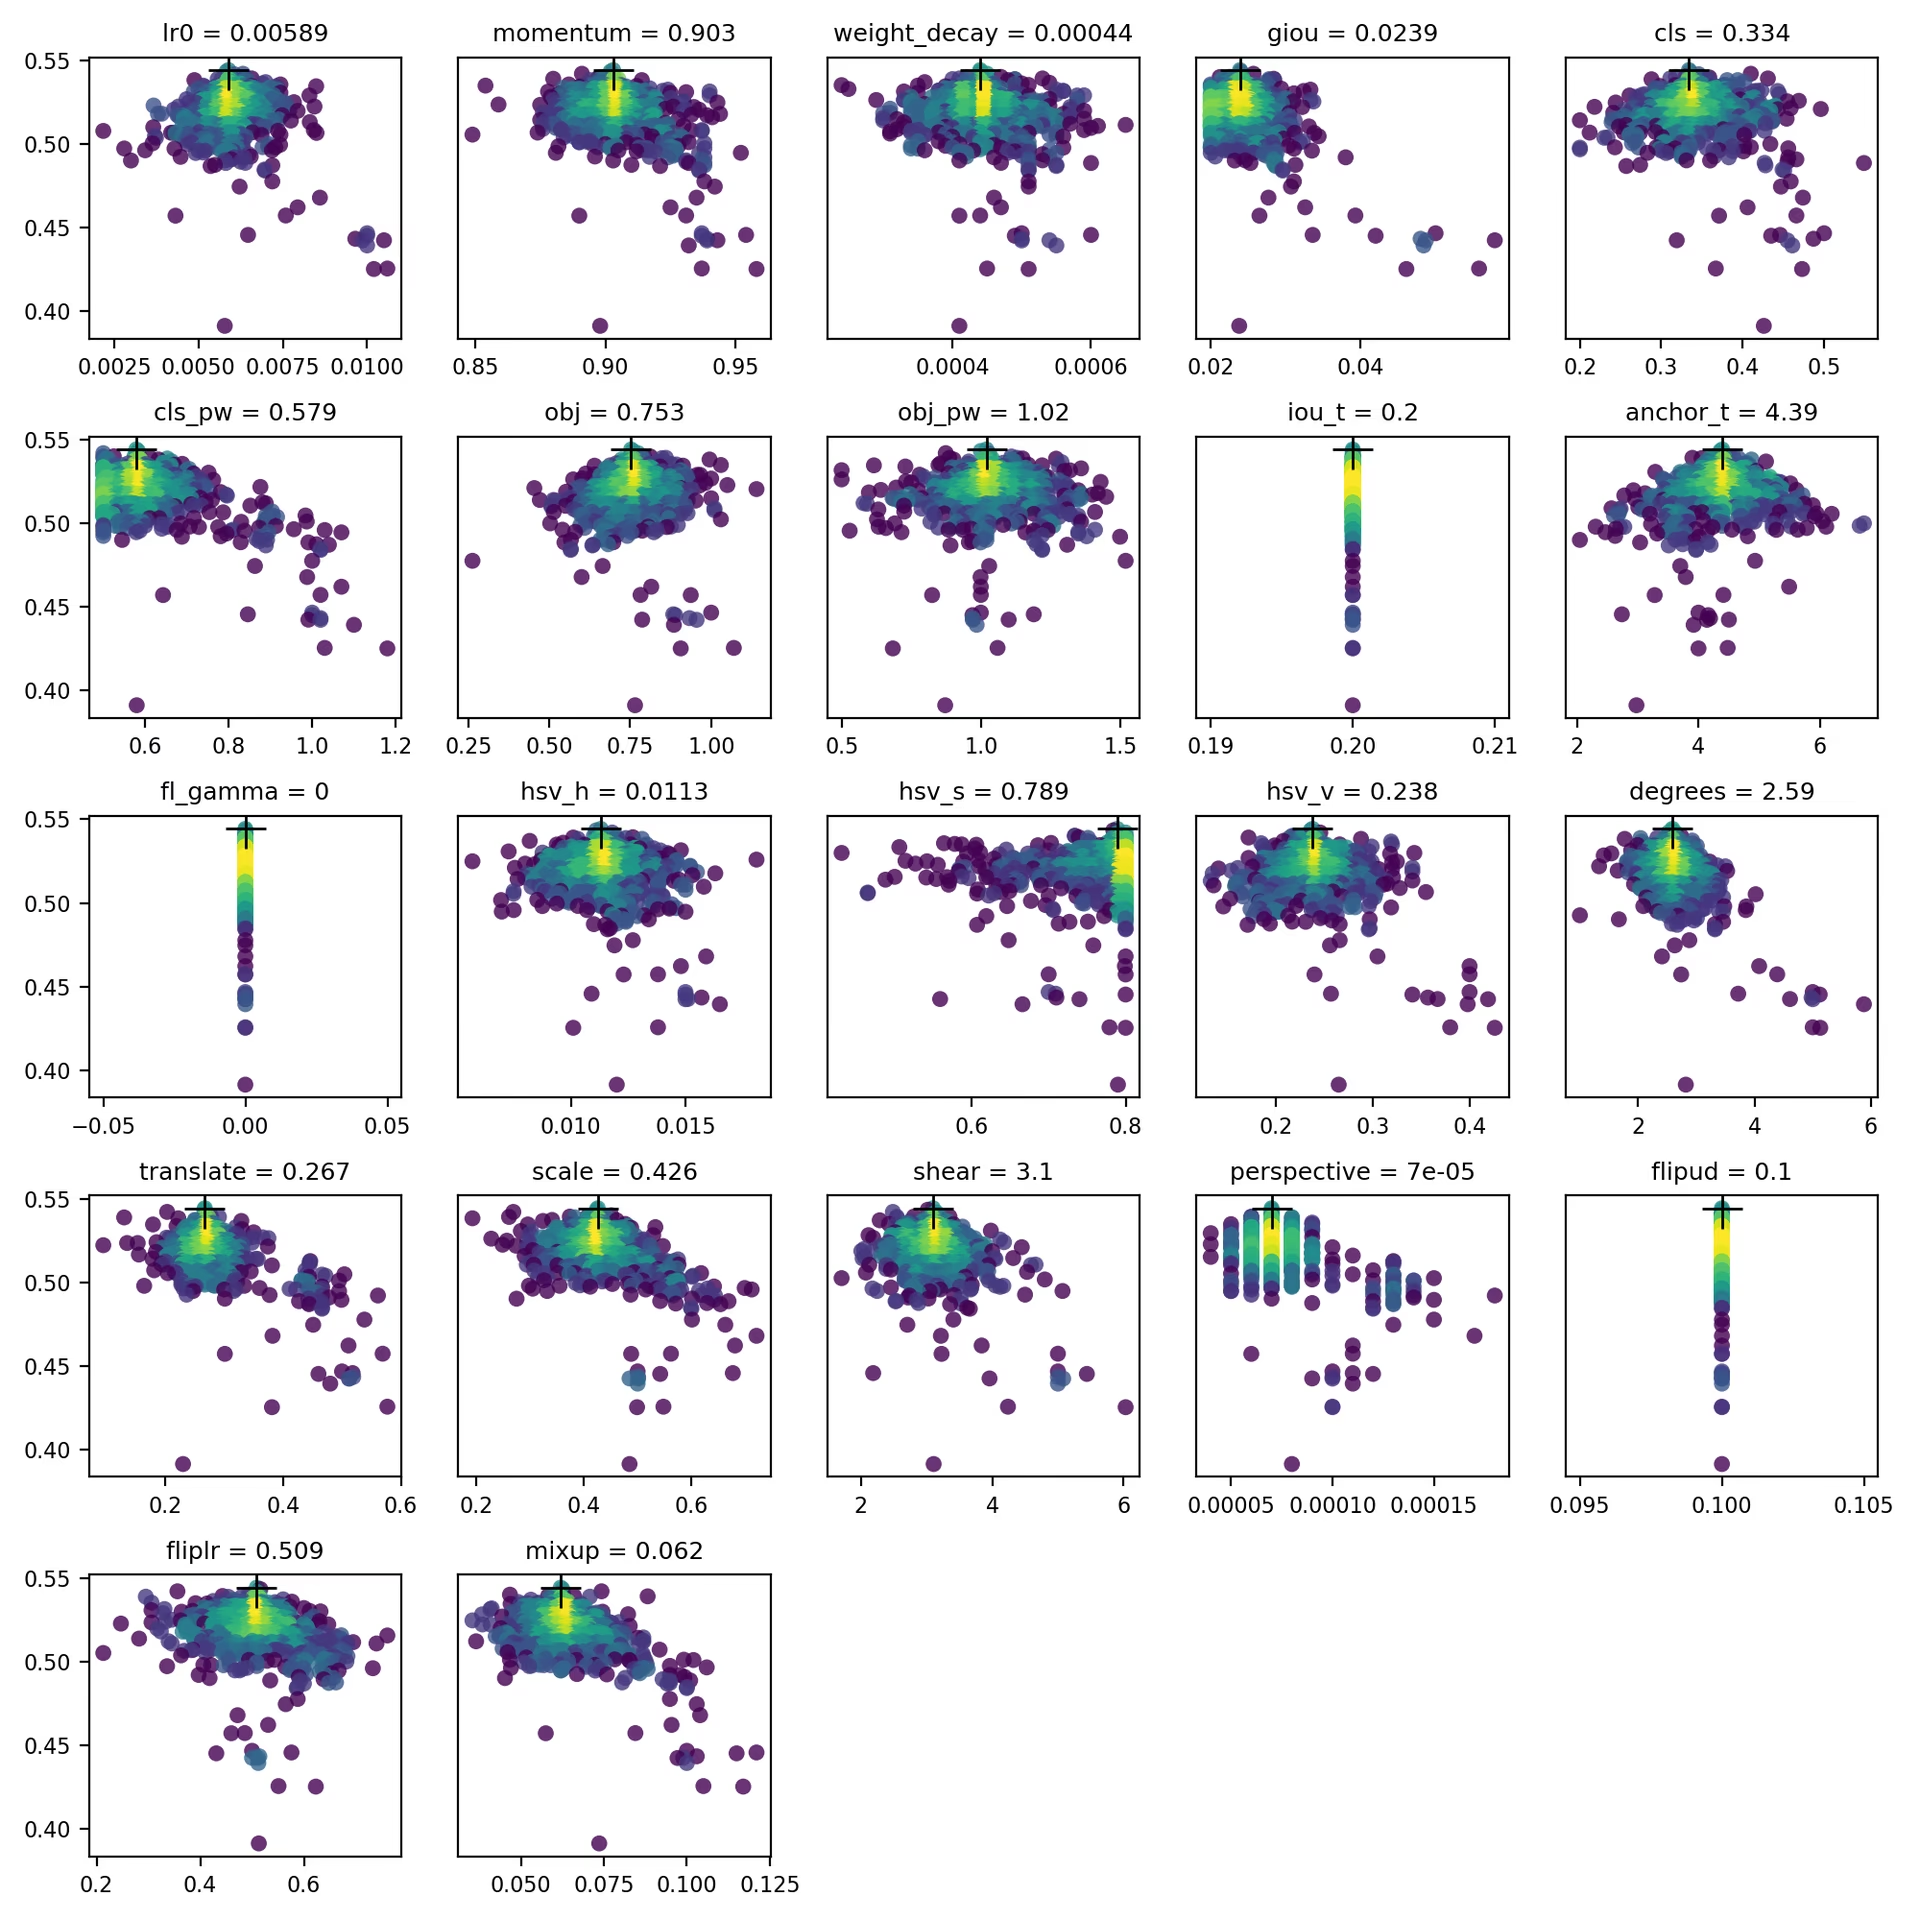
evolve.csv, evrim tamamlandıktan sonra utils.plots.plot_evolve() tarafından evolve.png olarak çizilir; her hiperparametre için uygunluğu (y ekseni) hiperparametre değerlerine (x ekseni) karşı gösteren bir alt grafik bulunur. Sarı renk daha yüksek yoğunlukları gösterir. Dikey dağılımlar, bir parametrenin devre dışı bırakıldığını ve mutasyona uğramadığını gösterir. Bu seçenek train.py içindeki meta sözlüğünden kullanıcı tarafından belirlenebilir ve parametreleri sabitlemek ve evrimleşmelerini önlemek için kullanışlıdır.
Desteklenen Ortamlar#
Ultralytics, projelerine hızlı bir başlangıç yapman için CUDA, CUDNN, Python ve PyTorch gibi temel bağımlılıkların önceden yüklendiği, kullanıma hazır çeşitli ortamlar sunar.
- Ücretsiz GPU Not Defterleri:


- Google Cloud: GCP Hızlı Başlangıç Kılavuzu
- Amazon: AWS Hızlı Başlangıç Kılavuzu
- Azure: AzureML Hızlı Başlangıç Kılavuzu
- Docker: Docker Hızlı Başlangıç Kılavuzu
Proje Durumu#

Bu rozet, tüm YOLOv5 GitHub Actions Sürekli Entegrasyon (CI) testlerinin başarıyla geçtiğini gösterir. Bu CI testleri, YOLOv5'in çeşitli önemli alanlardaki işlevselliğini ve performansını titizlikle kontrol eder: eğitim, doğrulama, çıkarım, dışa aktarma ve karşılaştırmalı testler. Testler her 24 saatte bir ve her yeni işleme sonrasında yürütülerek macOS, Windows ve Ubuntu üzerinde tutarlı ve güvenilir çalışmayı güvence altına alır.
SSS#
Her nesil, 50 üyeli popülasyondaki birey başına temel senaryoyu bir kez eğitir, bu nedenle 10 epoch'luk bir COCO128 çalışmasının 300 nesli, böyle bir çalışmanın maliyetinin kabaca 15.000 katıdır. Temel senaryoyu kısa ve temsil edici tut. Yukarıdaki çoklu GPU döngüsü, tek bir aramayı paylaşmak yerine her GPU'da bağımsız bir arama başlatır, bu nedenle sabit bir bütçeyle çalışıyorsan süreç başına
--evolvedeğerini azalt.Evet.
--evolvevarsayılan olarak 300 nesildir; daha fazla çalıştırmak için--evolve 1000gibi bir sayı aktar.train.pyiçindekimetasözlüğünde bulunan girdisinin ilk değeriniFalseolarak ayarla. Hariç tutulan parametreler başlangıç değerlerini korur veevolve.pngiçinde dikey çizgiler olarak görünür.Kaydedilen dosyayı normal bir eğitim çalışmasına aktar:
python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt.