Ultralytics YOLOv5 Mimarisi#
YOLOv5 (v6.0/6.1), Ultralytics tarafından geliştirilen güçlü bir nesne algılama algoritmasıdır. Bu makalede YOLOv5 mimarisi, veri artırma stratejileri, eğitim yöntemleri ve kayıp hesaplama teknikleri derinlemesine inceleniyor. Bu kapsamlı anlayış; gözetim, otonom araçlar ve görüntü tanıma dâhil olmak üzere çeşitli alanlarda nesne algılama uygulamalarını iyileştirmene yardımcı olur.
1. Model Yapısı#
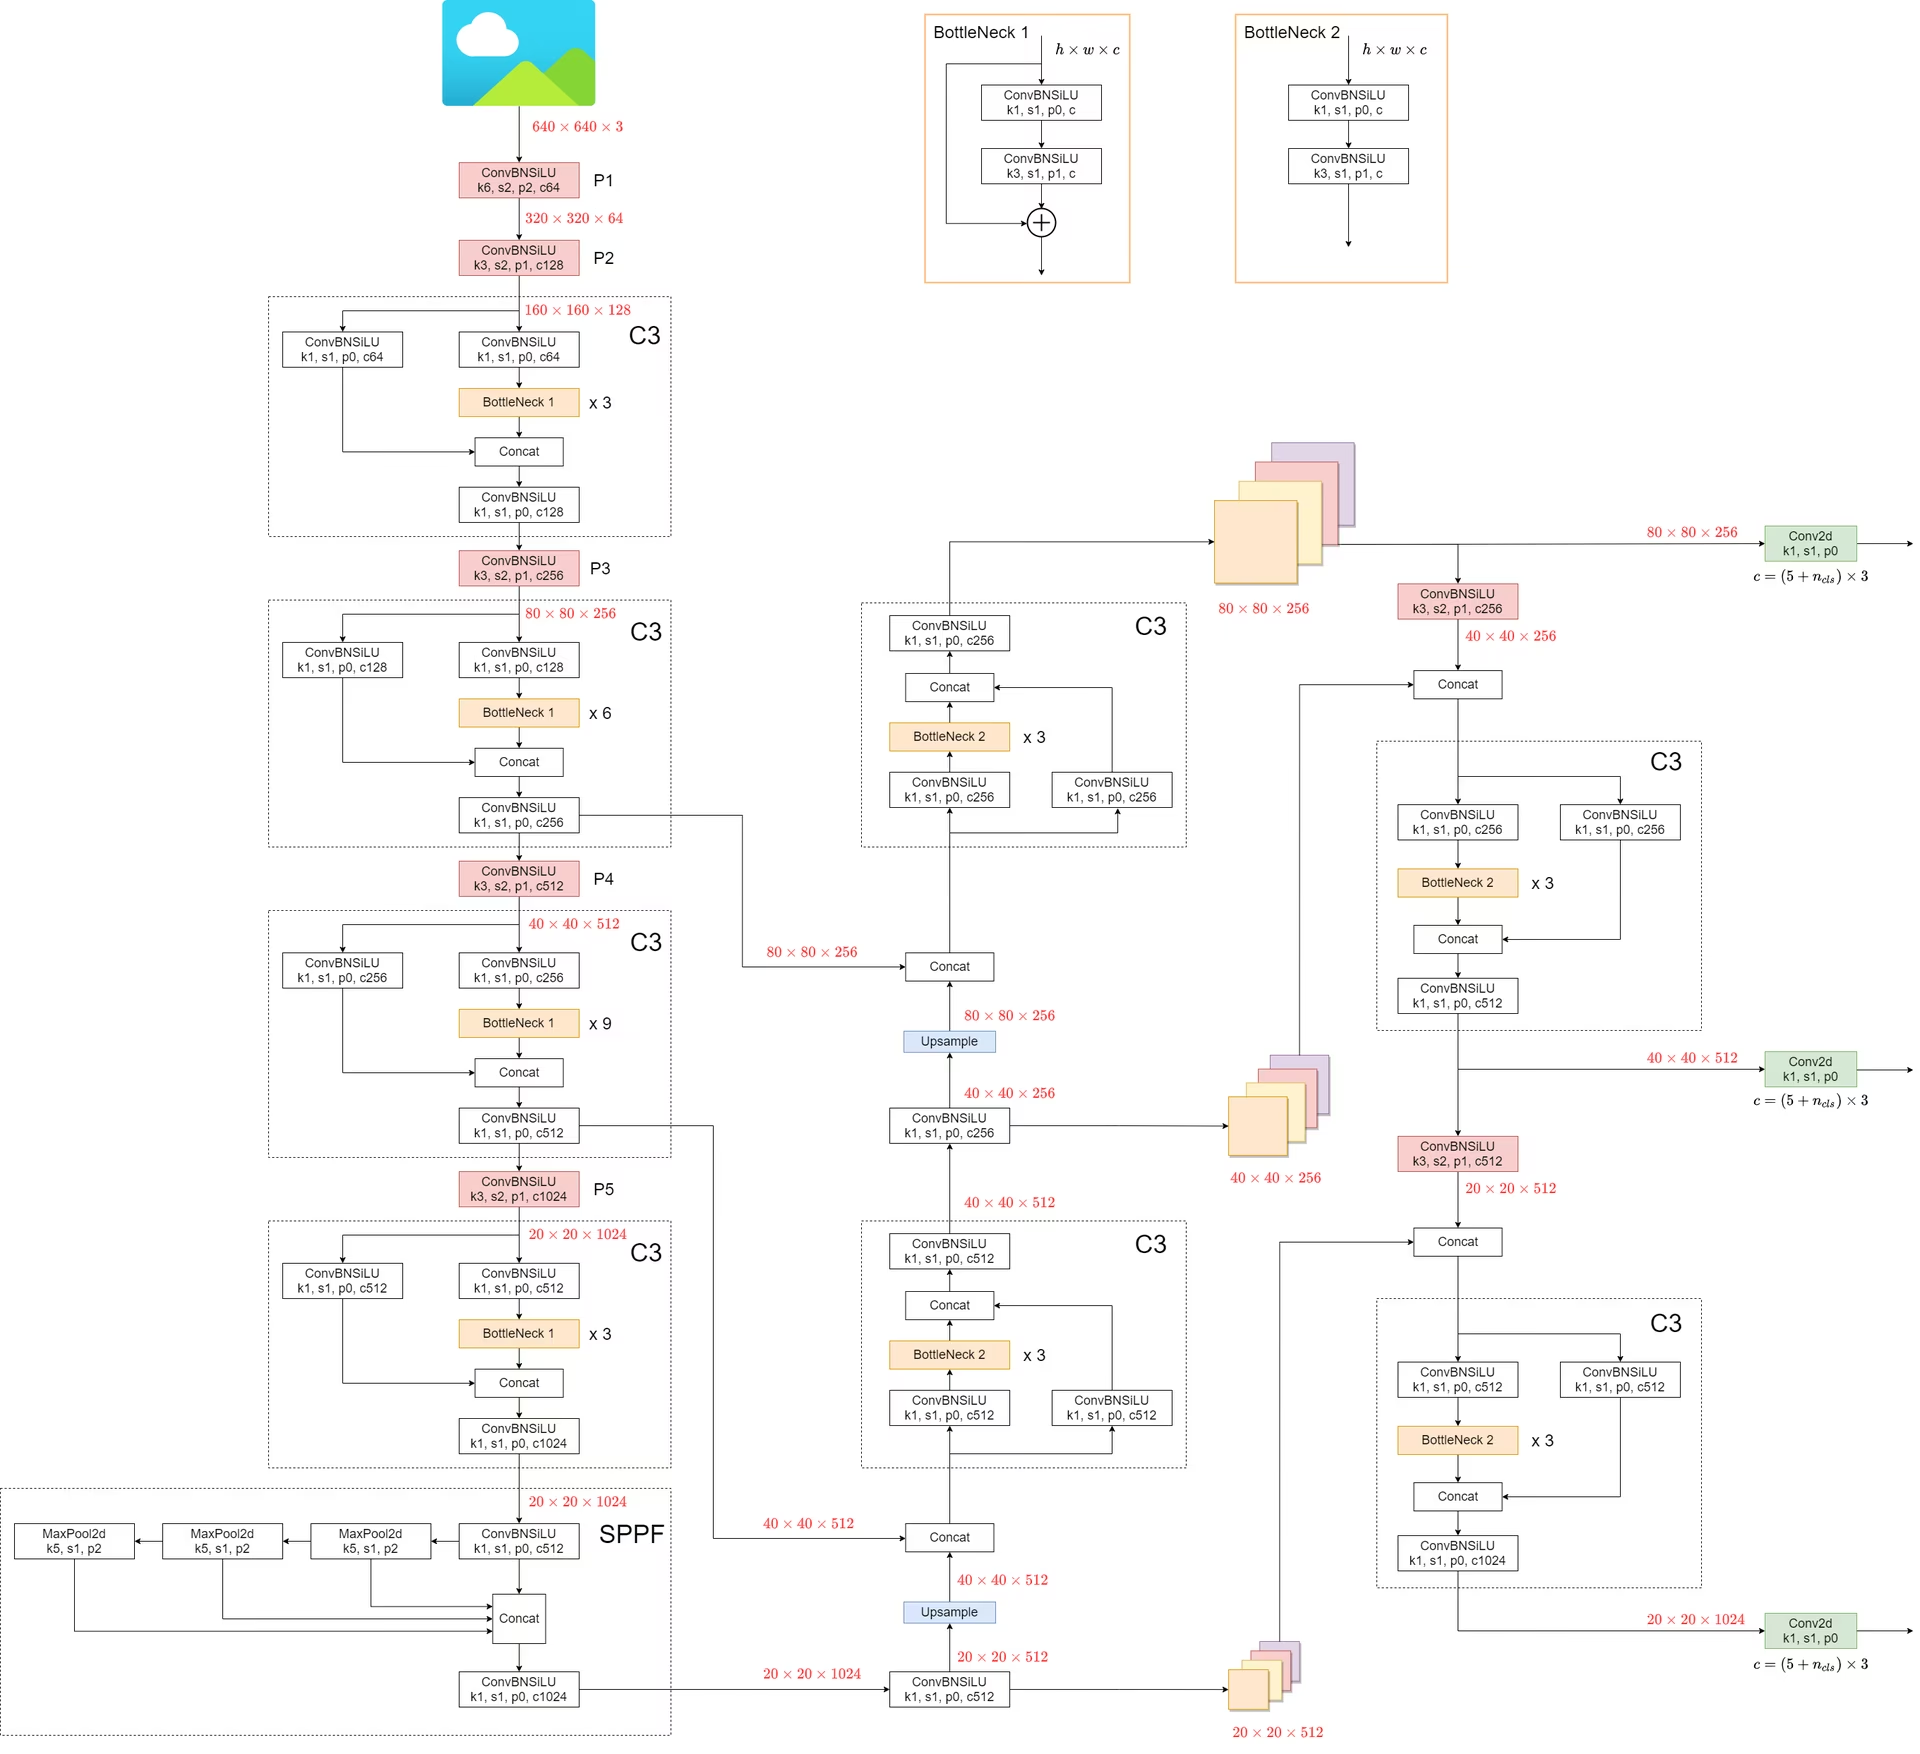
YOLOv5 mimarisi üç ana bölümden oluşur:
- Omurga: Ağın ana gövdesidir. YOLOv5'in omurgası, önceki sürümlerde kullanılan Darknet mimarisinin bir değişikliği olan
CSPDarknet53yapısıyla tasarlanmıştır. - Boyun: Bu bölüm omurgayı ve başlığı birbirine bağlar. YOLOv5'te
SPPF(Spatial Pyramid Pooling - Fast) vePANet(Path Aggregation Network) yapıları kullanılır. - Başlık: Bu bölüm son çıktıyı oluşturmaktan sorumludur. YOLOv5 bu amaçla
YOLOv3 Headkullanır.
Modelin yapısı aşağıdaki görselde gösterilmiştir. Model yapısının ayrıntılarına models/yolov5l.yaml üzerinden ulaşabilirsin.
YOLOv5, önceki sürümlerine kıyasla dikkat çekici bazı iyileştirmeler sunar:
- Önceki sürümlerde bulunan
Focusyapısının yerini6x6 Conv2dyapısı almıştır. Bu değişiklik verimliliği artırır #4825. SPPyapısının yeriniSPPFalmıştır. Bu değişiklik, aynı çıktıyı korurken işlem hızını iki kattan fazla artırır.
SPP ve SPPF hızını test etmek için aşağıdaki kod kullanılabilir:
SPP ve SPPF hız profilleme örneği (açmak için tıkla)
import time

import torch
from torch import nn

class SPP(nn.Module):
    def __init__(self):
        """Initializes an SPP module with three different sizes of max pooling layers."""
        super().__init__()
        self.maxpool1 = nn.MaxPool2d(5, 1, padding=2)
        self.maxpool2 = nn.MaxPool2d(9, 1, padding=4)
        self.maxpool3 = nn.MaxPool2d(13, 1, padding=6)

    def forward(self, x):
        """Applies three max pooling layers on input `x` and concatenates results along channel dimension."""
        o1 = self.maxpool1(x)
        o2 = self.maxpool2(x)
        o3 = self.maxpool3(x)
        return torch.cat([x, o1, o2, o3], dim=1)

class SPPF(nn.Module):
    def __init__(self):
        """Initializes an SPPF module with a specific configuration of MaxPool2d layer."""
        super().__init__()
        self.maxpool = nn.MaxPool2d(5, 1, padding=2)

    def forward(self, x):
        """Applies sequential max pooling and concatenates results with input tensor."""
        o1 = self.maxpool(x)
        o2 = self.maxpool(o1)
        o3 = self.maxpool(o2)
        return torch.cat([x, o1, o2, o3], dim=1)

def main():
    """Compares outputs and performance of SPP and SPPF on a random tensor (8, 32, 16, 16)."""
    input_tensor = torch.rand(8, 32, 16, 16)
    spp = SPP()
    sppf = SPPF()
    output1 = spp(input_tensor)
    output2 = sppf(input_tensor)

    print(torch.equal(output1, output2))

    t_start = time.time()
    for _ in range(100):
        spp(input_tensor)
    print(f"SPP time: {time.time() - t_start}")

    t_start = time.time()
    for _ in range(100):
        sppf(input_tensor)
    print(f"SPPF time: {time.time() - t_start}")

if __name__ == "__main__":
    main()
sonuç:
True
SPP time: 0.5373051166534424
SPPF time: 0.20780706405639648
2. Veri Artırma Teknikleri#
YOLOv5, modelin genelleme yeteneğini artırmak ve aşırı öğrenmeyi azaltmak için çeşitli veri artırma tekniklerinden yararlanır. Bu teknikler şunları içerir:
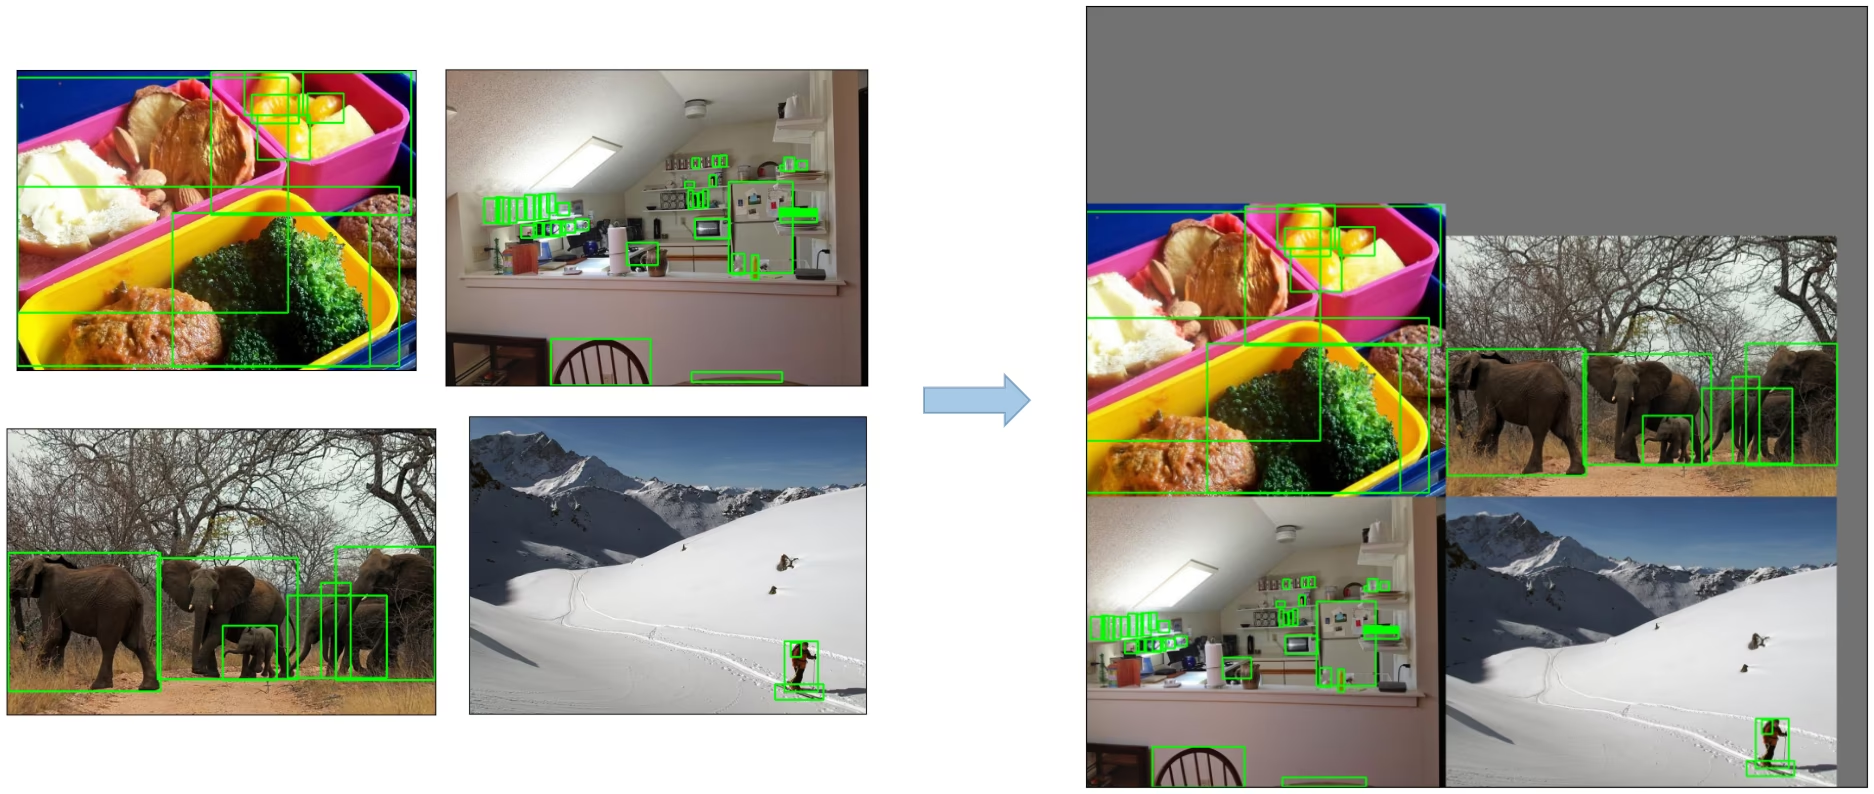
-
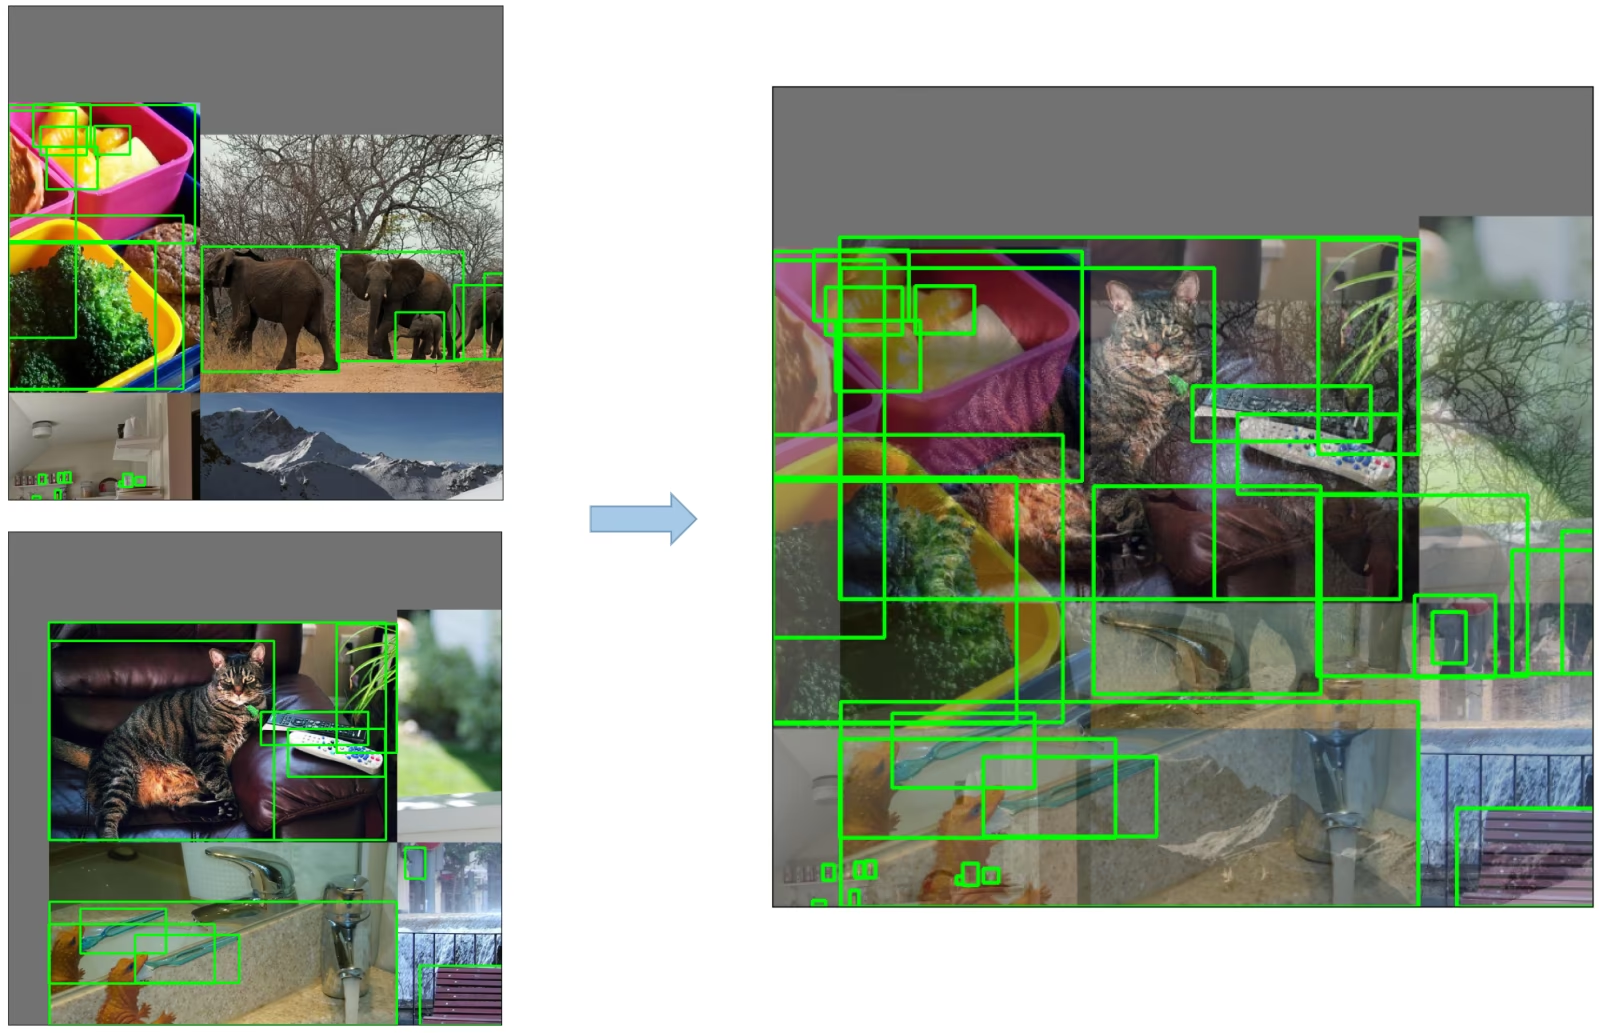
Mozaik Artırma: Nesne algılama modellerinin çeşitli nesne ölçeklerini ve ötelemeleri daha iyi ele almasını teşvik edecek şekilde dört eğitim görüntüsünü tek bir görüntüde birleştiren bir görüntü işleme tekniğidir.
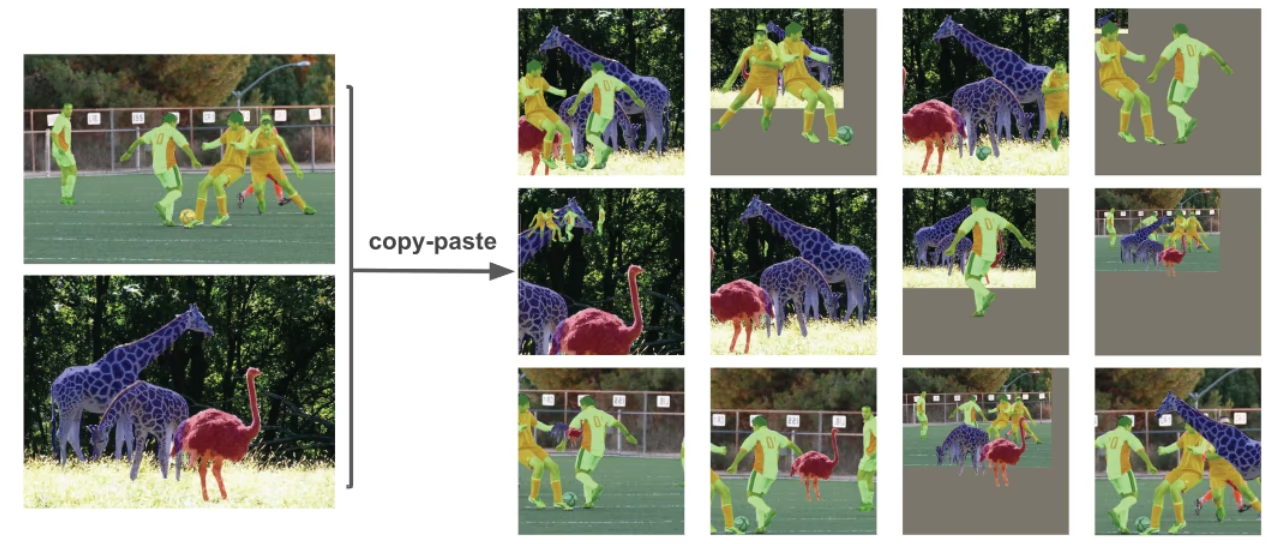
-
Kopyala-Yapıştır Artırması: Bir görüntüden rastgele parçaları kopyalayıp rastgele seçilen başka bir görüntüye yapıştırarak etkili biçimde yeni bir eğitim örneği oluşturan yenilikçi bir veri artırma yöntemidir.
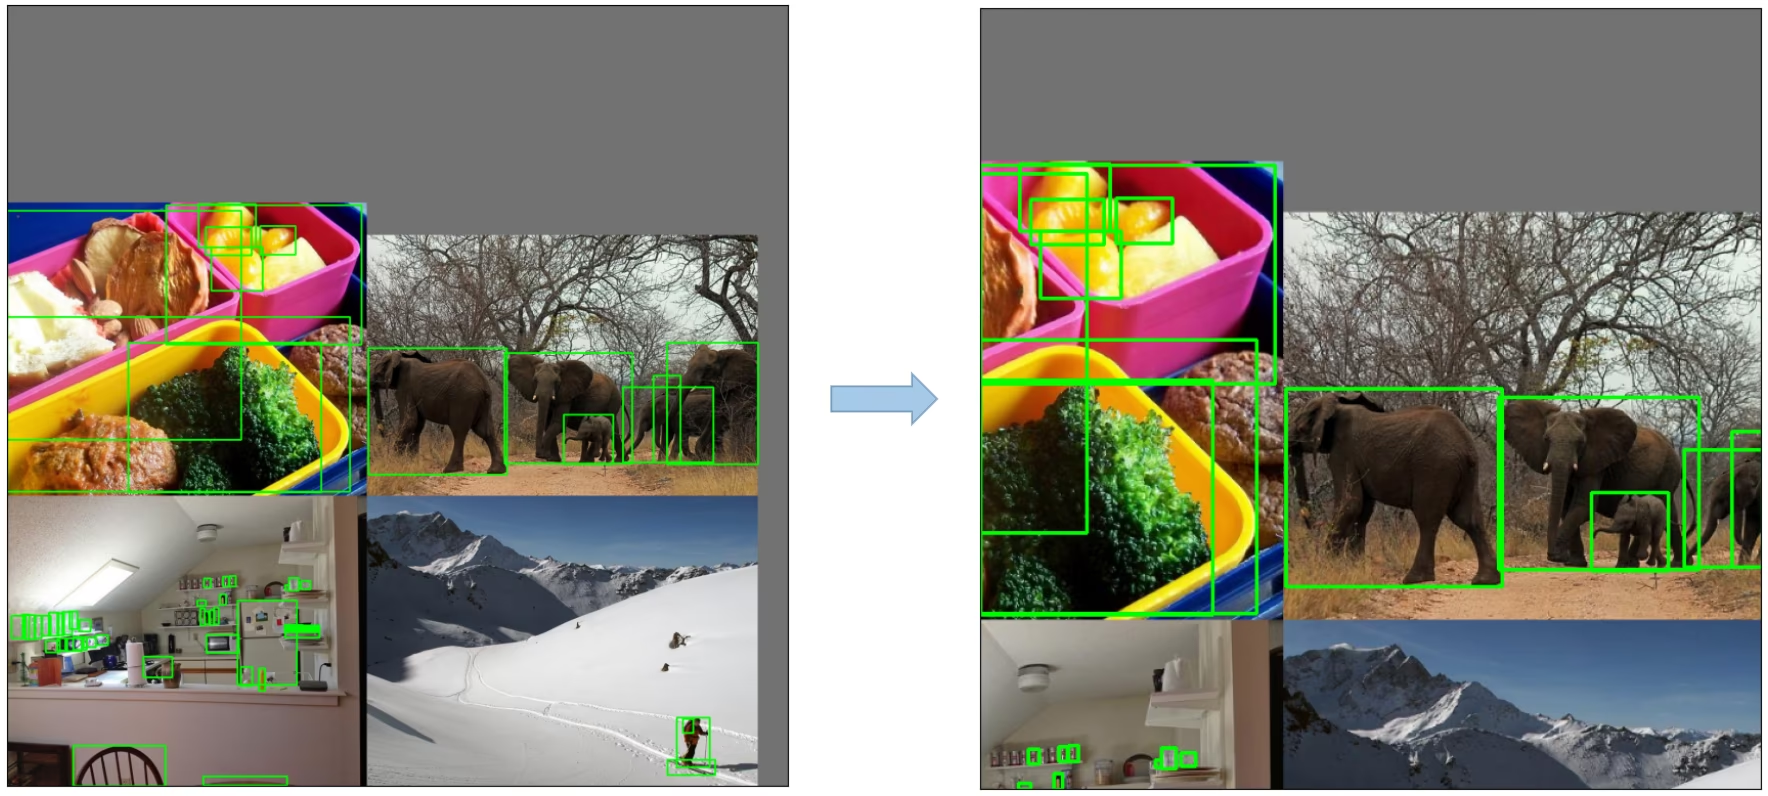
-
Rastgele Afin Dönüşümleri: Görüntülerin rastgele döndürülmesini, ölçeklendirilmesini, ötelenmesini ve kaydırılmasını içerir.
-
MixUp Artırması: İki görüntünün ve bunlarla ilişkili etiketlerin doğrusal birleşimini alarak bileşik görüntüler oluşturan bir yöntemdir.
-
Albumentations: Çok çeşitli artırma tekniklerini destekleyen güçlü bir görüntü artırma kitaplığıdır. Albumentations artırmalarını kullanma hakkında daha fazla bilgi edin.
-
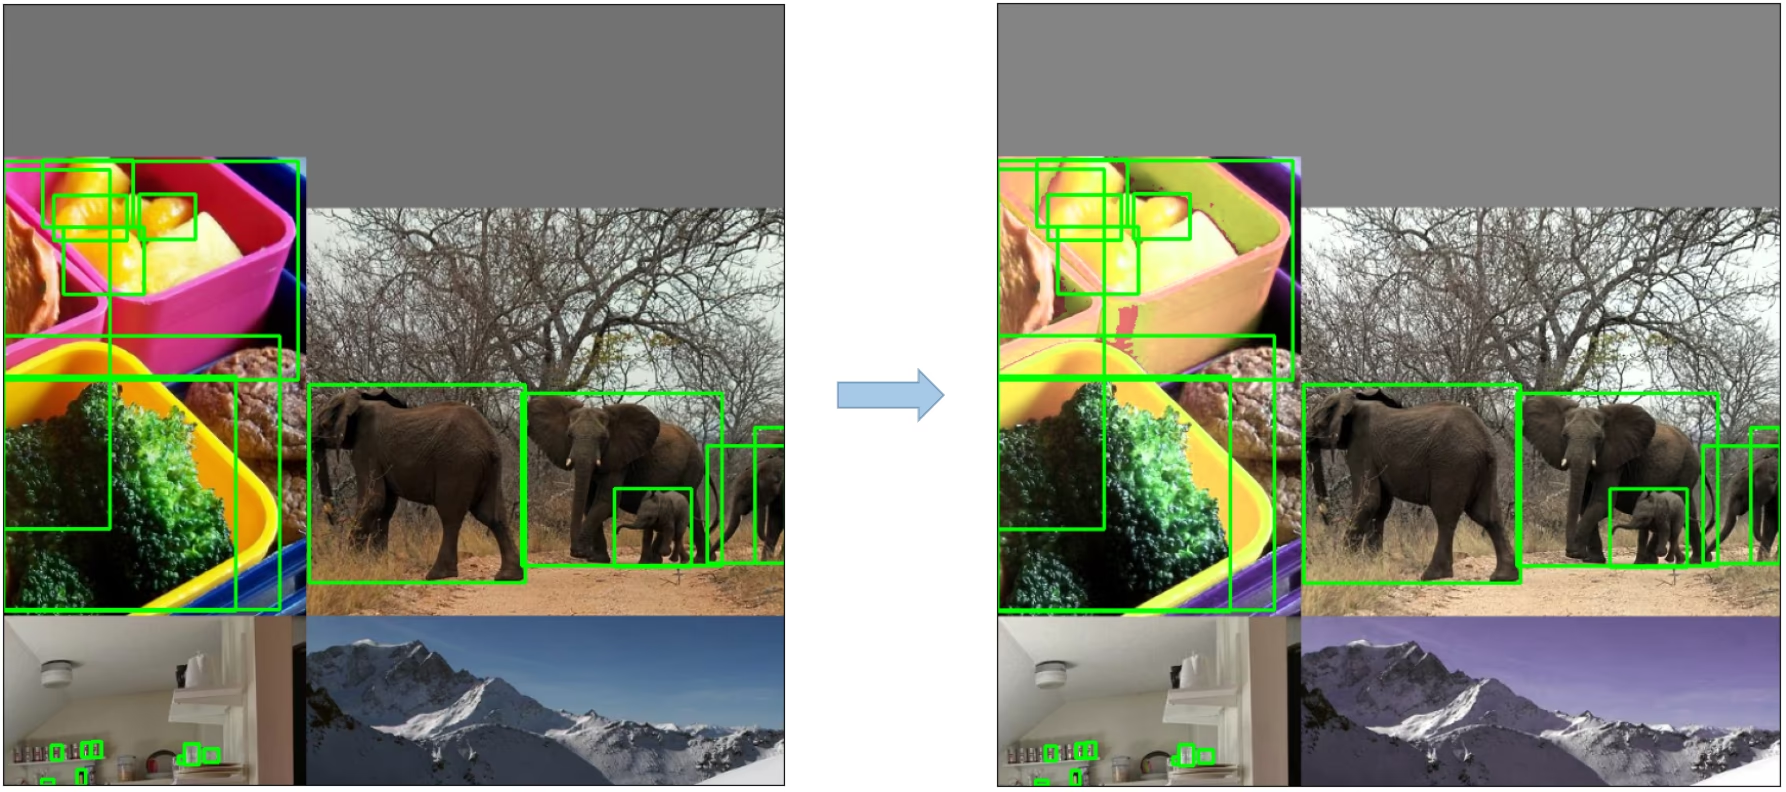
HSV Artırması: Görüntülerin Ton, Doygunluk ve Değer bileşenlerinde rastgele değişiklikler yapar.
-
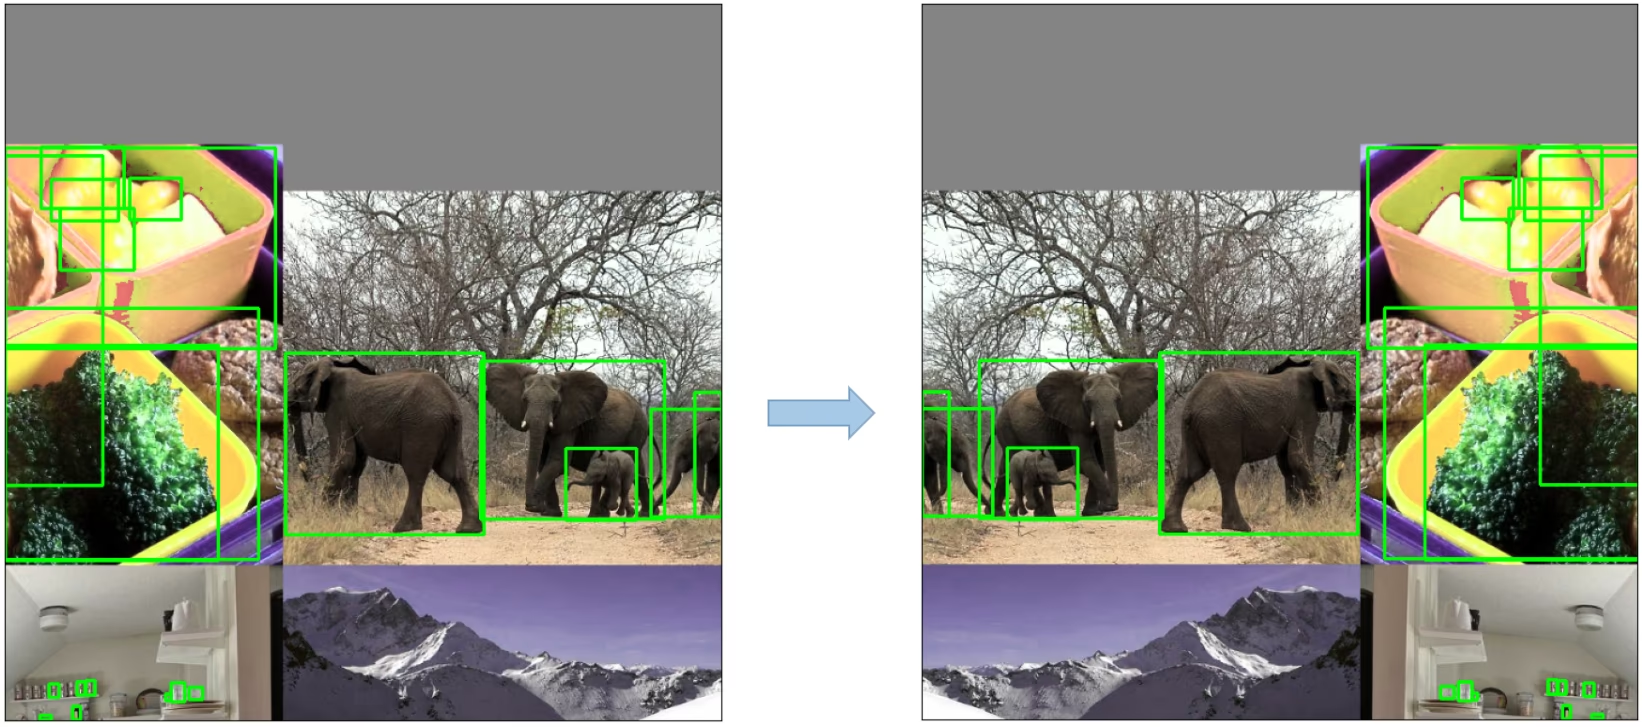
Rastgele Yatay Çevirme: Görüntüleri yatay olarak rastgele çeviren bir artırma yöntemidir.
3. Eğitim Stratejileri#
YOLOv5, model performansını artırmak için çeşitli gelişmiş eğitim stratejileri uygular. Bunlar şunlardır:
- Çok Ölçekli Eğitim: Eğitim sürecinde giriş görüntüleri, özgün boyutlarının 0,5 ila 1,5 katı arasında rastgele yeniden ölçeklendirilir.
- AutoAnchor: Bu strateji, önceden belirlenmiş anchor kutularını özel verilerindeki ground truth kutularının istatistiksel özelliklerine uyacak şekilde optimize eder.
- Warmup ve Cosine LR Scheduler: Model performansını artırmak için öğrenme oranını ayarlama yöntemi.
- Üstel Hareketli Ortalama (EMA): Eğitim sürecini kararlı hâle getirmek ve genelleme hatasını azaltmak için önceki adımlardaki parametrelerin ortalamasını kullanan bir strateji.
- Karma Hassasiyet Eğitimi: İşlemleri yarı-hassasiyet biçiminde gerçekleştirerek bellek kullanımını azaltan ve hesaplama hızını artıran bir yöntem.
- Hiperparametre Evrimi: En iyi performansı elde etmek için hiperparametreleri otomatik olarak ayarlama stratejisi. Hiperparametre Evrimi eğitimine göz at.
4. Ek Özellikler#
4.1 Kayıp Değerlerini Hesaplama#
YOLOv5'teki kayıp, üç ayrı kayıp bileşeninin birleşimi olarak hesaplanır:
- Sınıf Kaybı (BCE Kaybı): Sınıflandırma görevinin hatasını ölçen ikili çapraz entropi kaybı.
- Nesne Varlığı Kaybı (BCE Kaybı): Belirli bir ızgara hücresinde bir nesnenin bulunup bulunmadığını tespit etme hatasını hesaplayan başka bir ikili çapraz entropi kaybı.
- Konum Kaybı (CIoU Kaybı): Nesnenin ızgara hücresi içindeki konumunu belirleme hatasını ölçen Tam IoU kaybı.
Genel kayıp fonksiyonu şu şekilde gösterilir:
4.2 Kayıpları Dengeleme#
Üç tahmin katmanının (P3, P4, P5) nesne varlığı kayıpları farklı ağırlıklandırılır. Denge ağırlıkları sırasıyla [4.0, 1.0, 0.4] değerleridir. Bu yaklaşım, farklı ölçeklerdeki tahminlerin toplam kayba uygun biçimde katkıda bulunmasını sağlar.
4.3 Izgara Hassasiyetini Ortadan Kaldırma#
YOLOv5 mimarisi, kutu tahmin stratejisinde önceki YOLO sürümlerine kıyasla bazı önemli değişiklikler yapar. YOLOv2 ve YOLOv3'te kutu koordinatları, son katmanın aktivasyonu kullanılarak doğrudan tahmin ediliyordu.

Ancak YOLOv5'te kutu koordinatlarını tahmin etme formülü, ızgara hassasiyetini azaltmak ve modelin sınırsız kutu boyutları tahmin etmesini önlemek üzere güncellendi.
Tahmin edilen sınırlayıcı kutuyu hesaplamak için güncellenen formüller şöyledir:
Ölçeklendirme öncesi ve sonrası merkez noktası ofsetini karşılaştır. Merkez noktası ofset aralığı (0, 1) değerinden (-0.5, 1.5) değerine ayarlanır. Böylece ofset kolayca 0 veya 1 değerini alabilir.

Ayarlama öncesi ve sonrası yükseklik ve genişlik ölçeklendirme oranını (anchor'a göre) karşılaştır. Orijinal yolo/darknet kutu denklemlerinde ciddi bir kusur vardır. Genişlik ve yükseklik tamamen sınırsızdır; çünkü bunlar yalnızca out=exp(in) şeklinde hesaplanır. Bu durum tehlikelidir; gradyanların kontrolden çıkmasına, kararsızlığa, NaN kayıplara ve nihayetinde eğitimin tamamen başarısız olmasına yol açabilir. Daha fazla bilgi için bu soruna göz at.

4.4 Hedefleri Oluşturma#
YOLOv5'te hedef oluşturma süreci, eğitim verimliliği ve model doğruluğu açısından kritik öneme sahiptir. Bu süreç, ground truth kutularının çıktı haritasındaki uygun ızgara hücrelerine atanmasını ve uygun anchor kutularıyla eşleştirilmesini içerir.
Bu süreç şu adımları izler:
- Ground truth kutusunun boyutları ile her anchor şablonunun boyutları arasındaki oranı hesapla.

- Hesaplanan oran eşik değerinin içindeyse ground truth kutusunu karşılık gelen anchor ile eşleştir.

- Eşleştirilen anchor'ı uygun hücrelere ata. Güncellenen merkez noktası ofseti nedeniyle ground truth kutusunun birden fazla anchor'a atanabileceğini unutma: merkez noktası ofset aralığı (0, 1) değerinden (-0.5, 1.5) değerine ayarlanarak ek eşleşmeler mümkün hâle gelir.

Böylece hedef oluşturma süreci, eğitim sırasında her ground truth nesnesinin doğru biçimde atanmasını ve eşleştirilmesini sağlayarak YOLOv5'in nesne tespiti görevini daha etkili şekilde öğrenmesine olanak tanır.
Sonuç#
YOLOv5, gerçek zamanlı nesne tespitinin gelişiminde önemli bir adımdır. Mimari tercihleri, eğitim stratejileri ve mühendislik iyileştirmeleri, önceki YOLO sürümlerine kıyasla güçlü performans ve verimlilik sunar.
YOLOv5'in başlıca iyileştirmeleri arasında dinamik bir mimari, çok çeşitli veri artırma teknikleri, yenilikçi eğitim stratejileri ve kayıp değerlerinin hesaplanması ile hedef oluşturma sürecindeki önemli düzenlemeler yer alır. Tüm bu yenilikler, YOLO modellerinin alametifarikası olan yüksek hızı korurken nesne tespitinin doğruluğunu ve verimliliğini önemli ölçüde artırır.
Sık Sorulan Sorular#
CSPDarknet53 backbone'u özellikleri çıkarır, SPPF ve PANet neck'i bunları ölçekler arasında birleştirir, YOLOv3 tarzı head ise 8, 16 ve 32 stride değerlerinde kutuları, nesne varlığını ve sınıfları tahmin eder. Tüm katmanların listesi
models/yolov5l.yamliçinde yer alır.SPPF, 5x5, 9x9 ve 13x13 havuzlama işlemlerini paralel yürütmek yerine üç adet 5x5 maksimum havuzlama işlemini art arda uygular. Çıktı matematiksel olarak aynıdır ancak yukarıdaki profil oluşturma kod parçacığında gösterildiği gibi iki kattan fazla hızlı çalışır.
Orijinal YOLO ofseti tam olarak 0 veya 1 değerine ulaşamıyordu; bu nedenle ızgara sınırlarında ortalanmış nesneleri tahmin etmek zordu. Sigmoid değerini (-0.5, 1.5) aralığına ölçeklendirmek ızgara hassasiyetini ortadan kaldırır. Genişlik ve yükseklik için
2σdeğerinin karesini almak da tahminleri anchor boyutunun 4 katıyla sınırlandırarak sınırsız üstel fonksiyonun yol açtığı kontrolden çıkan gradyanları önler.Genişlik ve yükseklik oranları
anchor_t(varsayılan olarak 4.0) değerinin içinde kalan tüm anchor'lar eşleşir. Genişletilmiş ofset aralığı, kutunun bitişikteki iki ızgara hücresine de atanabilmesini sağlar. Böylece tek bir nesne birkaç pozitif hedef oluşturabilir ve yakınsama hızlanır.