TFLite 模型导出用于部署(已弃用)#
自 Ultralytics 8.4.83 起,独立的 tflite 导出格式已被移除,并由统一的 Google LiteRT 格式取代。LiteRT(Lite Runtime)是 TensorFlow Lite 的新一代版本和新名称,并且导出的是相同的 .tflite 模型——现在可通过一种格式覆盖移动设备、嵌入式设备、边缘设备和浏览器部署。
format="tflite" 仍可使用,但会发出弃用警告,并改为导出 LiteRT 模型。后续请使用 format="litert";如需了解当前的导出说明和选项,请参阅 LiteRT 导出指南。
在边缘设备或嵌入式设备上部署计算机视觉模型,需要使用能够确保流畅运行的格式。
原有的 TensorFlow Lite 或 TFLite 导出格式可针对边缘应用中的目标检测和图像分类等任务优化 Ultralytics YOLO26 模型。本指南保留了旧版 TFLite 部署背景;新导出请使用 LiteRT。
为什么使用 TFLite 导出?#
TensorFlow Lite(简称 TFLite)由 Google 于 2017 年 5 月作为 TensorFlow 框架的一部分推出,是一种开源深度学习框架,专为设备端推理而设计,也称为边缘计算。它为开发者提供了工具,可在移动设备、嵌入式设备和物联网设备以及传统计算机上运行训练好的模型。
TensorFlow Lite 支持多种平台,包括嵌入式 Linux、Android、iOS 和微控制器(MCU)。TFLite 导出模型可让应用在本地离线运行。
TFLite 模型的主要功能#
TFLite 模型具备多种关键功能,可帮助开发者在移动设备、嵌入式设备和边缘设备上运行模型,从而实现设备端机器学习:
-
设备端优化:TFLite 针对设备端机器学习进行优化,通过在本地处理数据来降低延迟,通过不传输个人数据来增强隐私保护,并通过缩小模型尺寸来节省空间。
-
支持多种平台:TFLite 具有广泛的平台兼容性,支持 Android、iOS、嵌入式 Linux 和微控制器。
-
支持多种语言:TFLite 兼容多种编程语言,包括 Java、Swift、Objective-C、C++ 和 Python。
-
高性能:通过硬件加速和模型优化实现卓越性能。
实测性能(历史数据)#
这些结果是在 Android 16/API 36 上,使用 Ultralytics Flutter 插件 0.6.8 和 LiteRT 2.1.5 测得的,测试设备为配备 12 GB LPDDR5X 内存的 Xiaomi 17。其 3 nm Snapdragon 8 Elite Gen 5(SM8850)搭载 8 核 Qualcomm Oryon CPU(2 个 Prime 核心,最高 4.6 GHz;6 个 Performance 核心,最高 3.62 GHz)、Adreno GPU 和 Hexagon NPU。这些表格比较了旧版 onnx2tf INT8 TFLite 资源与迁移期间评估的候选 litert-torch 导出模型。随后,发布资源已被标准化导出模型覆盖,因此这些数字并不代表当前 v0.6.6 资源文件的字节内容。当前测量结果请参阅 LiteRT 性能表。
两种格式均在同一轮连续 GPU 测试中以所示输入尺寸运行。每个单元格显示总耗时 (预处理 + 推理 + 后处理),下方列出了各阶段的耗时明细;原生日志确认,两种格式都通过 LiteRT OpenCL(LITERT_CL)将完整计算图交由 Adreno GPU 执行。
| 模型 | 任务 | 尺寸 (像素) | 旧版 onnx2tf INT8 TFLite (毫秒) | 候选 w8a32 LiteRT (毫秒) |
|---|---|---|---|---|
| YOLO26n | 检测 | 640 | 14.0 1.8 / 8.1 / 4.2 | 13.5 1.9 / 8.1 / 3.5 |
| YOLO26n-seg | 分割 | 640 | 30.1 1.9 / 20.3 / 8.0 | 28.6 1.8 / 20.1 / 6.7 |
| YOLO26n-sem | 语义 | 640 | 26.4 1.9 / 16.4 / 8.1 | 32.9 1.8 / 23.0 / 8.2 |
| YOLO26n-cls | 分类 | 224 | 3.5 0.9 / 2.2 / 0.4 | 3.2 1.0 / 2.2 / 0.1 |
| YOLO26n-pose | 姿态 | 640 | 17.4 2.4 / 9.9 / 5.1 | 14.0 1.9 / 9.3 / 2.8 |
| YOLO26n-obb | OBB | 640 | 13.9 3.0 / 8.3 / 2.7 | 13.0 2.9 / 7.9 / 2.3 |
同一迁移过程还比较了 YOLO26n 检测模型的量化格式。推理时间是可比较且取决于格式的指标:
| Android 格式 | GPU 推理(毫秒) | GPU 编译 |
|---|---|---|
| onnx2tf INT8(旧版 TFLite) | 8.6 | 是 |
| LiteRT w8a32(候选) | 8.4 | 是 |
LiteRT INT8(quantize=8) | 11.0 | 是 |
| LiteRT FP32 | 8.8 | 是 |
LiteRT w8a16(quantize="w8a16") | CPU 回退 | 否 |
在本次测试中,w8a16 回退到 CPU 执行,总耗时约 660 毫秒;GPU 格式的耗时约为 17 毫秒。这些结果促使我们发布 w8a32,但委托兼容性和性能取决于设备及运行时版本。请在目标设备上进行基准测试,并在运行时日志中确认加速器的执行位置。
TFLite 部署选项#
在查看 LiteRT 替代导出示例之前,先了解 TFLite 模型的常见用法。
TFLite 为机器学习模型提供多种设备端部署选项,包括:
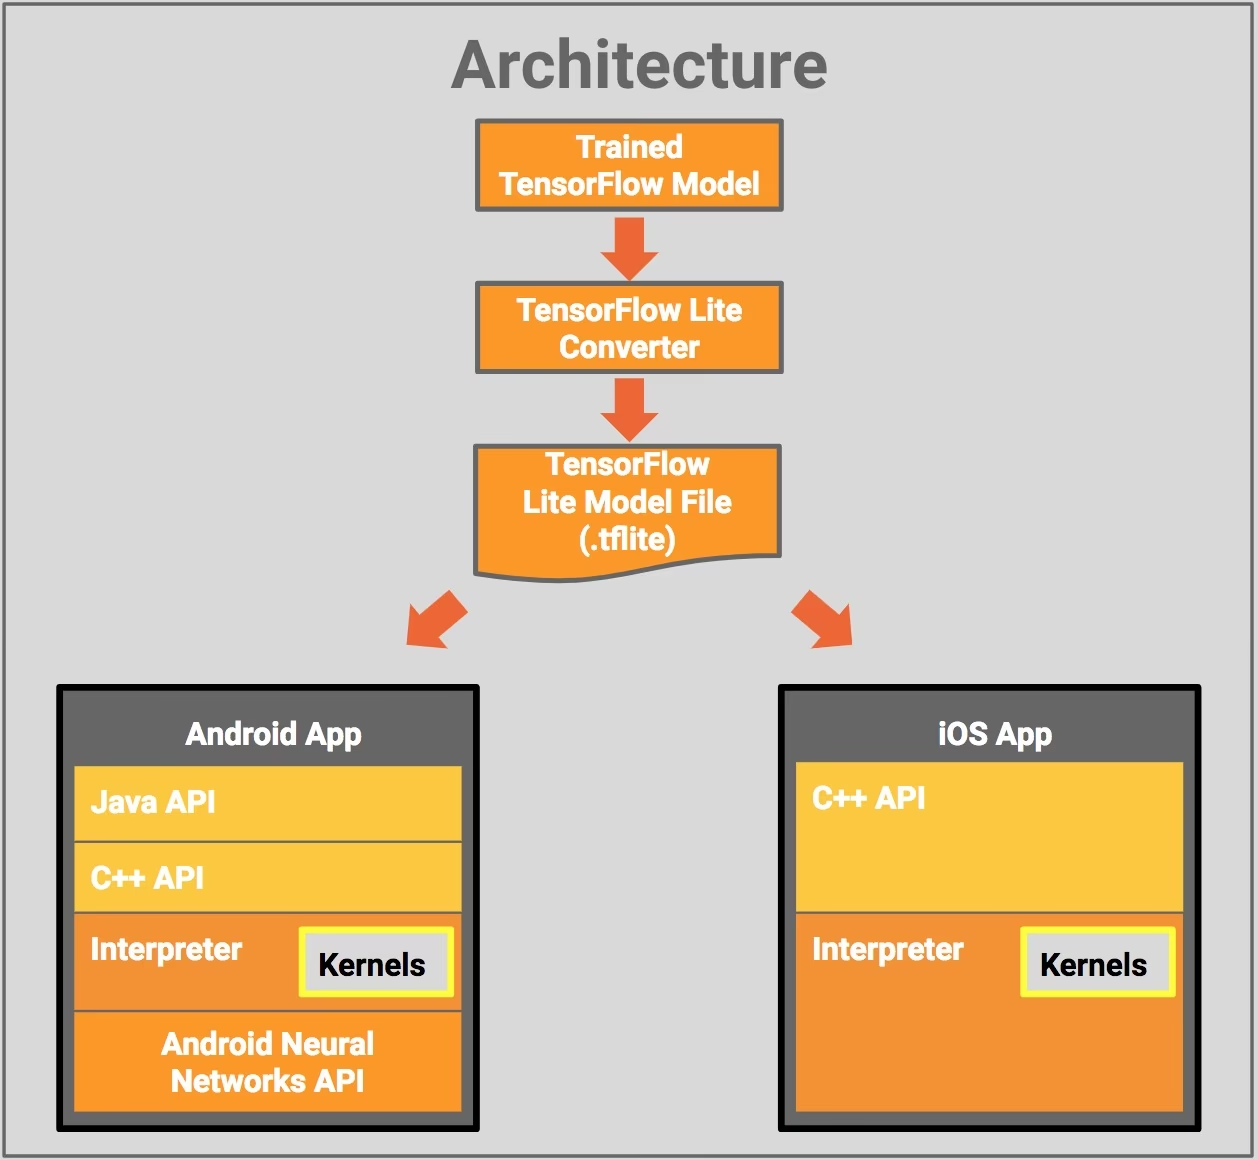
- 使用 Android 和 iOS 部署:搭载 TFLite 的 Android 和 iOS 应用都可以分析边缘摄像头画面和传感器数据,以检测和识别物体。TFLite 还提供使用 Swift 和 Objective-C 编写的原生 iOS 库。下方的架构图展示了如何使用 TensorFlow Lite 将训练好的模型部署到 Android 和 iOS 平台。
-
在嵌入式 Linux 上运行:如果使用 Ultralytics 指南在 Raspberry Pi 上运行推理无法满足你的用例对速度的要求,你可以使用导出的 TFLite 模型来加快推理速度。此外,还可以借助 Coral Edge TPU 设备进一步提升性能。
-
在微控制器上部署:TFLite 模型还可部署到微控制器及其他内存仅有几 KB 的设备上。核心运行时在 Arm Cortex M3 上仅占用 16 KB 空间,并可运行许多基础模型。它不需要操作系统支持、任何标准 C 或 C++ 库,也不需要动态内存分配。
用 LiteRT 替代 TFLite 导出#
新导出请将模型转换为 LiteRT 格式。生成的模型仍使用 .tflite 文件扩展名。
安装#
运行以下命令安装所需的软件包:
# Install the required package for YOLO26
pip install ultralytics
有关安装流程的详细说明和最佳实践,请查看我们的 Ultralytics 安装指南。安装 YOLO26 所需的软件包时,如果遇到困难,请查阅我们的常见问题指南,获取解决方案和建议。
用法#
所有 Ultralytics YOLO26 模型均支持开箱即用的导出,便于你将模型集成到首选的部署工作流中。你可以查看支持的导出格式和配置选项的完整列表,为你的应用选择最佳配置。
替代用的 LiteRT 格式支持 导出、预测和验证模式。导出模型后,加载导出的 .tflite 模型即可运行推理或验证其精度。
from ultralytics import YOLO

# 加载 YOLO26 模型
model = YOLO("yolo26n.pt")

# 将模型导出为 LiteRT 格式
model.export(format="litert", imgsz=640) # 分类任务使用 imgsz=224from ultralytics import YOLO
# 加载导出的 TFLite 模型
model = YOLO("yolo26n.tflite")
# 运行推理
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# 加载导出的 TFLite 模型
model = YOLO("yolo26n.tflite")
# 在 COCO8 数据集上验证准确率
metrics = model.val(data="coco8.yaml")导出参数#
| 参数 | 类型 | 默认值 | 说明 |
|---|---|---|---|
format | str | 'litert' | 导出模型的目标格式,用于定义与各种部署环境的兼容性。 |
imgsz | int 或 tuple | 640 | 模型输入所需的图像尺寸。正方形图像可使用整数;若要指定具体尺寸,则可使用元组 (height, width)。 |
quantize | int 或 str | None | 量化精度:8(静态 INT8,int8 权重 + int8 激活;需要校准 data/fraction)、'w8a16'(静态,int8 权重 + int16 激活;需要校准 data/fraction)、'w8a32'(动态 INT8,int8 权重 + FP32 激活;无需校准),或 32/未设置(FP32)。FP16 不会单独导出 — FP32 模型会在 GPU 委托程序上自动以 FP16 运行。此选项取代了已弃用的 half/int8 标志。 |
batch | int | 1 | 指定导出模型的批量推理大小,或导出模型在 predict 模式下可同时处理的最大图像数。 |
data | str | None | 数据集 YAML 文件的路径,是量化所必需的;分类任务则使用数据集目录或内置数据集名称。如果在使用 quantize=8 或 'w8a16' 时未指定,Ultralytics 会根据模型任务选择默认校准数据集。 |
fraction | float、int 或 list | 1.0 | 校准子集,可按比例、图像数量或 [train, val, test] 比例/数量指定。包含两个项目的列表会让 test 保持完整,而 0 会跳过它。 |
device | str | None | 指定导出设备:CPU (device=cpu),Apple 芯片上的 MPS (device=mps)。 |
有关导出流程的更多详情,请访问 Ultralytics 导出文档页面。
部署导出的 YOLO26 TFLite 模型#
将 Ultralytics YOLO26 模型导出为 LiteRT 格式后,你就可以部署生成的 .tflite 模型。运行 TFLite 模型时,首要且推荐的第一步是使用 YOLO("model.tflite") 方法,如前面的用法代码片段所示。不过,如果你需要了解如何在其他各种环境中部署 TFLite 模型,请参阅以下资源:
-
Android:快速入门指南,介绍如何将 TensorFlow Lite 集成到 Android 应用中,并提供易于遵循的步骤来设置和运行机器学习模型。
-
iOS:查看这份面向开发者的详细指南,了解如何在 iOS 应用中集成和部署 TensorFlow Lite 模型,其中提供了逐步说明和相关资源。
-
端到端示例:此页面概述了各种 TensorFlow Lite 示例,展示了实用应用和教程,旨在帮助开发者在移动设备和边缘设备的机器学习项目中实现 TensorFlow Lite。
总结#
本指南保留了旧版 TFLite 部署工作流程。新导出请使用 LiteRT,为边缘计算环境创建 .tflite 模型。
如需了解更多使用详情,请访问 TFLite 官方文档。
另外,如果你想了解其他 Ultralytics YOLO26 集成方案,请查看我们的集成指南页面。你可以在那里找到大量实用信息和见解。
常见问题#
新导出请使用 LiteRT 格式。首先,使用以下命令安装所需软件包:
pip install ultralytics然后,使用以下代码片段导出模型:
from ultralytics import YOLO

# 加载 YOLO26 模型
model = YOLO("yolo26n.pt")

# 将模型导出为 LiteRT 格式
model.export(format="litert", imgsz=640)  # 分类任务使用 imgsz=224
CLI 用户可以使用以下命令完成操作:
yolo export model=yolo26n.pt format=litert imgsz=640 # use imgsz=224 for classification如需了解更多详情,请访问 Ultralytics 导出指南。
可以,你可以在 Raspberry Pi 上运行 YOLO26 TFLite 模型,以提高推理速度。首先,按照上文说明将模型导出为 LiteRT 格式。然后,使用 TensorFlow Lite Interpreter 等工具在 Raspberry Pi 上运行模型。
如需进一步优化,可以考虑使用 Coral Edge TPU。详细步骤请参阅我们的 Raspberry Pi 部署指南和 Edge TPU 集成指南。
TFLite 支持在资源有限的微控制器上部署:其核心运行时在 Arm Cortex M3 上仅需 16 KB 内存,并可运行许多基础模型。不过,YOLO26 模型通常对于典型微控制器的内存容量来说过大,因此单板计算机、移动设备或专用加速器更适合运行 YOLO26。
如需开始使用,请访问 TFLite Micro 微控制器指南。
TensorFlow Lite 具有广泛的平台兼容性,因此你可以在多种设备上部署 YOLO26 模型,包括:
- Android 和 iOS:通过 TFLite Android 和 iOS 库提供原生支持。
- 嵌入式 Linux:适用于 Raspberry Pi 等单板计算机。
- 微控制器:适用于资源受限的 MCU。
如需详细了解部署选项,请参阅我们的部署指南。