模型训练
Ultralytics Platform提供训练 YOLO 模型的工具,涵盖实验管理以及通过实时指标流运行云端训练任务。
观看: 开始使用 Ultralytics Platform - 训练
概述#
训练部分可帮助你:
工作流#
训练选项#
Ultralytics Platform 支持多种训练方式:
| 方法 | 说明 | 适用场景 |
|---|---|---|
| 云端训练 | 使用 Ultralytics Cloud GPU 进行训练 | 无需本地 GPU,具备可扩展性 |
| 本地训练 | 在本地训练,并将指标流式传输到平台 | 使用现有硬件,保障隐私 |
| Colab 训练 | 将 Google Colab 与平台集成使用 | 免费使用 GPU |
当你选择的 GPU 比 RTX PRO 6000 便宜,且 Ultralytics 管理的算力有空闲时,Platform 会让你的任务使用 RTX PRO 6000,但仍按你所选 GPU 的每小时费率计费。任务可能更快完成,成本也可能低于使用所选 GPU 的情况——升级绝不会增加耗时或费用。
GPU 选项#
Ultralytics Cloud 云端训练可用的 GPU:
| GPU | 代际 | 显存 | 适用场景 |
|---|---|---|---|
| RTX 2000 Ada | Ada | 16 GB | 小型数据集、测试 |
| RTX A4500 | Ampere | 20 GB | 小型到中型数据集 |
| RTX A5000 | Ampere | 24 GB | 中型数据集 |
| RTX 4000 Ada | Ada | 20 GB | 中型数据集 |
| RTX 3090 | Ampere | 24 GB | 通用训练 |
| RTX PRO 4000 | Blackwell | 24 GB | 经济型 Blackwell |
| L4 | Ada | 24 GB | 针对推理优化 |
| A40 | Ampere | 48 GB | 较大的批次大小 |
| RTX A6000 | Ampere | 48 GB | 大型模型 |
| RTX PRO 4500 | Blackwell | 32 GB | 性价比出色 |
| L40 | Ada | 48 GB | 大型模型 |
| RTX 4090 | Ada | 24 GB | 通用训练 |
| RTX PRO 5000 | Blackwell | 48 GB | 大批次训练 |
| RTX 6000 Ada | Ada | 48 GB | 大批次训练 |
| L40S | Ada | 48 GB | 大批次训练 |
| RTX 5090 | Blackwell | 32 GB | 最新一代消费级产品 |
| A100 PCIe | Ampere | 80 GB | 生产环境训练 |
| A100 SXM | Ampere | 80 GB | 生产环境训练 |
| RTX PRO 6000 | Blackwell | 96 GB | 推荐默认选项 |
| H100 PCIe | Hopper | 80 GB | 高性能训练 |
| H100 NVL | Hopper | 94 GB | 最高性能 |
| H200 NVL | Hopper | 143 GB | 最大显存 |
| H100 SXM | Hopper | 80 GB | 最快的训练 |
| H200 SXM | Hopper | 141 GB | 最高性能 |
| B200 | Blackwell | 180 GB | 大型模型(Pro+) |
| B300 | Blackwell | 288 GB | 最大型模型(Pro+) |
当前每小时价格显示在训练对话框的 GPU 选择器和定价页面上。
B200 和 B300 GPU 需要Pro 或 Enterprise 套餐。其他所有 GPU 均适用于所有套餐,包括 Free 套餐。
新账户会获得训练注册赠金。详情请查看账单。
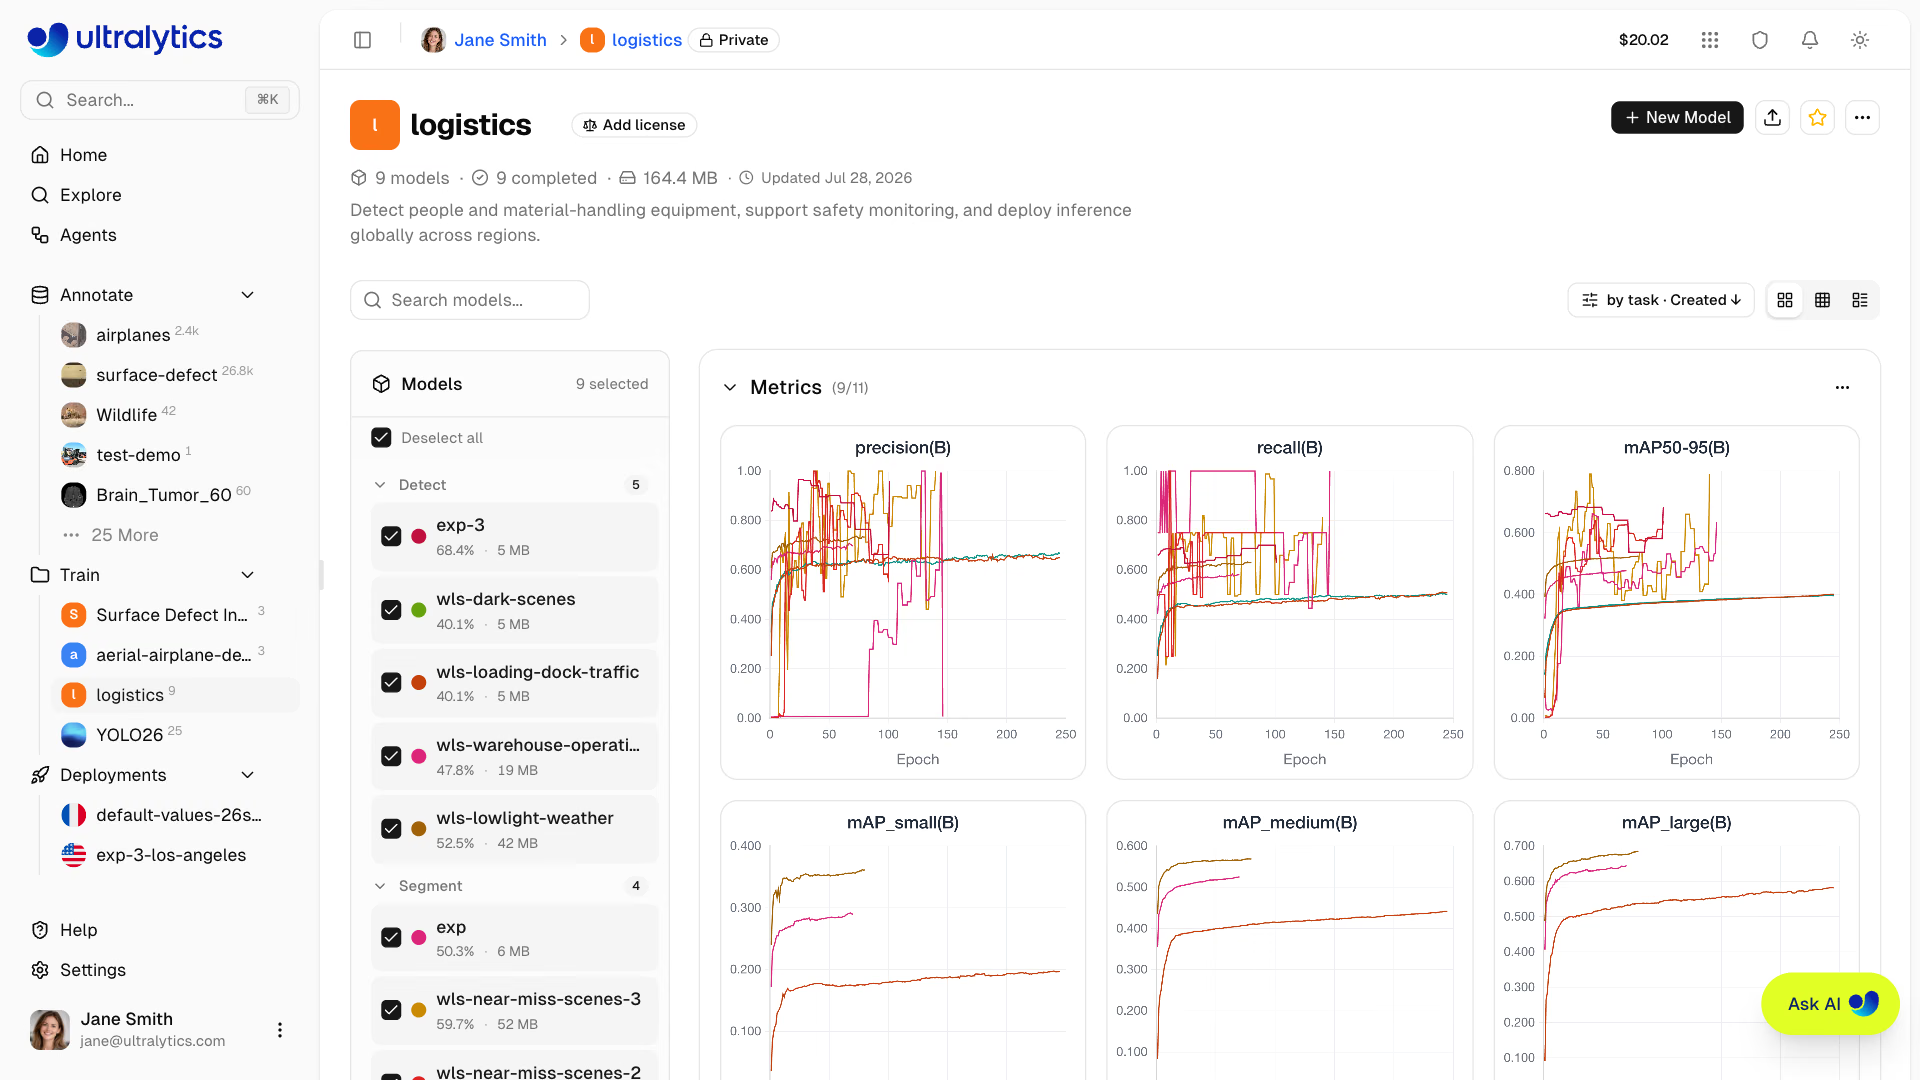
实时指标#
在模型的 Train 选项卡中查看实时指标和可用的验证结果:
| 子选项卡 | 指标 |
|---|---|
| 指标 | 任务指标(检测任务的 mAP50、mAP50-95、精确率、召回率)、训练/验证损失、学习率 |
| 验证 | 可用时显示已记录的验证图表和逐图像分析结果 |
| 控制台 | 带 ANSI 颜色的实时训练日志和自动错误检测 |
| 系统 | GPU 利用率、GPU 内存和温度、CPU、RAM、网络和磁盘 I/O |
最佳检查点(best.pt,即适应度最高的轮次)会在训练运行期间定期上传到 Platform,并在运行结束时再次上传,因此下载、导出和部署始终会使用迄今为止生成的最佳轮次。已取消的运行会保留最后一个完成上传的检查点。
快速入门#
不到一分钟即可开始云端训练:
- 在侧边栏中创建项目
- 点击 New Model
- 选择模型、数据集和 GPU
- 点击 Start Training
快速链接#
常见问题#
训练时间取决于:
- 数据集大小(图像数量)
- 模型大小(n、s、m、l、x)
- 轮数
- 所选 GPU 类型
当前估算器预测,在 RTX PRO 6000 上使用 YOLO26n 训练 1000 张图像 100 个周期约需 6 分钟,而在 RTX 4090 上使用 YOLO26n 训练 500 张图像 50 个周期约需 2 分钟。实际耗时会有所不同;请在训练 对话框中查看针对所选数据集和配置的实时估算。
可以。并发云端训练数量上限取决于你的套餐:Free 支持 3 个,Pro 支持 10 个,Enterprise 不限数量。如需更多并行训练任务,可在多台机器上使用远程训练。
如果训练失败:
- 模型会被标记为失败,计算实例也会被终止
- 模型页面会显示错误横幅,其中包含捕获到的错误、指向控制台输出的链接,以及 使用 AI 诊断和 Retry Training 操作(Editor 角色或更高权限),点击后会重新打开训练对话框并保留相同配置
- 如果某个运行连续 4 小时没有报告活动,就会自动标记为失败,并释放其计算资源
- 如果云端计算已启动,则会按已用 GPU 时间计费;计算启动前失败则不会产生 GPU 使用费用
场景 推荐 GPU 大多数训练任务 RTX PRO 6000 大型数据集或批次大小 H100 SXM 或 H200 注重预算 RTX 4090


评论
提出问题、分享结果,或帮助其他人。