نشر YOLO26 على الأجهزة المحمولة والطرفية باستخدام ExecuTorch
يتطلب نشر نماذج الرؤية الحاسوبية على أجهزة الحافة، مثل الهواتف الذكية والأجهزة اللوحية والأنظمة المضمنة، بيئة تشغيل محسّنة توازن بين الأداء وقيود الموارد. يتيح ExecuTorch، وهو حل PyTorch لـالحوسبة الطرفية، استدلالًا فعالًا على الجهاز لنماذج Ultralytics YOLO.
يوضح هذا الدليل كيفية تصدير نماذج Ultralytics YOLO إلى تنسيق ExecuTorch، ما يتيح لك نشر نماذجك على الأجهزة المحمولة والطرفية بأداء محسّن.
لماذا التصدير إلى ExecuTorch؟#
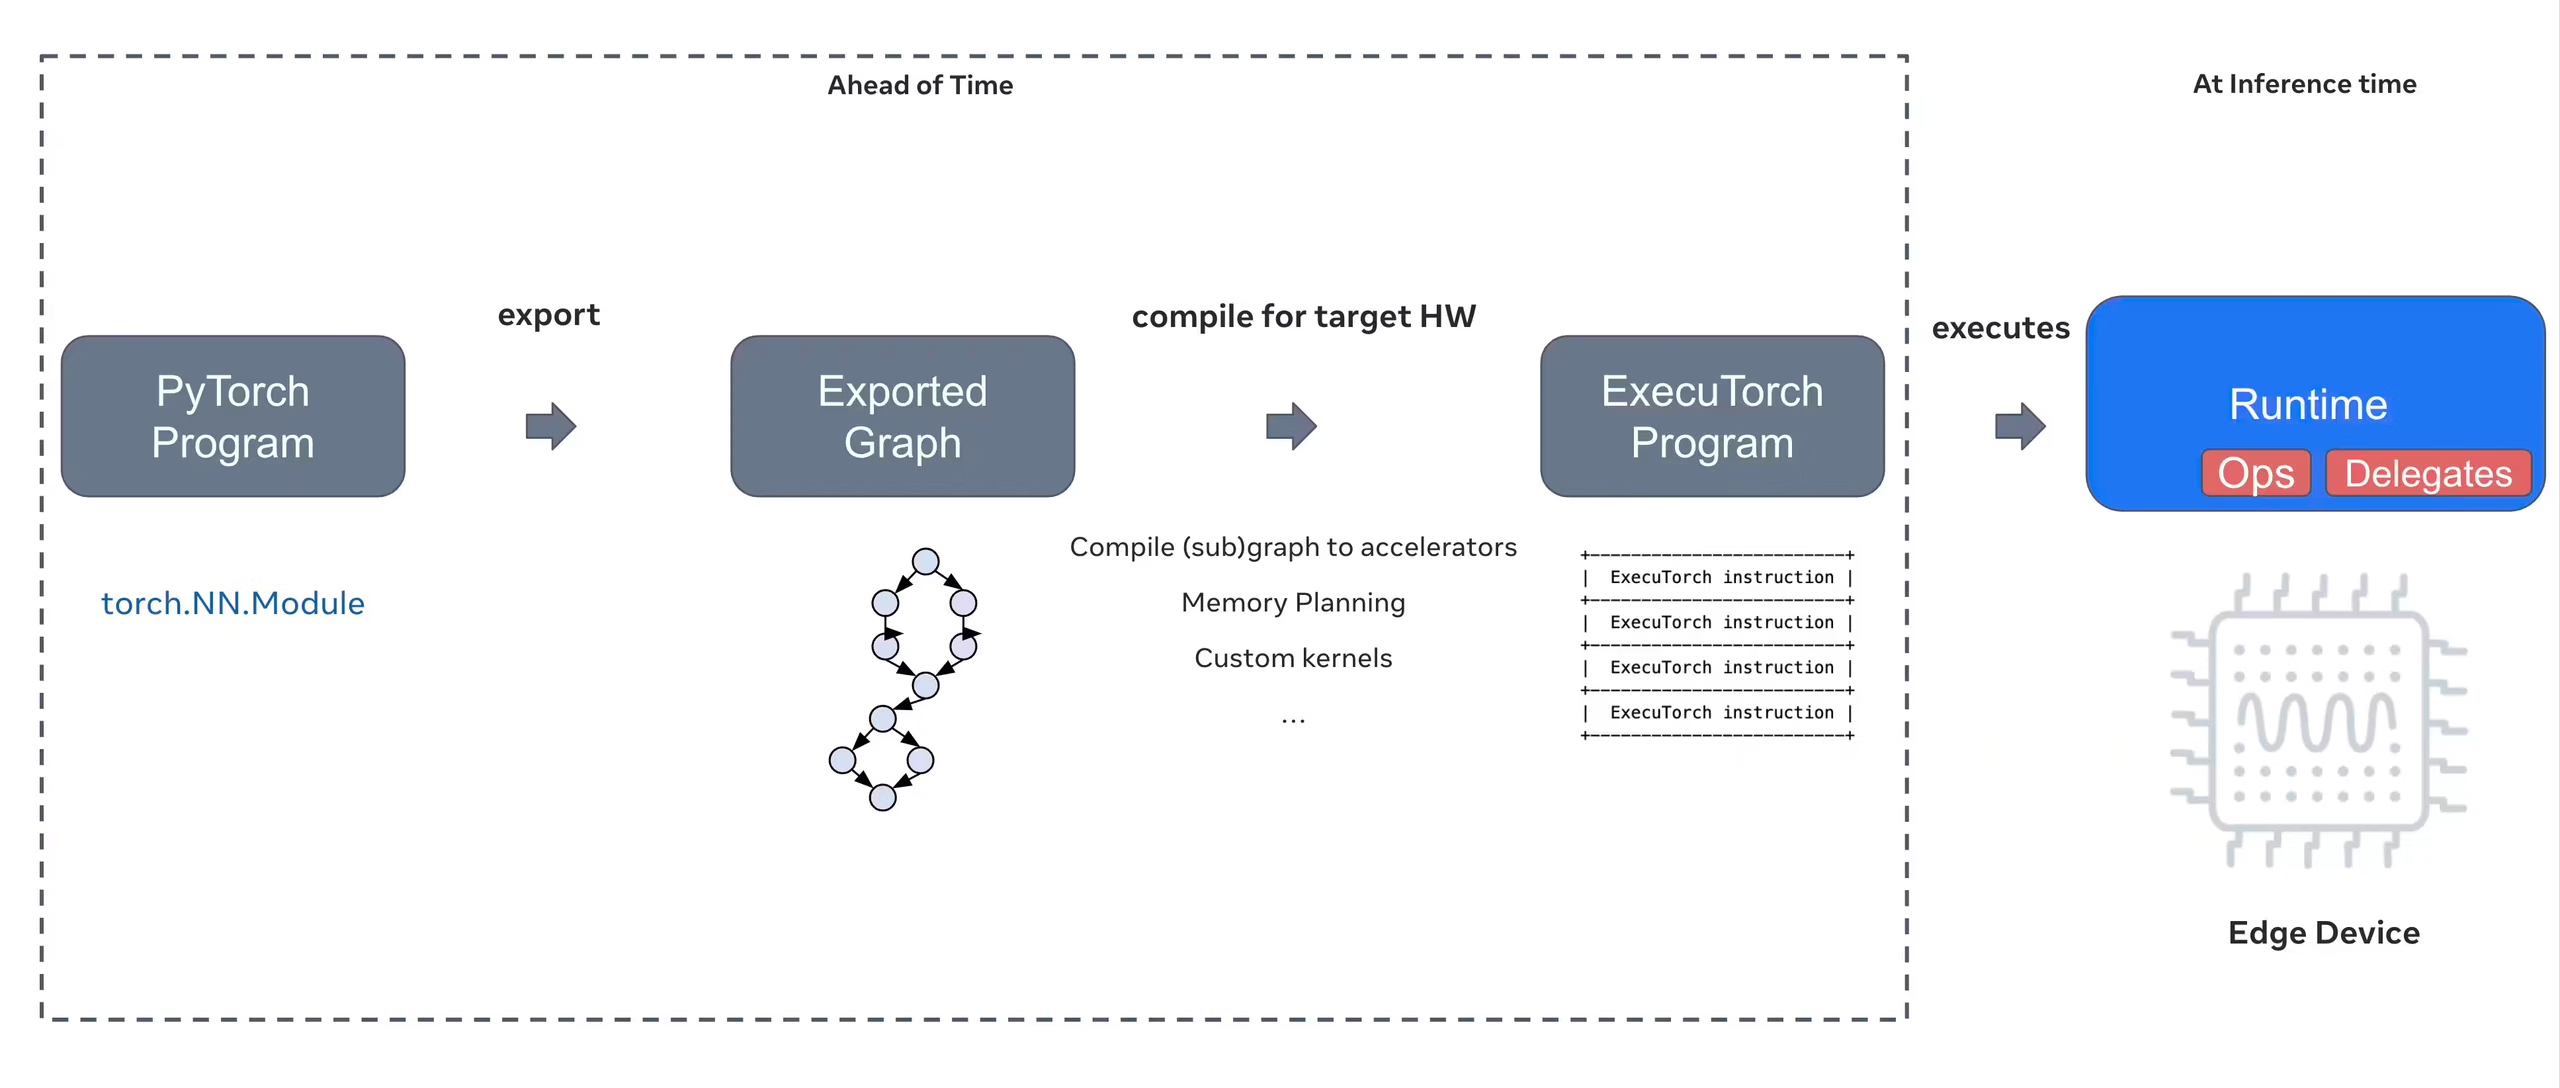
يمثل ExecuTorch حل PyTorch الشامل لتمكين إمكانات الاستدلال على الجهاز عبر الأجهزة المحمولة والطرفية. وقد صُمم ليكون محمولًا وفعالًا، ويمكن استخدام ExecuTorch لتشغيل برامج PyTorch على مجموعة واسعة من منصات الحوسبة.
الميزات الرئيسية لـ ExecuTorch#
يوفر ExecuTorch ميزات متعددة لنشر نماذج Ultralytics YOLO على أجهزة الحافة:
-
تنسيق نموذج محمول: يستخدم ExecuTorch تنسيق
.pte(PyTorch ExecuTorch)، المحسّن من حيث الحجم وسرعة التحميل على الأجهزة محدودة الموارد. -
واجهة XNNPACK الخلفية: يوفر التكامل الافتراضي مع XNNPACK استدلالًا محسّنًا بدرجة عالية على وحدات CPU المحمولة، ما يحقق أداءً قويًا دون الحاجة إلى عتاد متخصص.
-
جاهز للتكميم: يدعم نظام ExecuTorch تقنيات التكميم لتقليل حجم النموذج وتحسين سرعة الاستدلال؛ وتُصدِّر Ultralytics النماذج بدقة FP32 افتراضيًا، وبصيغة INT8 الثابتة باستخدام
quantize=8للواجهة الخلفية XNNPACK. -
كفاءة الذاكرة: تقلل إدارة الذاكرة المحسّنة من استهلاك الذاكرة أثناء التشغيل، ما يجعلها مناسبة للأجهزة ذات ذاكرة RAM المحدودة.
-
البيانات الوصفية للنموذج: تتضمن النماذج المصدّرة بيانات وصفية (مثل حجم الصورة وأسماء الفئات وغيرها) في ملف YAML منفصل لتسهيل التكامل.
خيارات النشر باستخدام ExecuTorch#
يمكن نشر نماذج ExecuTorch على منصات متنوعة للأجهزة الطرفية والمحمولة:
-
تطبيقات الأجهزة المحمولة: انشر على تطبيقات iOS وAndroid بأداء أصلي، ما يتيح اكتشاف الأجسام في الوقت الفعلي ضمن تطبيقات الأجهزة المحمولة.
-
الأنظمة المضمنة: شغّل النماذج على أجهزة Linux المضمنة، مثل Raspberry Pi وNVIDIA Jetson وغيرها من الأنظمة القائمة على ARM، بأداء محسّن.
-
أجهزة الذكاء الاصطناعي الطرفية: انشر على أجهزة متخصصة للذكاء الاصطناعي الطرفي باستخدام مفوّضات مخصصة لتسريع الاستدلال.
-
أجهزة إنترنت الأشياء: ادمج النماذج في أجهزة إنترنت الأشياء لإجراء الاستدلال على الجهاز دون الحاجة إلى الاتصال بالسحابة.
المهام المدعومة#
يدعم تصدير ExecuTorch مهام Ultralytics السبع كلها. ولا يتوفر التجزئة الدلالية وتقدير العمق إلا مع YOLO26، وهي العائلة الوحيدة التي تتضمن هذين الرأسين.
تصدير نماذج Ultralytics YOLO26 إلى ExecuTorch#
يتيح تحويل نماذج Ultralytics YOLO26 إلى تنسيق ExecuTorch نشرها بكفاءة على الأجهزة المحمولة والطرفية.
التثبيت#
يتطلب التصدير باستخدام ExecuTorch إصدار Python من 3.10 إلى 3.14 وPyTorch >= 2.9.0. تثبّت Ultralytics حزمة executorch متوافقة عند تصدير نموذج ExecuTorch أو تحميله، وتثبّتها على الإصدار executorch<1.5 عند استخدام PyTorch أقدم من 2.13، لذا لا ترقّها يدويًا.
# Install Ultralytics package
pip install ultralytics
للحصول على تعليمات مفصلة وأفضل الممارسات المتعلقة بعملية التثبيت، راجع دليل تثبيت YOLO26. وإذا واجهت أي صعوبات أثناء تثبيت الحزم المطلوبة لـ YOLO26، فاستعن بـدليل المشكلات الشائعة للاطلاع على الحلول والنصائح.
الاستخدام#
يتطلب تصدير نماذج YOLO26 إلى ExecuTorch أمرًا واحدًا.
يدعم تنسيق ExecuTorch أوضاع التصدير والتنبؤ والتحقق. صدّر نموذجك، ثم حمّل النموذج المصدّر لإجراء الاستدلال أو التحقق من دقته.
from ultralytics import YOLO
# تحميل نموذج YOLO26
model = YOLO("yolo26n.pt")
# صدّر النموذج إلى تنسيق ExecuTorch
model.export(format="executorch") # creates 'yolo26n_executorch_model'from ultralytics import YOLO
# حمّل نموذج ExecuTorch المصدّر
model = YOLO("yolo26n_executorch_model")
# تنفيذ الاستدلال
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# حمّل نموذج ExecuTorch المصدّر
model = YOLO("yolo26n_executorch_model")
# # التحقق من الدقة على مجموعة بيانات COCO8
metrics = model.val(data="coco8.yaml")ينشئ التصدير إلى ExecuTorch دليلًا يتضمن ملف .pte وبيانات وصفية. استخدم بيئة تشغيل ExecuTorch في تطبيقك المحمول أو المضمن لتحميل النموذج .pte وإجراء الاستدلال.
وسيطات التصدير#
عند التصدير إلى تنسيق ExecuTorch، يمكنك تحديد الوسيطات التالية:
| المعامل | النوع | الافتراضي | الوصف |
|---|---|---|---|
format | str | 'executorch' | التنسيق المستهدف للنموذج المُصدَّر، ويحدد مدى توافقه مع بيئات النشر المختلفة. |
imgsz | int أو tuple | 640 | حجم الصورة المطلوب كمدخل للنموذج. يمكن تحديده كعدد صحيح للصور المربعة أو كصف (height, width) للأبعاد المحددة. |
quantize | int أو str | None | دقة التكميم: 8 (INT8 ثابت، أوزان int8 + تنشيطات int8، مع إبقاء رأس الكشف والتجزئة والوضعية وOBB بدقة FP32؛ ويتطلب بيانات معايرة data/fraction وexecutorch>=1.6.0) أو 32/غير مضبوط (FP32). لا يُدعم FP16 وW8A16. |
batch | int | 1 | يحدد حجم الدفعة للاستدلال بنموذج التصدير، أو الحد الأقصى لعدد الصور التي سيعالجها النموذج المُصدّر بالتزامن في وضع predict. |
data | str | None | ملف YAML لمجموعة البيانات المستخدم لمعايرة INT8؛ أما التصنيف فيتطلب دليلًا لمجموعة بيانات أو اسم مجموعة بيانات مدمجة. إذا لم يُحدَّد مع quantize=8، فستختار Ultralytics مجموعة بيانات المعايرة الافتراضية لمهمة النموذج. |
fraction | float أو int أو list | 1.0 | مجموعة فرعية للمعايرة محددة كنسبة أو عدد صور أو نسب/أعداد [train, val, test]. تترك القوائم المكوّنة من عنصرين test كاملة، بينما تتجاوزها 0. |
device | str | None | يحدد الجهاز المستخدم للتصدير: GPU (device=0)، أو CPU (device=cpu)، أو MPS لأجهزة Apple silicon (device=mps). |
بنية الإخراج#
ينشئ التصدير إلى ExecuTorch دليلًا يحتوي على النموذج والبيانات الوصفية:
yolo26n_executorch_model/
├── model.pte               # ExecuTorch model file
└── metadata.yaml           # Model metadata (classes, image size, etc.)
استخدام نماذج ExecuTorch المصدّرة#
بعد تصدير نموذجك، ستحتاج إلى دمجه في التطبيق المستهدف باستخدام بيئة تشغيل ExecuTorch.
التكامل مع الأجهزة المحمولة#
بالنسبة إلى تطبيقات الأجهزة المحمولة (iOS/Android)، ستحتاج إلى:
- أضف بيئة تشغيل ExecuTorch: أدرج مكتبة بيئة تشغيل ExecuTorch في مشروعك للأجهزة المحمولة
- حمّل النموذج: حمّل الملف
.pteفي تطبيقك - أجرِ الاستدلال: عالج الصور واحصل على التنبؤات
iOS#
مثال على تكامل iOS (Objective-C/C++):
// iOS uses C++ APIs for model loading and inference
// See https://docs.pytorch.org/executorch/stable/using-executorch-ios.html for complete examples

#include <executorch/extension/module/module.h>

using namespace ::executorch::extension;

// Load the model
Module module("/path/to/model.pte");

// Create input tensor
float input[1 * 3 * 640 * 640];
auto tensor = from_blob(input, {1, 3, 640, 640});

// Run inference
const auto result = module.forward(tensor);Android#
أضف ExecuTorch Android AAR من Maven Central:
dependencies {
    implementation("org.pytorch:executorch-android:<version>")
}
مثال على تكامل Android (Kotlin):
import org.pytorch.executorch.EValue
import org.pytorch.executorch.Module
import org.pytorch.executorch.Tensor

// Load the model
val module = Module.load("/path/to/model.pte")

// Prepare input tensor
val inputTensor = Tensor.fromBlob(floatData, longArrayOf(1, 3, 640, 640))
val inputEValue = EValue.from(inputTensor)

// Run inference
val outputs = module.forward(inputEValue)
val predictions = outputs[0].toTensor().dataAsFloatArray
Linux المضمن#
لأنظمة Linux المضمنة، استخدم واجهة C++ البرمجية لـ ExecuTorch:
#include <executorch/extension/module/module.h>
#include <executorch/extension/tensor/tensor.h>

using namespace ::executorch::extension;

// Load model
Module module("model.pte");

// Prepare input
std::vector<float> input_data = preprocessImage(image);
auto input_tensor = from_blob(input_data.data(), {1, 3, 640, 640});

// Run inference
const auto outputs = module.forward(input_tensor);
لمزيد من التفاصيل حول دمج ExecuTorch في تطبيقاتك، تفضّل بزيارة وثائق ExecuTorch.
تحسين الأداء#
تحسين حجم النموذج#
لتقليل حجم النموذج عند النشر:
- استخدم نماذج أصغر: ابدأ بـYOLO26n (نانو) للحصول على أصغر حجم ممكن
- خفض دقة الإدخال: استخدم أحجام صور أصغر (مثل
imgsz=320أوimgsz=416) - التكميم: صدِّر باستخدام
quantize=8ومجموعة بيانات للمعايرة (data) للحصول على نموذج INT8 ثابت، أصغر بنحو 3 مرات من نموذج FP32، وذلك لـ YOLO26n.
تحسين سرعة الاستدلال#
للاستدلال بسرعة أكبر:
- واجهة XNNPACK الخلفية: توفّر واجهة XNNPACK الخلفية الافتراضية استدلالًا محسّنًا على CPU
- تسريع الأجهزة: استخدم مفوّضات خاصة بالمنصة (مثل CoreML لنظام iOS)
- المعالجة الدفعية: عالج صورًا متعددة متى أمكن
المعايير المرجعية#
قارن فريق Ultralytics نماذج YOLO26، واختبر السرعة والدقة بين PyTorch وExecuTorch.
| النموذج | التنسيق | الحالة | الحجم (MB) | metrics/mAP50-95(B) | وقت الاستدلال (ms/im) |
|---|---|---|---|---|---|
| YOLO26n | PyTorch | ✅ | 5.3 | 0.4790 | 314.80 |
| YOLO26n | ExecuTorch | ✅ | 9.4 | 0.4800 | 142 |
| YOLO26s | PyTorch | ✅ | 19.5 | 0.5730 | 930.90 |
| YOLO26s | ExecuTorch | ✅ | 36.5 | 0.5780 | 376.1 |
لا يشمل وقت الاستدلال المعالجة المسبقة أو اللاحقة.
استكشاف الأخطاء وإصلاحها#
المشكلات الشائعة#
المشكلة: Python version error
الحل: يتطلب ExecuTorch إصدار Python من 3.10 إلى 3.14. أنشئ بيئة باستخدام إصدار مدعوم:
# Using conda
conda create -n executorch python=3.14
conda activate executorch
للمزيد من المساعدة في استكشاف الأخطاء وإصلاحها، تفضّل بزيارة مشكلات Ultralytics على GitHub أو وثائق ExecuTorch.
الملخص#
يتيح تصدير نماذج YOLO26 إلى تنسيق ExecuTorch نشرها بكفاءة على الأجهزة المحمولة وأجهزة الحافة. وبفضل تكامله الأصلي مع PyTorch ودعمه للمنصات المتعددة وأدائه المحسّن، يُعد ExecuTorch خيارًا قويًا لتطبيقات الذكاء الاصطناعي على الحافة.
أهم النقاط:
- يوفر ExecuTorch نشرًا على الحافة متوافقًا أصليًا مع PyTorch، مع أداء قوي
- صدّر باستخدام الوسيط
format='executorch' - تُحسَّن النماذج لوحدات CPU المحمولة عبر واجهة XNNPACK الخلفية
- يدعم منصات iOS وAndroid وLinux المضمن
- يتطلب Python من 3.10 إلى 3.14 وPyTorch >= 2.9.0
الأسئلة الشائعة#
صدّر نموذج YOLO26 إلى ExecuTorch باستخدام Python أو CLI:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(format="executorch")
أو
yolo export model=yolo26n.pt format=executorchيتطلب تصدير ExecuTorch ما يلي:
- Python من 3.10 إلى 3.14
- الحزمة
executorch، التي تُثبَّت تلقائيًا (executorch<1.5على إصدارات PyTorch الأقدم من 2.13، والتي لا تدعمها إصدارات تشغيل ExecuTorch الأحدث) - PyTorch (يُثبَّت تلقائيًا مع ultralytics)
ملاحظة: تتضمن حزمة
executorchملفات wheels مُنشأة مسبقًا (مع واجهة XNNPACK الخلفية)، لذا لا حاجة إلى خطوة تجميع إضافية أثناء التصدير.يمكن تحميل نماذج ExecuTorch مباشرةً باستخدام
YOLO()لإجراء الاستدلال والتحقق في Python (راجع أمثلة التنبؤ/التحقق أعلاه)، كما يمكن نشرها على الأجهزة المحمولة وأجهزة الحافة باستخدام مكتبات وقت تشغيل ExecuTorch.يدعم ExecuTorch ما يلي:
- الأجهزة المحمولة: iOS وAndroid
- Linux المضمن: Raspberry Pi وNVIDIA Jetson وأجهزة ARM أخرى
- أجهزة سطح المكتب: Linux وmacOS وWindows (للتطوير)
يُعد كل من ExecuTorch وLiteRT مناسبًا تمامًا للنشر على الأجهزة المحمولة:
- ExecuTorch: تكامل أفضل مع PyTorch، وسير عمل أصلي لـ PyTorch، ومنظومة آخذة في النمو
- LiteRT: أكثر نضجًا، ودعم أوسع للأجهزة، وأمثلة نشر أكثر، ويشغّل النموذج نفسه على Android وiOS والمتصفح
اختر ExecuTorch إذا كنت تستخدم PyTorch بالفعل وتريد مسار نشر أصليًا. واختر LiteRT للحصول على أقصى توافق وأدوات ناضجة.
نعم. يدعم ExecuTorch تسريع العتاد عبر واجهات خلفية متنوعة:
- GPU للأجهزة المحمولة: عبر مفوّضات Vulkan أو Metal أو OpenCL
- NPU/DSP: عبر مفوّضات خاصة بالمنصة
- الافتراضي: XNNPACK للاستدلال المحسّن على CPU
راجع وثائق ExecuTorch للاطّلاع على إعدادات الواجهات الخلفية الخاصة بكل منصة.


التعليقات
اطرح سؤالًا، وشارك نتائجك، أو ساعد شخصًا آخر.