دليل خطوة بخطوة لتدريب نماذج YOLO26 باستخدام IBM Watsonx
تحتاج حلول الرؤية الحاسوبية القابلة للتوسع إلى بنية تحتية للبيانات والتدريب والنشر. IBM Watsonx منصة للذكاء الاصطناعي والبيانات تدعم تطوير نماذج الذكاء الاصطناعي ونشرها وإدارتها. وتغطي دورة حياة الذكاء الاصطناعي بأكملها، كما تتكامل مع خدمات IBM Cloud.
يمكنك تدريب نماذج Ultralytics YOLO26 باستخدام IBM Watsonx. وهو خيار جيد للمؤسسات المهتمة بكفاءة تدريب النماذج، وضبط النماذج لمهام محددة، وتحسين أداء النماذج باستخدام أدوات قوية وإعداد سهل الاستخدام. يرشدك هذا الدليل خلال تدريب YOLO26 باستخدام IBM Watsonx، بدءًا من إعداد البيئة وصولًا إلى تقييم النماذج المدرّبة.
ما IBM Watsonx؟#
Watsonx منصة IBM السحابية المصممة للبيانات العلمية والذكاء الاصطناعي التوليدي التجاري. وتتضافر المكونات الثلاثة لـIBM Watsonx — watsonx.ai وwatsonx.data وwatsonx.governance — لإنشاء منصة ذكاء اصطناعي موثوقة وشاملة يمكنها تسريع مشاريع الذكاء الاصطناعي الهادفة إلى حل مشكلات الأعمال. وتوفر أدوات لبناء النماذج وتدريبها ونشر نماذج تعلّم الآلة، كما تسهّل الاتصال بمصادر بيانات متنوعة.
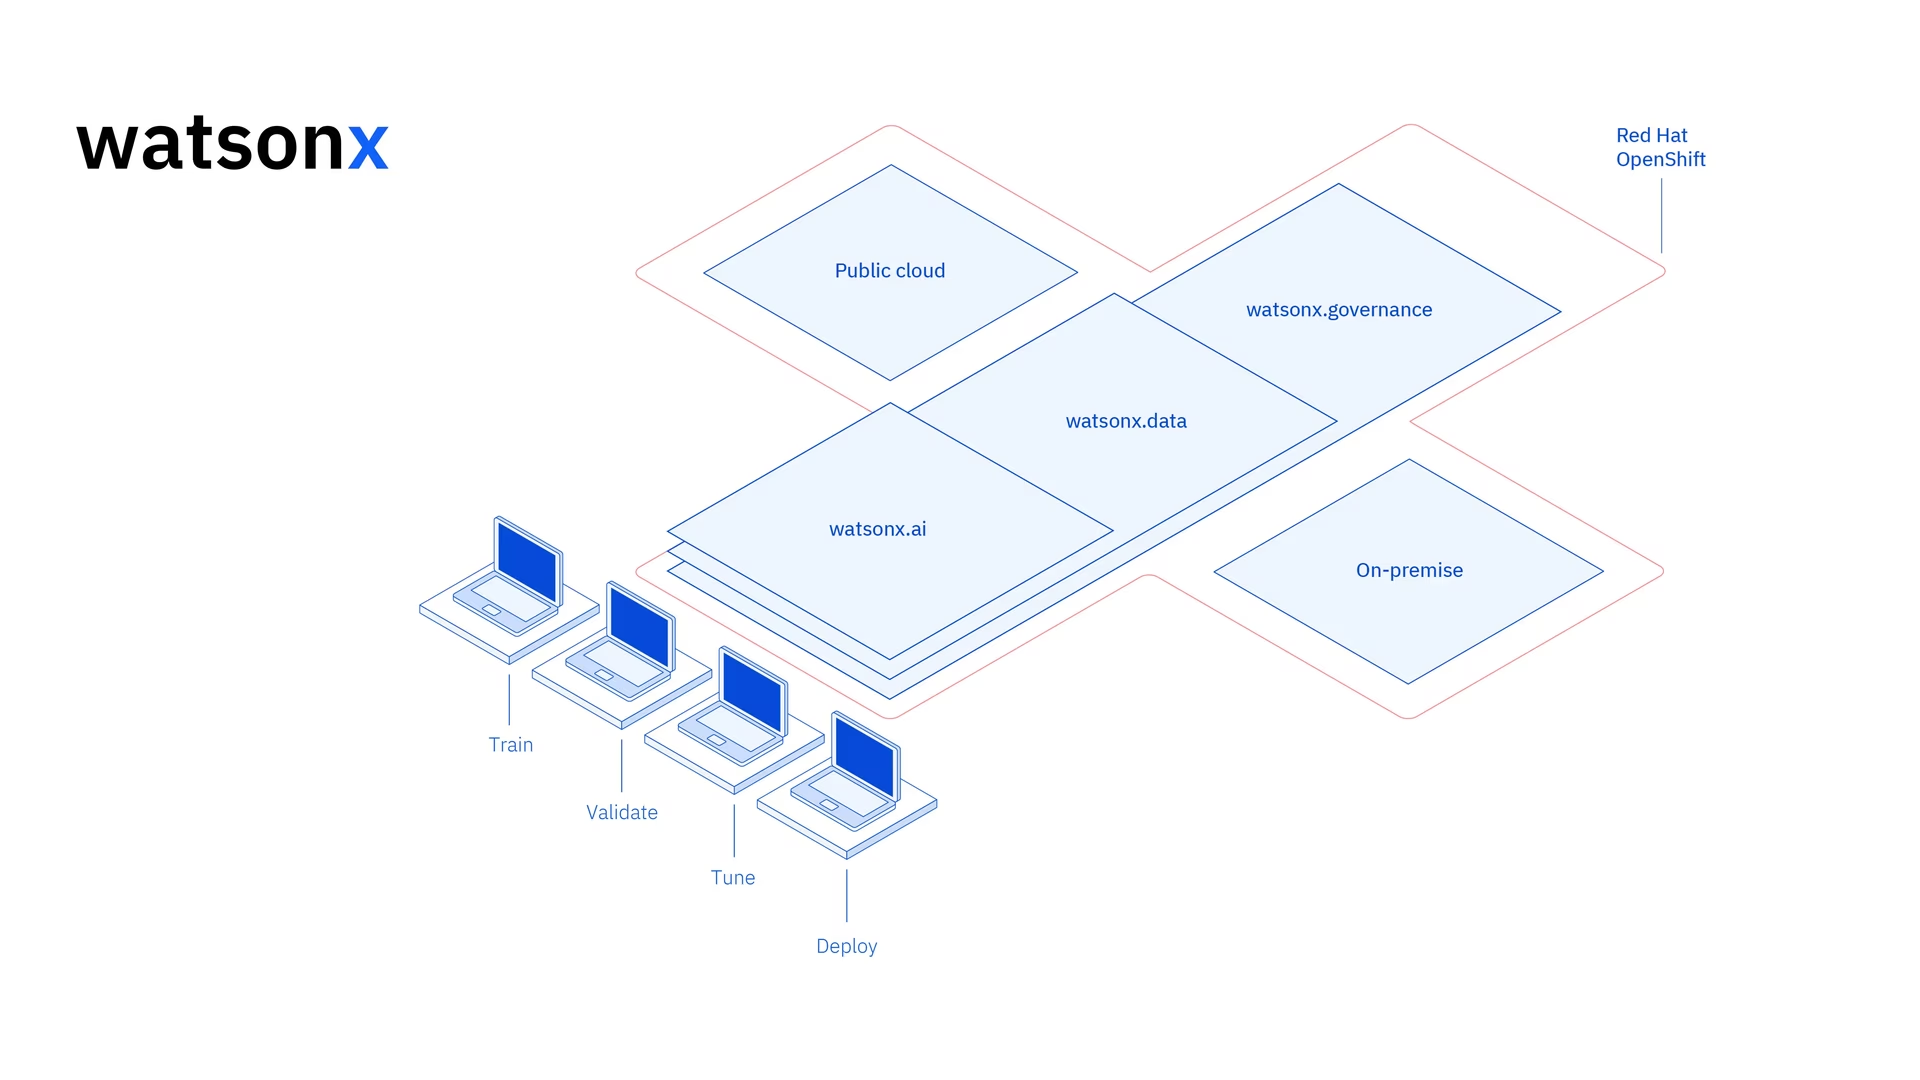
تدعم واجهته وميزات التعاون فيه تطوير النماذج وإدارتها ونشرها. ويدعم IBM Watsonx تطبيقات الرؤية الحاسوبية والتحليلات التنبؤية ومعالجة اللغة الطبيعية وغيرها من تطبيقات الذكاء الاصطناعي.
الميزات الرئيسية لـ IBM Watsonx#
يتكوّن IBM Watsonx من ثلاثة مكوّنات رئيسية: watsonx.ai وwatsonx.data وwatsonx.governance. ويغطي كل مكوّن جانبًا مختلفًا من الذكاء الاصطناعي وإدارة البيانات.
Watsonx.ai#
توفر Watsonx.ai أدوات لتطوير الذكاء الاصطناعي وإمكانية الوصول إلى نماذج مخصصة تدعمها IBM، ونماذج الجهات الخارجية مثل Llama 3، ونماذج Granite الخاصة بـ IBM. وتتضمن Prompt Lab لتجربة مطالبات الذكاء الاصطناعي وTuning Studio لتحسين أداء النماذج باستخدام البيانات الموسومة. كما توفر أدوات شاملة لأتمتة دورة حياة نماذج الذكاء الاصطناعي والاتصال بواجهات API ومكتبات متنوعة.
Watsonx.data#
تدعم Watsonx.data عمليات النشر السحابية والمحلية. وتوفر وحدة التحكم سهلة الاستخدام وصولًا مركزيًا إلى البيانات عبر البيئات، كما تيسّر استكشاف البيانات باستخدام SQL الشائع. وتحسّن أعباء العمل باستخدام محركات استعلام فعالة مثل Presto وSpark، وتسرّع استخلاص الرؤى من البيانات عبر طبقة دلالية مدعومة بالذكاء الاصطناعي، وتتضمن قاعدة بيانات متجهية لزيادة ملاءمة نتائج الذكاء الاصطناعي، وتدعم تنسيقات البيانات المفتوحة لتسهيل مشاركة بيانات التحليلات والذكاء الاصطناعي.
Watsonx.governance#
يجعل Watsonx.governance الامتثال أسهل من خلال التعرّف التلقائي على التغييرات التنظيمية وإنفاذ السياسات. ويربط المتطلبات ببيانات المخاطر الداخلية ويوفّر بطاقات حقائق محدثة للذكاء الاصطناعي. وتساعد المنصة على إدارة المخاطر عبر التنبيهات والأدوات اللازمة لاكتشاف مشكلات مثل التحيز والانحراف. كما تؤتمت مراقبة دورة حياة الذكاء الاصطناعي وتوثيقها، وتنظم تطوير الذكاء الاصطناعي عبر جرد النماذج، وتعزز التعاون باستخدام لوحات معلومات وأدوات إعداد تقارير سهلة الاستخدام.
كيفية تدريب YOLO26 باستخدام IBM Watsonx#
يمكنك استخدام IBM Watsonx لتسريع سير عمل تدريب نموذج YOLO26.
المتطلبات الأساسية#
تحتاج إلى حساب IBM Cloud لإنشاء مشروع watsonx.ai، كما ستحتاج إلى حساب Kaggle لتحميل مجموعة البيانات.
الخطوة 1: إعداد البيئة#
أولًا، ستحتاج إلى إعداد حساب IBM لاستخدام Jupyter Notebook. سجّل الدخول إلى watsonx.ai باستخدام حساب IBM Cloud.
بعد ذلك، أنشئ مشروع watsonx.ai ودفتر Jupyter.
بعد ذلك، ستُفتح لك بيئة دفتر ملاحظات لتحميل مجموعة البيانات. يمكنك استخدام الشيفرة البرمجية الواردة في هذا البرنامج التعليمي لتدريب نموذج بسيط لاكتشاف الكائنات.
الخطوة 2: تثبيت المكتبات ذات الصلة واستيرادها#
بعد ذلك، يمكنك تثبيت مكتبات Python اللازمة واستيرادها.
# Install the required packages
pip install torch torchvision torchaudio
pip install ultralytics-opencv-headless
للاطلاع على التعليمات التفصيلية وأفضل الممارسات المتعلقة بعملية التثبيت، راجع دليل تثبيت Ultralytics. إذا واجهت أي صعوبات أثناء تثبيت الحزم المطلوبة لـ YOLO26، فراجع دليل المشكلات الشائعة للاطلاع على الحلول والنصائح.
ثم يمكنك استيراد الحزم المطلوبة.
import glob
import os
import shutil

from IPython.display import display
from PIL import Image

import ultralytics
from ultralytics.utils import YAML

ultralytics.checks()
الخطوة 3: تحميل البيانات#
سنستخدم في هذا البرنامج التعليمي مجموعة بيانات النفايات البحرية المتاحة على Kaggle (وهي متاحة أيضًا باسم Trash-ICRA19 على Ultralytics Platform). باستخدام مجموعة البيانات هذه، سندرّب نموذج YOLO26 مخصصًا لاكتشاف النفايات والكائنات البيولوجية وتصنيفها في الصور تحت الماء.
يمكننا تحميل مجموعة البيانات مباشرةً إلى دفتر الملاحظات باستخدام Kaggle API. أولًا، أنشئ حسابًا مجانيًا على Kaggle. بعد إنشاء الحساب، ستحتاج إلى إنشاء مفتاح API. يمكنك العثور على إرشادات إنشاء المفتاح في وثائق Kaggle API ضمن قسم "بيانات اعتماد API".
انسخ اسم المستخدم ومفتاح API الخاصين بك في Kaggle والصقهما في الشيفرة التالية. ثم شغّل الشيفرة لتثبيت API وتحميل مجموعة البيانات إلى Watsonx.
# Install kaggle
pip install kaggle
بعد تثبيت Kaggle، يمكننا تحميل مجموعة البيانات إلى Watsonx.
# Replace "username" string with your username
os.environ["KAGGLE_USERNAME"] = "username"
# Replace "apiKey" string with your key
os.environ["KAGGLE_KEY"] = "apiKey"

# Load dataset
os.system("kaggle datasets download atiqishrak/trash-dataset-icra19 --unzip")

# Store working directory path as work_dir
work_dir = os.getcwd()

# Print work_dir path
print(os.getcwd())

# Print work_dir contents
print(os.listdir(f"{work_dir}"))

# Print trash_ICRA19 subdirectory contents
print(os.listdir(f"{work_dir}/trash_ICRA19"))
بعد تحميل مجموعة البيانات، طبعنا دليل العمل وحفظناه. كما طبعنا محتويات دليل العمل للتأكد من تحميل مجموعة البيانات "trash_ICRA19" على نحو صحيح.
إذا ظهر "trash_ICRA19" ضمن محتويات الدليل، فهذا يعني أنه حُمّل بنجاح. ينبغي أن ترى ثلاثة ملفات/مجلدات: ملف config.yaml، ومجلد videos_for_testing، ومجلد dataset. لن نستخدم مجلد videos_for_testing، لذا يمكنك حذفه.
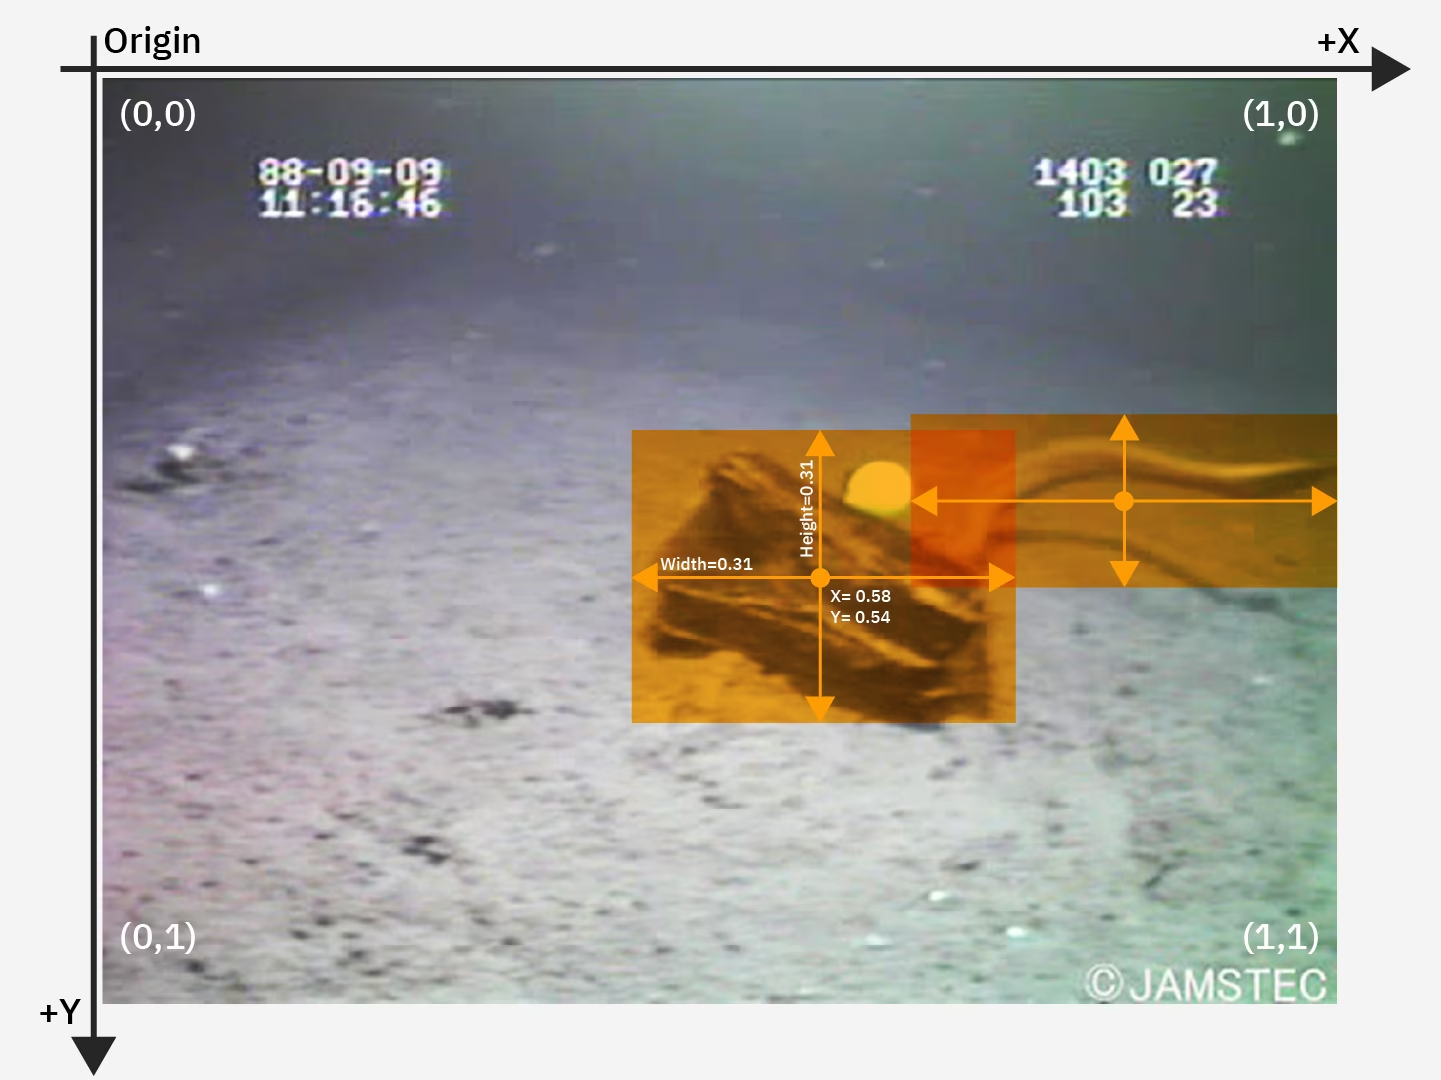
سنستخدم الملف config.yaml ومحتويات دليل مجموعة البيانات لتدريب نموذج اكتشاف الكائنات. إليك صورة نموذجية من مجموعة بيانات النفايات البحرية.
الخطوة 4: المعالجة المسبقة للبيانات#
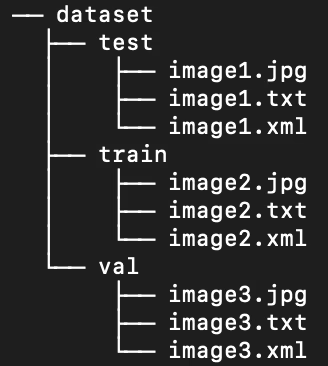
جميع التسميات في مجموعة بيانات النفايات البحرية منسقة مسبقًا كملفات YOLO .txt. لكن علينا إعادة ترتيب دليلي الصور والتسميات كي يتمكن النموذج من العثور عليهما. يتبع دليل مجموعة البيانات المحمّلة حاليًا البنية التالية:
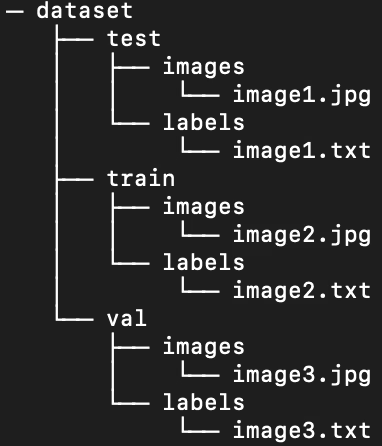
تتطلب نماذج YOLO افتراضيًا دليليْن فرعييْن منفصلين images وlabels ضمن كل تقسيم من تقسيمات train/val/test. علينا إعادة تنظيم الدليل وفق البنية التالية:
لإعادة تنظيم دليل مجموعة البيانات، يمكننا تشغيل البرنامج النصي التالي:
# Function to reorganize dir
def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        # Create image and label subdirs if non-existent
        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        # Move images and labels to respective subdirs
        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))
            # Delete .xml files
            elif filename.endswith(".xml"):
                os.remove(os.path.join(subdir_path, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
    organize_files(directory)
بعد ذلك، علينا تعديل ملف YAML الخاص بمجموعة البيانات. هذا هو الإعداد الذي سنستخدمه في ملف .yaml. تبدأ أرقام معرّفات الفئات من 0:
path: /path/to/dataset/directory # root directory for dataset
train: train/images # train images subdirectory
val: val/images # validation images subdirectory
test: test/images # test images subdirectory

# Classes
names:
    0: plastic
    1: bio
    2: rov
شغّل البرنامج النصي التالي لحذف المحتويات الحالية لـ config.yaml واستبدالها بالإعدادات التي تعكس بنية دليل مجموعة البيانات الجديدة. يستخدم البرنامج النصي تلقائيًا المتغير work_dir الذي عرّفناه سابقًا، لذا تأكد من أنه يشير إلى مجموعة بياناتك قبل التنفيذ، واترك تعريفات الأدلة الفرعية train وval وtest دون تغيير.
# Contents of new config.yaml file
def update_yaml_file(file_path):
    data = {
        "path": f"{work_dir}/trash_ICRA19/dataset",
        "train": "train/images",
        "val": "val/images",
        "test": "test/images",
        "names": {0: "plastic", 1: "bio", 2: "rov"},
    }
    YAML.save(file_path, data)  # keeps key order, so "names" follows the directories

if __name__ == "__main__":
    file_path = f"{work_dir}/trash_ICRA19/config.yaml"  # .yaml file path
    update_yaml_file(file_path)
    print(f"{file_path} updated successfully.")
الخطوة 5: تدريب نموذج YOLO26#
شغّل الأمر التالي لإجراء ضبط دقيق لنموذج YOLO26n مدرّب مسبقًا.
!yolo detect train data={work_dir}/trash_ICRA19/config.yaml model=yolo26n.pt epochs=2 batch=32 plots=Trueإليك نظرة عن كثب على المعلمات في أمر تدريب النموذج:
- detect: مهمة الرؤية الحاسوبية التي تستخدم فيها نموذج YOLO ومجموعة البيانات المحددين.
- train: الوضع الذي يحدد الغرض من تحميل النموذج والبيانات المحددين. لاحقًا، عندما نختبر أداء نموذجنا، سنستخدم
predict. - epochs: عدد المرات التي سيمر فيها YOLO26 على مجموعة البيانات بأكملها.
- batch: حجم الدفعة أثناء التدريب، أي عدد الصور التي يعالجها النموذج قبل تحديث معلماته.
- plots: يوجّه YOLO لإنشاء مخططات مقاييس تدريب نموذجنا وتقييمه وحفظها.
للاطلاع على فهم مفصّل لعملية تدريب النموذج وأفضل الممارسات، راجع دليل تدريب نموذج YOLO26. سيساعدك هذا الدليل على تحقيق أقصى استفادة من تجاربك وضمان استخدام YOLO26 بفاعلية.
الخطوة 6: اختبار النموذج#
يمكننا الآن تشغيل الاستدلال لاختبار أداء نموذجنا المحسّن:
!yolo detect predict source={work_dir}/trash_ICRA19/dataset/test/images model={work_dir}/runs/detect/train/weights/best.pt conf=0.5 iou=.5 save=True save_txt=Trueينشئ هذا الأمر تسميات متوقعة لكل صورة في مجموعة الاختبار، بالإضافة إلى ملفات صور ناتجة جديدة تُظهر مربع الإحاطة المتوقع فوق الصورة الأصلية.
تُحفظ تسميات .txt المتوقعة لكل صورة باستخدام الوسيط save_txt=True، وتُنشأ الصور الناتجة التي تتضمن مربعات إحاطة باستخدام الوسيط save=True. تخبر المعلمة conf=0.5 النموذج بتجاهل جميع التنبؤات التي تقل درجة الثقة فيها عن 50%.
أخيرًا، تحدد iou=.5 عتبة كبت غير الحد الأقصى (NMS): تُستبعد المربعات من الفئة نفسها إذا تجاوز تداخلها مع مربع ذي درجة أعلى 50%. وهذا يقلل المربعات المكررة الناتجة للكائن نفسه. يمكننا تحميل الصور التي تتضمن مربعات الإحاطة المتوقعة للاطلاع على أداء نموذجنا في مجموعة من الصور.
# Show the first ten images from the preceding prediction task
for pred_dir in glob.glob(f"{work_dir}/runs/detect/predict/*.jpg")[:10]:
    img = Image.open(pred_dir)
    display(img)
يعرض الرمز أعلاه عشر صور من مجموعة الاختبار مع مربعات الإحاطة المتوقعة، إلى جانب تسميات أسماء الفئات ودرجات الثقة.
الخطوة 7: تقييم النموذج#
يمكننا إنشاء تصورات مرئية لكل فئة توضح الدقة والاستدعاء في النموذج. تُحفظ هذه التصورات في دليل تشغيل التدريب ({work_dir}/runs/detect/train/). وتُعرض درجة الدقة في BoxP_curve.png:
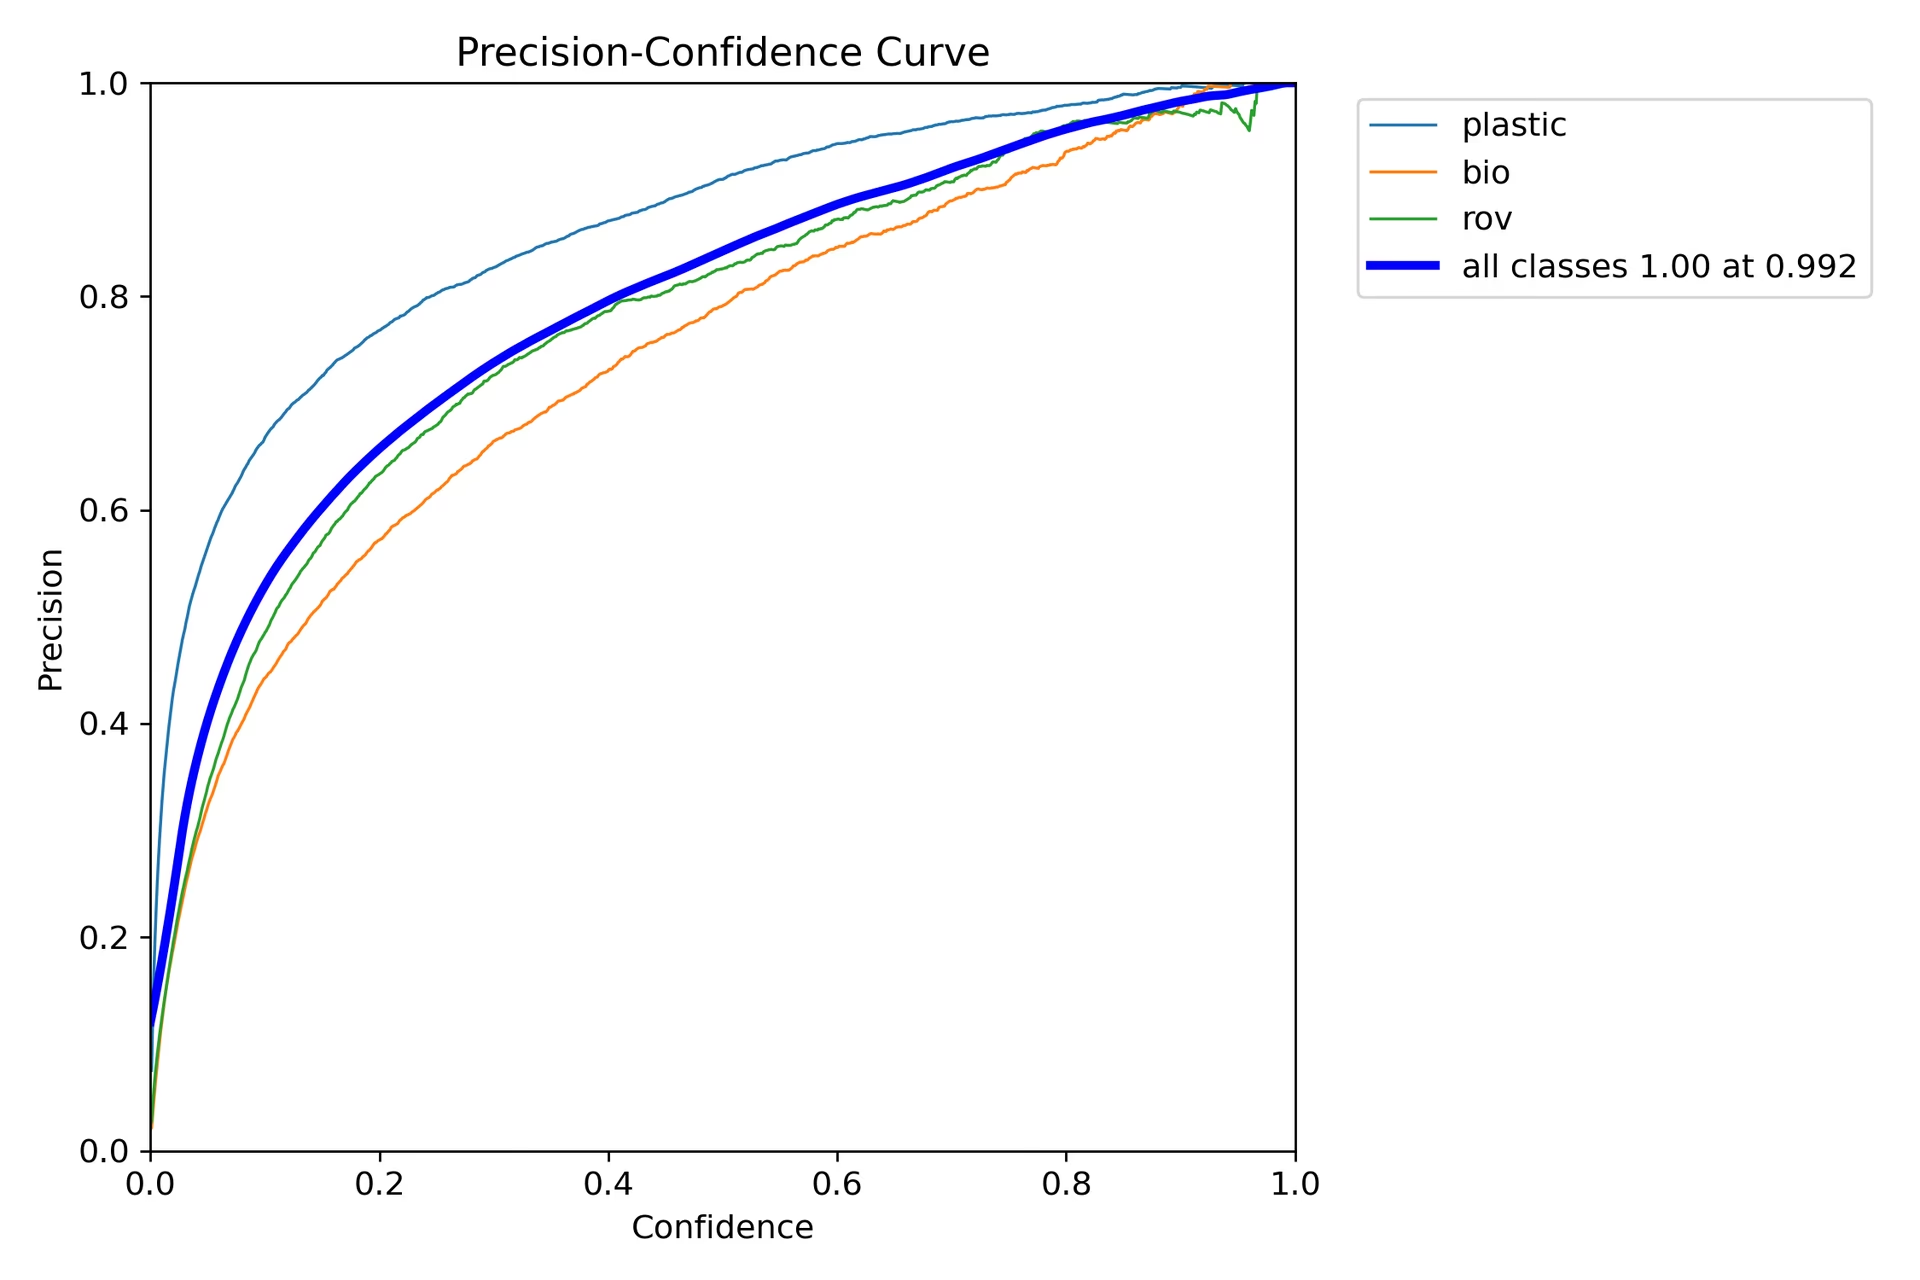
يوضح الرسم البياني ارتفاع الدقة مع زيادة عتبة الثقة للتنبؤات. لكن دقة النموذج لم تستقر بعد عند مستوى معين من الثقة بعد حقبتين.
يُظهر الرسم البياني لـالاستدعاء (BoxR_curve.png) اتجاهًا عكسيًا:
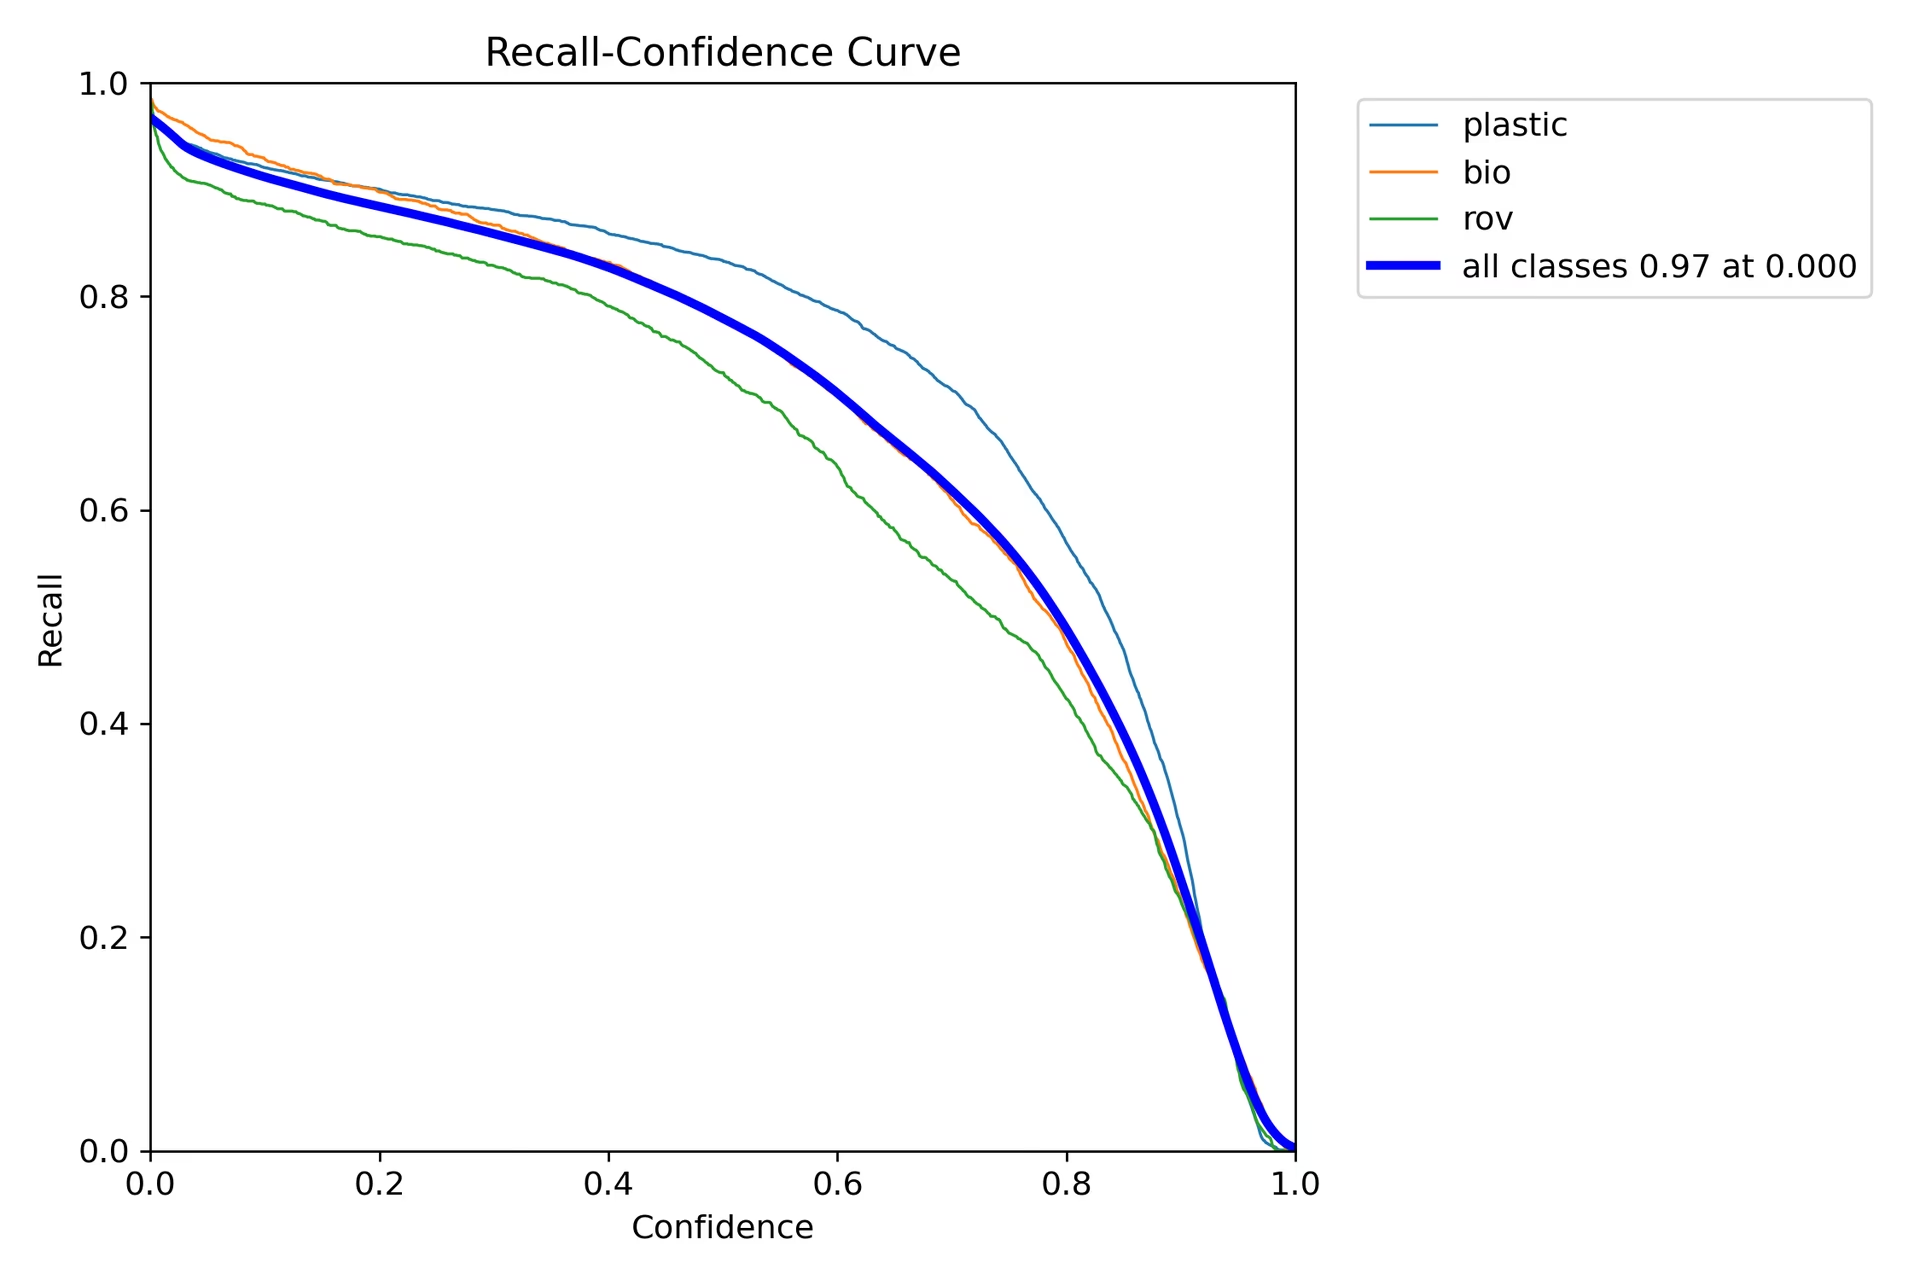
على خلاف الدقة، يبلغ الاستدعاء أعلى مستوياته عند عتبات الثقة المنخفضة، ثم ينخفض مع ارتفاع العتبة. ويوضح ذلك المفاضلة بين الدقة والاستدعاء.
الخطوة 8: حساب التقاطع على الاتحاد#
يمكنك قياس دقة تحديد المواقع بحساب التقاطع على الاتحاد (IoU) بين مربع إحاطة متوقع ومربع إحاطة للحقيقة الأرضية للكائن نفسه.
الملخص#
استكشفنا الميزات الرئيسية لمنصة IBM Watsonx وكيفية تدريب نموذج YOLO26 باستخدامها. كما توفّر IBM Watsonx أدوات لبناء النماذج وإدارة البيانات والامتثال.
لمزيد من التفاصيل حول الاستخدام، تفضل بزيارة الوثائق الرسمية لـ IBM Watsonx.
الأسئلة الشائعة#
لتدريب نموذج YOLO26 باستخدام IBM Watsonx، اتبع الخطوات التالية:
- إعداد بيئتك: أنشئ حسابًا على IBM Cloud وأعدّ مشروعًا على Watsonx.ai. استخدم Jupyter Notebook بيئةً للبرمجة.
- تثبيت المكتبات: ثبّت المكتبات اللازمة مثل
torchوopencvوultralytics. - تحميل البيانات: استخدم Kaggle API لتحميل مجموعة البيانات إلى Watsonx.
- المعالجة المسبقة للبيانات: نظّم مجموعة البيانات وفق بنية الدليل المطلوبة وحدّث ملف الإعدادات
.yaml. - تدريب النموذج: استخدم واجهة سطر الأوامر في YOLO لتدريب نموذجك باستخدام معلمات مثل
epochsوbatch. - الاختبار والتقييم: شغّل الاستدلال لاختبار النموذج وقيّم أداءه باستخدام مقاييس مثل الدقة والاستدعاء.
للحصول على تعليمات مفصلة، راجع دليل تدريب نموذج YOLO26.
يوفر IBM Watsonx عدة ميزات رئيسية لتدريب نماذج الذكاء الاصطناعي:
- Watsonx.ai: يوفر أدوات لتطوير الذكاء الاصطناعي، بما في ذلك إمكانية الوصول إلى نماذج مخصصة تدعمها IBM ونماذج الجهات الخارجية مثل Llama 3. ويتضمن Prompt Lab وTuning Studio لإدارة شاملة لدورة حياة الذكاء الاصطناعي.
- Watsonx.data: يدعم النشر على السحابة وفي البيئات المحلية، ويوفر وصولًا مركزيًا إلى البيانات، ومحركات استعلام فعالة مثل Presto وSpark، وطبقة دلالية مدعومة بالذكاء الاصطناعي.
- Watsonx.governance: يؤتمت الامتثال، ويدير المخاطر عبر التنبيهات، ويوفر أدوات لاكتشاف المشكلات مثل التحيز والانحراف. كما يضم لوحات معلومات وأدوات لإعداد التقارير والتعاون.
لمزيد من المعلومات، تفضل بزيارة الوثائق الرسمية لـ IBM Watsonx.
يلائم IBM Watsonx تدريب Ultralytics YOLO26 لأن أدواته تغطي دورة حياة الذكاء الاصطناعي بأكملها. ومن أبرز الفوائد:
- قابلية التوسع: وسّع نطاق تدريب نماذجك بسهولة باستخدام خدمات IBM Cloud.
- التكامل: الاتصال بمصادر بيانات وواجهات API متنوعة.
- واجهة سهلة الاستخدام: تبسّط عملية التطوير بفضل واجهة تعاونية وسهلة الاستخدام.
- الأدوات المتقدمة: استخدم أدوات مثل Prompt Lab وTuning Studio لتحسين أداء النماذج.
لإجراء المعالجة المسبقة لمجموعة بياناتك لتدريب YOLO26 على IBM Watsonx:
- تنظيم الأدلة: تأكد من اتباع مجموعة البيانات بنية أدلة YOLO، مع أدلة فرعية منفصلة للصور والتسميات ضمن تقسيمات train/val/test.
- تحديث ملف .yaml: عدّل ملف الإعدادات
.yamlليعكس بنية الأدلة الجديدة وأسماء الفئات. - تشغيل برنامج المعالجة المسبقة: استخدم برنامجًا نصيًا بلغة Python لإعادة تنظيم مجموعة البيانات وتحديث الملف
.yamlوفقًا لذلك.
إليك مثالًا على برنامج نصي لتنظيم مجموعة البيانات:
import os
import shutil

def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
    organize_files(directory)
لمزيد من التفاصيل، راجع دليل المعالجة المسبقة للبيانات.
قبل البدء بتدريب نموذج YOLO26 على IBM Watsonx، تأكد من استيفاء المتطلبات الأساسية التالية:
- حساب IBM Cloud: أنشئ حسابًا على IBM Cloud للوصول إلى Watsonx.ai.
- حساب Kaggle: ستحتاج إلى حساب Kaggle ومفتاح API لتحميل مجموعات البيانات.
- Jupyter Notebook: أعدّ بيئة Jupyter Notebook داخل Watsonx.ai للبرمجة وتدريب النماذج.
لمزيد من المعلومات حول إعداد بيئتك، تفضل بزيارة دليل تثبيت Ultralytics.


التعليقات
اطرح سؤالًا، وشارك نتائجك، أو ساعد شخصًا آخر.