COCO128-Datensatz
Einführung#
Ultralytics COCO128 ist ein kleiner, aber vielseitiger Objekterkennungs-Datensatz, der aus den ersten 128 Bildern des COCO-Trainingssatzes von 2017 besteht. Dieser Datensatz eignet sich ideal zum Testen und Debuggen von Objekterkennungsmodellen sowie zum Ausprobieren neuer Erkennungsansätze. Mit 128 Bildern ist er klein genug, um sich leicht verwalten zu lassen, und dennoch vielfältig genug, um Trainingspipelines auf Fehler zu prüfen und vor dem Training mit größeren Datensätzen als Plausibilitätsprüfung zu dienen.
Ansehen: Überblick über den Ultralytics-COCO-Datensatz
Dieser Datensatz ist für die Verwendung mit der Ultralytics Platform und YOLO26 vorgesehen.
Datensatzstruktur#
COCO128 enthält die ersten 128 Bilder aus dem COCO-Trainingssatz von 2017, die mit den 80 COCO-Klassennamen (71 davon kommen in diesen Bildern vor) im YOLO-Label-Format beschriftet sind. Dieselben 128 Bilder dienen sowohl als Trainings- als auch als Validierungsaufteilung, wodurch der Datensatz für schnelle Plausibilitätsprüfungen schlank bleibt:
coco128/
├── images/
│   └── train2017/   # 128 images (used for both train and val)
└── labels/
    └── train2017/
YAML-Datei des Datensatzes#
Eine YAML-Datei definiert die Konfiguration des Datensatzes. Sie enthält Informationen zu den Pfaden, Klassen und weiteren relevanten Angaben des Datensatzes. Beim COCO128-Datensatz wird die Datei coco128.yaml unter https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco128.yaml verwaltet.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO128 dataset https://www.kaggle.com/datasets/ultralytics/coco128 (first 128 images from COCO train2017) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/coco128
# Example usage: yolo train data=coco128.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco128 ← downloads here (7 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco128 # dataset root dir
train: images/train2017 # train images (relative to 'path') 128 images
val: images/train2017 # val images (relative to 'path') 128 images
test: # test images (optional)

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/coco128.zipVerwendung#
Der COCO128-Datensatz (7 MB) wird beim ersten Trainingsstart automatisch heruntergeladen. Um ein YOLO26n-Modell 100 Epochen lang mit Bildgröße 640 auf COCO128 zu trainieren, kannst du die folgenden Codeausschnitte verwenden.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n.pt")  # ein vortrainiertes Modell laden (für das Training empfohlen)

# Das Modell trainieren
results = model.train(data="coco128.yaml", epochs=100, imgsz=640)
Beispielbilder und Annotationen#
Hier siehst du einige Beispielbilder aus dem COCO128-Datensatz mit den zugehörigen Annotationen:
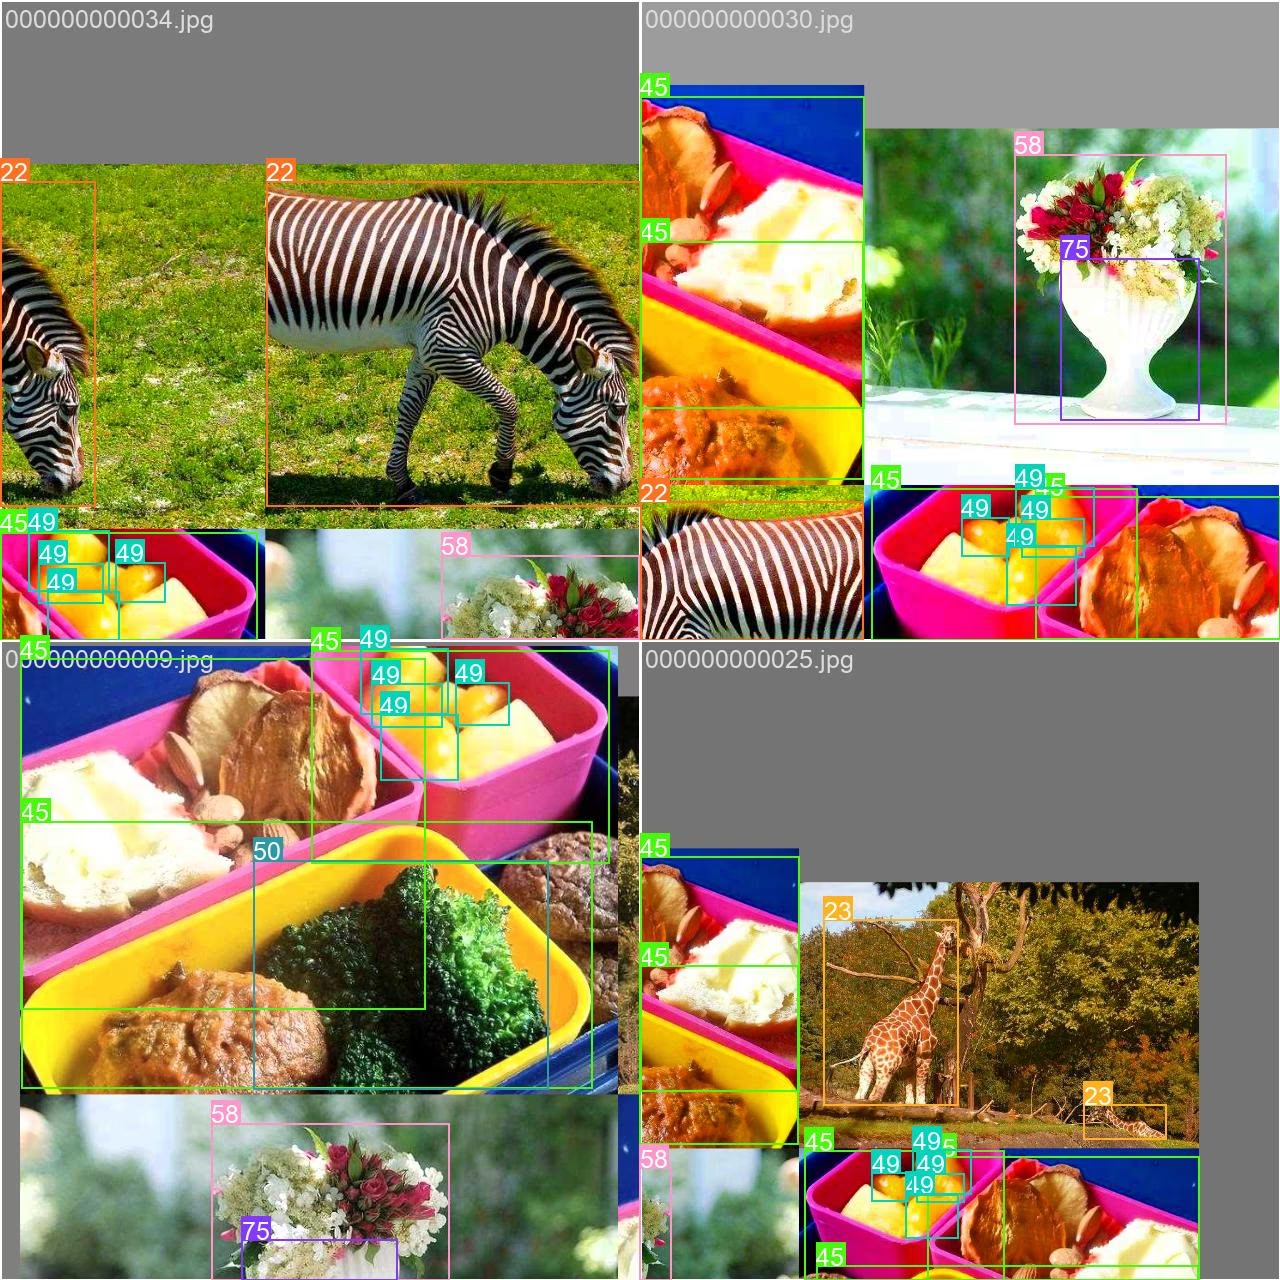
- Mosaikbild: Dieses Bild zeigt einen Trainingsbatch aus mosaikartig zusammengesetzten Datensatzbildern. Mosaik ist eine Datenaugmentierungs-Technik, die während des Trainings mehrere Bilder zu einem einzigen Bild kombiniert, um die Vielfalt der Objekte und Szenen in jedem Trainingsbatch zu erhöhen. Dies verbessert die Fähigkeit des Modells, auf unterschiedliche Objektgrößen, Seitenverhältnisse und Kontexte zu verallgemeinern.
Das Beispiel zeigt die Vielfalt und Komplexität der Bilder im COCO128-Datensatz sowie die Vorteile des Mosaikeinsatzes während des Trainings.
Zitate und Danksagungen#
Wenn du den COCO-Datensatz für deine Forschung oder Entwicklungsarbeit verwendest, zitiere bitte die folgende Arbeit:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Wir möchten dem COCO-Konsortium dafür danken, dass es diese wertvolle Ressource für die Computer-Vision-Community erstellt und pflegt. Weitere Informationen zum COCO-Datensatz und seinen Urhebern findest du auf der COCO-Datensatz-Website.
Häufig gestellte Fragen#
Der Ultralytics-COCO128-Datensatz ist eine kompakte Teilmenge mit den ersten 128 Bildern aus dem COCO-Trainingsdatensatz von 2017. Er wird vor allem zum Testen und Debuggen von Objekterkennungs-Modellen, zum Ausprobieren neuer Erkennungsansätze und zum Überprüfen von Trainingspipelines vor dem Wechsel zu größeren Datensätzen verwendet. Dank seiner überschaubaren Größe eignet er sich gut für schnelle Iterationen und bietet gleichzeitig genügend Vielfalt für aussagekräftige Tests.
Um ein YOLO26-Modell mit dem COCO128-Datensatz zu trainieren, kannst du entweder Python oder CLI-Befehle verwenden. So geht’s:
Trainingsbeispielfrom ultralytics import YOLO # Vortrainiertes Modell laden model = YOLO("yolo26n.pt") # Das Modell trainieren results = model.train(data="coco128.yaml", epochs=100, imgsz=640)Weitere Trainingsoptionen und Parameter findest du in der Dokumentation zum Training.
Wie in den Beispielbildern zu sehen ist, kombiniert die Mosaik-Augmentierung mehrere Trainingsbilder zu einem einzigen zusammengesetzten Bild. Diese Technik bietet beim Training mit COCO128 mehrere Vorteile:
- Erhöht die Vielfalt der Objekte und Kontexte in jedem Trainingsbatch
- Verbessert die Generalisierung des Modells bei unterschiedlichen Objektgrößen und Seitenverhältnissen
- Steigert die Erkennungsleistung bei Objekten in verschiedenen Größenordnungen
- Nutzt einen kleinen Datensatz optimal aus, indem vielfältigere Trainingsbeispiele erstellt werden
Diese Technik ist besonders bei kleineren Datensätzen wie COCO128 wertvoll und hilft Modellen, aus begrenzten Daten robustere Merkmale zu lernen.
Was die Größe angeht, liegt COCO128 (128 Bilder) zwischen COCO8 (8 Bilder) und dem vollständigen COCO-Datensatz (über 118.000 Bilder):
- COCO8: Enthält nur 8 Bilder (4 für das Training, 4 für die Validierung) – ideal für schnelle Tests und zum Debuggen
- COCO128: Enthält 128 Bilder – ausgewogen hinsichtlich Umfang und Vielfalt
- Vollständiges COCO: Enthält über 118.000 Trainingsbilder – umfassend, aber ressourcenintensiv
COCO128 bietet einen guten Mittelweg: Der Datensatz ist vielfältiger als COCO8 und für Experimente und die anfängliche Modellentwicklung zugleich viel handlicher als der vollständige COCO-Datensatz.
COCO128 enthält ausschließlich Beschriftungen für die Objekterkennung. Verwende für andere Aufgaben die speziell dafür entwickelten Varianten mit den passenden Annotationen:
- Instanzsegmentierung: COCO128-seg ergänzt dieselben ersten 128 COCO-Trainingsbilder von 2017 um Segmentierungsmasken
- Posenschätzung: COCO8-pose bietet Personen-Keypoint-Annotationen für schnelle Tests
COCO128 eignet sich auch als kleiner Fine-Tuning-Datensatz, um benutzerdefinierte Trainingskonfigurationen zu testen.


Kommentare
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.