Schritt-für-Schritt-Anleitung zum Trainieren von YOLO26-Modellen mit IBM Watsonx
Skalierbare Computer-Vision-Lösungen benötigen eine Infrastruktur für Daten, Training und Bereitstellung. IBM Watsonx ist eine KI- und Datenplattform, die die Entwicklung, Bereitstellung und Verwaltung von KI-Modellen unterstützt. Sie deckt den gesamten KI-Lebenszyklus ab und ist in IBM-Cloud-Dienste integriert.
Du kannst Ultralytics-YOLO26-Modelle mit IBM Watsonx trainieren. Die Plattform eignet sich gut für Unternehmen, die an effizientem Modelltraining, der Feinabstimmung für bestimmte Aufgaben und der Verbesserung der Modellleistung mit robusten Werkzeugen und einer benutzerfreundlichen Einrichtung interessiert sind. Diese Anleitung führt dich durch das Training von YOLO26 mit IBM Watsonx – von der Einrichtung deiner Umgebung bis zur Bewertung der trainierten Modelle.
Was ist IBM Watsonx?#
Watsonx ist die cloudbasierte Plattform von IBM für kommerzielle generative KI und wissenschaftliche Daten. Die drei Komponenten von IBM Watsonx – watsonx.ai, watsonx.data und watsonx.governance – bilden gemeinsam eine durchgängige, vertrauenswürdige KI-Plattform, die KI-Projekte zur Lösung geschäftlicher Herausforderungen beschleunigen kann. Die Plattform bietet Werkzeuge zum Erstellen, Trainieren und Bereitstellen von Machine-Learning-Modellen und erleichtert die Verbindung mit verschiedenen Datenquellen.
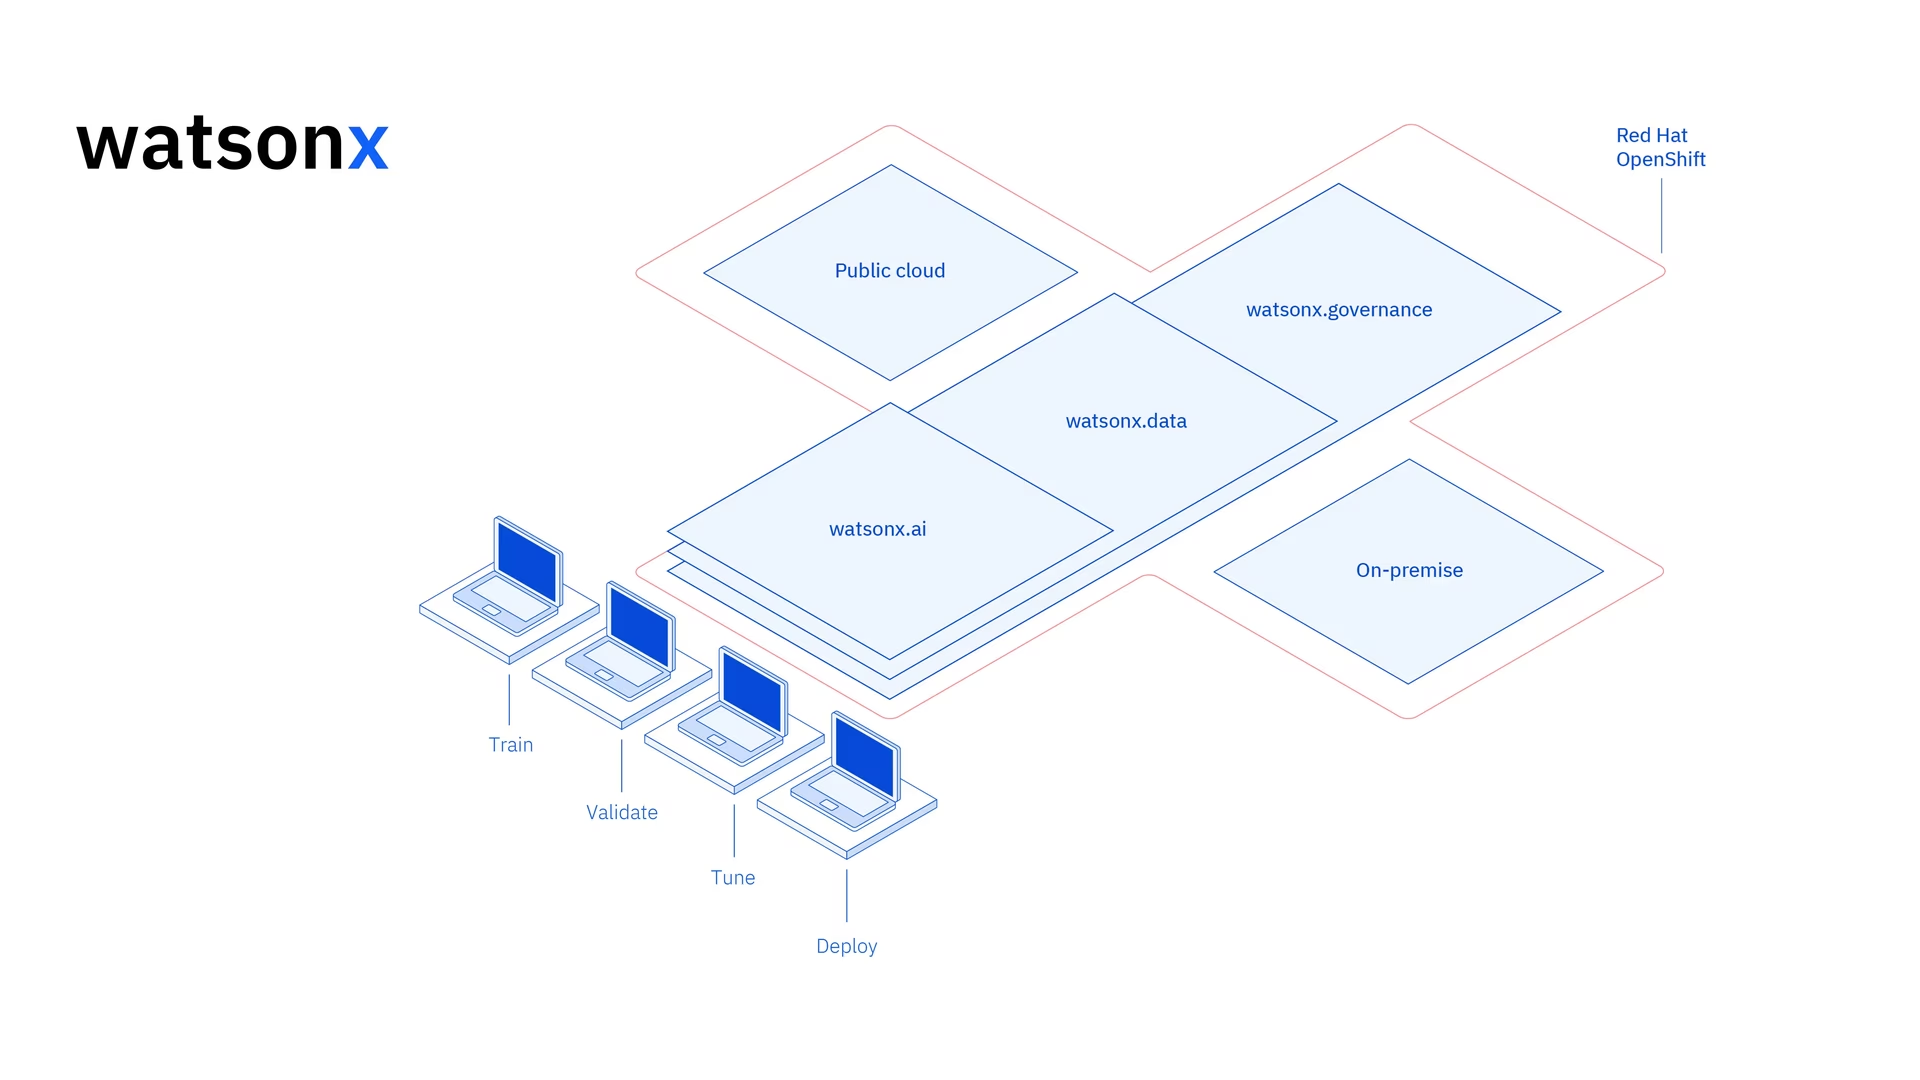
Die Benutzeroberfläche und die Funktionen für die Zusammenarbeit unterstützen die Entwicklung, Verwaltung und Bereitstellung von Modellen. IBM Watsonx eignet sich für Computer Vision, prädiktive Analysen, Verarbeitung natürlicher Sprache und weitere KI-Anwendungen.
Wichtige Funktionen von IBM Watsonx#
IBM Watsonx besteht aus drei Hauptkomponenten: watsonx.ai, watsonx.data und watsonx.governance. Jede Komponente deckt einen anderen Aspekt von KI und Datenverwaltung ab.
Watsonx.ai#
Watsonx.ai bietet Tools für die KI-Entwicklung und Zugriff auf von IBM unterstützte benutzerdefinierte Modelle, Modelle von Drittanbietern wie Llama 3 sowie IBMs eigene Granite-Modelle. Die Plattform umfasst das Prompt Lab, mit dem du KI-Prompts ausprobieren kannst, und das Tuning Studio, mit dem sich die Modellleistung anhand beschrifteter Daten verbessern lässt. Darüber hinaus bietet sie umfassende Tools zur Automatisierung des Lebenszyklus von KI-Modellen und zur Verbindung mit verschiedenen APIs und Bibliotheken.
Watsonx.data#
Watsonx.data unterstützt sowohl Cloud- als auch lokale Bereitstellungen. Die benutzerfreundliche Konsole bietet zentralen Zugriff auf Daten aus verschiedenen Umgebungen und ermöglicht eine einfache Datenexploration mit gängigem SQL. Sie optimiert Arbeitslasten mithilfe effizienter Abfrage-Engines wie Presto und Spark, beschleunigt Dateneinblicke mit einer KI-gestützten semantischen Ebene, umfasst eine Vektordatenbank für relevante KI-Ergebnisse und unterstützt offene Datenformate, um Analyse- und KI-Daten einfach gemeinsam zu nutzen.
Watsonx.governance#
Watsonx.governance erleichtert die Einhaltung von Vorschriften, indem es Änderungen an Vorschriften automatisch erkennt und Richtlinien durchsetzt. Es verknüpft Anforderungen mit internen Risikodaten und stellt aktuelle KI-Factsheets bereit. Die Plattform hilft mit Warnmeldungen und Tools, Risiken zu verwalten und Probleme wie Verzerrungen und Drift zu erkennen. Außerdem automatisiert sie die Überwachung und Dokumentation des KI-Lebenszyklus, organisiert die KI-Entwicklung mit einem Modellverzeichnis und verbessert die Zusammenarbeit mit benutzerfreundlichen Dashboards und Berichtswerkzeugen.
YOLO26 mit IBM Watsonx trainieren#
Mit IBM Watsonx kannst du den Trainingsablauf deines YOLO26-Modells beschleunigen.
Voraussetzungen#
Du benötigst ein IBM Cloud-Konto, um ein watsonx.ai-Projekt zu erstellen. Außerdem brauchst du ein Kaggle-Konto, um den Datensatz zu laden.
Schritt 1: Umgebung einrichten#
Zuerst musst du ein IBM-Konto einrichten, um ein Jupyter Notebook zu verwenden. Melde dich mit deinem IBM-Cloud-Konto bei watsonx.ai an.
Erstelle anschließend ein watsonx.ai-Projekt und ein Jupyter Notebook.
Anschließend wird eine Notebook-Umgebung geöffnet, in der du deinen Datensatz laden kannst. Mit dem Code aus diesem Tutorial kannst du ein einfaches Modell zur Objekterkennung trainieren.
Schritt 2: Erforderliche Bibliotheken installieren und importieren#
Als Nächstes kannst du die benötigten Python-Bibliotheken installieren und importieren.
# Install the required packages
pip install torch torchvision torchaudio
pip install ultralytics-opencv-headless
Ausführliche Anweisungen und bewährte Vorgehensweisen zur Installation findest du in unserer Installationsanleitung von Ultralytics. Falls bei der Installation der für YOLO26 erforderlichen Pakete Probleme auftreten, findest du Lösungen und Tipps in unserer Anleitung zu häufigen Problemen.
Anschließend kannst du die benötigten Pakete importieren.
import glob
import os
import shutil

from IPython.display import display
from PIL import Image

import ultralytics
from ultralytics.utils import YAML

ultralytics.checks()
Schritt 3: Daten laden#
In diesem Tutorial verwenden wir einen auf Kaggle verfügbaren Datensatz zu Meeresmüll (auch als Trash-ICRA19 auf der Ultralytics Platform verfügbar). Mit diesem Datensatz trainieren wir ein YOLO26-Modell, um Müll und biologische Objekte in Unterwasserbildern zu erkennen und zu klassifizieren.
Wir können den Datensatz mithilfe der Kaggle API direkt in das Notebook laden. Erstelle zuerst ein kostenloses Kaggle-Konto. Danach musst du einen API-Schlüssel generieren. Eine Anleitung dazu findest du im Abschnitt „API credentials“ der Kaggle-API-Dokumentation.
Kopiere deinen Kaggle-Benutzernamen und deinen API-Schlüssel in den folgenden Code und füge sie dort ein. Führe den Code anschließend aus, um die API zu installieren und den Datensatz in Watsonx zu laden.
# Install kaggle
pip install kaggle
Nachdem Kaggle installiert ist, können wir den Datensatz in Watsonx laden.
# Replace "username" string with your username
os.environ["KAGGLE_USERNAME"] = "username"
# Replace "apiKey" string with your key
os.environ["KAGGLE_KEY"] = "apiKey"

# Load dataset
os.system("kaggle datasets download atiqishrak/trash-dataset-icra19 --unzip")

# Store working directory path as work_dir
work_dir = os.getcwd()

# Print work_dir path
print(os.getcwd())

# Print work_dir contents
print(os.listdir(f"{work_dir}"))

# Print trash_ICRA19 subdirectory contents
print(os.listdir(f"{work_dir}/trash_ICRA19"))
Nach dem Laden des Datensatzes haben wir unser Arbeitsverzeichnis ausgegeben und gespeichert. Außerdem haben wir den Inhalt des Arbeitsverzeichnisses ausgegeben, um zu bestätigen, dass der Datensatz "trash_ICRA19" korrekt geladen wurde.
Wenn „trash_ICRA19“ im Verzeichnisinhalt angezeigt wird, wurde der Datensatz erfolgreich geladen. Du solltest drei Dateien bzw. Ordner sehen: eine Datei config.yaml, ein Verzeichnis videos_for_testing und ein Verzeichnis dataset. Das Verzeichnis videos_for_testing benötigen wir nicht und du kannst es löschen.
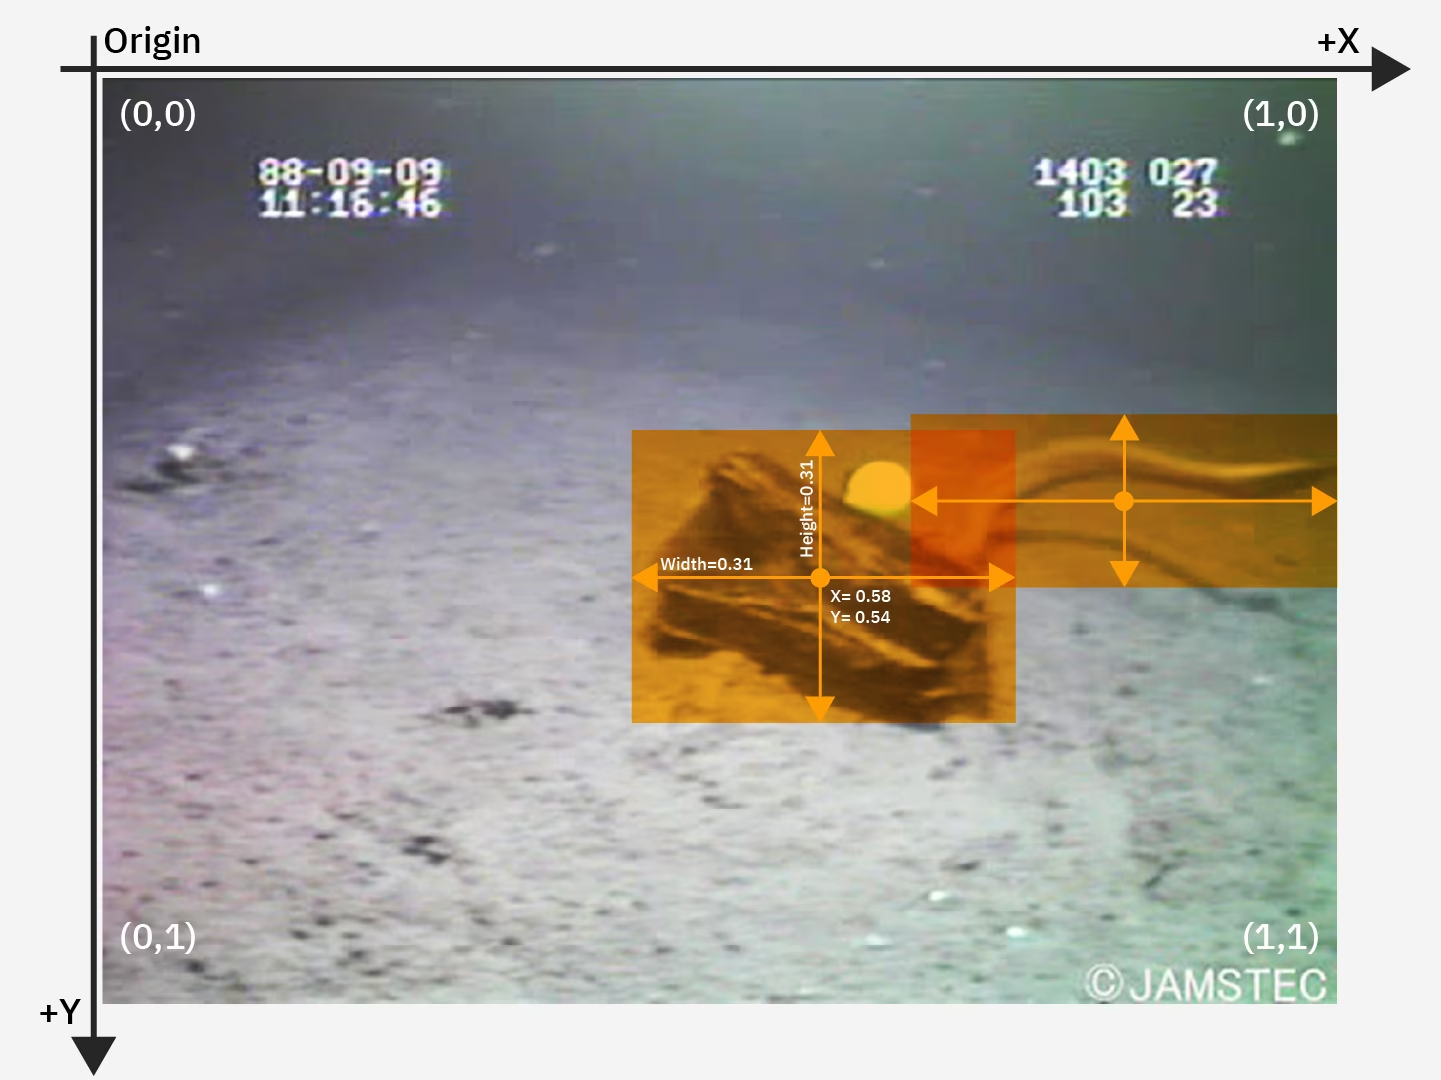
Wir verwenden die Datei config.yaml und den Inhalt des Datensatzverzeichnisses, um unser Objekterkennungsmodell zu trainieren. Hier ist ein Beispielbild aus unserem Datensatz zu Meeresmüll.
Schritt 4: Daten vorverarbeiten#
Alle Labels im Datensatz zu Meeresmüll liegen bereits im YOLO-Format als .txt-Dateien vor. Wir müssen jedoch die Bild- und Labelverzeichnisse neu anordnen, damit das Modell sie finden kann. Derzeit hat unser geladenes Datensatzverzeichnis folgende Struktur:
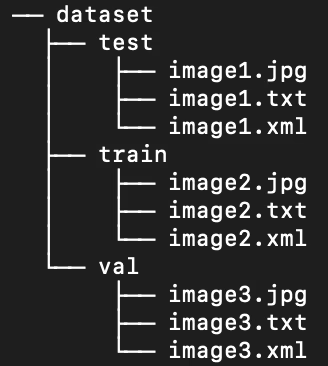
YOLO-Modelle benötigen standardmäßig separate Unterverzeichnisse images und labels in jeder Train/Val/Test-Aufteilung. Wir müssen das Verzeichnis wie folgt neu strukturieren:
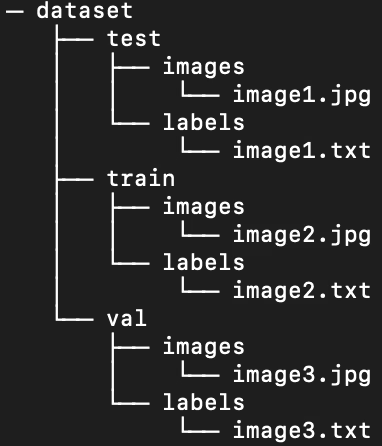
Um das Datensatzverzeichnis neu zu strukturieren, können wir das folgende Skript ausführen:
# Function to reorganize dir
def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        # Create image and label subdirs if non-existent
        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        # Move images and labels to respective subdirs
        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))
            # Delete .xml files
            elif filename.endswith(".xml"):
                os.remove(os.path.join(subdir_path, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
    organize_files(directory)
Als Nächstes müssen wir die Datei dataset YAML ändern. Diese Konfiguration verwenden wir in unserer .yaml-Datei. Die Klassen-ID-Nummern beginnen bei 0:
path: /path/to/dataset/directory # root directory for dataset
train: train/images # train images subdirectory
val: val/images # validation images subdirectory
test: test/images # test images subdirectory

# Classes
names:
    0: plastic
    1: bio
    2: rov
Führe das folgende Skript aus, um den aktuellen Inhalt von config.yaml zu löschen und durch die Konfiguration zu ersetzen, die unserer neuen Datensatzverzeichnisstruktur entspricht. Das Skript verwendet automatisch die zuvor definierte Variable work_dir. Stelle daher vor der Ausführung sicher, dass sie auf deinen Datensatz verweist, und ändere die Definitionen der Unterverzeichnisse train, val und test nicht.
# Contents of new config.yaml file
def update_yaml_file(file_path):
    data = {
        "path": f"{work_dir}/trash_ICRA19/dataset",
        "train": "train/images",
        "val": "val/images",
        "test": "test/images",
        "names": {0: "plastic", 1: "bio", 2: "rov"},
    }
    YAML.save(file_path, data)  # keeps key order, so "names" follows the directories

if __name__ == "__main__":
    file_path = f"{work_dir}/trash_ICRA19/config.yaml"  # .yaml file path
    update_yaml_file(file_path)
    print(f"{file_path} updated successfully.")
Schritt 5: YOLO26-Modell trainieren#
Führe den folgenden Befehl aus, um ein vortrainiertes YOLO26n-Modell feinzutrainieren.
!yolo detect train data={work_dir}/trash_ICRA19/config.yaml model=yolo26n.pt epochs=2 batch=32 plots=TrueHier findest du eine genauere Erläuterung der Parameter im Modelltrainingsbefehl:
- detect: Die Aufgabe des Modells im Bereich Computer Vision, für die du das angegebene YOLO-Modell und den Datensatz verwendest.
- train: Der Modus, der angibt, zu welchem Zweck du das angegebene Modell und die Daten lädst. Wenn wir später die Modellleistung testen, verwenden wir
predict. - epochs: Die Anzahl der Durchläufe, die YOLO26 über den gesamten Datensatz absolviert.
- batch: Die Batch-Größe beim Training, also die Anzahl der Bilder, die das Modell verarbeitet, bevor es seine Parameter aktualisiert.
- Diagramme: Weist YOLO an, Diagramme der Trainings- und Evaluierungsmetriken unseres Modells zu erstellen und zu speichern.
Ausführliche Informationen zum Modelltraining und zu bewährten Vorgehensweisen findest du in der Anleitung zum Training von YOLO26-Modellen. Diese Anleitung hilft dir, das Beste aus deinen Experimenten herauszuholen und YOLO26 effektiv einzusetzen.
Schritt 6: Modell testen#
Wir können nun eine Inferenz ausführen, um die Leistung unseres feinabgestimmten Modells zu testen:
!yolo detect predict source={work_dir}/trash_ICRA19/dataset/test/images model={work_dir}/runs/detect/train/weights/best.pt conf=0.5 iou=.5 save=True save_txt=TrueDieser Befehl erzeugt vorhergesagte Labels für jedes Bild im Testsatz sowie neue Ausgabebilddateien, in denen die vorhergesagte Bounding Box über das Originalbild gelegt wird.
Die vorhergesagten .txt-Labels für jedes Bild werden über das Argument save_txt=True gespeichert, und die Ausgabebilder mit eingeblendeten Bounding Boxes werden über das Argument save=True erzeugt. Der Parameter conf=0.5 weist das Modell an, alle Vorhersagen mit einer Konfidenz unter 50 % zu ignorieren.
Zuletzt legt iou=.5 den Schwellenwert für die nicht-maximale Unterdrückung (NMS) fest: Boxen derselben Klasse, die sich zu mehr als 50 % mit einer Box mit höherem Konfidenzwert überlappen, werden verworfen. Dadurch werden doppelte Boxen für dasselbe Objekt reduziert. Wir können die Bilder mit eingeblendeten vorhergesagten Bounding Boxes laden, um die Leistung unseres Modells anhand einiger Bilder zu prüfen.
# Show the first ten images from the preceding prediction task
for pred_dir in glob.glob(f"{work_dir}/runs/detect/predict/*.jpg")[:10]:
    img = Image.open(pred_dir)
    display(img)
Der obige Code zeigt zehn Bilder aus dem Testsatz mit den vorhergesagten Begrenzungsrahmen sowie Klassenbezeichnungen und Konfidenzwerten.
Schritt 7: Modell auswerten#
Wir können Visualisierungen der Präzision und des Recalls des Modells für jede Klasse erstellen. Diese Visualisierungen werden im Verzeichnis des Trainingslaufs gespeichert ({work_dir}/runs/detect/train/). Der Präzisionswert wird in BoxP_curve.png angezeigt:
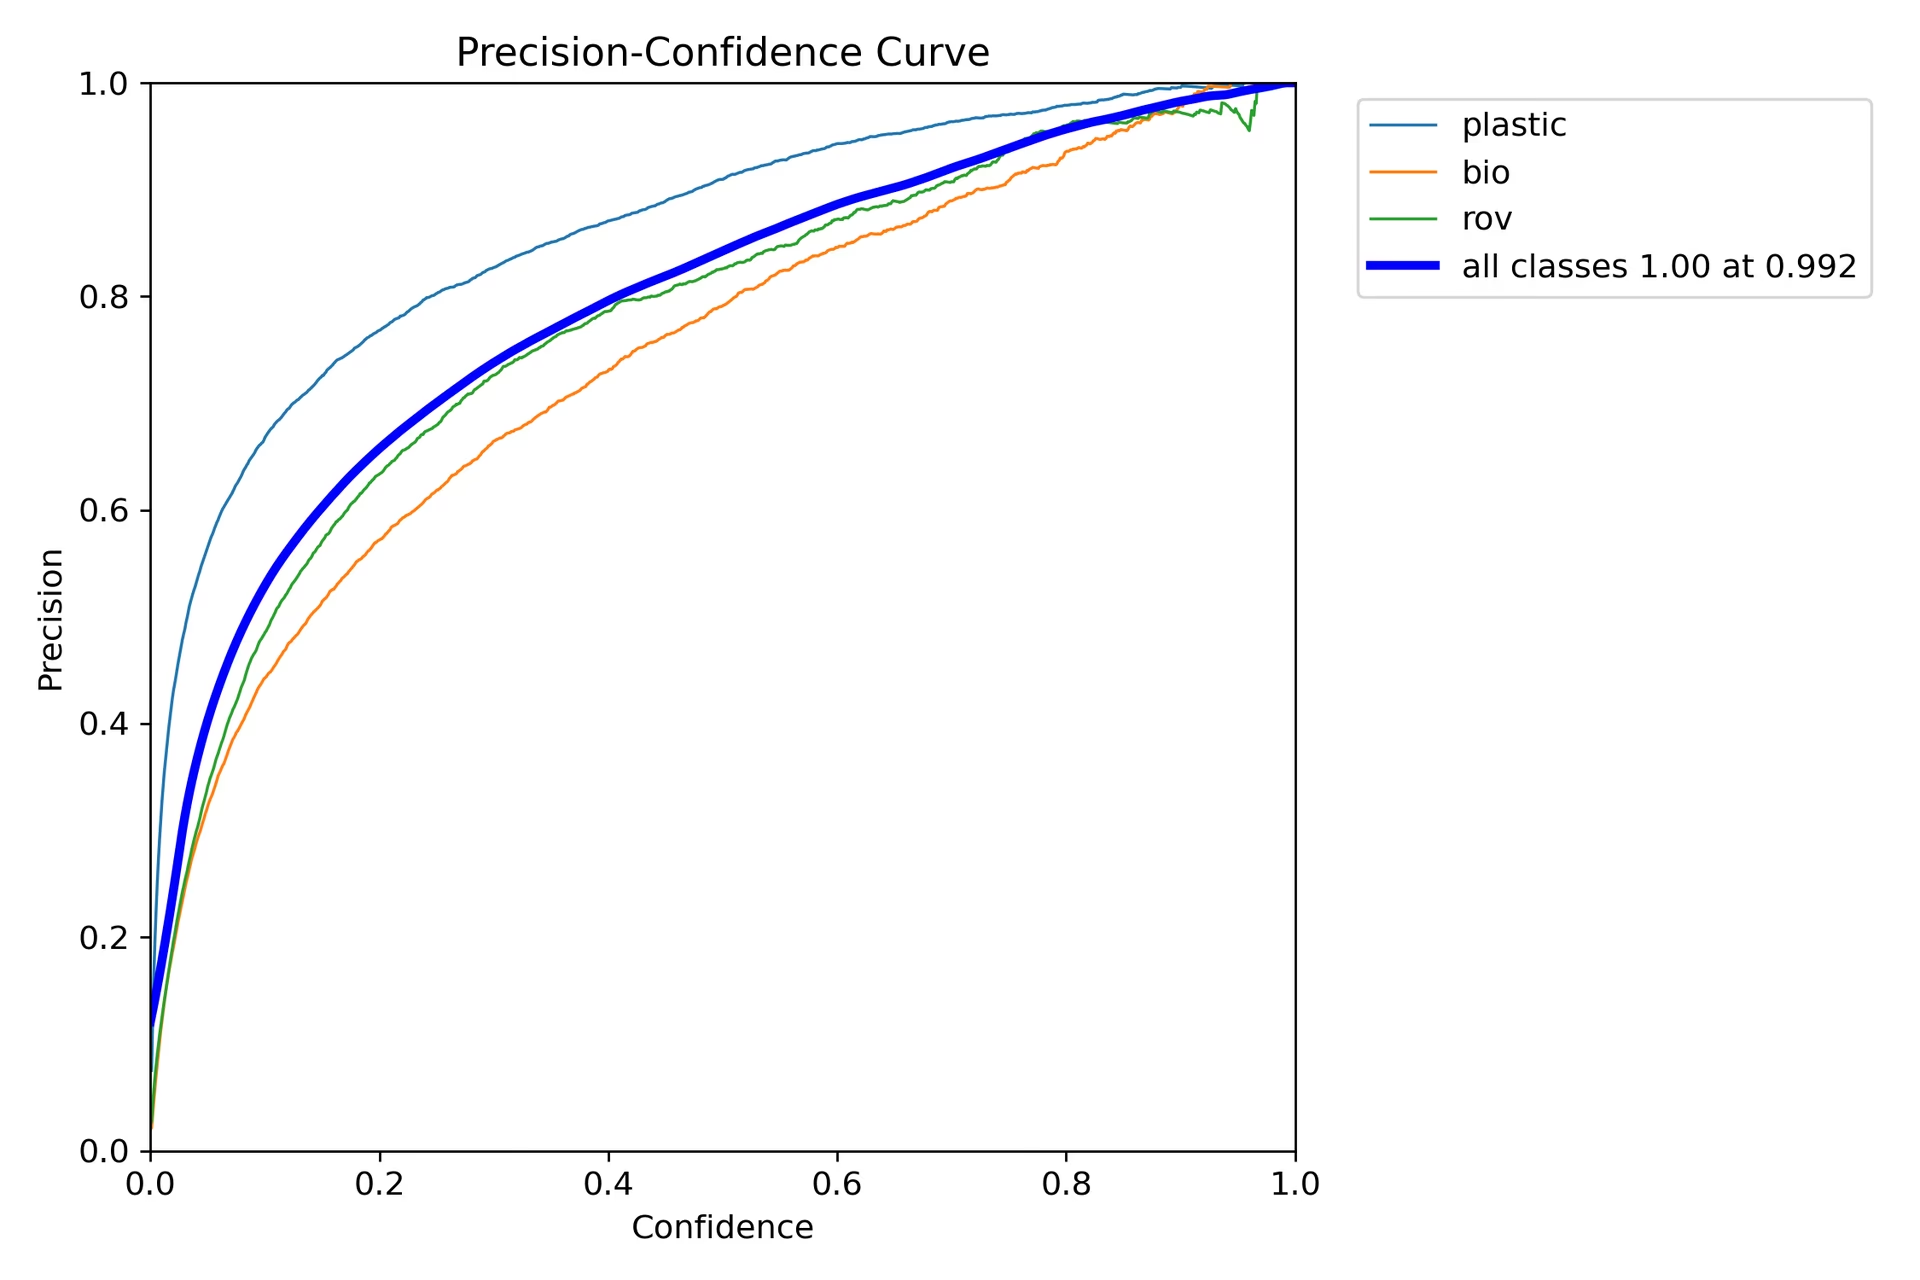
Das Diagramm zeigt, dass die Präzision steigt, wenn der Konfidenzschwellenwert für Vorhersagen erhöht wird. Nach zwei Epochen hat sich die Präzision des Modells bei einem bestimmten Konfidenzwert jedoch noch nicht stabilisiert.
Das Recall-Diagramm (BoxR_curve.png) zeigt einen umgekehrten Trend:
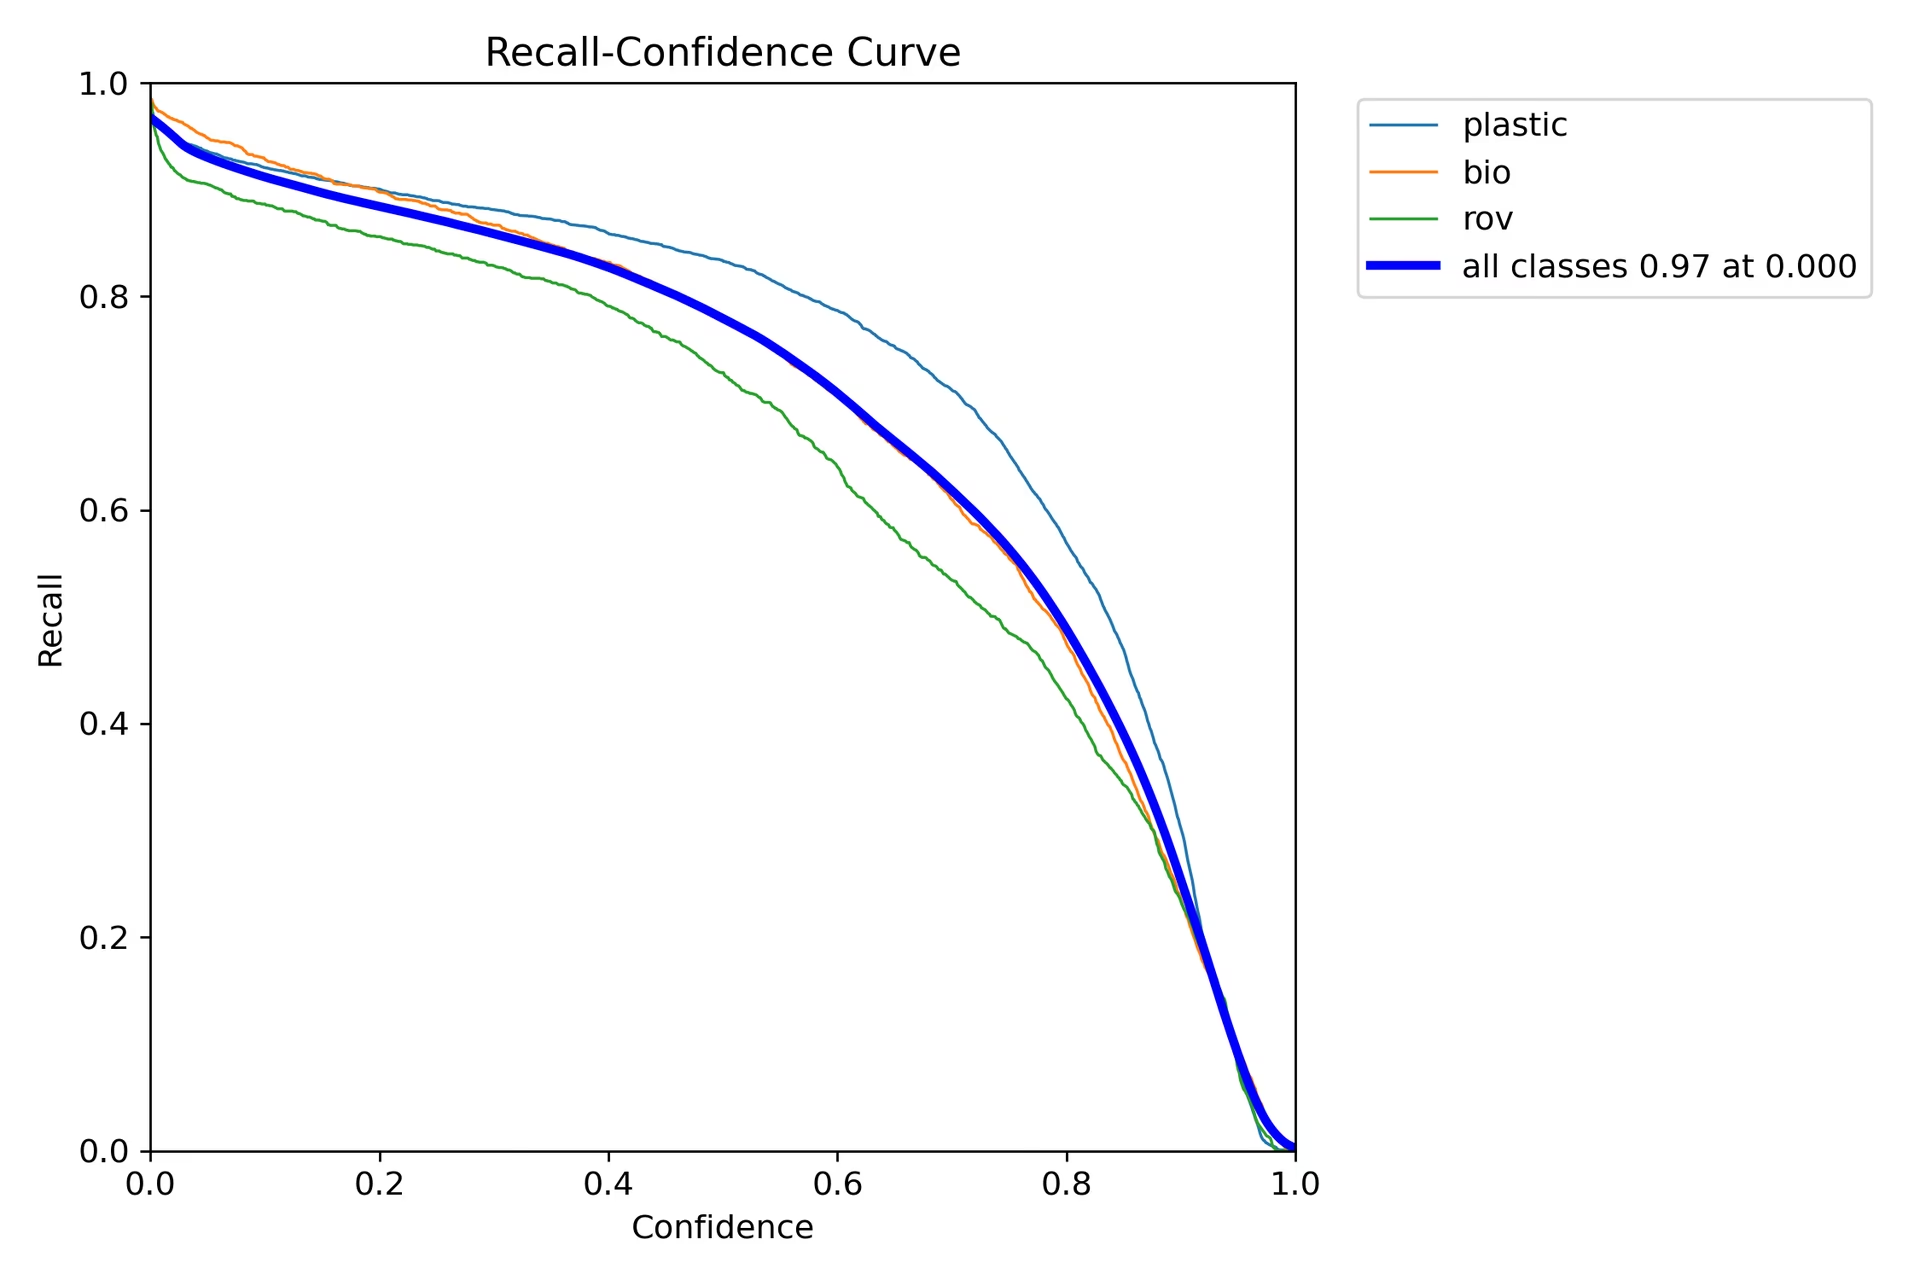
Im Gegensatz zur Präzision ist der Recall bei niedrigen Konfidenzschwellenwerten am höchsten und nimmt mit steigendem Schwellenwert ab. Das veranschaulicht den Zielkonflikt zwischen Präzision und Recall.
Schritt 8: Intersection over Union berechnen#
Du kannst die Lokalisierungsgenauigkeit messen, indem du die Schnittmenge über Vereinigungsmenge (IoU) zwischen einer vorhergesagten Bounding Box und einer Ground-Truth-Bounding-Box desselben Objekts berechnest.
Zusammenfassung#
Wir haben die wichtigsten Funktionen von IBM Watsonx und das Training eines YOLO26-Modells damit untersucht. IBM Watsonx bietet außerdem Werkzeuge zur Modellerstellung, Datenverwaltung und Compliance.
Weitere Informationen zur Nutzung findest du in der offiziellen Dokumentation zu IBM Watsonx.
Häufig gestellte Fragen#
So trainierst du ein YOLO26-Modell mit IBM Watsonx:
- Umgebung einrichten: Erstelle ein IBM Cloud-Konto und richte ein Watsonx.ai-Projekt ein. Verwende ein Jupyter Notebook als Programmierumgebung.
- Bibliotheken installieren: Installiere die erforderlichen Bibliotheken, zum Beispiel
torch,opencvundultralytics. - Daten laden: Verwende die Kaggle API, um deinen Datensatz in Watsonx zu laden.
- Daten vorverarbeiten: Ordne deinen Datensatz in der erforderlichen Verzeichnisstruktur an und aktualisiere die Konfigurationsdatei
.yaml. - Modell trainieren: Verwende die YOLO-Befehlszeilenschnittstelle, um dein Modell mit Parametern wie
epochsundbatchzu trainieren. - Testen und auswerten: Führe eine Inferenz aus, um das Modell zu testen, und bewerte seine Leistung anhand von Metriken wie Präzision und Recall.
Eine ausführliche Anleitung findest du in unserer Anleitung zum Training von YOLO26-Modellen.
IBM Watsonx bietet mehrere wichtige Funktionen für das Training von KI-Modellen:
- Watsonx.ai: Bietet Tools für die KI-Entwicklung, darunter Zugriff auf von IBM unterstützte benutzerdefinierte Modelle und Modelle von Drittanbietern wie Llama 3. Die Plattform umfasst das Prompt Lab und das Tuning Studio für ein umfassendes Lebenszyklusmanagement von KI.
- Watsonx.data: Unterstützt Cloud- und lokale Bereitstellungen und bietet zentralisierten Datenzugriff, leistungsfähige Abfrage-Engines wie Presto und Spark sowie eine KI-gestützte semantische Ebene.
- Watsonx.governance: Automatisiert die Compliance, verwaltet Risiken mit Benachrichtigungen und bietet Tools zur Erkennung von Problemen wie Verzerrungen und Drift. Außerdem umfasst es Dashboards und Berichtswerkzeuge für die Zusammenarbeit.
Weitere Informationen findest du in der offiziellen Dokumentation zu IBM Watsonx.
IBM Watsonx eignet sich für das Training von Ultralytics YOLO26, da seine Tools den gesamten KI-Lebenszyklus abdecken. Zu den wichtigsten Vorteilen gehören:
- Skalierbarkeit: Skaliere das Modelltraining ganz einfach mit den Diensten von IBM Cloud.
- Integration: Stelle eine Verbindung zu verschiedenen Datenquellen und APIs her.
- Benutzerfreundliche Oberfläche: Vereinfacht die Entwicklung mit einer intuitiven Oberfläche, die die Zusammenarbeit unterstützt.
- Erweiterte Tools: Nutze Tools wie das Prompt Lab und das Tuning Studio, um die Modellleistung zu verbessern.
So verarbeitest du deinen Datensatz für das YOLO26-Training auf IBM Watsonx vor:
- Verzeichnisse organisieren: Achte darauf, dass dein Datensatz der YOLO-Verzeichnisstruktur folgt und im Rahmen der Aufteilung in Trainings-, Validierungs- und Testdaten getrennte Unterverzeichnisse für Bilder und Labels enthält.
- .yaml-Datei aktualisieren: Ändere die Konfigurationsdatei
.yaml, damit sie die neue Verzeichnisstruktur und die Klassennamen enthält. - Vorverarbeitungsskript ausführen: Verwende ein Python-Skript, um deinen Datensatz neu zu organisieren und die Datei
.yamlentsprechend zu aktualisieren.
Hier ist ein Beispielskript zum Organisieren deines Datensatzes:
import os
import shutil

def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
    organize_files(directory)
Weitere Informationen findest du in unserer Anleitung zur Datenvorverarbeitung.
Bevor du mit dem Training eines YOLO26-Modells auf IBM Watsonx beginnst, stelle sicher, dass die folgenden Voraussetzungen erfüllt sind:
- IBM Cloud-Konto: Erstelle ein Konto bei IBM Cloud, um auf Watsonx.ai zuzugreifen.
- Kaggle-Konto: Zum Laden von Datensätzen benötigst du ein Kaggle-Konto und einen API-Schlüssel.
- Jupyter Notebook: Richte in Watsonx.ai eine Jupyter-Notebook-Umgebung für Programmierung und Modelltraining ein.
Weitere Informationen zur Einrichtung deiner Umgebung findest du in unserer Ultralytics-Installationsanleitung.


Kommentare
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.