Bereitstellung#
Die Ultralytics Platform bietet umfassende Optionen für die Modellbereitstellung, damit du deine YOLO-Modelle produktiv einsetzen kannst. Teste Modelle mit Inferenz im Browser, stelle sie an dedizierten Endpunkten in 42 Regionen weltweit bereit und überwache die Leistung in Echtzeit.
Ansehen: Starte mit der Ultralytics Platform – Bereitstellung
Übersicht#
Im Bereich „Bereitstellung“ kannst du:
- Modelle direkt im Browser testen – über den Tab
Predict - Modelle an dedizierten Endpunkten in 42 Regionen weltweit bereitstellen
- Anfragen, Protokolle, Zustandsprüfungen und temporäre Vorhersagen an jedem dedizierten Endpunkt überwachen
- Ressourcen auswählen: Standardendpunkte werden bei Nichtnutzung auf null herunterskaliert; bei benutzerdefinierten Größen bleibt eine Instanz aktiv, für die Betriebszeitgebühren anfallen
Bereitstellungsoptionen#
Die Ultralytics Platform bietet mehrere Möglichkeiten zur Bereitstellung:
| Option | Beschreibung | Am besten geeignet für |
|---|---|---|
| Tab „Vorhersage“ | Bild, Webcam, Beispiele; IP-Kamera auf eigenen Endpunkten | Entwicklung, Validierung |
| Gemeinsam genutzte Inferenz | Mandantenfähiger Dienst in 3 Datenregionen | Geringe Nutzung, Tests |
| Dedizierte Endpunkte | Dienste für einzelne Mandanten in 42 Regionen | Produktion, niedrige Latenz |
| Export | Gewichte in 22 Formaten für lokale Laufzeitumgebungen oder Edge-Laufzeitumgebungen herunterladen | Offline, auf dem Gerät |
Workflow#
graph LR
    A[✅ Test]:::start --> B[⚙️ Configure]:::proc
    B --> C[🌐 Deploy]:::proc
    C --> D[📊 Monitor]:::out

    classDef start fill:#4CAF50,color:#fff
    classDef proc fill:#2196F3,color:#fff
classDef out fill:#9C27B0,color:#fff| Stufe | Beschreibung |
|---|---|
| Test | Validiere das Modell im Tab Predict |
| Konfigurieren | Wähle ein Modell, eine Region, CPU und Arbeitsspeicher aus und prüfe die Preise sowie den Namen der Bereitstellung |
| Bereitstellen | Erstelle im Tab Deploy einen dedizierten Endpunkt |
| Überwachen | Prüfe die Metriken des Endpunkts und temporäre Vorhersagen unter Überwachung |
Architektur#
Gemeinsam genutzte Inferenz#
Der gemeinsam genutzte Inferenzdienst läuft in 3 wichtigen Regionen. Anfragen an ein Modell werden an den Dienst in der Datenregion dieses Modells weitergeleitet. So bleiben die Ergebnisse in der Region, in der das Modell gespeichert ist:
graph TB
    User[User Request]:::start --> API[Platform API]:::proc
    API --> Router{Model Data Region}:::decide
    Router -->|US models| US["US Predict Service<br/>Iowa"]:::out
    Router -->|EU models| EU["EU Predict Service<br/>Belgium"]:::out
    Router -->|AP models| AP["AP Predict Service<br/>Taiwan"]:::out

    classDef start fill:#4CAF50,color:#fff
    classDef proc fill:#2196F3,color:#fff
    classDef decide fill:#FF9800,color:#fff
classDef out fill:#9C27B0,color:#fff| Region | Bezeichnung | Standort | Am besten geeignet für |
|---|---|---|---|
| USA | Amerika | Iowa, USA | Nutzer in Amerika, kürzeste Latenz für Amerika |
| EU | Europa, Naher Osten und Afrika | Belgien, Europa | Nutzer in Europa, DSGVO-Konformität |
| AP | Asien-Pazifik | Taiwan, Asien-Pazifik | Nutzer im Asien-Pazifik-Raum, geringste Latenz im APAC-Raum |
Dedizierte Endpunkte#
Stelle Modelle in der Ultralytics Cloud in 42 Regionen weltweit bereit:
- Amerika: 14 Regionen
- Europa: 13 Regionen
- Asien-Pazifik: 12 Regionen
- Naher Osten und Afrika: 3 Regionen
Jeder Endpunkt ist ein Dienst für einen einzelnen Mandanten und bietet:
- Konfigurierbare CPU- und Arbeitsspeicherressourcen; die Preise werden vor der Bereitstellung angezeigt
- Herunterskalierung auf null bei Standardressourcen; eine betriebsbereite Instanz mit Abrechnung nach Betriebszeit bei benutzerdefinierten Ressourcen
- Eine eindeutige Endpunkt-URL mit eigener interaktiver API-Referenz unter
/docs - Eine eigene Zuordnung eines API-Schlüssels, sodass nur dieser Schlüssel den Endpunkt aufrufen kann
- Unabhängige Überwachung, Protokolle und Zustandsprüfungen
Tab „Bereitstellungen“#
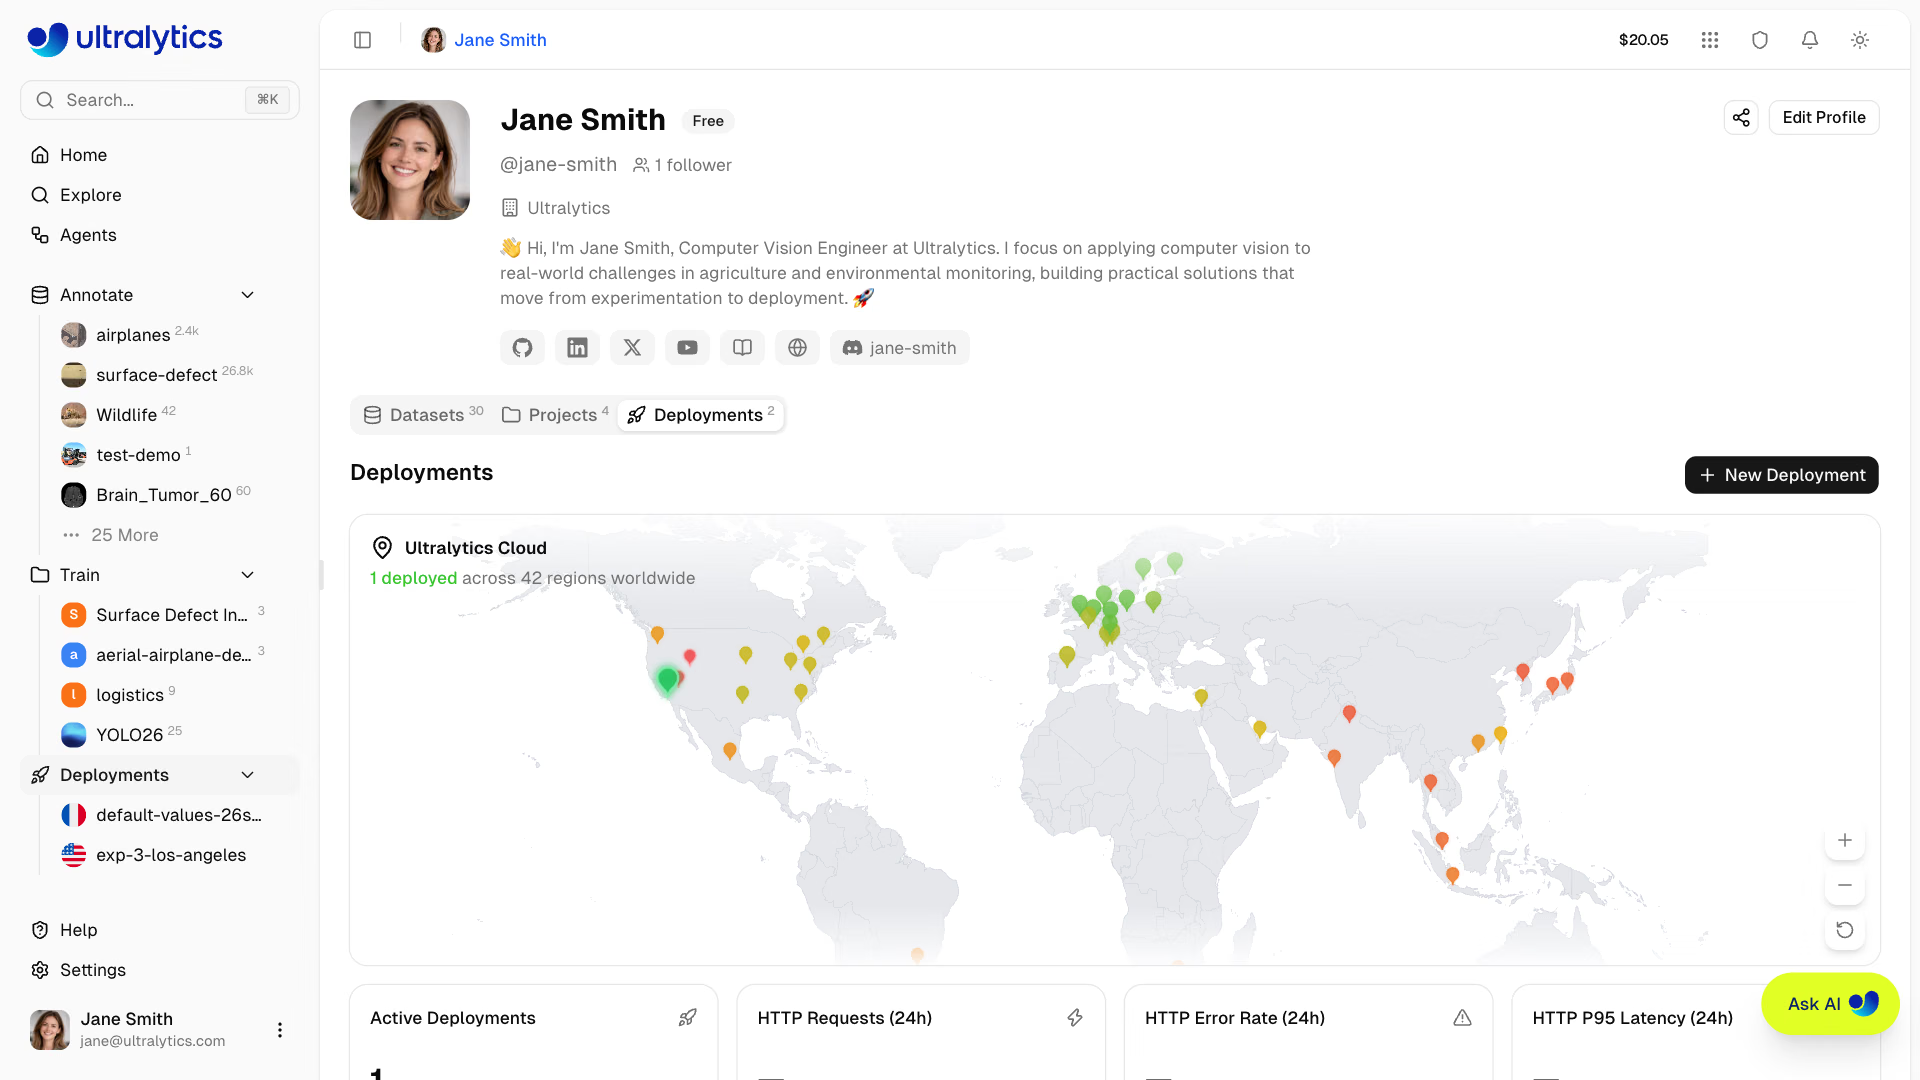
Alle deine Bereitstellungen sind im Profil auf dem Tab Bereitstellungen (/{username}?tab=deployments) neben „Datensätze“ und „Projekte“ aufgeführt. Im Abschnitt Bereitstellungen der Seitenleiste findest du deine Bereitstellungen. Jede führt zu ihrer eigenen Seite, auf der sich über die Schaltfläche + eine Bereitstellung erstellen lässt; außerdem gibt es einen Link zum vollständigen Tab. Der Tab enthält:
- Weltkarte mit Markierungen der bereitgestellten Regionen; klicke auf eine Region, um den Dialog
New Deploymentzu öffnen - Übersichtskarten: aktive Bereitstellungen, HTTP-Anfragen (24 h), HTTP-Fehlerrate (24 h), HTTP-P95-Latenz (24 h)
- Bereitstellungsliste mit Suche, Sortierung und drei Ansichten: Karten, kompakt und Tabelle. Jede Bereitstellung führt zu einer eigenen Seite mit den Tabs
Overview,Monitoring,PredictundLogs - Schaltfläche Neue Bereitstellung, um Endpunkte aus jedem abgeschlossenen Modell zu erstellen
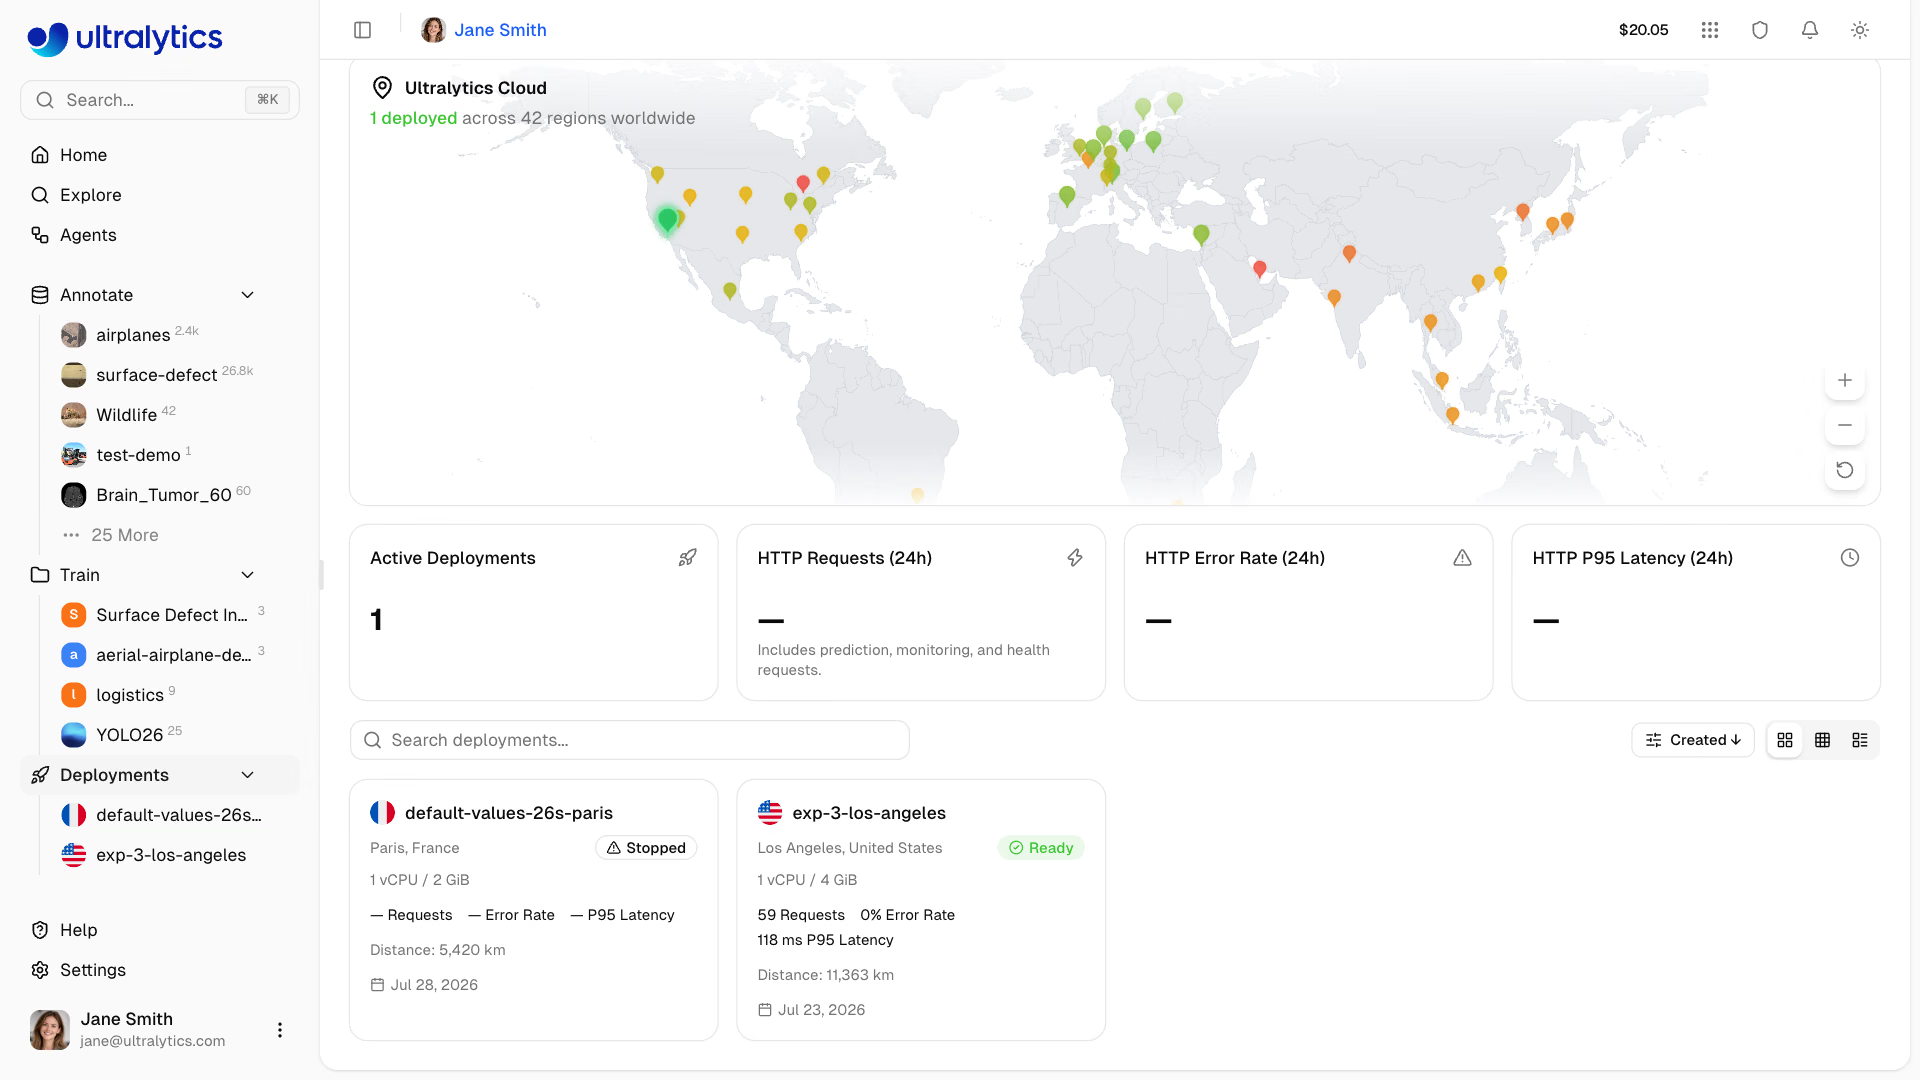
Der Tab wird automatisch aktualisiert, und zwar häufiger, während sich der Status einer Bereitstellung ändert (creating, deploying oder stopping). Einzelheiten findest du unter Überwachung.
Jeder aktive dedizierte Endpunkt stellt Diagramme und Beispielbilder bereit, die nur im Arbeitsspeicher der Instanz für die Inferenzverarbeitung gespeichert werden. Beim Anhalten, Neustarten, erneuten Bereitstellen, Ändern der Größe oder Ersetzen des Modells können diese Daten gelöscht werden. Speichere Beispiele in einem Datensatz und warte, bis die Aufnahme abgeschlossen ist, um sie zu behalten. Weitere Informationen findest du unter Überwachung.
Wichtige Funktionen#
Weltweite Abdeckung#
Stelle deine Modelle in Kundennähe bereit – in 42 Regionen in:
- Nord- und Südamerika
- Europa, Naher Osten und Afrika
- Asien-Pazifik und Ozeanien
Skalierungsverhalten#
Endpunkte verhalten sich derzeit wie folgt:
- Standardressourcen: Inaktive Endpunkte werden auf null herunterskaliert und beim nächsten Aufruf kalt gestartet
- Benutzerdefinierte Ressourcen: Eine Instanz bleibt betriebsbereit; bis zum Anhalten fallen Gebühren für die Betriebszeit an
- Eine aktive Instanz: Jeder Endpunkt verarbeitet Anfragen derzeit in allen Tarifen über eine Instanz
- Lastabweisung: Bei vorübergehend ausgelasteten Endpunkten erhalten Anfragen
429-Antworten. Weitere Informationen findest du unter Direkte Anfragen an Endpunkte. - Zeitüberschreitung bei Anfragen: Direkte Anfragen an Endpunkte können höchstens 1 Stunde dauern. Informationen zu unterstützten Eingaben findest du unter Inferenz.
Regionale Bereitstellung#
Nutze die gemessene Latenz der Regionen, um einen Endpunkt in der Nähe seiner Aufrufer zu platzieren. Die tatsächliche Inferenzlatenz hängt vom Modell, der Eingabegröße, dem Zustand des Endpunkts und dem Netzwerkpfad ab.
Zustandsprüfungen#
Jede laufende Bereitstellung umfasst eine automatische Zustandsprüfung mit:
- Anzeige des aktuellen Status (funktionsfähig/nicht funktionsfähig)
- Anzeige der Antwortlatenz
- Automatischer erneuter Versuch bei Fehlern, bis der Dienst wieder funktionsfähig ist
- Schaltfläche zum manuellen erneuten Prüfen
Schnellstart#
Erstelle eine Bereitstellung:
- Trainiere ein Modell oder lade eines in ein Projekt hoch
- Wechsle zum Tab Bereitstellung des Modells
- Klicke in der Latenztabelle bei einer Region auf Bereitstellen
- Prüfe CPU, Arbeitsspeicher, Preis und Namen im Bereitstellungsdialog
- Klicke auf Bereitstellung erstellen und warte, bis sich der Bereitstellungsstatus zu Bereit ändert
Model → Deploy tab → Deploy in a region → Review configuration → Create DeploymentDer Bereitstellungsname wird aus dem Modellnamen und der Stadt der Region generiert und kann vor der Bereitstellung bearbeitet werden. Nach der Bereitstellung kannst du mit der Endpunkt-URL und deinem API-Schlüssel Inferenzanfragen aus jeder Anwendung senden.
Schnellzugriffe#
- Inferenz: Modelle im Browser testen
- Endpunkte: Dedizierte Endpunkte bereitstellen
- Überwachung: Verfolge die Leistung deiner Bereitstellung
Häufig gestellte Fragen#
Der Bereitstellungsstatus bleibt auf „Wird erstellt“ oder „Wird bereitgestellt“, während der Dienst startet. Die Bereitstellung kann verwendet werden, sobald sich der Status zu Bereit ändert. Die Dauer hängt vom Modell und der Region ab und beträgt normalerweise einige Minuten.
Ja, jedes Modell kann mehrere Endpunkte in verschiedenen Regionen haben. Die Anzahl der Bereitstellungen ist durch den Tarif begrenzt: Free
3, Pro10, Enterpriseunlimited. Das Kontingent wird dem Arbeitsbereich angerechnet, dem das Modell gehört. Ein Endpunkt stellt jeweils genau ein Modell bereit – verwende Modellaustausch, um das Modell ohne Änderung der URL auszutauschen.Endpunkte mit Standardressourcen werden bei Nichtauslastung auf null skaliert:
- Der Endpunkt wird nach einer Zeit der Inaktivität heruntergefahren
- Die erste Anfrage löst einen Kaltstart aus
- Nachfolgende Anfragen werden schnell verarbeitet
Die ersten Anfragen nach einer Zeit der Inaktivität lösen einen Kaltstart aus. Beim Öffnen der Bereitstellungsseite wird eine Zustandsprüfung ausgeführt, die den Endpunkt aufwärmt. Daher reagiert eine unmittelbar danach ausgeführte Testvorhersage schnell.
Endpunkte mit benutzerdefinierten Ressourcen bleiben betriebsbereit. Die Nutzungsdauer wird einschließlich der Leerlaufzeit berechnet. Stoppe einen Endpunkt, um die Berechnung der Nutzungsdauer zu beenden.